多模态生成
共 290 个仓库 · Python
让视频扩散模型在普通显卡上也能跑起来,通过帧打包技术大幅降低显存占用,实现实用的长视频生成。
基于流匹配的语音合成模型官方实现,只需一段参考音频就能克隆音色并生成流畅自然的语音,适合做零样本 TTS 和语音克隆。
开源实现的 CLIP 多模态模型,提供图像-文本对比学习训练与预训练权重,支持零样本图像分类和跨模态检索。
开源音乐生成基础模型,用符号规划、零样本翻唱和智能体编辑从歌词生成完整歌曲,适合研究音乐生成与风格迁移。
开源文生视频和图生视频模型,CogVideoX 支持从文本或图片生成视频,适合搭建视频生成推理服务。
腾讯混元开源的大规模视频生成框架,基于扩散 Transformer 把文本提示直接生成连贯视频,适合做文生视频研究和应用落地。
用 Python 直接调用微软 Edge 的在线语音合成服务,无需安装 Edge 浏览器或密钥,即可把文本转成自然语音。
LTX-Video 是 Lightricks 开源的视频生成模型,支持文生视频和图生视频,基于 DiT 扩散架构,可快速生成高质量短视频。
把网页直接当像素图像来检索的 RAG 引擎,跳过 HTML 解析,靠视觉语言模型做原生搜索,适合构建多模态 Agent 的长期记忆。
开源多模态大模型家族,视觉语言能力接近 GPT-4o,支持图像分类、图文检索、语义分割和视频理解等任务。

SANA 是英伟达开源的高效扩散生成模型与配套训练推理引擎,支持文生图、文生视频和世界模型,用线性注意力和 NVFP4 量化在低显存下实现快速生成。
一份持续更新的异常检测资源大全,汇总书籍、论文、视频和工具箱,覆盖传统方法与最新的 LLM、VLM 工作,适合快速入门和跟进前沿。
基于多模态大模型的 GUI 智能体家族,能看懂手机和电脑界面并自动点击操作,帮你完成跨 App 的自动化任务。
基于 so-vits-svc 改进的歌声与语音转换工具,支持实时变声、更友好的操作界面和更多功能,适合做 AI 翻唱和音色克隆。
A sound cloning tool with a web interface, using your voice or any sound to record audio / 一个带web界面的声音克隆工具,使用你的音色或任意声音来录制音频
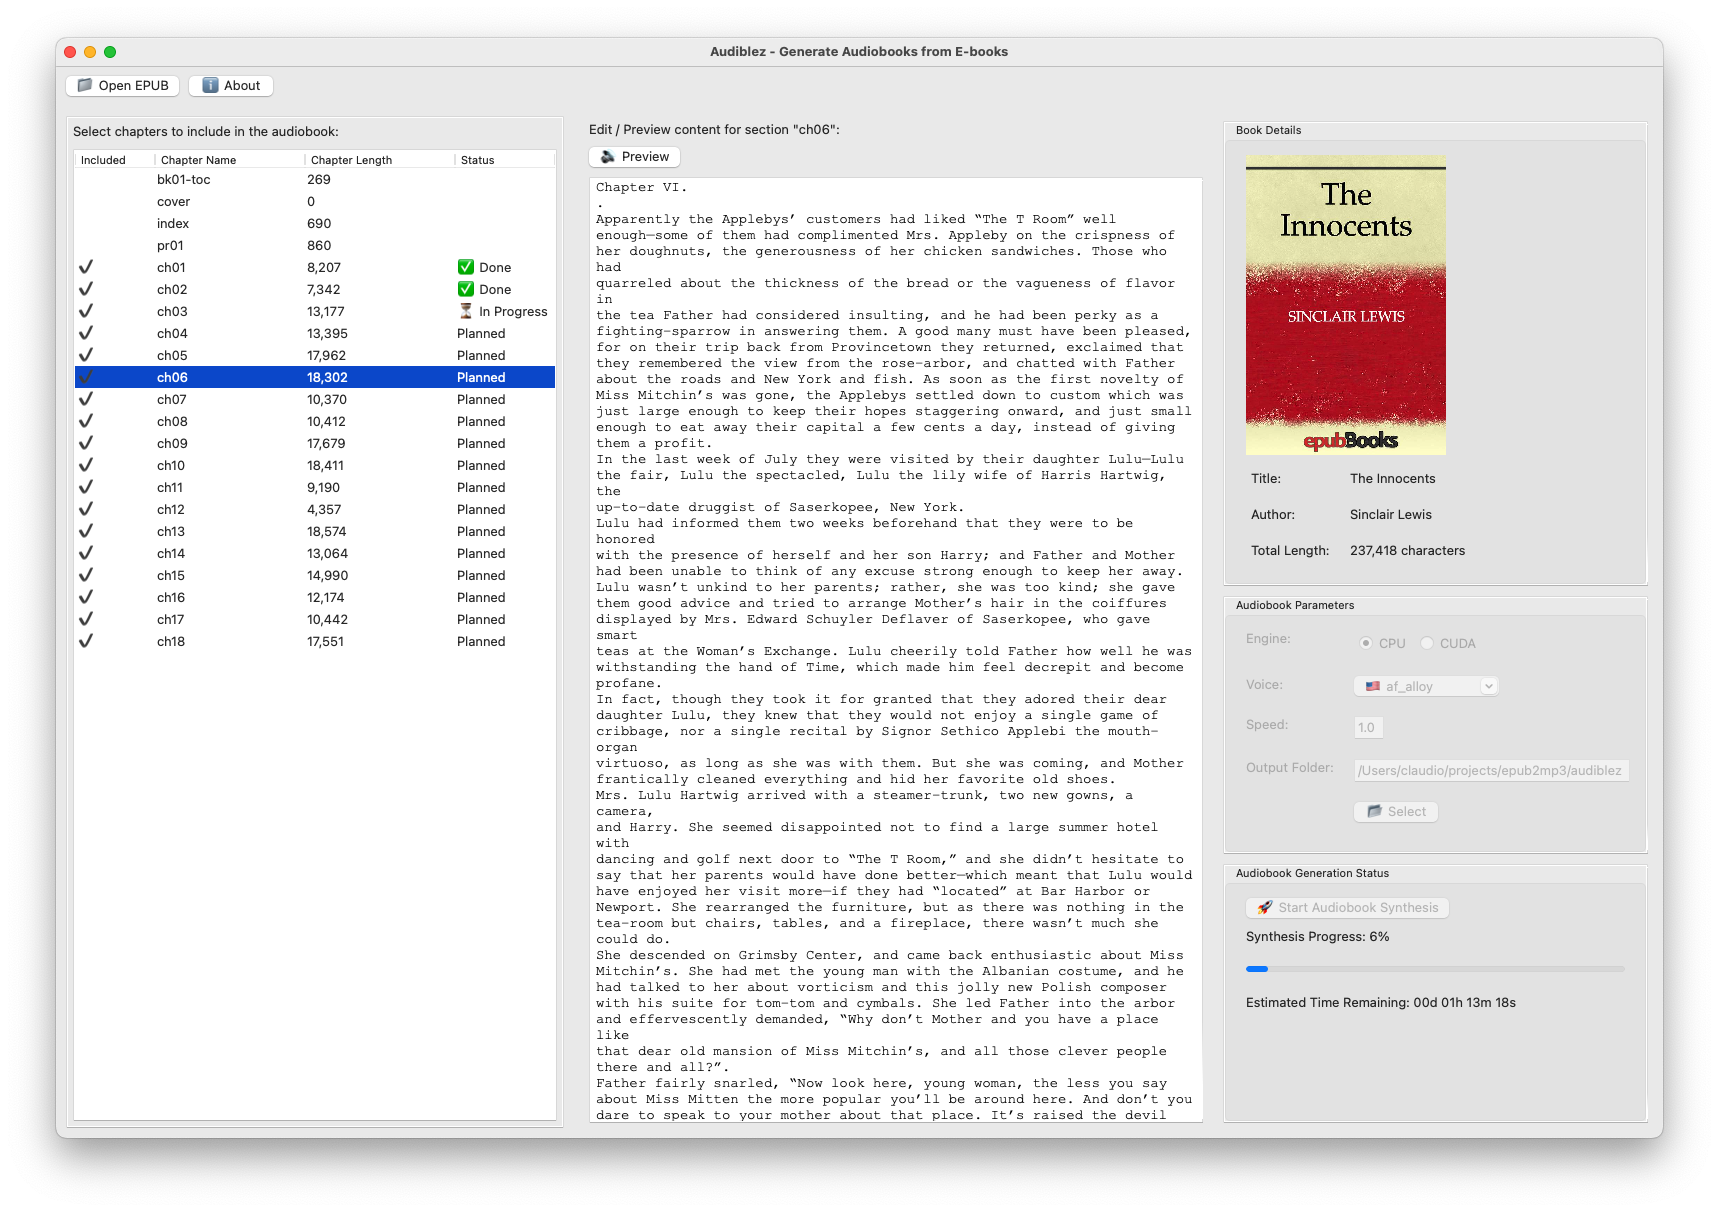
把 EPUB 电子书转成有声书的 Python 工具,基于 Kokoro 语音合成模型,适合想批量制作个人音频书的人。

用两小时从零训练一个 65M 参数的多模态视觉语言模型,代码和流程完整,适合低成本复现 VLM 训练与对话实验。
基于 VITS2 骨干网络和多语言 BERT 的语音合成模型,能生成自然度较高的多语种语音,适合做 TTS 训练与推理。
多音色、支持提示词控制情感与风格的语音合成引擎,输入文本即可生成带情绪表现力的自然语音,适合做有声内容和虚拟人配音。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
ERNIE 4.5 系列大模型与配套的工业级开发工具包 ERNIEKit,基于 PaddlePaddle,支持大语言模型和多模态模型的训练、微调与推理部署。
支持中英日韩法西六种语言的高质量语音合成库,适合需要多语种 TTS 能力的应用直接集成。
给 ChatTTS 套了个本地网页界面,输入文字就能合成语音,还能对外提供 API 接口,省去自己写前端和接口的功夫。
面向全模态模型的高效推理框架,支持图像、视频、音频生成与多模态模型服务,基于 PyTorch 提供统一的推理与部署能力。