多模态生成
共 290 个仓库 · Python
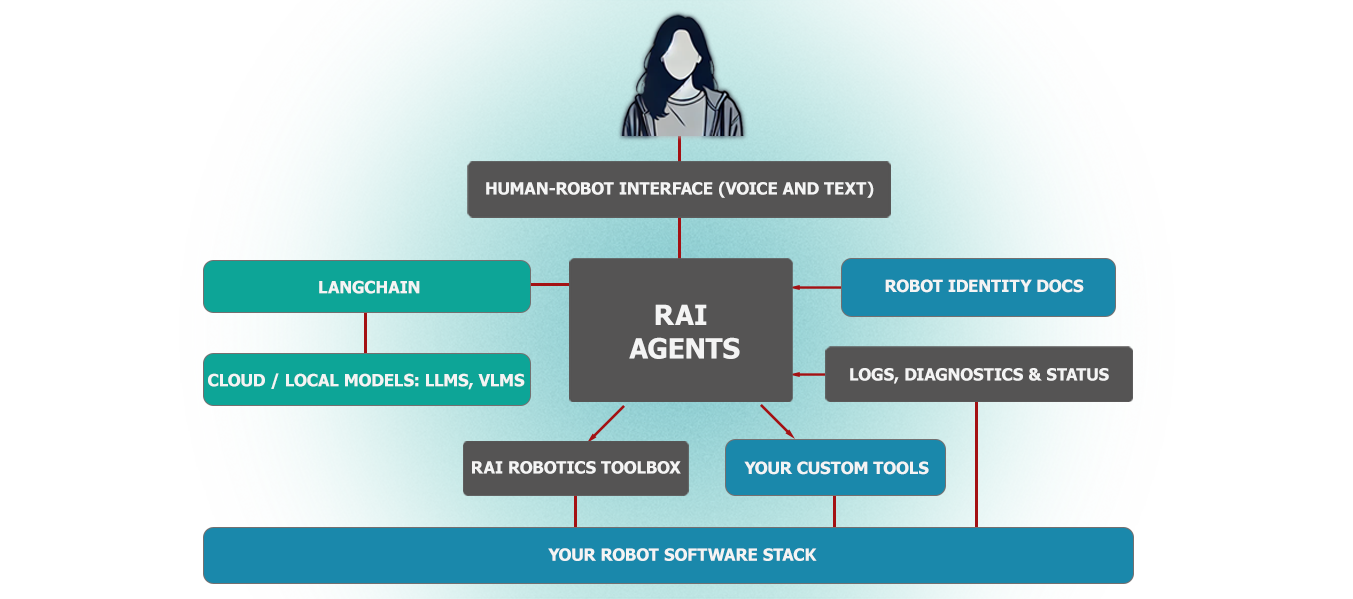
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
基于预训练模型的持续学习工具箱,集成多种增量学习与终身学习算法,方便在视觉和视觉语言模型上做可复现的持续学习实验。
用 VQAScore 给文生图、文生视频和文生 3D 模型打分的评测工具,基于视觉语言模型判断生成内容与文本提示是否匹配。
把角色的脸、身材、服装和声音打包进一个 .char 文件,让同一个角色在不同扩散模型和视频生成工具里保持一致,省去反复调参对齐的麻烦。
统一的多模态大模型,能高效理解图像、高分辨率图像和视频,用极少的视觉 token 完成多模态推理,适合显存和算力受限的场景。
面向视频场景的空间超级感知多模态大模型,专注提升视觉语言模型对视频中空间关系的理解与推理能力。
在 MiniMax H3 生成的视频里逐帧追踪并裁剪小尺寸人脸,用 H3 精修后再拼回原画面,解决远景人脸模糊、细节丢失的问题。
一站式微调视频生成模型的工具库,支持文本到视频等扩散模型,方便做内容创作和视觉艺术定制。
提供各行业专用的 Pydantic schema 集合,让视觉语言模型按统一结构输出 JSON,省去手写解析和字段对齐的麻烦。
给 Claude Code 和 Codex 用的 UI 设计与还原技能,能从截图生成设计稿,再把设计稿还原成可运行页面。
把影视生成的场景依赖建成 DAG,用关键路径法调度多模型并行出片,让原本逐个生成的镜头同时跑,缩短整片制作时间。
统一视觉分词器,把图像同时编码成适合生成和理解任务的离散 token,解决生成与理解模型各用一套 tokenizer 的割裂问题。
基于 WebGPU 的高斯泼溅渲染平台,可在浏览器里跑 3DGS/4DGS 和神经渲染,用来做三维场景与数字人展示。
把一句想法扩写成可直接投喂 Sora、可灵、Veo、Seedance 的电影级视频提示词,内置 21 种类型模板和五段式结构,省去反复调 prompt 的功夫。

在多种虚拟游戏世界中继续预训练视觉语言模型,打造能跨游戏泛化的具身智能体,并公开模型权重。
ComfyUI 的本地短剧与长视频生成插件,基于 MiniMax H3 工作流实现无限时长视频,支持文生视频和图生视频。
把视觉语言模型直接改造成机器人操作策略,无需改动架构就能训练出顶尖的视觉-语言-动作模型。
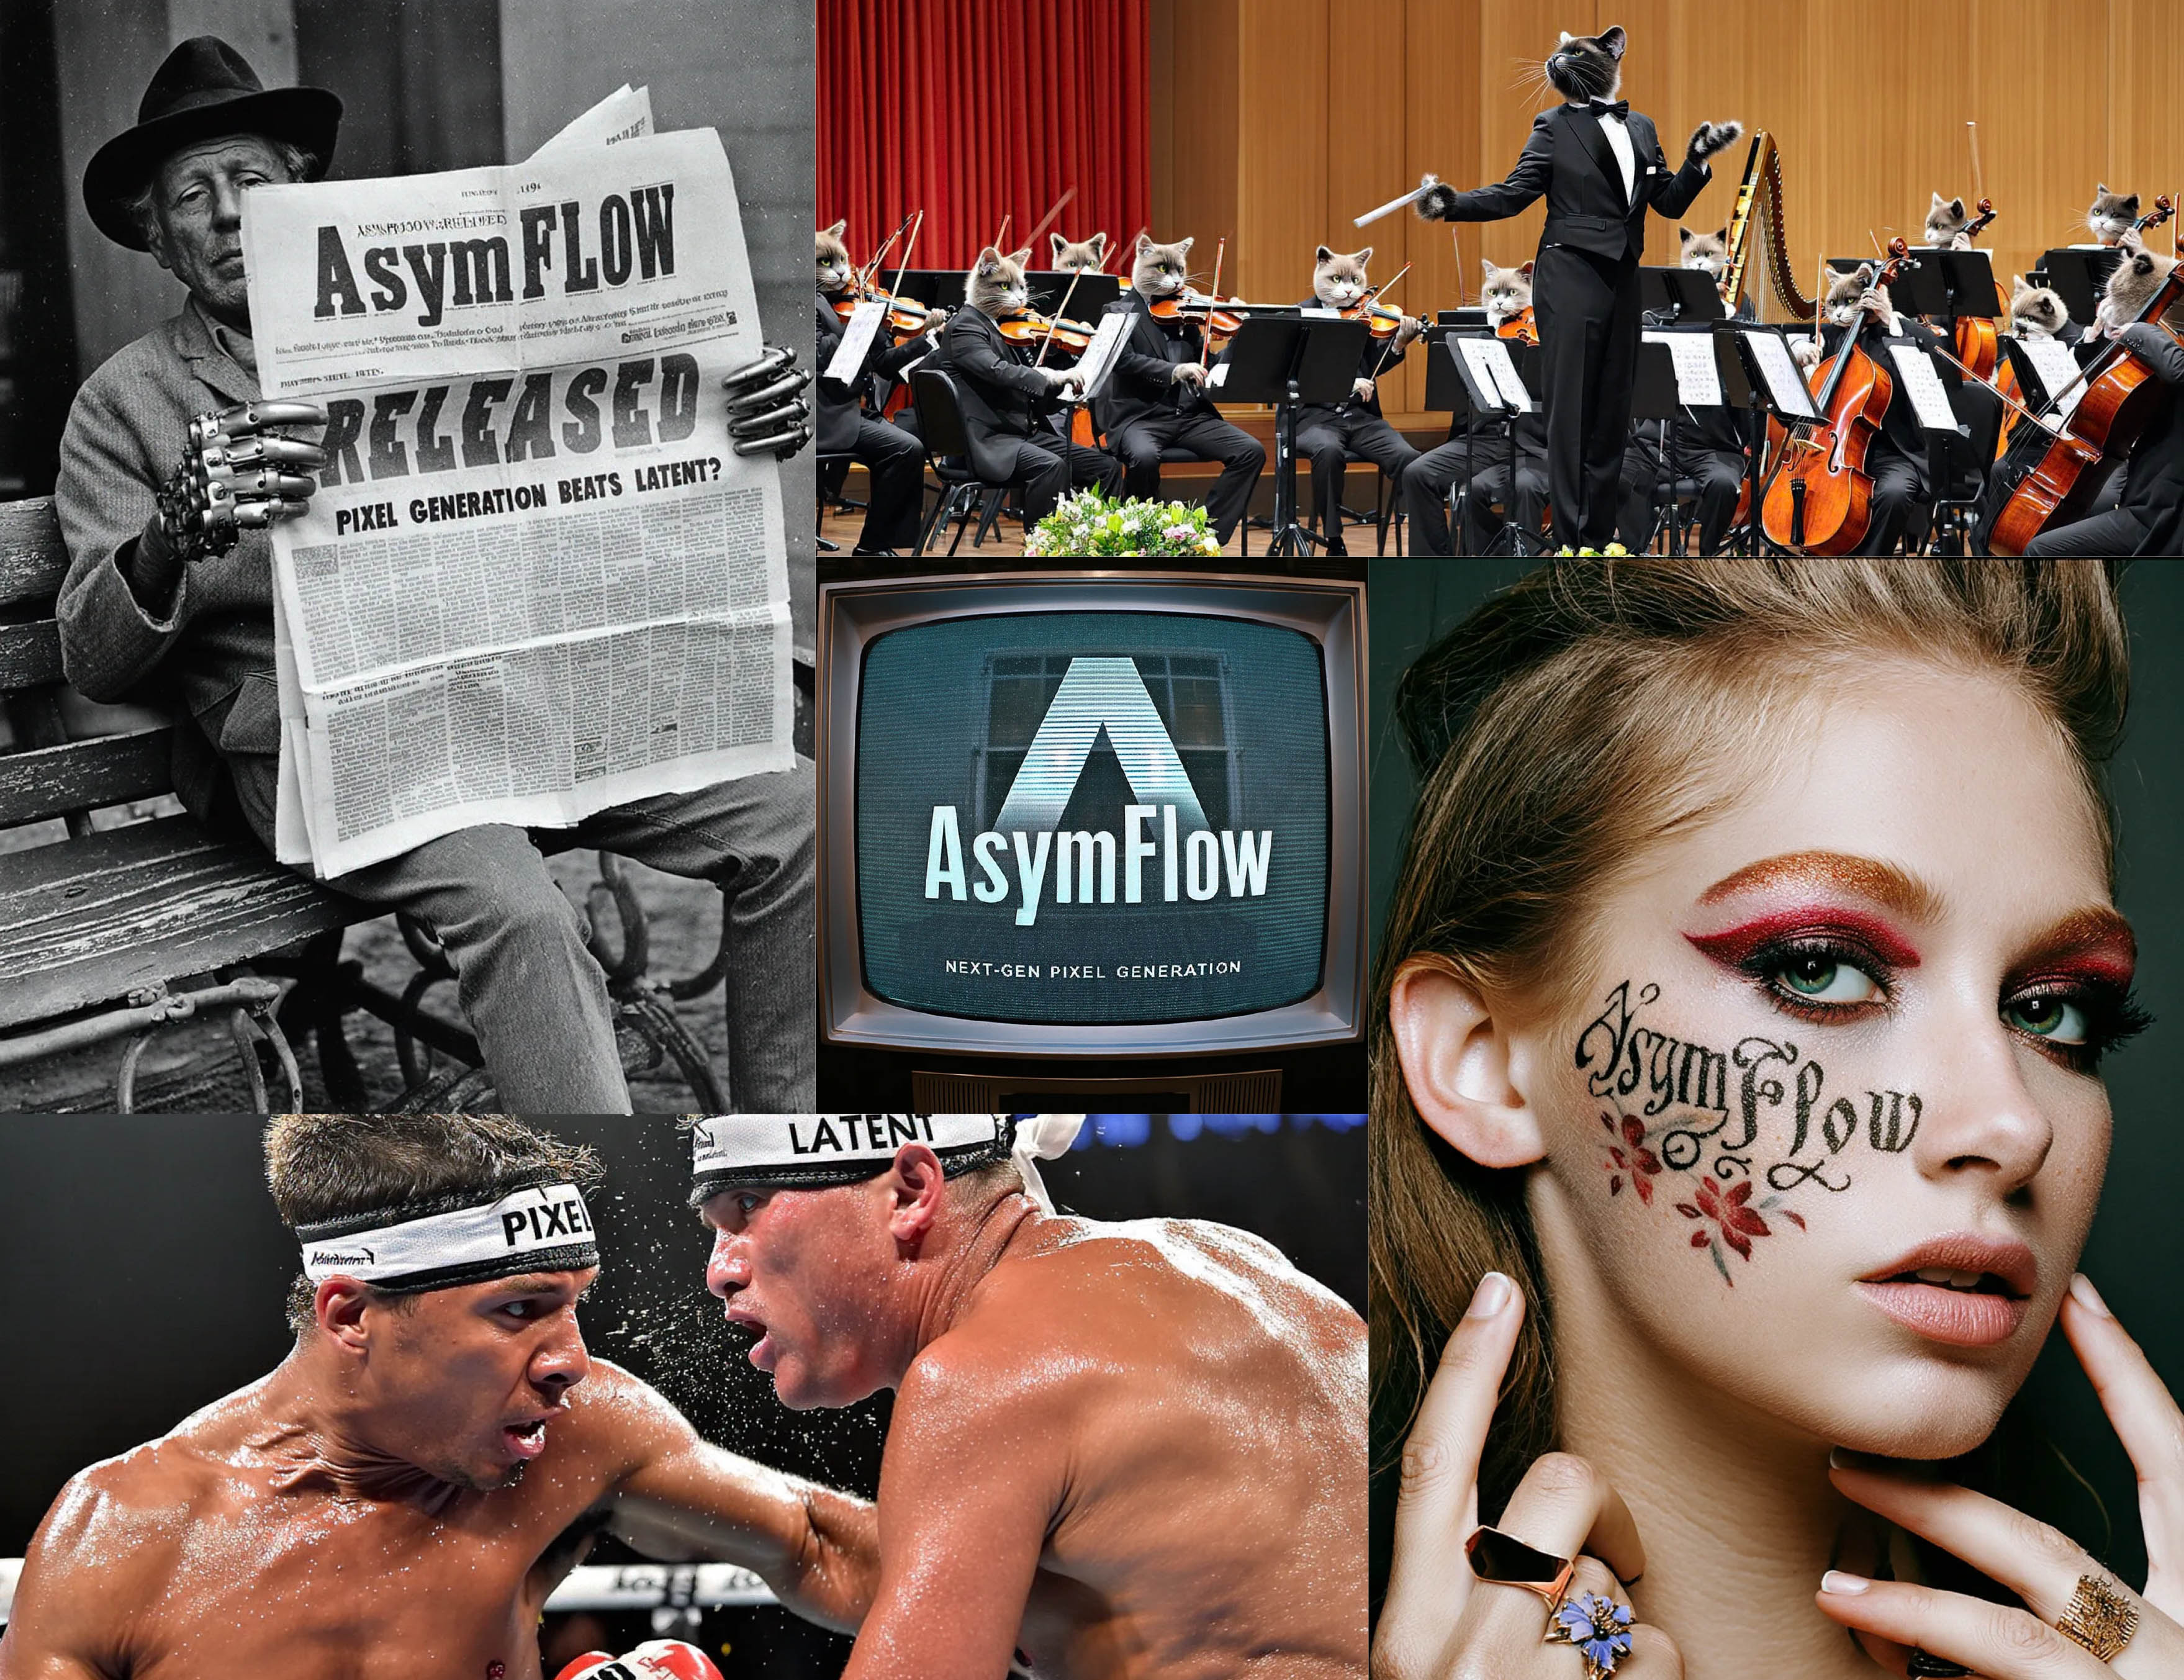
提供 AsymFlow、pi-Flow、GMFlow 等流匹配与扩散蒸馏算法的官方 PyTorch 实现,用于加速文本到图像生成模型的训练与推理。
无需微调即可把任意参考图的风格迁移到任意内容上,生成高质量个性化风格化图片的风格迁移模型。
汇总视觉语言模型空间智能方向论文与资源的 awesome 清单,配套综述《Spatial Intelligence in Vision-Language Models》,方便快速跟进空间推理研究进展。
仅靠视觉输入就能完成闭环自动驾驶的视觉-语言-动作模型,把语言理解和驾驶动作对齐,在 CARLA 里做端到端评测。
VisionZip 是 CVPR 2025 提出的视觉语言模型加速方案,通过压缩视觉 token 减少冗余计算,在保持多模态任务精度的同时显著提升推理效率。
用 OpenAI 的 CLIP 引导扩散模型,把文字描述直接生成图片,提供命令行工具和 Python 模块两种用法。
统一多模态模型,把图文理解、文生图和图像编辑整合进同一套框架,省去为不同任务分别部署模型的麻烦。