多模态生成

共 434 个仓库

打开分类页
ComfyUI_InfiniteYou
bytedance·Python

基于 FLUX 的身份保持图像生成 ComfyUI 原生节点,可在换脸、图像编辑时稳定保留人物面部特征。

身份保持+4图像生成
300532025-07-25 04:53 UTC
Phidias-Diffusion
3DTopia·Python

从文本、图像或 3D 条件生成 3D 内容的扩散模型,通过检索增强引入参考模型,提升生成质量与可控性。

3D生成+4图像生成
298162025-11-04 07:59 UTC
i1
zlab-princeton·Python

一套完全开源的强文本到图像扩散模型训练配方,提供 JAX 和 PyTorch 实现,方便复现和二次开发。
文本到图像+4图像生成
294192026-08-16 07:14 UTC
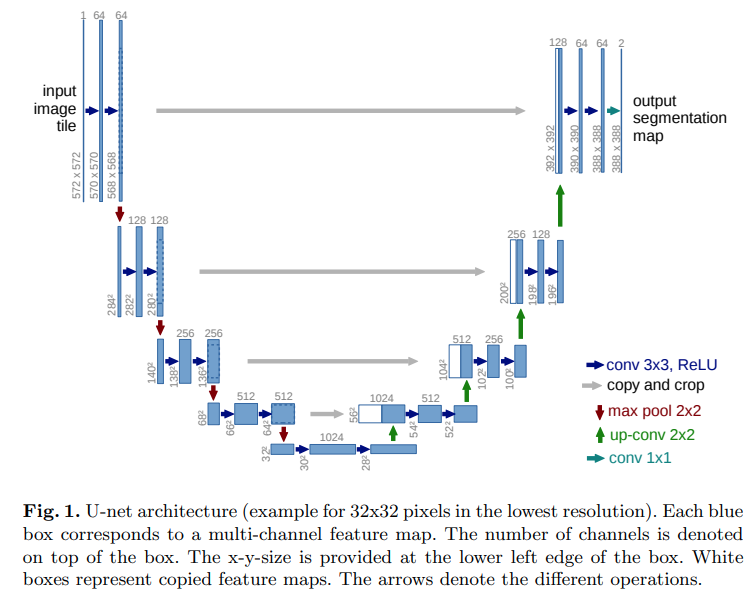
x-unet
lucidrains·Python

实现带高效注意力的 U-Net,并融合最新研究改进,适合图像生成和分割任务的训练与微调。

U-Net+4图像生成
294230.4.02026-09-23 02:12 UTC
Story2Board
DavidDinkevich·Python

无需训练就能把故事文本转成富有表现力的分镜图,基于扩散模型直接生成,省去微调成本。
分镜生成+4图像生成
293492025-08-22 03:35 UTC
SparseVLMs
Gumpest·Python

SparseVLM 是 ICML'25 与 TPAMI'26 论文的官方实现,通过稀疏化视觉 token 来降低视觉语言模型的计算开销,提升多模态推理效率。

视觉语言模型+4视觉语言模型
28922v2.02026-07-30 11:23 UTC
OmTrackVLA
om-ai-lab·Python

面向视觉-语言-动作模型(VLA)的可复现开源研究项目,聚焦目标跟踪类 VLA,提供训练与评测代码,方便复现和对比实验结果。

视觉语言动作模型+4具身智能 / VLA
289162026-07-21 05:58 UTC
VisualCloze
lzyhha·Python

一个通用图像生成框架,用上下文学习统一处理多种域内任务,并能泛化到未见过的任务,已合入 diffusers 官方流水线。

图像生成+4图像生成
284142026-01-07 01:02 UTC
Spatial-TTT
THU-SI·Python

面向流式视频场景的空间智能框架,用测试时训练让多模态大模型持续理解三维空间关系,解决长视频中空间推理能力退化的问题。
空间智能+4视觉语言模型
282102026-06-19 13:13 UTC
Thinking-with-Visual-Primitives
ailuntx·Makefile

面向视觉语言模型的空间推理与视觉定位研究代码快照,探索用视觉基元辅助多模态模型理解空间关系。

视觉语言模型+4视觉语言模型
279642026-06-17 08:22 UTC
openjourney
ammaarreshi·TypeScript

复刻 MidJourney 网页交互体验的开源界面,接入 Google Gemini SDK,用 Imagen 4 生成图片、Veo 2/3 生成带音频的视频。

图像生成+4图像生成
272712025-07-21 20:17 UTC
lighthouse
line·Python

面向视频/音频片段检索与高光检测的可复现 Python 库,统一多模态流程,方便研究者快速复现和对比实验结果。

视频片段检索+4视觉语言模型
27222v1.22026-11-01 13:05 UTC
VLM-RL
zihaosheng·Python

把视觉语言模型和强化学习整合到同一个框架里,用于自动驾驶策略训练,并在 CARLA 仿真中验证安全性。

视觉语言模型+4视觉语言模型
271312026-02-01 03:26 UTC
RoboRefer
Zhoues·Python

RoboRefer 是面向机器人场景的空间指代推理视觉语言模型官方实现,让机器人能理解「把左边那个杯子递给我」这类带空间关系的指令。

空间指代+4ROS / 机器人框架
270112025-12-16 08:22 UTC
html-anime
blixvip·JavaScript

把场景提示词拆成分镜表,再让编码智能体用 HTML/CSS 动画把影片画出来,不依赖视频生成模型。

HTML动画+4视频生成
263612026-11-07 22:52 UTC
seedance-2.0-api
apiframe-ai

字节 Seedance 2.0 视频生成 API 的调用示例,覆盖文生视频和图生视频两种模式,方便开发者快速接入。

视频生成+4视频生成
25912026-08-14 22:11 UTC
flow-agent
kodelyx·JavaScript

封装 Google Flow 的 CLI 工具,用命令行批量生成 Nano Banana Pro 图片和 Omni Flash 视频,并支持 MCP v2 与 OpenAI API 接入。

命令行工具+4图像生成
25781v1.0.02026-09-25 05:35 UTC
Silo
KwokKwok·JavaScript

纯前端的多模型并行对话与文生图工具,填上 API Key 就能同时对比 ChatGPT、Claude 等模型的回答并生成图片,无需自建服务端。
多模型对话+4图像生成
25629v1.8.172026-05-31 03:29 UTC
Crayotter
idwts·Python

基于多模态大模型的视频剪辑智能体,能把文字需求直接变成成片,自动完成剪辑、合成与全流程视频生产。

视频剪辑+4视频生成
252+112v1.1.02026-10-31 08:35 UTC
ComfyUI-Upscaler-Tensorrt
yuvraj108c·Python

用 TensorRT 加速 ComfyUI 的图片放大节点,把 ESRGAN、Real-ESRGAN 等放大模型跑出 2~4 倍速度,适合出图后处理提速。

图像放大+4图像生成
252462026-06-07 09:49 UTC
texel-studio
EYamanS·Python

用工具调用方式逐笔绘制像素画的 AI 智能体,靠形状、噪点和逐像素控制作画,而非扩散模型生成,适合做游戏素材。

像素画生成+4图像生成
251+1462026-10-12 18:04 UTC
FreeFuse
yaoliliu·Python

多主体 LoRA 融合方法,在测试时通过自适应 token 级路由把多个 LoRA 组合起来,让扩散模型一次生成多个指定主体。

LoRA 融合+4图像生成
250+1232026-11-06 05:53 UTC
FM-AD-Survey
TUM-AVS·Python

汇总自动驾驶场景生成与分析方向的基础模型论文,涵盖扩散模型、大语言模型和多模态模型,持续更新最新研究进展。
自动驾驶+4自动驾驶
248192026-10-06 14:51 UTC
Medical_Image_Analysis
Event-AHU·Python

基于基础模型的医学图像分析代码库,涵盖MAE预训练、Mamba状态空间模型、视觉语言模型与医学报告生成,为医学影像研究提供可复用的模型实现。

医学图像分析+4视觉语言模型
243182026-09-22 14:57 UTC