视觉与 3D
共 256 个仓库 · Python
一套统一的视觉 SLAM 评测框架,把主流 VSLAM 系统和公开数据集整合到同一套流程里,省去逐个配置环境、跑对比实验的麻烦。
从多视角立体视觉出发,前馈式快速重建可泛化的高斯泼溅表示,无需逐场景优化即可合成新视角。
统一模型,从单目视频中同时重建动态人体与三维场景,输出带时间维度的4D结果,可用于人体姿态估计与场景理解。
用深度学习和传统手工特征做多视图图像匹配,为 COLMAP 等 SfM 软件提供高质量匹配结果,支持高分辨率图像和带旋转的图像,提供命令行和图形界面。
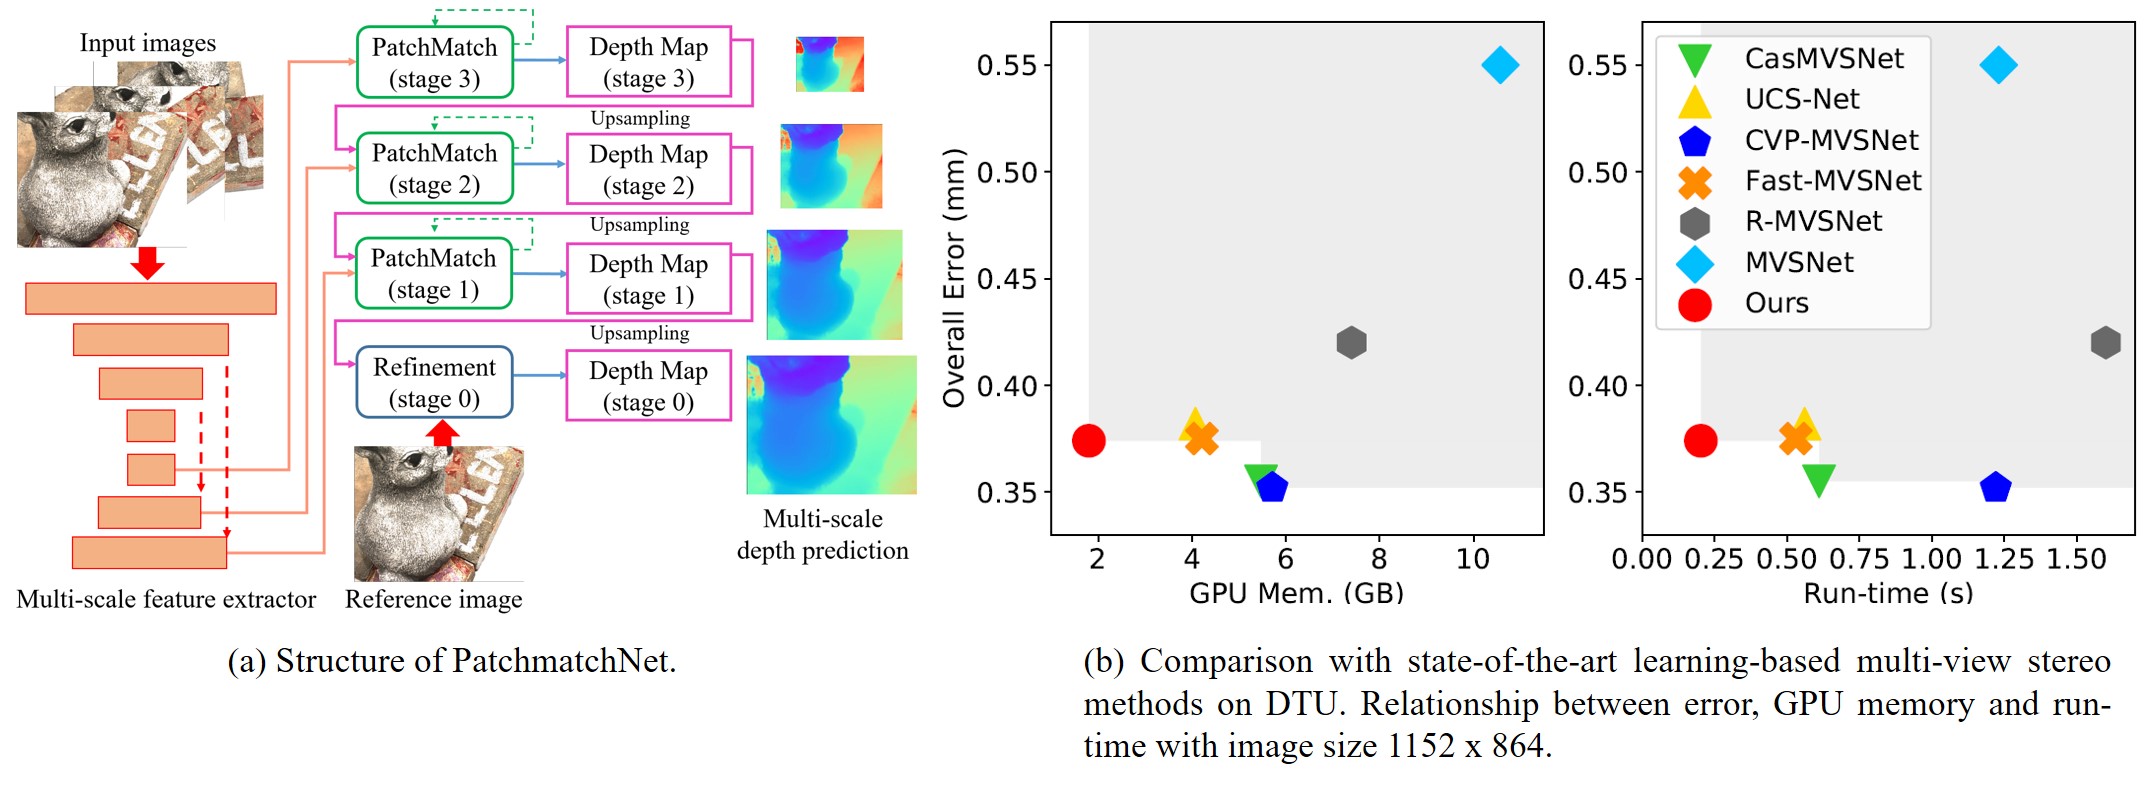
PatchmatchNet 是 CVPR 2021 Oral 的官方实现,用可学习的 Patchmatch 做多视图立体匹配,从多张图片重建稠密三维点云。
从单张图片生成多视角一致图像,进而重建完整三维场景,解决单视图场景重建中视角覆盖不足的问题。
面向大规模场景的可扩展测试时训练 3D 重建方案,通过在线自适应提升深度估计与重建精度,适合处理超长序列和大范围场景。
开箱即用的 LiDAR SLAM 系统,用 Python 实现,能直接完成激光雷达建图与定位,省去繁琐配置。
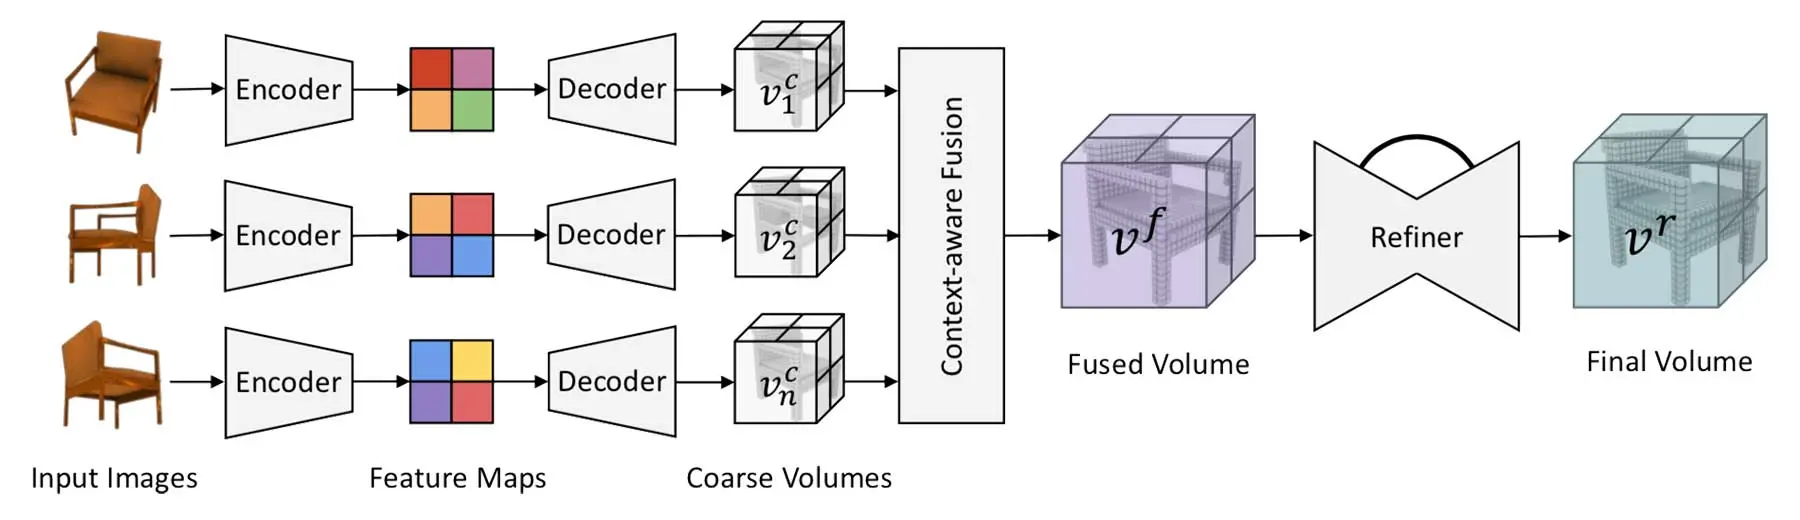
从单张或多视角图片重建三维体素模型的官方实现,基于 ICCV 2019 论文,用上下文感知融合提升重建精度。
开放词表目标计数模型,基于视觉语言基础模型,能按任意文本描述统计图像中物体数量,无需针对新类别重新训练。
MILo 是 SIGGRAPH Asia 2025 的官方实现,把网格优化嵌进 3D 高斯泼溅流程,从多视角图像重建出细节丰富又轻量的表面网格。
基于曼哈顿世界假设的神经隐式三维重建方法,利用场景中互相垂直的平面结构约束,从多视角图像重建室内房间的稠密几何。

ARCTIC 数据集官方工具链,提供下载、预处理、可视化和模型训练脚本,用于手物交互与手部追踪研究。
用稀疏视角图像在几秒内重建大规模三维场景,把体素与高斯泼溅结合成 VoxSplats 表示,适合快速生成可渲染的城市场景。
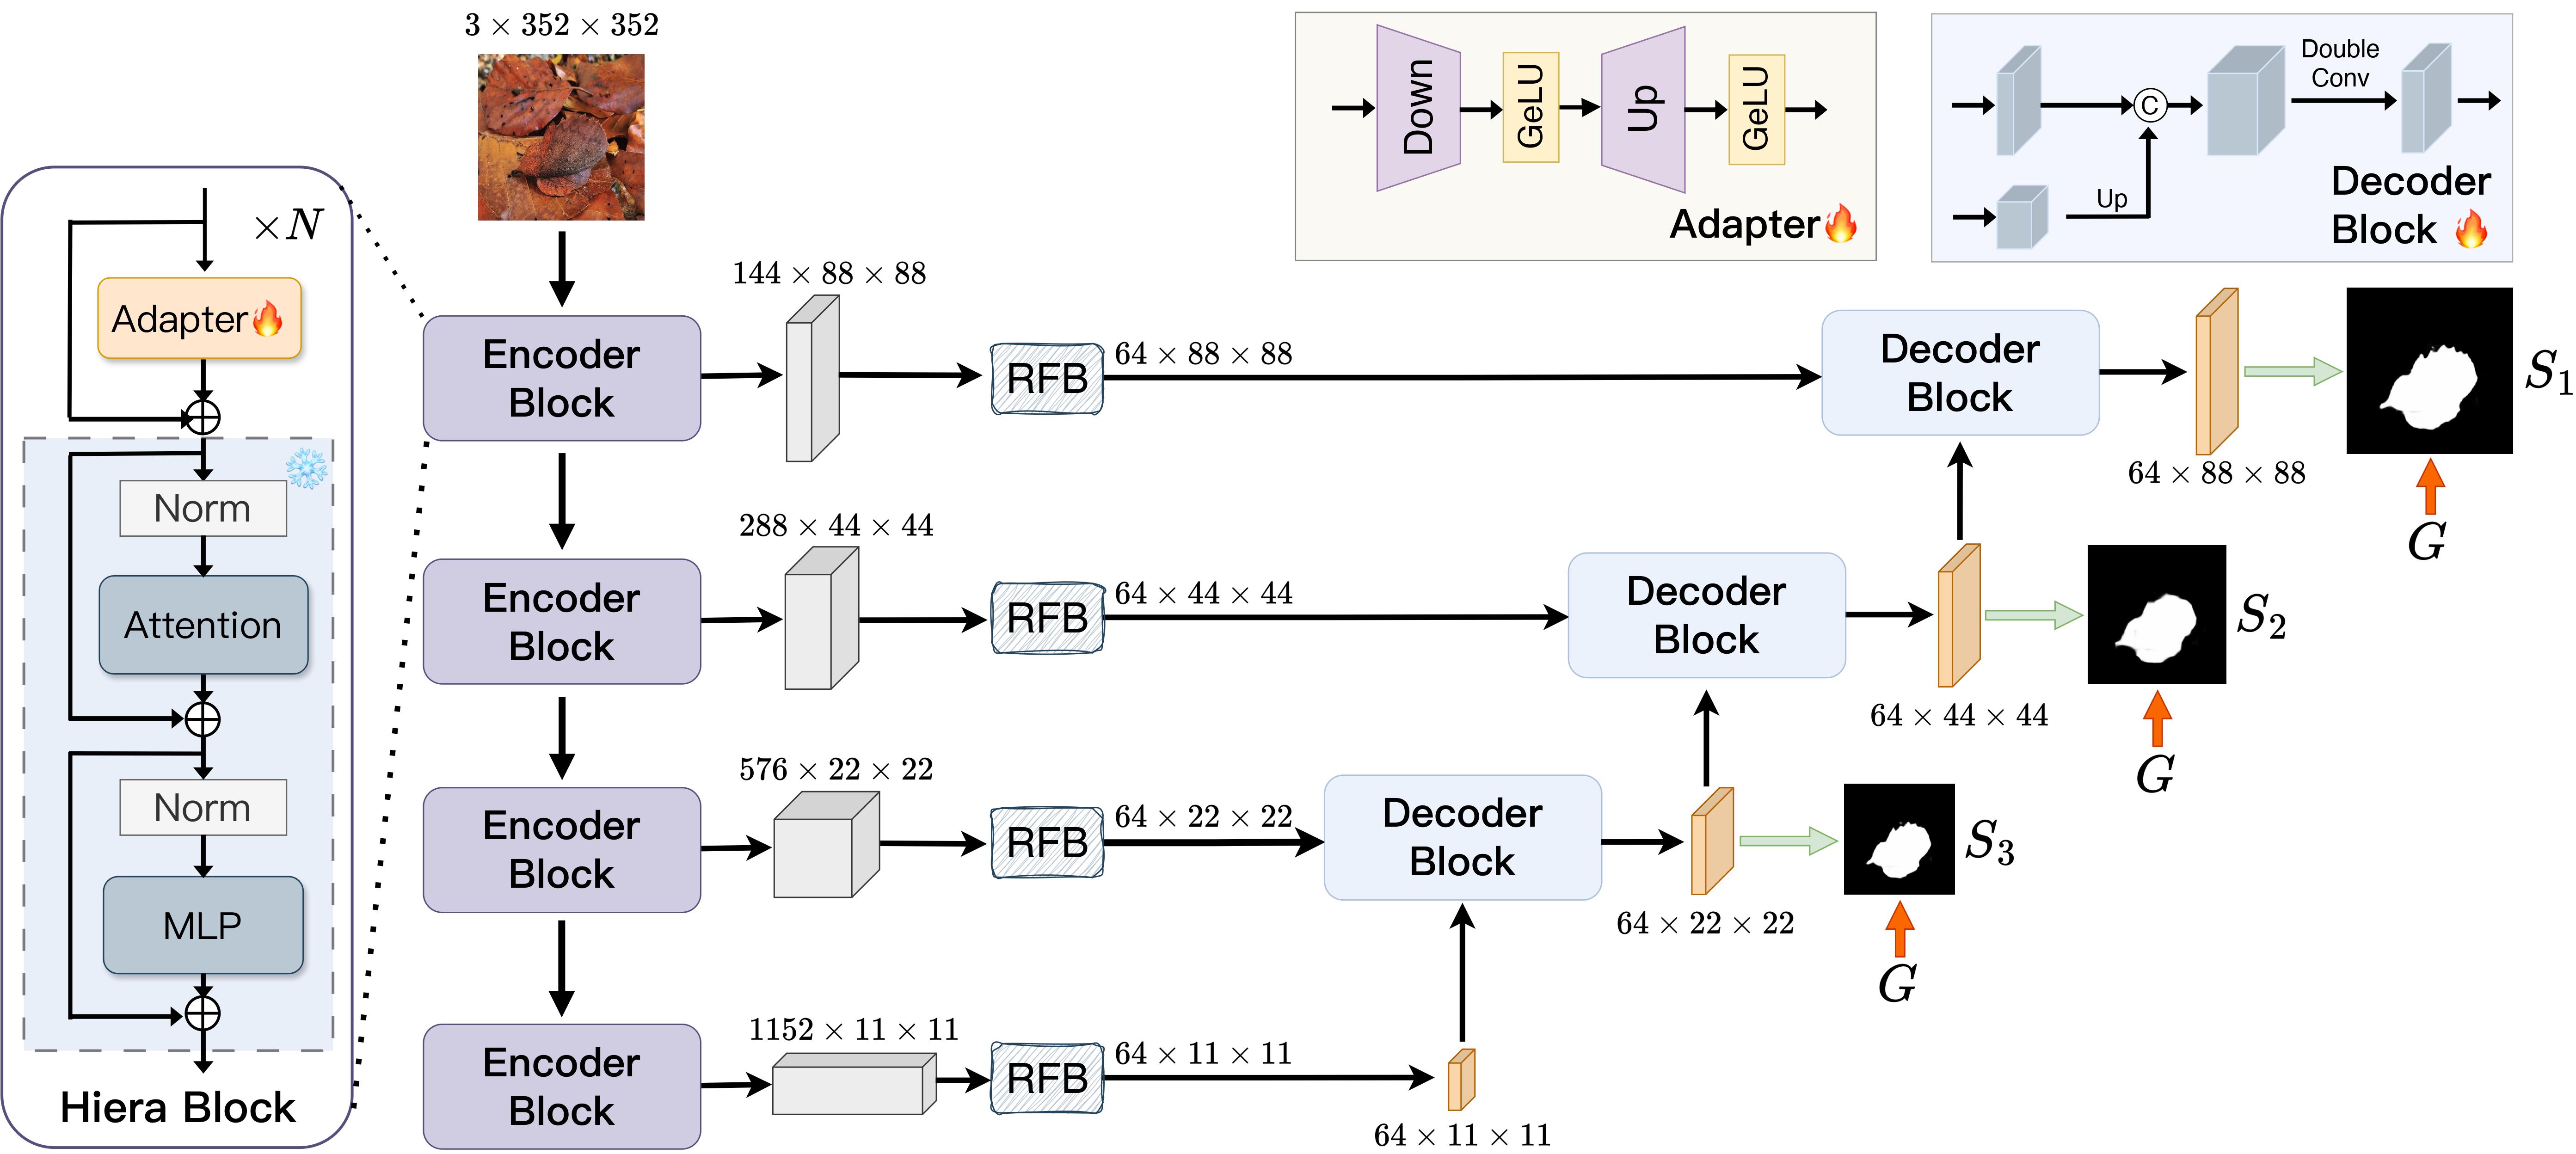
把 Segment Anything 2 当作强编码器接上 U-Net 解码器,做自然图像和医学图像分割,覆盖伪装目标、息肉、海洋动物等场景。
CVPR 2022 发布的大规模 3D 头部对齐数据集,提供密集、准确、多样的标注,用于从单张图像重建 3D 人脸和头部。
基于 SAM2 的视觉目标跟踪记忆模块,通过抑制干扰物来提升跟踪稳定性,适用于复杂场景下的单目标跟踪。
仅用一段 MP4 监控录像和对应的谷歌地图位置,就能重建出数字孪生风格的三维交通场景,把画面里的车辆投影到真实地理坐标上。

从单目视频里同时重建关节手和物体的三维姿态与形状,无需预扫描物体模板或手物交互训练数据,适合做手物交互建模与AR/VR研究。
FaceLit 是 CVPR 2023 的官方实现,用 GAN 和 NeRF 生成可重打光的三维人脸,让生成的人脸能按任意光照条件渲染。

基于 PyQt5 的图形界面工具,用 YOLO 系列模型做目标检测、跟踪、实例分割和人体姿态估计,支持图片、视频和摄像头输入。
面向嵌入式设备的开源 AI 模型训练与部署工具,支持在 ESP32、Jetson、树莓派等硬件上完成图像分类、目标检测等任务的训练与推理。
跨平台计算机视觉标注工具,集成 Grounding DINO 与 SAM 实现自动预标注,支持目标检测和旋转框标注,大幅减少手工画框工作量。
基于 OpenPifPaf 人体姿态估计模型做跌倒检测,结合目标跟踪分析视频中的人体关键点,判断是否发生摔倒,可在 CPU 或 GPU 上运行。