视觉与 3D
共 464 个仓库
端到端 SLAM 系统,把相机标定、单目先验和 3D 高斯泼溅稠密渲染串成一条流水线,让单目视觉同时完成跟踪与高质量三维重建。
面向 ROS 1/2 的实时 3D 激光雷达障碍物检测工具,集地面分割、聚类、跟踪与轨迹预测于一体,单核 CPU 约 10ms 处理一帧,可选 TensorRT 加速的 CenterPoint。
SLAM 课程配套的代码练习集,用 C++ 和 Python 实现视觉定位与建图的核心算法,适合边学理论边动手跑通完整流程。
无需训练即可从视频中恢复人体网格模型,结合 SAM-3、Diffusion-VAS 和 SAM-3D-Body 实现 4D 人体重建,适合快速做视频人体建模。

HUGS 用高斯泼溅从单目视频重建可动画的人体三维模型,能同时还原人体和场景,方便做数字人渲染。
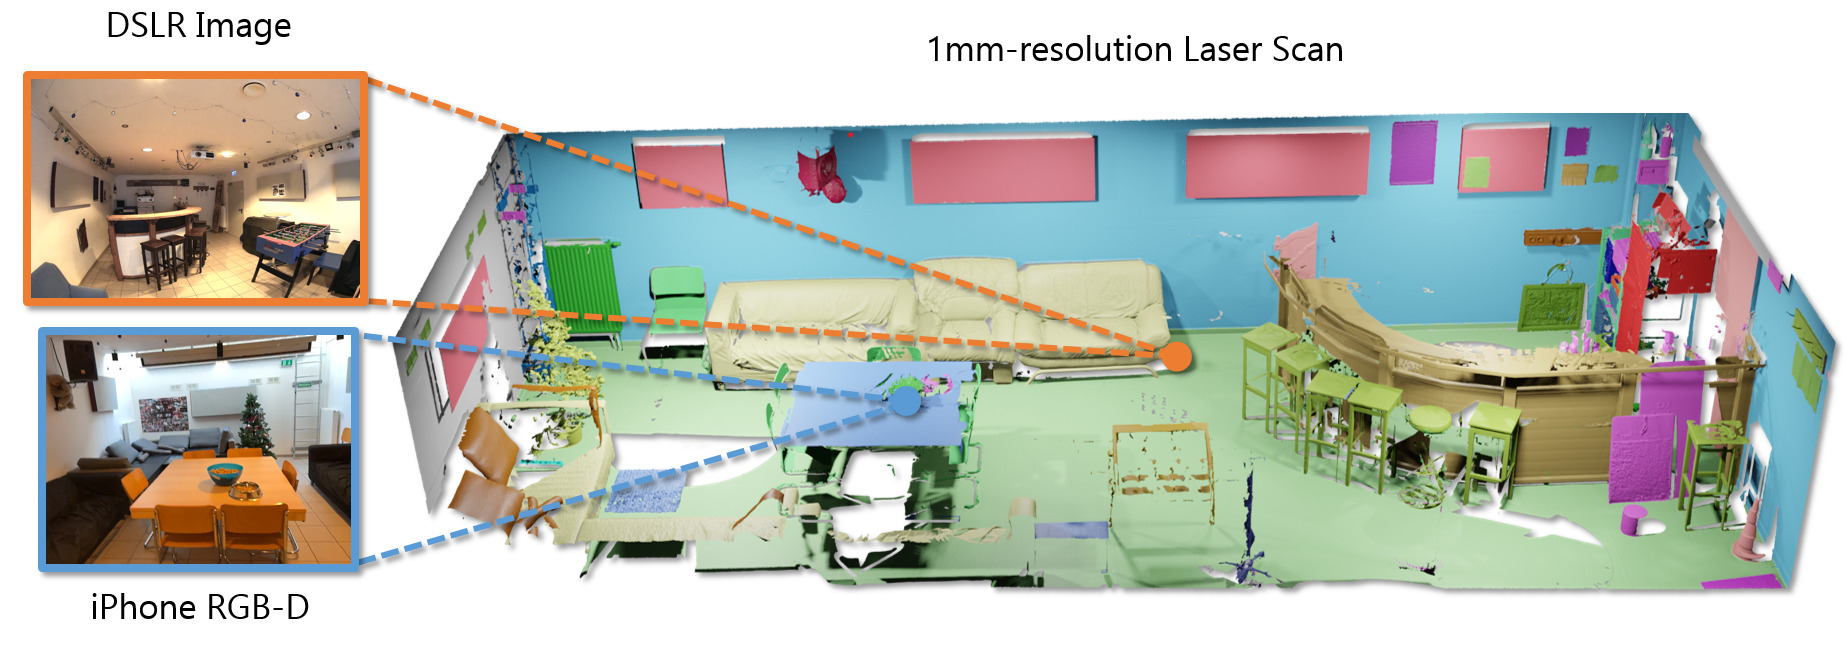
ScanNet++ 是一个高保真 3D 室内场景数据集,提供配套工具,支撑三维重建、语义与实例分割、新视角合成等研究。
面向动态足式机器人的多传感器里程计,融合腿部运动学、IMU 与激光雷达,在剧烈运动和高动态场景下提供稳健的定位与建图。
封装 MeshFix 的 Python 库,能自动修补三角网格表面的孔洞和缺陷,适合 3D 重建后处理。

压缩 3D 高斯泼溅模型,减少存储占用并加速新视角合成渲染,适合在资源受限设备上部署 3DGS 场景。
从图像生成带物理属性的三维资产,让模型产出的 3D 物体不仅外形逼真,还具备质量、材质等可供仿真使用的物理参数。
汇总 Transformer 在视觉目标跟踪任务中的论文清单,覆盖 CVPR、ECCV、ICCV、NeurIPS 等顶会工作,方便快速跟进该方向的研究进展。
把 SAM 的分割能力扩展到任意分割任务的多模态大模型,支持文本指令驱动的通用图像分割。
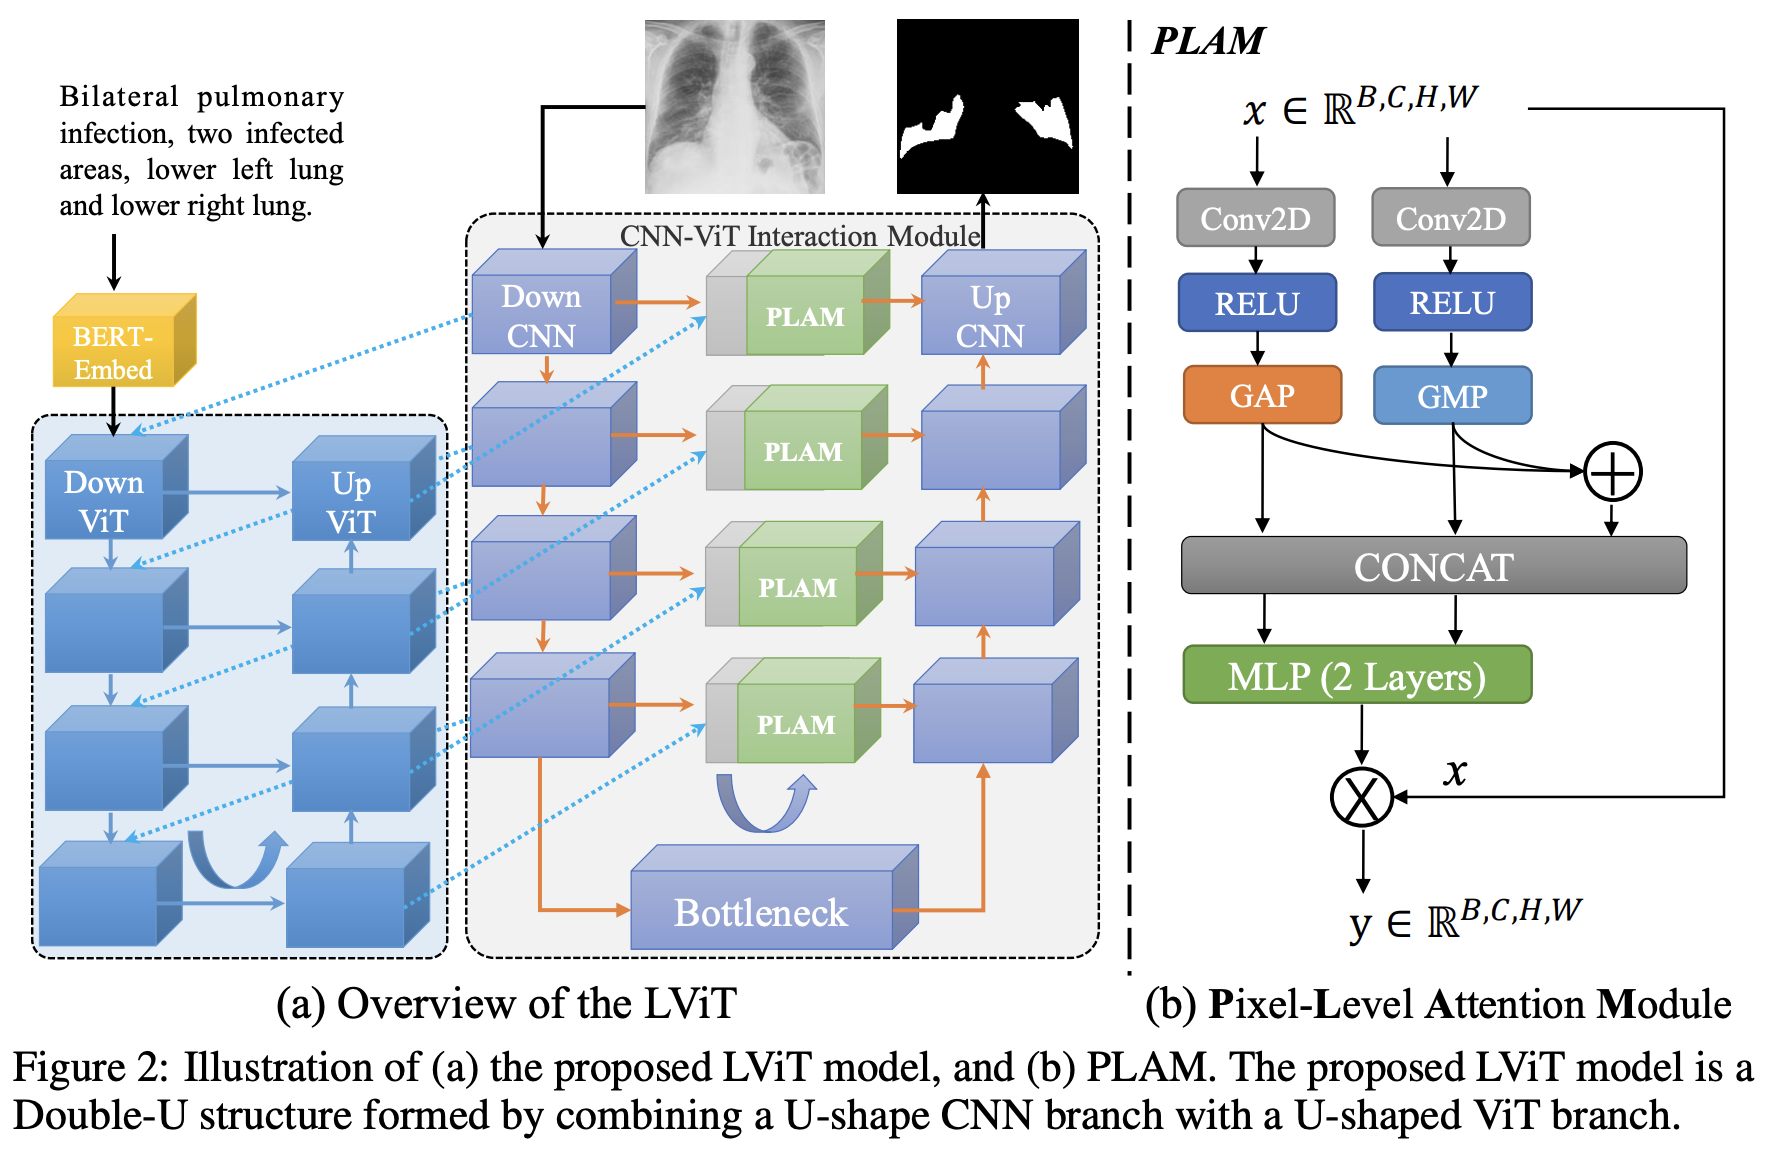
LViT 把文本描述引入视觉 Transformer,做医学图像分割,用语言信息弥补标注数据不足,提升分割精度。
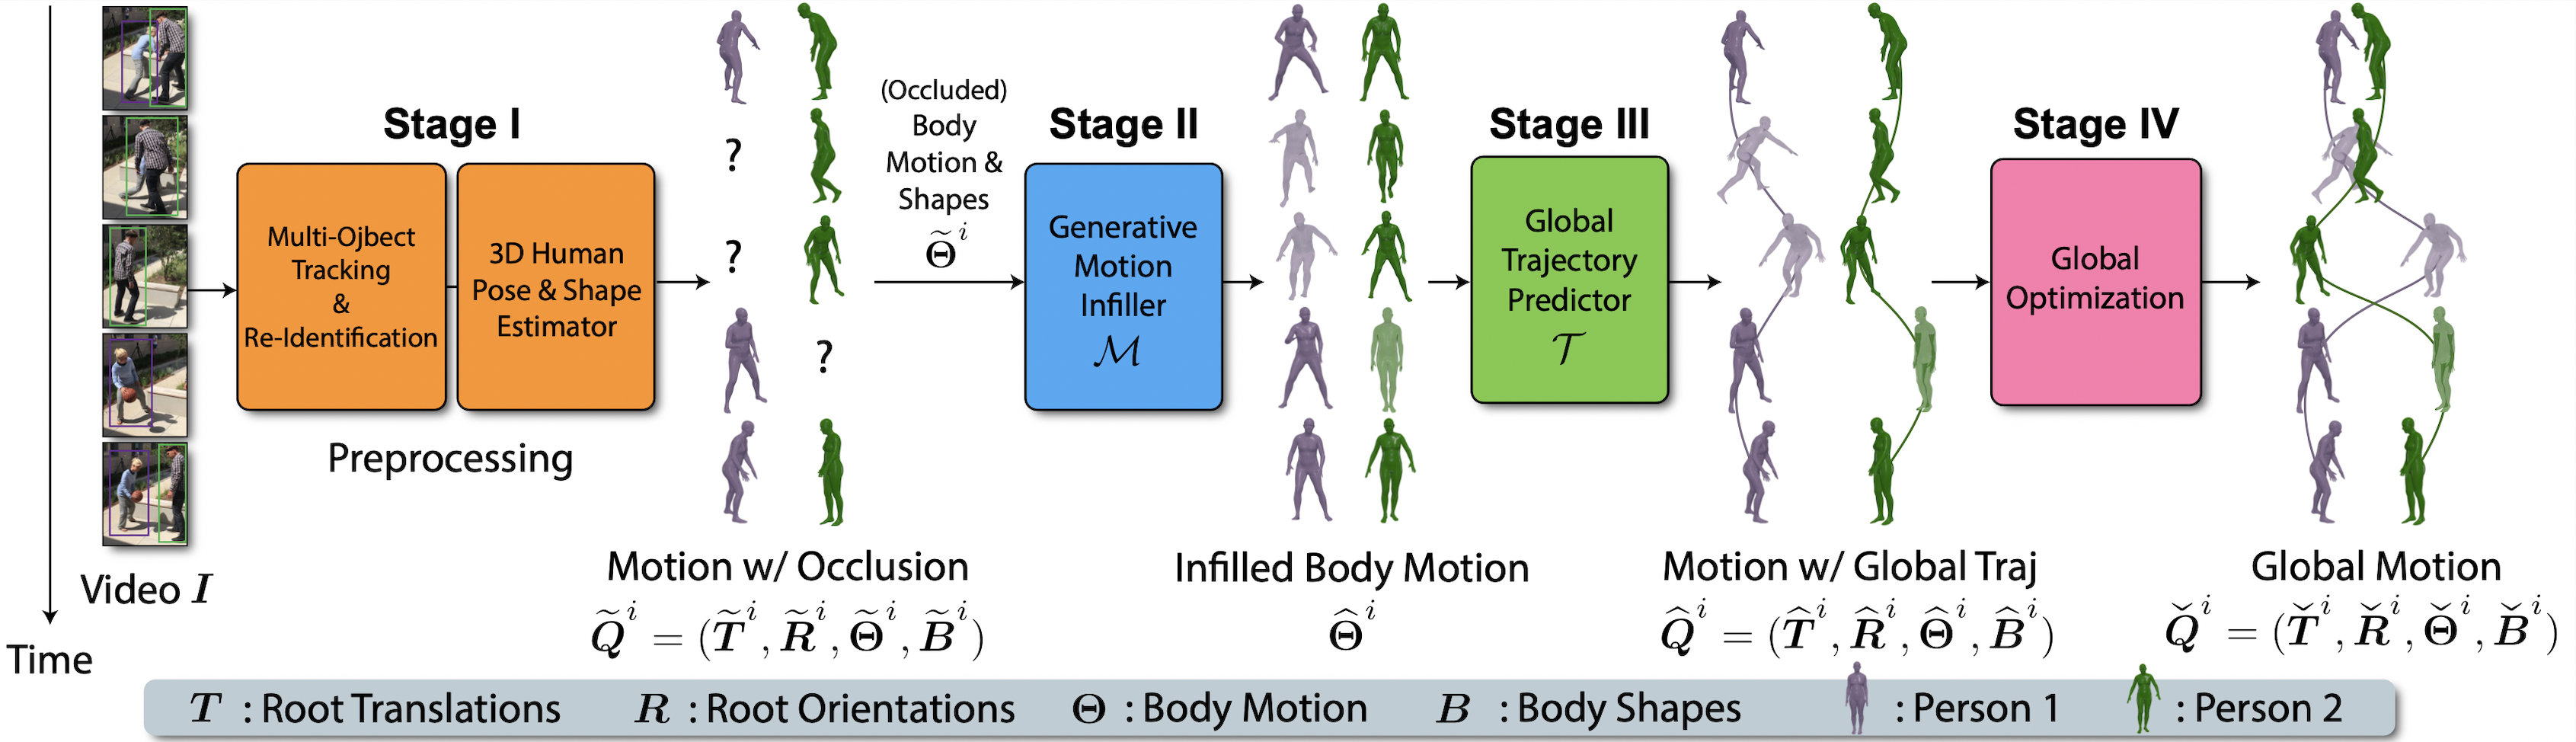
从动态相机拍摄的视频中恢复人体网格,能处理遮挡和全局轨迹,适合做人体动作捕捉与三维重建研究。
给 GTSAM 补上点云 SLAM 所需的因子和优化器,涵盖配准、建图、定位与连续时间轨迹估计,支持 CUDA 加速。
从多视角图像生成三维网格模型,通过形变网络逐步细化网格顶点,解决单视图重建细节不足的问题。
给四足和人形机器人用的模块化开源大脑,带 Web 界面做遥操作、自主导航、建图和监控,配套可 3D 打印硬件,跑在 ROS2 上。

用 SfM 引导的单目深度估计做多视角三维重建,把稀疏重建的相机位姿和单目深度先验结合起来,提升复杂场景下的重建精度。
面向户外机器人的 ROS 2 定位模块,用 23 状态 UKF 以 100 Hz 融合 IMU、轮速计和 GPS;定位出错时能指出是哪个传感器、为什么出错,而不是悄悄漂移。

基于 3D 高斯泼溅的高动态范围新视角合成方法,用高斯表示重建 HDR 场景,比 NeRF 类方案快约 1000 倍。
用 ArUco 标记做视觉 SLAM 的 C++ 实现,通过扩展卡尔曼滤波融合观测来估计相机位姿和路标位置,适合移动机器人定位与导航。
用单张图片自监督重建三维场景,基于神经辐射场实现新视角合成与深度估计,无需三维标注数据。

OmniVGGT 是 CVPR 2026 提出的多模态视觉几何 Transformer,把图像、深度、点云等不同模态统一进一个空间基础模型,用来做 3D 重建和几何理解。
用生成模型合成带标注的肝脏肿瘤 CT 图像,无需人工标注即可训练分割模型,缓解医学影像标注成本高的问题。