探索全部
共 1,390 个仓库 · 近 4 个月有推送 · Python
自动刷新的游戏反编译与重编译资源清单,收录反编译、静态重编译、源码移植和引擎重制项目,方便查找可玩的逆向工程游戏版本。
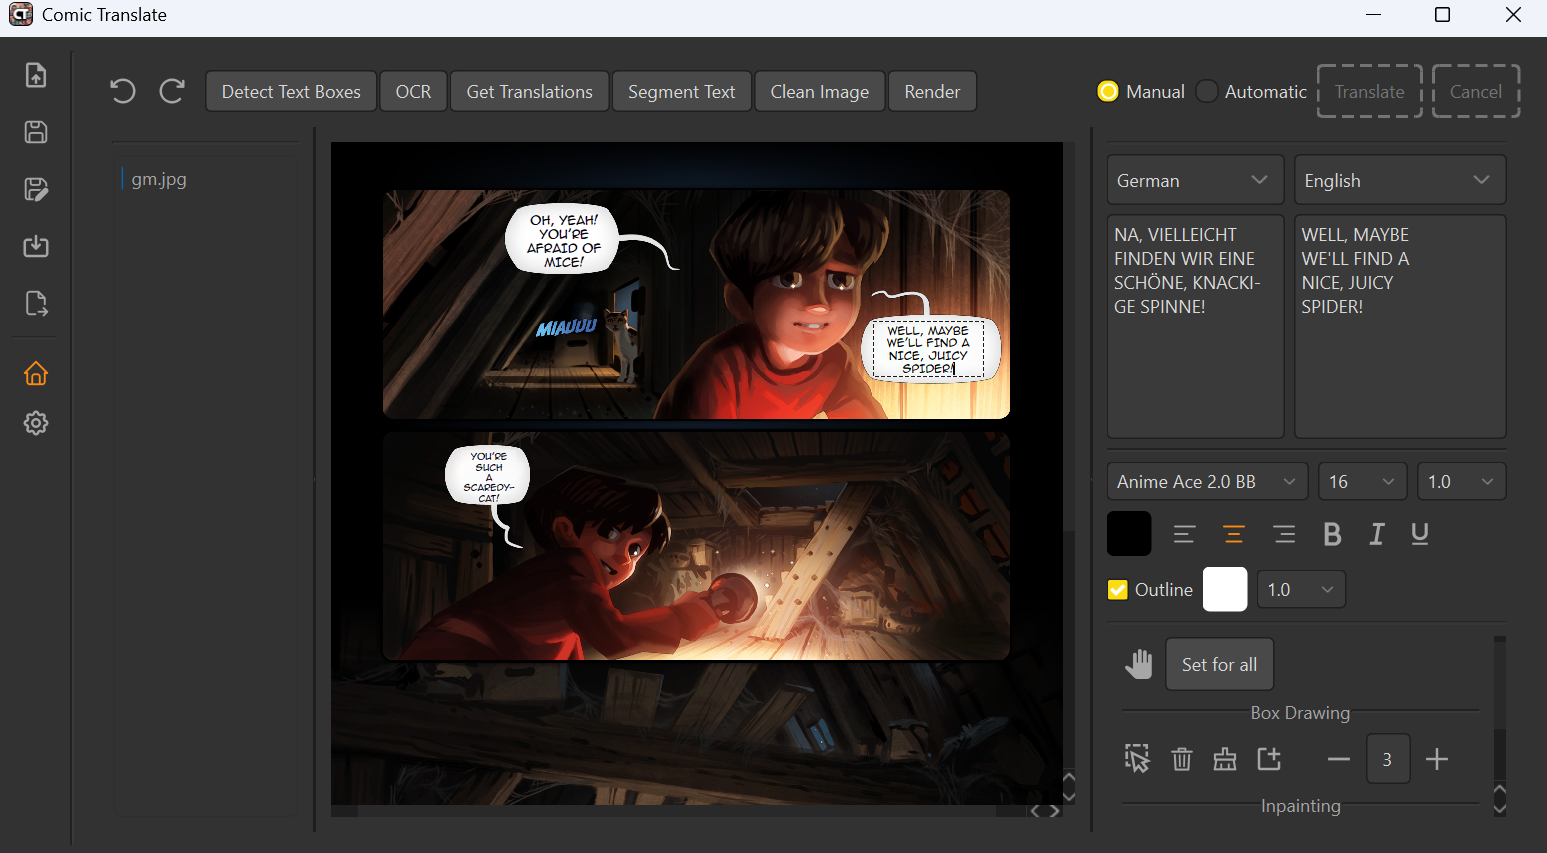
自动翻译漫画、日漫、韩漫等图片与 PDF/EPUB/CBR/CBZ 文件,集成 OCR、图像修复和机器翻译,支持多语言多格式。
基于 PySide6 的 faster-whisper 图形界面,让语音转文字不用敲命令行,支持 VAD 和 WhisperX 等能力。
轻量级图像与视频生成推理框架,支持 Wan、Hunyuan、LTX 等主流视频模型及自回归扩散模型,降低多模态生成模型的部署与推理门槛。

面向大语言模型的高性能推理框架,主打高效、灵活和易用,支持 DeepSeek 等模型在 GPU 上做推理服务部署。
轻量级嵌入式代码搜索引擎 CLI,基于 AST 解析建立索引,帮编码 Agent 快速定位相关代码、节省上下文窗口。
斯坦福 CRFM 出品的 Python 评测框架,对基础模型和大语言模型做全面、可复现、透明的基准测试,方便横向对比模型能力。

一款用 Python 编写的跨平台桌面音乐播放器,支持 FLAC、MP3 等格式,内置音乐库管理,适合在 Linux 桌面上管理和播放本地音乐。
基于 CTPN 做中文场景文字检测、CRNN+CTC 做识别的端到端 OCR 老项目,适合拿来跑通中文自然场景文字识别的完整流程。
面向图像、视频、音频扩散模型的通用微调工具箱,支持 Stable Diffusion、Flux 等模型,帮你在自有数据上快速训练出定制生成模型。
在普通电脑上跑 MiniMax H3 视频生成,最低 8GB 显存加 16GB 内存就能用,还会根据硬件自动选择加速方案。
用 Python 库和命令行抓取 X/Twitter 推文,支持多账号轮换和内置限流处理,解决大规模采集时账号被封或触发频率限制的问题。

把 Nunchaku 的 4-bit 量化扩散模型推理接进 ComfyUI,让 FLUX 等模型在低显存下也能快速出图。
基于音频声学分析为音乐库生成智能播放列表,无需元数据或外部服务,支持 Navidrome、Jellyfin、Plex 等主流媒体服务器。
面向 Blackwell 架构 GPU 的高速 LLM 推理引擎,支持 DeepSeek、Kimi、GLM 等模型,主打极致推理吞吐与低延迟。
用 100 行 Python 代码复现各类深度学习论文,涵盖扩散模型、GAN、元学习、逆渲染等,适合通过精简代码快速理解论文核心思想。

面向 Agent 的 AI 治理平台,用上下文图谱管理知识、上下文和 Agent 运行时,让 Agent 行为可追溯、可管控。
一种新的 RAG 检索架构,用知识图谱和向量检索构建知识库,让人和 Agent 都能高效查询结构化知识。
用 Python/C 实现的强制对齐工具,能把音频和对应文本自动对齐到词或音素级别,适合做语音数据集标注和字幕时间轴生成。
从视频里精确截取带内嵌字幕的画面,直接生成 3:4 社交长图,省去手动找帧和排版字幕的麻烦。
Lingvo 是 Google 开源的序列建模框架,用 TensorFlow 搭建语音识别、机器翻译、语言模型等 NLP 任务,支持分布式 GPU 训练。
基于 Whisper 的多语言语音识别工具,能输出词级时间戳和置信度,方便做字幕对齐和逐词定位。
基于 Kokoro 模型和 ONNX Runtime 的轻量级语音合成方案,用 Python 就能在本地跑出高质量 TTS,省去复杂环境配置。
给 Claude Code、Codex 等 AI 编码代理提供持久化统一记忆层,用 Markdown 存内容、Milvus 做向量检索,让代理跨会话记住上下文。