探索全部
共 1,808 个仓库 · 一年内有推送 · Python

基于航拍和卫星影像做语义分割,自动提取建筑、停车场、道路、水体、云等要素,适合遥感影像制图与地物识别。
一款用 Python 写的 Markdown 和 reStructuredText 编辑器,支持实时预览和语法高亮,适合写文档和笔记时专注排版。
一份精选的逆向工程资源清单,汇总二进制、应用、固件、文件格式和协议分析所需的工具与学习资料,方便安全研究和 CTF 选手快速找到趁手工具。
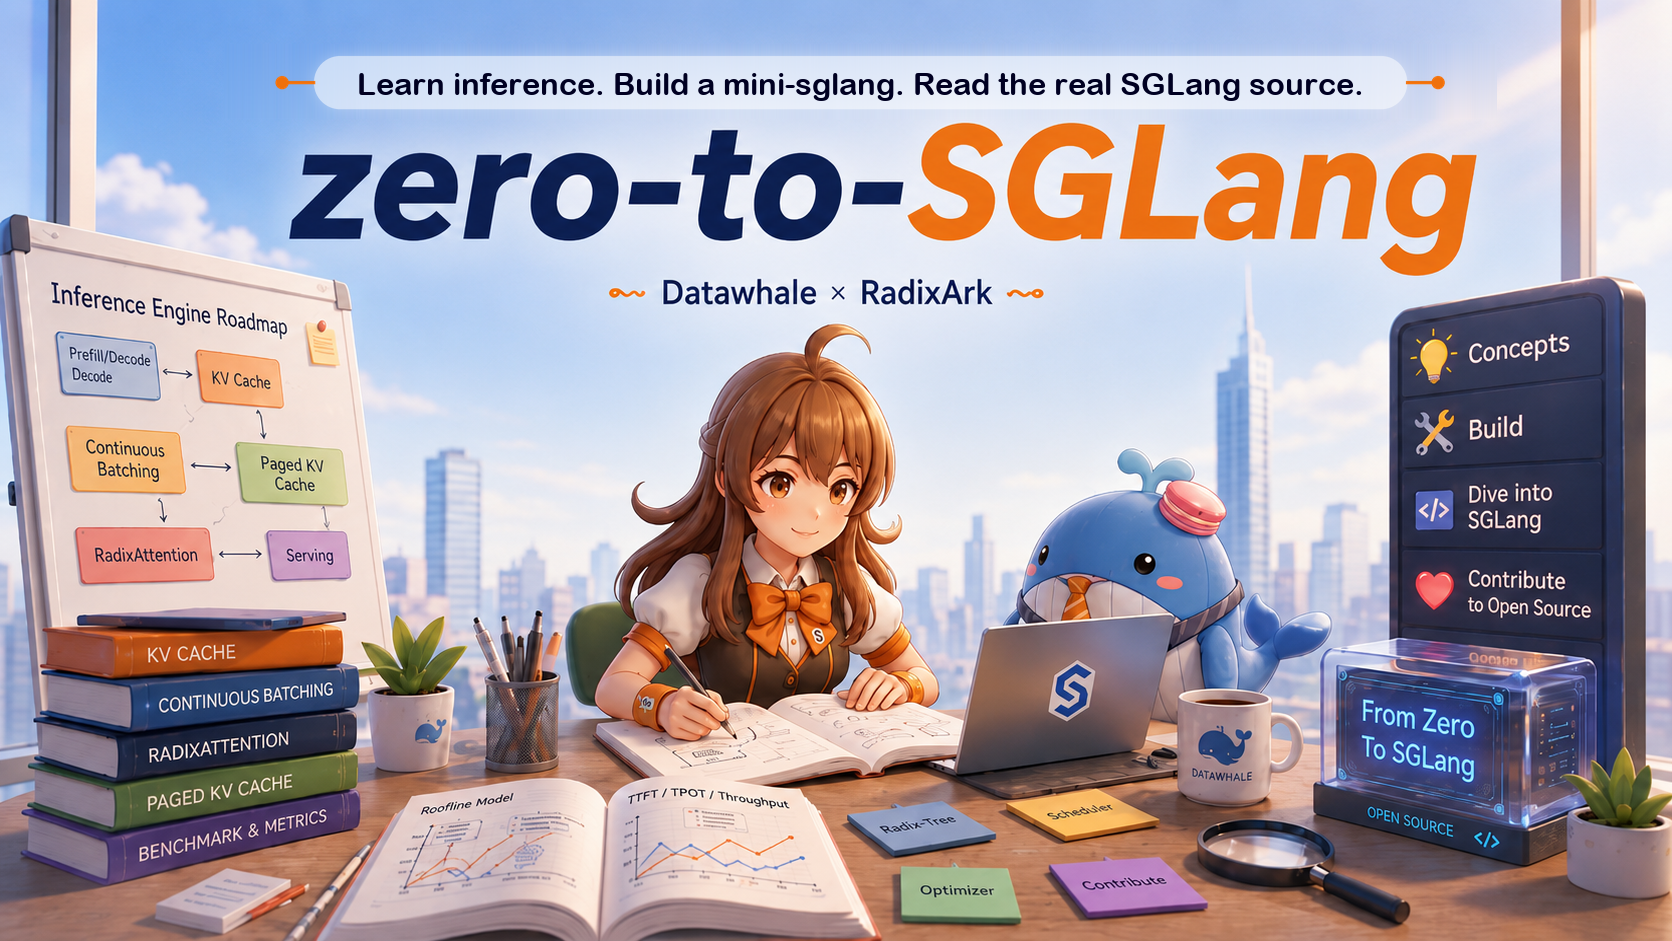
Datawhale 与 SGLang 官方合作的 LLM 推理课程,从零手写 mini-sglang 理解推理原理,再读真实源码并完成第一个 PR。
为 LLM 推理提供虚拟化弹性 KV Cache,让多个推理任务动态共享 GPU 显存,减少显存碎片和浪费,提升 GPU 利用率。
开源推理研究平台,用于在 AMD、CUDA 等不同 GPU 上对 LLM 推理服务做基准测试和性能对比,帮团队选型加速卡。
汇总联邦学习领域的论文、框架、数据集、教程和研讨会信息,帮研究者快速跟进最新进展。
把原始文档编译成结构化、本地优先的 wiki 知识库,用可读可维护的编译式方案替代传统 RAG,支持自管理自改进。
开源工业级语音识别模型,支持普通话、中文方言和英语,在公开普通话 ASR 榜单上刷新 SOTA,还能精准识别歌词。

把 Yandex Station 等带 Alice 语音助手的智能家居设备接入 Home Assistant,实现语音控制和 TTS 播报。
CVNets 是苹果开源的计算机视觉训练库,基于 PyTorch,支持分类、检测、分割等任务,覆盖 ImageNet、COCO、ADE20K 等主流数据集。
基于 Kokoro 模型的命令行语音合成工具,支持多语言、音色混合,可直接把 EPUB 电子书和 PDF 文档转成有声书或播客音频。
用一个 Transformer 统一多模态理解与生成,既能看图回答,也能按文字生成图像,省去多模型拼接的麻烦。
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
开源微调 Qwen-VL 系列多模态大模型的实现,支持 Qwen2-VL、Qwen2.5-VL、Qwen3-VL 等版本,方便按自己的数据定制视觉语言模型。
只用几张图片就能让文生图扩散模型学会多个新概念,并把它们组合到同一张图里,适合做个性化图像生成和少样本微调。
基于 Meta Llama 3 开发的中文大模型项目,提供中文 LLaMA-3 和 Alpaca-3 模型及训练、部署方案,解决中文场景下开源大模型可用性问题。
基于 GPU 加速的视频分析智能体参考架构,用视觉语言模型、LLM 和 RAG 实现长视频的实时告警、视觉问答与自动报告生成。
面向流式视频超分的一步扩散框架,用局部约束稀疏注意力和微型条件解码器把扩散超分做到实时,适合直播、视频通话等低延迟场景。

轻量级剪贴板同步工具,无需按键即可在 Android、Linux、macOS 等多设备间自动同步文本、图片和文件,支持自托管与多用户。
自动收集并整理 IPTV 直播源,按天更新生成 m3u/m3u8 播放列表和 EPG 节目单,可直接导入 FongMi 等播放器使用。
面向自动化渗透测试的多智能体编排框架,用 AI 指挥官调度 worker 集群,配合分层事实-意图图实现无人值守的自主攻击。
整合多个优质上游规则并去重整理的广告拦截规则集,可直接用于 AdGuard、Quantumult X 和 SmartDNS,省去自己拼规则、查重复的麻烦。
用 Python 写的 dotfiles 管理器,把配置文件集中存到 Git 仓库,再通过 Jinja2 模板和 GPG 加密按机器差异部署到各台设备。