探索全部
共 1,808 个仓库 · 一年内有推送 · Python
自托管的 AI 网关,把私有 RAG、自然语言查数据库和工具调用智能体统一到一个入口,方便在内部环境安全接入大模型。
本地运行的桌面 Agent 操作系统,用语音或聊天指挥编码 Agent、浏览器和各类应用,全部在你自己的机器上完成。
在 Apple Silicon 上做 W8A8/W4A8 量化推理,调用 M5 闲置的 INT8 TensorOps 让 LLM prefill 快 1.2–1.9 倍,并用类 FlashInfer 的 GQA 解码注意力加速 SDPA。

首个开源的 JSON 原生文生图模型,用结构化 JSON 输入实现可控、可预测且版权合规的图像生成。
一键抓取影片元数据并生成 NFO 和封面图,供 Jellyfin、Emby、Kodi 媒体库使用,免 Docker 和命令行,Windows/macOS 直接安装。
给 Claude Code 加钩子的本地代理,能拦截并改写请求与响应,支持自定义模型名和按逻辑智能路由模型。
用 Python 实现的多摄像头实时多人跌倒检测,结合人体姿态估计和 LSTM 识别视频中的跌倒事件,适合看护场景。
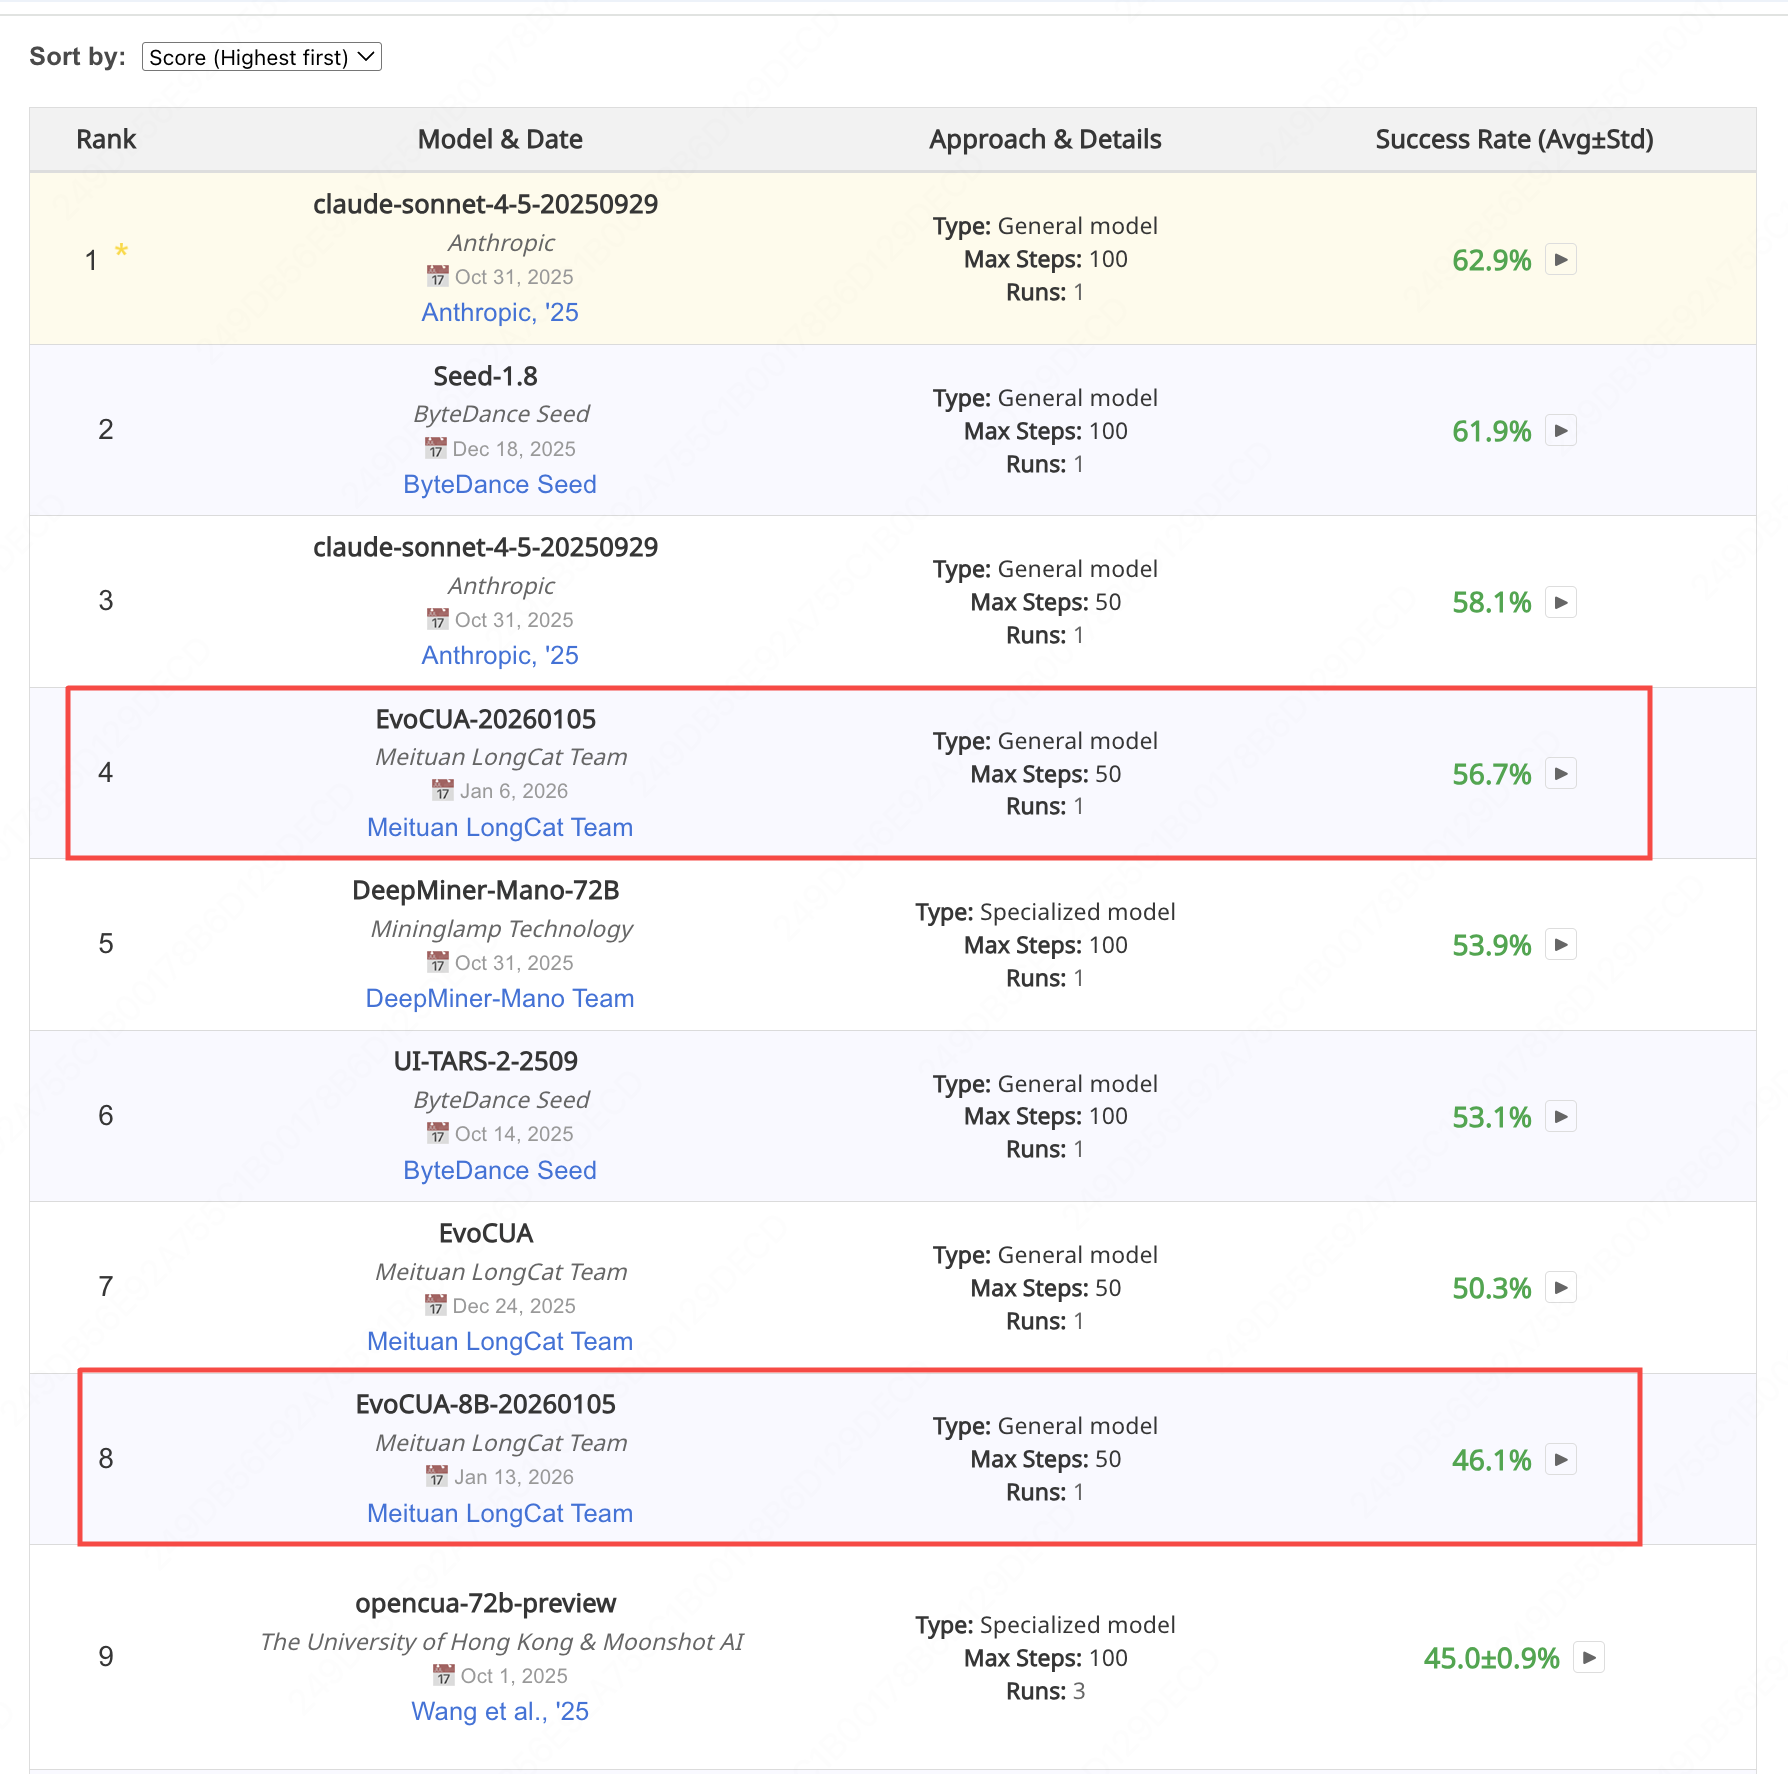
EvoCUA 是一个可自我进化的计算机使用智能体,基于视觉语言模型理解图形界面并自动完成操作任务。
面向考勤场景的自拍人脸认证平台,无需 OTP、注册或代打卡,专为低成本手机优化,可大规模部署。
用逐步分组相对策略优化(Step-wise GRPO)训练多模态大模型做推理,提升视觉语言任务上的推理能力。
用强化学习把目标检测、分割、计数等视觉感知任务统一进多模态大模型的推理流程,让模型边推理边定位。
用 YOLO 检测工地未戴安全帽、未穿反光衣及靠近机械等危险行为,并用 HDBSCAN 聚类锥桶坐标划定监控区域,提升施工安全。
一套包含 23 个 Claude Code 插件的工具集,覆盖 TDD 强制、Git/PR 流程、规格驱动开发、代码审查与多 LLM 委派,帮团队把 AI 编码代理接入规范化的研发流程。
本地一站式 LoRA 训练工作台,从单张照片或大批图片构建角色、风格、概念数据集,自动打标并用 ai-toolkit 训练,支持多模型 checkpoint 对比。
高灵敏度的镜头边界检测方案,能更精准地切分视频场景并保留更多信息,适合视频剪辑与转码流程中的自动分镜。
PromptKD 是 CVPR 2024 的官方 PyTorch 实现,用无监督提示蒸馏把大视觉语言模型的能力迁移到小模型上,免去人工标注。
T2I-CompBench 是评估文生图模型组合能力的基准,覆盖属性绑定、物体关系和数量等维度,帮研究者量化模型是否真的画对了提示词。
用掩码生成式 Transformer 做高分辨率文生图的官方实现,把非自回归架构重新拉回实用水平,兼顾生成效率与画质。
一站式动漫视频增强工具,一次处理即可完成 AI 超分、RIFE 补帧和画质修复,支持命令行、独立程序和 After Effects 插件。
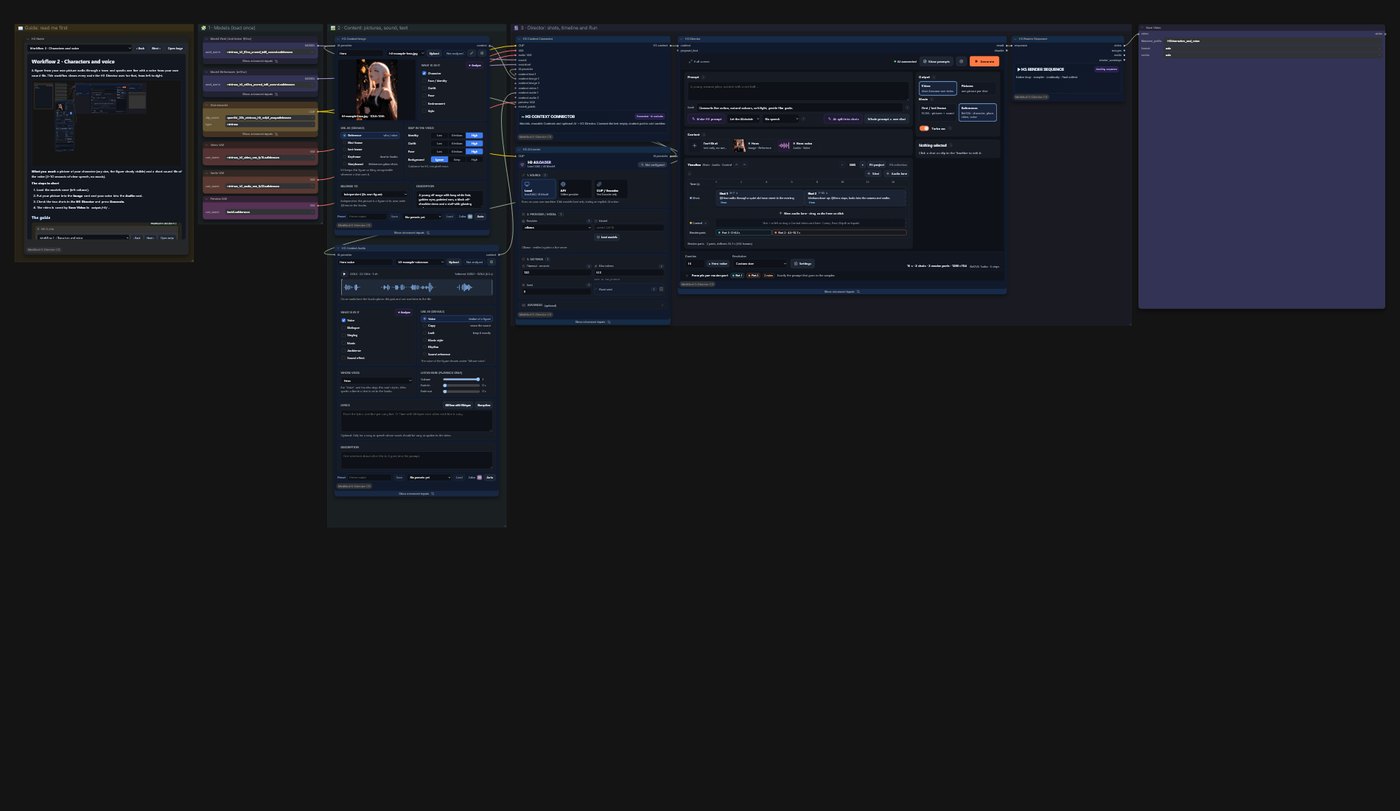
在 ComfyUI 里给 MiniMax H3 视频模型加了一条时间轴编辑器,用分镜提示词、首尾关键帧、图/视频/音频参考和联合音频来编排镜头,还能实时预览采样、重拍和镜头串联。
在预算约束下自动搜索最优 Agent 工作流,用多目标优化和帕累托前沿帮你权衡成本与效果,省去手工调参。
面向 GenAI 应用的 Python 追踪框架,基于 OpenTelemetry 采集 LLM 调用与 Agent 执行链路,帮开发者定位问题、做可观测性。
输入一句提示词,由 ChatGPT 自动补全成适合 MidJourney 的完整绘画提示,帮你省去反复琢磨措辞、激发更多创意灵感。

在终端里用 ASCII 艺术展示 Linux/BSD 系统信息,是原版 Archey 的维护分支,适合替代 neofetch、screenfetch 快速查看配置。