Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 42 / 43 页
基于基础模型的医学图像分析代码库,涵盖MAE预训练、Mamba状态空间模型、视觉语言模型与医学报告生成,为医学影像研究提供可复用的模型实现。
用 PyTorch 和 CUDA 复现 3D Gaussian Splatting 的非官方实现,支持三维重建和新视角合成,方便研究和二次开发。

一门小课程,教你搭建强化学习环境来评估和训练语言模型,涵盖 GRPO、RLVR 和井字棋等实例。
一套 Python 脚本,用来整理和优化 IPTV 播放体验,处理 m3u 播放列表等日常维护工作。
局域网内快速传文件的桌面应用,带用户/组权限和审计日志,适合团队内部安全共享文件。
可自部署的 AI 长期记忆与聊天网关,为多轮对话保存跨会话记忆,并统一接入和路由各家大模型。
基于 Flutter 的跨平台 TVBox 空壳播放器,支持订阅源和 M3U/TXT/JSON 直播源,适配遥控器操作,覆盖 Android TV、iOS、macOS 等设备。
把 macOS 桌面操作封装成 MCP 服务,让 AI Agent 能直接控制鼠标键盘、操作窗口,实现电脑使用自动化。
把电影、动漫、短剧或小说剧本自动拆成分镜片段,并生成 Sora、Veo、Runway 等模型可用的连贯视频提示词,保持角色与剧情跨片段一致。
27 章手把手教程,用 Python 从零搭建自主 AI Agent,覆盖 Agent 循环、工具系统、记忆、技能、MCP 与自进化。
用 PPO 强化学习和 LoRA 低秩适配微调 LLaMA 模型,做 RLHF 对齐训练,显存占用低,适合在单卡上跑通大模型偏好优化流程。
基于 Claude Code 的通用开发自动化工具,能自动实现功能、跑测试、提 PR,支持 15+ 框架预设,适合想省下重复开发时间的团队。

用强化学习(GRPO)训练视觉语言模型生成更细粒度、更密集的图像描述,解决普通 caption 模型描述过于笼统的问题。
单容器自托管的家庭实验室监控面板,集中展示 GPU、本地 AI 显存、Docker、systemd 和电费,并提供只读 MCP 服务让 AI 代理直接查询这些数据。
在单台桌面机器上跑 100GB 级大模型的开源推理引擎,支持 AMD Strix Halo、NVIDIA RTX 和 Apple Mac,兼容 OpenAI API,基于 ExLlamaV3 构建。
处理 Polycam 原始扫描数据的 Python 工具集,能把采集结果导出成 NeRF 等格式,方便后续做三维重建和神经渲染。
一套面向 AI 编程助手的生成式媒体技能包,让 Claude、Cursor 等助手能直接产出高质量图片、视频、音频和语音内容。

把真实或虚拟硬件接入 CI/CD 流水线,支持本地远程、人工或自动化测试,解决嵌入式与硬件在环场景下难以持续集成的问题。
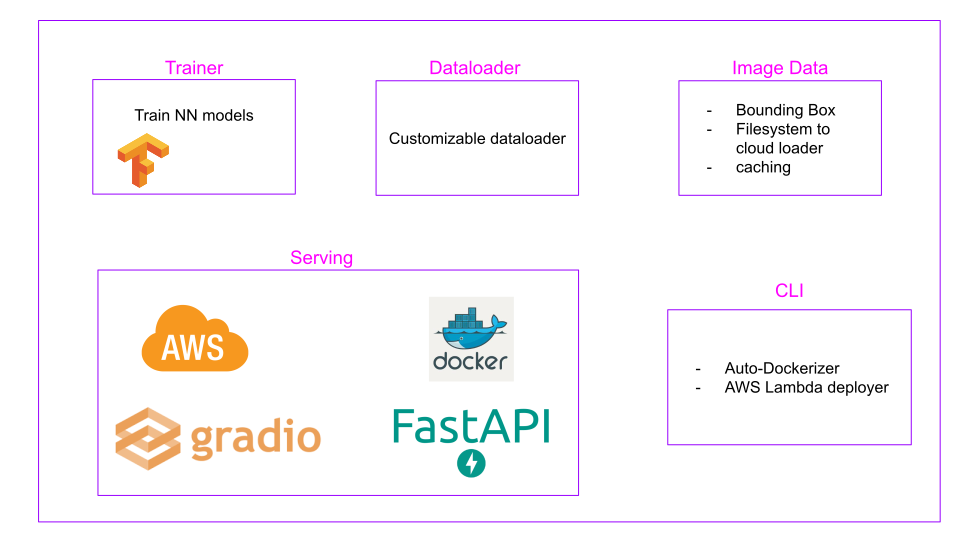
一站式深度学习全栈库,把模型搭建、FastAPI 接口开发和模型部署串起来,还带 GradCAM 可解释性分析,省去自己拼装各环节的麻烦。
面向机器人操作的自进化智能体训练方案,通过后训练和递归自我改进,在成功率提升14%的同时把 token 消耗降低65%。
跨平台剪贴板工具,能在 tmux、vim 等终端环境与系统剪贴板之间复制粘贴,无需网络即可远程同步。
面向视觉语言模型的对齐与安全研究代码库,提供对抗攻击方法,用于评估多模态基础模型的鲁棒性和可信度。
面向 Apple Silicon 的自适应混合精度量化与推理运行时,把 GGUF 模型转成 MLX 可用格式,让 Mac 上跑大模型更省显存。
基于 3D 高斯泼溅的文本生成 3D 场景工具,通过 Formation Pattern Sampling 从文字描述直接构建可渲染的三维场景,适合做 3D AIGC 内容创作。

用 Python 从零实现的教学版 vLLM,帮助理解大模型推理引擎的调度与 KV Cache 机制,适合边读代码边学习。
提供山东联通 IPTV 的 M3U 播放列表和 EPG 节目单,方便在播放器里直接导入观看直播频道。
在终端里管理 KeePass 密码库的命令行工具,把密码安全地藏在命令行里,适合习惯用 Unix 工具链、不想开图形界面的用户。
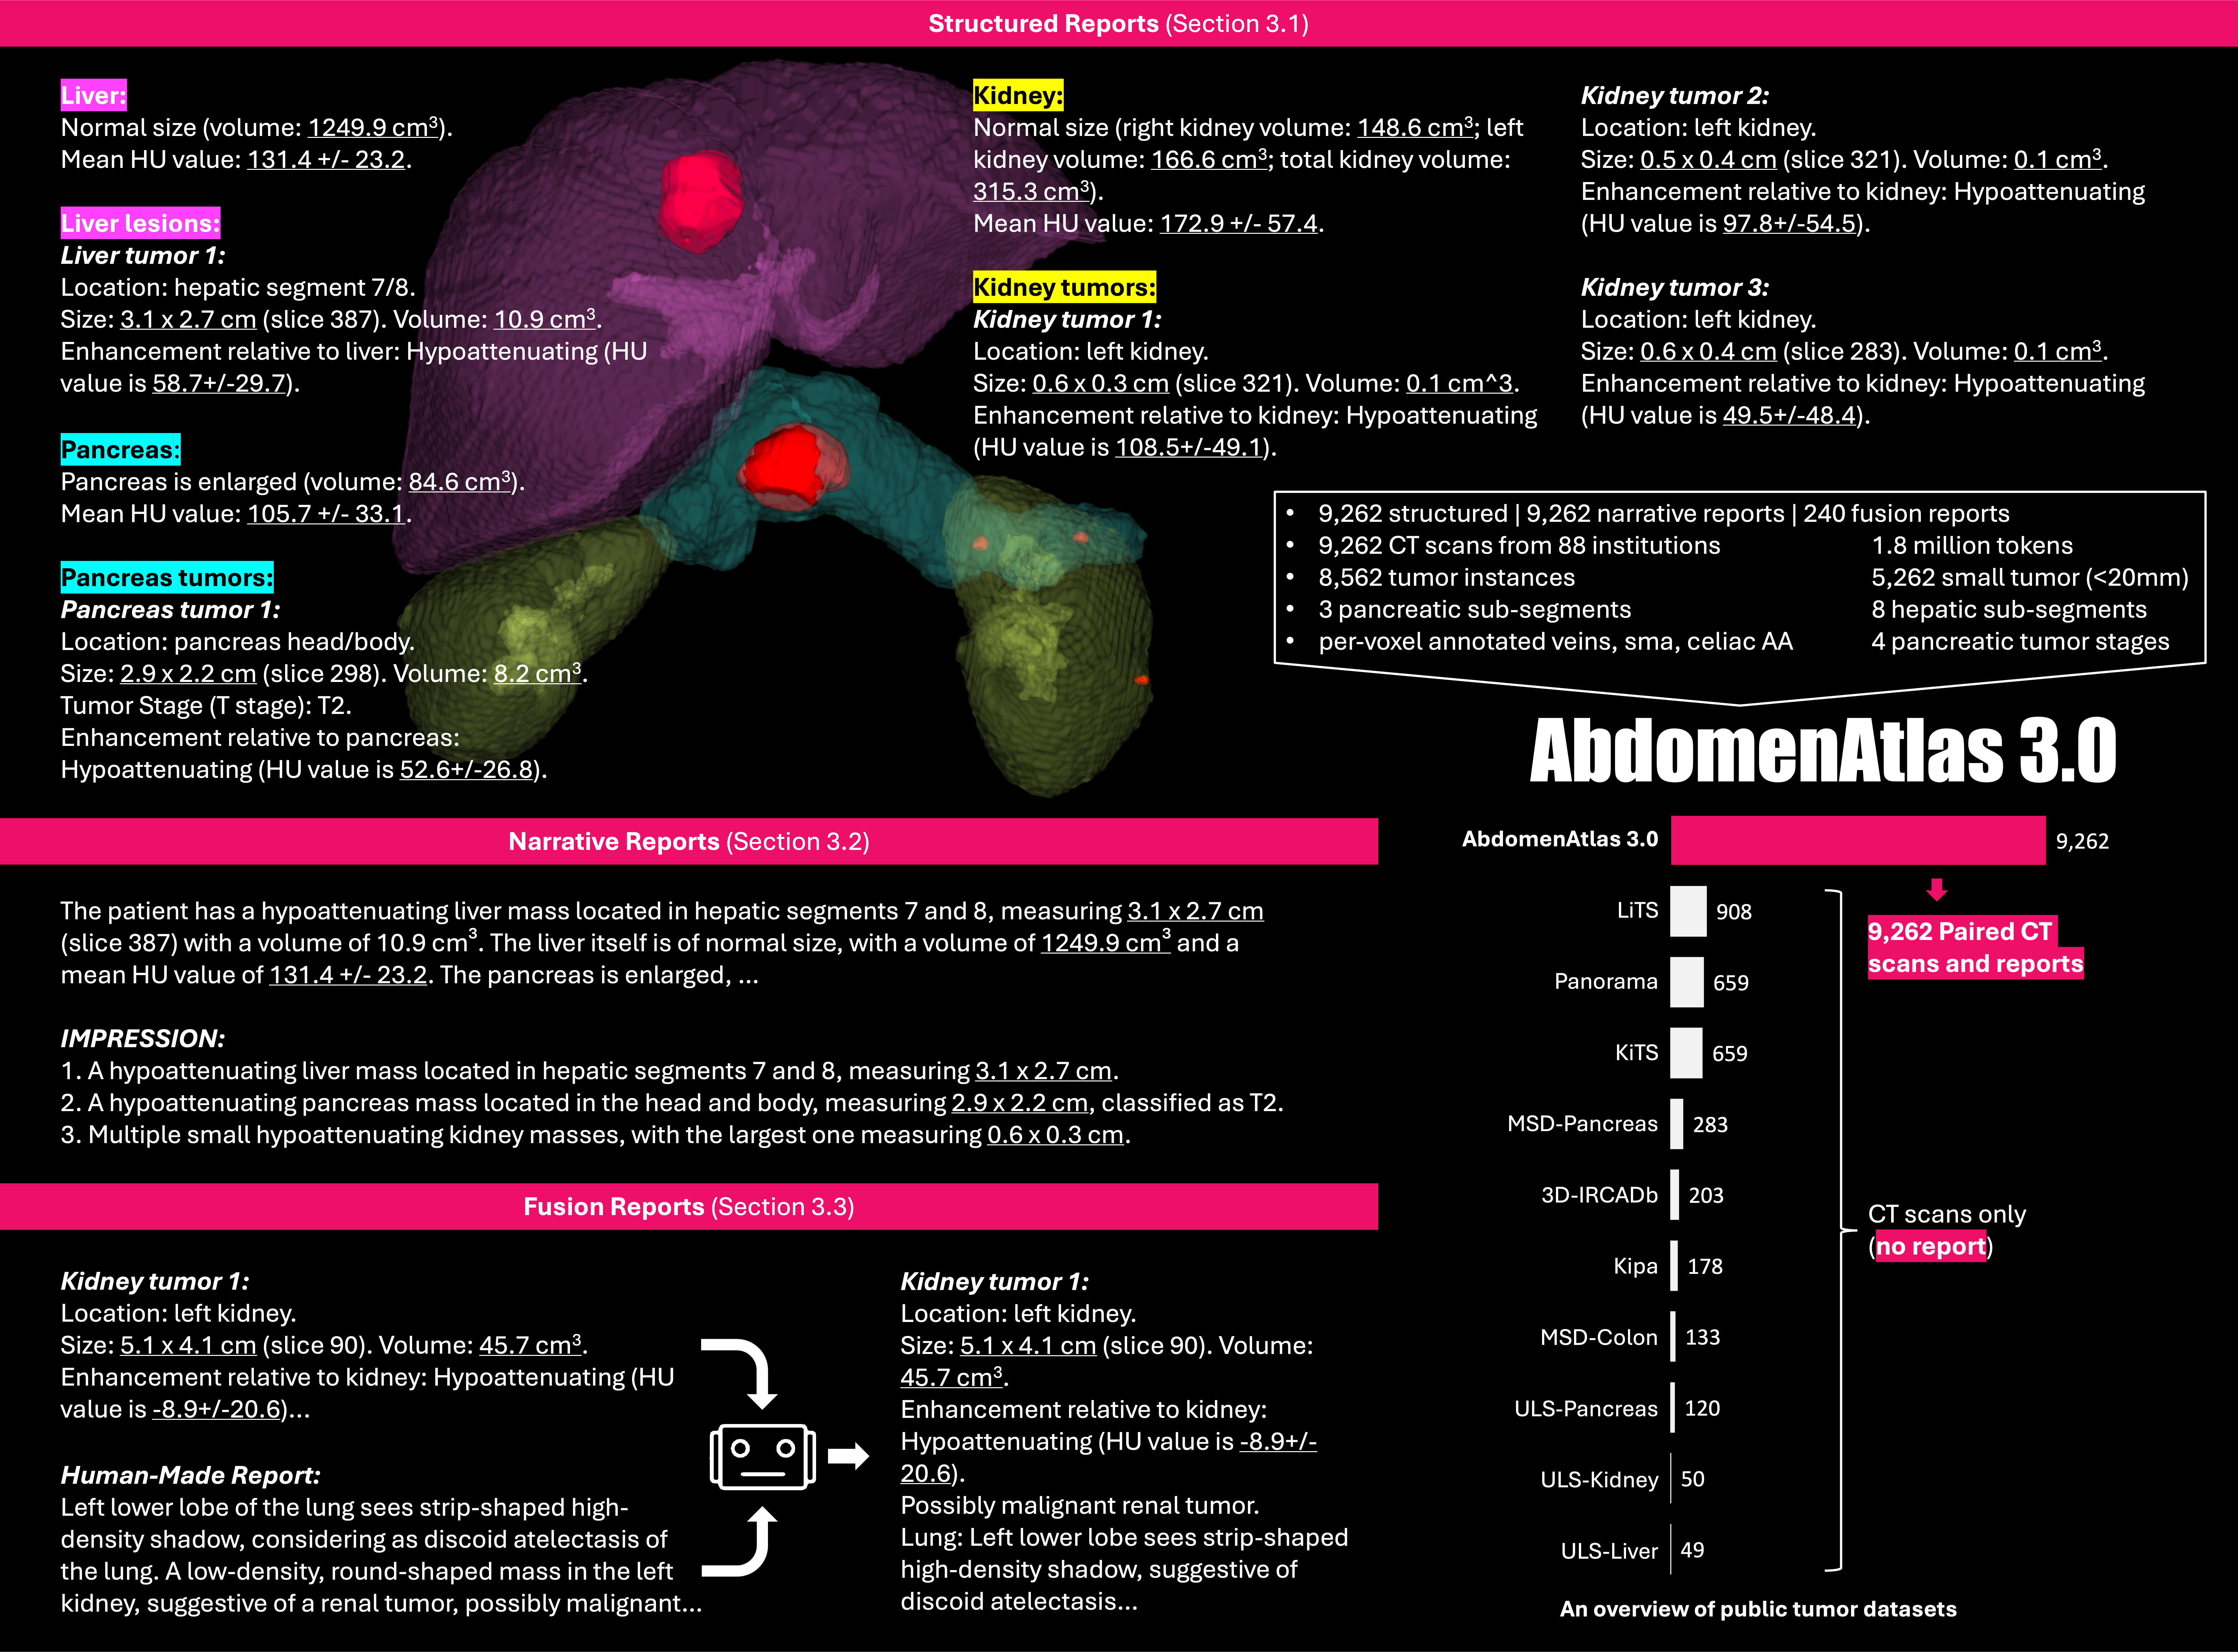
AbdomenAtlas 3.0 提供 9262 例腹部 CT 及配套医学报告,报告比人工书写更准、更细、更规范且生成更快,可用于训练和评测病灶分割与视觉语言模型。
在 Windows 上原生一键跑 Qwen3.6-27B 推理,无需 WSL 或 Docker,RTX 5090 上可达 158 tok/s,适合本地离线、注重隐私的部署。
自托管的 GitOps 控制平面,把 OpenTofu 的基础设施编排和 Ansible 的配置管理串成一条流水线,统一管理云上、本地和混合环境的部署。
用强化学习对扩散模型做后训练,支持文生图、文生视频和图生视频,主打高效、稳定、可扩展。
把 fal.ai 上 1400 多个图像、视频、音频和 LLM 模型接进 ComfyUI 的自定义节点,自带缓存和费用控制,方便在本地工作流里直接调用云端生成能力。
把视觉预训练扩展到 4K 分辨率,让视觉语言模型在高清图像上也能高效训练和推理。
一站式实时视觉训练与部署框架,覆盖目标检测、关键点估计、实例与语义分割,支持导出 TensorRT、ONNX、OpenVINO、CoreML 到边缘设备。
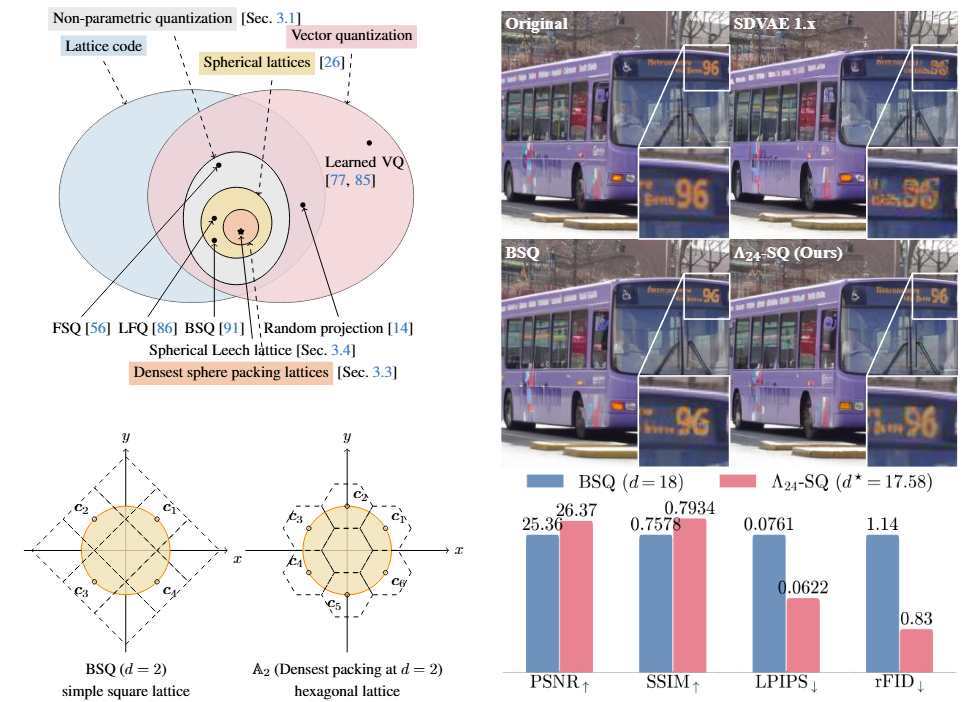
面向视觉 tokenizer 的球面量化方案,包含二值球面量化和 Leech 球面量化两种方法,用于压缩视觉 token 并提升表示效率。
Iris-3B 是一个 3B 参数的扩散 Transformer,直接在像素空间生成图像、无需 VAE;同一预训练先验微调后还能做单目深度估计和 4 倍图像修复。
NVIDIA Alpamayo 的开发者配方库,提供自动驾驶与机器人模型的微调、强化学习后训练、量化和部署现成方案,省去从零搭建流程的麻烦。
纯 Python 实现的跨平台高性能 FFmpeg 实时视频帧解码器,为计算机视觉和视频处理提供低延迟的帧读取能力。

提供紧凑且高质量的俄语词向量,基于 GloVe 和 word2vec 训练并支持量化压缩,适合俄语 NLP 任务直接加载使用。

轻量级 Web 面板,实时查看多块 GPU 的占用率、显存和温度等状态,方便跑深度学习训练时随时掌握显卡负载。
从零手写的 LLM 推理引擎,实现分页 KV 缓存、连续批处理、投机解码和 CUDA 图等优化,并提供 OpenAI 兼容服务接口。
用 Python 写的随机密码生成与本地管理小工具,带图形界面,帮你生成强密码并集中保存,省去记密码的麻烦。
Archived oneAPI specification sources. The current dynamic specification is maintained on the UXL Foundation website and in project documentation.
命令行待办管理工具,用简单命令记录和整理任务,适合习惯在终端里工作的人。
面向鱼眼等通用相机的 3D 高斯泼溅渲染实现,让新视角合成在非针孔相机下既精确又高效,适用于自动驾驶与 AR 场景。
把扩散模型的去噪步骤拆到多张卡上异步并行执行,无需重新训练就能显著加速 Stable Diffusion 等文生图、文生视频模型的推理。
为 ComfyUI 提供 MiniMax H3 文生图、参考图编辑和 Qwen 细节精修的节点与实测工作流,开箱即用。

ChronoMagic-Bench 是 NeurIPS 2024 提出的文本到延时视频生成评测基准,用变形评估衡量扩散模型生成延时视频的质量。