仓库是图文资料而非可运行代码,无需安装依赖;图片采用非商业许可,商用需注意授权;用于论文或书籍需按 README 引用格式注明出处
LLM-RL-Visualized
changyeyu活跃维护用 100 多张原创原理图把 LLM 和强化学习的关键算法讲清楚,适合想系统理解大模型训练与 RL 机制的人对照学习。
🌟100+ 原创 LLM / RL 原理图📚,《大模型算法》作者巨献!💥(100+ LLM/RL Algorithm Maps )
暂无版本5,008star +2 / 7 天481fork同步于 2026-11-10 17:37 UTC
git clone https://github.com/changyeyu/LLM-RL-Visualized.git 硬件要求按 README 说明
README 未说明
100+ 原创 LLM/RL 原理图仓库,帮你快速搞懂大模型训练与强化学习算法
用 100 多张原创原理图把 LLM 和强化学习的关键算法讲清楚,适合想系统理解大模型训练与 RL 机制的人对照学习。
核心能力
- 收录 100+ 原创架构图,覆盖 LLM、VLM 与强化学习
- 按 SFT、DPO、RLHF、GRPO、PPO 等主题分 11 部分组织
- 提供 SVG 矢量图,可无限缩放并选中文字
- 附强化学习算法图谱与 LLM 结构总图 PDF
- 图旁标注对应书籍章节,可延伸阅读详解
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
暂无 release 数据(可能没有发版,或尚未同步)。
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。
简 介
🎉 原创 100+ 架构图,系统讲解大模型、强化学习,涵盖:LLM / VLM 等大模型原理、训练算法(RL、RLHF、GRPO、DPO、SFT 与 CoT 蒸馏等)、效果优化与 RAG 等。
🎉 关于架构图更详细的解读可参考:《大模型算法:强化学习、微调与对齐》 (豆瓣高分,多次京东AI图书Top 5 !)
🎉 本仓库长期勘误、追加,欢迎点击仓库顶部的 Star ⭐ 关注,感谢鼓励✨
🎉 单击图片可看高清大图,或浏览仓库目录中的 .svg 格式矢量图(活图,可无限缩放、可选择文字)
目 录
第1部分:大模型、强化学习的技术全景图
- 大模型算法总体架构(以LLM、VLM为主)
- 强化学习算法图谱 (rl‑algo‑map).pdf——全网最大!
- LLM结构总图——全网最大!
- 策略梯度(Policy Gradient)-强化学习(PPO&GRPO等)之根基.pdf
第2部分:大模型基础
第3部分:SFT(有监督微调)
- 微调(Fine‑Tuning)技术分类
- LoRA(1 of 2)
- LoRA(2 of 2)
- Prefix‑Tuning
- TokenID与词元的映射关系
- SFT的Loss(交叉熵)
- 指令数据的来源
- 多个数据的拼接(Packing)
第4部分:DPO(直接偏好优化)
第5部分:免训练的大模型优化技术
- CoT(Chain of Thought)与传统问答的对比
- CoT、Self‑consistency CoT、ToT、GoT
- 穷举搜索(Exhaustive Search)
- 贪婪搜索(Greedy Search)
- 波束搜索(Beam Search)
- 多项式采样(Multinomial Sampling)
- Top‑K采样(Top‑K Sampling)
- Top‑P采样(Top‑P Sampling)
- RAG(检索增强生成, Retrieval‑Augmented Generation)
- 功能调用(Function Calling)
第6部分:强化学习(RL)基础
- 强化学习(Reinforcement Learning, RL)的发展历程
- 三大机器学习范式
- 强化学习的基础架构
- 强化学习的运行轨迹
- 马尔可夫链 vs 马尔可夫决策过程(MDP)
- 探索与利用问题(Exploration and Exploitation)
- Ɛ‑贪婪策略下使用动态的Ɛ值
- 强化学习训练范式的对比
- 强化学习算法分类
- 回报(累计奖励,Return)
- 反向迭代并计算回报 G
- 奖励(Reward)、回报(Return)、价值(Value)的关系
- 价值函数 Qπ 与 Vπ 的关系
- 蒙特卡洛(Monte Carlo,MC)法预估状态 St 的价值
- TD 目标与 TD 误差的关系(TD target and TD error)
- TD(0)、多步 TD 与蒙特卡洛的关系
- 蒙特卡洛方法与 TD 方法的特性
- 蒙特卡洛、TD、DP、穷举搜索的关系
- 两种输入输出结构的 DQN(Deep Q-Network)模型
- DQN 的实际应用示例
- DQN 的“高估”问题
- 基于价值 vs 策略(Value-Based vs Policy-Based)
- 策略梯度(Policy Gradient)
- 多智能体强化学习(MARL,Multi-agent reinforcement learning)
- 多智能体 DDPG
- 模仿学习(IL,Imitation Learning)
- 行为克隆(BC,Behavior Cloning)
- 逆向强化学习(IRL,Inverse RL)
- 有模型(Model-Based) vs 无模型(Model-Free)
- 封建等级强化学习(Feudal RL)
- 分布价值强化学习(Distributional RL)
第7部分:策略优化架构及衍生算法
- Actor‑Critic 架构
- 引入基线与优势函数 A (Advantage)的作用
- GAE(广义优势估计,Generalized Advantage Estimation)算法
- PPO(Proximal Policy Optimization)算法的演进
- TRPO(Trust Region Policy Optimization)及其置信域
- 重要性采样(Importance sampling)
- PPO‑Clip
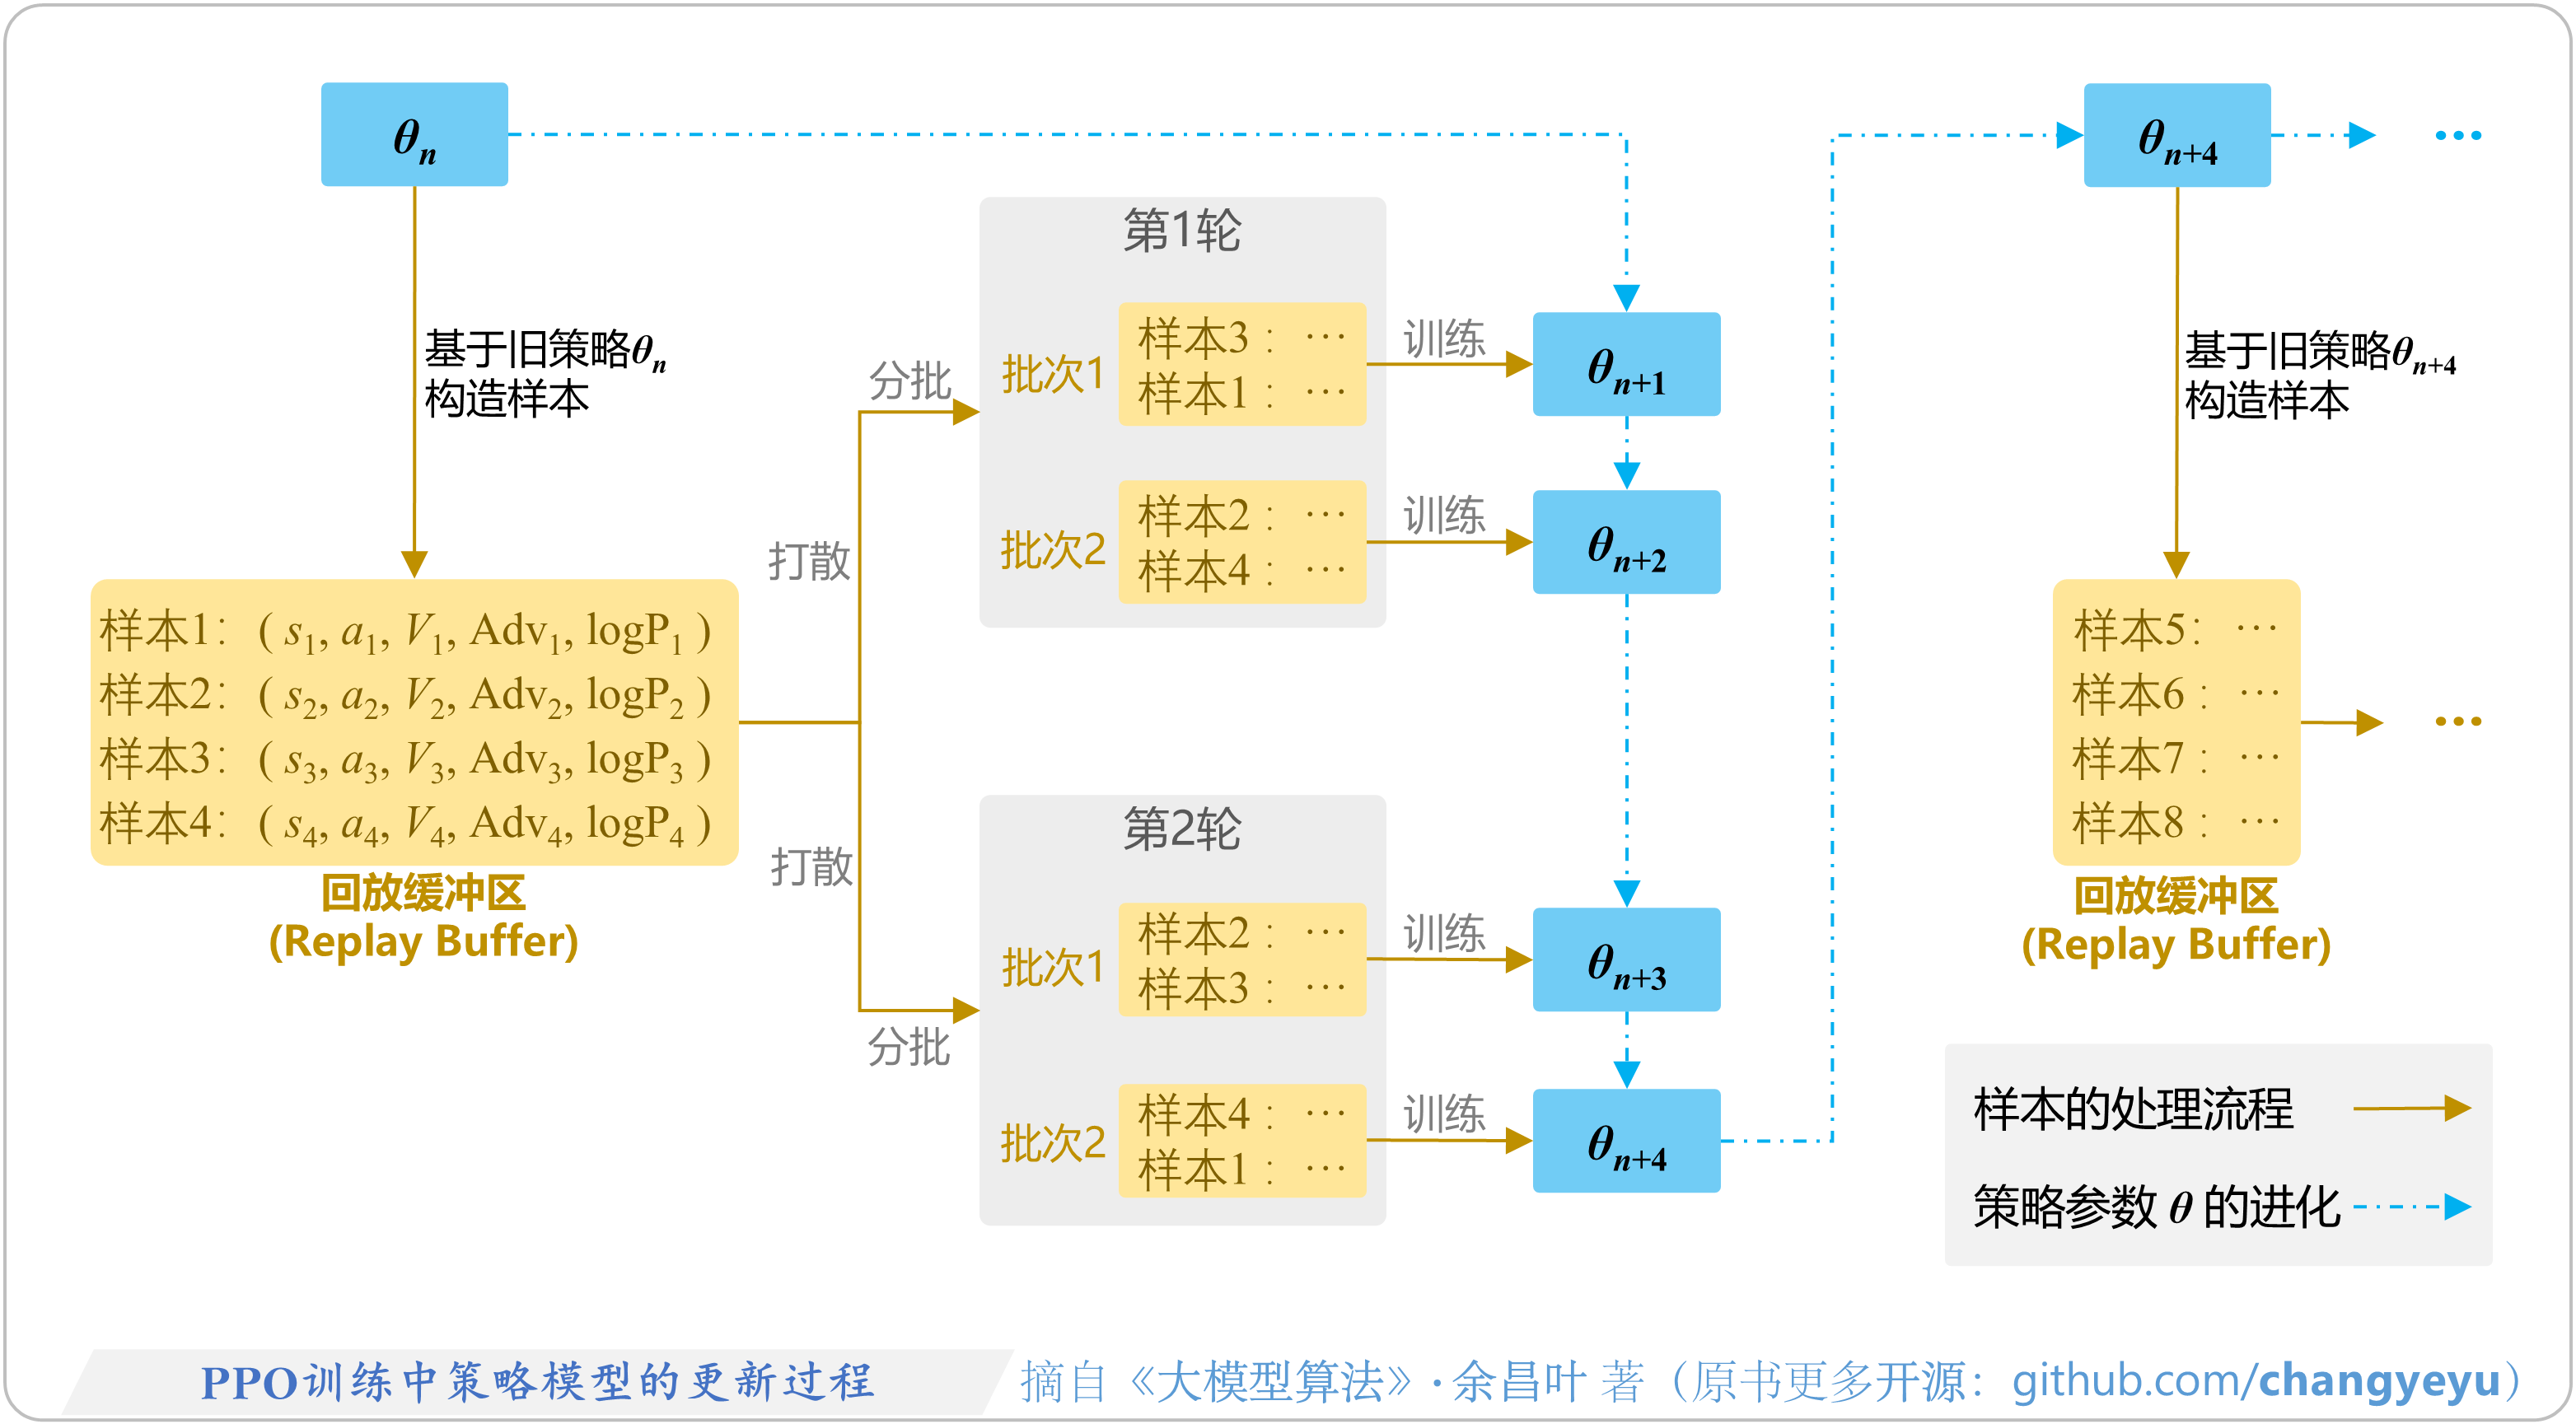
- PPO训练中策略模型的更新过程
- PPO 伪代码
- PPO 与 GRPO
- 确定性 vs 随机性策略(Deterministic policy vs. Stochastic policy)
- 确定性策略梯度(DPG)
- DDPG(Deep Deterministic Policy Gradient)
第8部分:RLHF 与 RLAIF
- 语言模型的强化学习建模
- RLHF 的两阶段式训练流程
- 奖励模型(RM)结构
- 奖励模型的输入输出
- 预测偏差与 Loss 的关系
- 奖励模型的训练
- PPO 中四种模型的合作关系
- PPO 中四种模型的结构与初始化
- 双头结构的价值模型
- 共享底座的四种模型
- PPO 输入与输出
- PPO 中的 KL 距离计算
- 基于 PPO 的 RLHF 原理图
- 拒绝采样(Rejection Sampling)微调
- RLAIF 与 RLHF 的区别
- Claude模型应用的宪法AI(CAI)原理
- OpenAI RBR(基于规则的奖励)
第9部分:逻辑推理(Reasoning)能力优化
- 基于 CoT 的知识蒸馏(Knowledge Distillation)
- 基于 DeepSeek 进行蒸馏
- ORM 和 PRM(结果奖励模型和过程奖励模型)
- MCTS 每次迭代的四个关键步骤
- MCTS 的运行过程
- 语言场景下的搜索树示例
- BoN(Best‑of‑N)采样
- 多数投票(Majority Vote)方法
- AlphaGo Zero 性能增长趋势
第10部分:大模型基础拓展
- 大模型性能优化技术图谱
- ALiBi 位置编码
- 传统的知识蒸馏
- 数值表示、量化(Quantization)
- 常规训练的前向/反向过程
- 梯度累积(Gradient Accumulation)
- Gradient Checkpoint(梯度重计算)
- Full recomputation(完全重计算)
- LLM Benchmark
- MHA、GQA、MQA、MLA
- RNN
- Pre‑norm 与 Post‑norm
- BatchNorm 与 LayerNorm
- RMSNorm
- 剪枝(Prune)
- 温度系数的作用
- SwiGLU
- AUC、PR、F1、Precision、Recall
- RoPE 位置编码
- RoPE 对序列位置与各维度的作用
第11部分:附录与引用
大模型算法总体架构(以LLM、VLM为主)
强化学习算法图谱 (rl-algo-map).pdf——全网最大!
- 本人历时数天、呕心沥血之作,点击本仓库右上角 ↗ 的 Star ⭐ ,就是对我最大的鼓励啦!
- 下图仅为预览图,高清图见: 强化学习算法图谱 (rl-algo-map).pdf

【LLM基础】LLM结构总图——全网最大!
- 本人历时几十个小时、呕心沥血之作,点击本仓库右上角 ↗ 的 Star ⭐ ,就是对我最大的鼓励啦!
- LLM主要有Decoder-Only(仅解码器)或MoE(Mixture of Experts, 专家混合模型)两种形式,两者在整体架构上较为相似,主要区别为MoE在FFN(前馈网络)部分引入了多个专家网络。


策略梯度(Policy Gradient)-强化学习(PPO&GRPO等)之根基.pdf
- 手撕推导 RL 核心理论之一 ,图灵奖得主 Sutton 提出。
- 大模型训练算法之根基(被ChatGPT、DeepSeek 等广泛使用的 PPO 和 GRPO 算法都是基于策略梯度)。
- 很重要 但常常被混淆的一部分内容,我重新推导公式、画原理图解释了一下(窄版排版) : 策略梯度(Policy Gradient)-强化学习(PPO&GRPO等)之根基.pdf
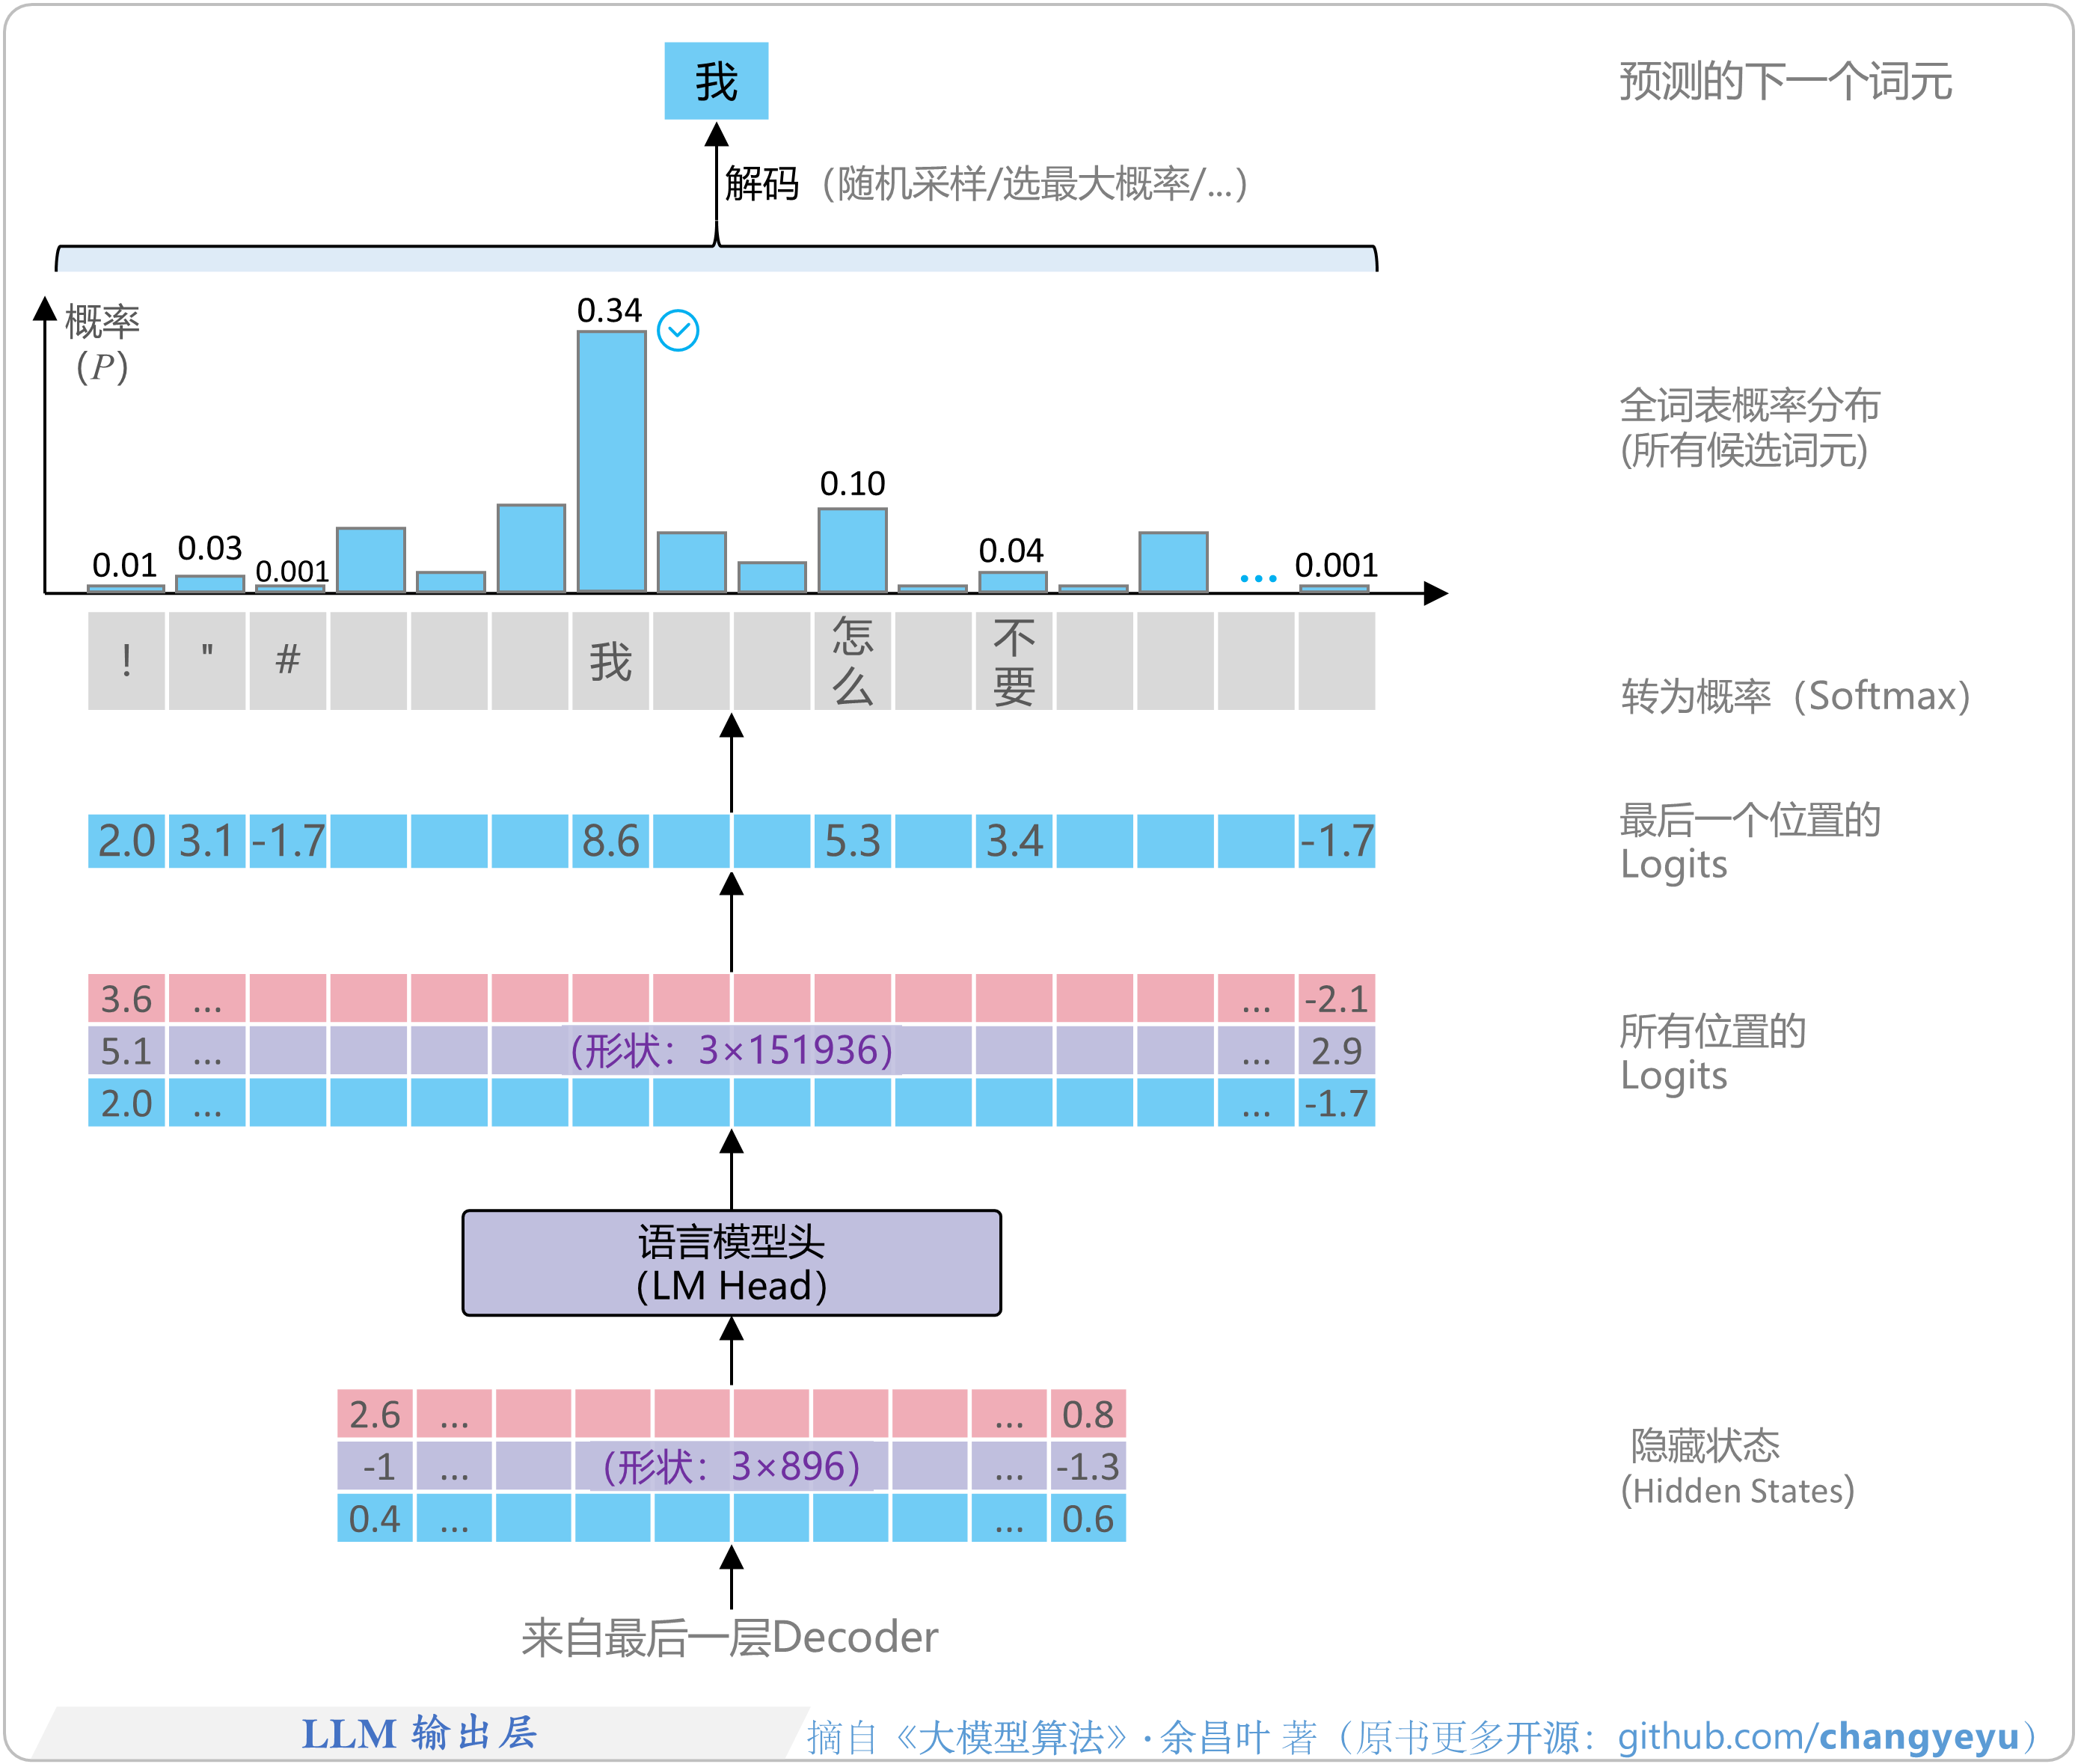
【LLM基础】LLM(Large Language Model)结构
- LLM主要有Decoder-Only(仅解码器)或MoE(Mixture of Experts, 专家混合模型)两种形式,两者在整体架构上较为相似,主要区别为MoE在FFN(前馈网络)部分引入了多个专家网络。
- 一个典型的LLM结构,可分为三部分——输入层、多层Decoder堆叠结构和输出层(包括语言模型头与解码模块)
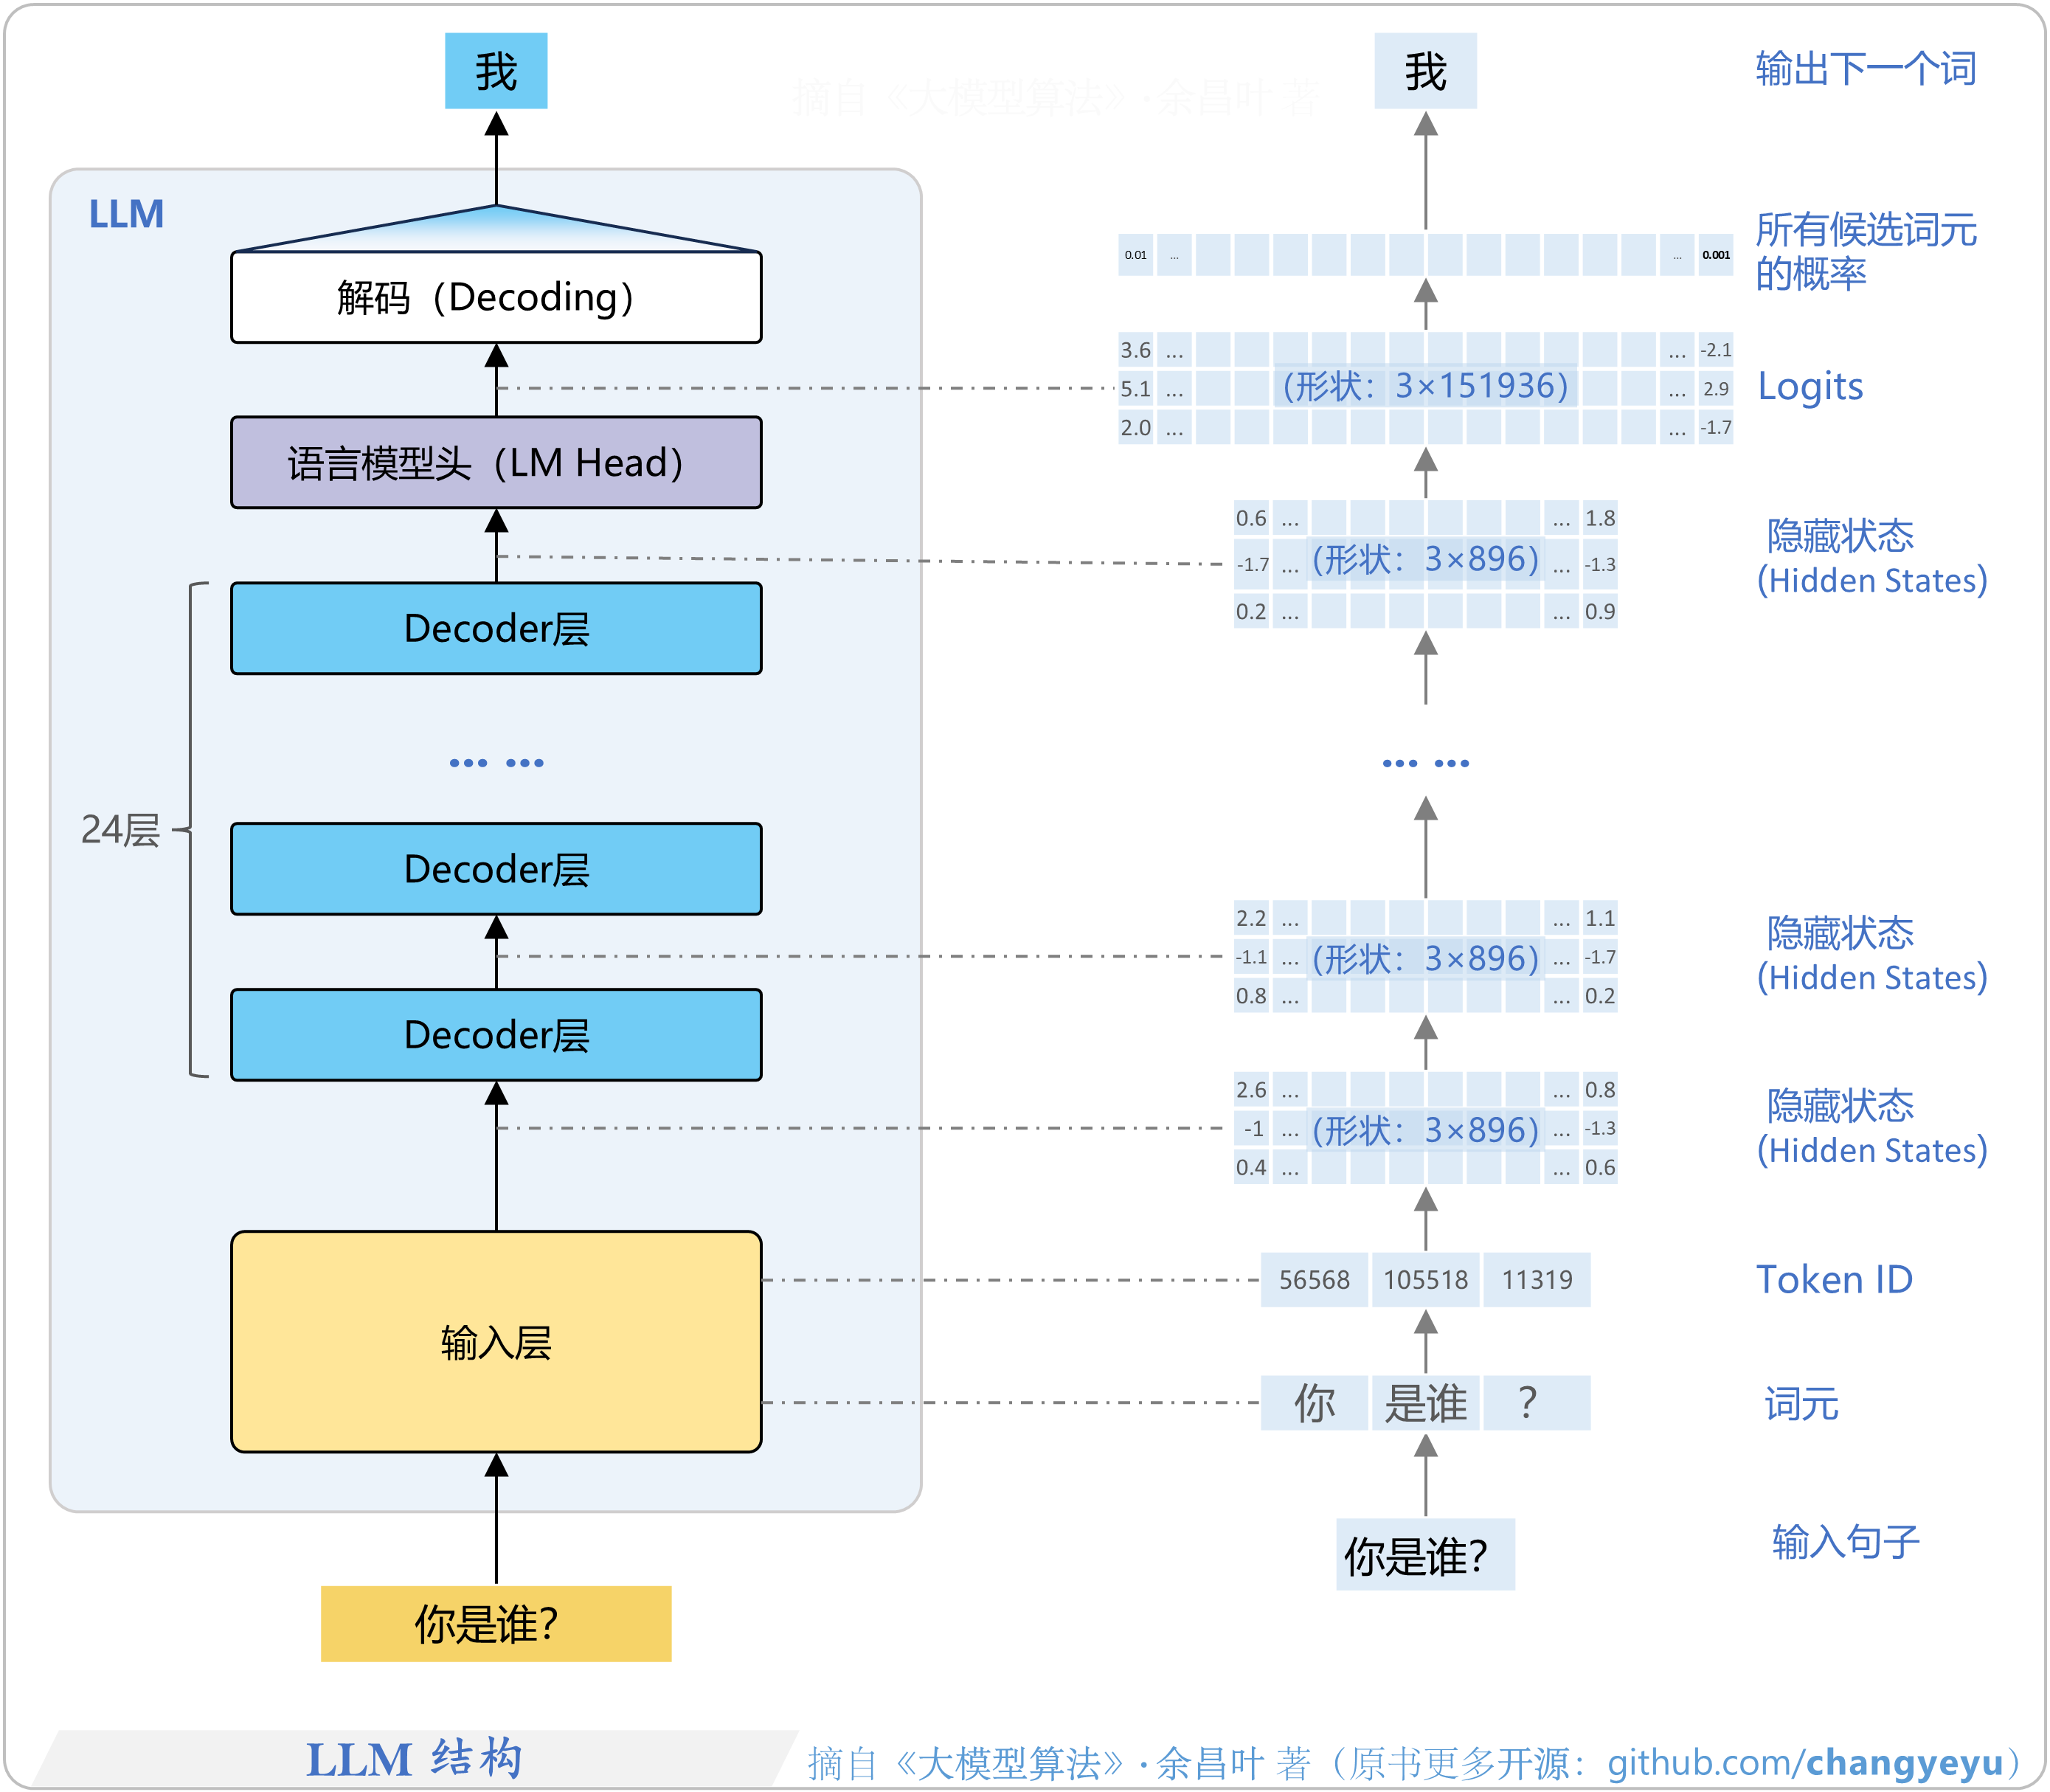
【LLM基础】LLM生成与解码(Decoding)过程
- 解码策略是决定最终输出文本流畅性、多样性及整体表现的核心因素。常见的解码算法包括:贪婪搜索、波束搜索(Beam Search)及其衍生算法、多项式采样、Top-K采样、Top-P采样、对比搜索(Contrastive Search)、投机解码(Speculative Decoding)、前瞻解码(Lookahead Decoding)、DoLa解码等。
- LLM的输出层负责根据概率分布,应用解码算法确定最终预测的下一个/N个词元。
- 根据概率分布,应用解码策略(例如随机采样或选择最大概率)确定最终预测的下一个词元。例如,在贪婪搜索解码策略下,选择概率最高的词元“我”作为预测结果。
- 每一个token(词元)的生成都需要重新走一遍所有层Transformer结构。
- 这里只展示了每次预测一个词元的方案,也有一次性预测多个词元的方案,详见《大模型算法:强化学习、微调与对齐》第四章。

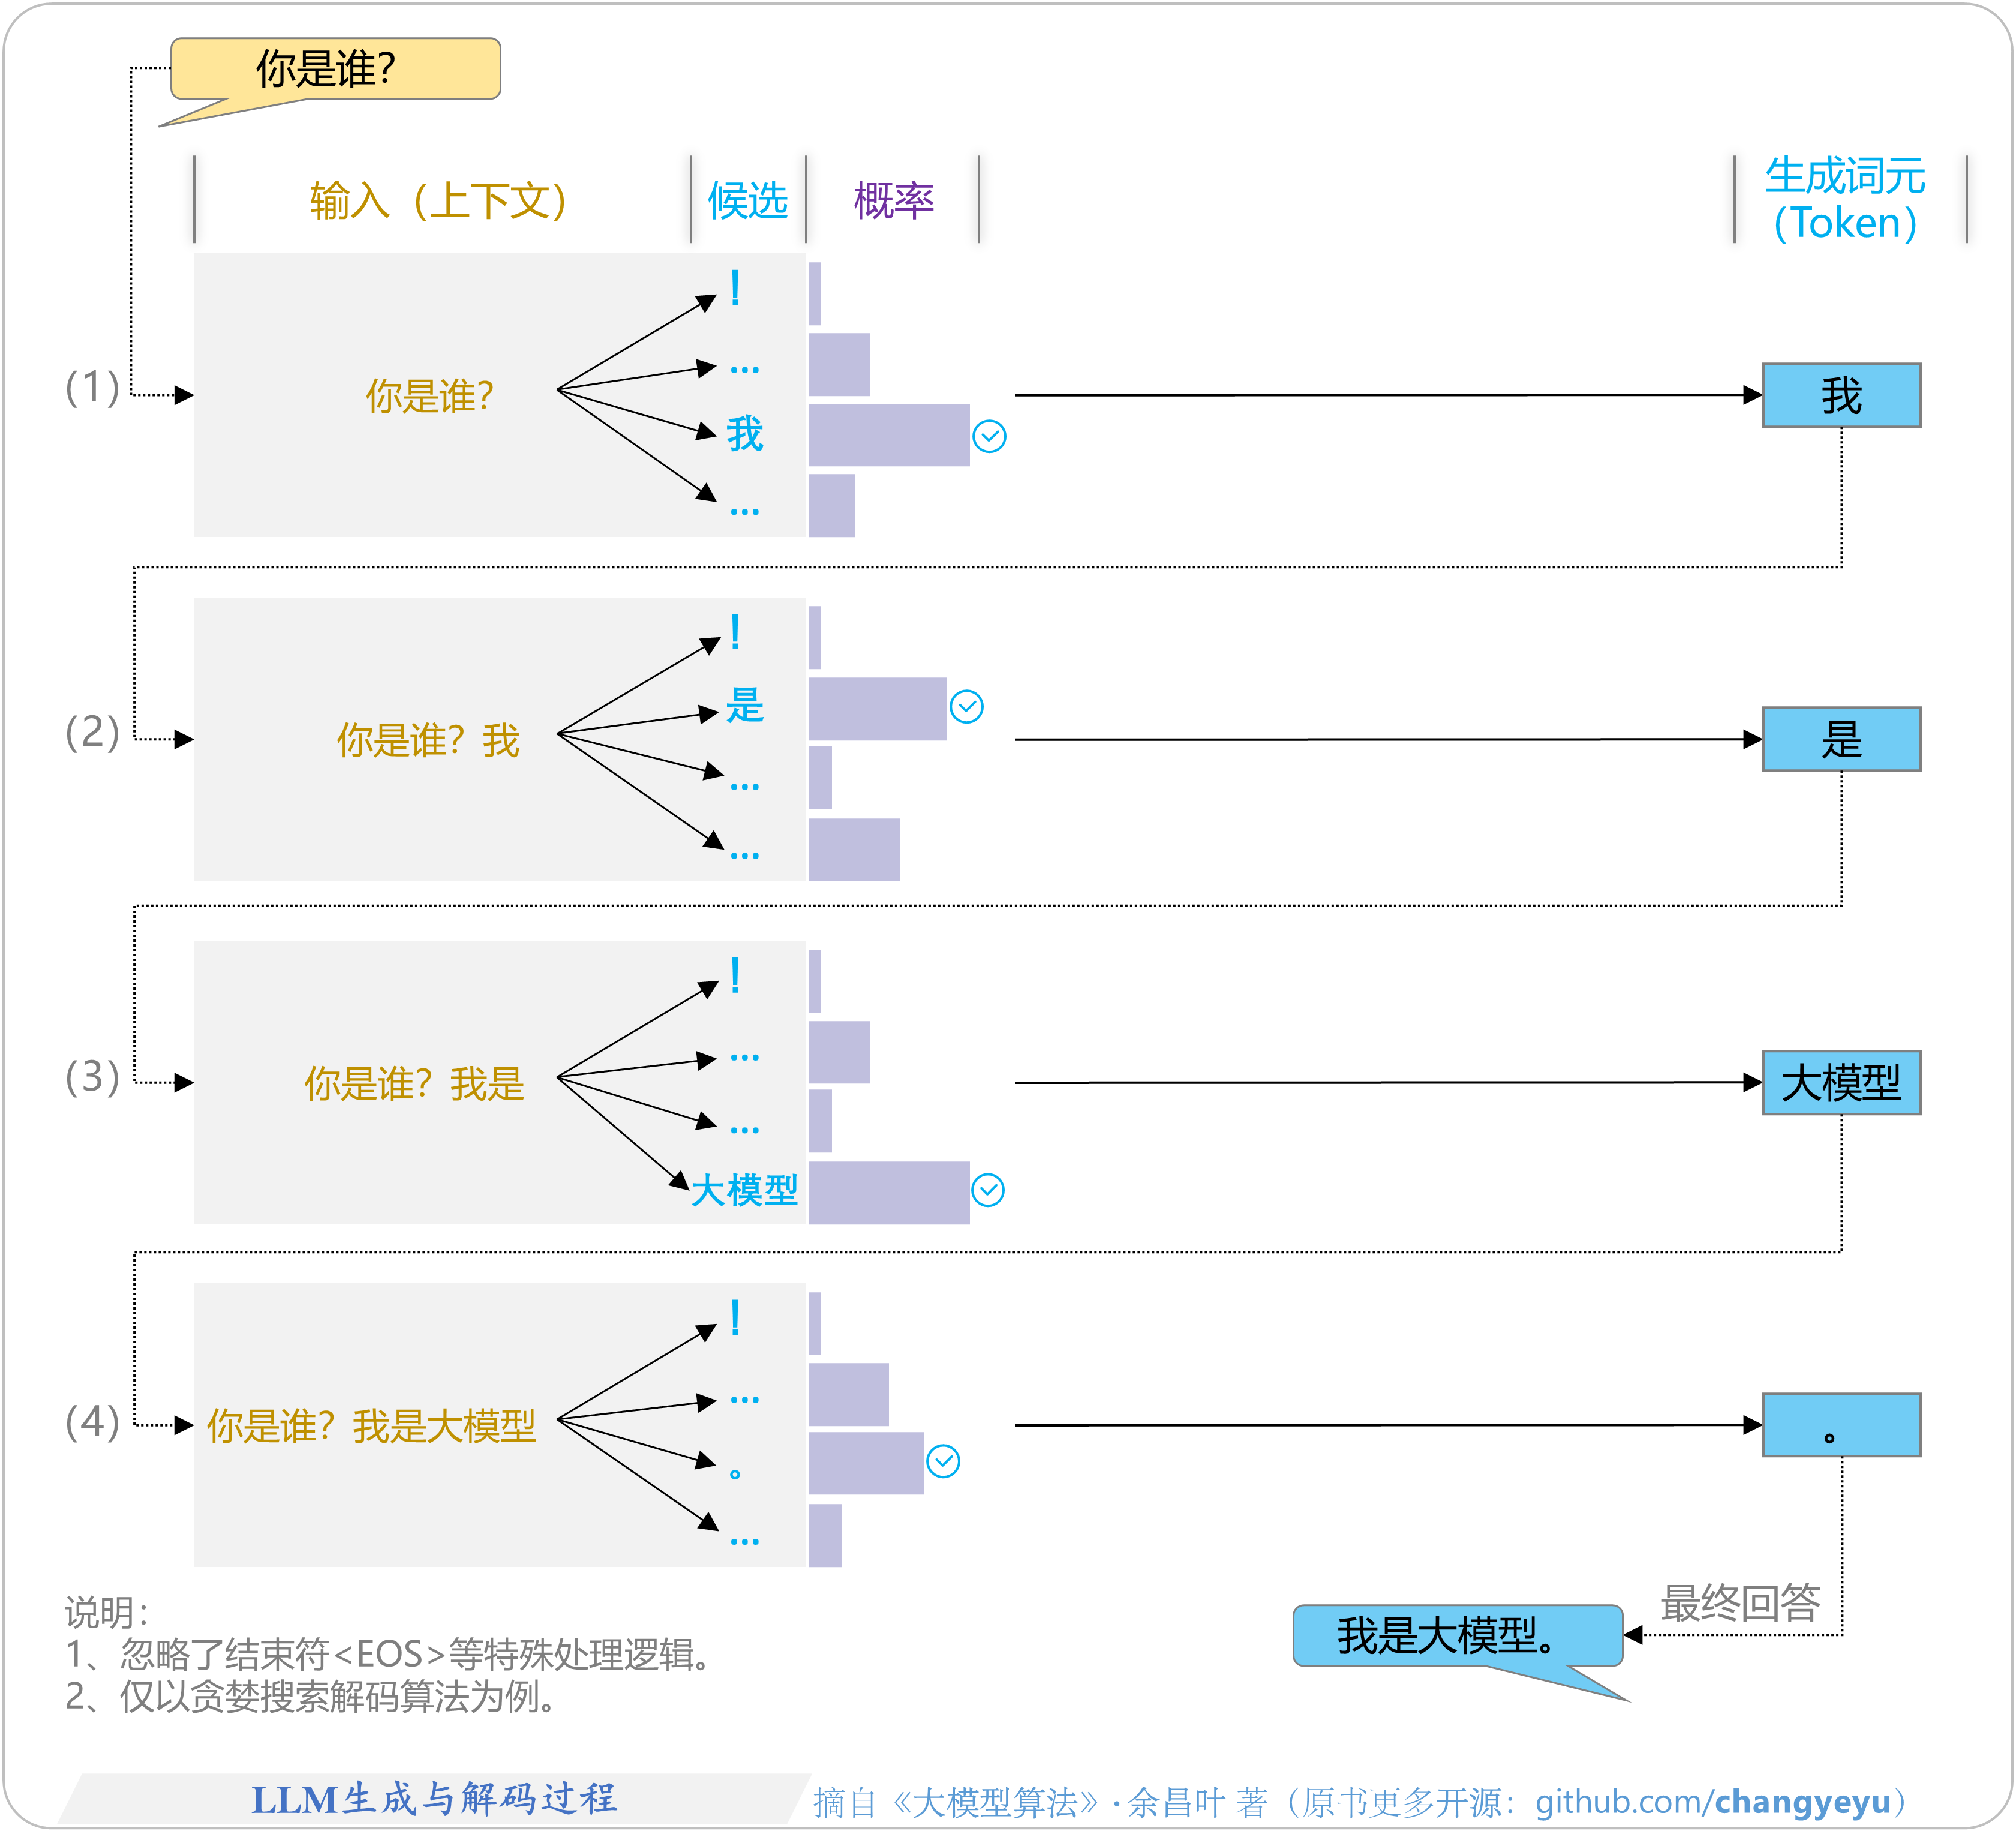
【LLM基础】LLM输入层
- LLM的输入层将输入文本转换为多维数值矩阵(Tensor,张量),以便送往模型主体结构进行计算。

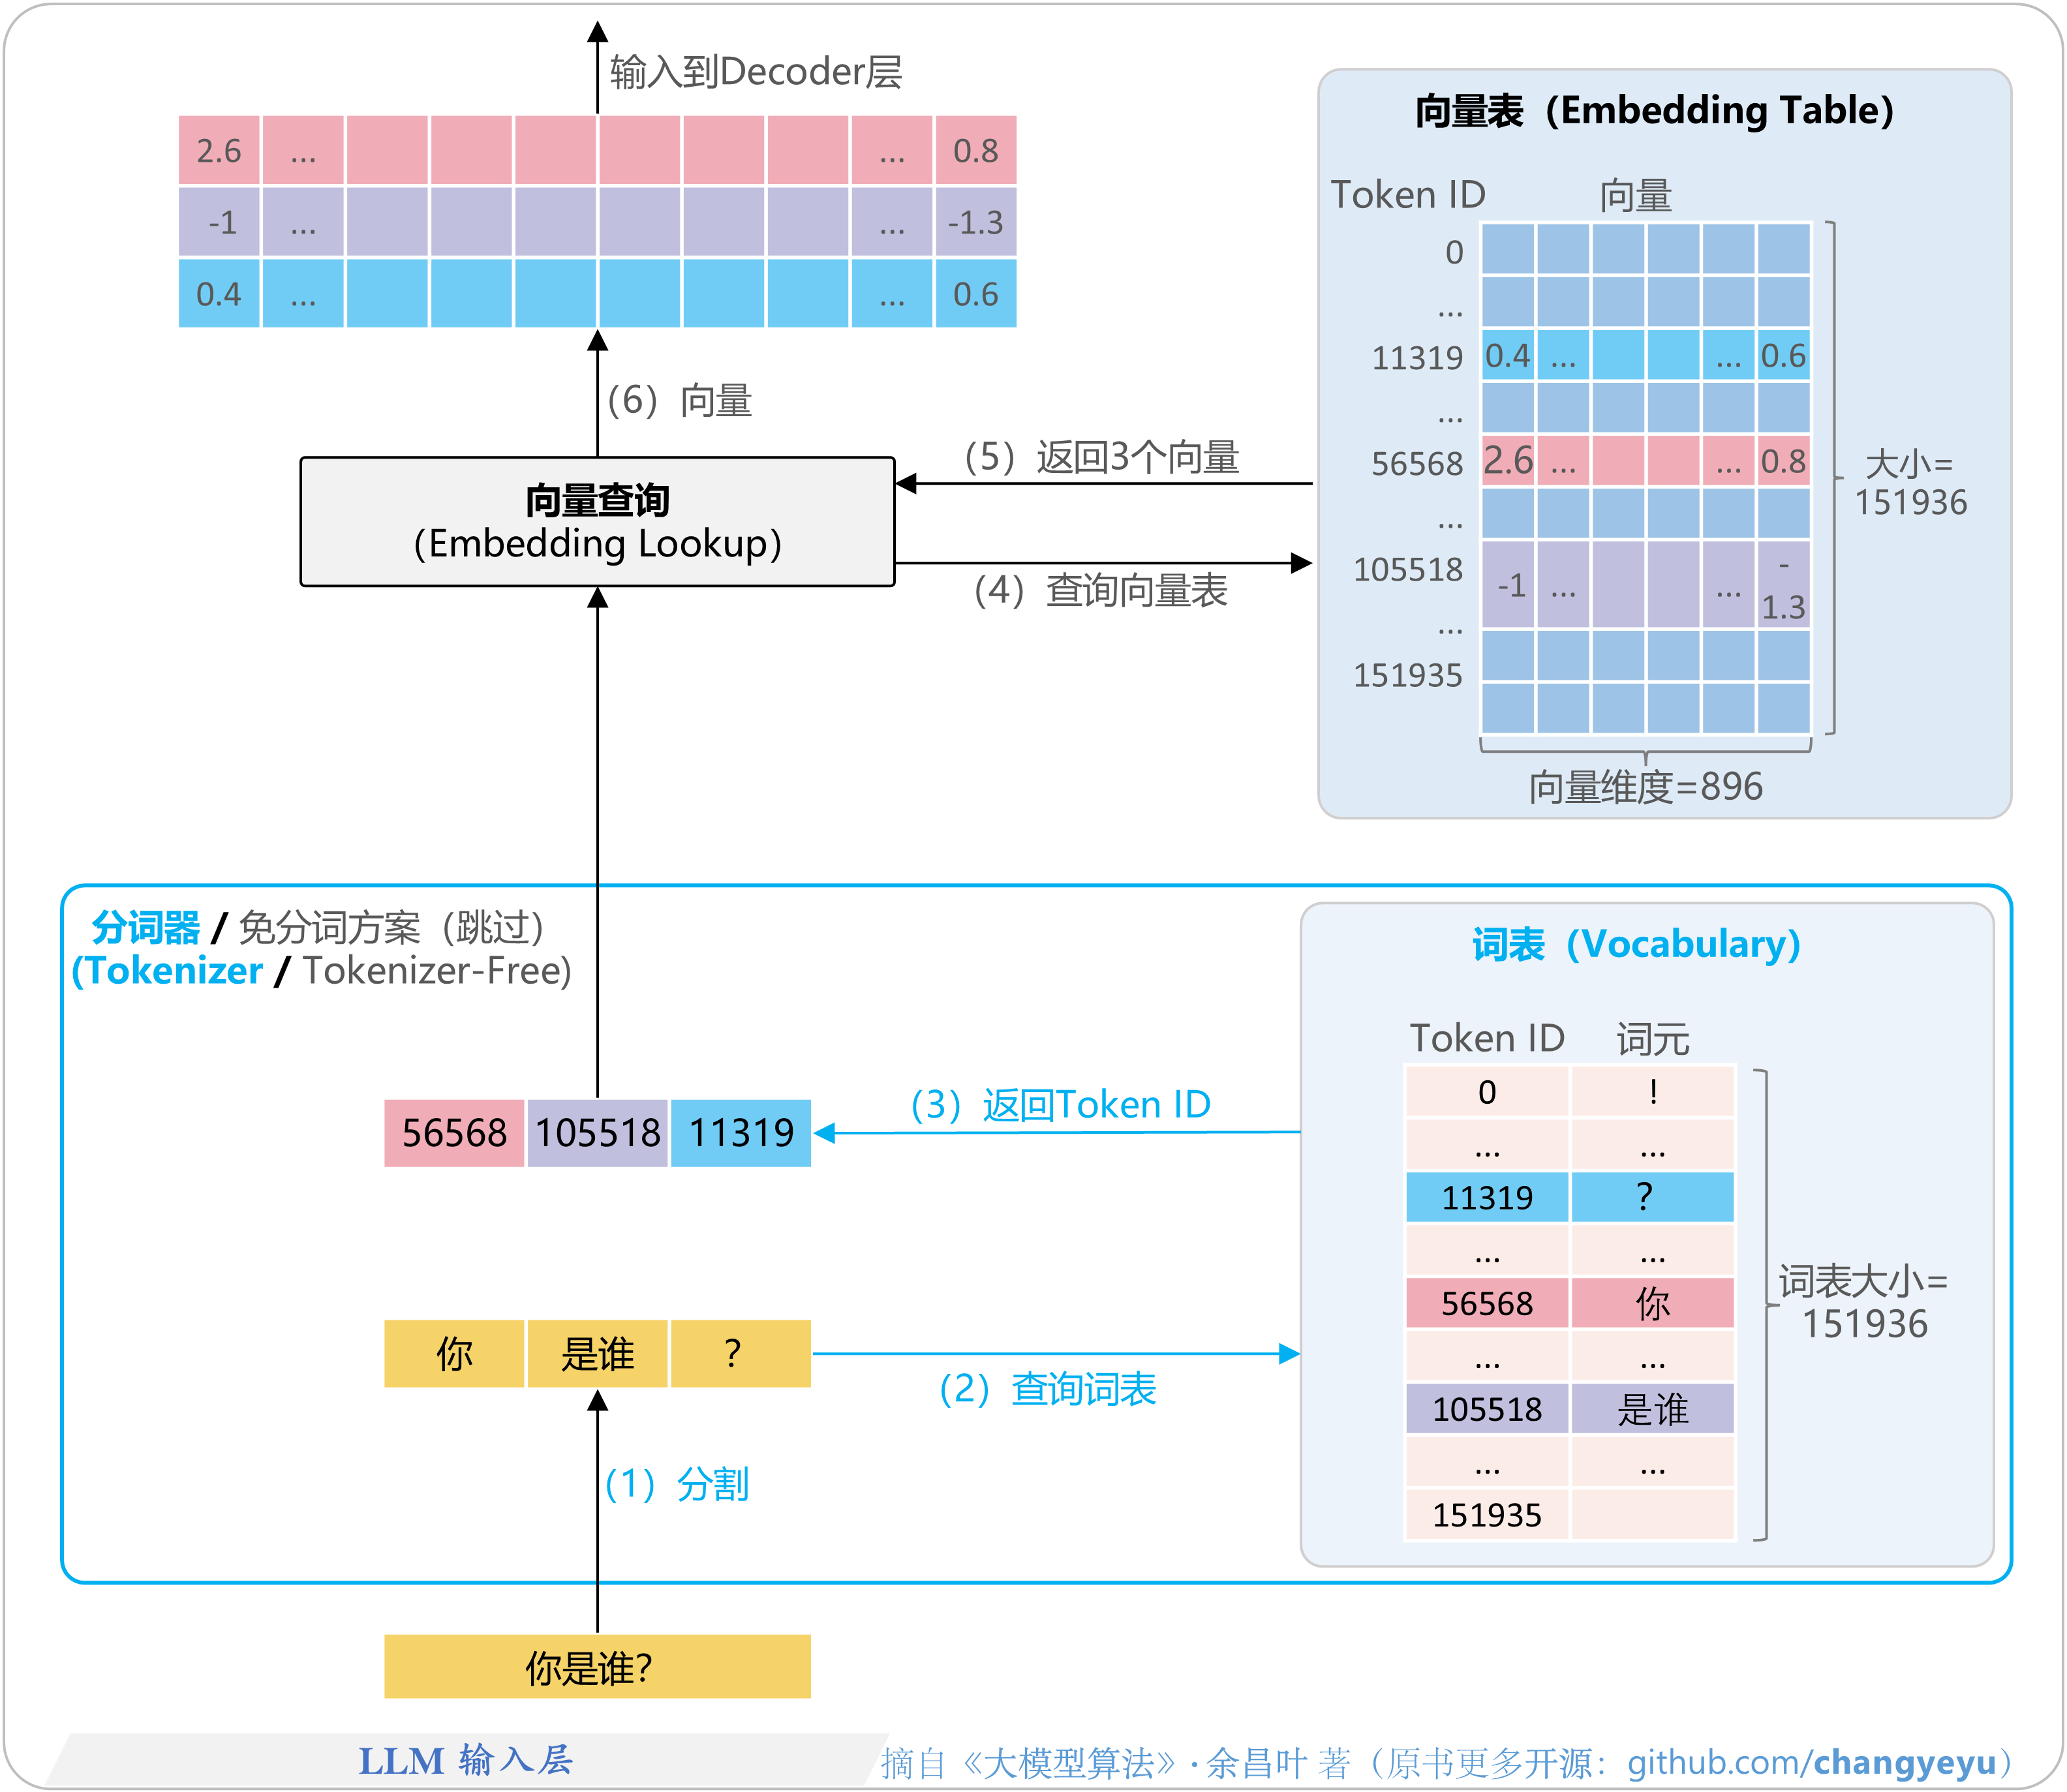
【LLM基础】LLM输出层
LLM的输出层负责根据隐藏状态(多维数值矩阵)预测下一个词元(文本)。处理流程如图所示:
- (1)输入隐藏状态:Decoder最后一层的隐藏状态(Hidden States)作为LLM输出层的输入。如图中所示维度为3×896的数值矩阵,包含了前缀序列的所有语义信息。
- (2)语言模型头(LM Head):通常是一个全连接层,用于将隐藏状态转换为Logits(推理时只计算最后一个位置的Logits)。如图所示,Logits的形状为3×151936,对应于词表中每个词元的得分。
- (3)提取最后位置的Logits:预测下一个词元仅依赖于前缀序列最后一个位置的Logits,因此需要从所有位置的Logits中提取最后一个位置的Logits。如图所示,提取得到一个151936维的向量 [2.0, 3.1, −1.7, ... , −1.7],用于后续预测。
- (4)转换为概率分布(Softmax):通过Softmax函数将Logits转换为概率分布,得到词表中每个词元的概率。例如,生成的151936维概率向量为[0.01, 0.03, 0.001, ... , 0.001],该向量内所有概率之和为1。概率值越大,表示该词元作为下一个词元的可能性越高。例如,“我”的概率为0.34。
- (5)解码(Decoding):根据概率分布,应用解码策略(例如随机采样或选择最大概率)确定最终预测的下一个词元。例如,在贪婪搜索解码策略下,选择概率最高的词元“我”作为预测结果。

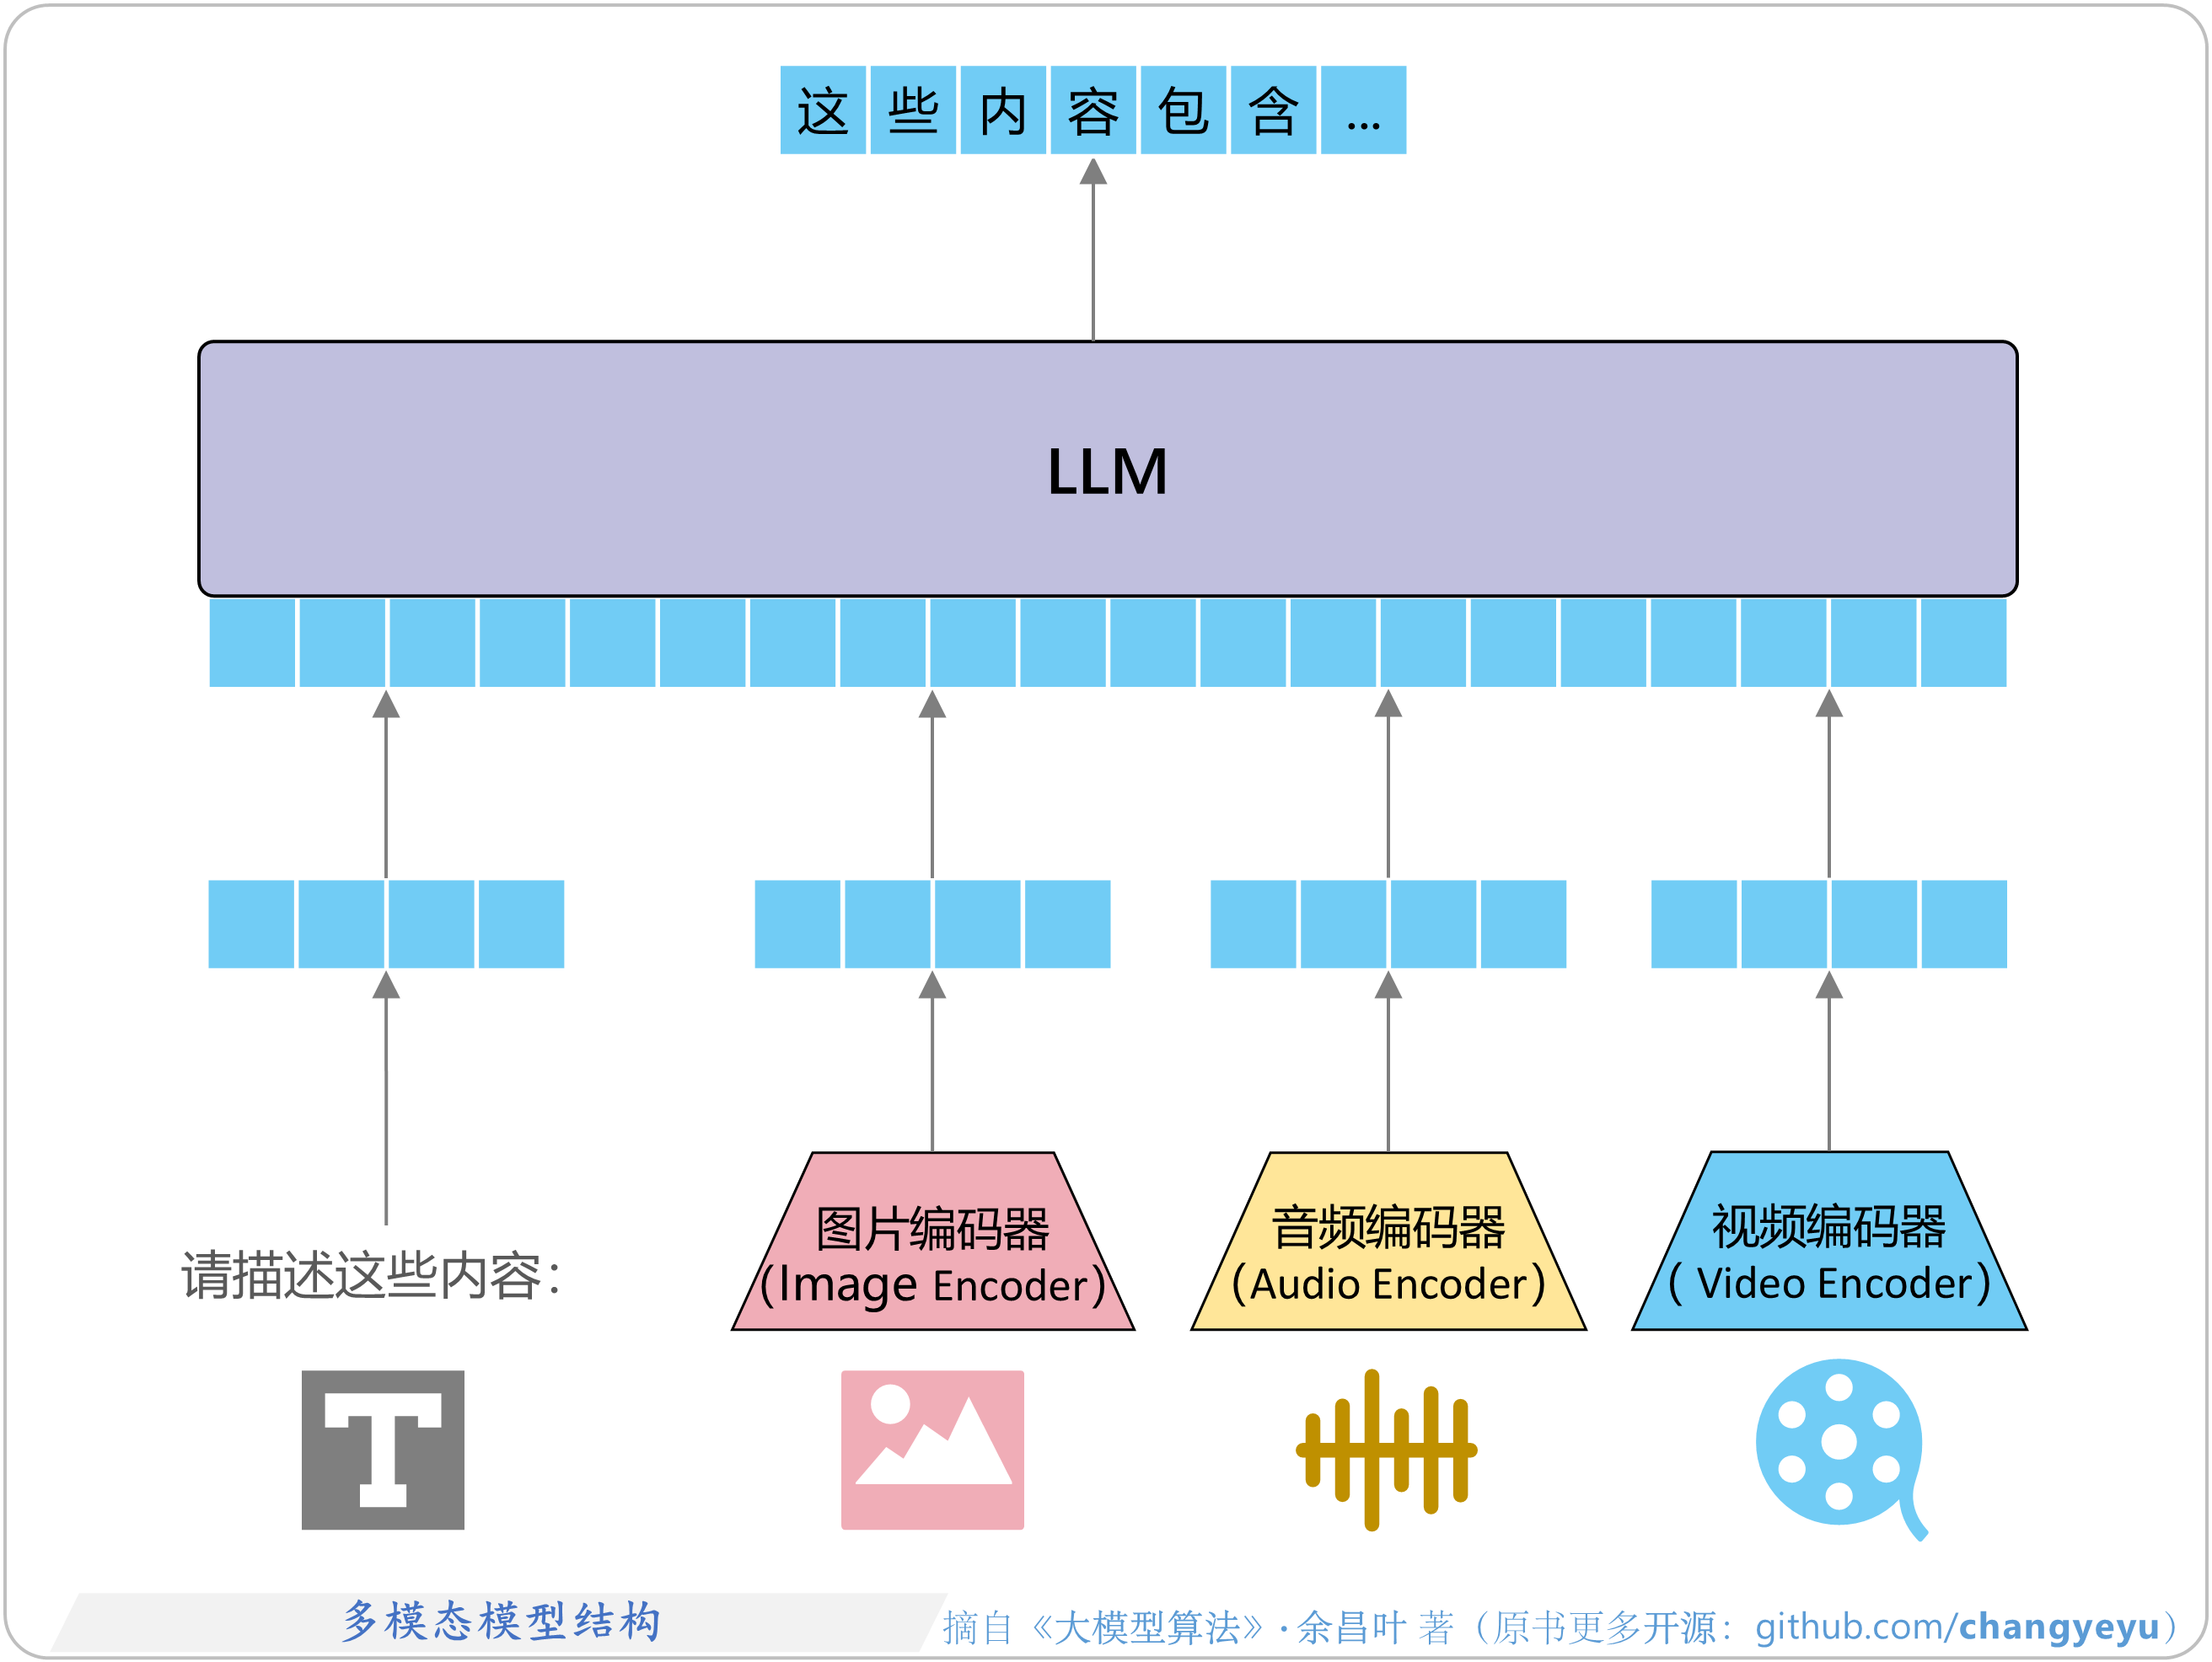
【LLM基础】多模态模型结构(VLM、MLLM ...)
多模态模型根据侧重不同,通常有以下多种称呼:
- VLM(Vision-Language Model,视觉语言模型)
- MLLM(Multimodal Large Language Model,多模态大语言模型)
- VLA(Vision-Language-Action Model,视觉语言动作模型)

【LLM基础】LLM训练流程
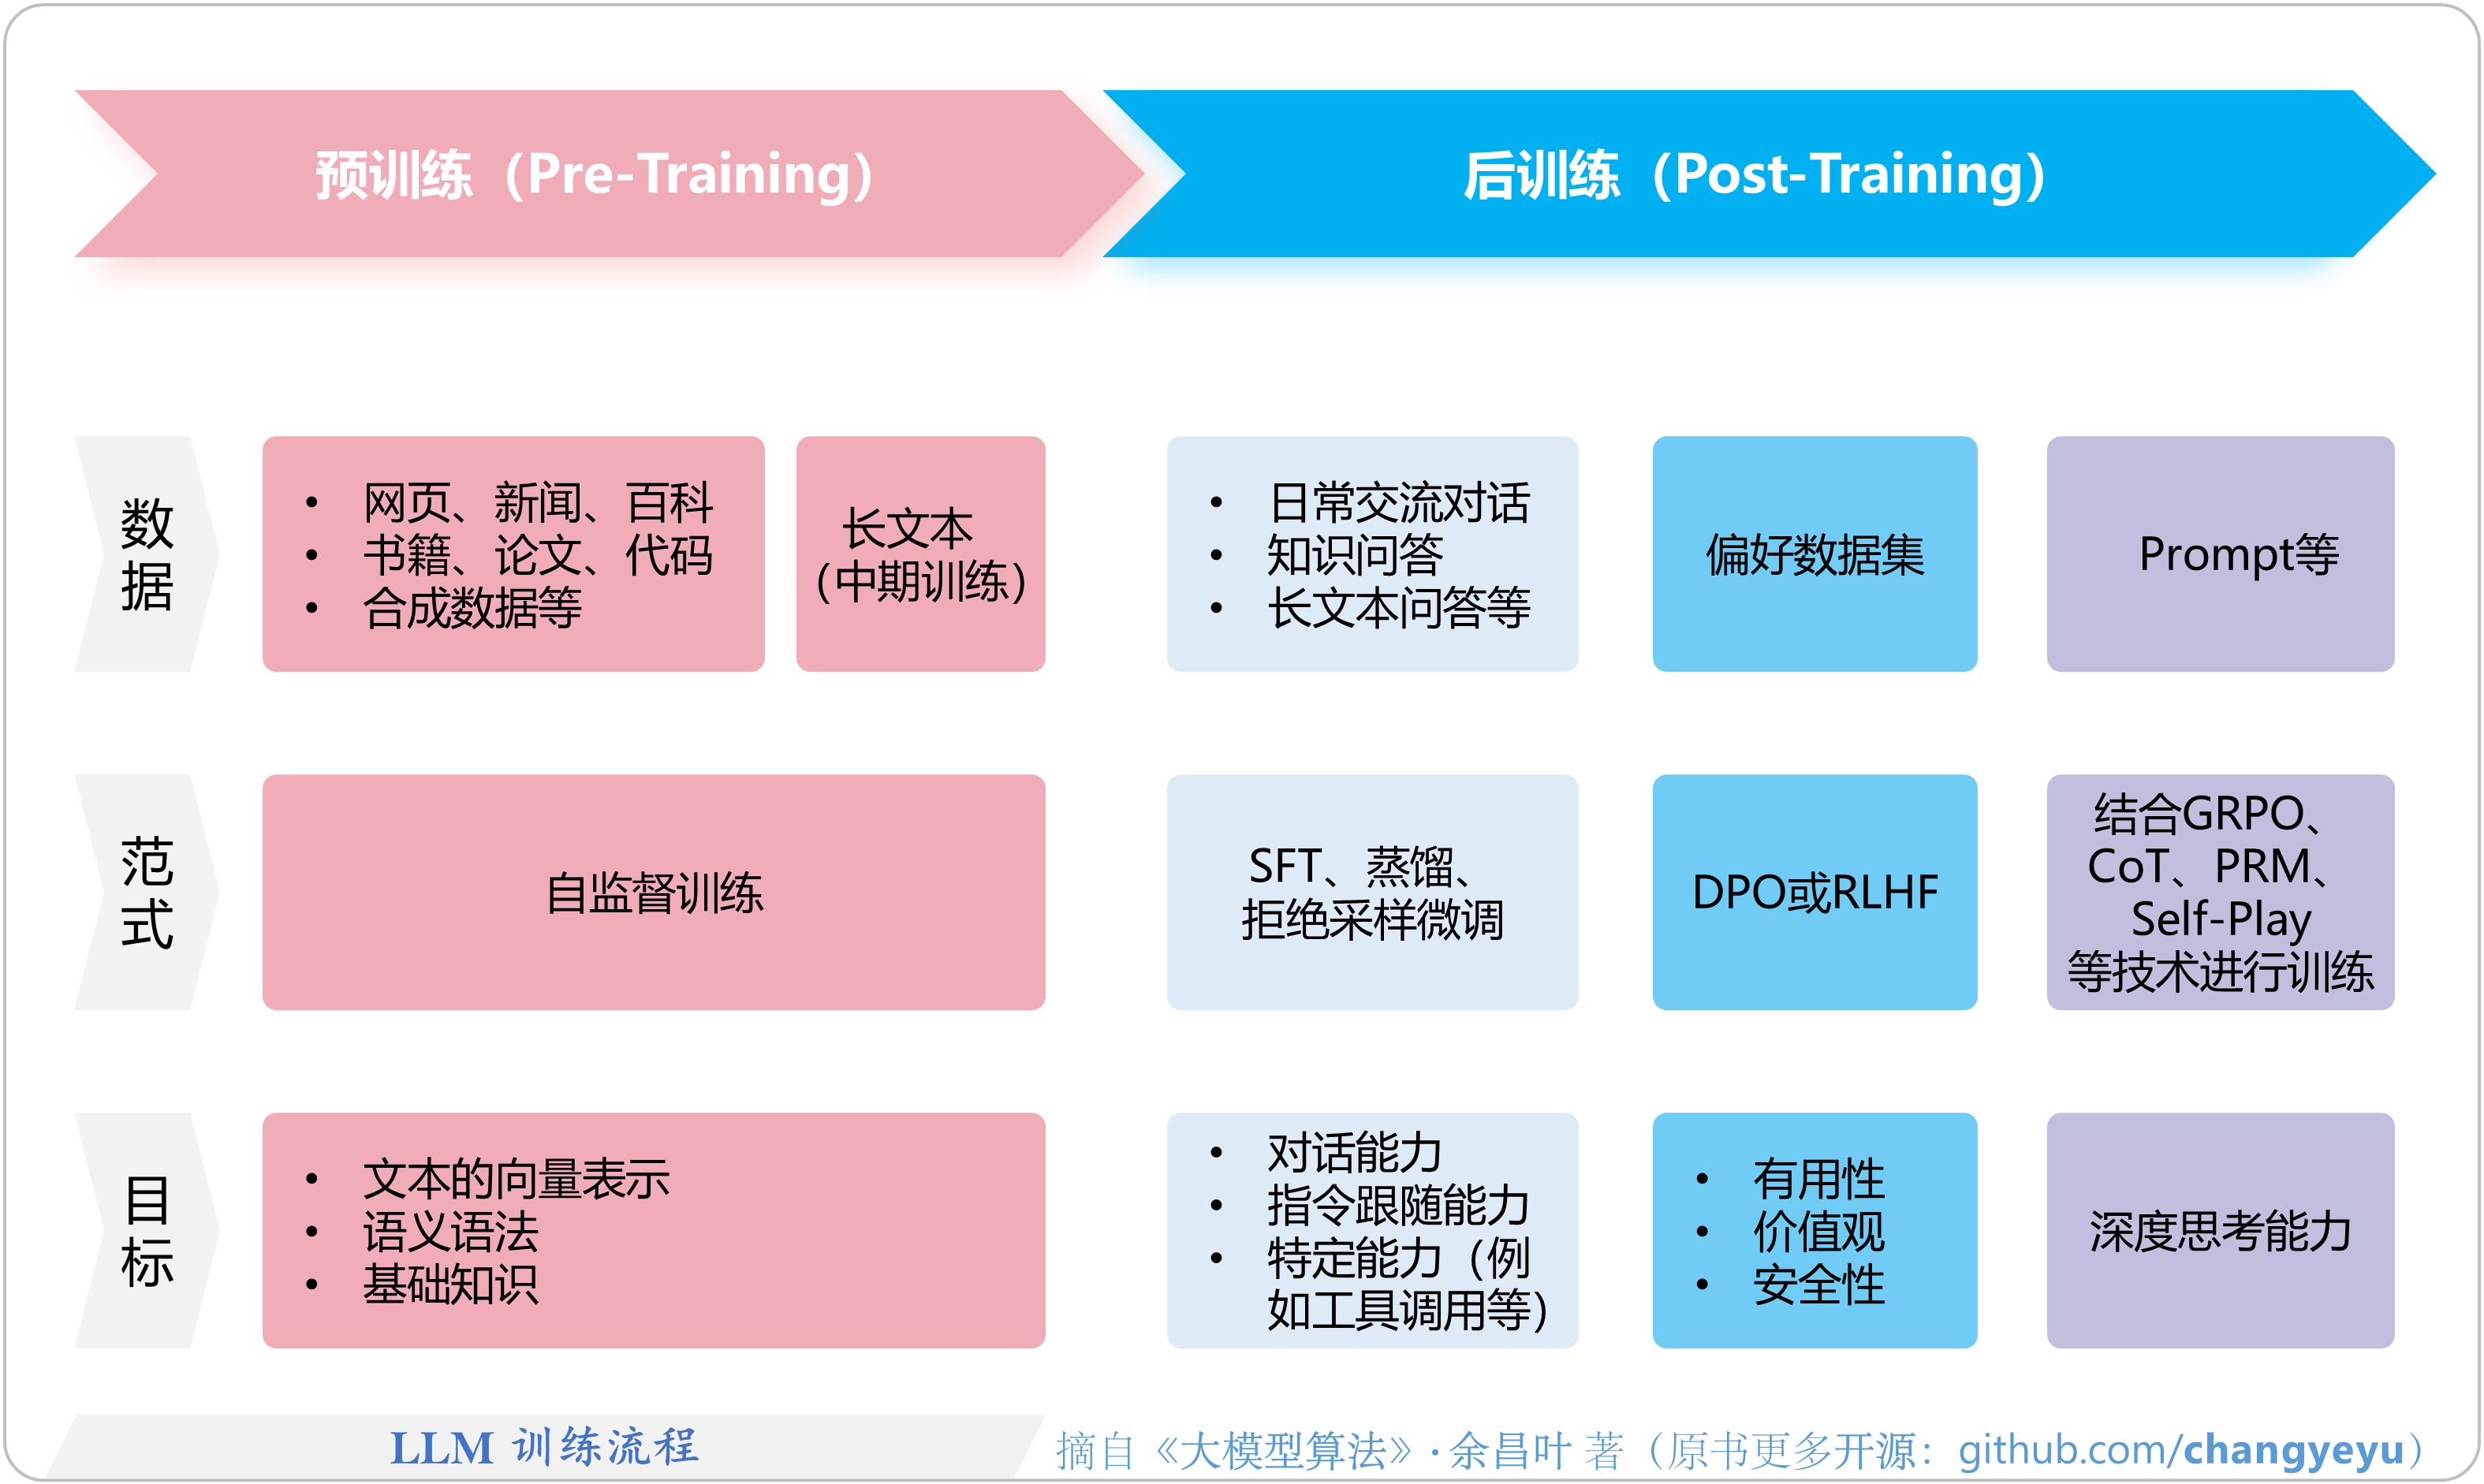
- 大模型的训练主要分为两个阶段——预训练(Pre-Training)和后训练(Post-Training)。在每个阶段,所使用的训练数据、训练范式(算法)、训练目标和超参数均有所不同。
- 预训练阶段包括初期训练(基于海量数据的短上下文训练)、中期训练(长文本/长上下文训练)以及退火(Annealing)训练等。此阶段以自监督学习为主,使用的数据量最大,同时也是最消耗算力的环节。
- 后训练阶段则包含多种可选的训练范式(算法),包括但不限于SFT(监督微调)、蒸馏、RSFT(拒绝采样微调)、RLHF(基于人类反馈的强化学习)、DPO(直接偏好优化),以及其他强化学习方法,例如GRPO(群体相对策略优化)、PPO(近端策略优化)等。其中,某些环节也可进行多轮迭代训练,例如多轮拒绝采样微调(Rejection Sampling Fine-Tuning, RSFT)。

【SFT】微调(Fine-Tuning)技术分类
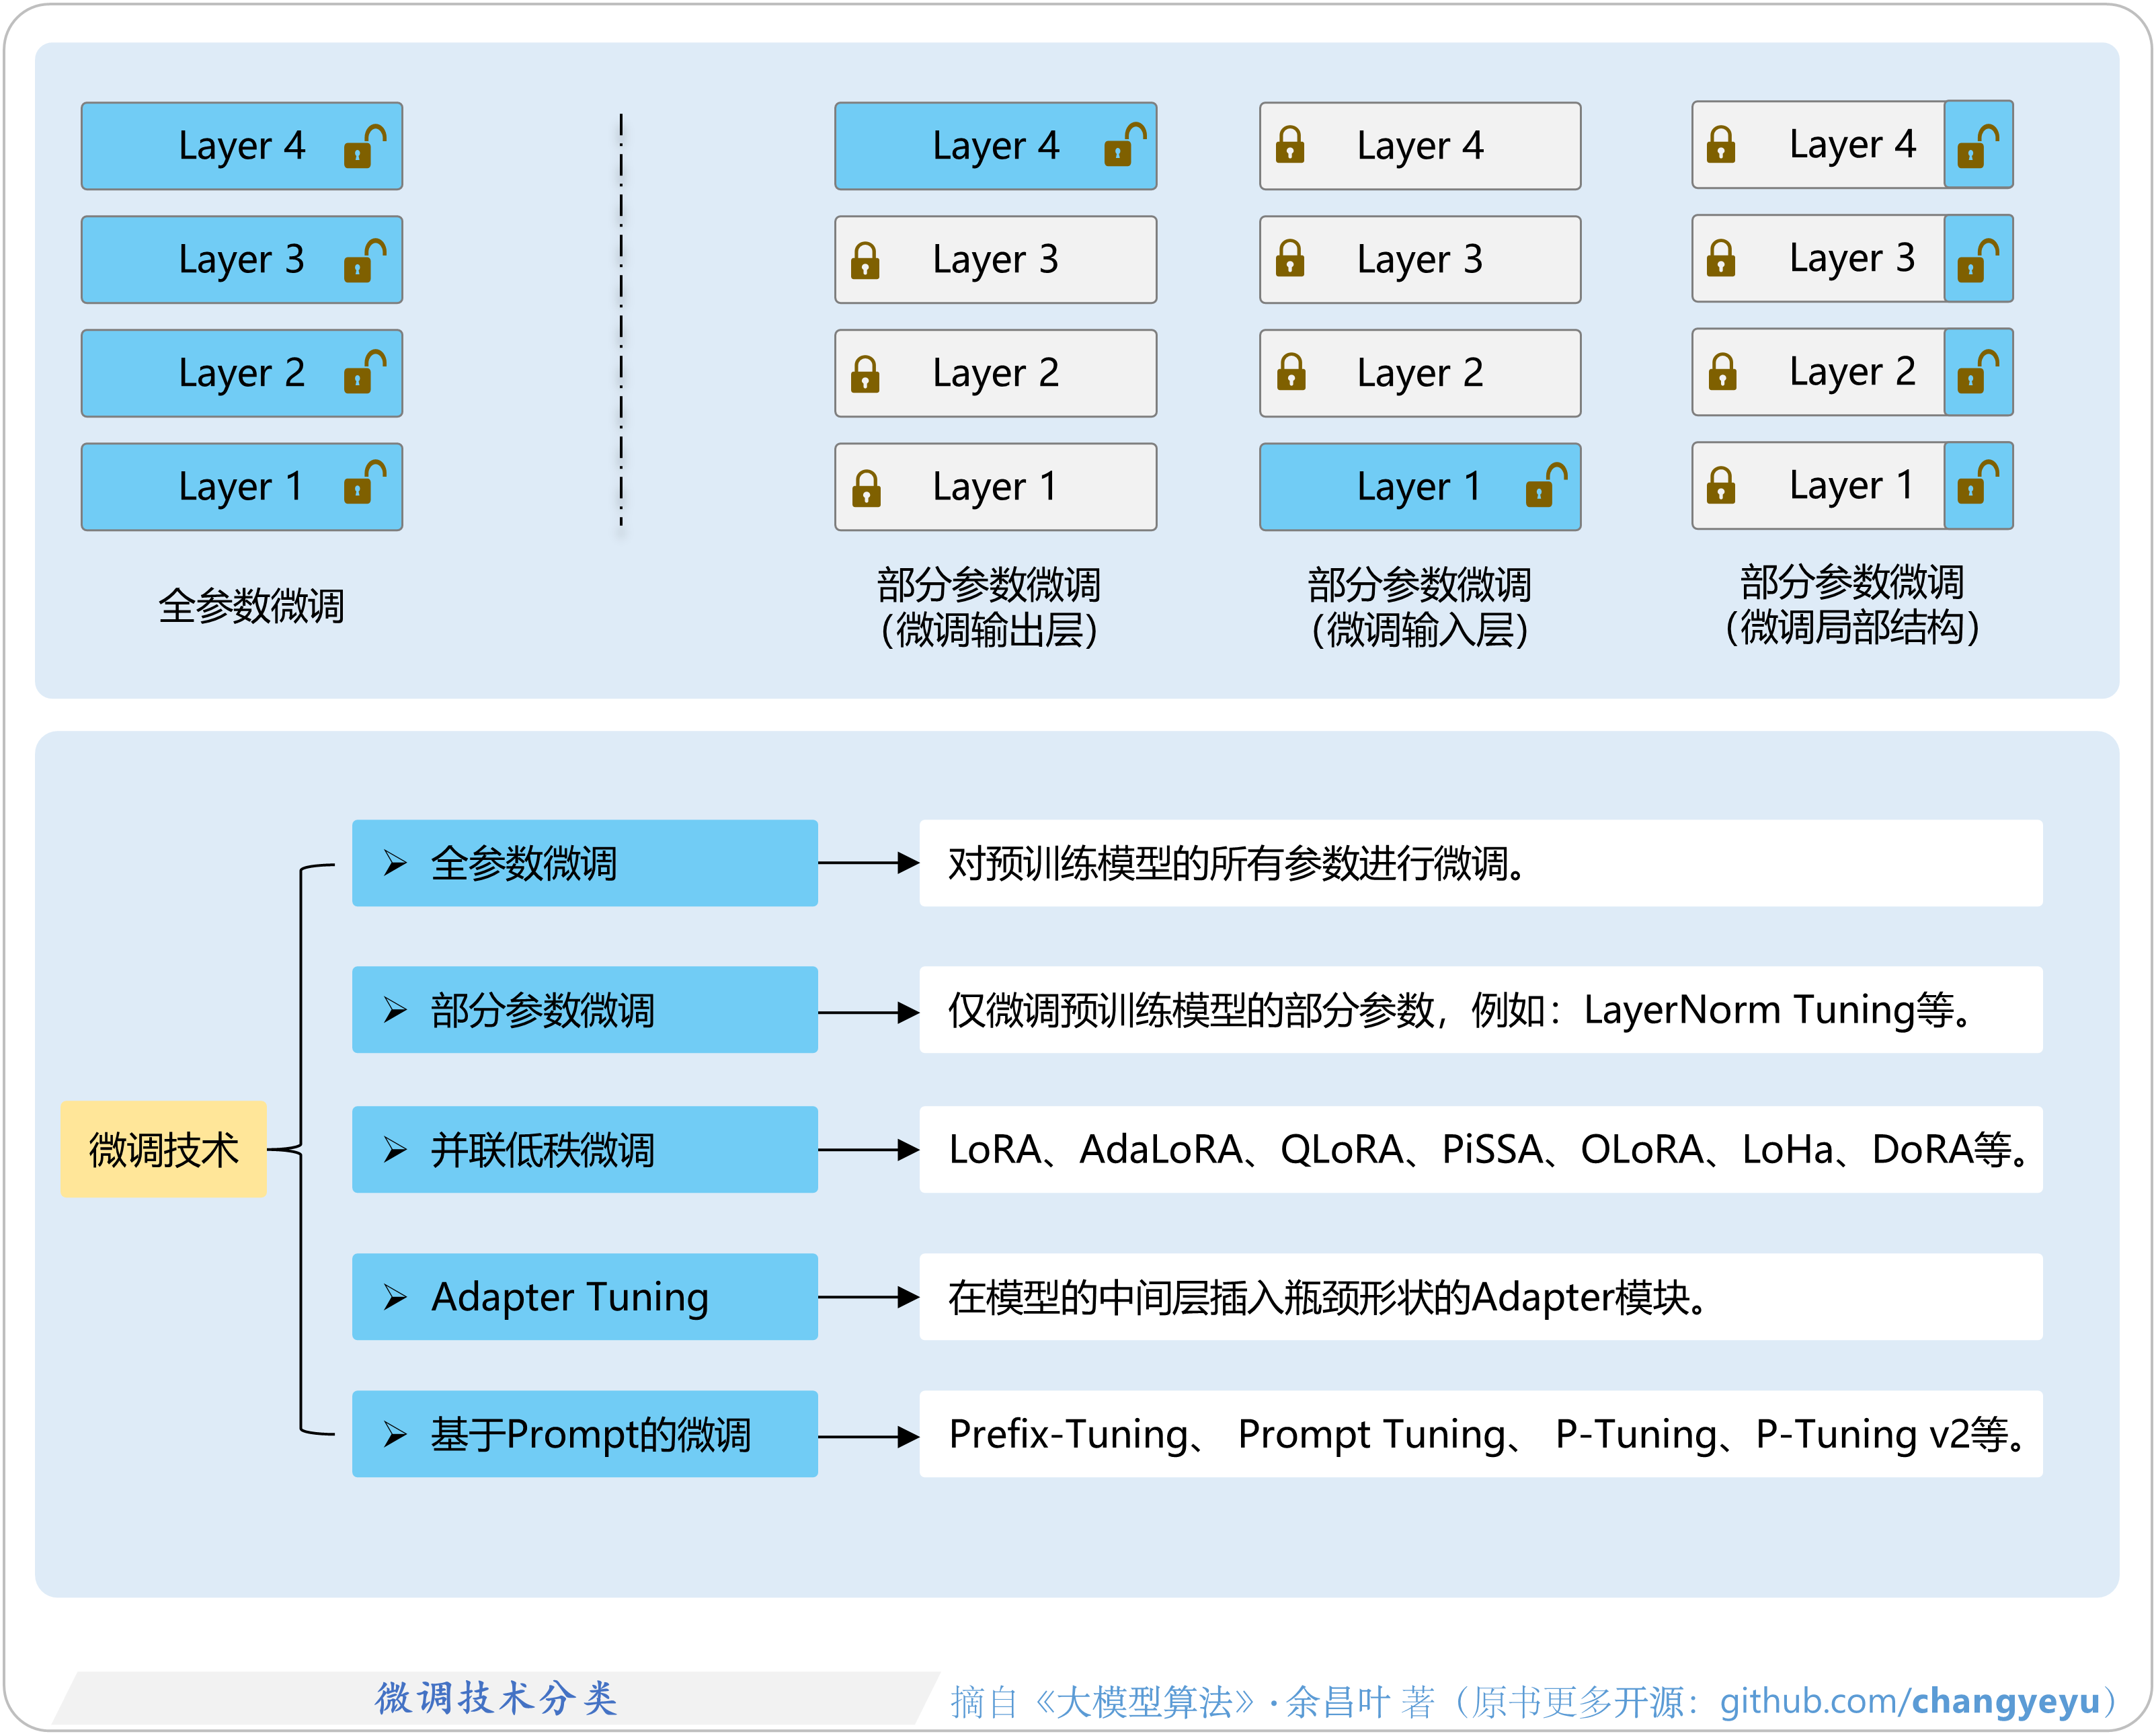
- 可用于SFT的微调技术种类多样,如下图的分类图所示:前两种方法仅需基于预训练模型主体进行微调,开发成本较低;而并联低秩微调和Adapter Tuning则需要引入额外的新模块,实施过程相对复杂一些。这些方法均是针对模型参数进行微调,而基于Prompt的微调则另辟蹊径,从模型的输入着手进行微调。

【SFT】LoRA(1 of 2)
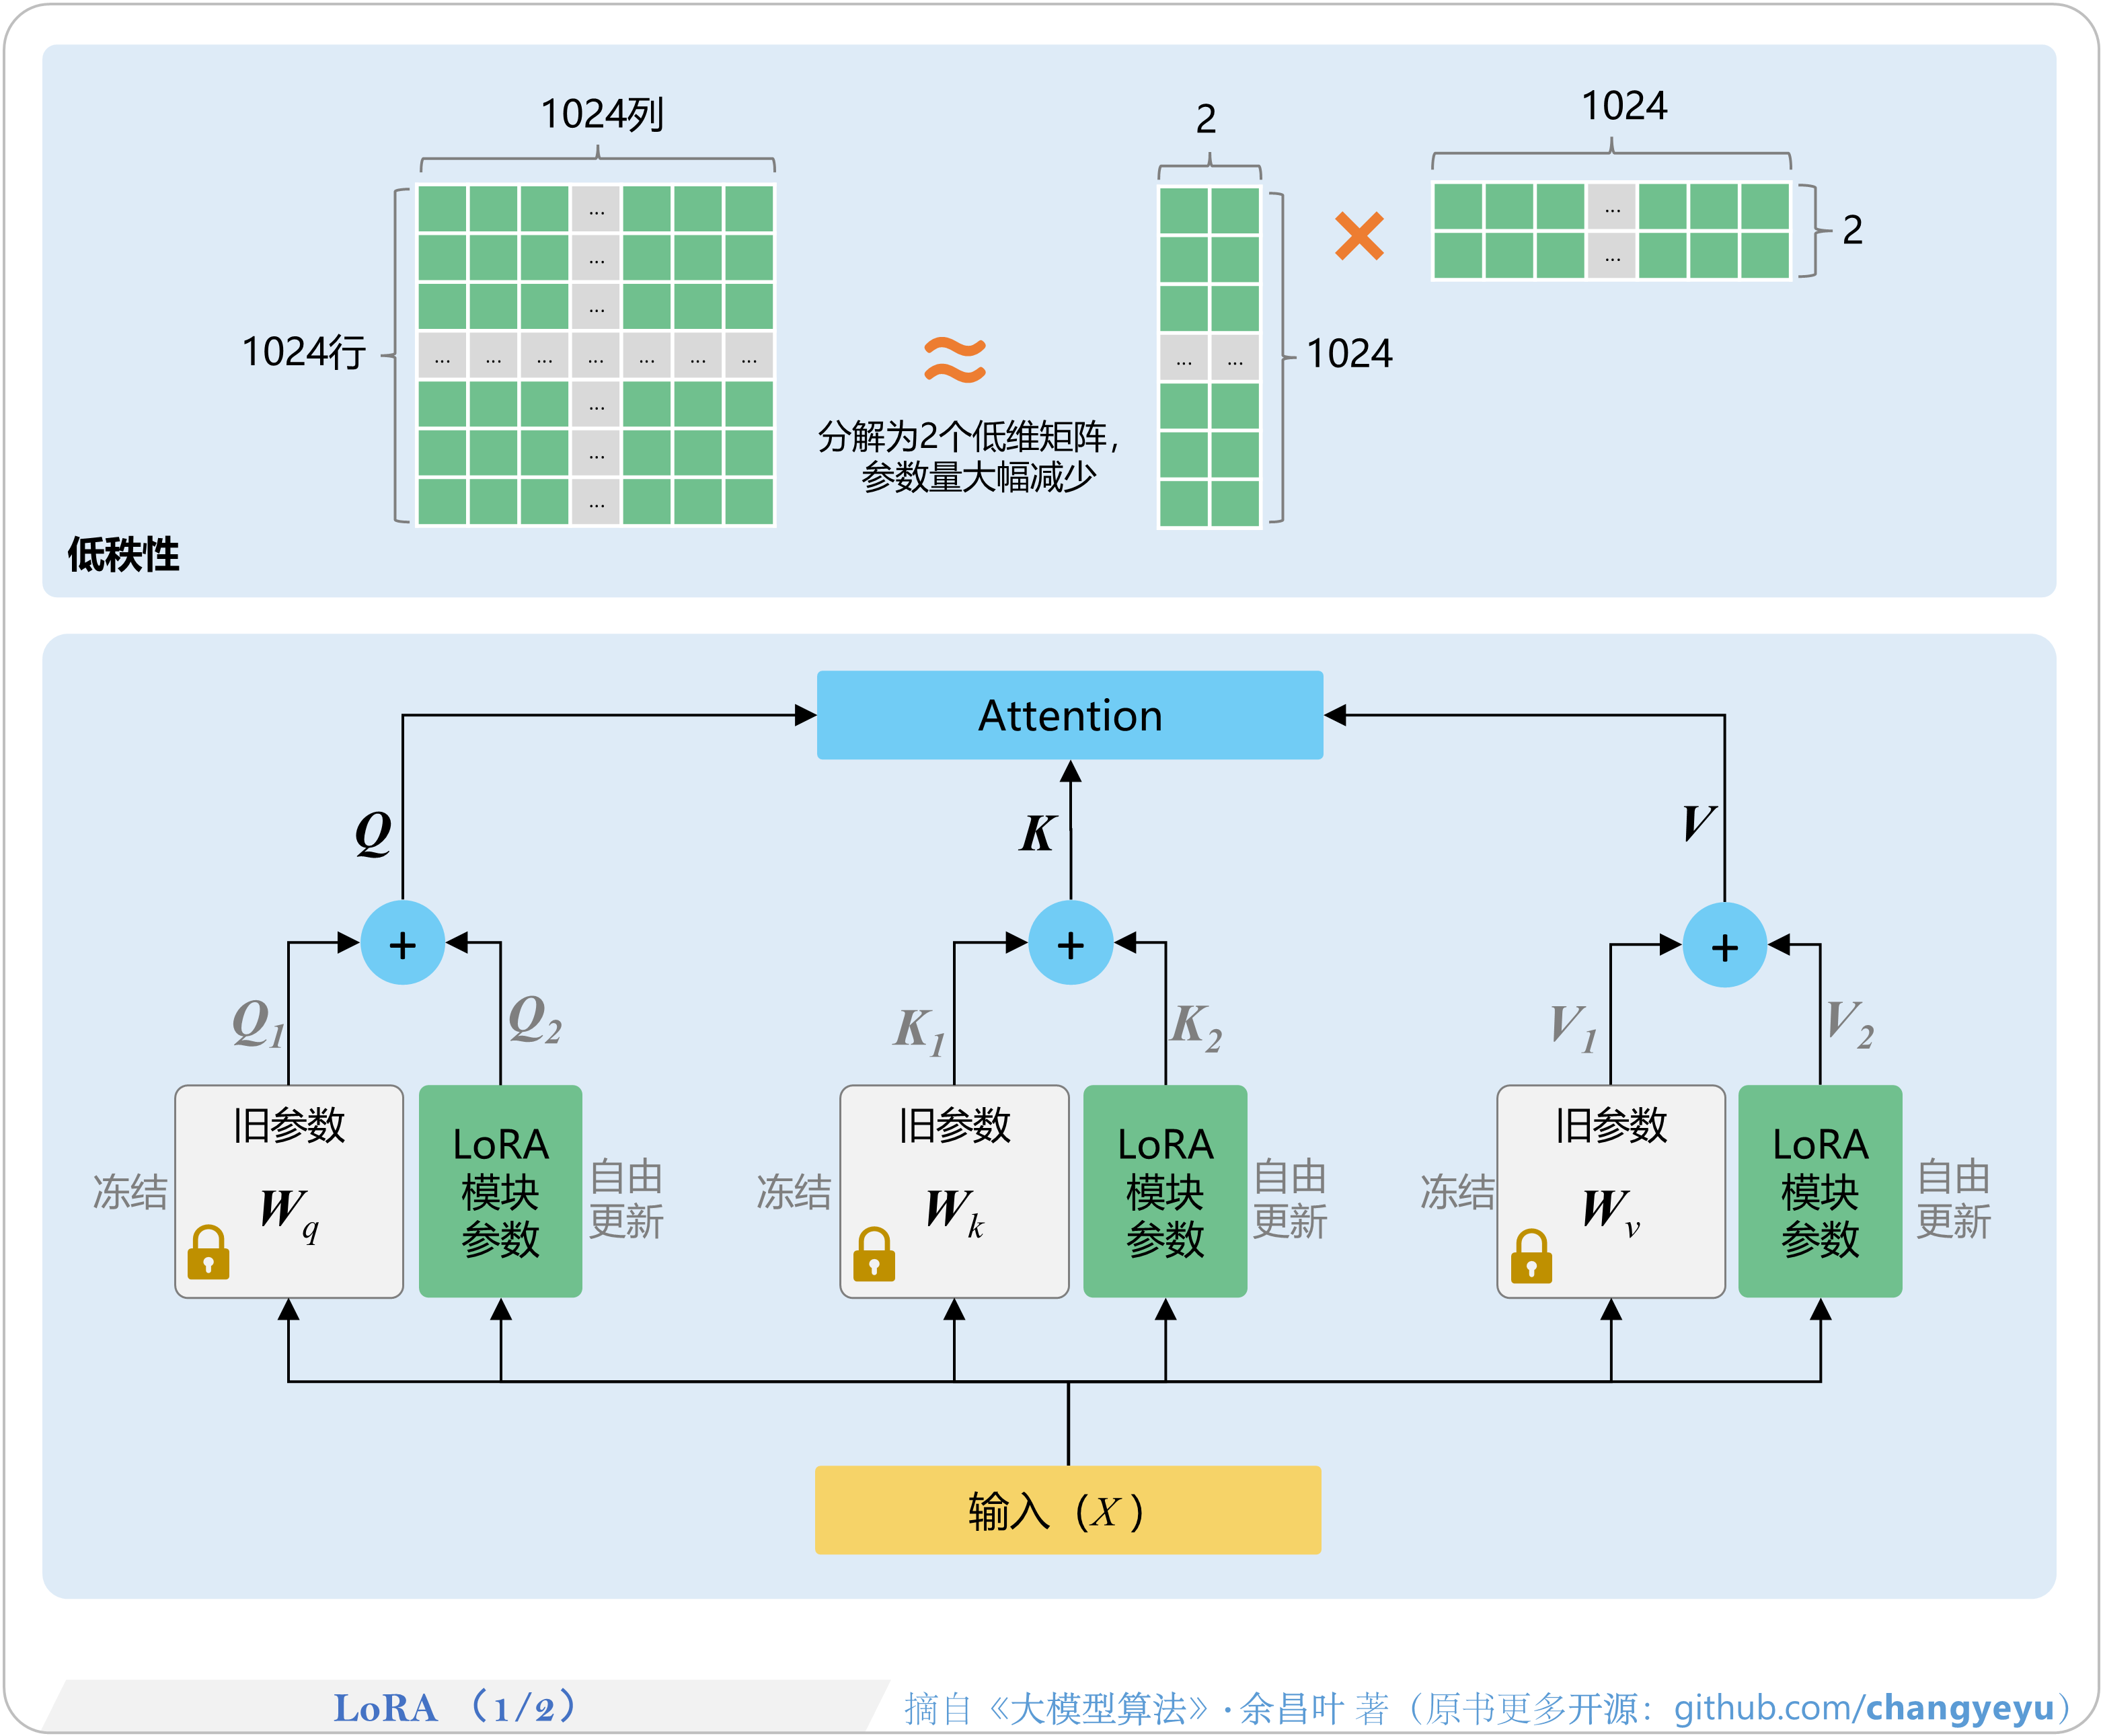
- LoRA(Low-Rank Adaptation, 低秩适配微调)由微软的研究团队于2021年发表。由于其高效的微调方式和良好的效果,在各类模型中得到广泛的应用。LoRA的核心思想在于——微调前后模型的参数差异∆W具有低秩性。
- 一个矩阵具有低秩性,意味着它包含较多的冗余信息,将其分解为多个低维矩阵后,不会损失过多有用信息。例如,如图所示,一个1024×1024的矩阵可以被近似分解为一个1024×2矩阵与一个2×1024矩阵的乘积,从而将参数量约减少至原来的0.4%。
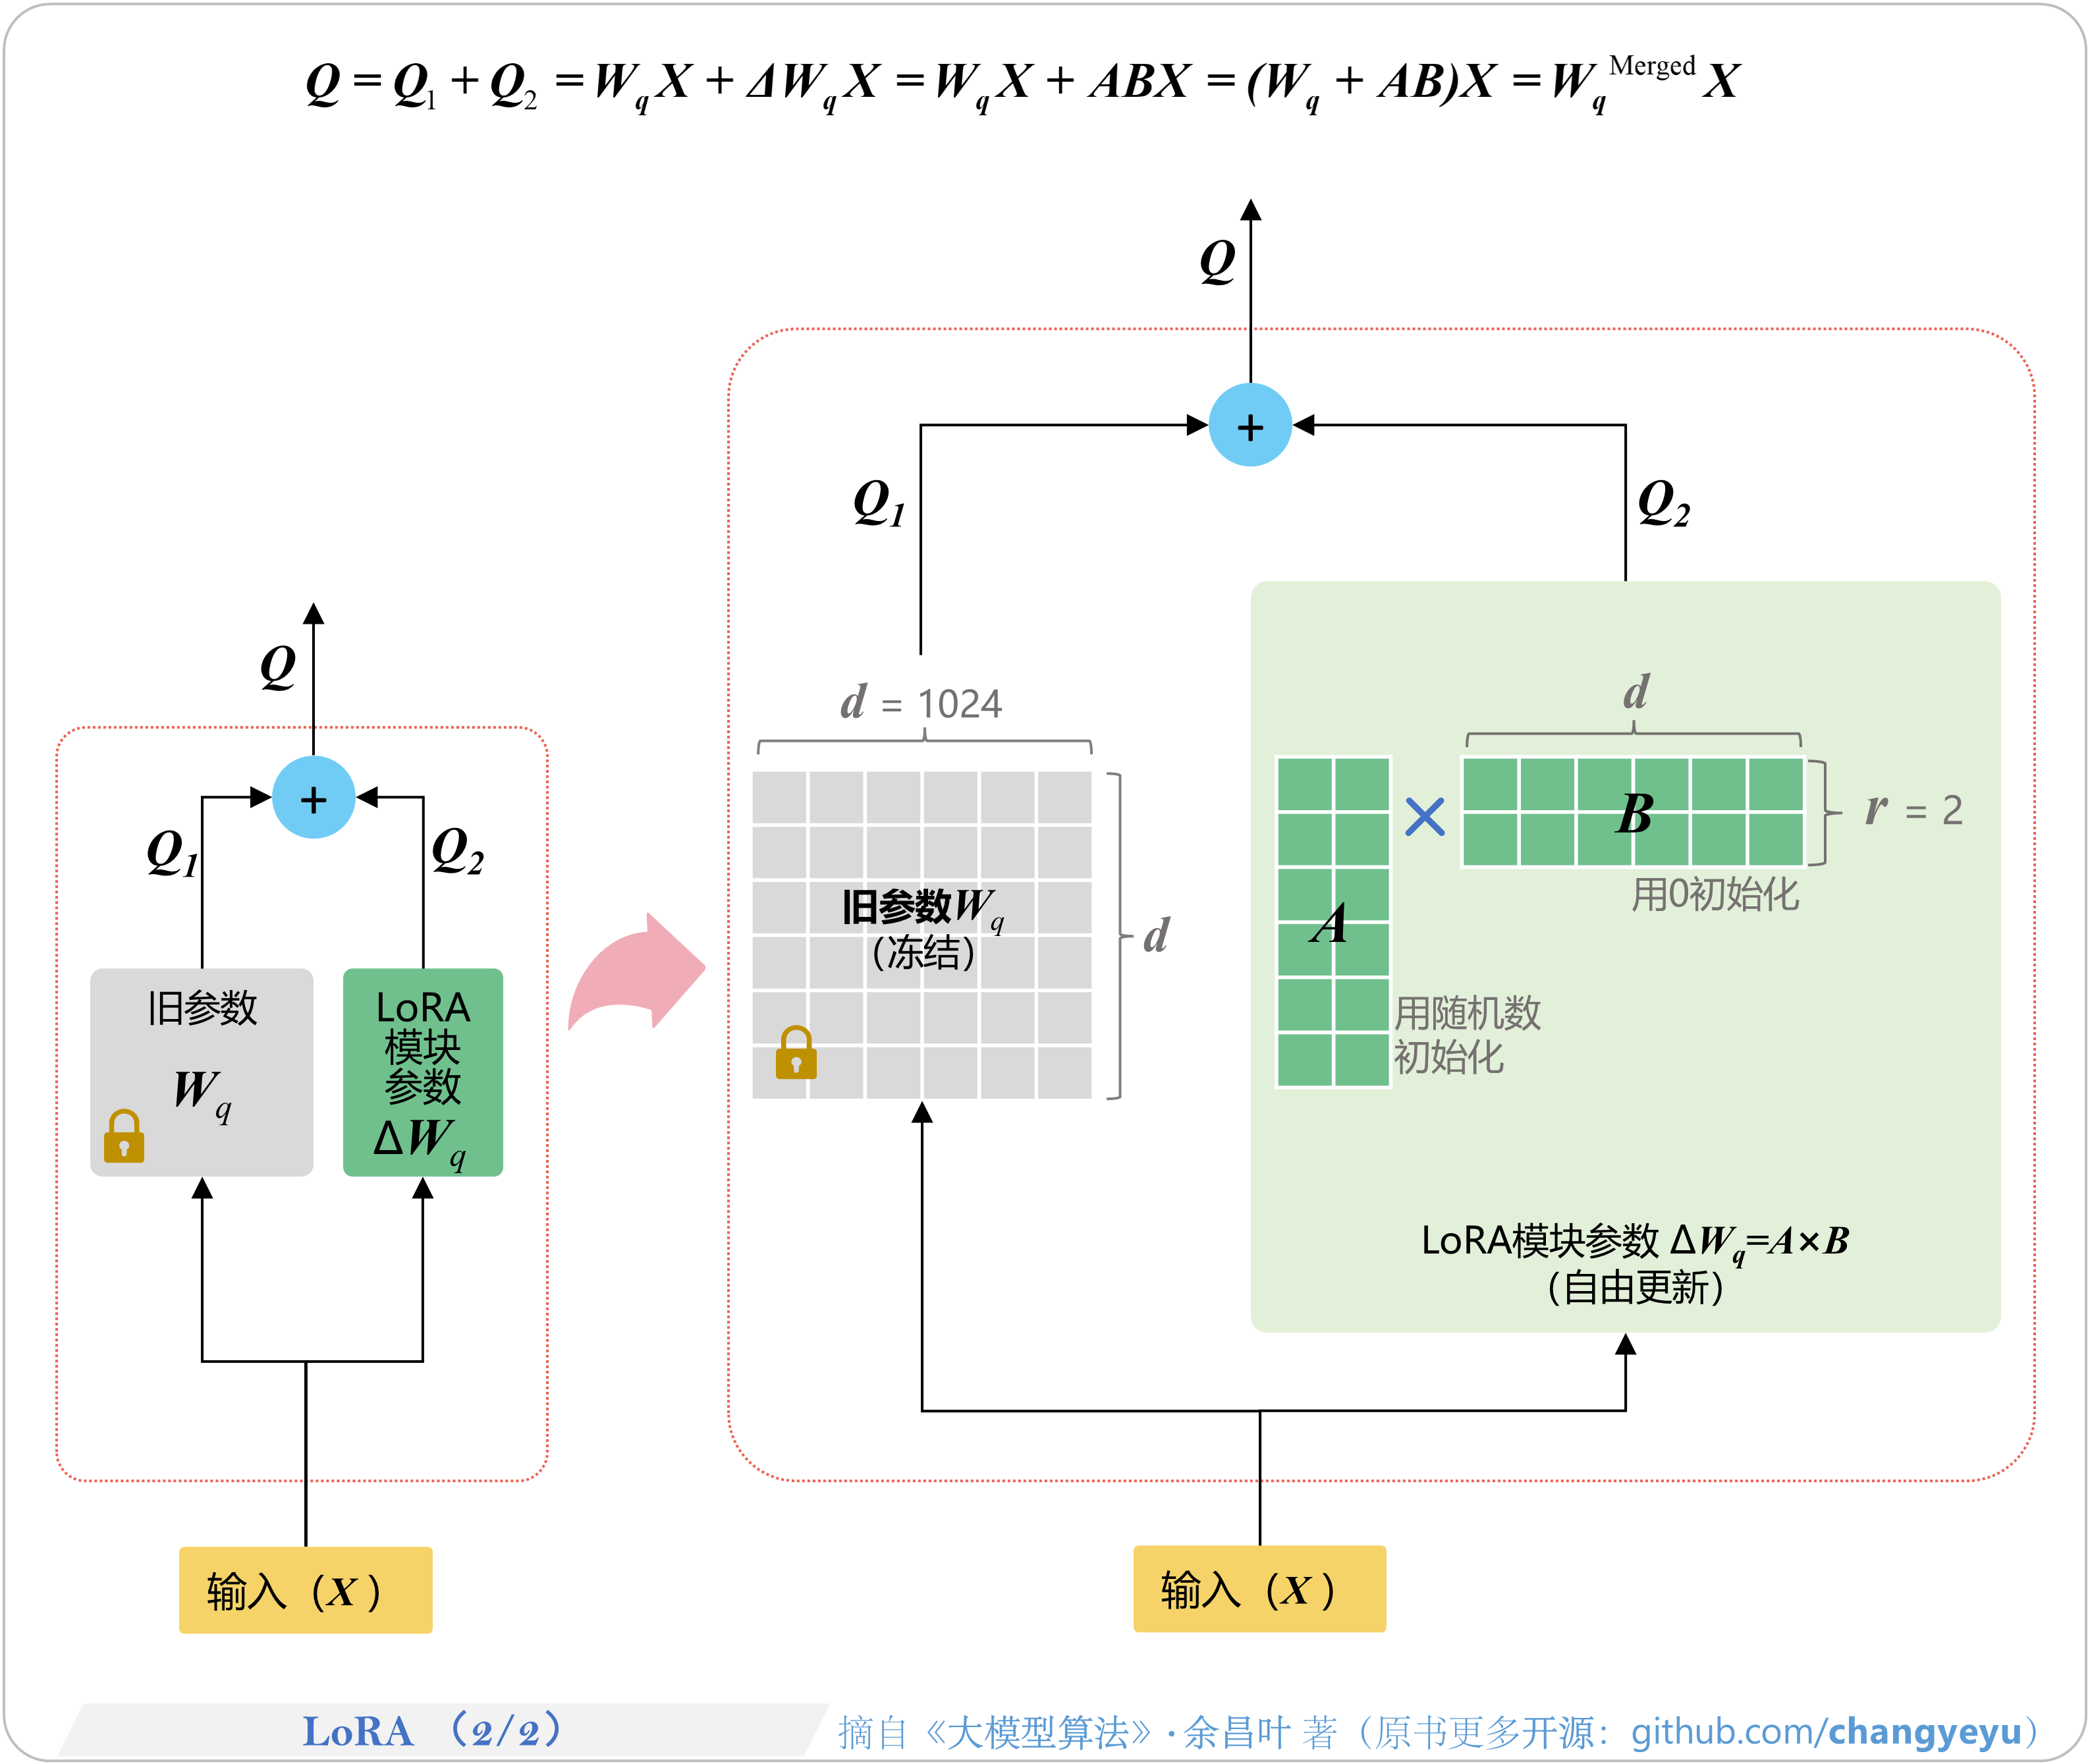
【SFT】LoRA(2 of 2)
- A和B的初始化方式:
- (1)矩阵A使用随机数初始化,如kaiming初始化;
- (2)矩阵B使用全0初始化,或使用极小的随机数初始化。
- 目的在于——确保在训练初期,插入的LoRA模块不会对模型整体输出造成过大的扰动。

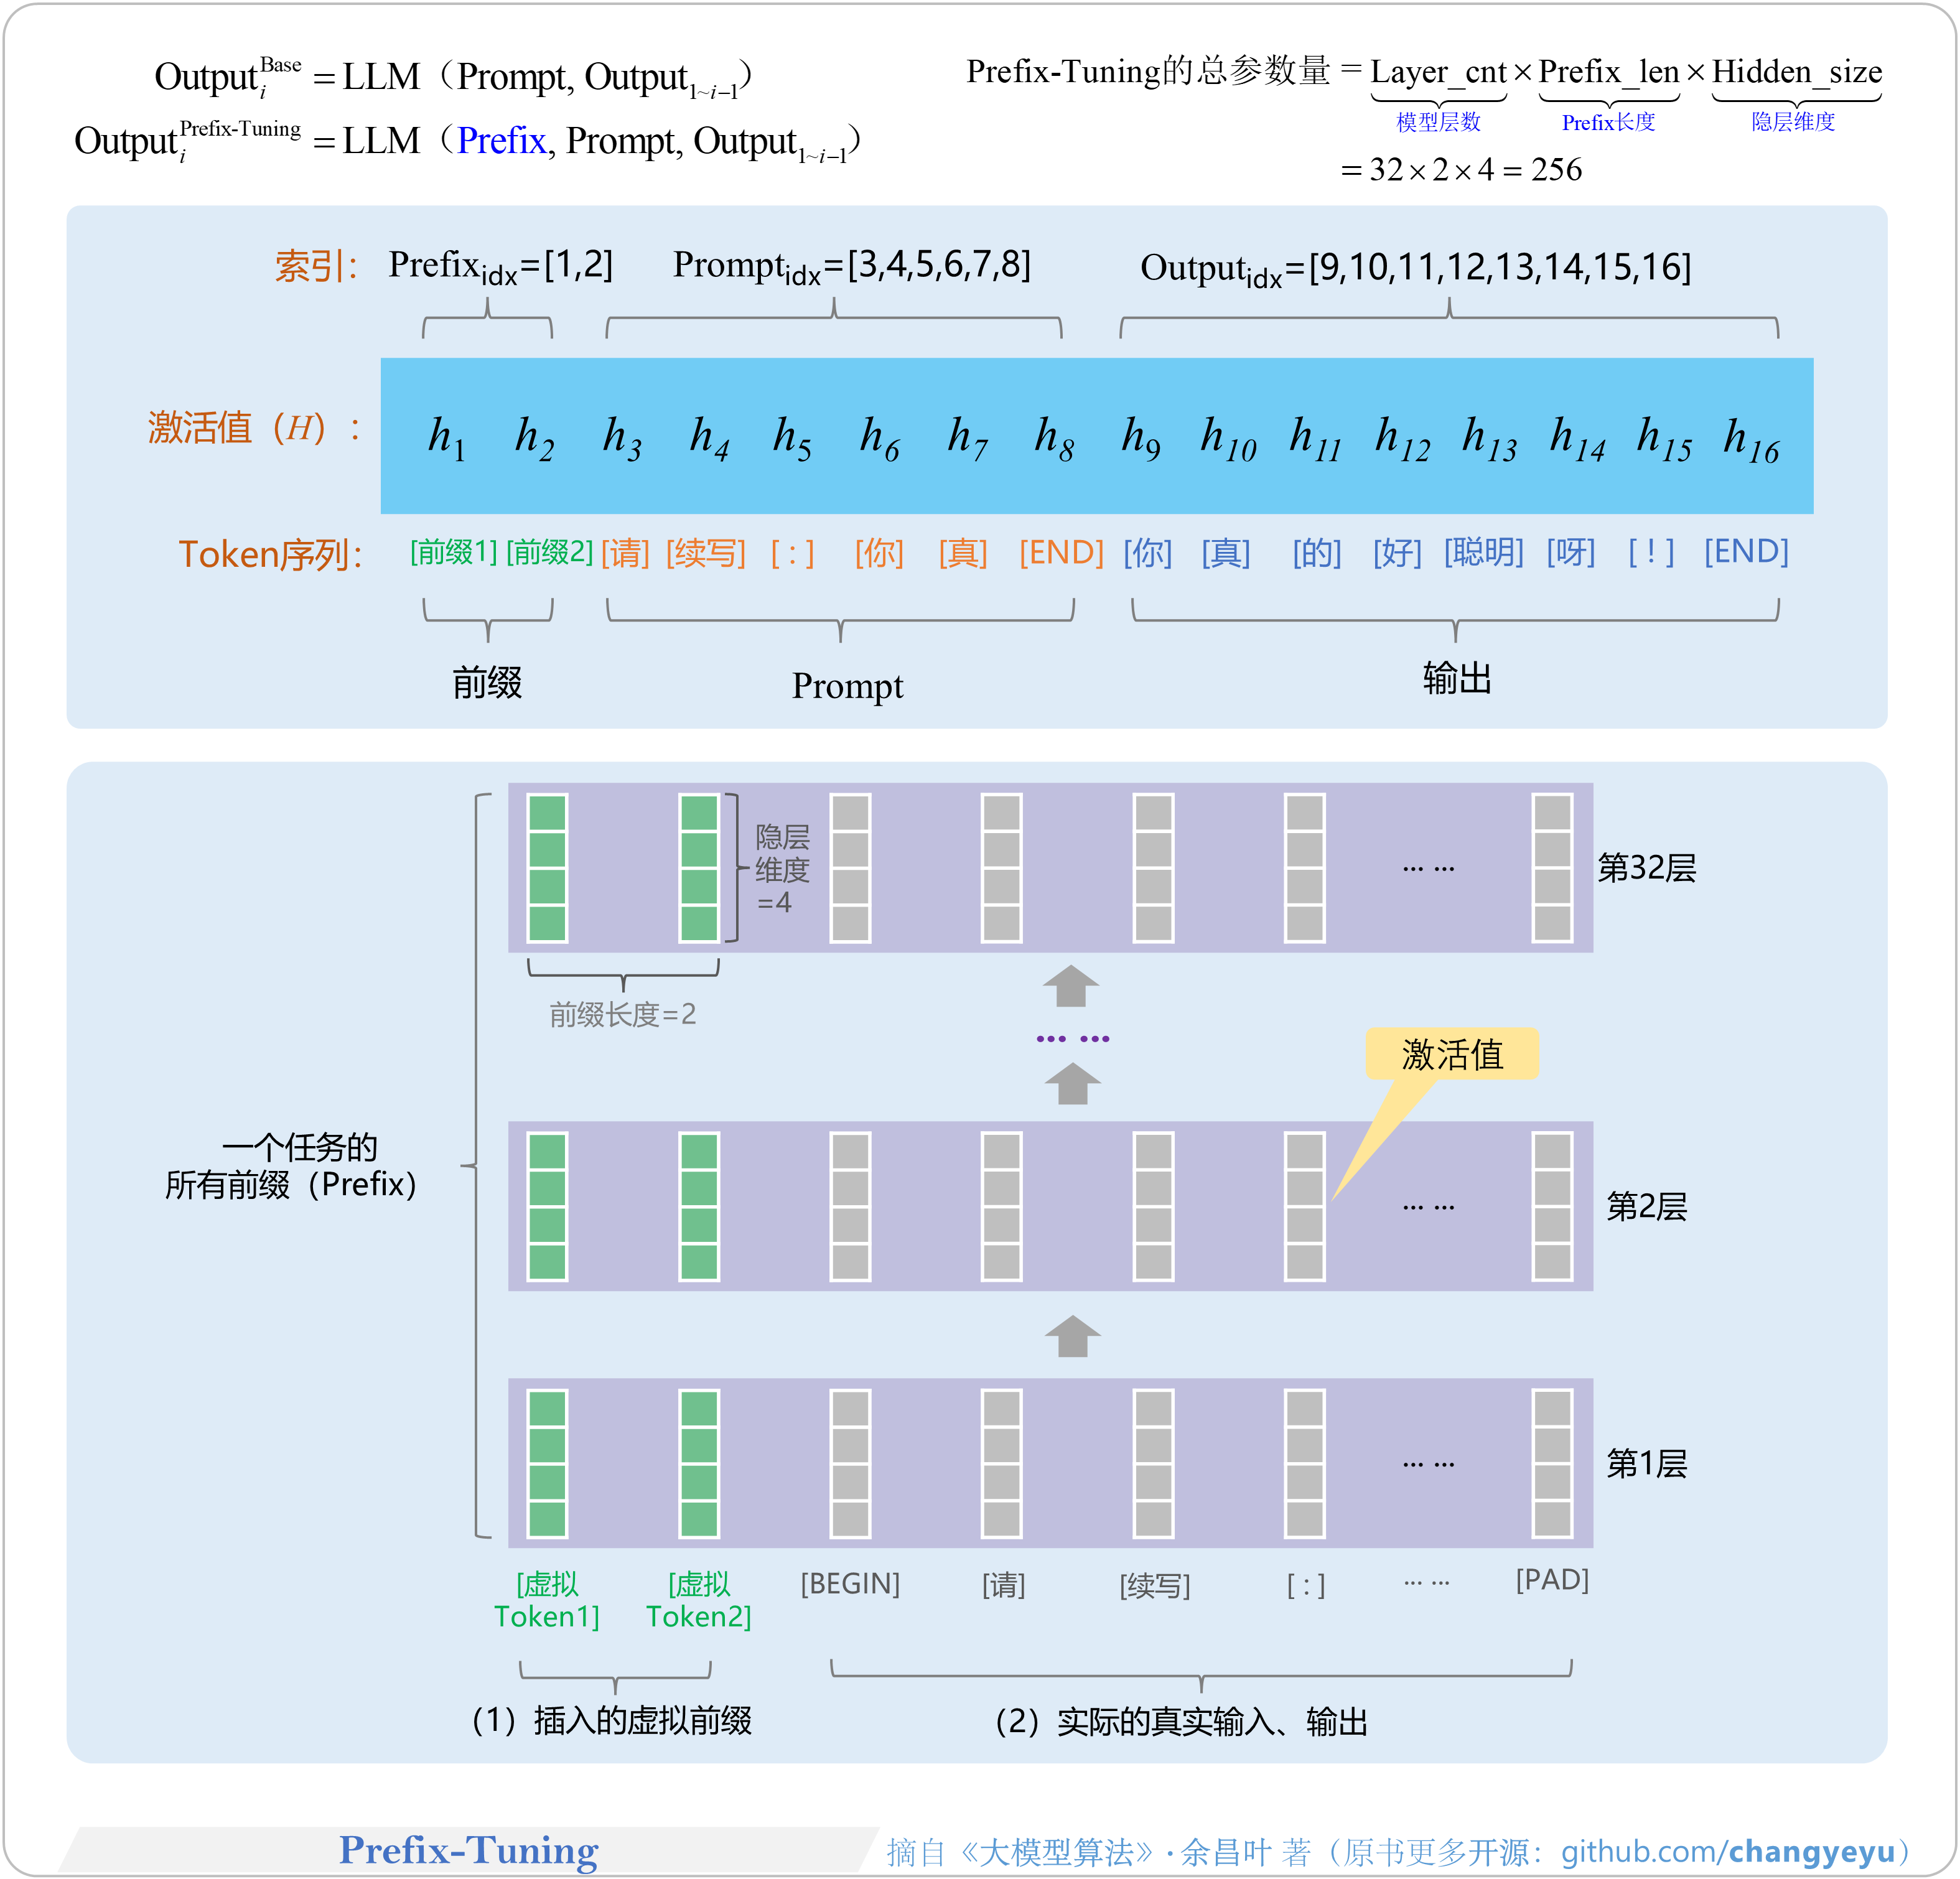
【SFT】Prefix-Tuning
- Prefix-Tuning由斯坦福大学的研究团队提出,可以用于对语言模型进行轻量级微调。
- 如图所示,该方法在输入的起始位置插入一段连续的、可训练的向量(Embedding),称为前缀(Prefix)。在处理后续的Token时,Transformer将这些向量视为 虚拟Token,并参与Attention计算。
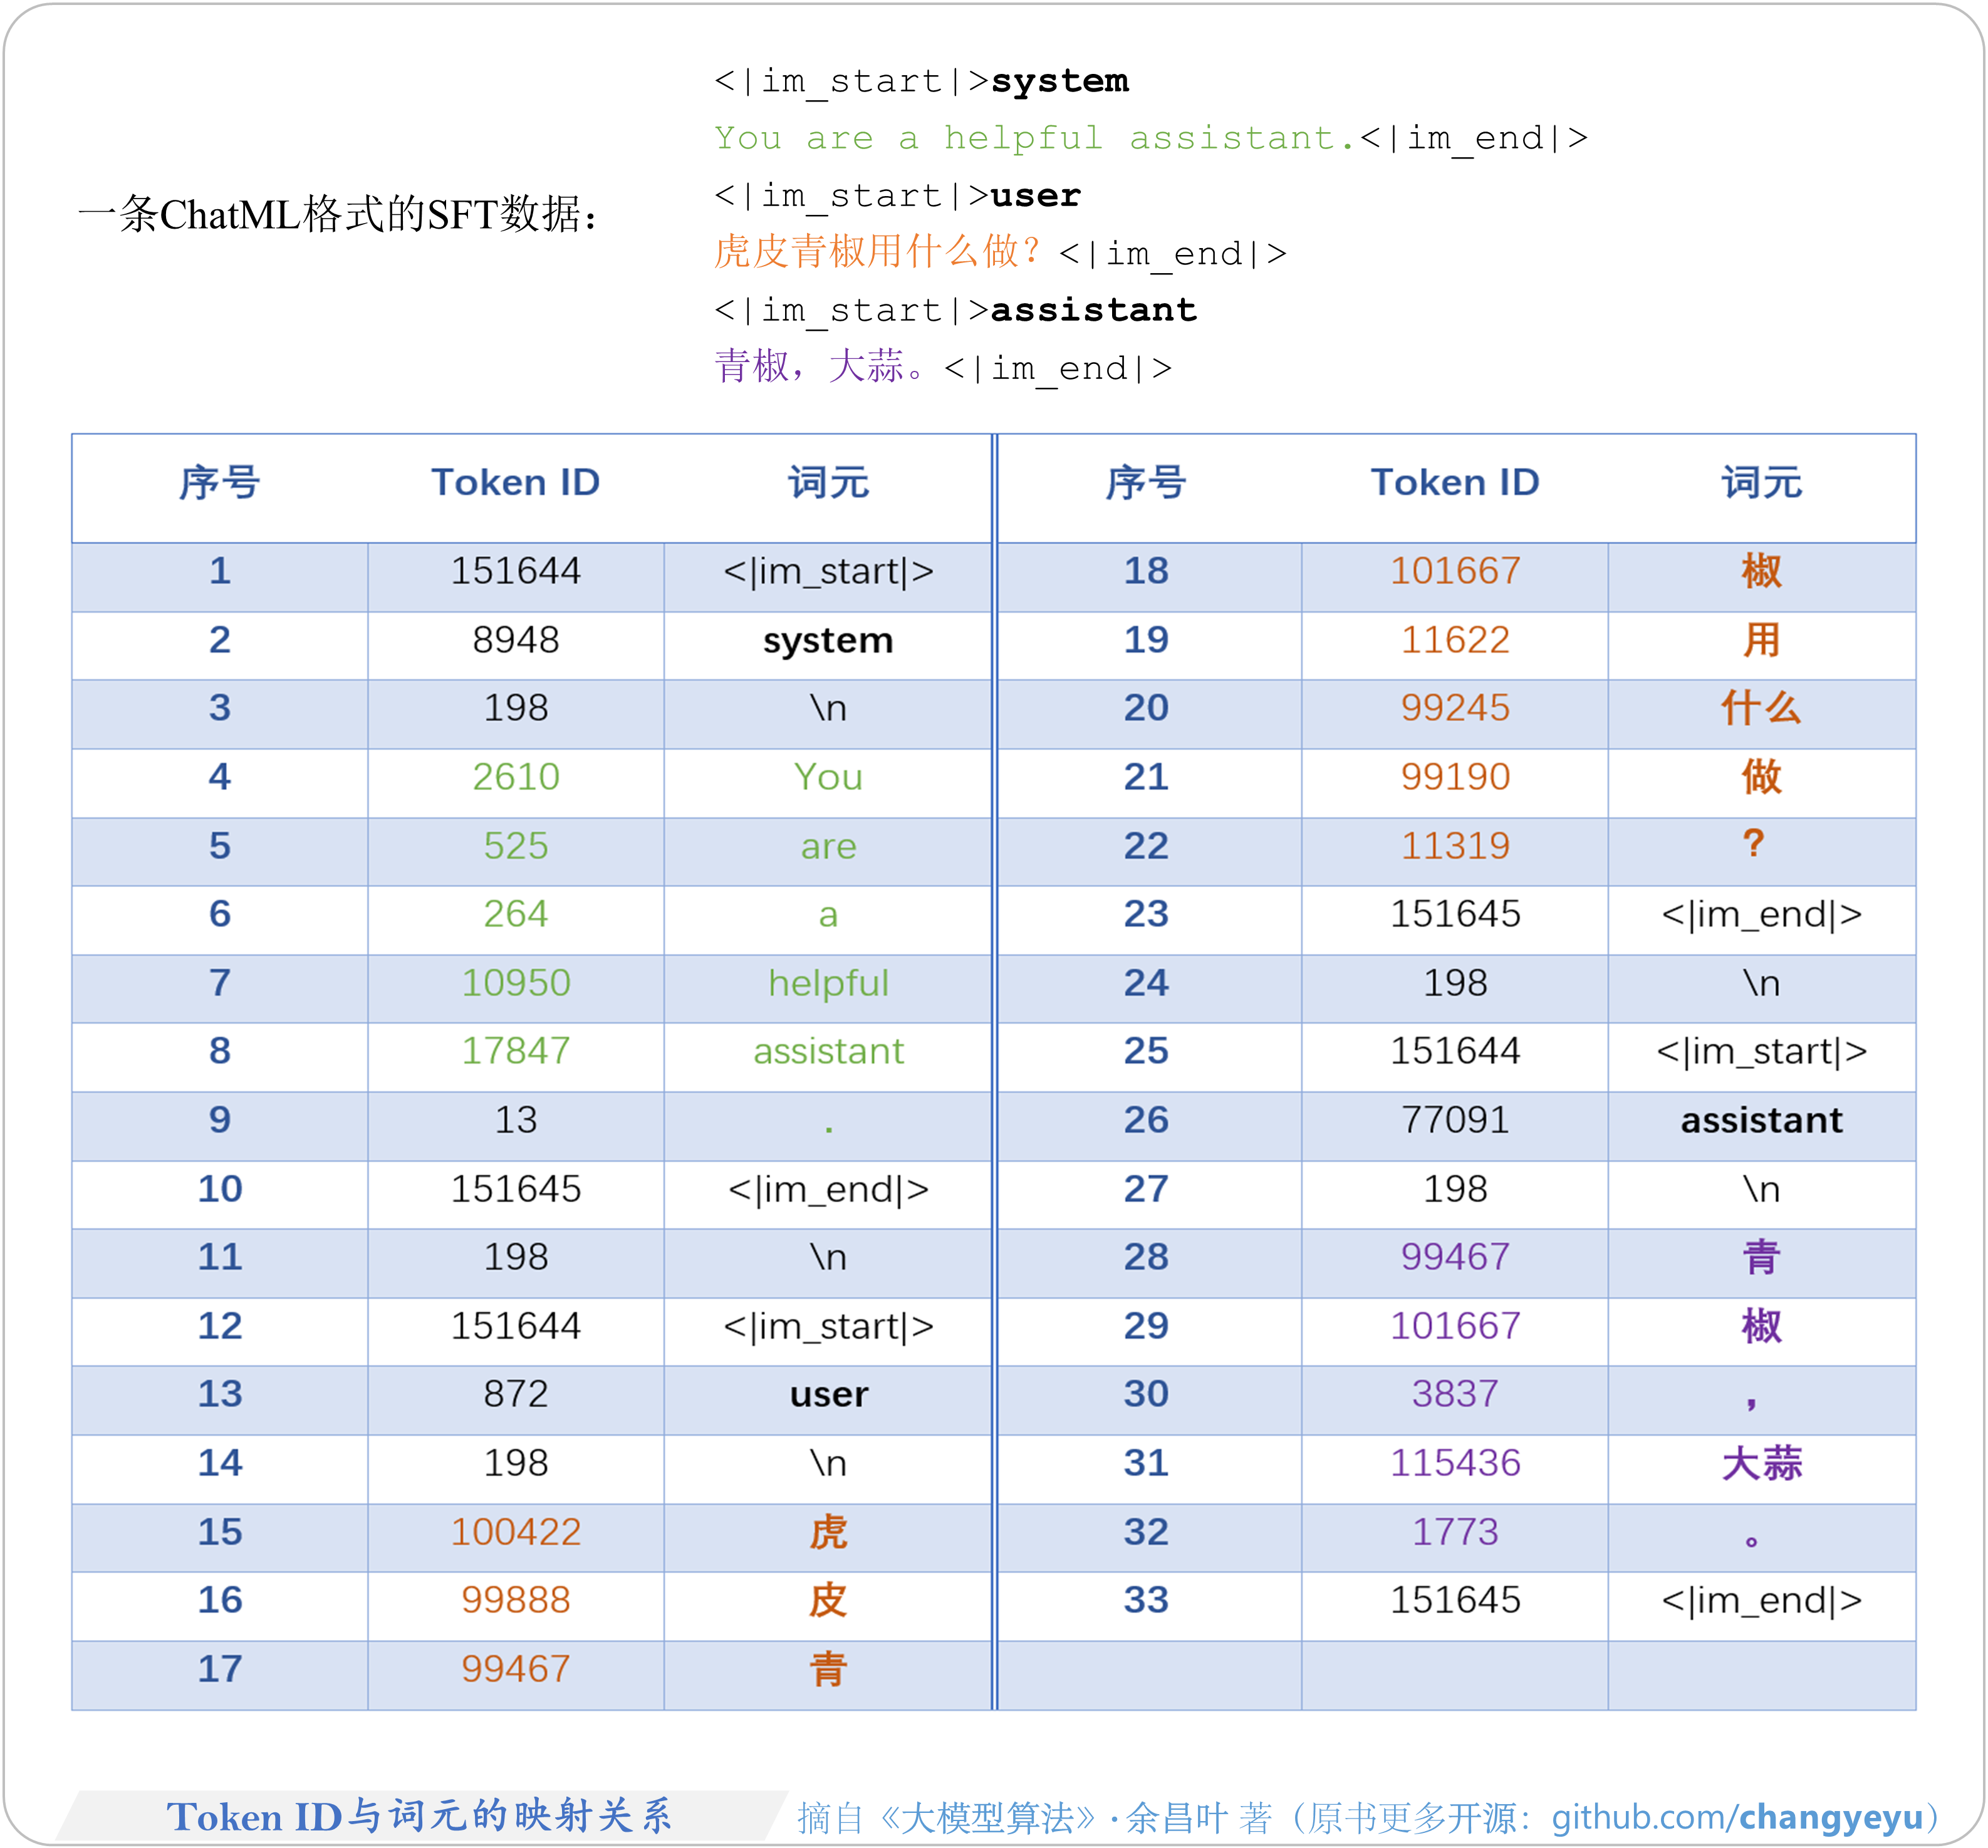
【SFT】TokenID与词元的映射关系
- 以SFT数据(经过ChatML格式预处理)为例,该数据经过Tokenizer处理后,被转换为33个Token,对应33个序列位置,如图所示。
- 每个Token ID与相应的词元一一对应。

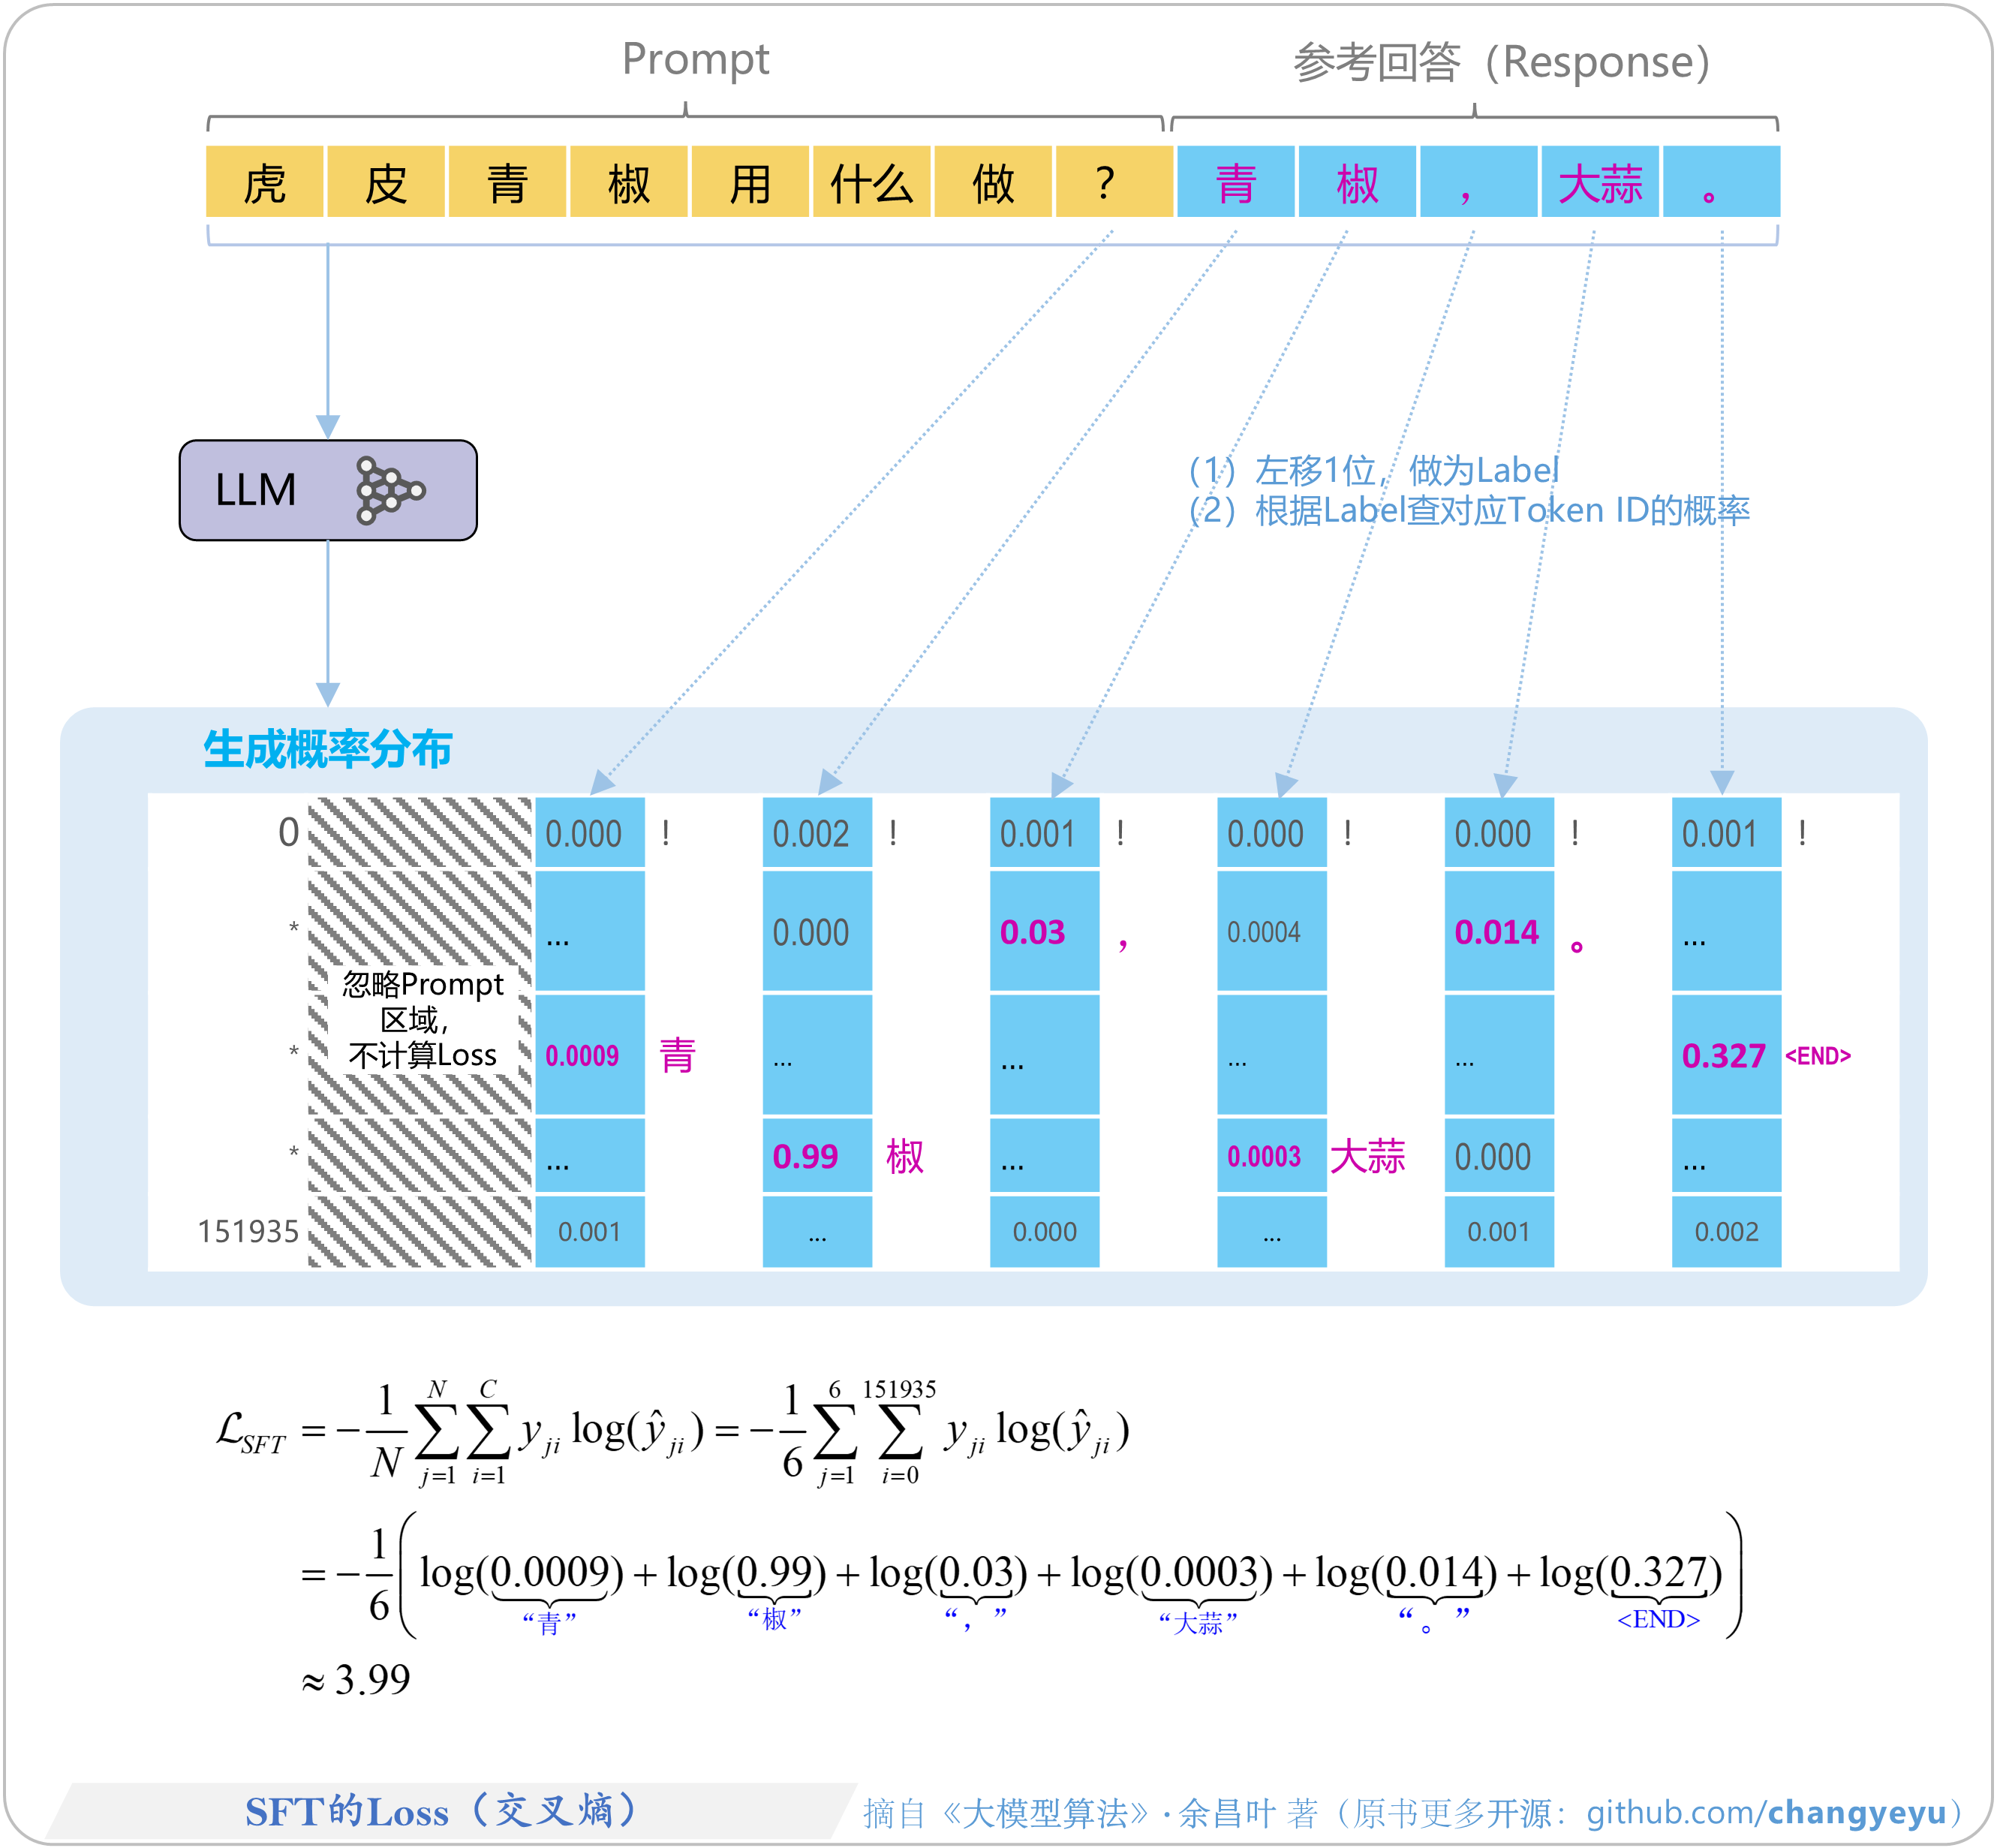
【SFT】SFT的Loss(交叉熵)
- 与预训练阶段类似,SFT的Loss也是基于交叉熵(CE,Cross Entropy)

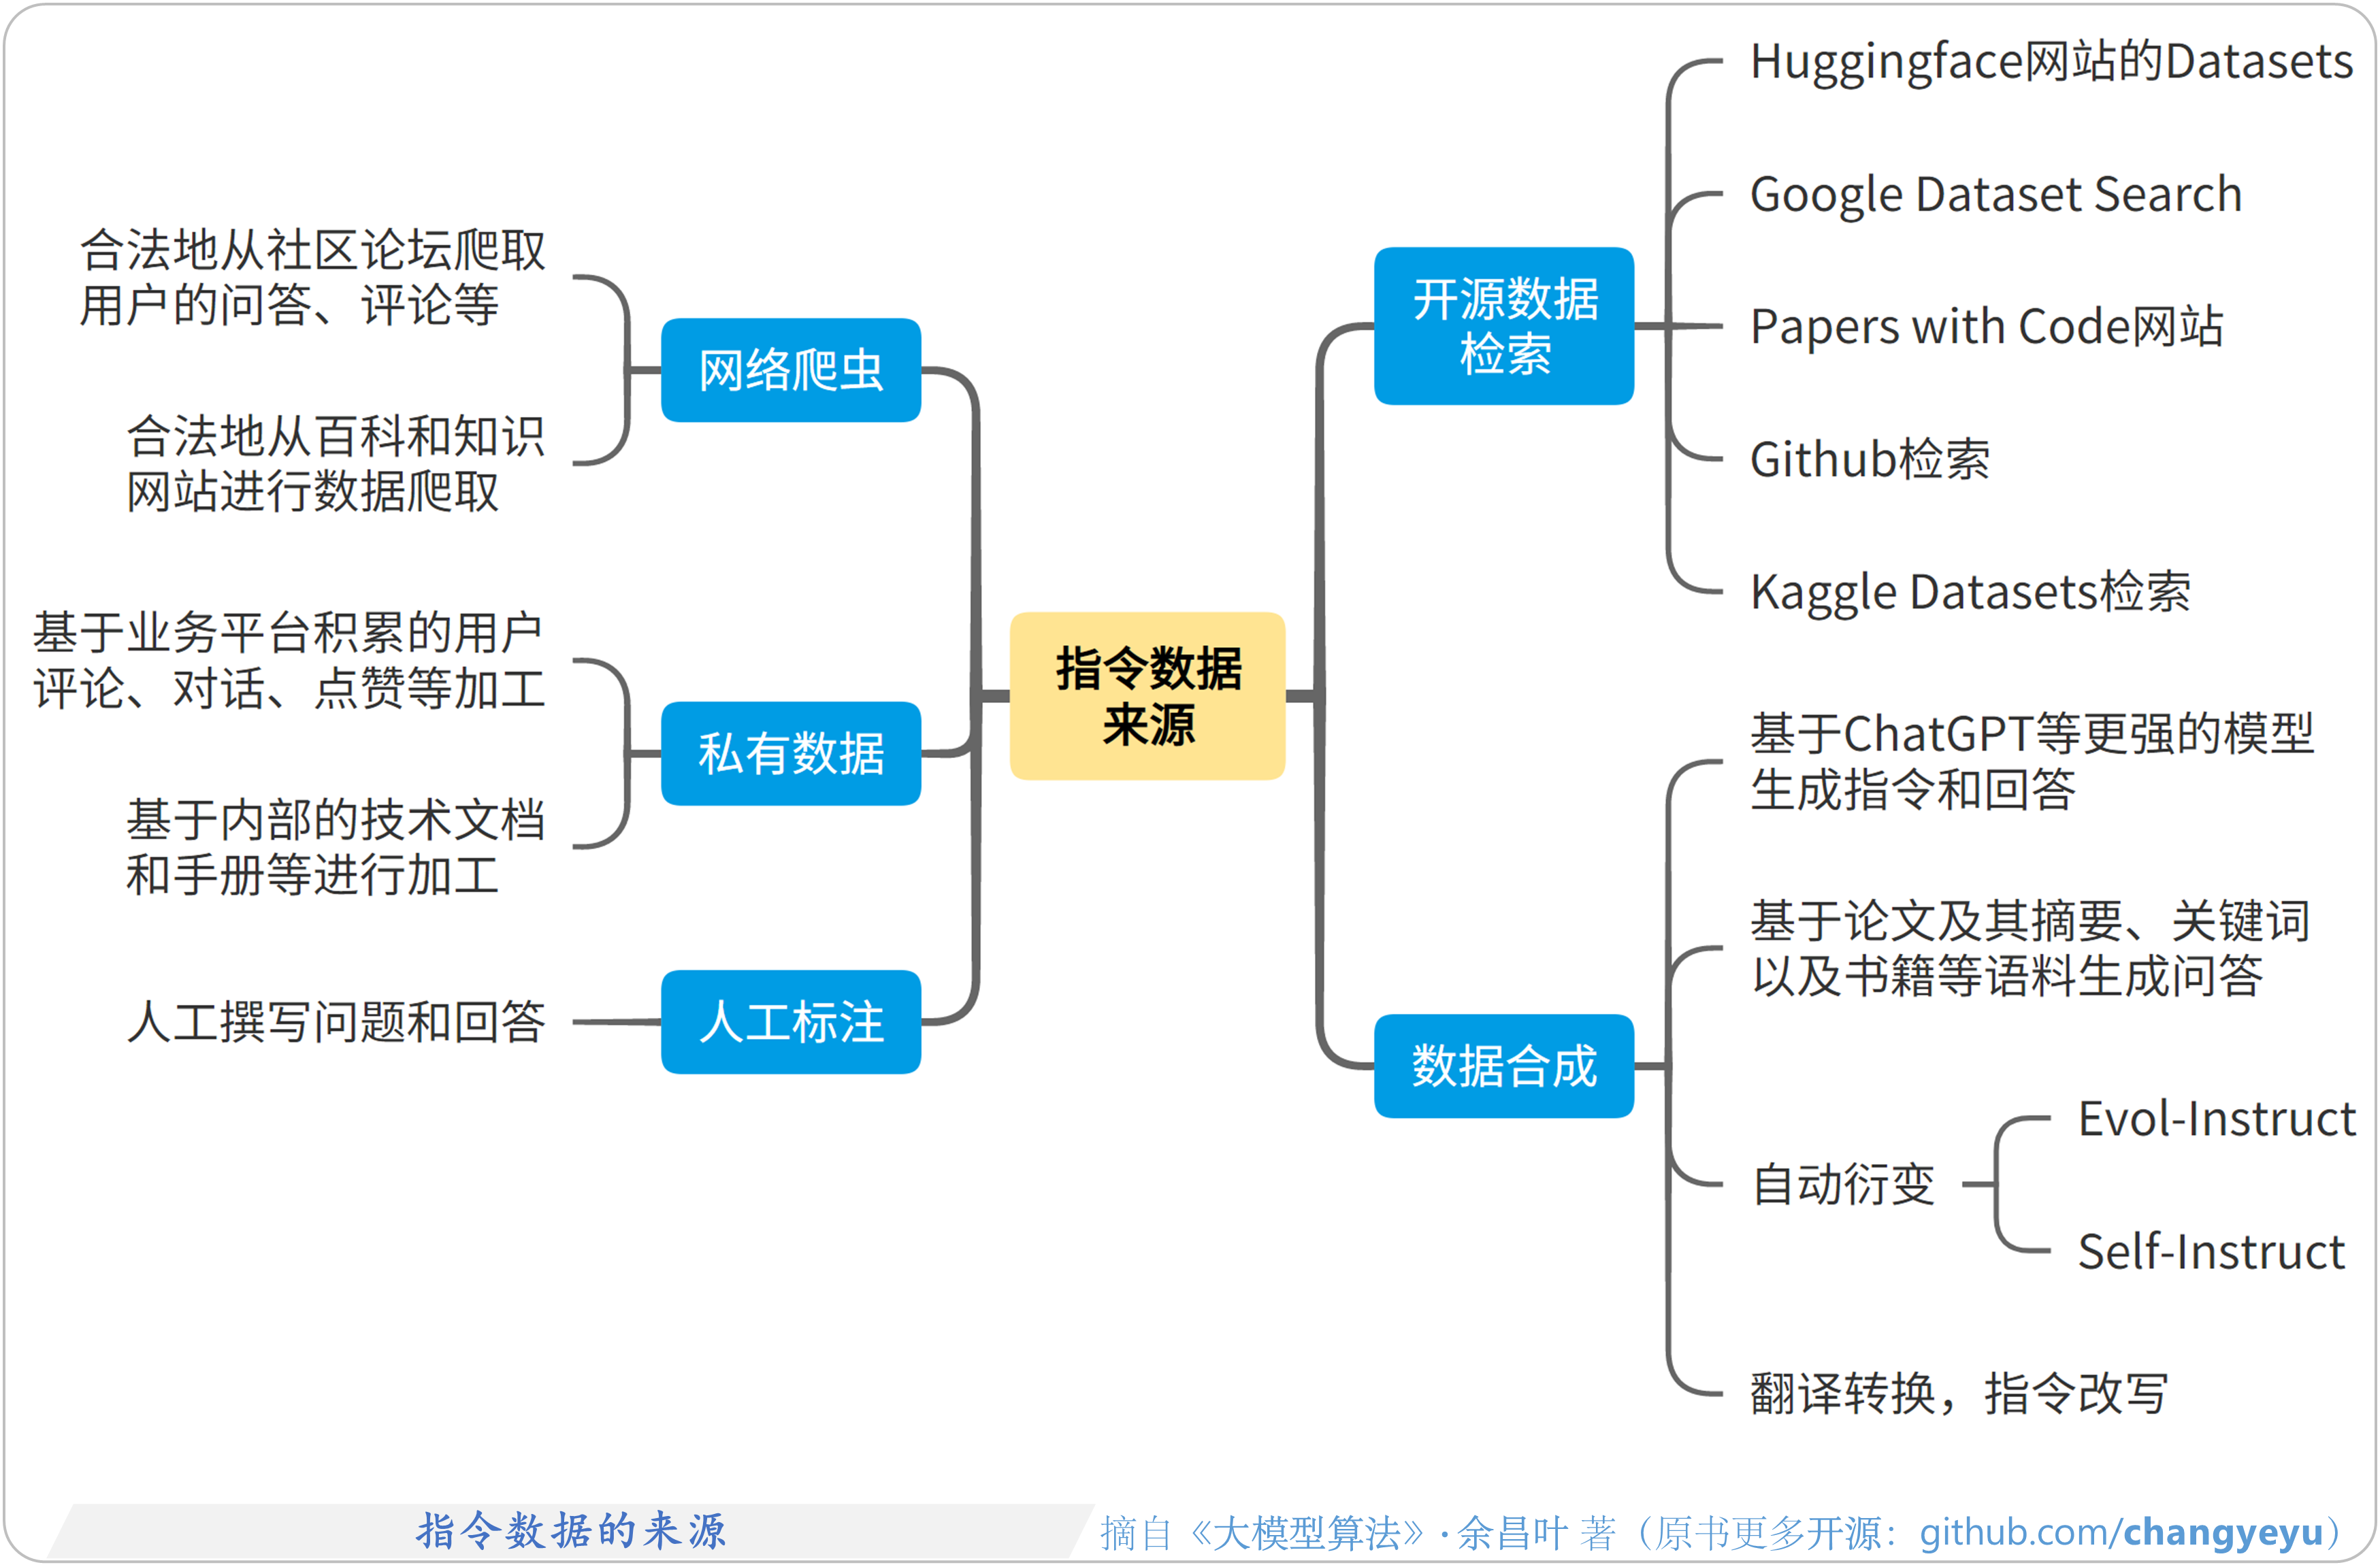
【SFT】指令数据的来源
- 指令数据(Instructions)是指为模型提供的一组引导性输入及期望输出的描述,通常包括问题(或任务提示)及其对应的答案,常用于对模型进行微调训练。

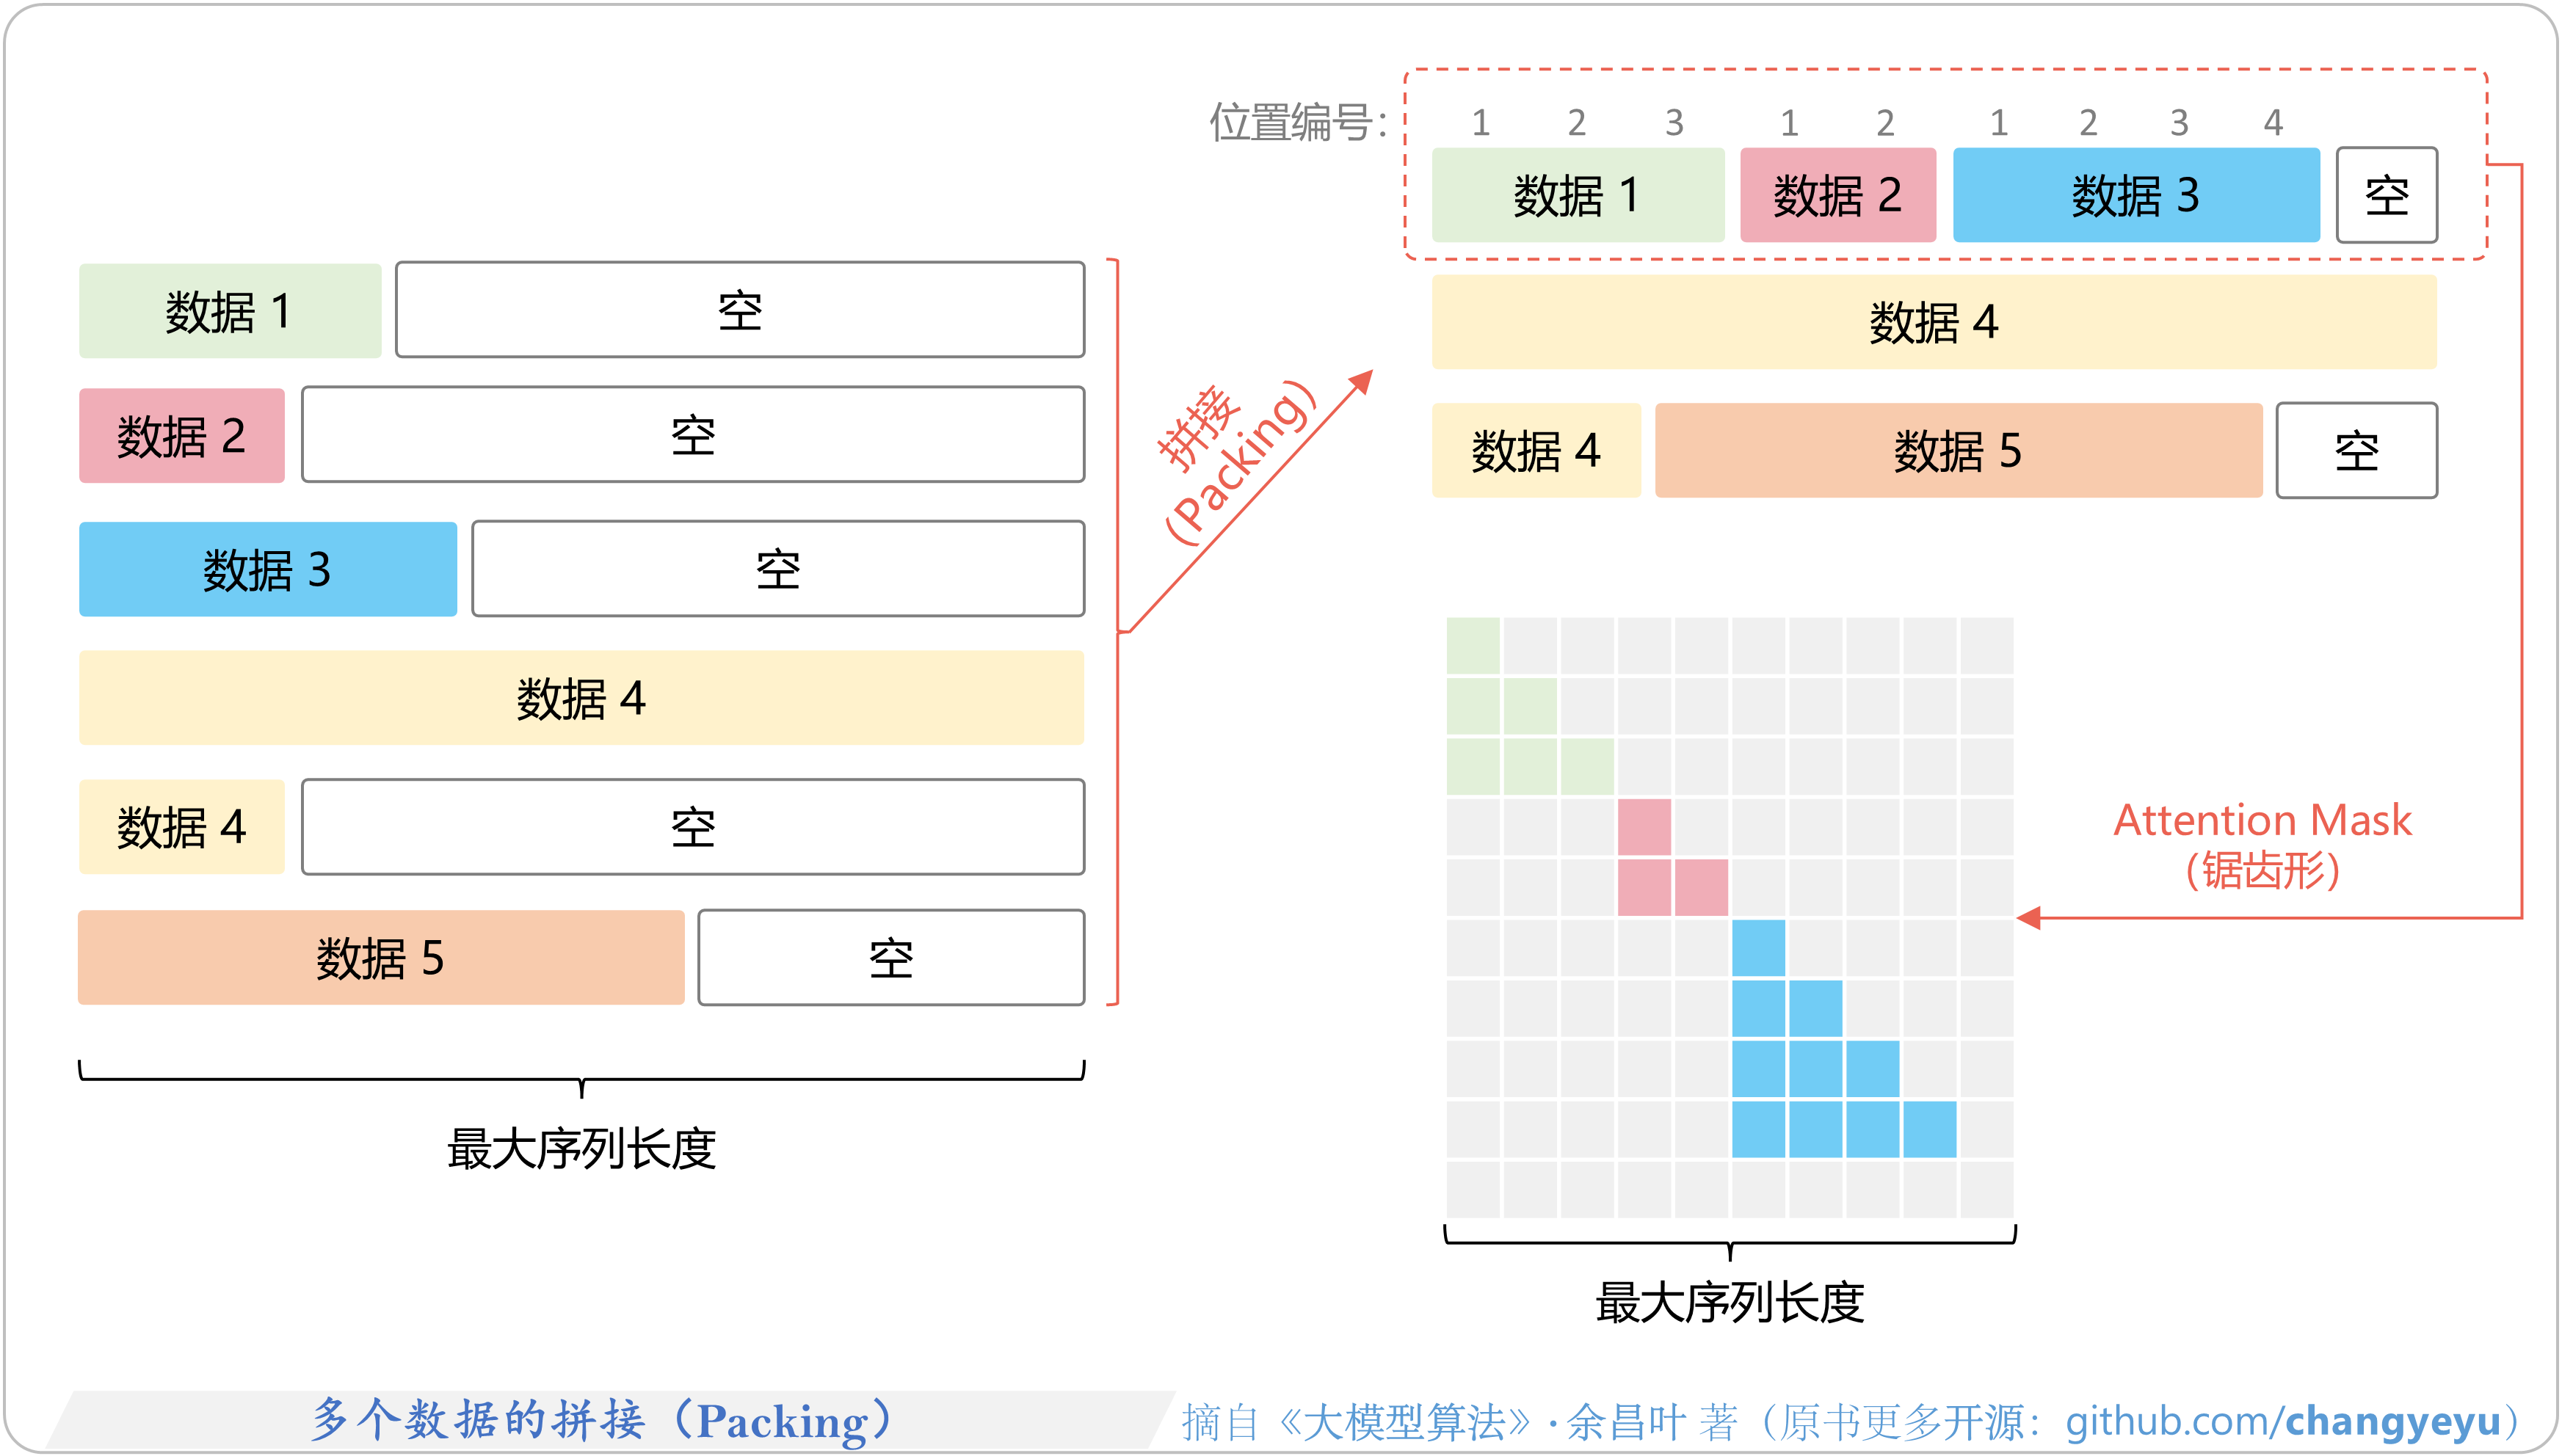
【SFT】多个数据的拼接(Packing)
- 模型训练时通常使用固定长度的输入。当输入的数据长度不一致时,对于短序列,会在其末尾填充(padding)以匹配最大序列长度,这会导致计算资源的浪费。
- 因此,正如图所示,常见的做法是将多条数据拼接(Packing)在一起,填充到一个固定长度的输入序列中。
- 为了确保计算过程中不同数据之间互不干扰,通常需要重设位置编号(Reset position ID)和注意力掩码(Reset attention mask),以在计算Attention时保持各条数据的语义独立性。

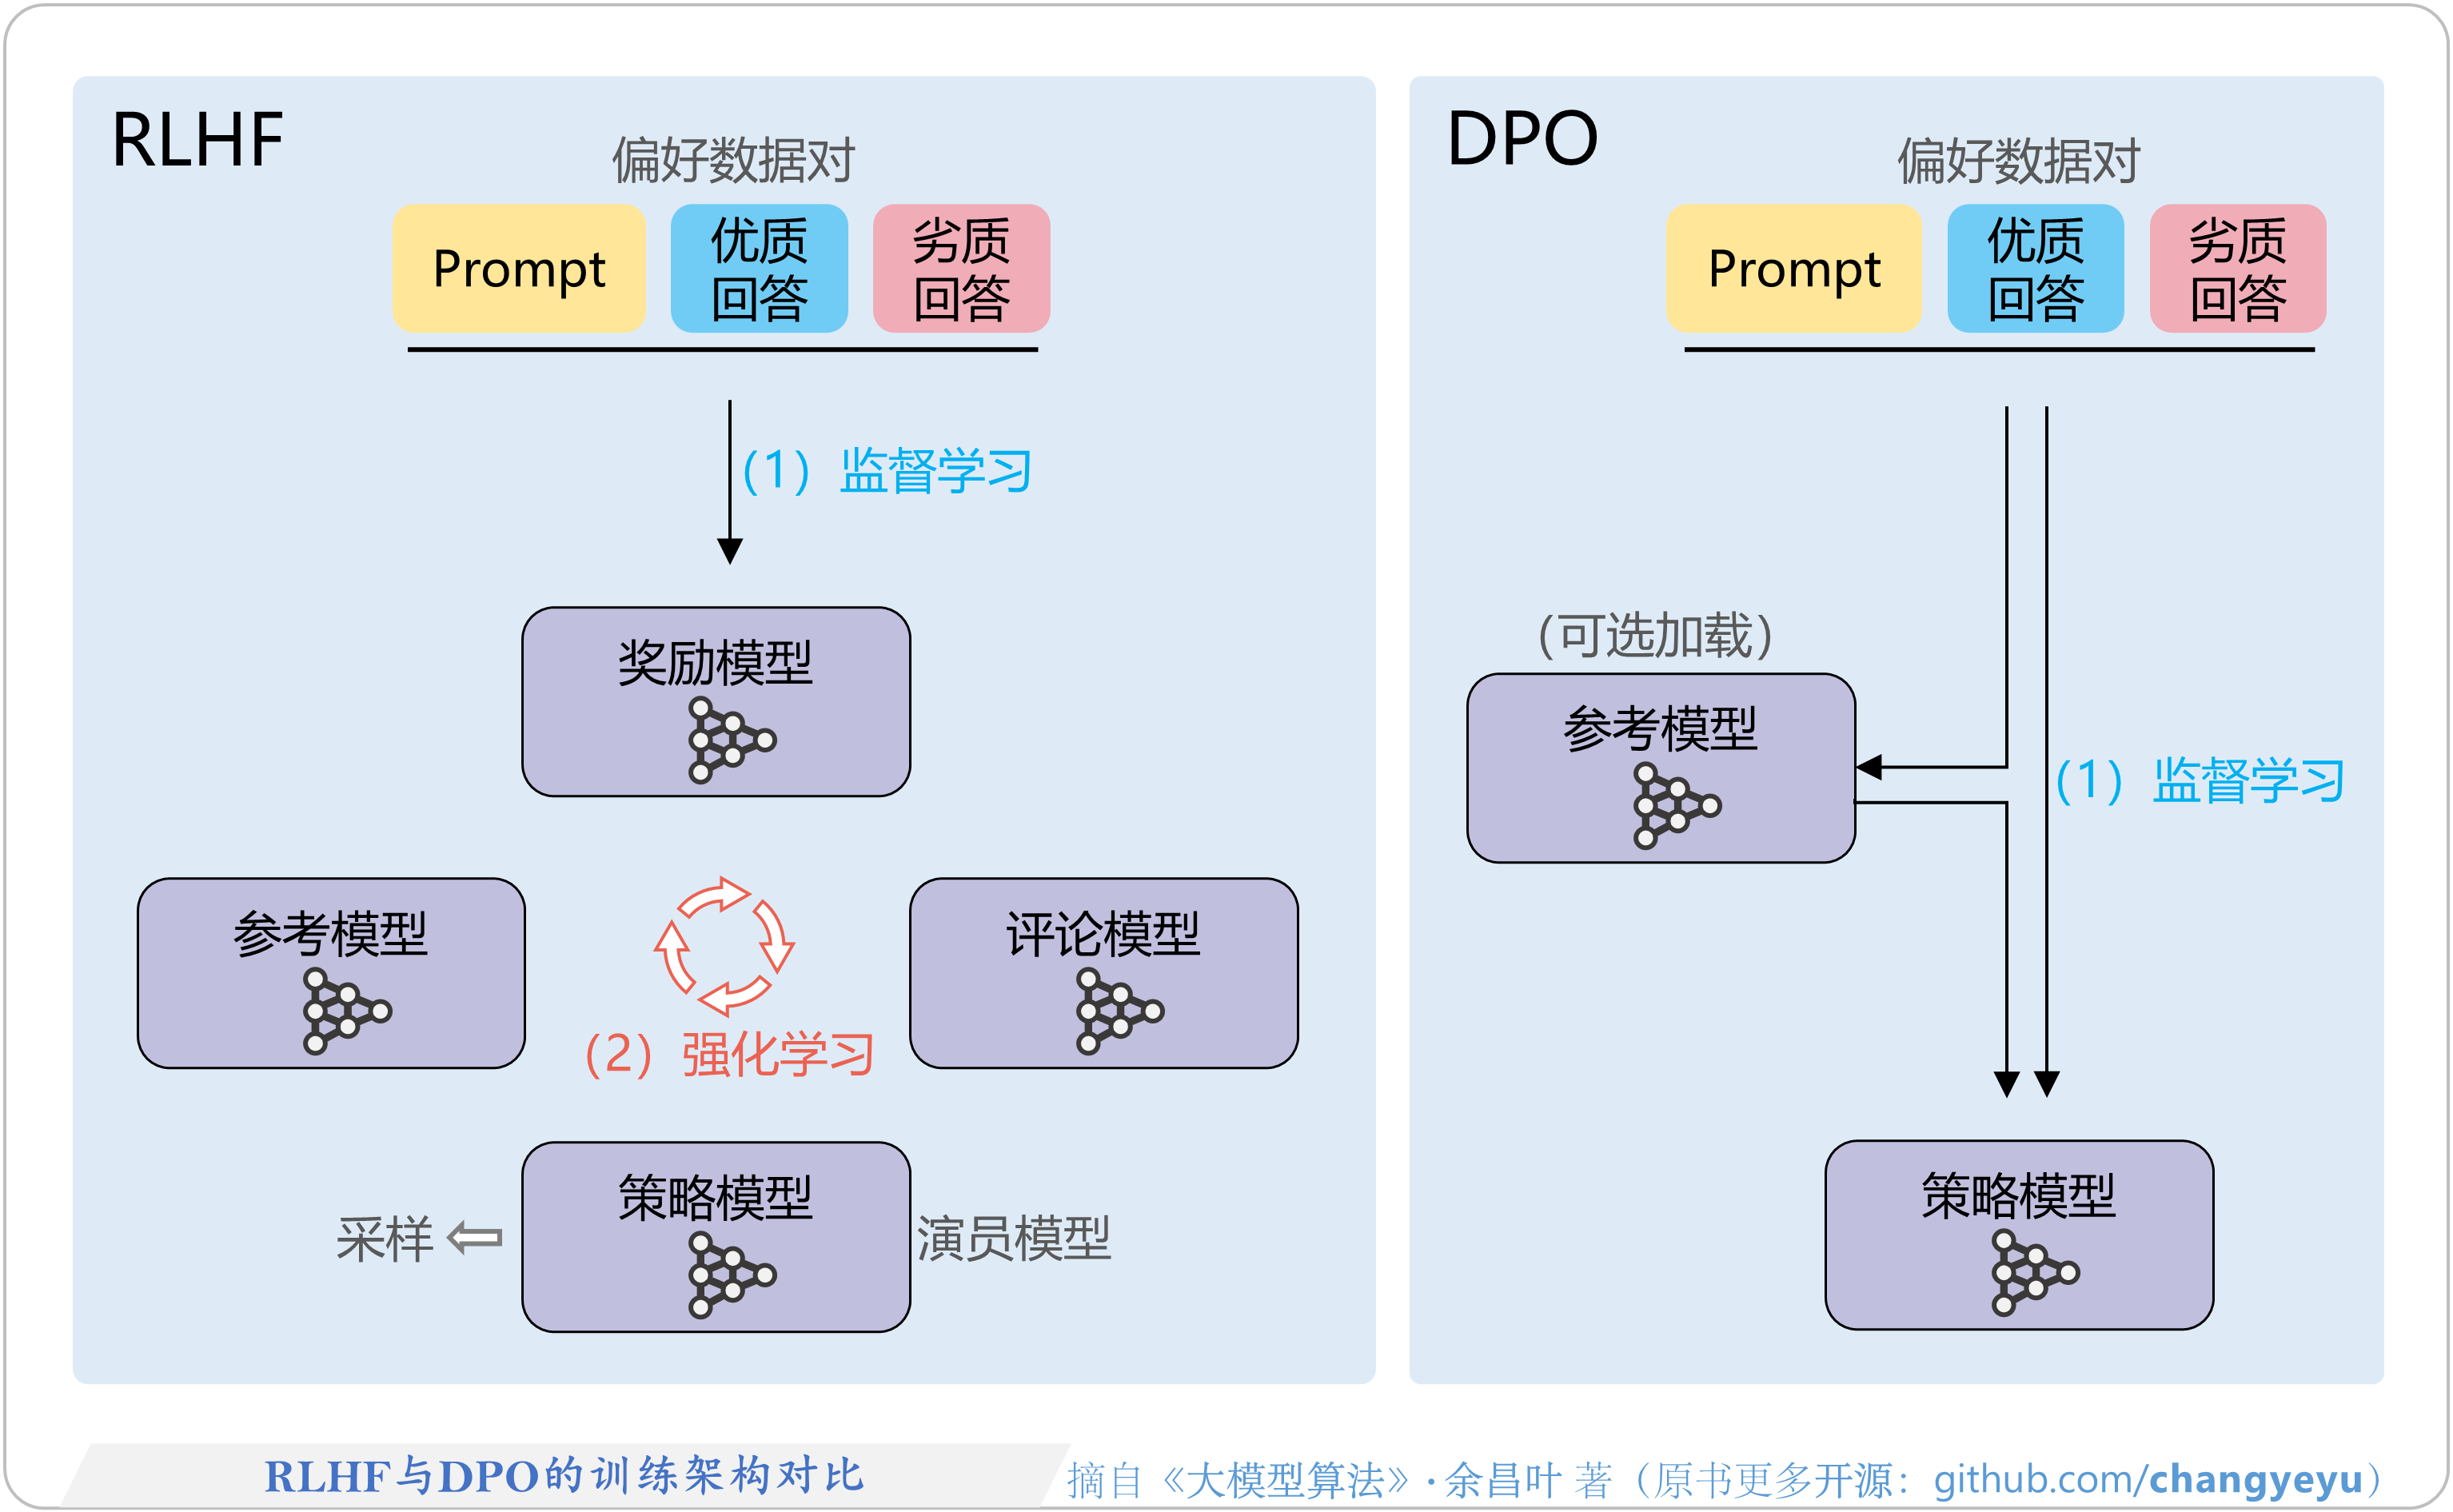
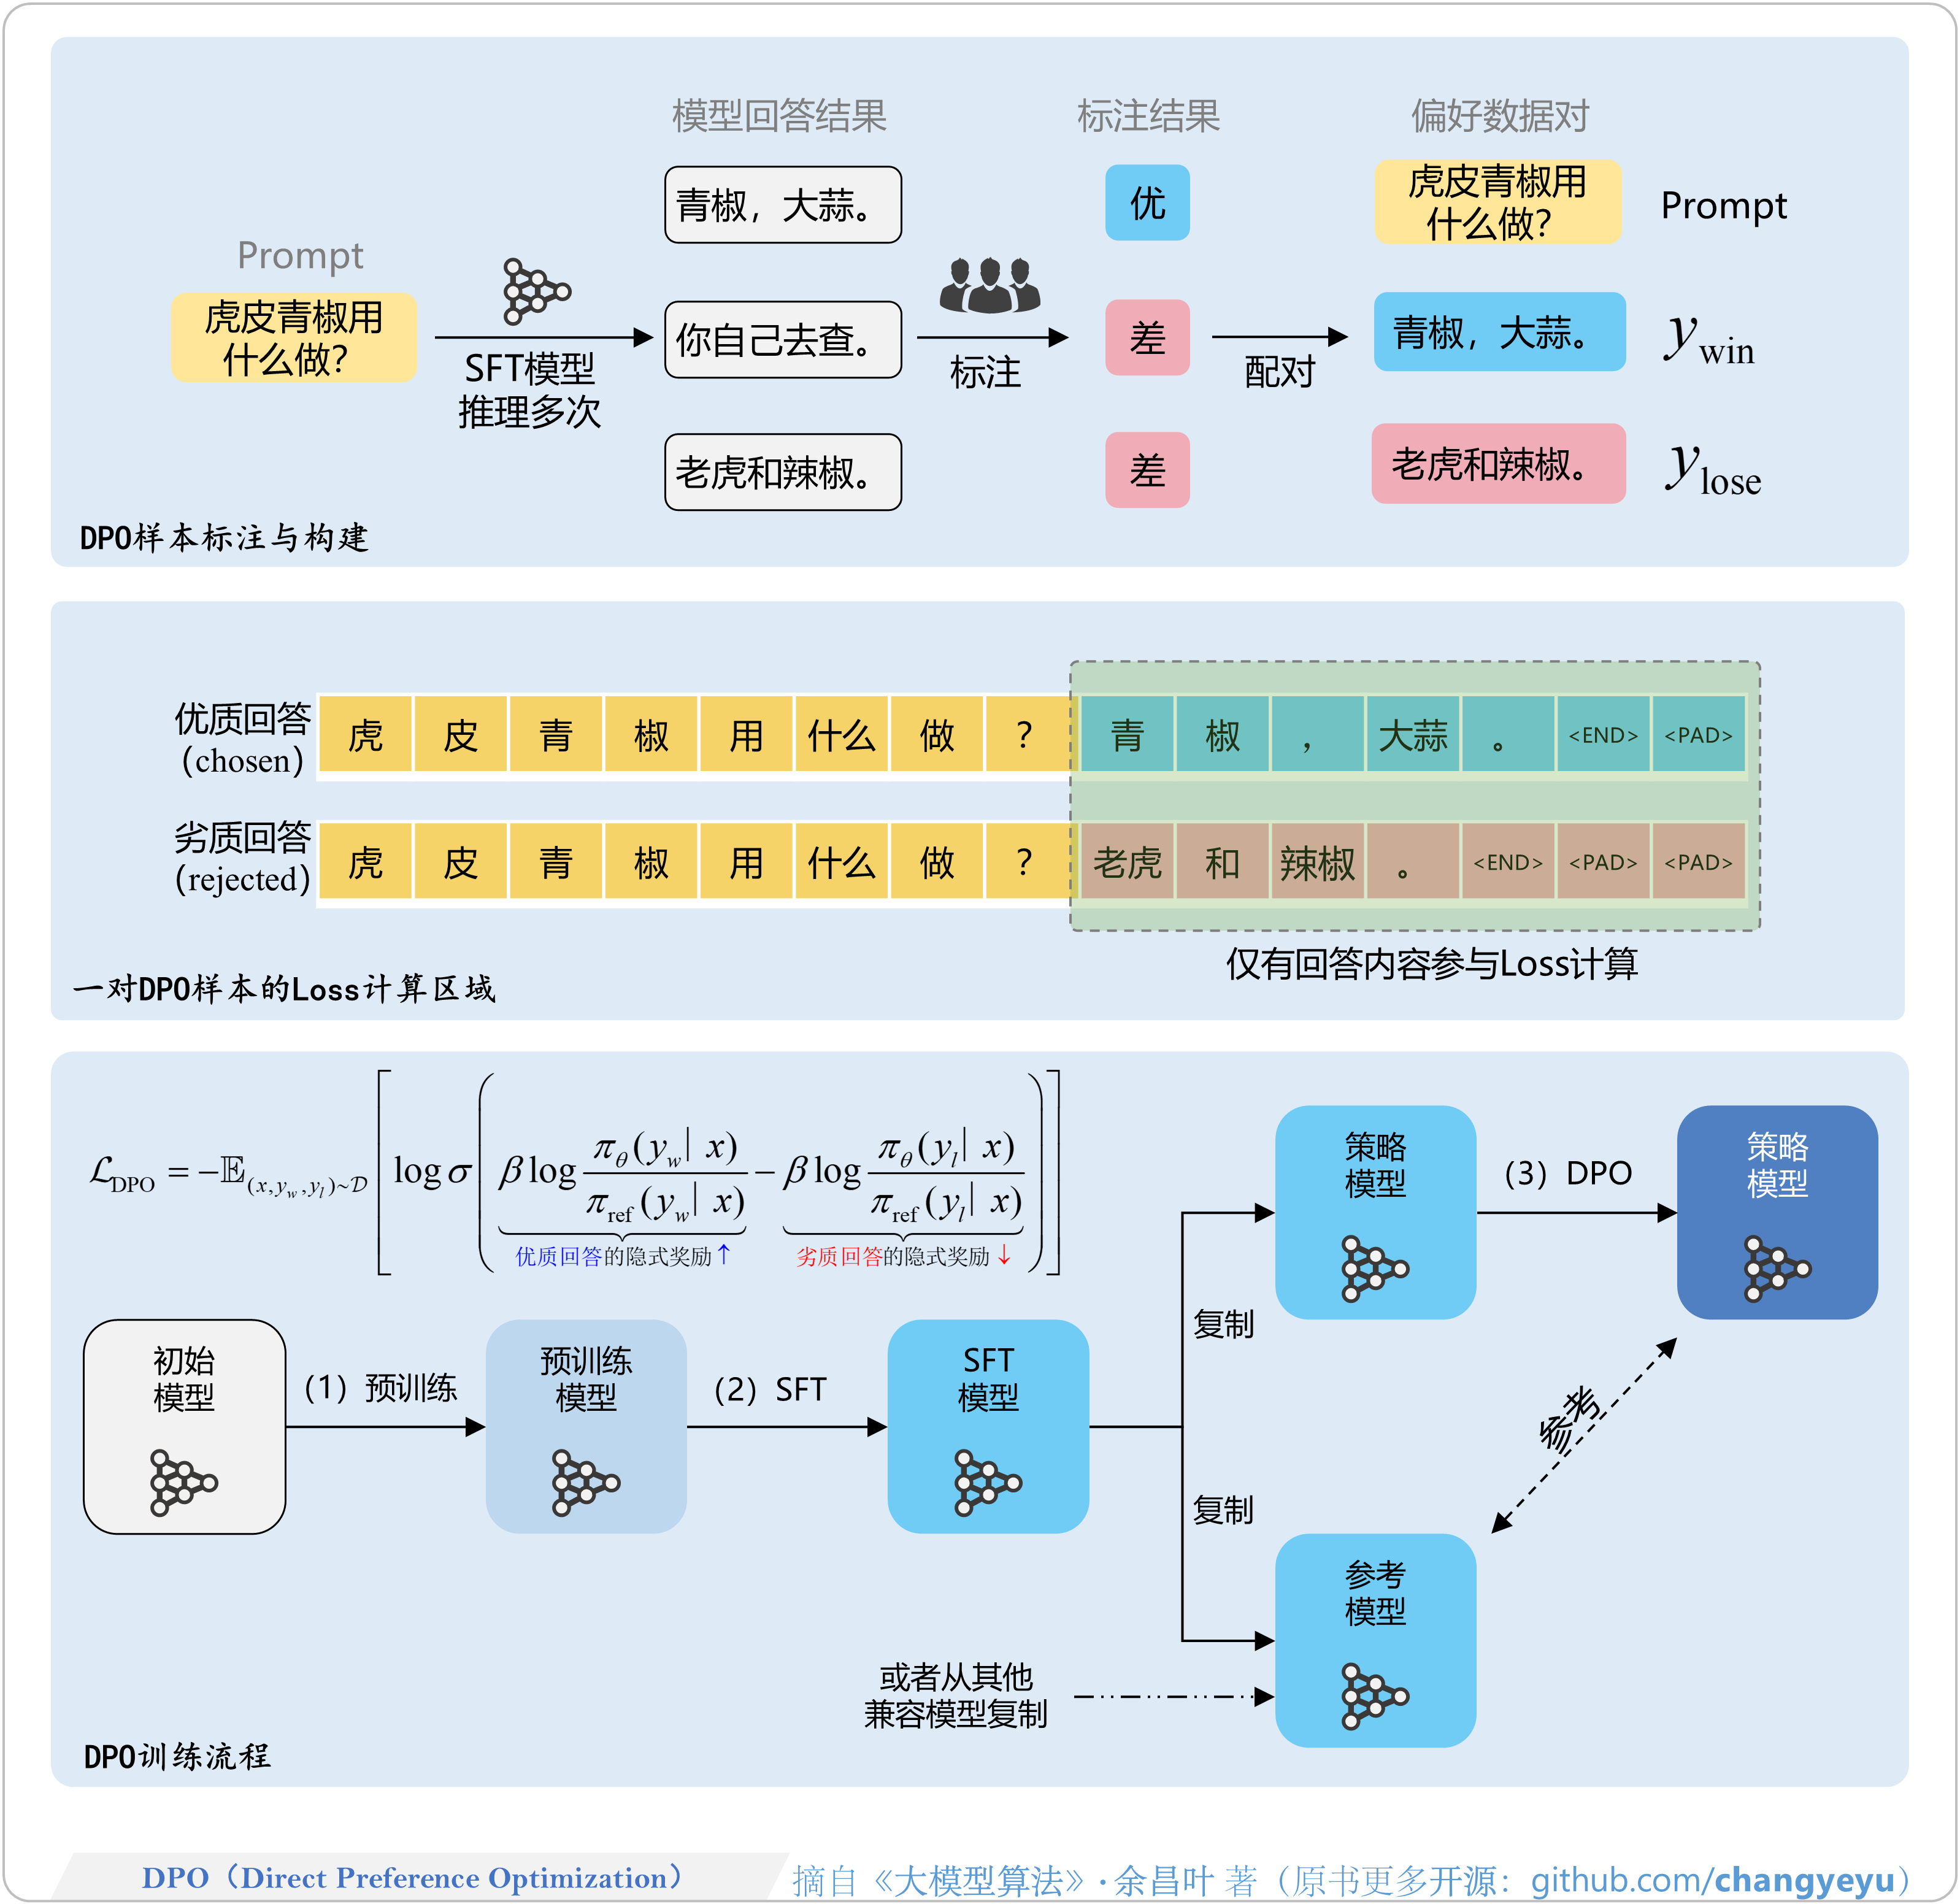
【DPO】RLHF与DPO的训练架构对比
不同于RLHF,DPO以监督学习的训练方式,大幅简化了对齐训练:
- 流程简洁:DPO直接对策略模型进行优化,不需要预先训练Reward模型(奖励函数)。DPO只需要基于预先给定的偏好数据进行训练,无需中途采样。
- 稳定性:DPO是一种监督学习方法,摆脱了强化学习训练的不稳定性。
- 低开销:DPO在训练过程中只需要加载一个模型(只需加载策略模型,而对于参考模型,可以将参考模型的输出结果预先录制好,然后在训练时就不需要加载),算力开销更低,更易于落地实践。

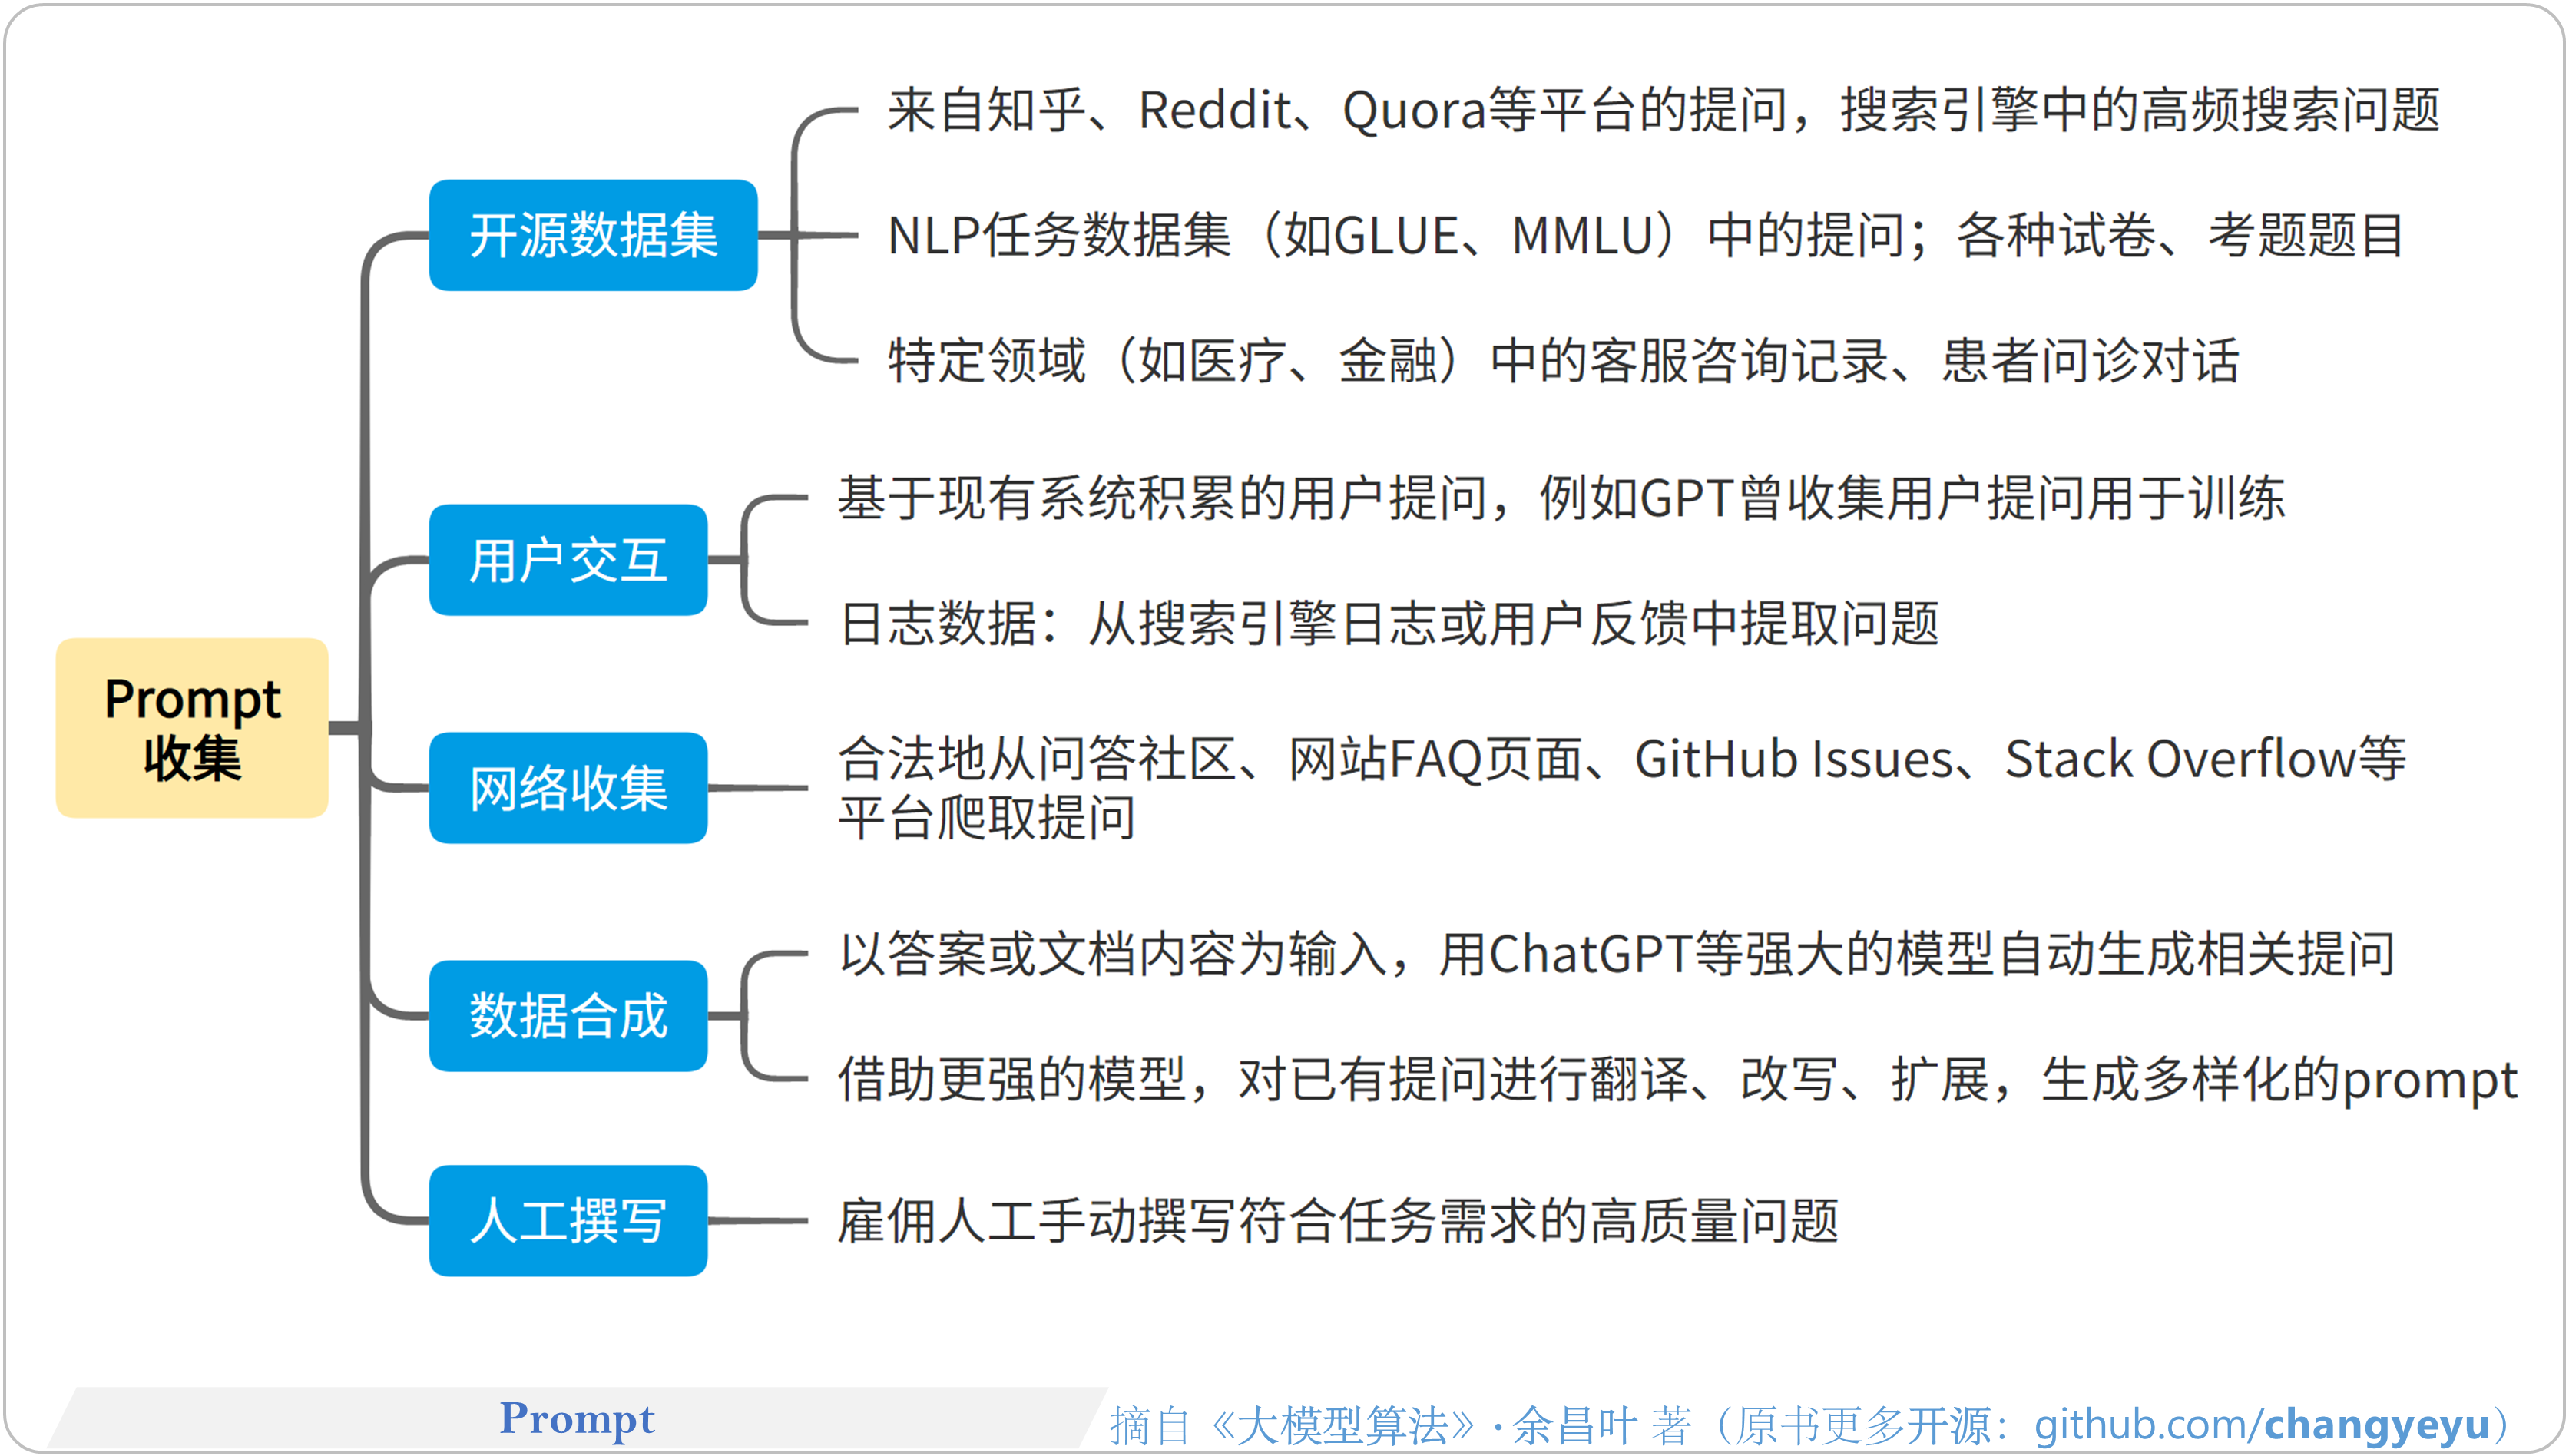
【DPO】Prompt的收集
【DPO】DPO(Direct Preference Optimization)
- DPO(Direct Preference Optimization,直接偏好优化)是由斯坦福大学等研究团队于2023年提出的一种偏好优化算法,可用于LLM、VLM与MLLM的对齐训练。
- 该算法在基于PPO的RLHF基础上进行了大幅简化。
- DPO算法跳过了训练奖励模型这一中间过程,直接(Direct)优化策略模型 ——这正是DPO命名中“D(Direct)”的含义所在。 DPO的训练涉及2个模型——策略模型和参考模型。它们的初始化方法如下:
- 策略模型:直接复制SFT模型作为初始化。
- 参考模型:通常也从SFT模型复制。但在某些情况下,可能会选择从一个比SFT模型更强的模型进行复制。此时,需特别关注参考模型与策略模型的匹配性,主要涉及两者的KL距离及训练数据分布等方面。

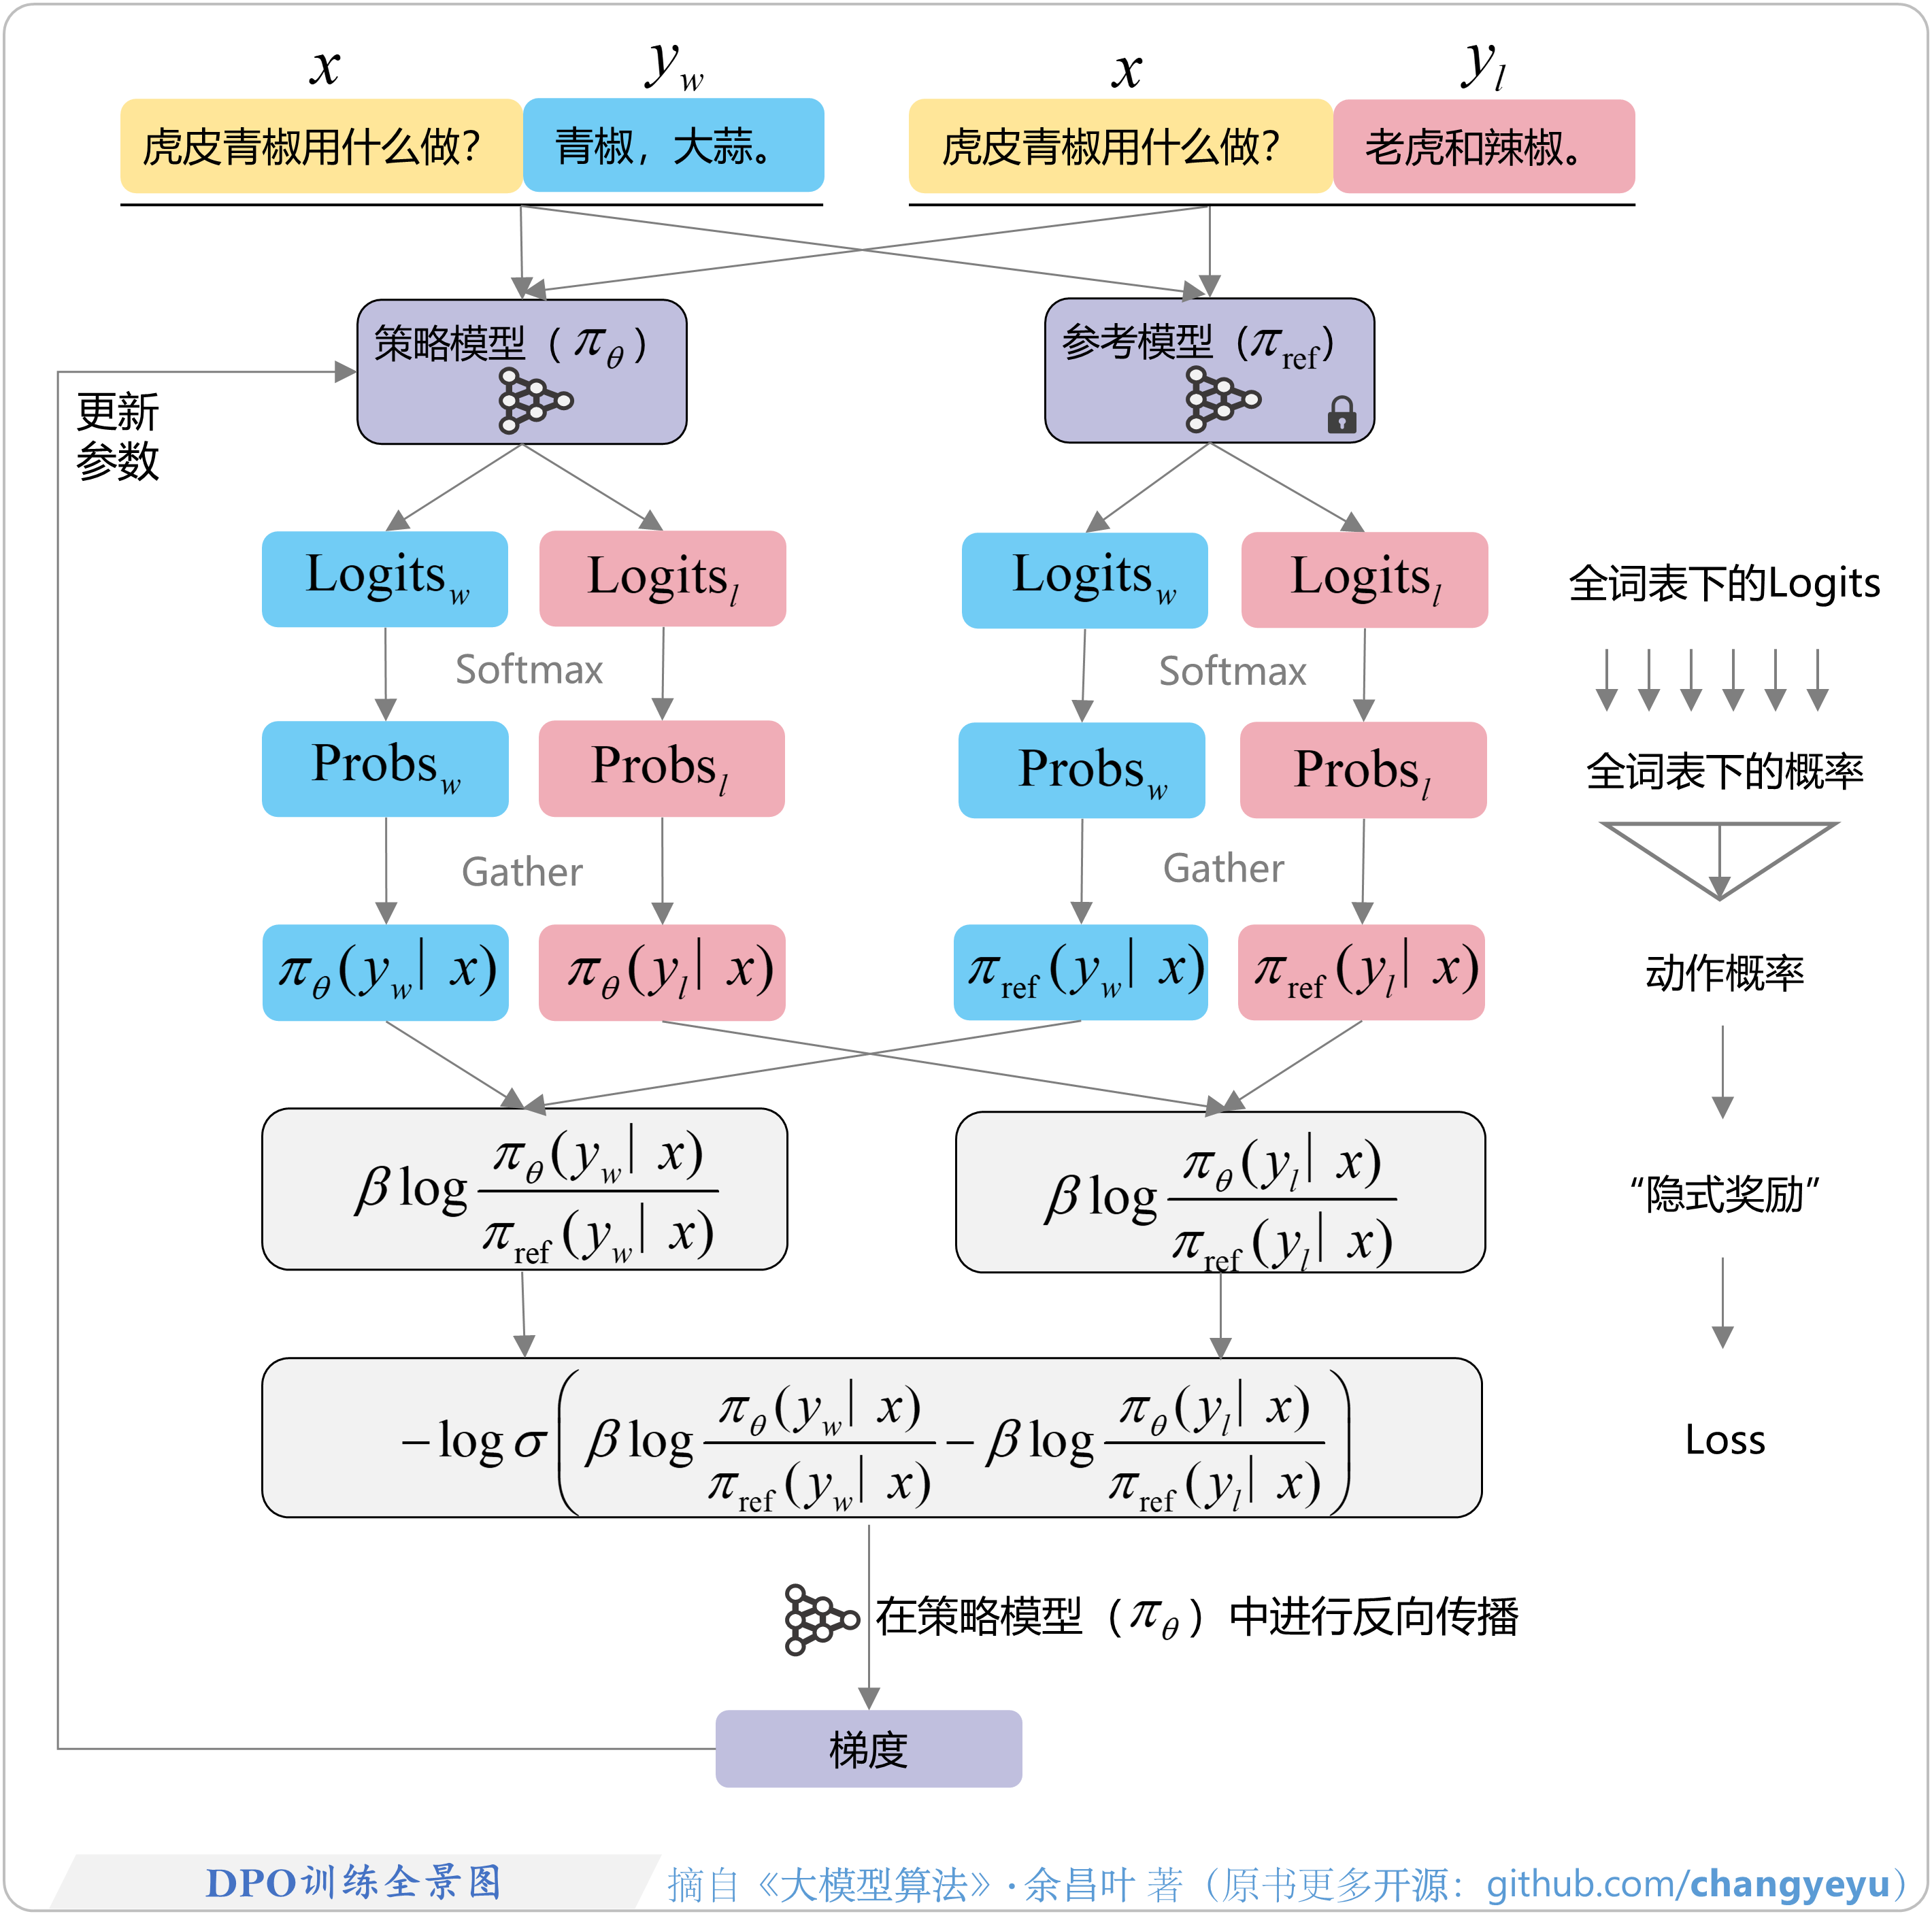
【DPO】DPO训练全景图
- DPO训练时,可以选择加载2个模型(策略模型 和参考模型 ),也可以只加载1个模型(策略模型 )。本文将优先分析加载2个模型的情况。
- DPO的整体训练流程如图所示(蓝色色块代表偏好数据对中的“优质回答” 及其对应的中间计算结果;粉色色块代表偏好数据对中的“劣质回答” 及其对应的中间计算结果)。

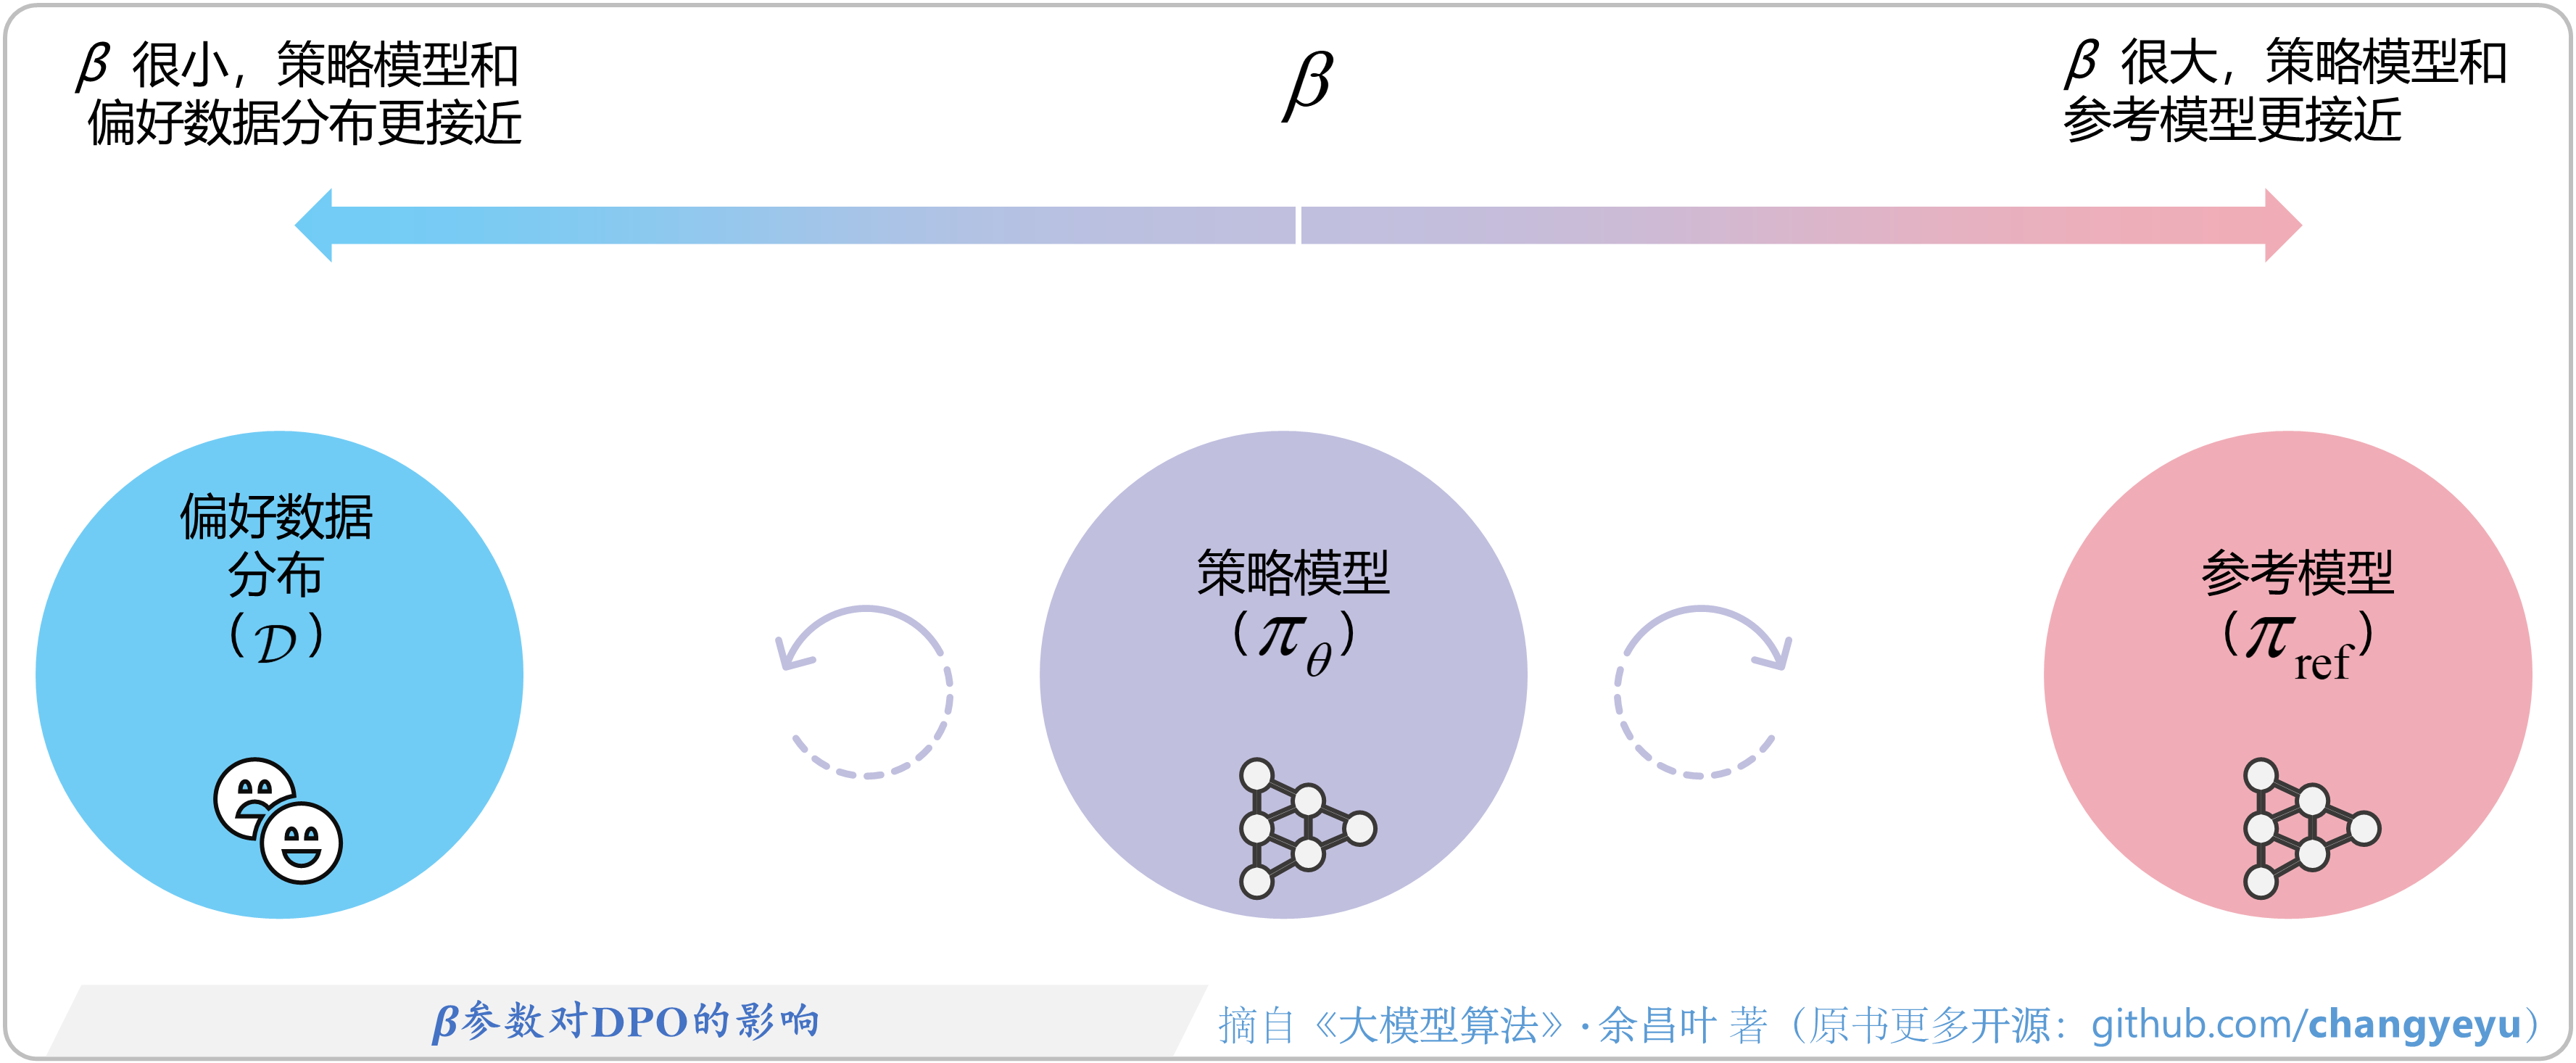
【DPO】β参数对DPO的影响
- 在DPO中, 参数的作用类似于其在RLHF中的作用。

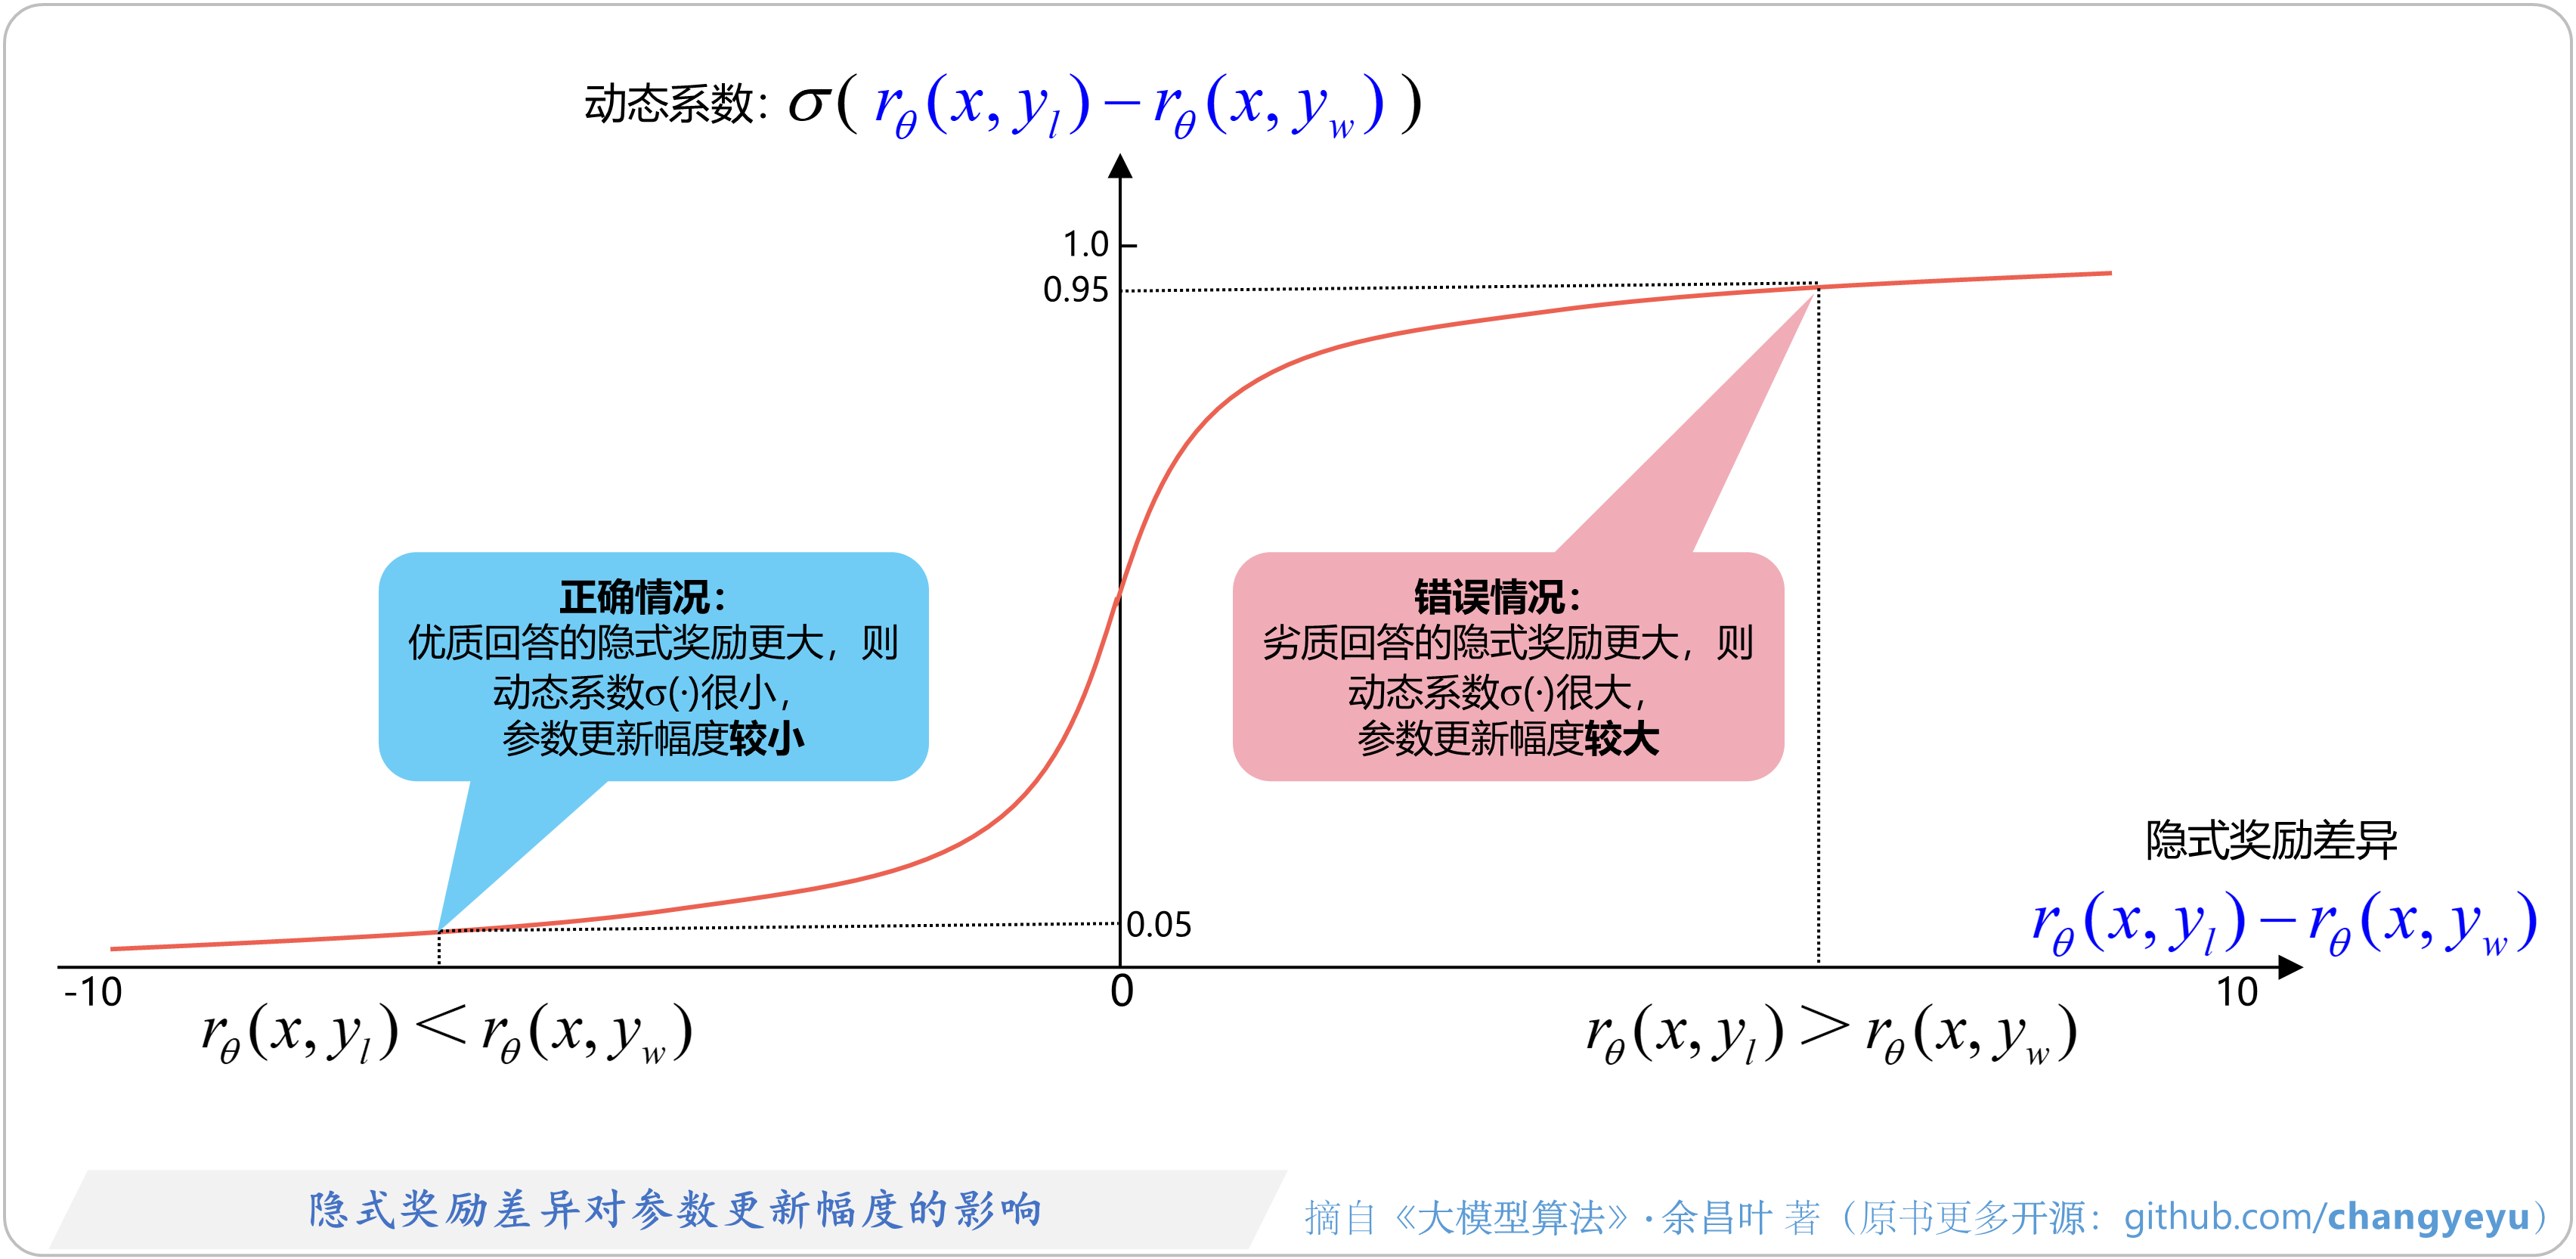
【DPO】隐式奖励差异对参数更新幅度的影响
- DPO的梯度更新旨在增加优质回答的概率,同时减少劣质回答的概率。
- 更重要的是,梯度中包含一个动态系数——优质和劣质回答的隐式奖励差异。换言之,这个动态系数反映了隐式“奖励模型”在对偏好顺序的判断上有多大误差。

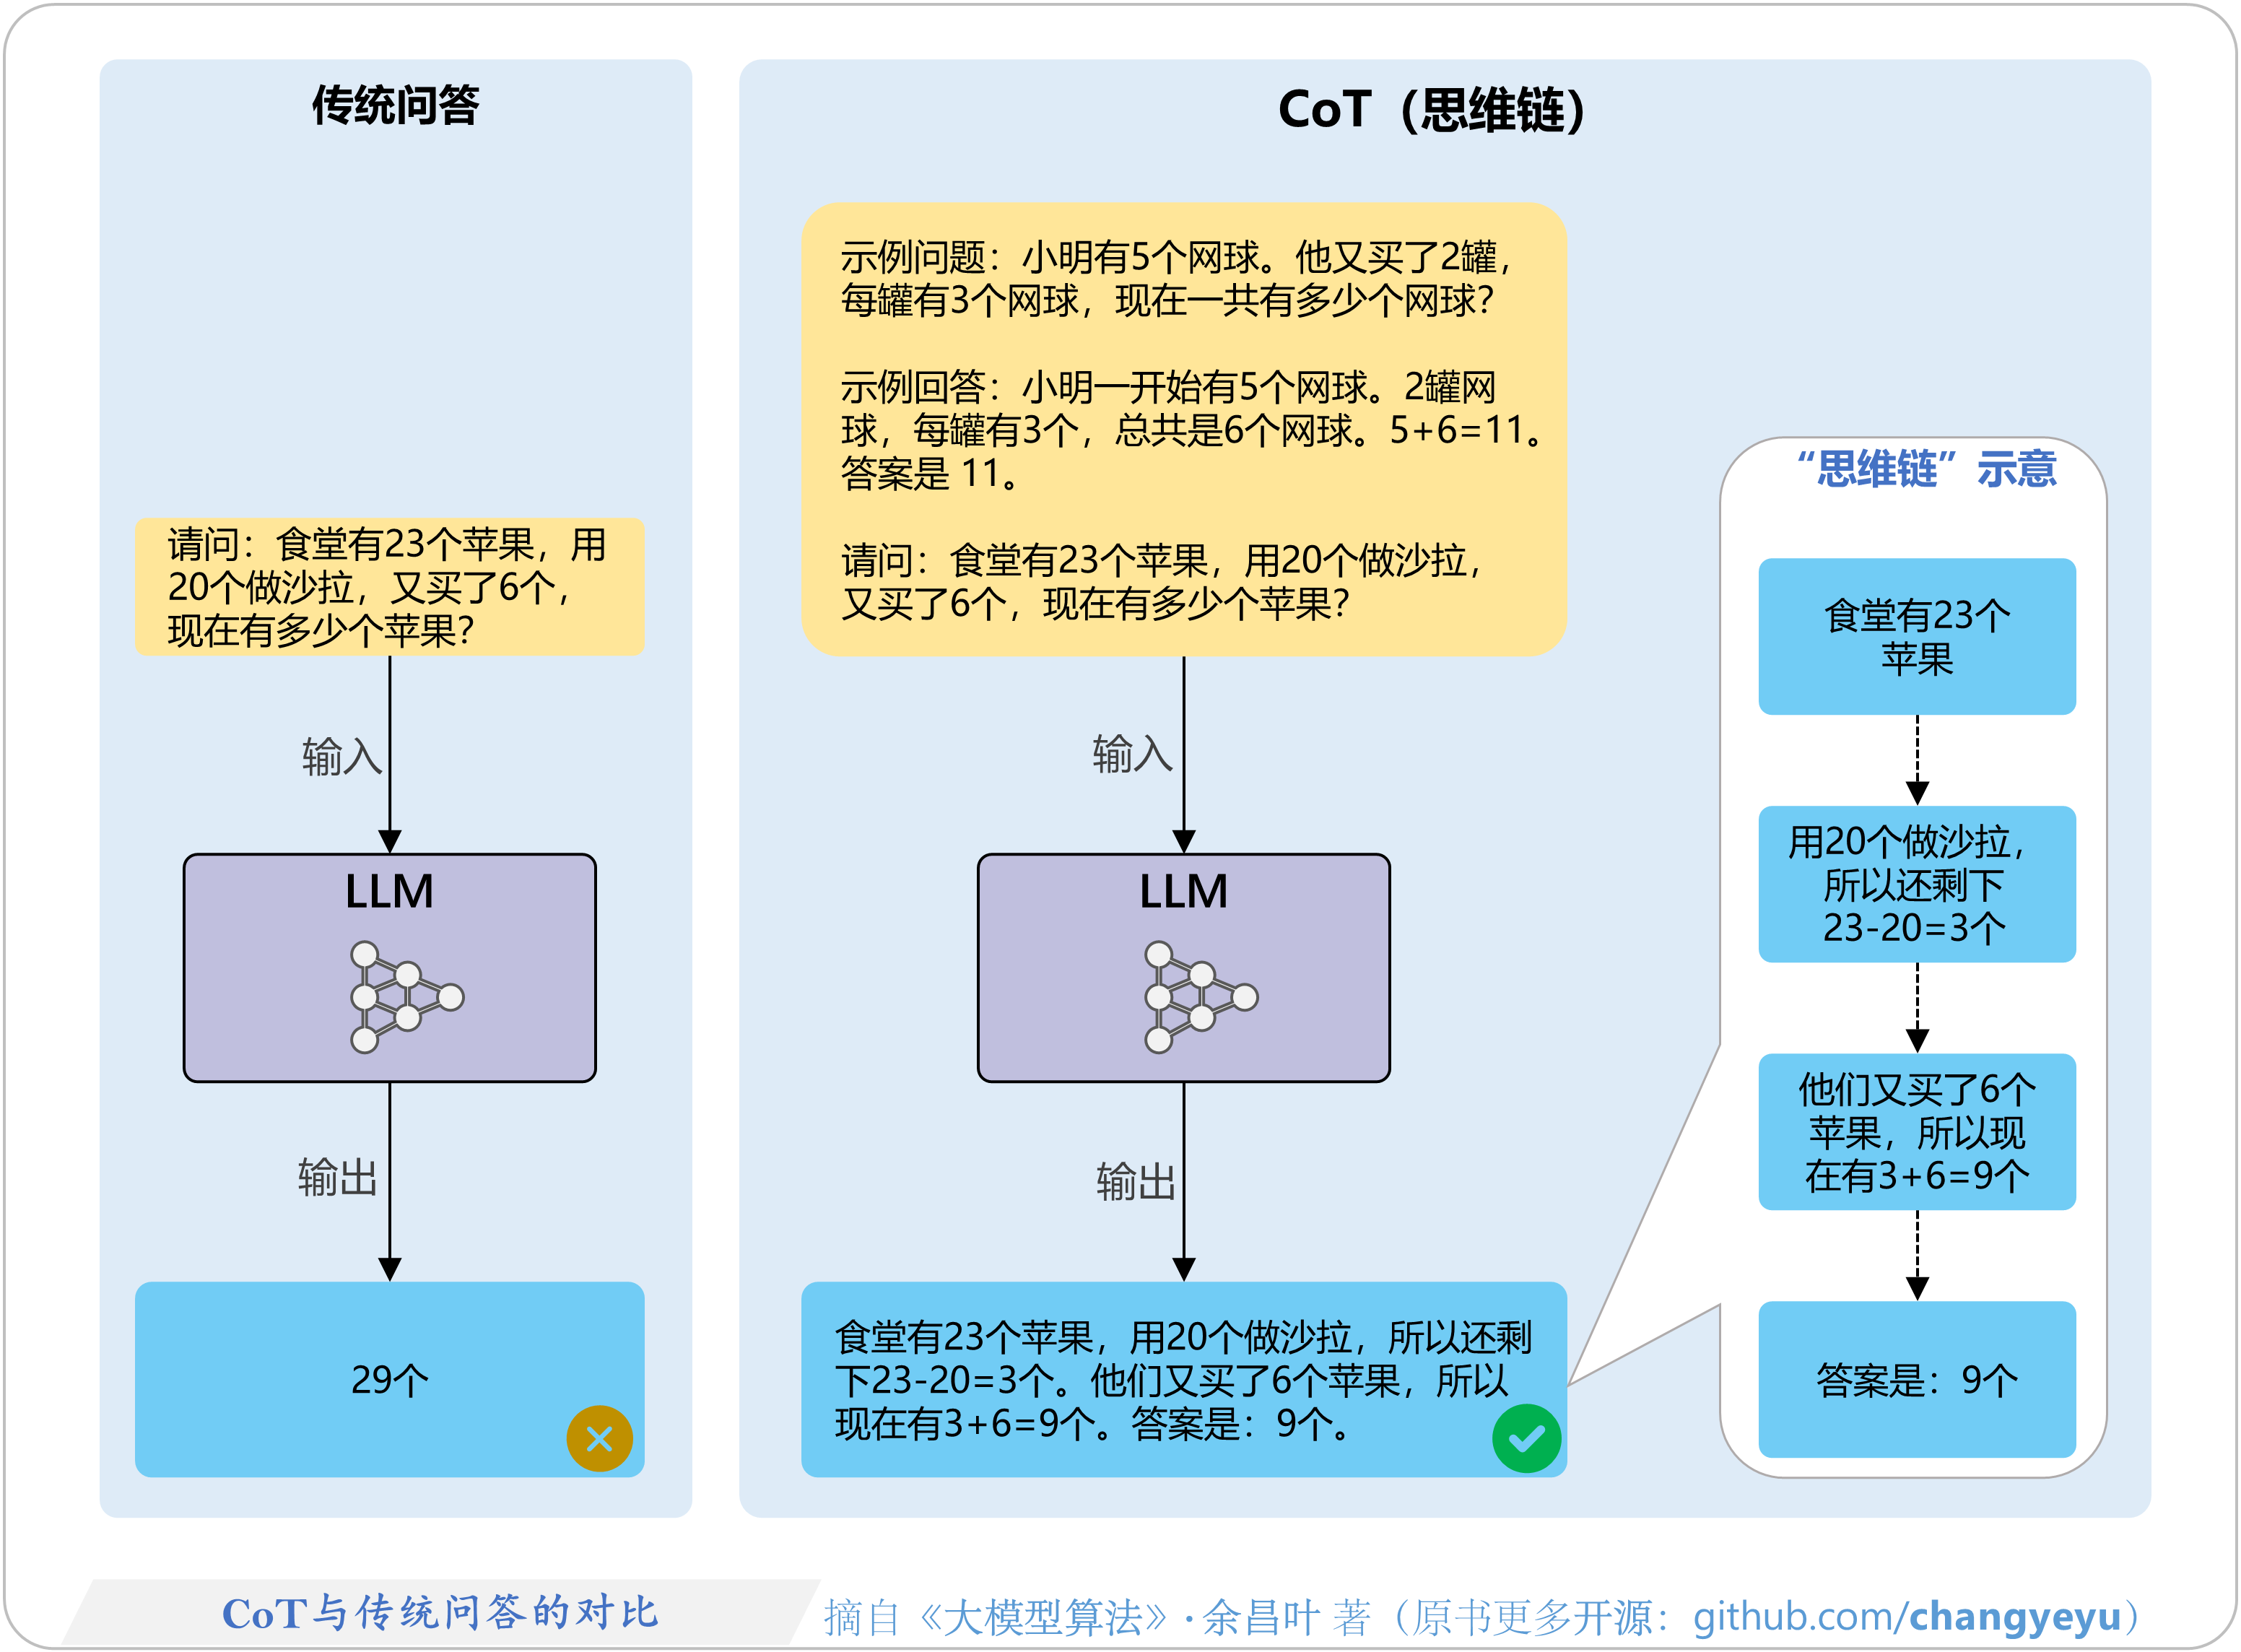
【免训练的优化技术】CoT(Chain of Thought)与传统问答的对比
- CoT(Chain of Thought,思维链)由Jason Wei等研究者于2022年在Google期间提出,是大模型领域的一项重要技术创新,并迅速被广泛应用于学术研究和实际场景。
- 其核心思想是通过显式地分步推理,提升模型在复杂推理任务中的表现。

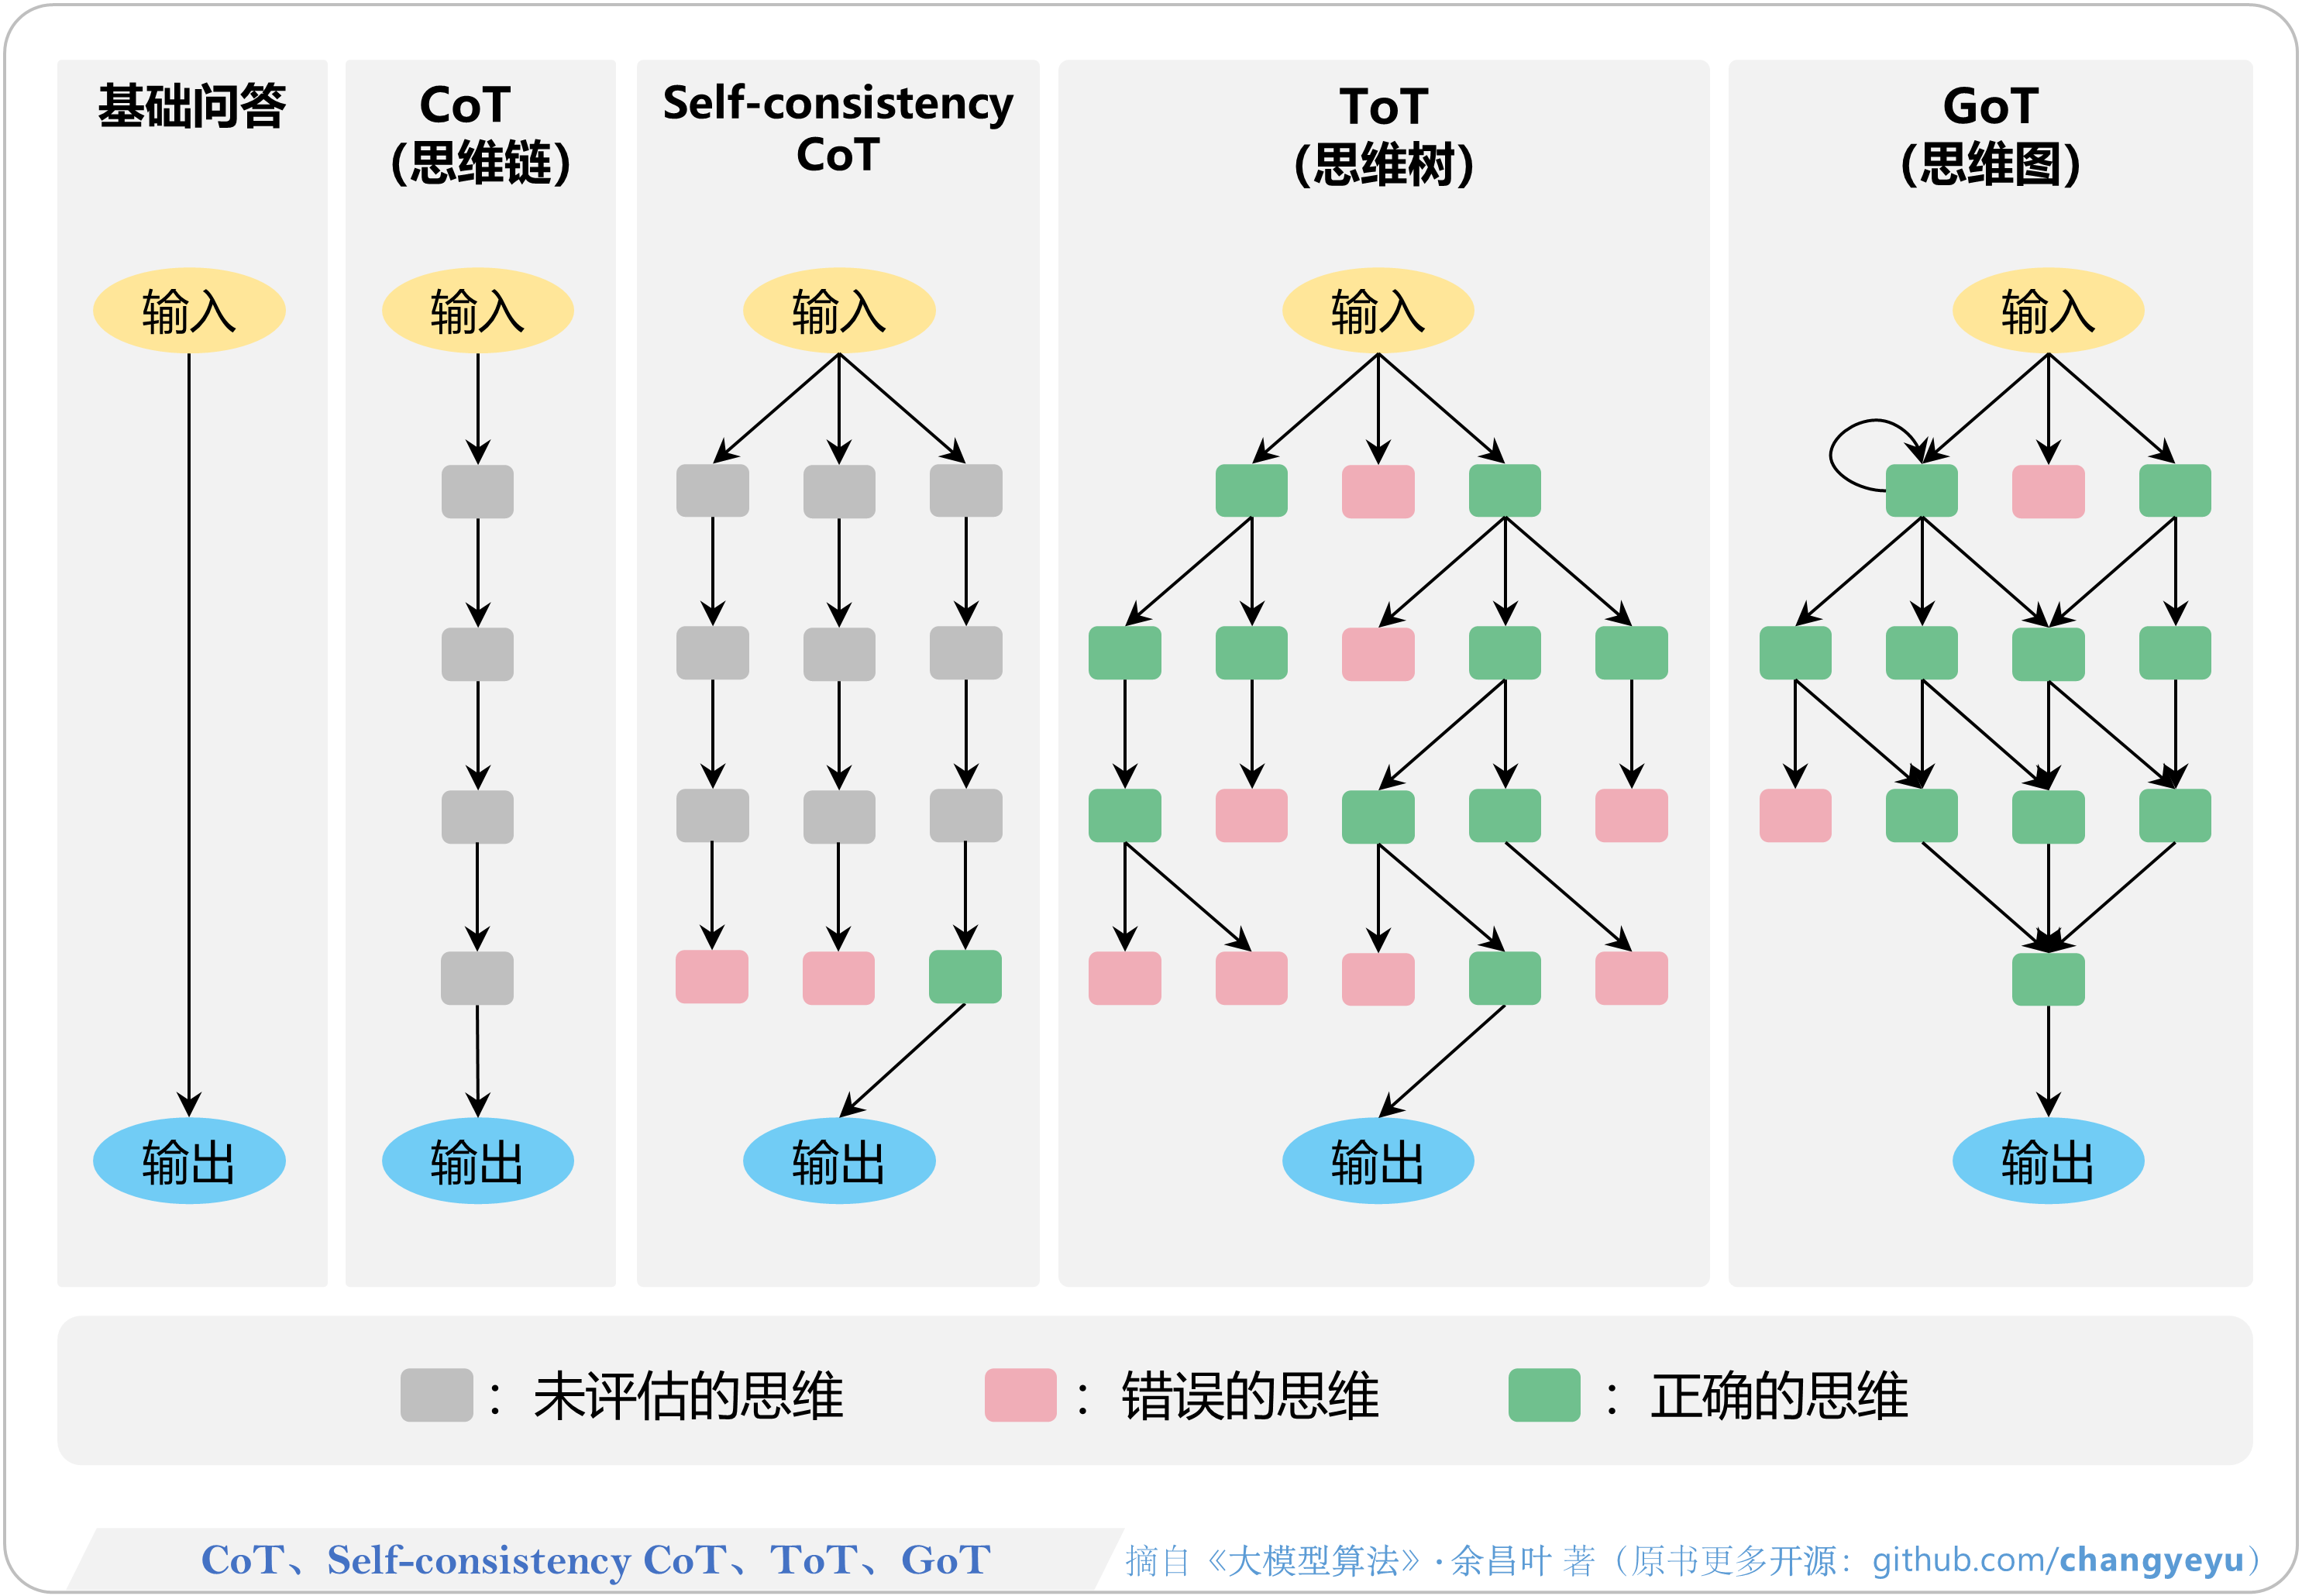
【免训练的优化技术】CoT、Self-consistency CoT、ToT、GoT [87]
- 在CoT展现其潜力后,迅速衍生出多种相关技术,例如ToT、GoT、Self-consistency CoT、Zero-shot-CoT、Auto-CoT、MoT、XoT等

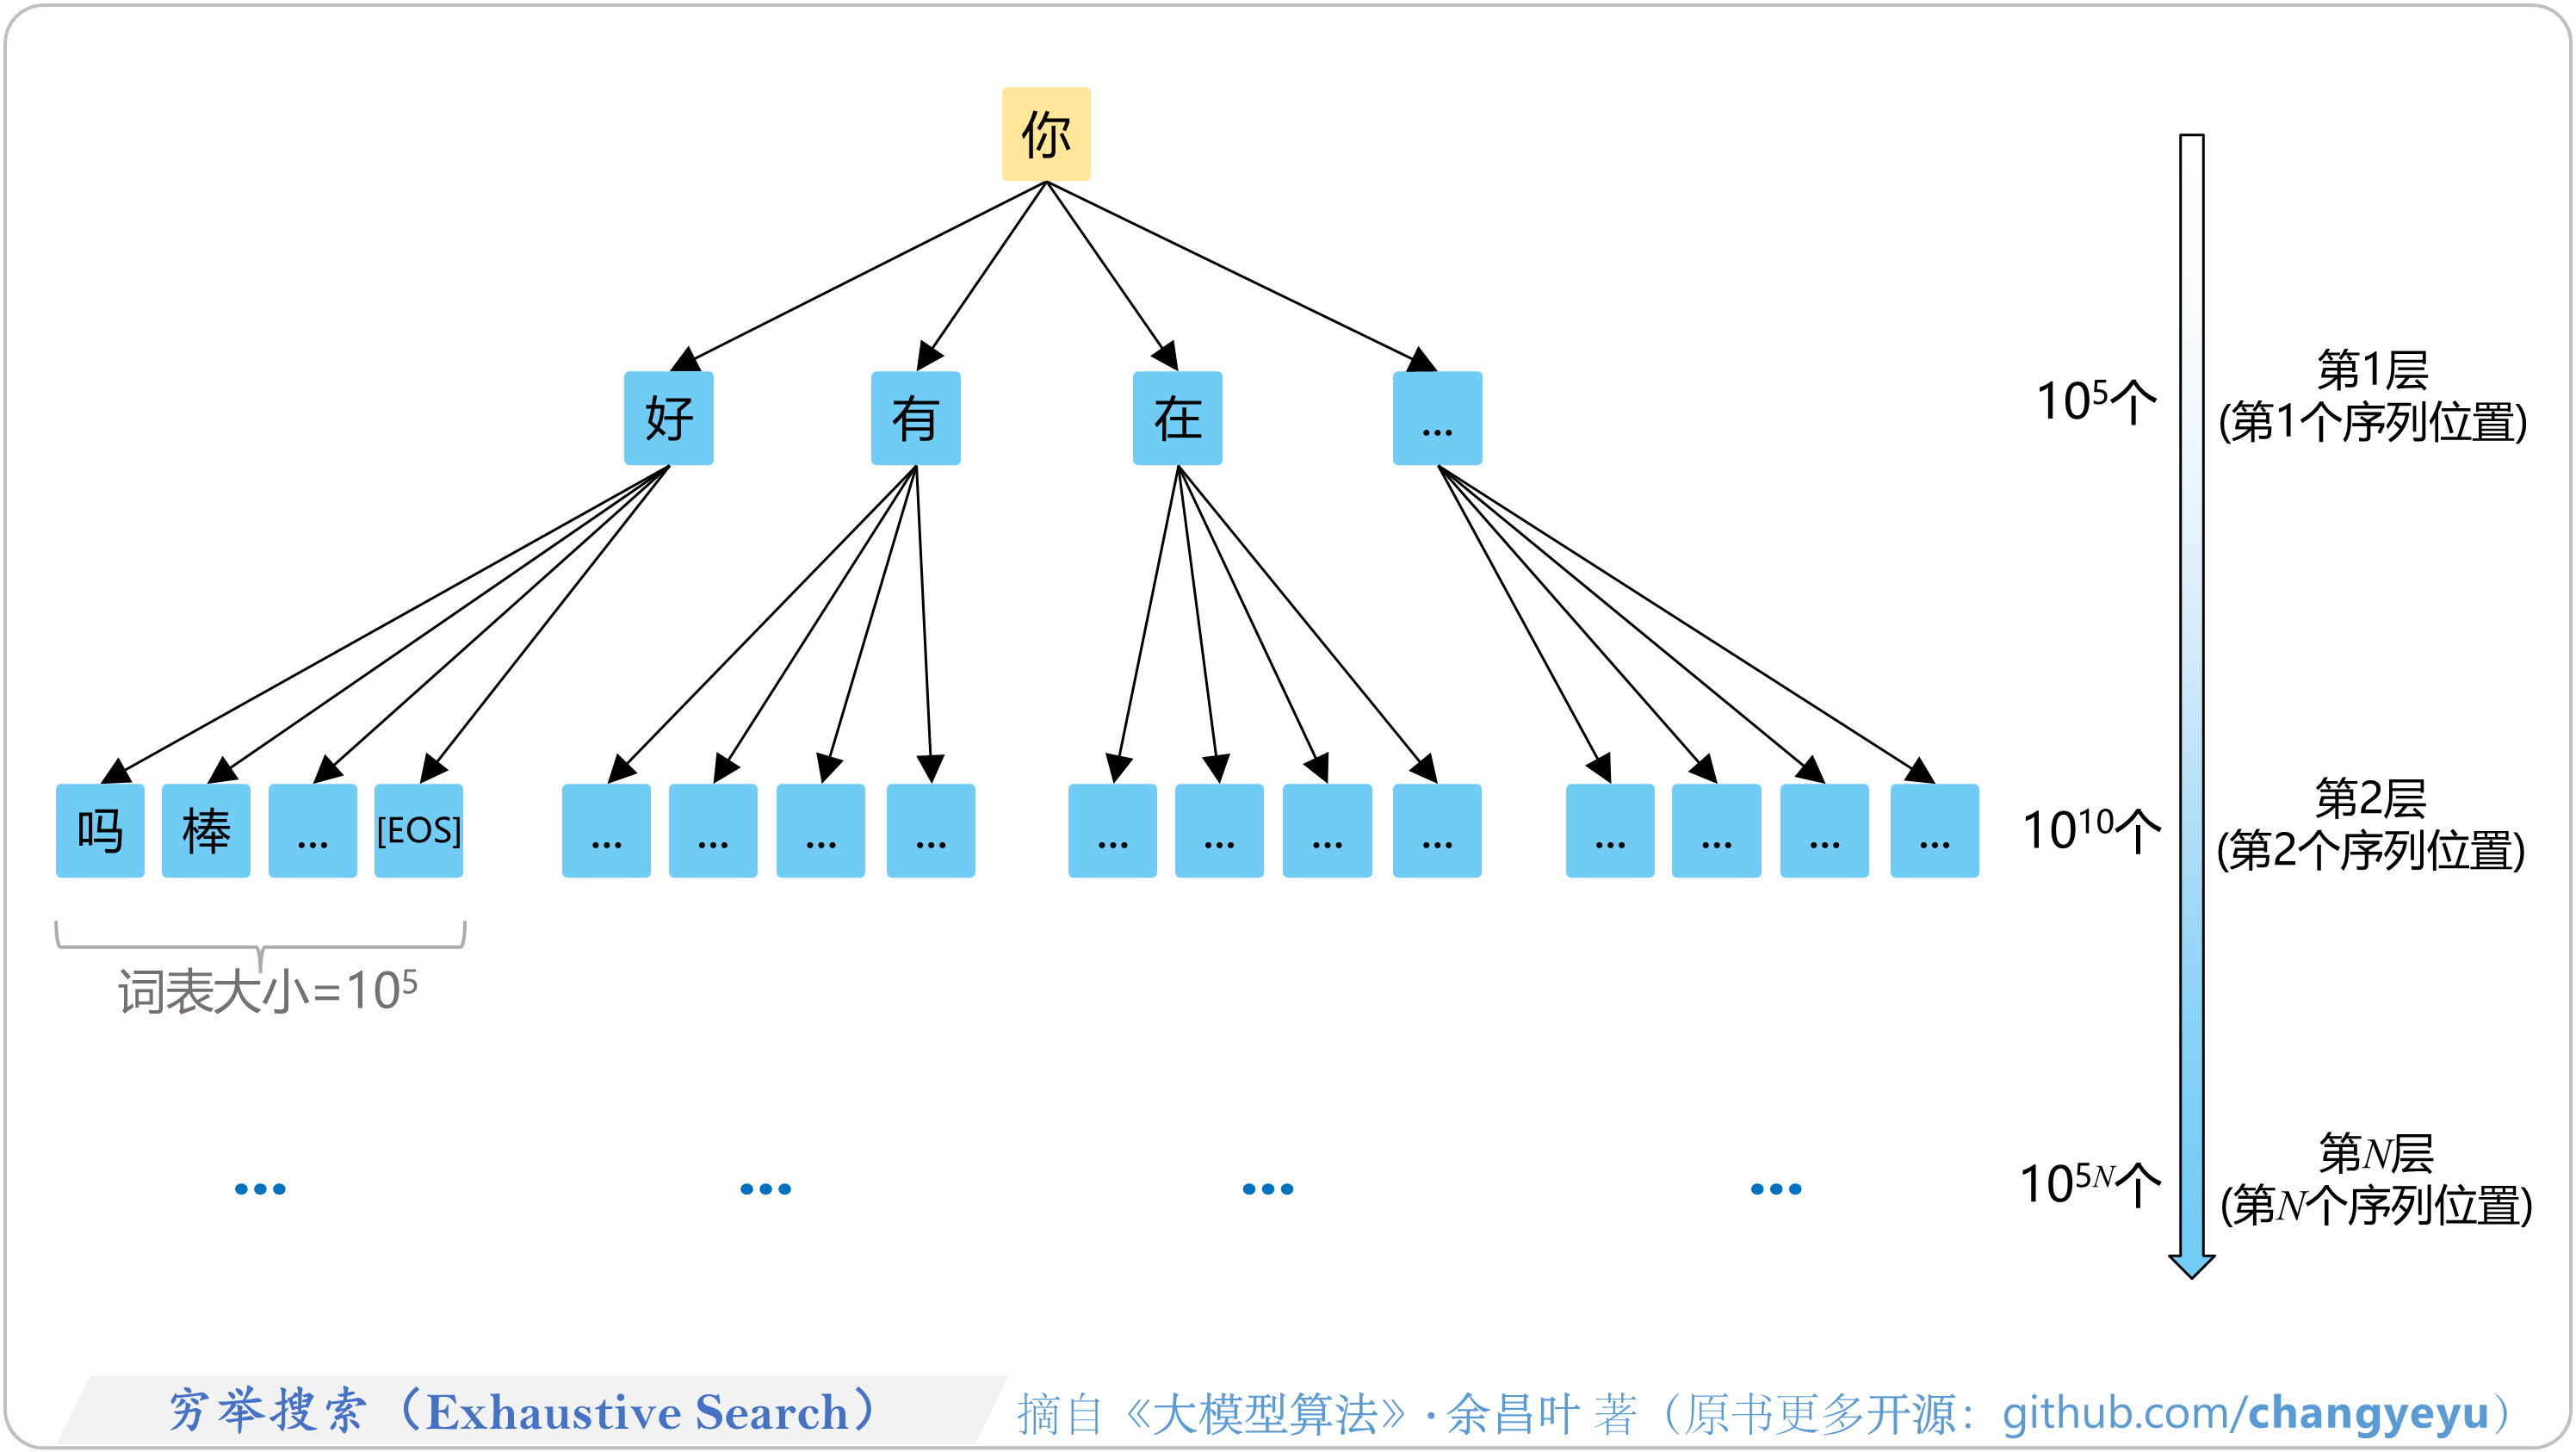
【免训练的优化技术】穷举搜索(Exhaustive Search)
- Token的生成过程可以形象地表示为一个以词表大小 V=105 为基数的多叉树结构。理论上,采用穷举搜索(Exhaustive Search)的方法能够获得全局最优解。然而,穷举搜索的计算代价极高。

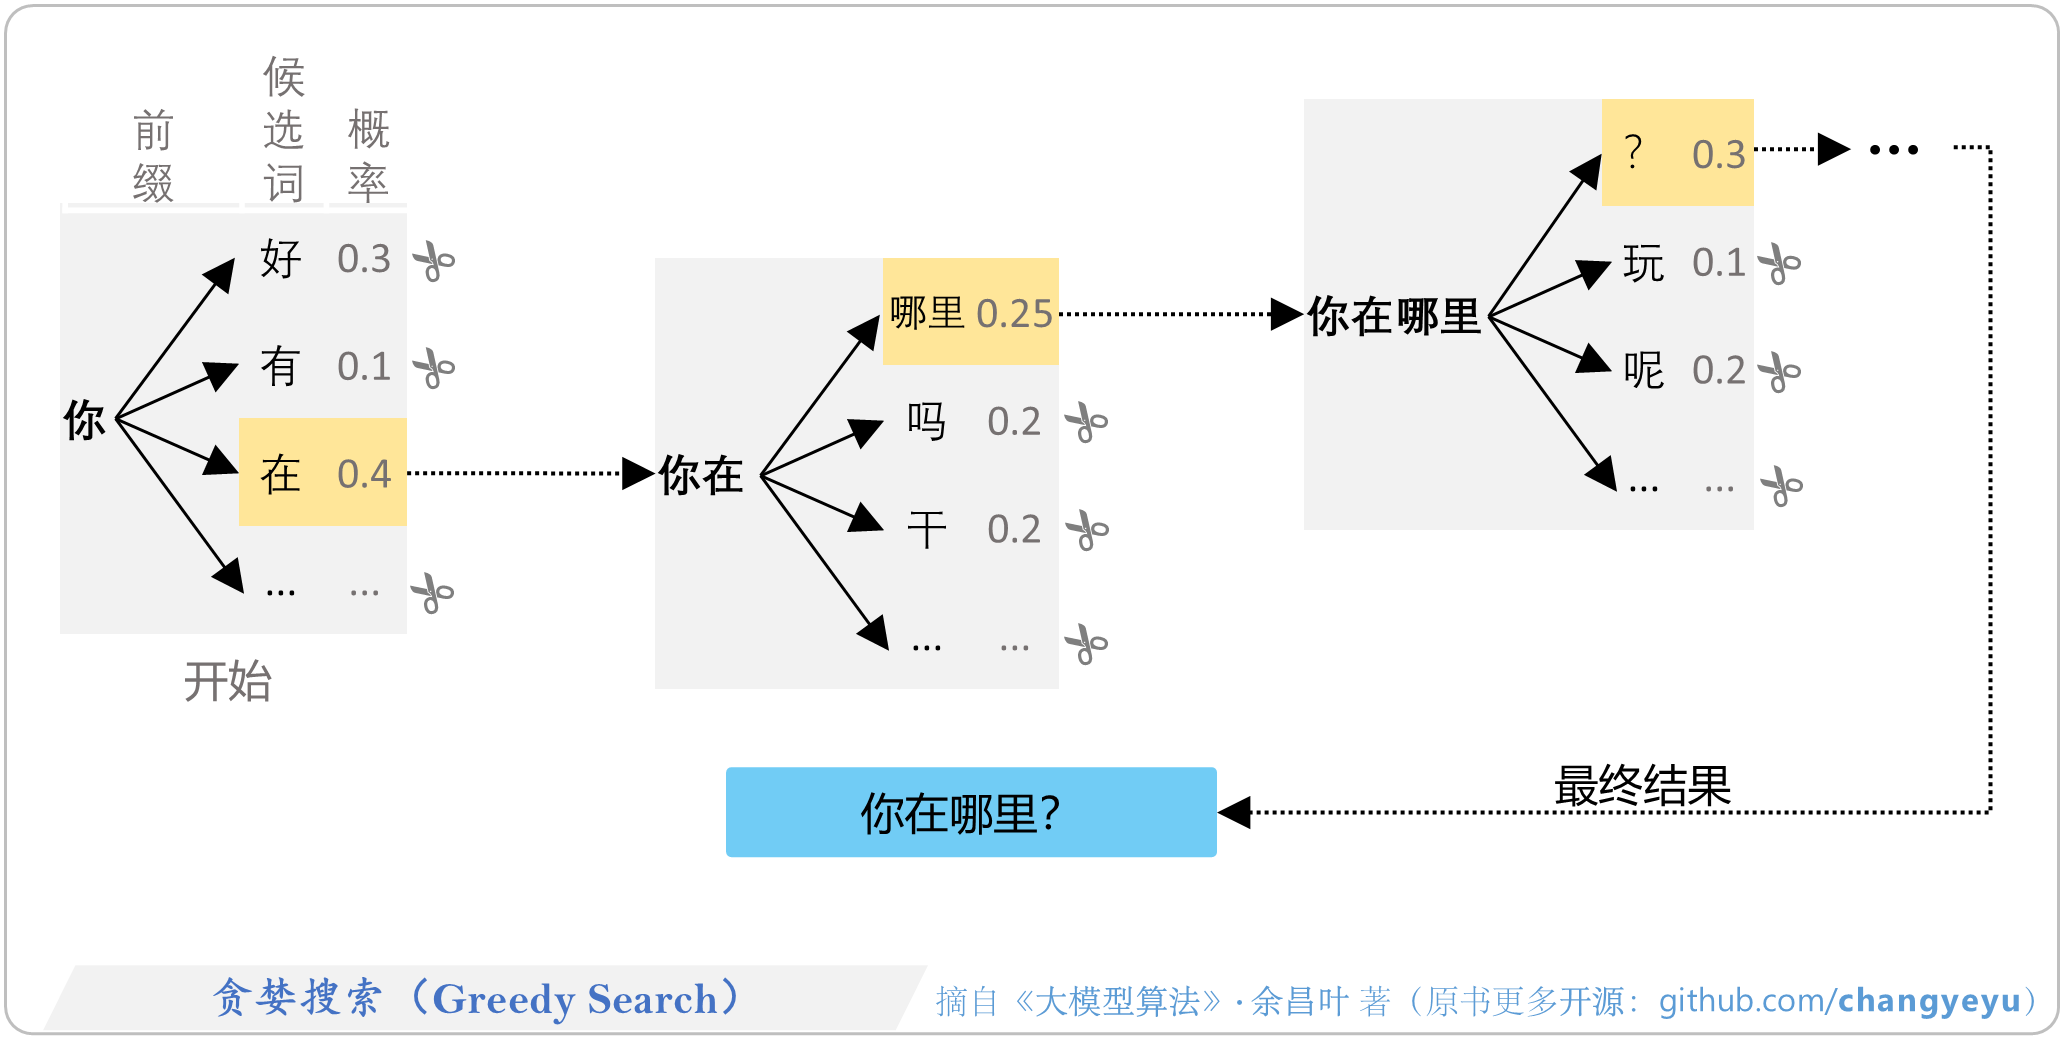
【免训练的优化技术】贪婪搜索(Greedy Search)
- 贪婪搜索(Greedy Search)在生成下一个Token(词元)时,每次都会选择当前概率最高的一个Token,不考虑生成序列的全局最优性或多样性,然后继续对下一个Token位置执行相同的操作。尽管这种方法简单快速,但生成的内容可能过早陷入局部最优,缺乏多样性。

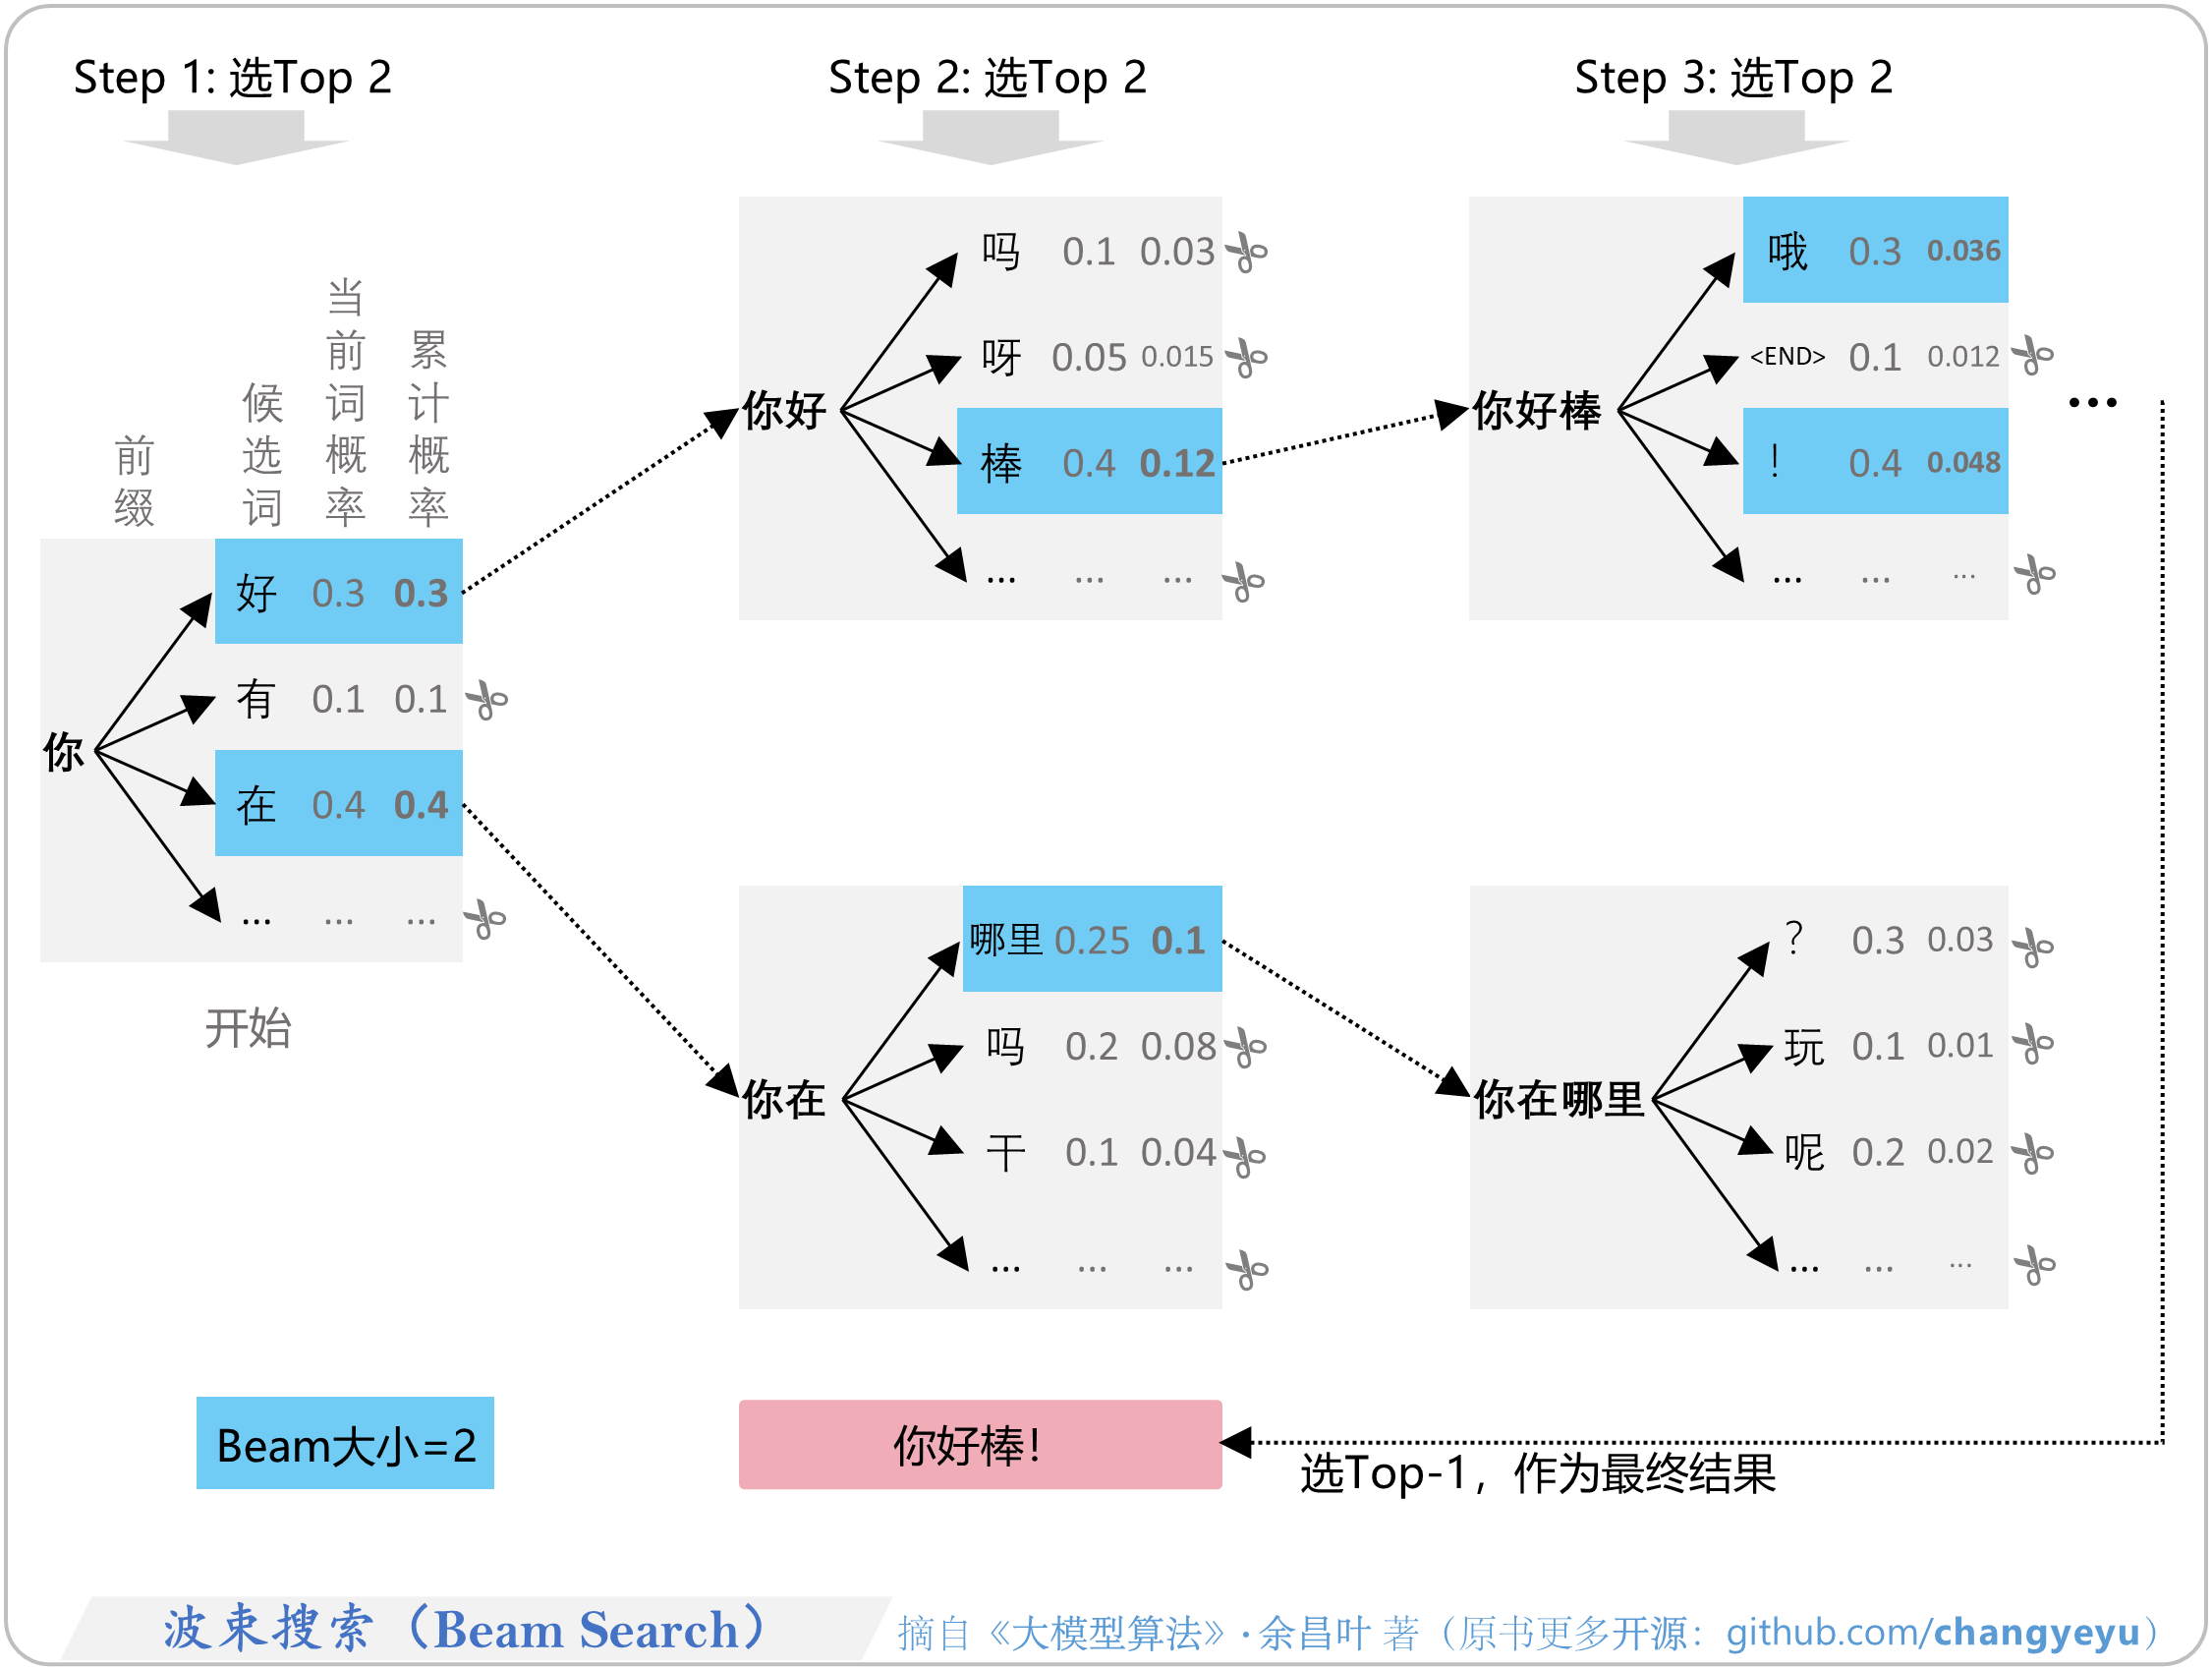
【免训练的优化技术】波束搜索(Beam Search)
- Beam Search(波束搜索)在每一步生成时,不仅仅选择一个最优Token(词元),而是保留多个候选序列(称为Beam,即波束),其余的路径则被剪枝。这些候选序列会在后续步骤中继续扩展,直到生成结束。
- 最终,从所有候选序列中选择得分最高的一条作为最终输出。Beam的数量(num_beams参数)越大,搜索空间越广,生成结果越接近全局最优,但计算成本也随之增加。

【免训练的优化技术】多项式采样(Multinomial Sampling)
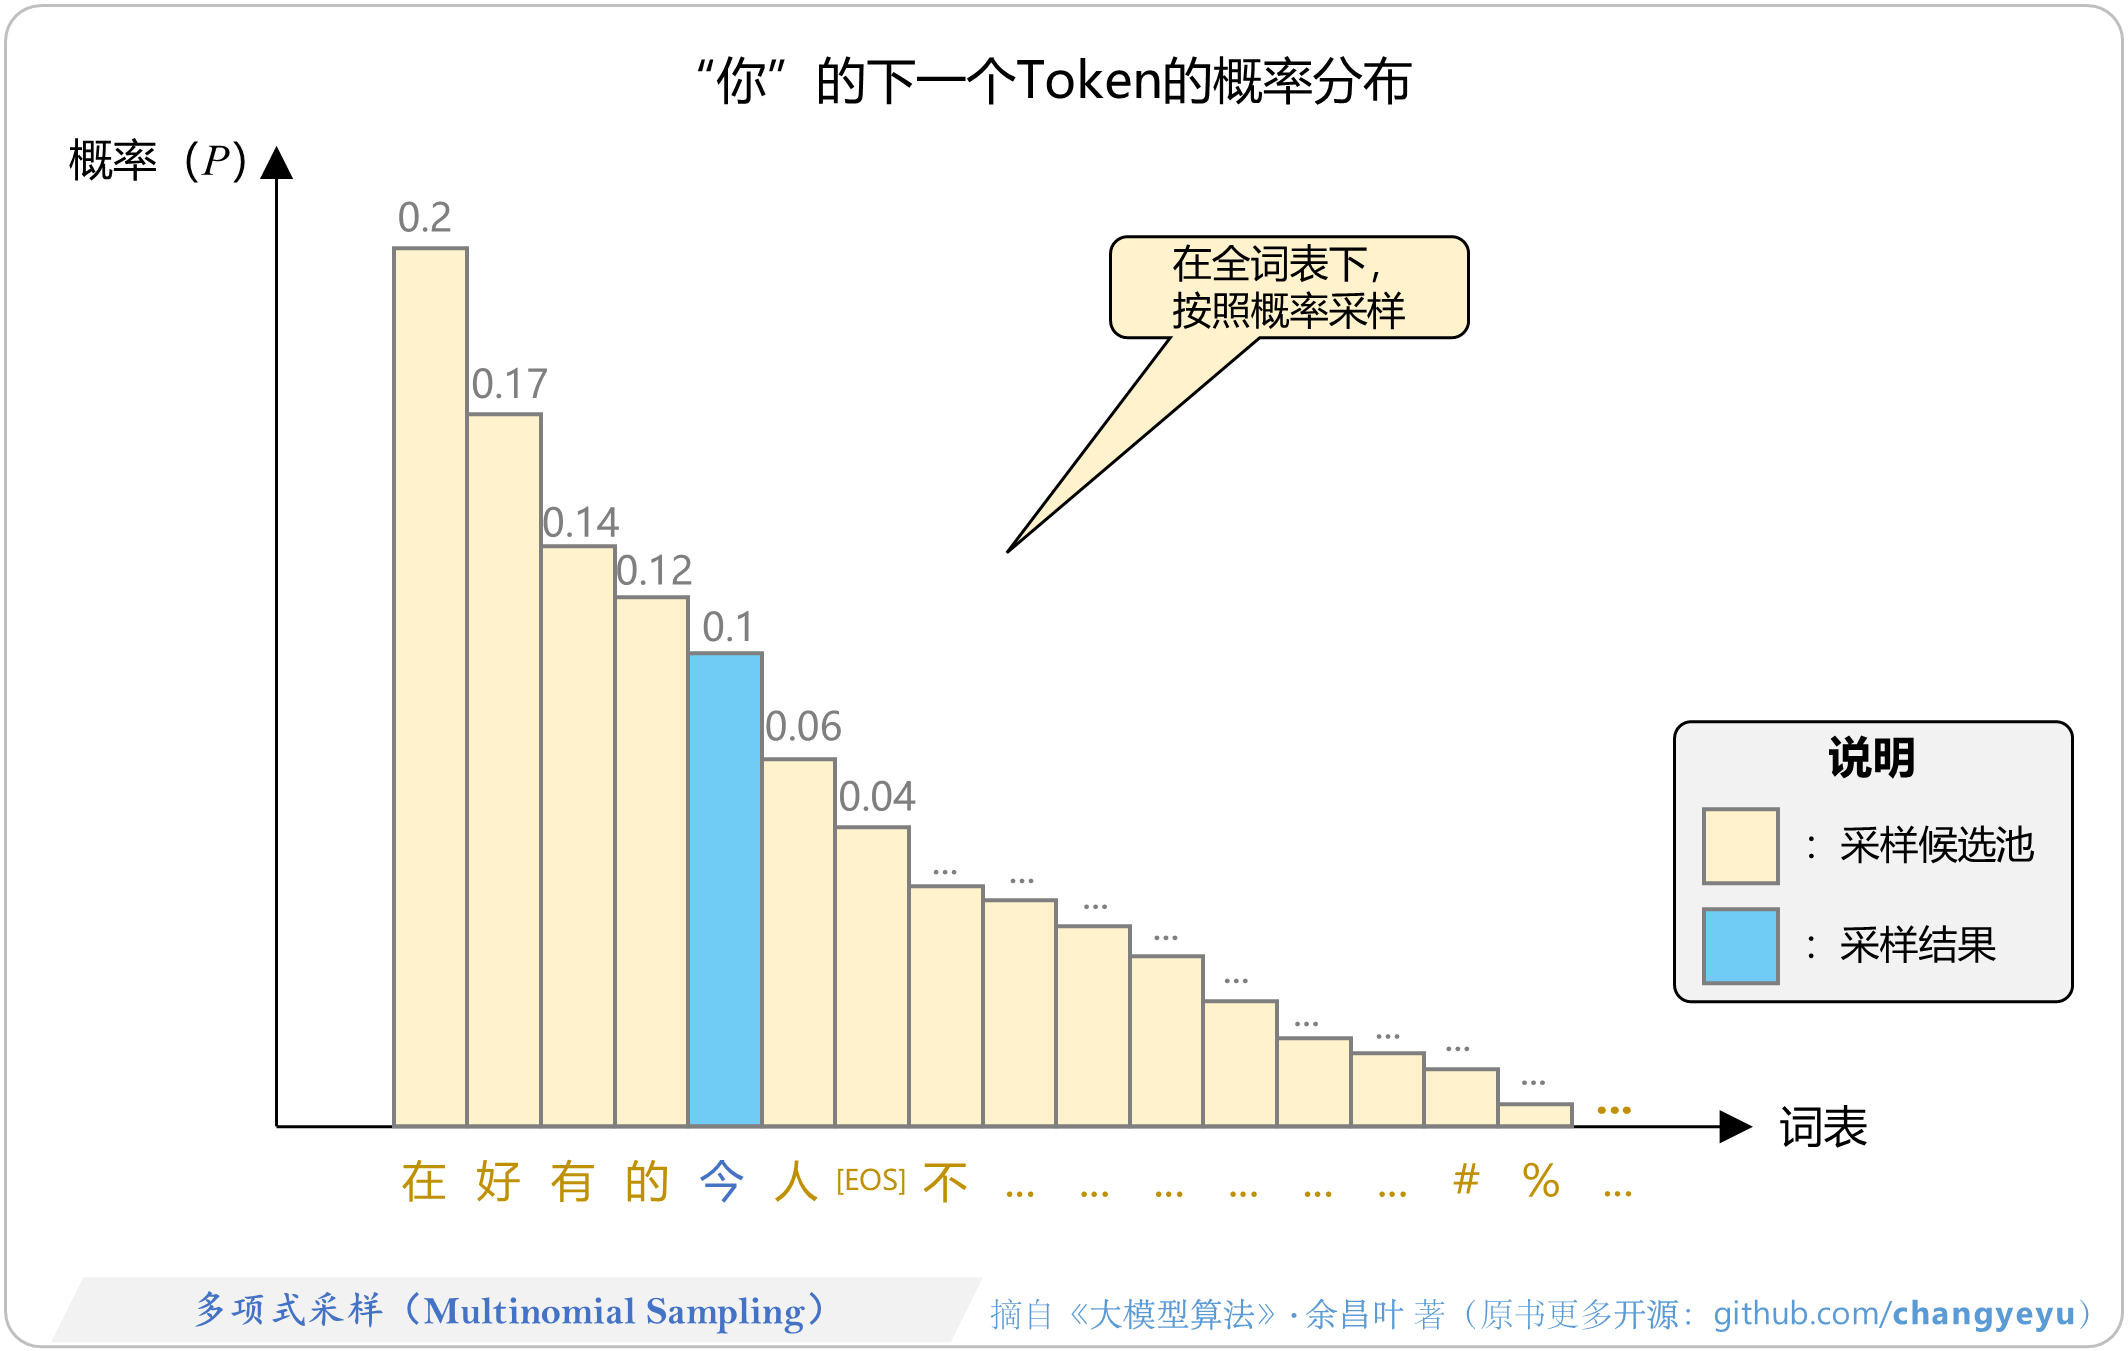
- 多项式采样(Multinomial Sampling)是生成式模型中一种常见的随机采样方法,生成下一个Token时,以模型预测的概率分布为依据,在概率分布中“按概率大小”随机抽取Token(而非等概率随机抽样)。
- 包含Top-K、Top-P等

【免训练的优化技术】Top-K采样(Top-K Sampling)
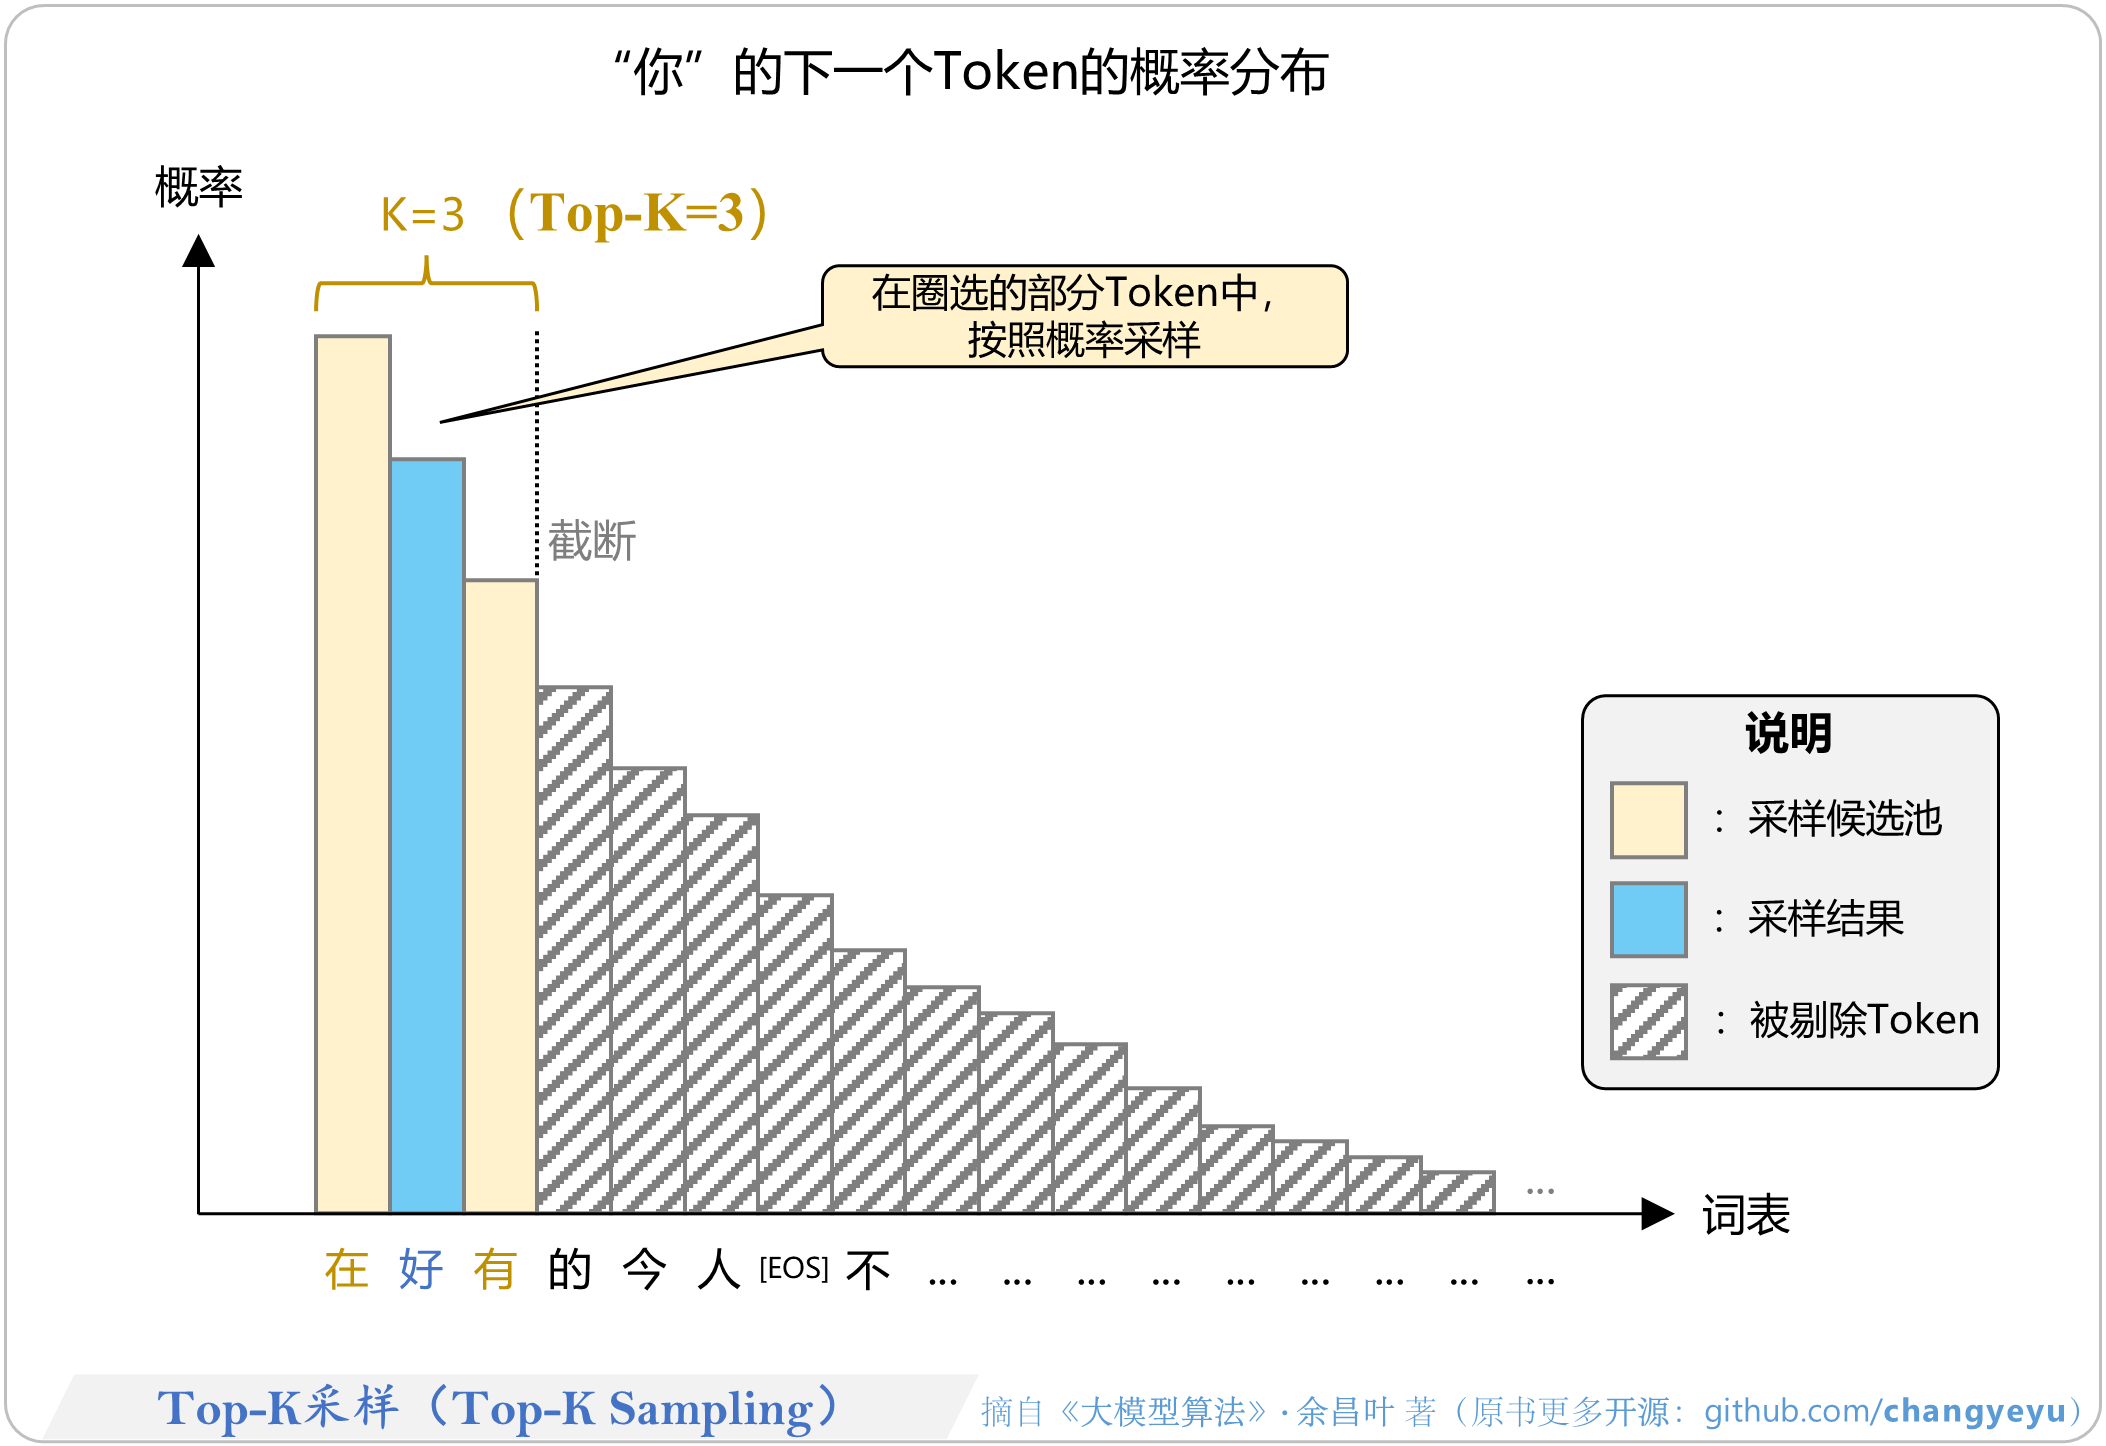
- Top-K采样(Top-K Sampling)是一种在生成任务中常用的策略,类似于多项式采样,但其采样候选池经过限制。使用Top-K采样时,每一步生成Token时仅保留模型预测概率最高的前K个词,并从中按概率分布进行随机抽样。

【免训练的优化技术】Top-P采样(Top-P Sampling)
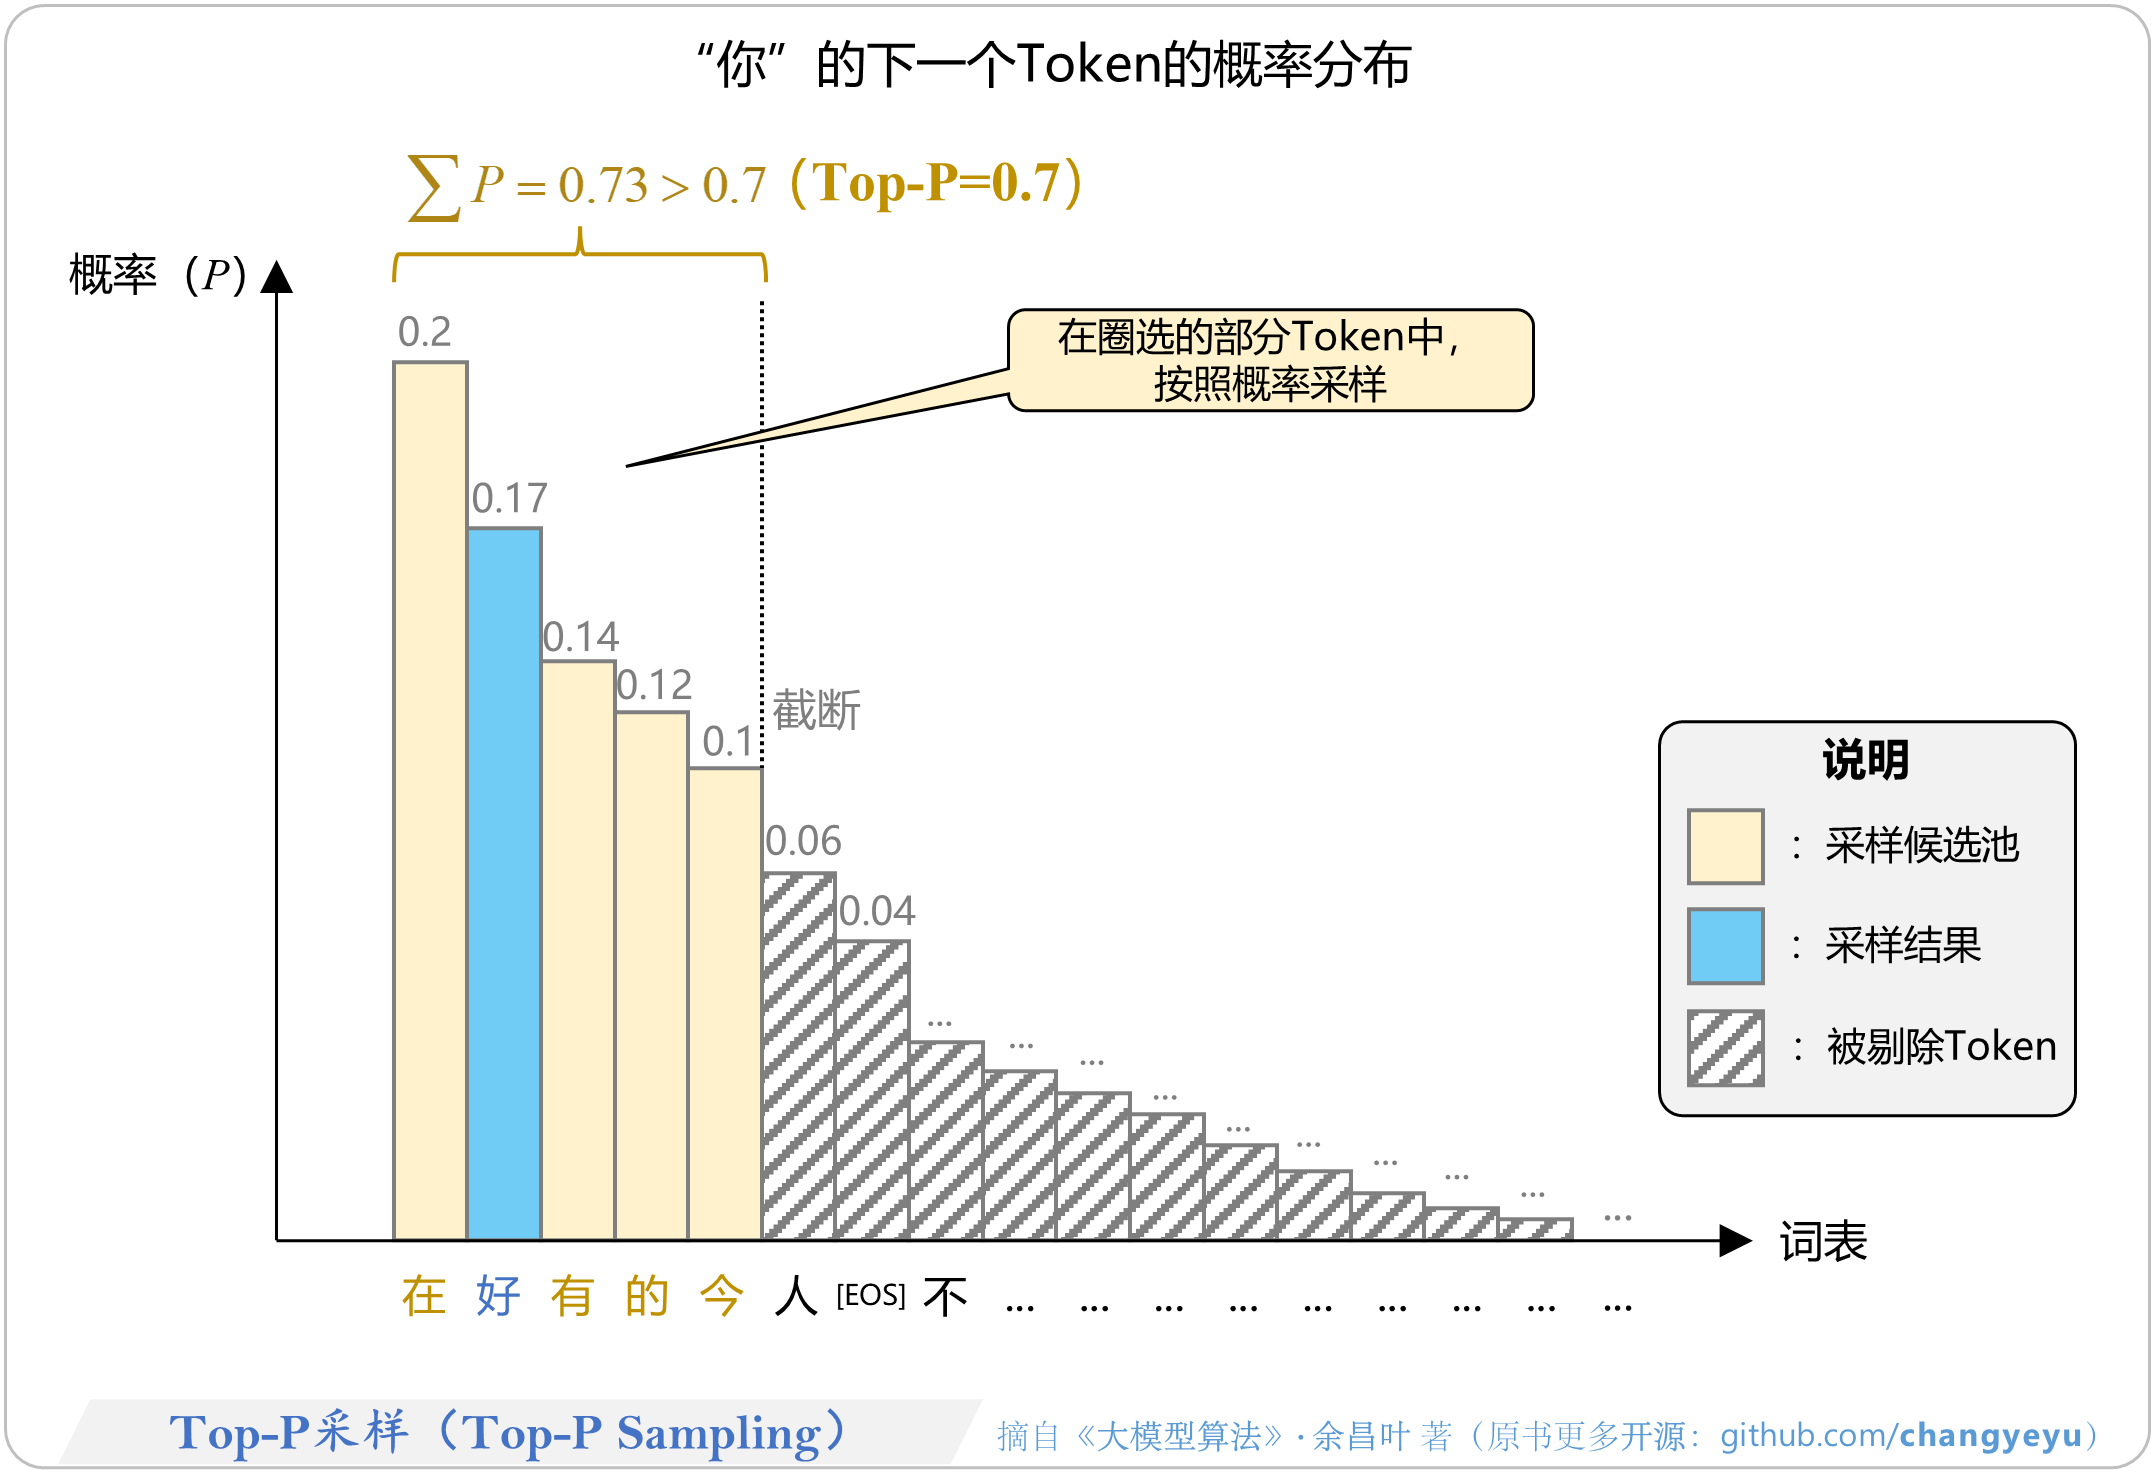
- Top-P采样(Top-P Sampling),又称核采样(Nucleus Sampling),该方法通过动态选择一个最小候选集合,使得候选词的概率和达到设定的概率阈值P,然后,在该候选集合中随机采样。与Top-K采样相比,Top-P采样能够根据概率累积动态调整候选集的大小。

【免训练的优化技术】RAG(检索增强生成,Retrieval-Augmented Generation)
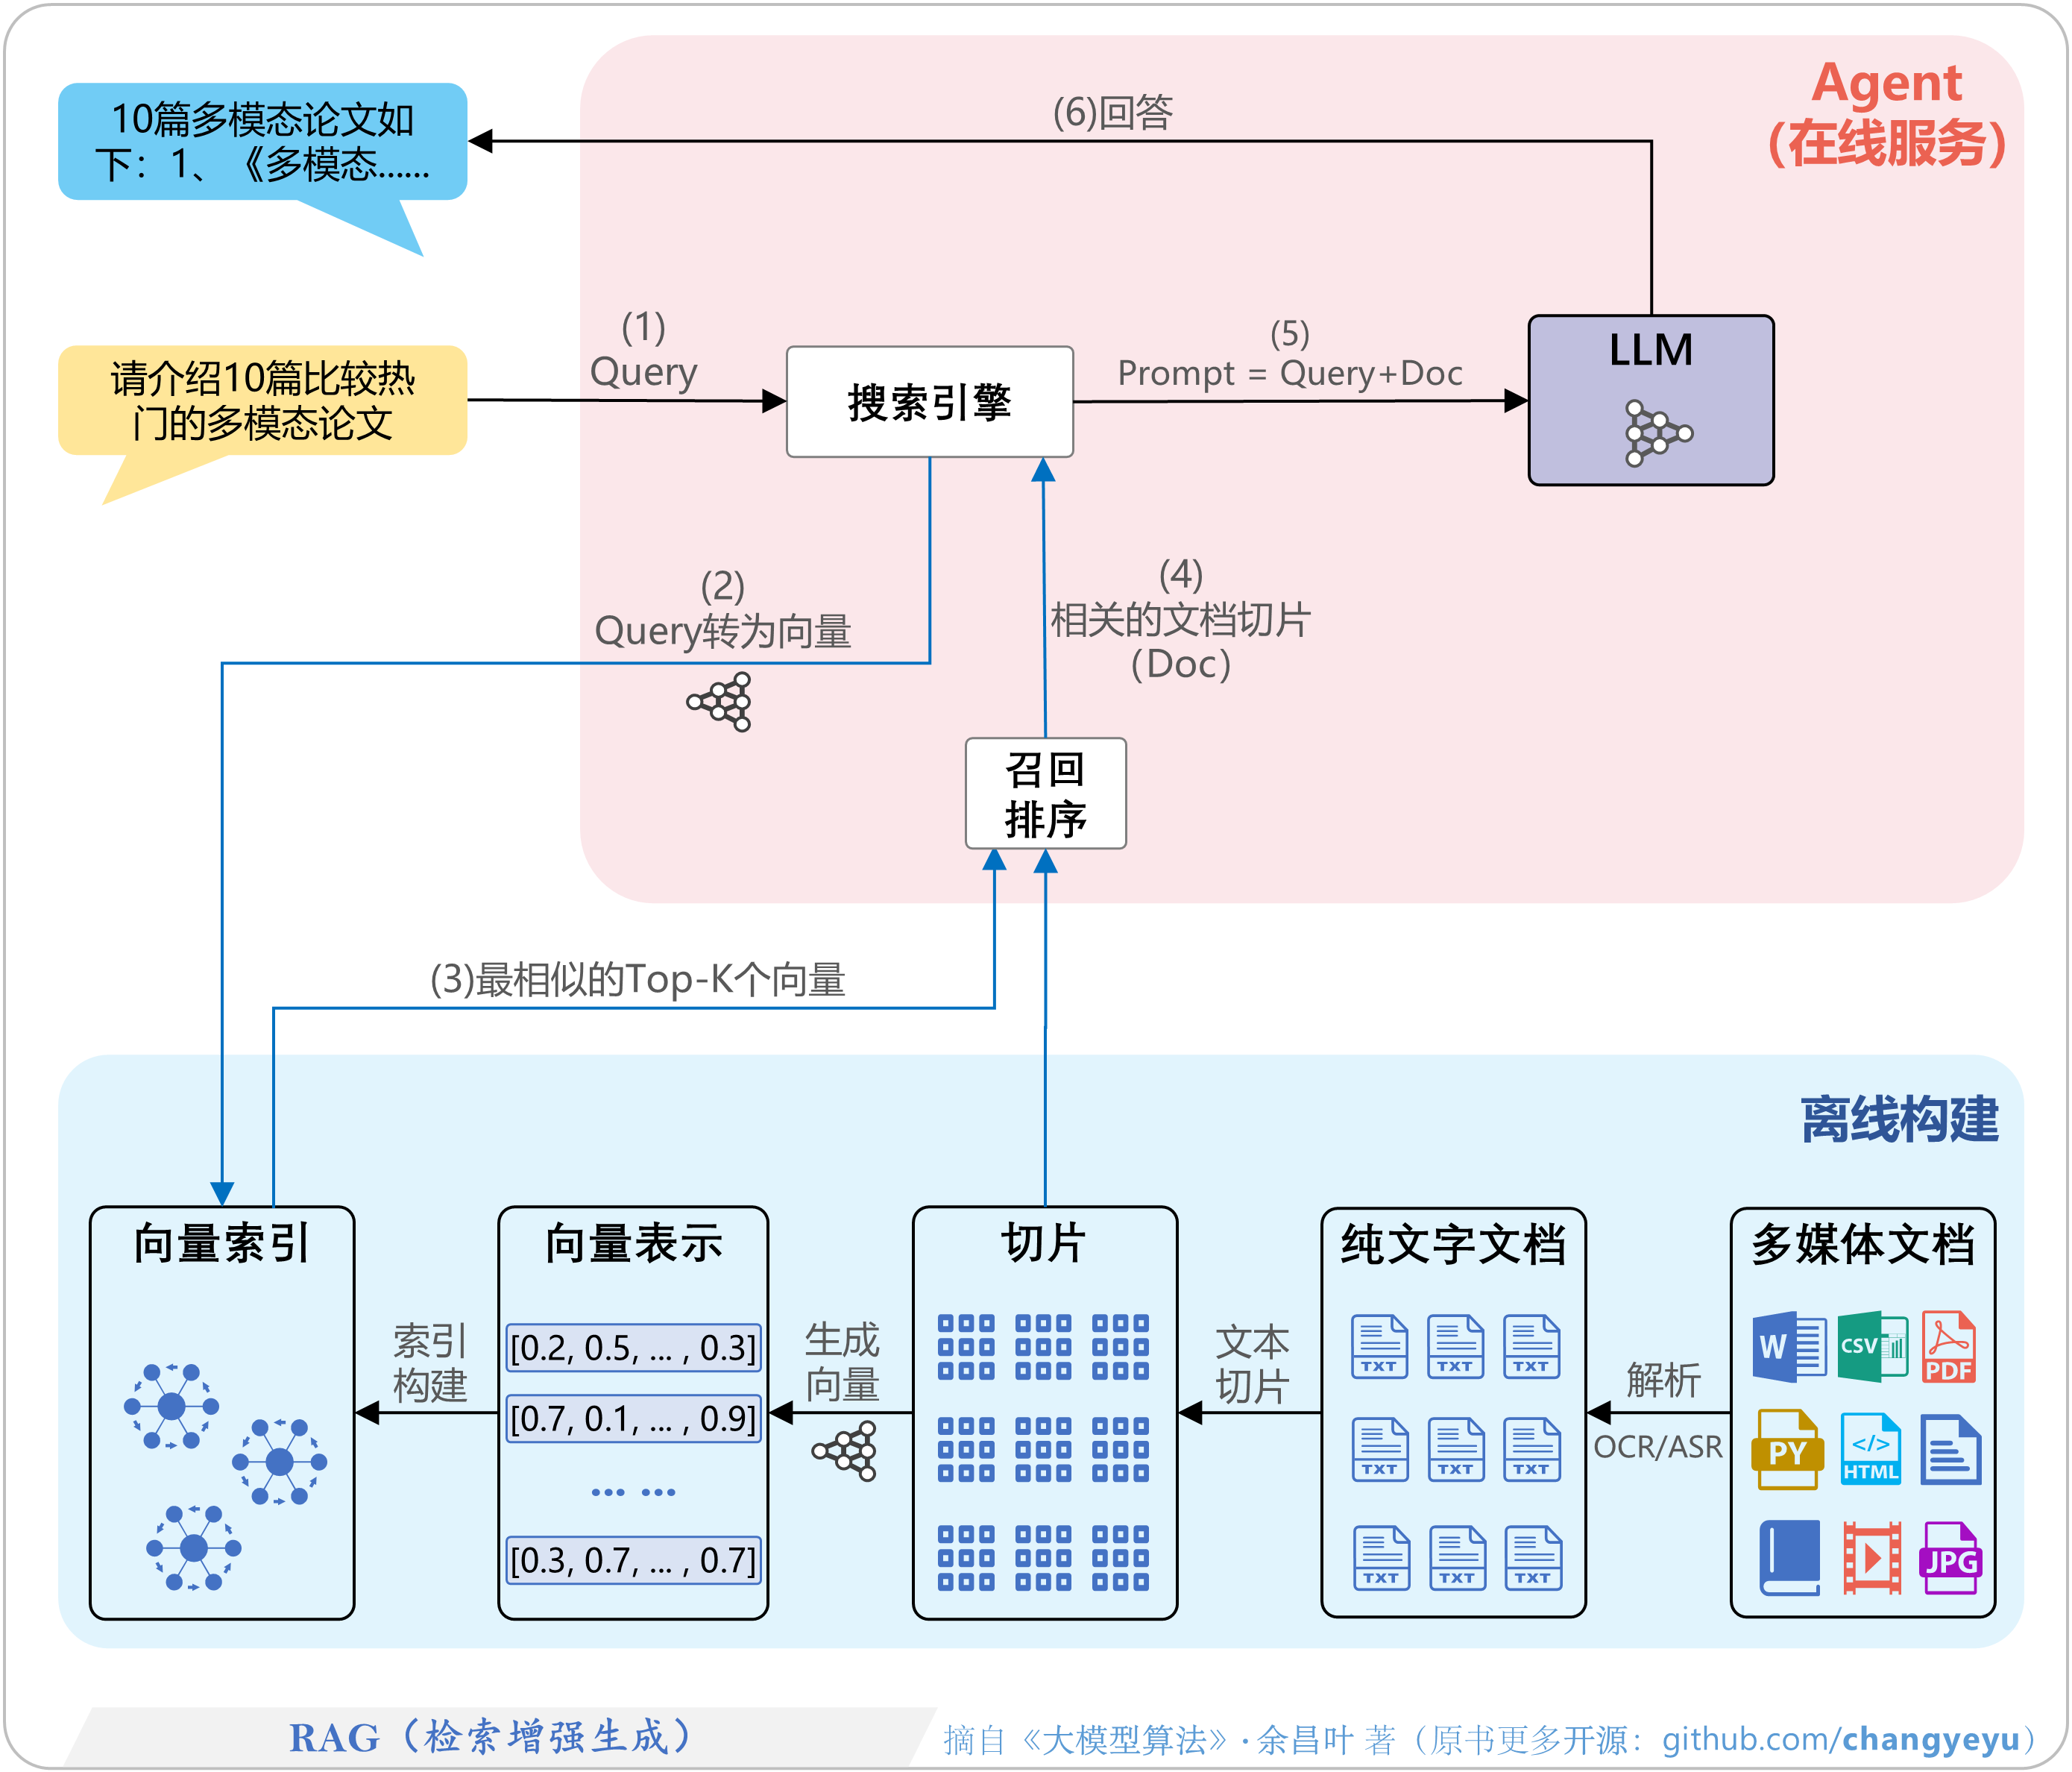
- RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合信息检索与模型生成的技术,通过引入外部知识库或检索系统,增强生成式模型的知识范围和回答准确性。
- Meta(前身为Facebook AI Research)等研究团队于2020年在其发表的工作中提出了RAG,并显著提升了知识密集型NLP任务的性能。
- RAG的原理如图所示,整体可分为两部分——离线构建环节和在线服务环节。

【免训练的优化技术】功能调用(Function Calling)
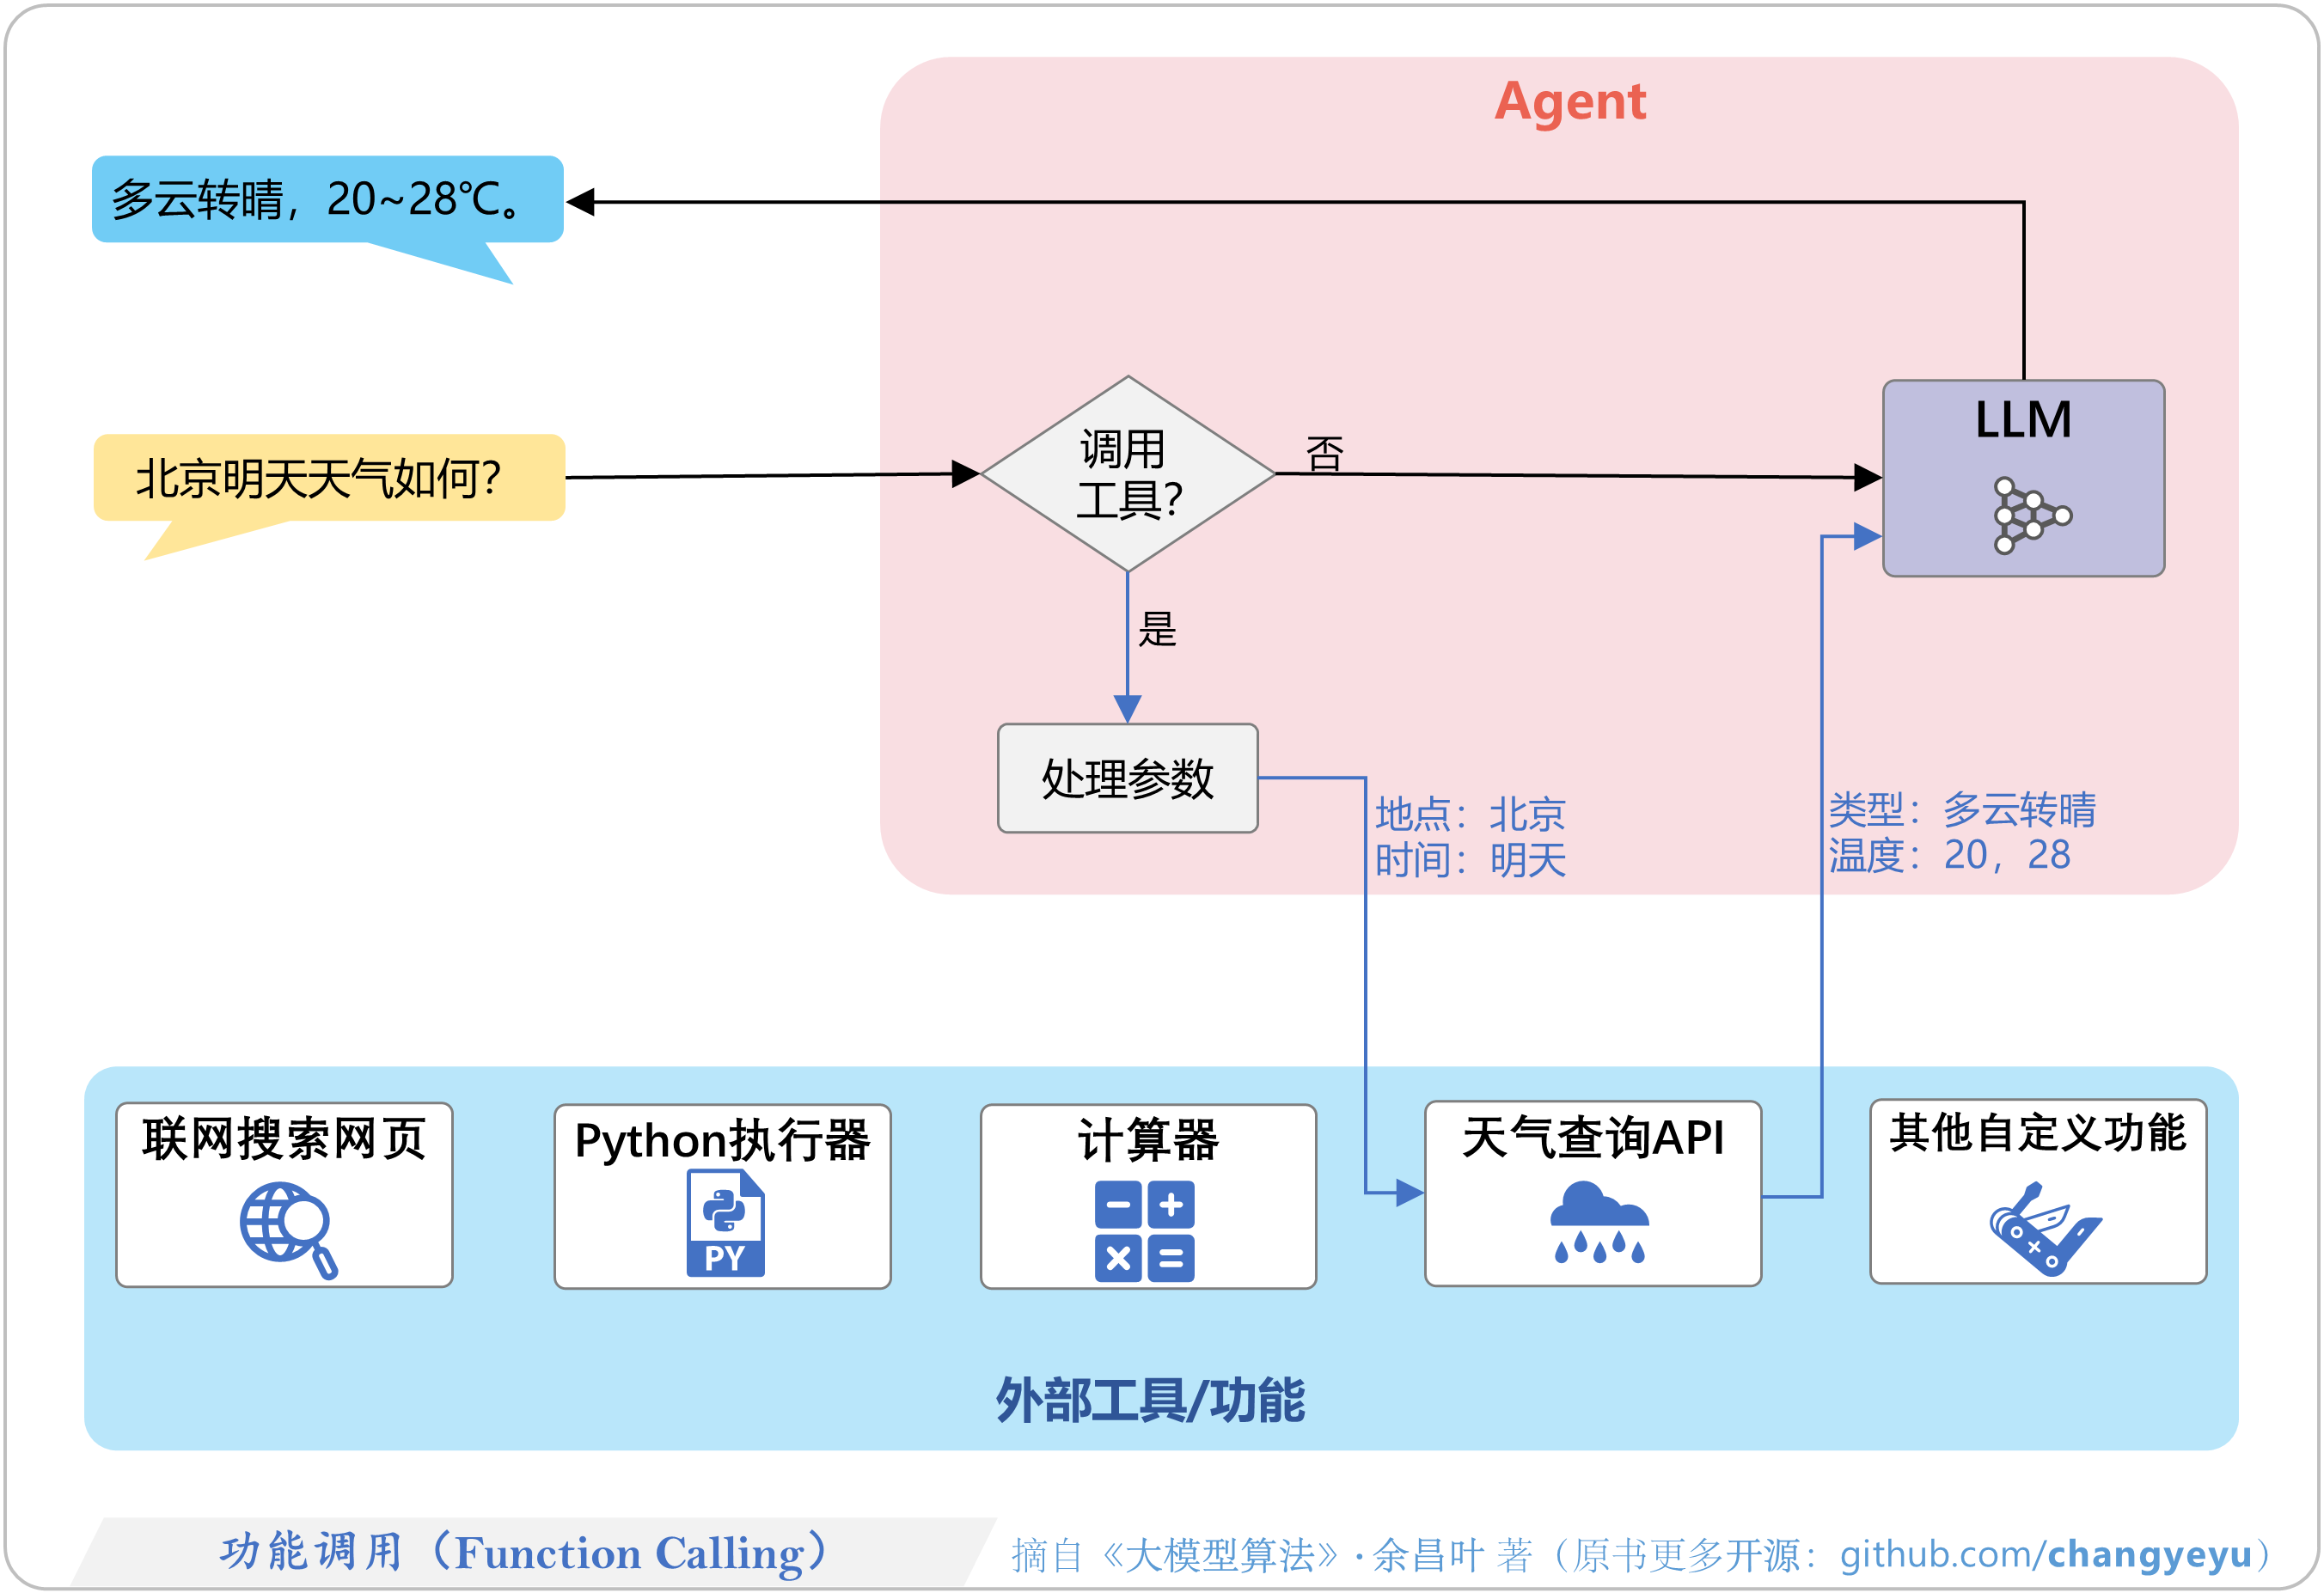
- 功能调用(Function Calling),也称工具调用(Tool Use),是指在基于大模型完成任务的过程中,Agent通过特定机制调用外部对象,获取返回结果后将其与原始Prompt一起输入到大模型,由大模型进一步推理并完成特定任务。
- 被调用的对象可以是远程API、数据库查询接口、本地函数或工具插件(Plugin)等。
- 下图展示了功能与工具调用技术的运行流程。其中,Agent是一个本地运行的软件系统,大模型是其子模块之一。Agent还包括用户请求解析模块、参数处理模块、工具调用模块、调用结果解析模块及与大模型交互的组件等。
【强化学习基础】强化学习(Reinforcement Learning, RL)的发展历程
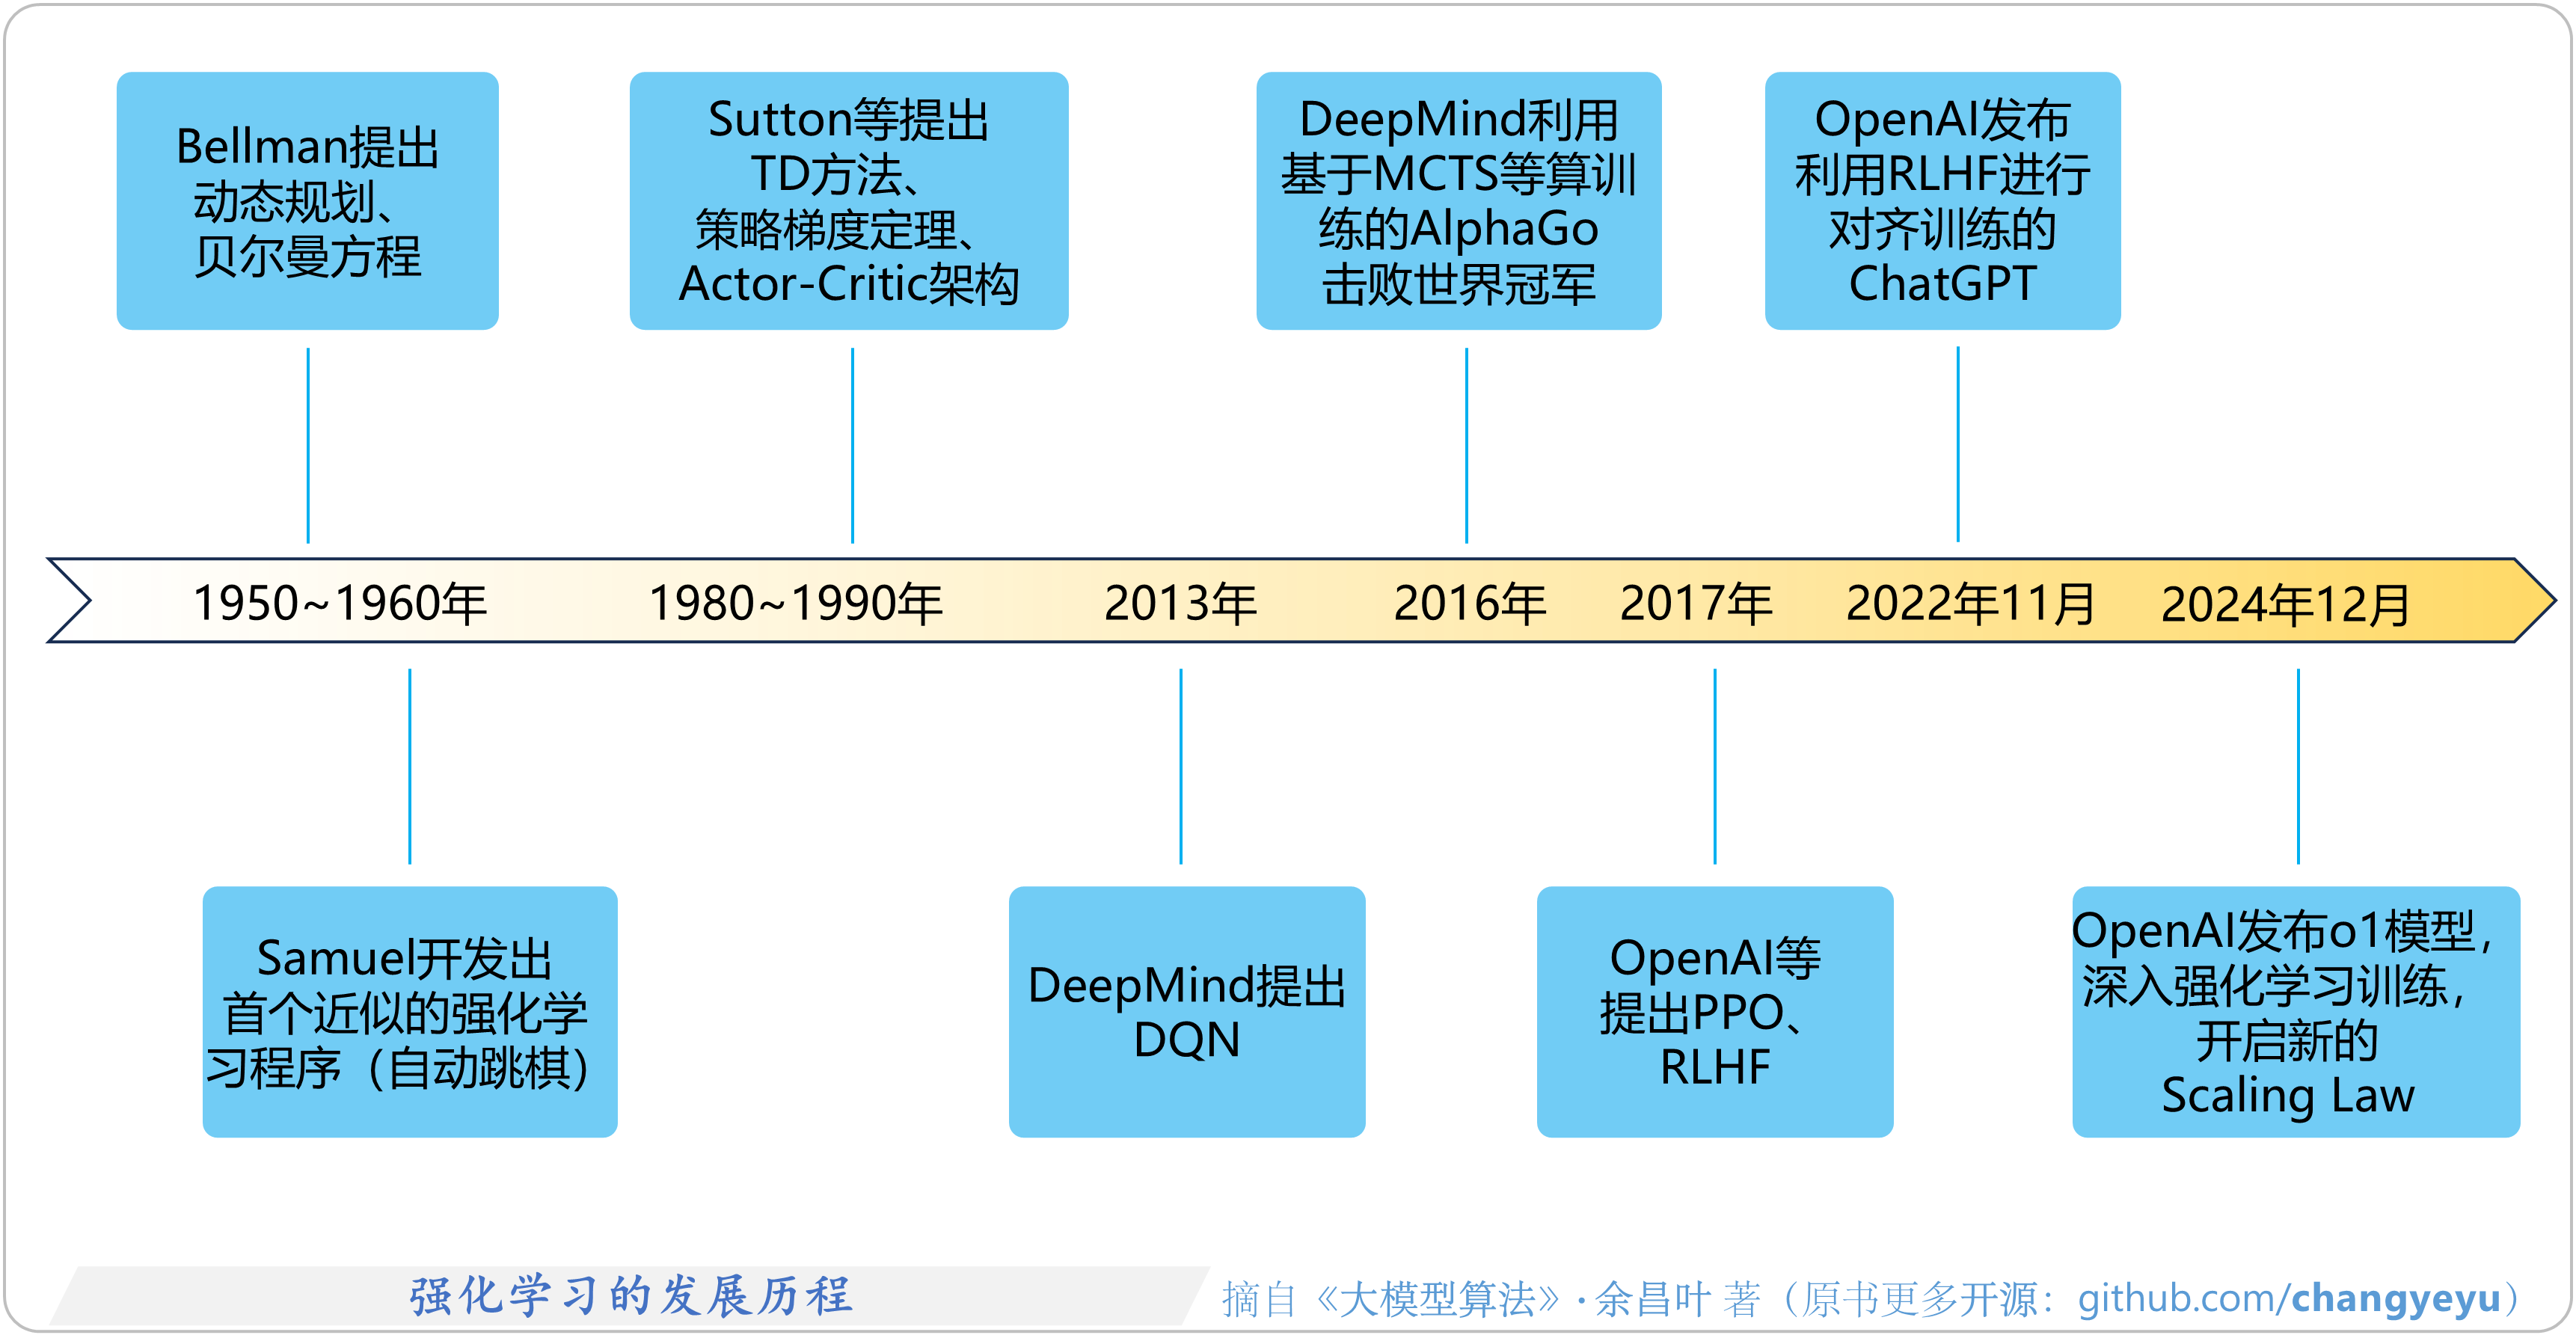
- 强化学习可以追溯至20世纪50年代,之后由Richard S. Sutton等学者相继提出了许多关键算法和理论。
- 自2012年起,随着深度学习的迅猛发展,强化学习在多个领域催生了备受关注的应用。
- 2022年11月,结合RLHF(基于人类反馈的强化学习)训练的ChatGPT正式发布。
- 随后在2024年12月,OpenAI推出经过更深入强化学习优化的o1模型,这极大地激发了业界基于强化学习对大模型进行训练的关注和投入。

【强化学习基础】三大机器学习范式
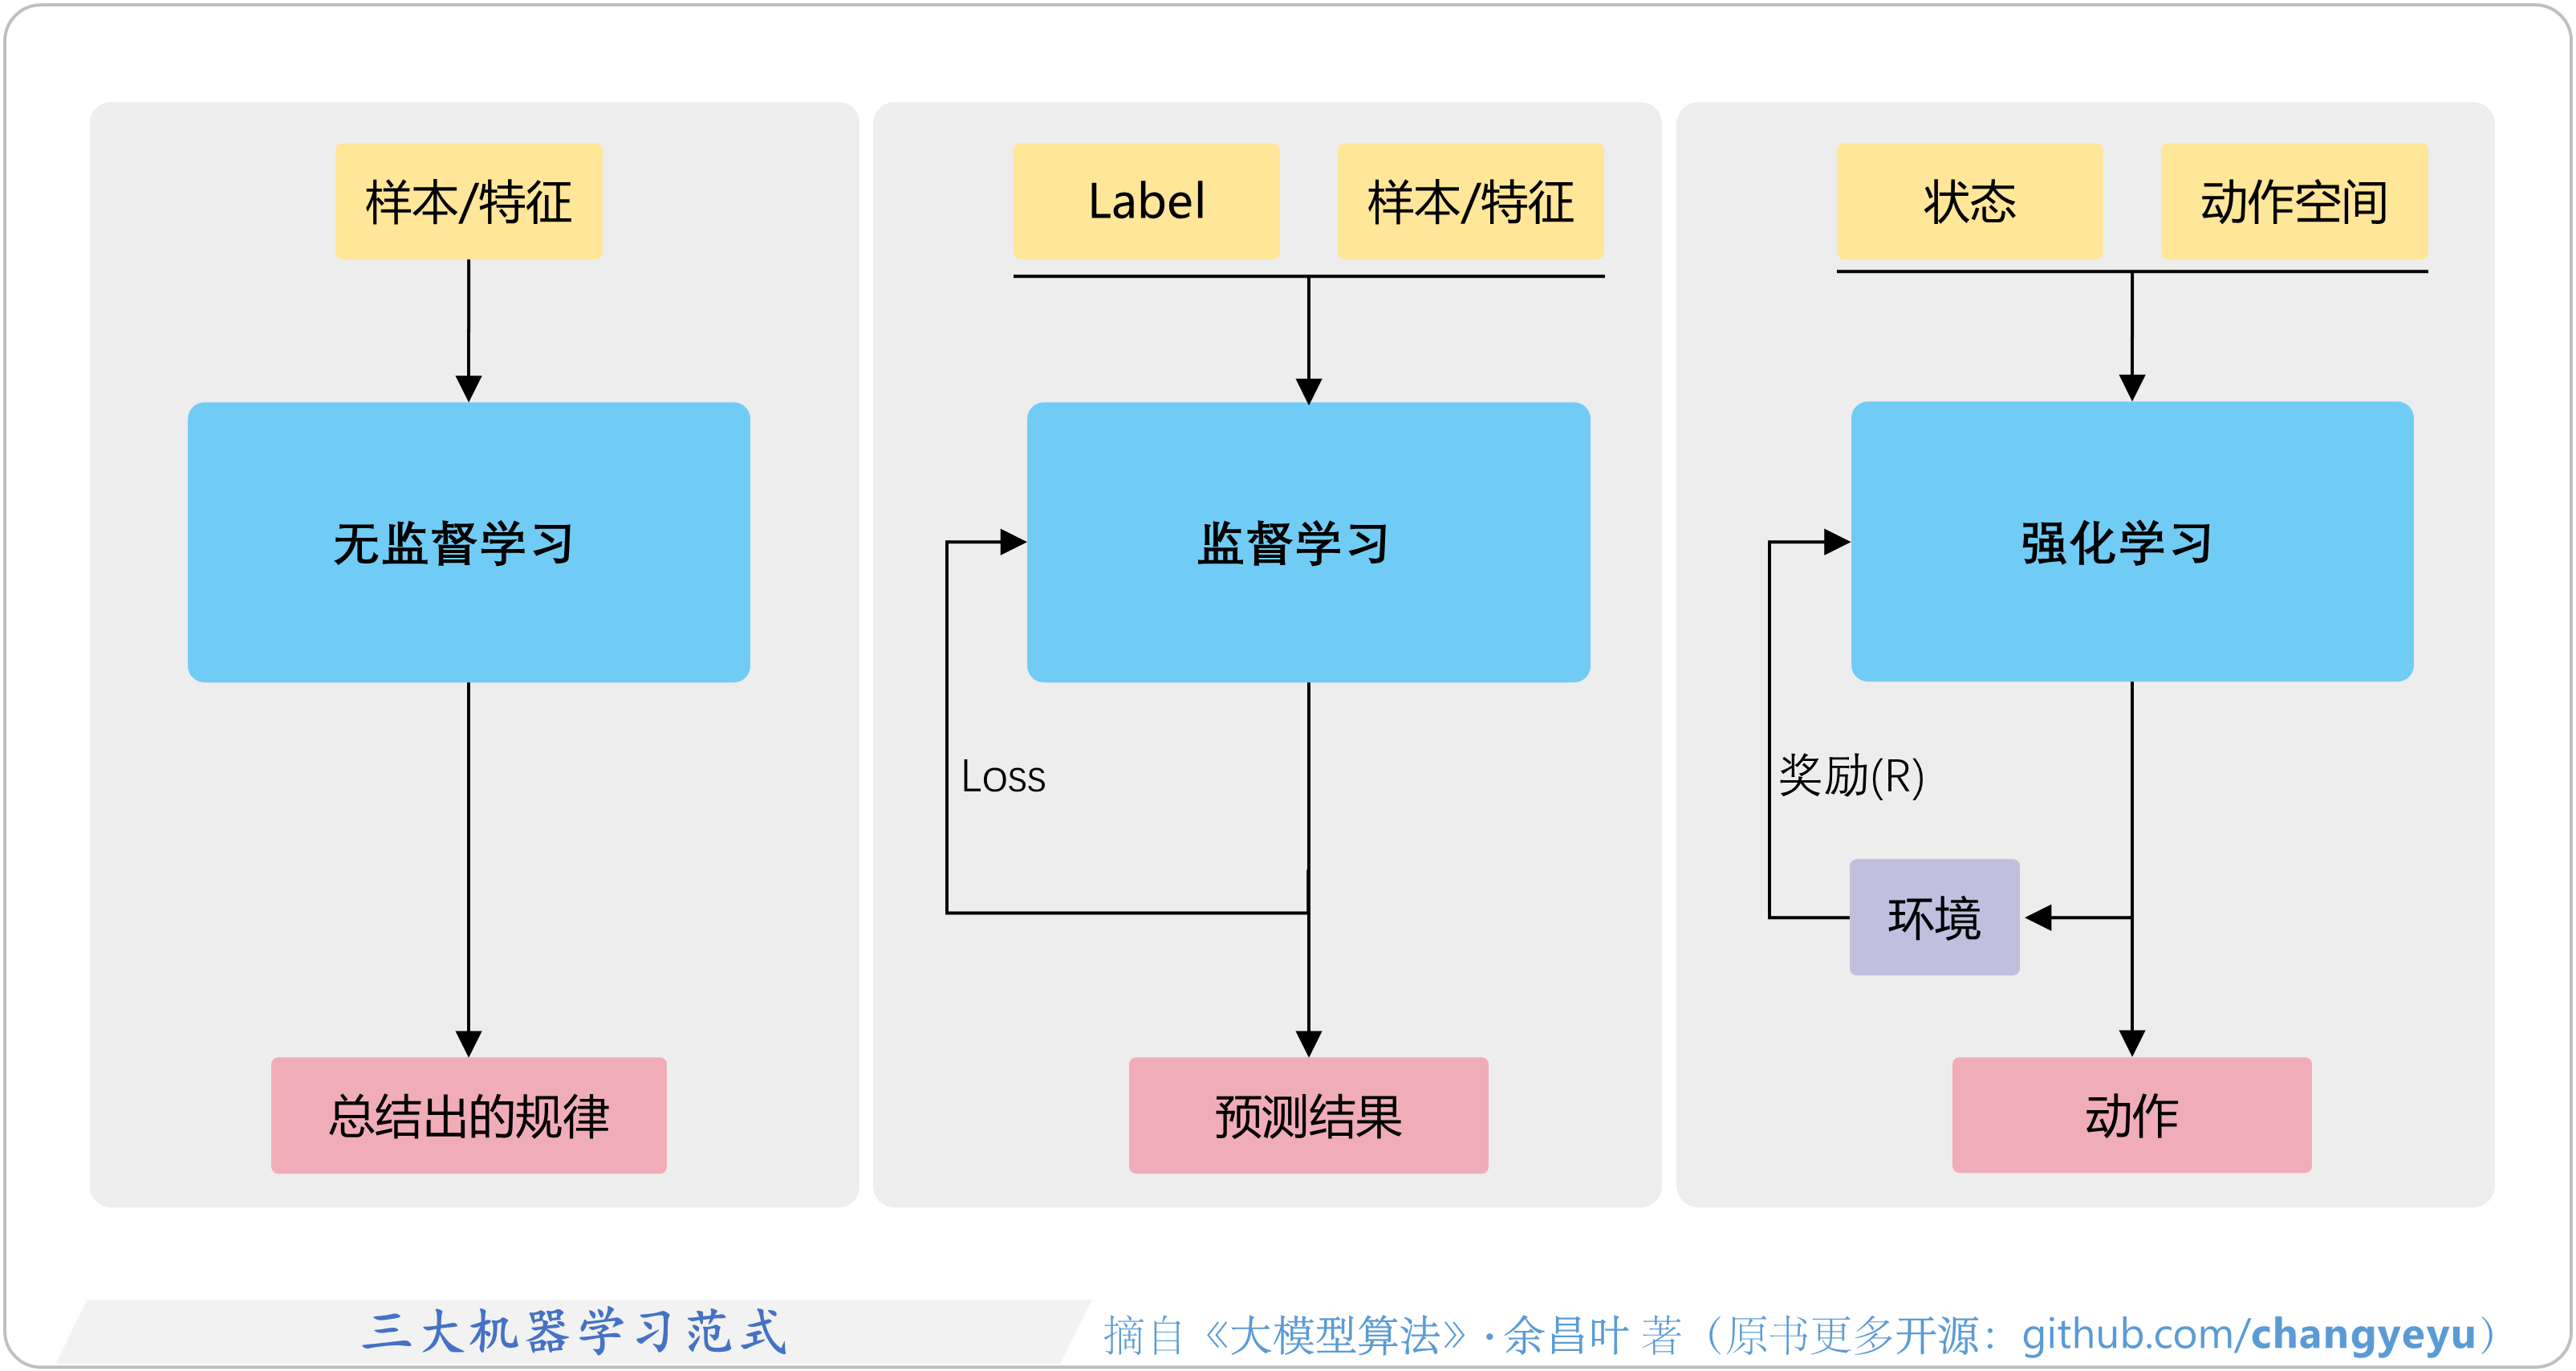
- 无监督学习、监督学习和强化学习并列为三大机器学习范式。

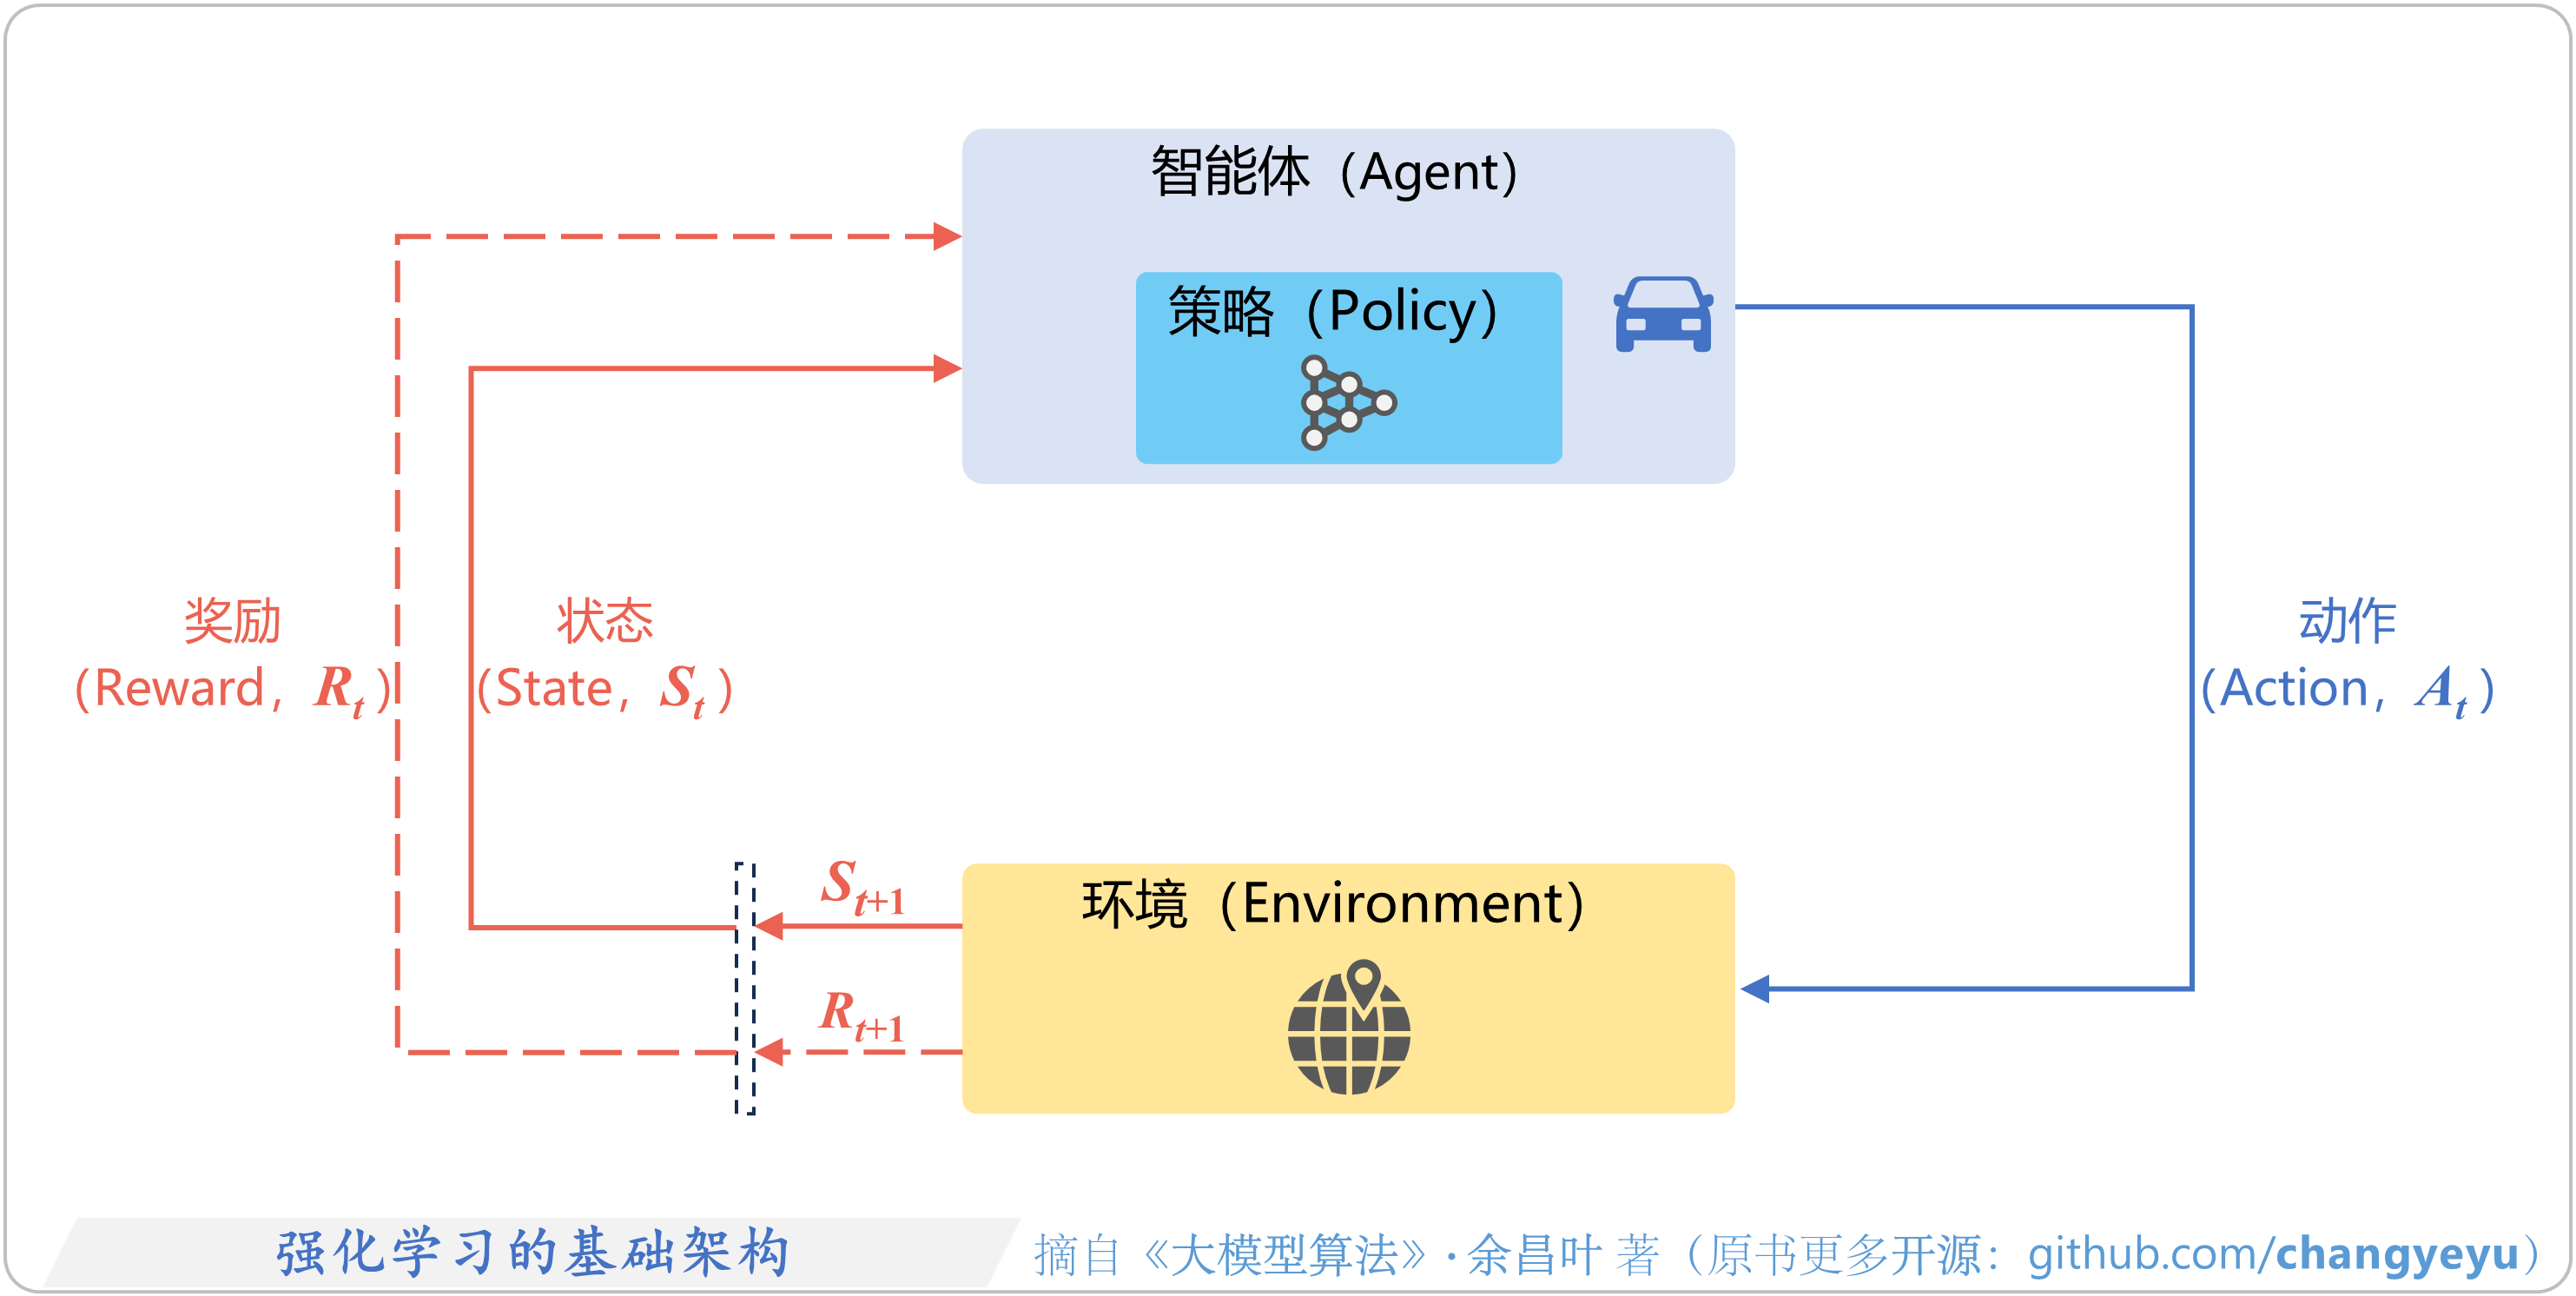
【强化学习基础】强化学习的基础架构
- 强化学习的运行主要涉及两个核心角色:智能体(Agent)和环境(Environment)。
- 智能体通过感知环境的状态,基于策略选择并执行动作;
- 环境接收动作后更新状态并反馈奖励信号。

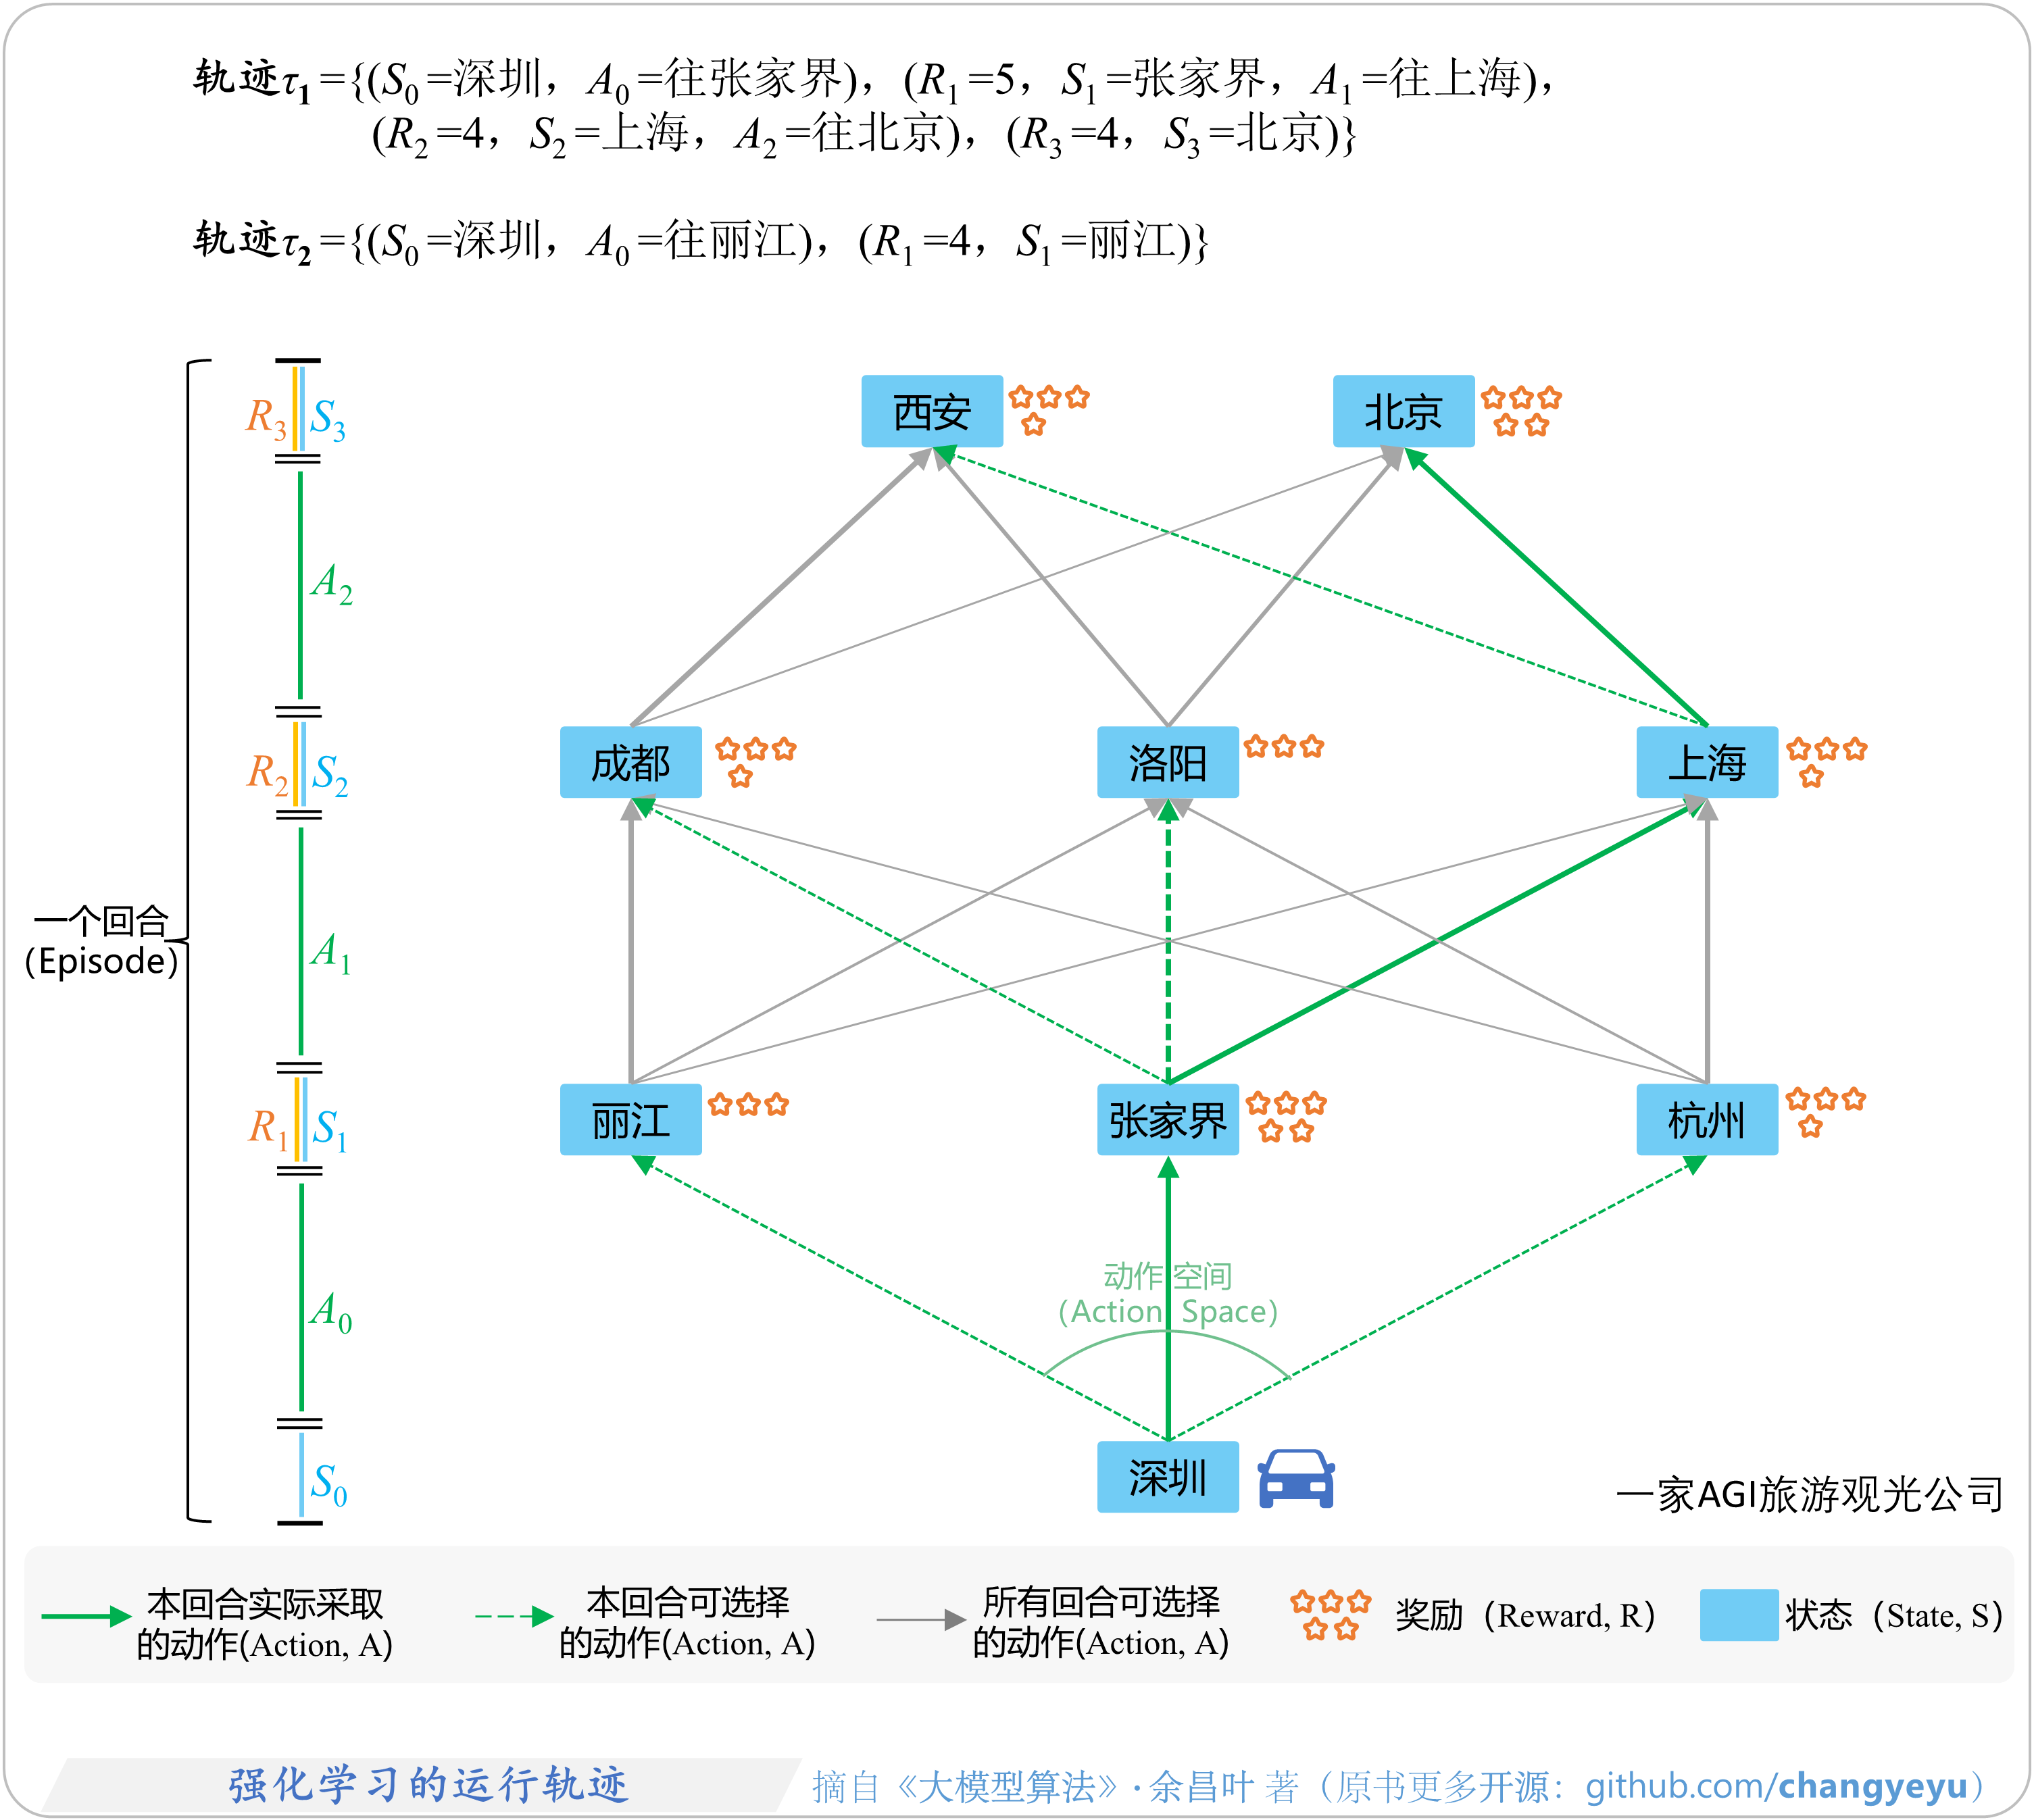
【强化学习基础】强化学习的运行轨迹
- 一个RL建模示例:假设未来有一家AGI旅游公司,提供基于自动驾驶汽车的长途旅游服务。旅客只需选择一个旅游行程,自动驾驶汽车将全程负责行程规划、驾驶以及接送服务,完成整个旅游任务。在旅游项目刚上线时,旅客最喜爱的路线尚未明确,需要通过多次实际运行,并结合累计奖励(旅客评分),基于强化学习训练旅游路线规划模型。目标是逐步优化乘客的旅游体验,最终确定最受旅客欢迎的最佳路线。
- 强化学习中的各个核心概念映射如图:

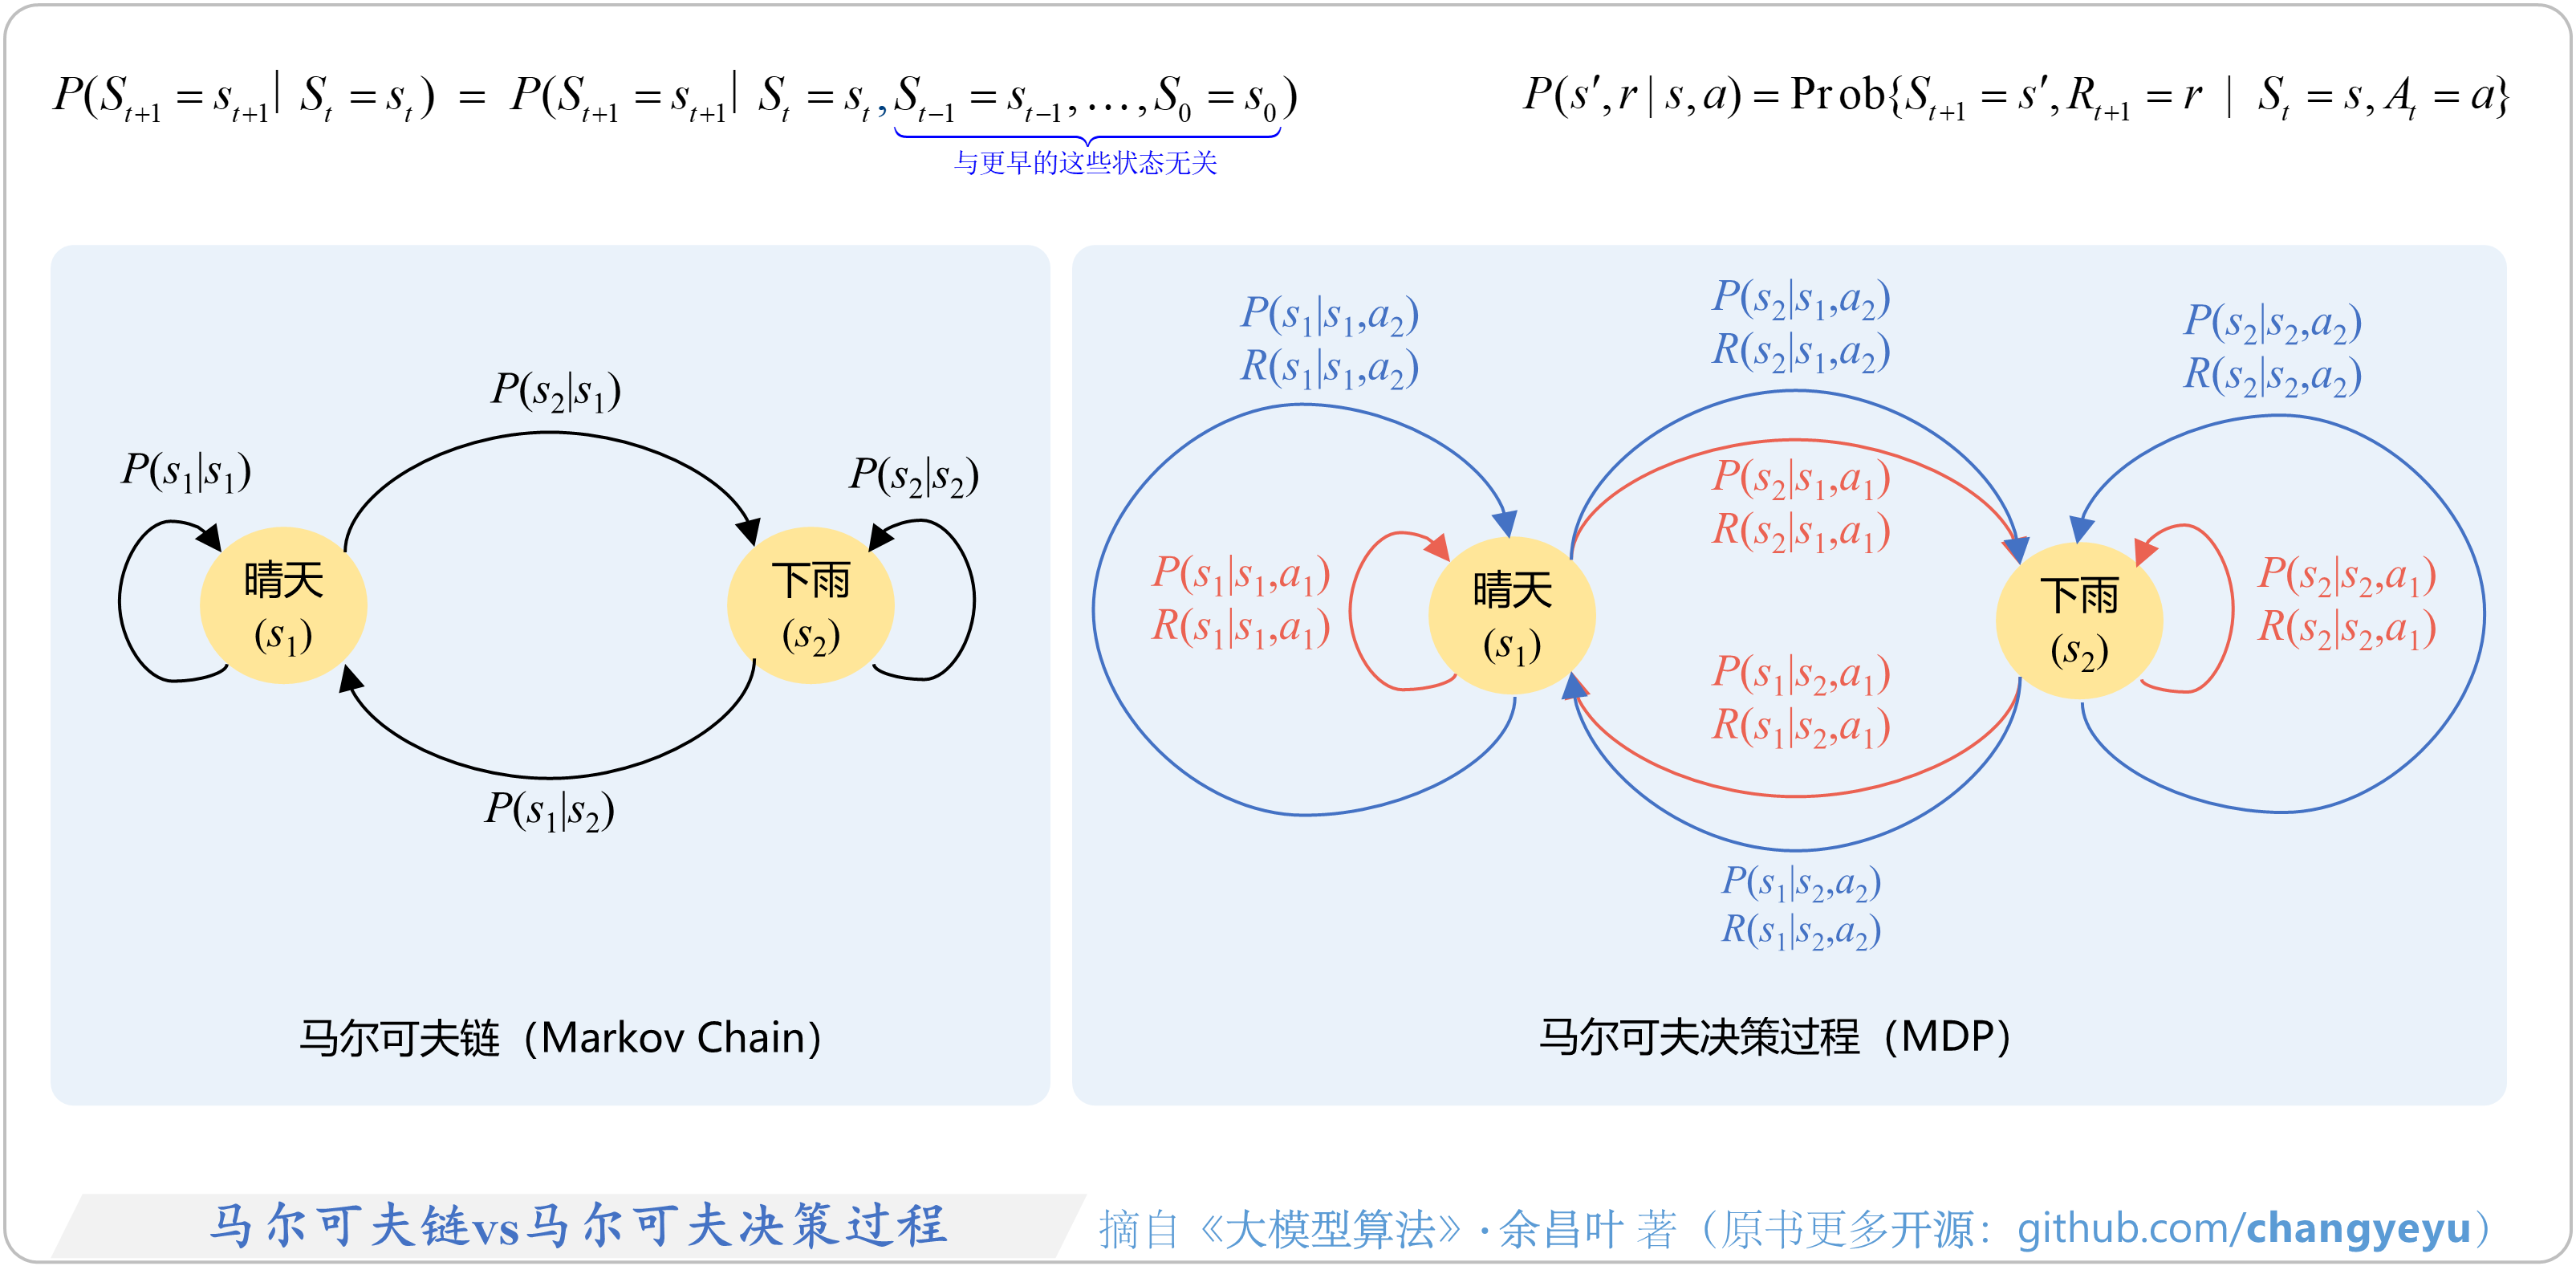
【强化学习基础】马尔可夫链vs马尔可夫决策过程(MDP)
- 马尔可夫链和马尔可夫决策过程(MDP)是强化学习领域的重要理论基础。
- 马尔可夫决策过程(Markov Decision Process, MDP)是在马尔可夫链的基础上引入了动作(A)和奖励(R)的概念。

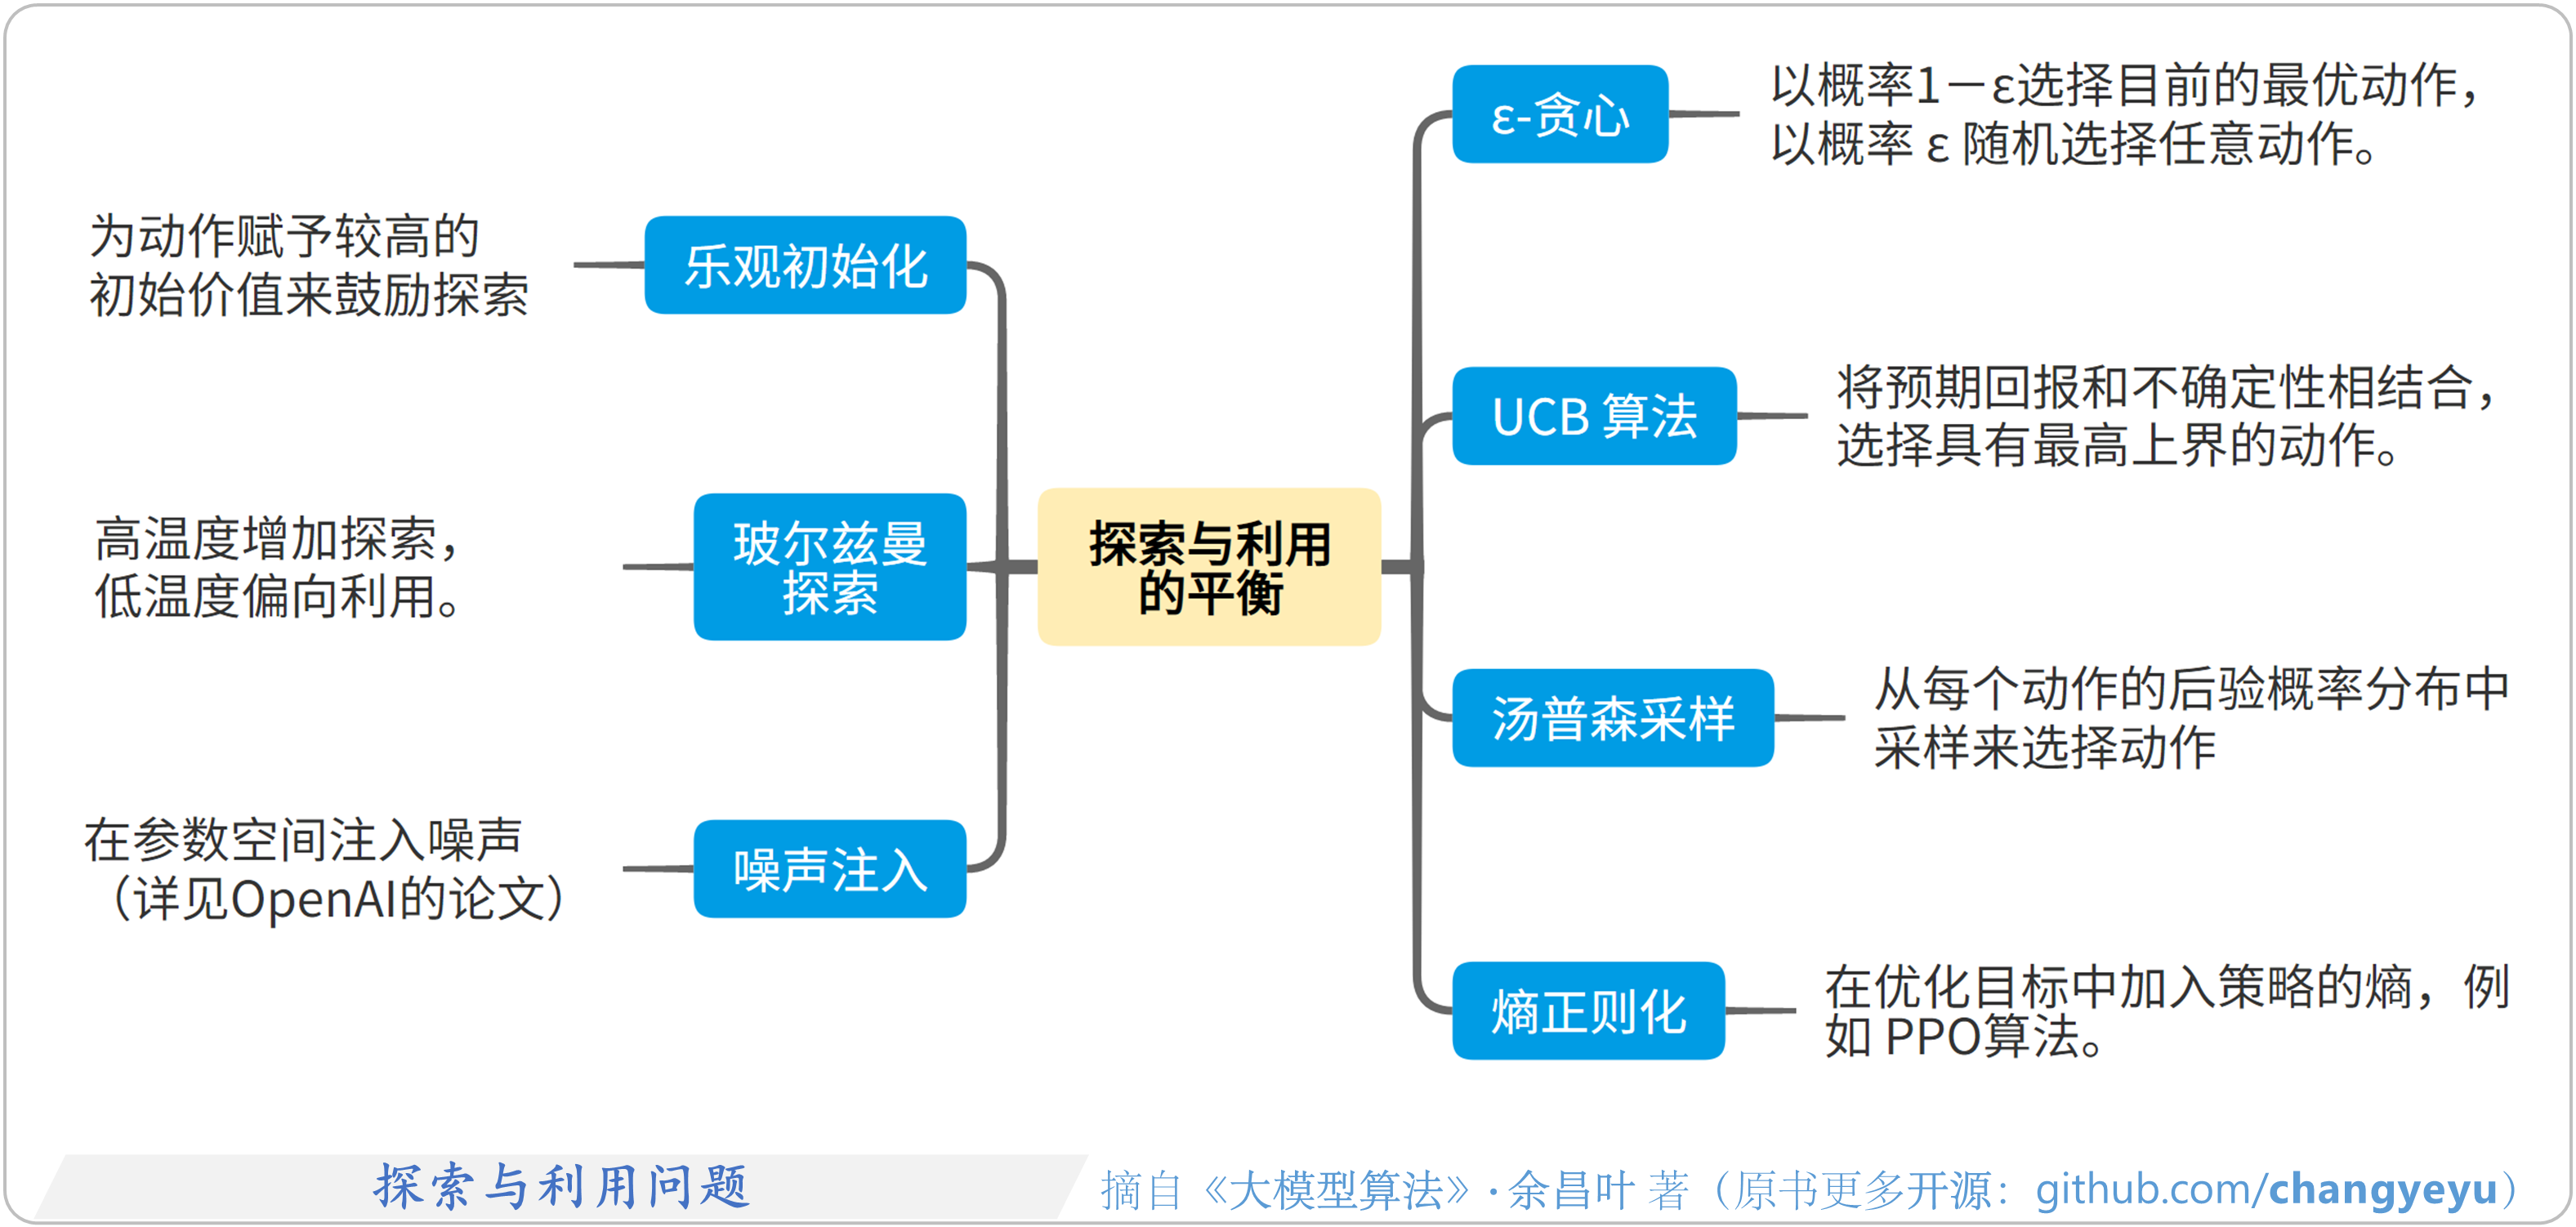
【强化学习基础】探索与利用问题(Exploration and Exploitation)
- 探索与利用(Exploration-Exploitation)的平衡是强化学习的核心挑战之一。
- 智能体在学习过程中需要在“尝试新动作”(探索)与“选择当前已知的最优动作”(利用)之间进行权衡。过度探索可能导致学习过程缓慢,甚至无法收敛到最优解;而过度利用则可能使智能体陷入局部最优,无法达到全局最优回报。

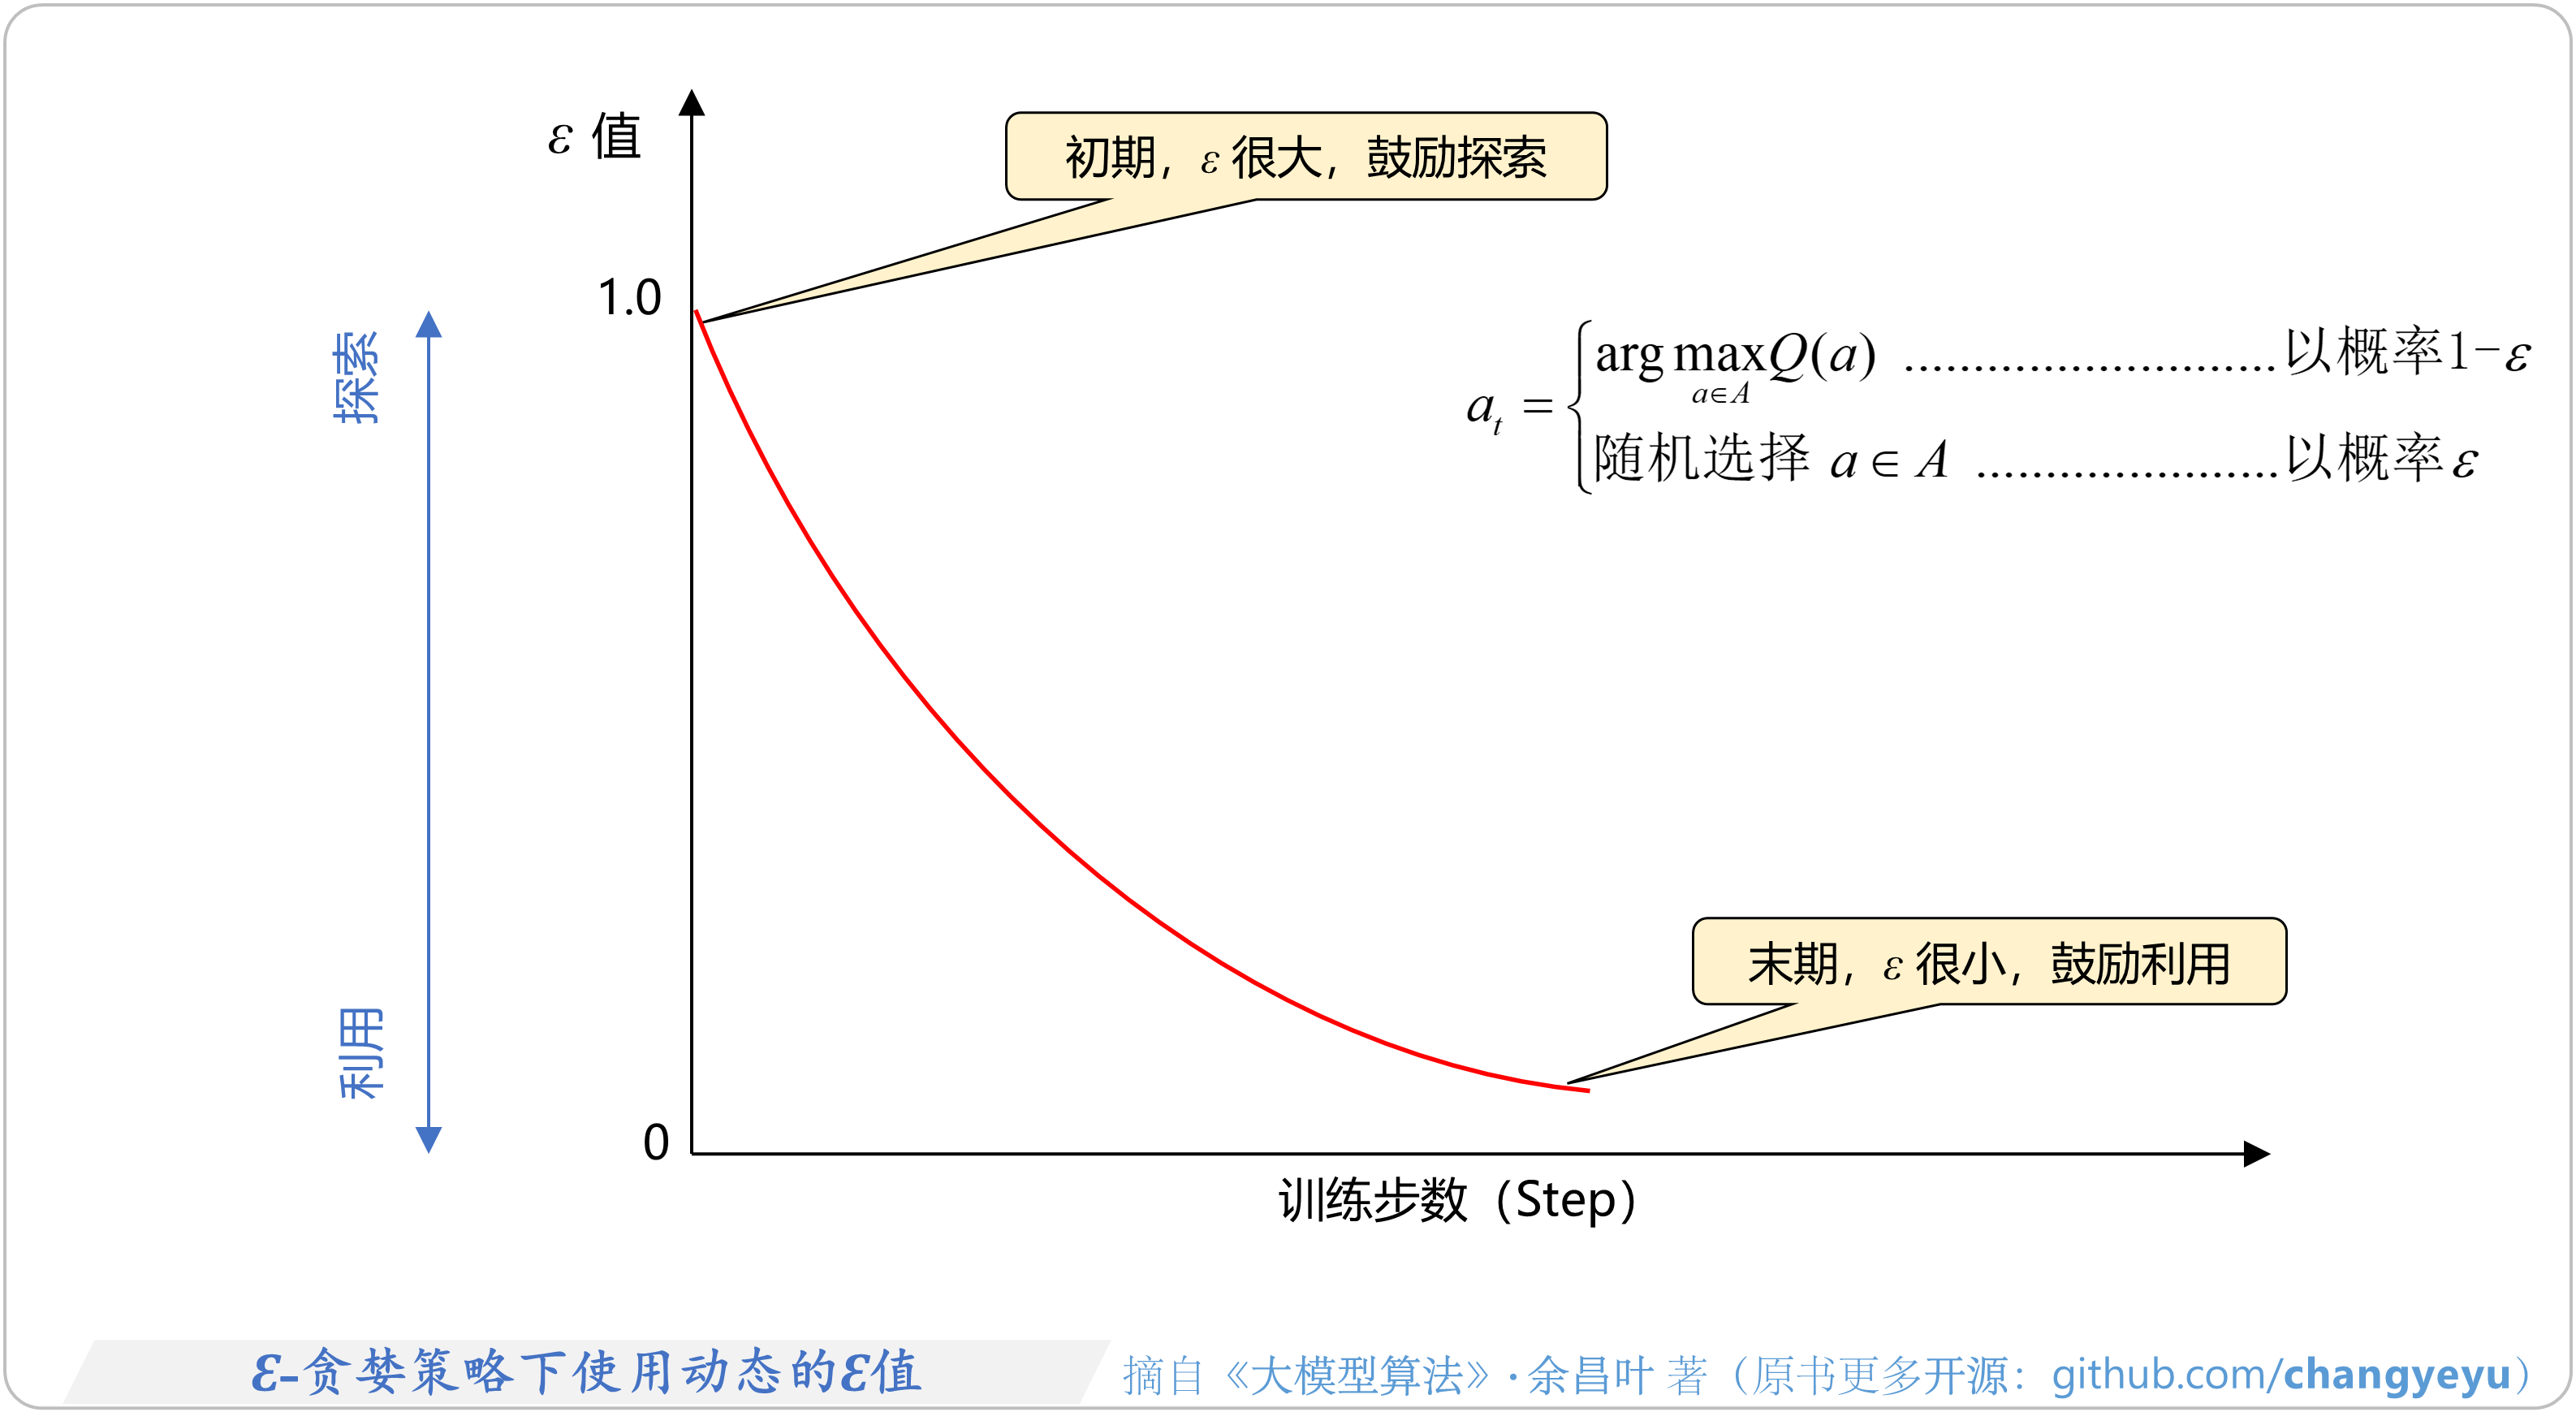
【强化学习基础】Ɛ-贪婪策略下使用动态的Ɛ值
- Ɛ-贪婪(Epsilon Greedy)是一种简单而有效的策略,用于在强化学习中平衡探索与利用。通过引入探索概率因子Ɛ,控制探索与利用的比例。
- 在训练初期,可以将Ɛ的值设得比较大,随着训练的进行,逐步降低 Ɛ的值,使智能体在初期更多地进行探索,随着对环境的了解加深,逐渐转向利用,从而提高学习效率和最终策略的性能。

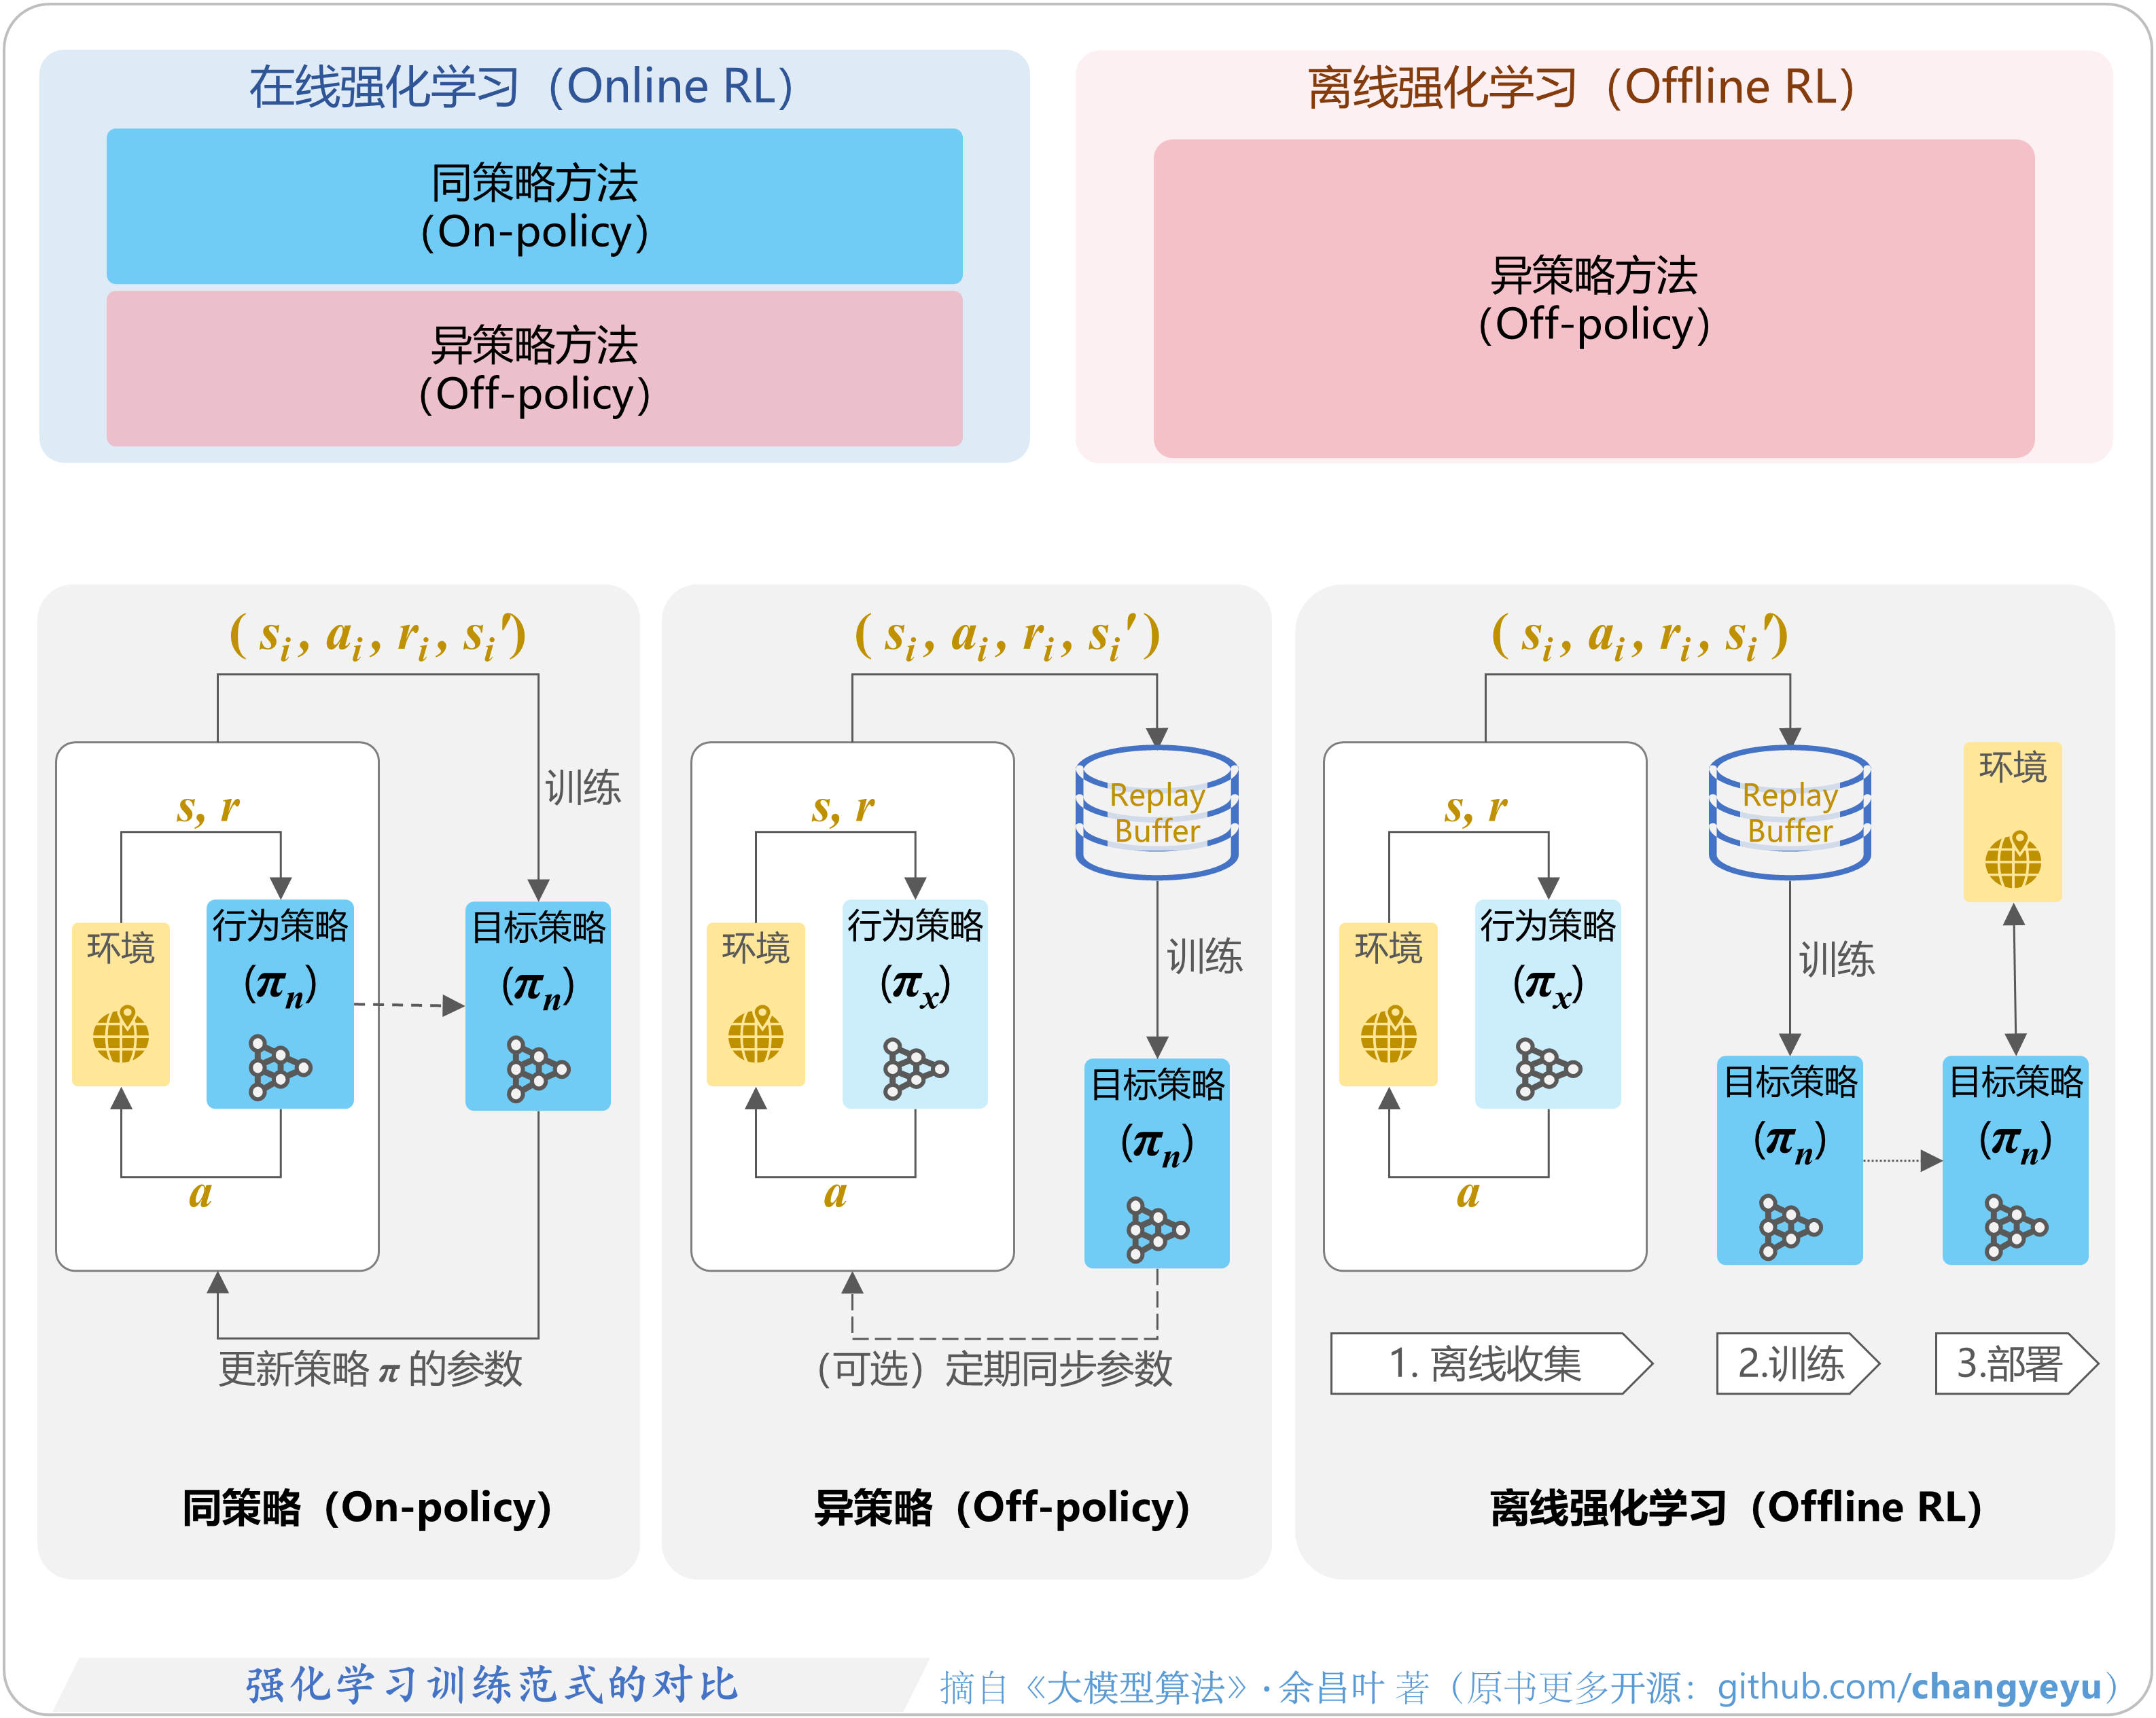
【强化学习基础】强化学习训练范式的对比
- 同策略(On-policy)、异策略(Off-policy)、在线强化学习(Online RL)和离线强化学习(Offline RL)
- 根据经验收集与策略训练的方式,主要可以划分为四个核心概念:同策略(On-policy)、异策略(Off-policy)、在线强化学习(Online RL)和离线强化学习(Offline RL)。
- 同策略(On-policy):当行为策略与目标策略相同时,称为同策略学习。也就是说,智能体根据当前策略选择动作,并利用这些经验来更新当前策略,两者是同一个版本的策略。如图所示,在同策略下,行为策略和目标策略都是πn。本质上是同一个策略(模型),为了便于理解和对比,图中绘制了两个策略的示意图。例如,策略梯度方法和SARSA算法都是典型的同策略算法。
- 异策略(Off-policy):当行为策略与目标策略不同时,称为异策略学习。智能体可以使用某种策略进行探索,但学习(训练)和优化的是另一种策略,两者属于不同版本(或不同类型)的策略。例如,Q-learning、DQN等算法是典型的异策略算法,尽管可能使用Ɛ-贪婪策略进行探索,但最终学习的是最优策略。
- 在线强化学习(Online RL):在训练过程中,策略持续与环境交互并收集经验,训练数据源源不断地动态生成,目标策略也在通过训练不断进化。
- 离线强化学习(Offline RL):又称批量强化学习(Batch RL),有时也称为完全异策略强化学习(Fully Off-policy RL)。在训练过程中,智能体完全不与环境交互,而是在一个与线上环境隔离的环境中进行训练,仅依赖预先收集的数据。这些数据可能来源于历史记录、其他策略的积累,或是模拟环境生成的样本。

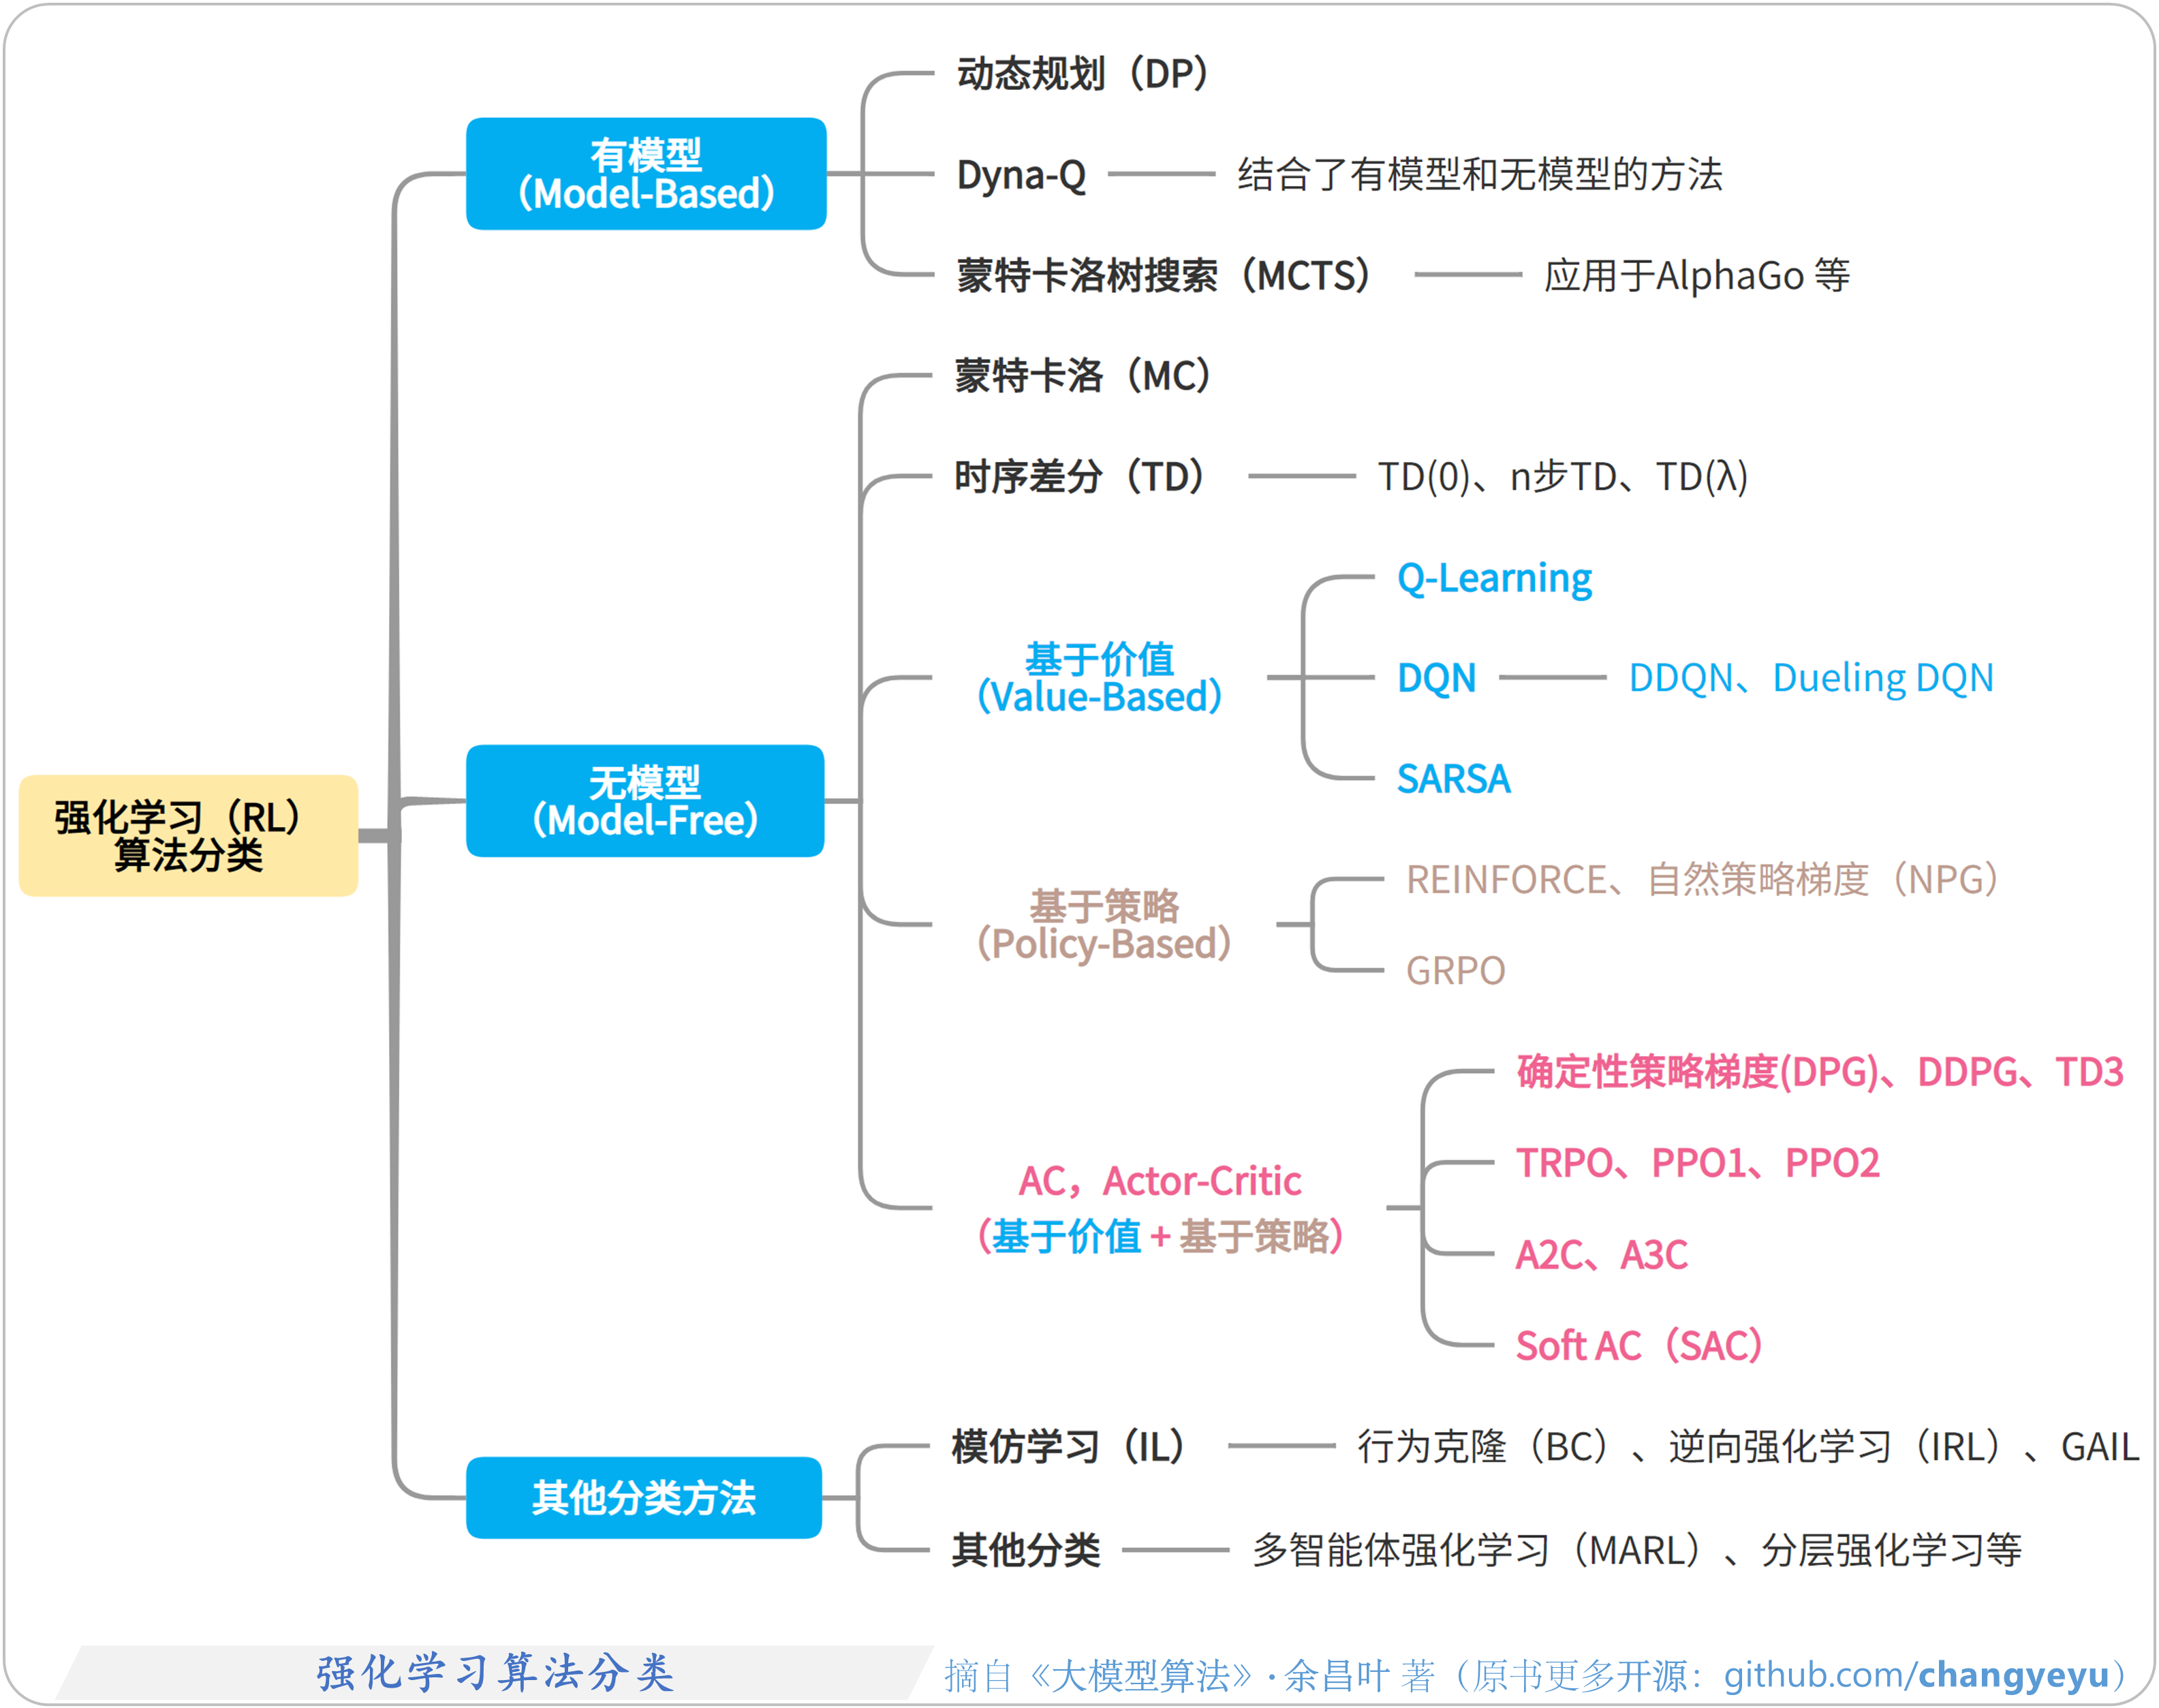
【强化学习基础】强化学习算法分类
- 根据不同的维度,强化学习算法分类如下图。
- 此外,强化学习还常与监督学习(Supervised Learning, SL)、对比学习(Contrastive Learning, CL)、模仿学习(Imitation Learning, IL)、生成对抗网络(Generative Adversarial Networks, GAN)等技术结合,这些结合催生了多种交叉类型的算法,进一步扩展了强化学习的应用领域。

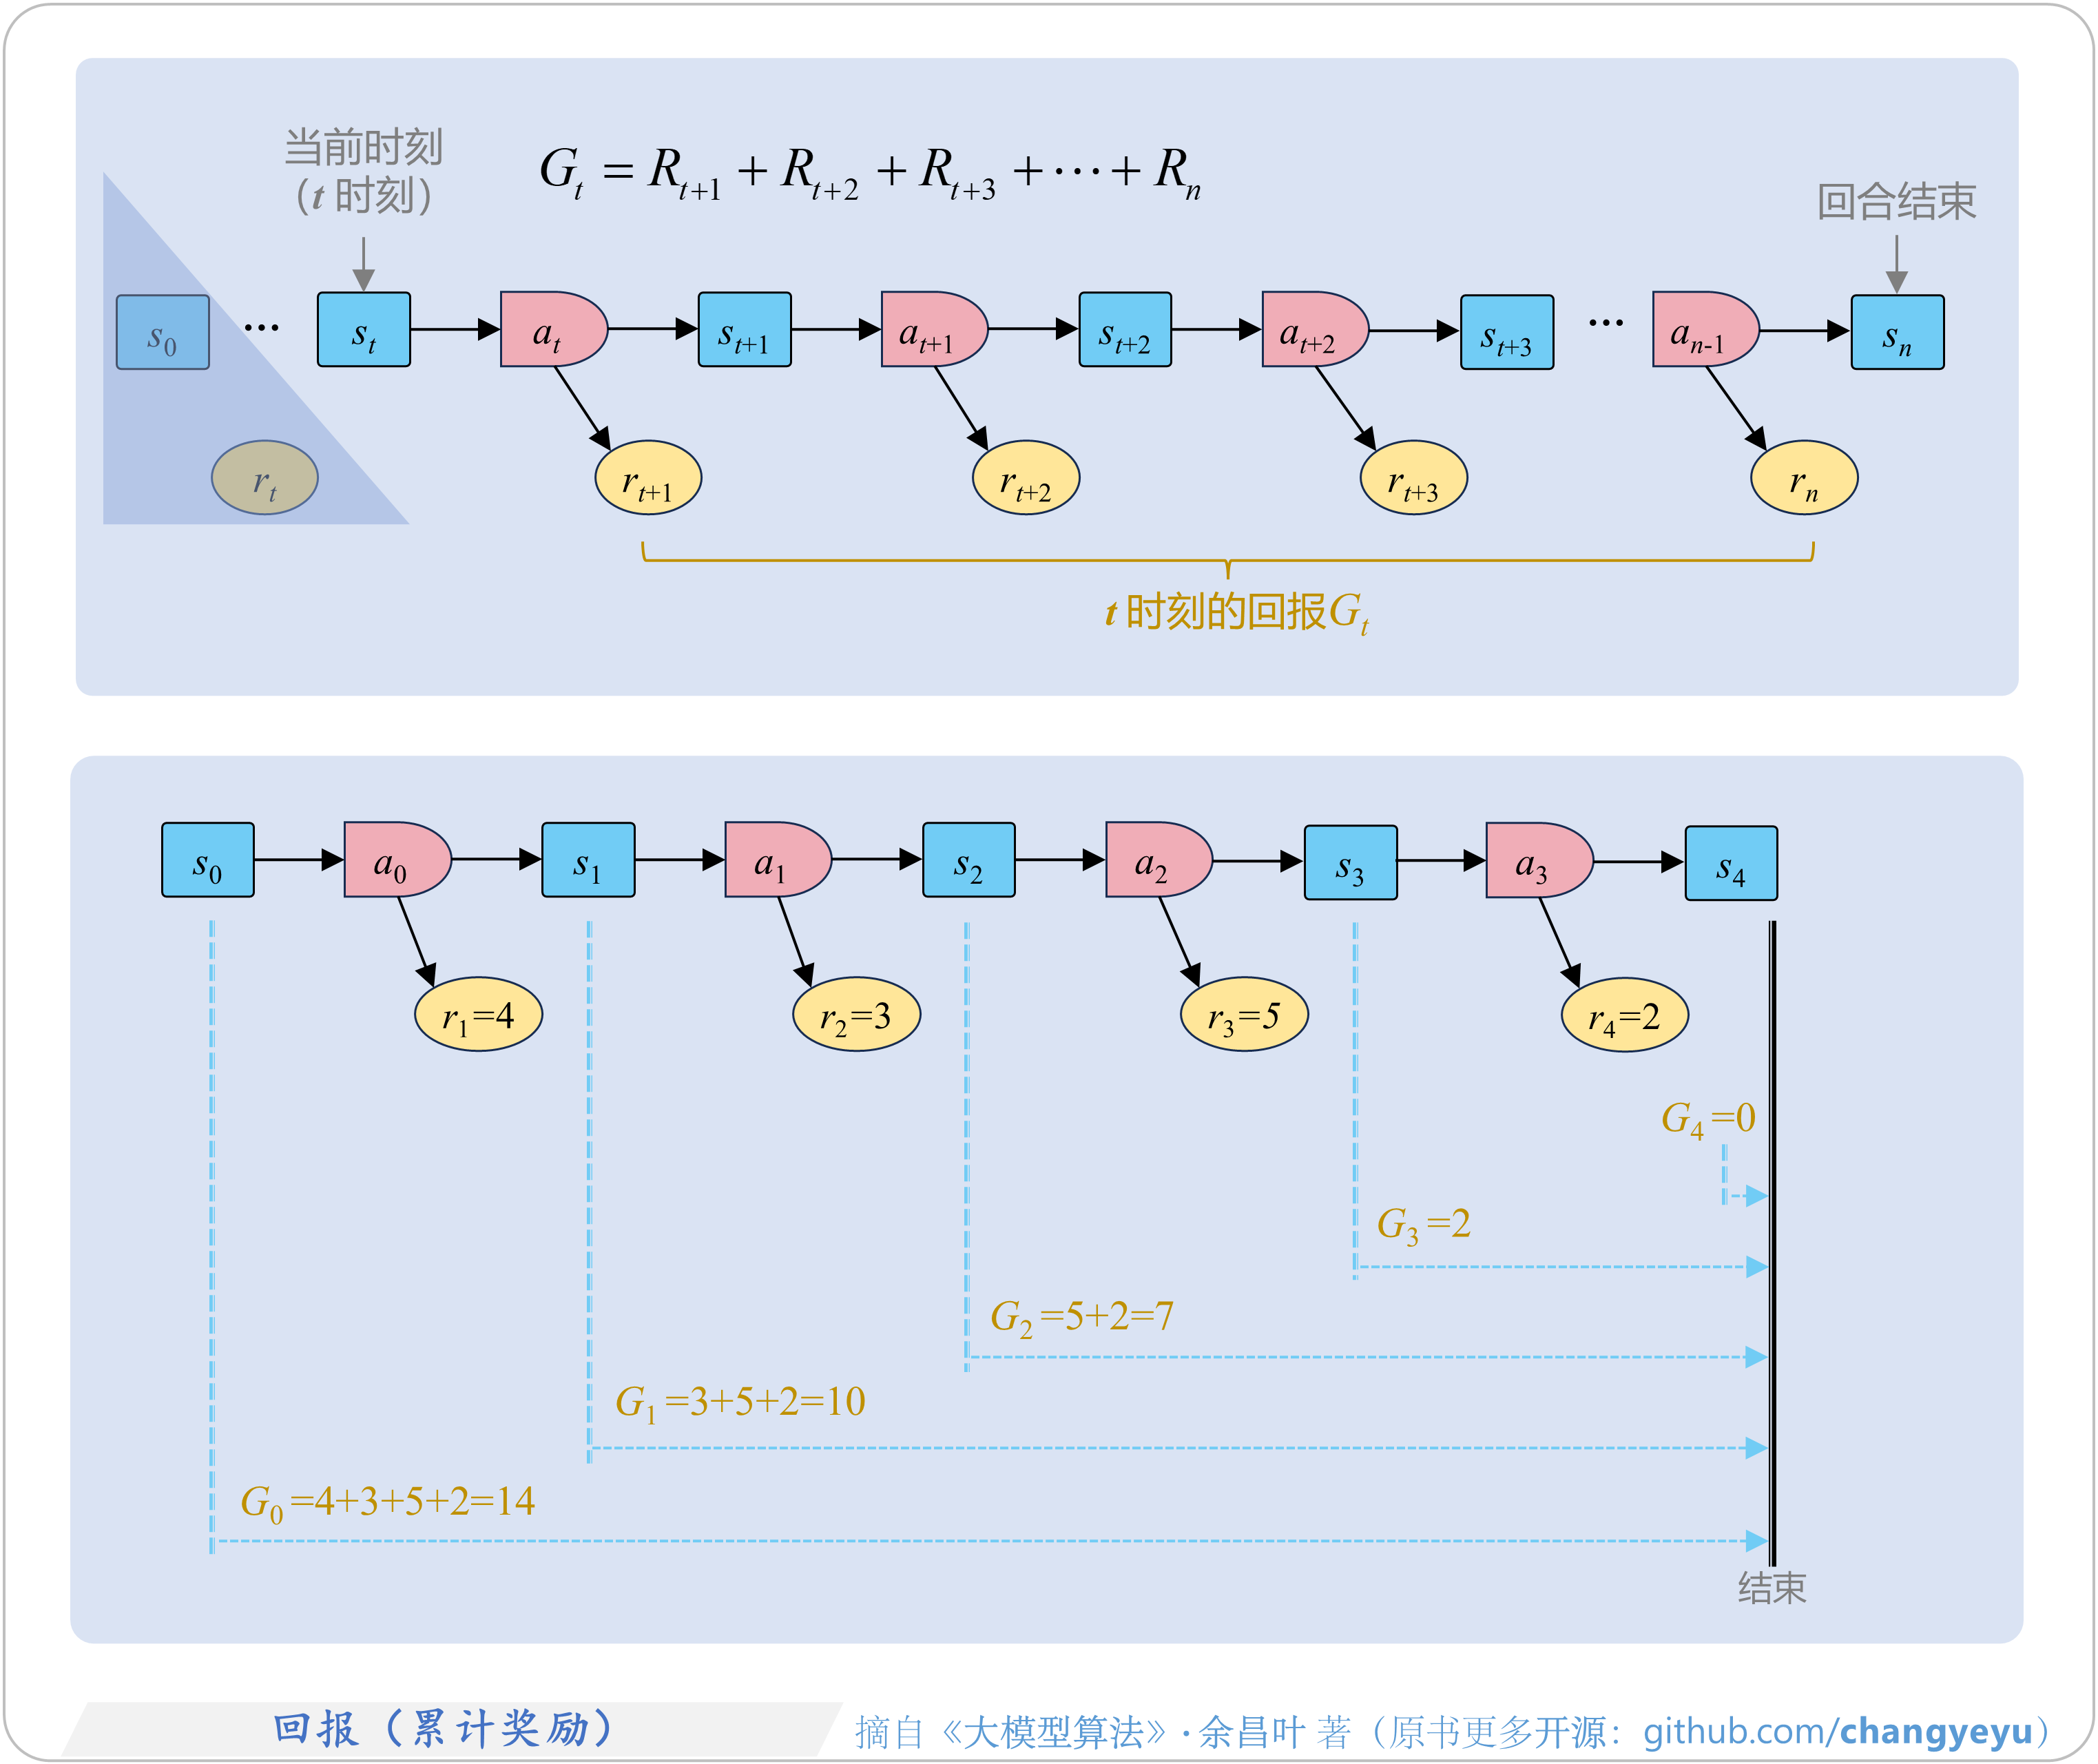
【强化学习基础】回报(累计奖励,Return)
- 回报(Return),常用字母G表示(G是Gain的缩写,即收益),也称为未来回报、累计奖励或累计折扣奖励,是指从某一时间步开始,未来所有奖励的累积总和。
- 它衡量了从当前时间步开始,智能体未来可能获得的总奖励,可用于评估智能体策略在长期内的优劣。

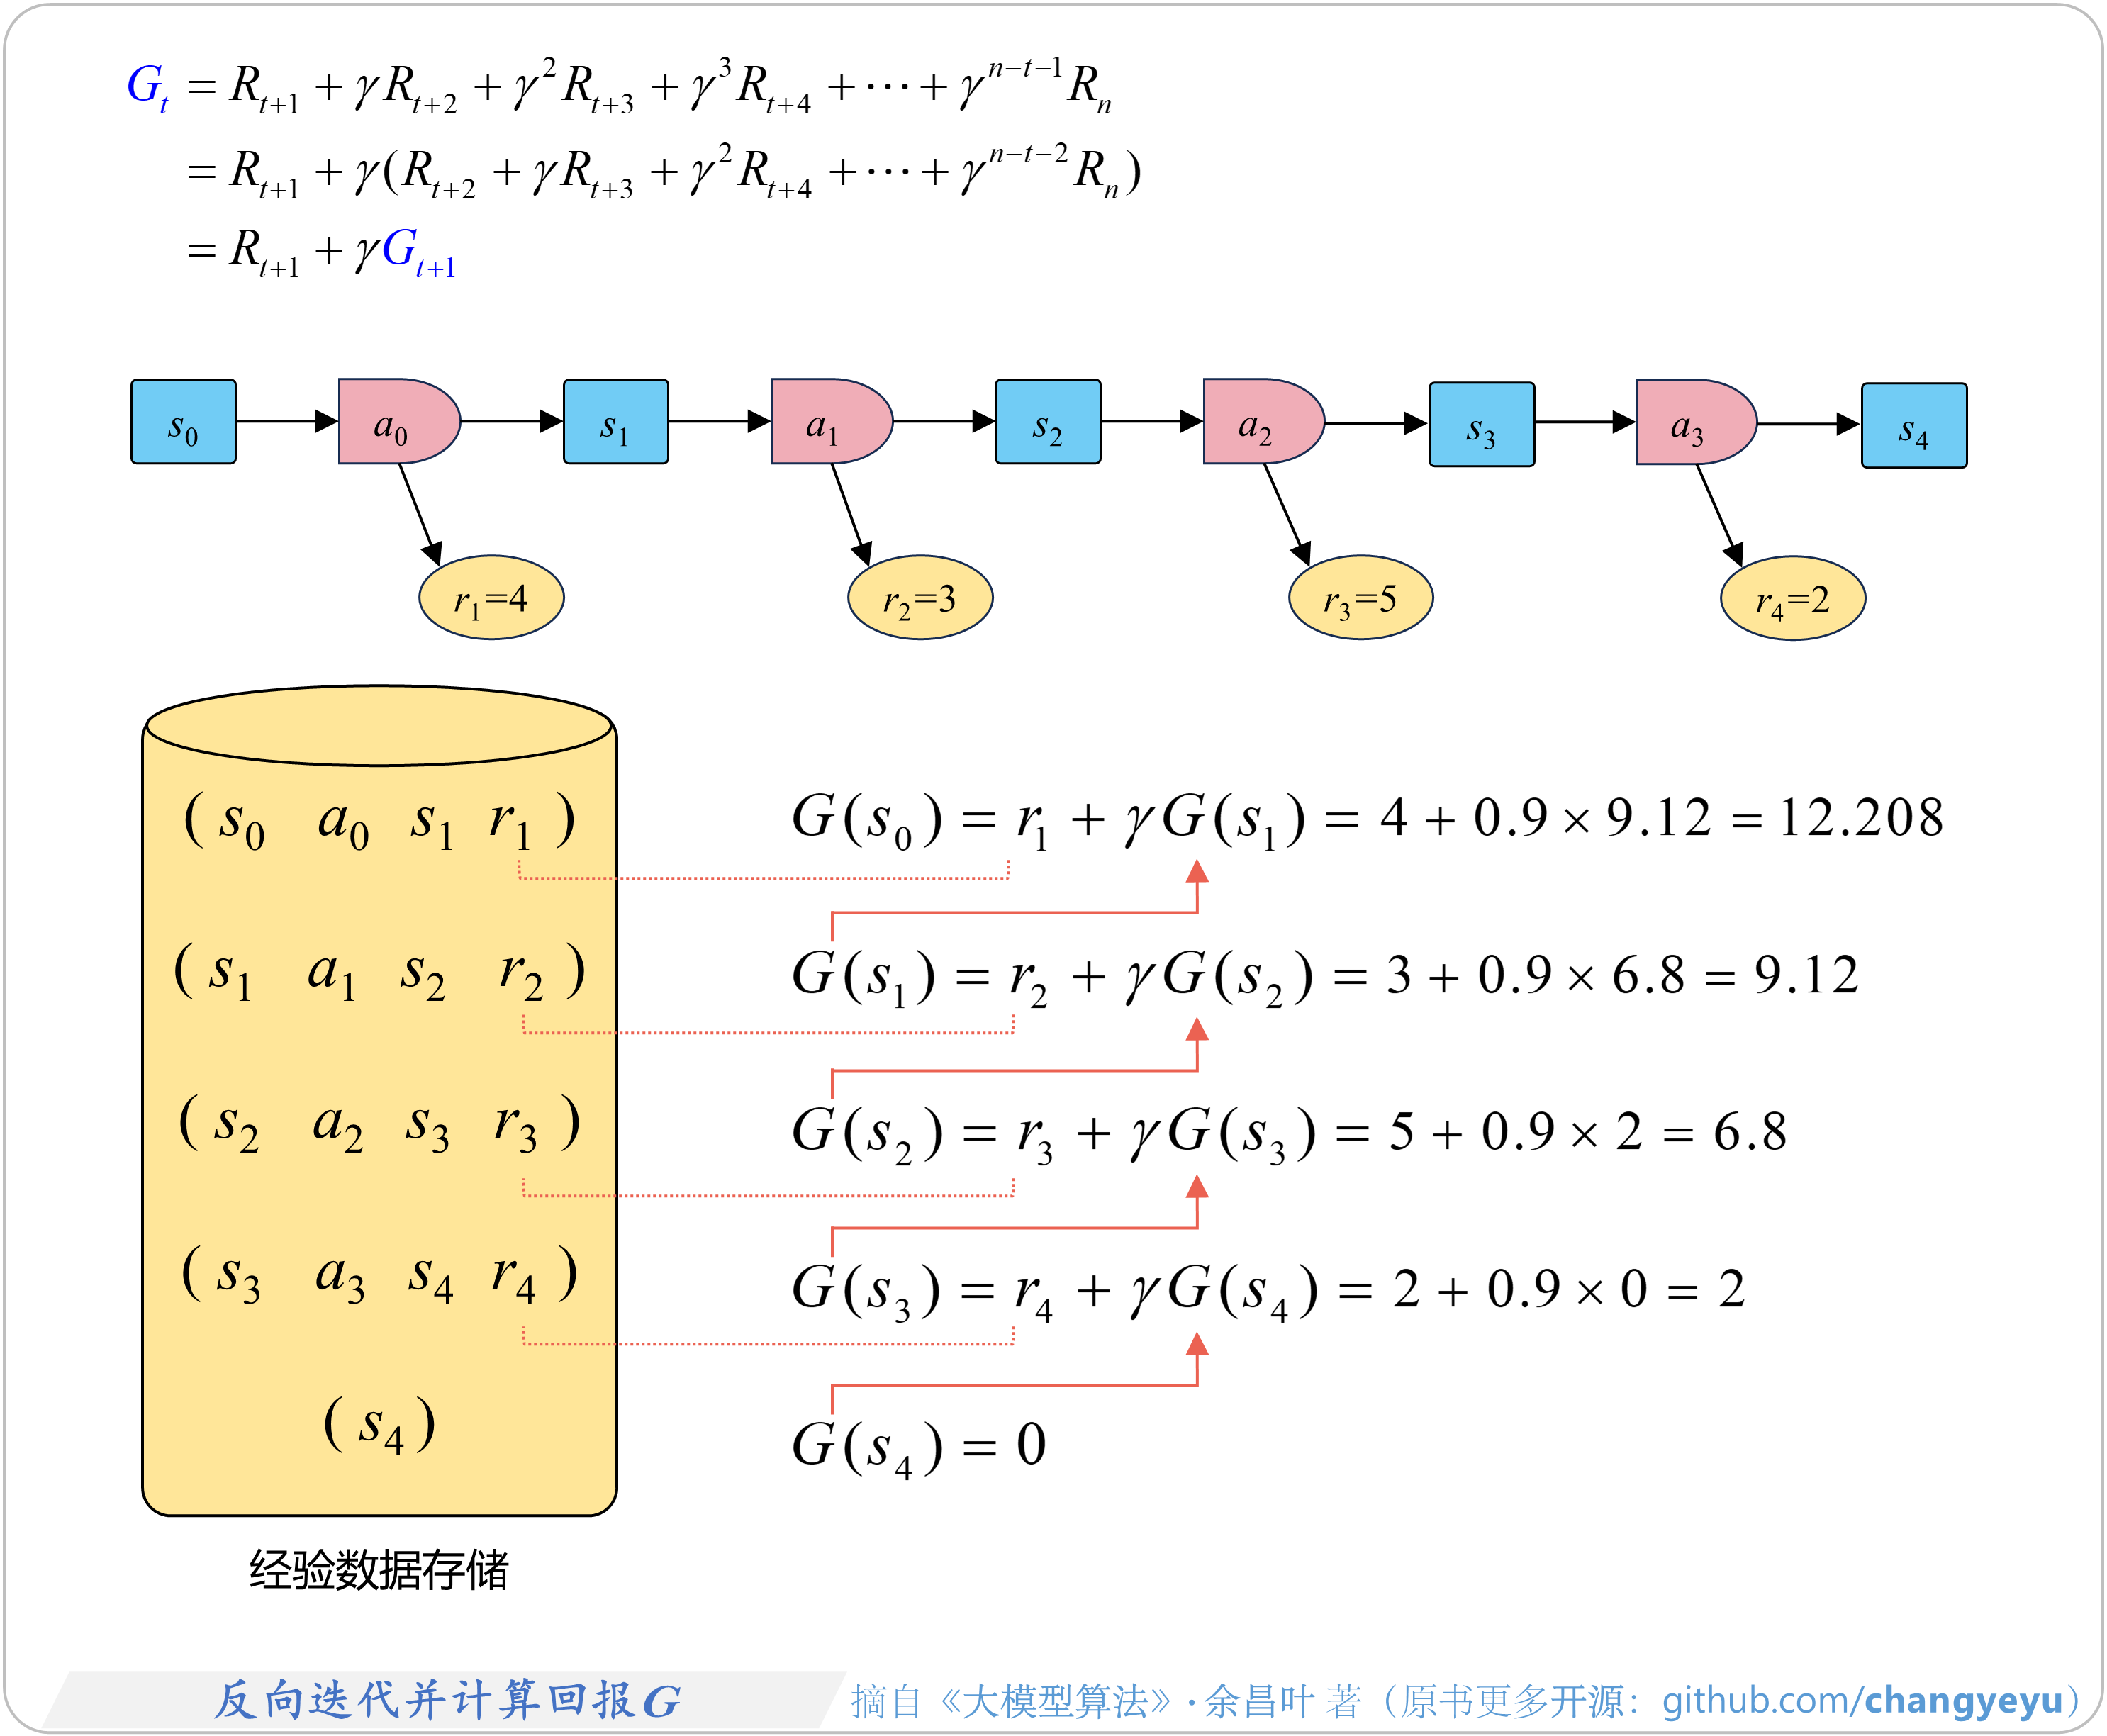
【强化学习基础】反向迭代并计算回报G
- 引入折扣因子γ,根据经验数据存储,从最后一个状态位置开始计算回报,反向迭代计算

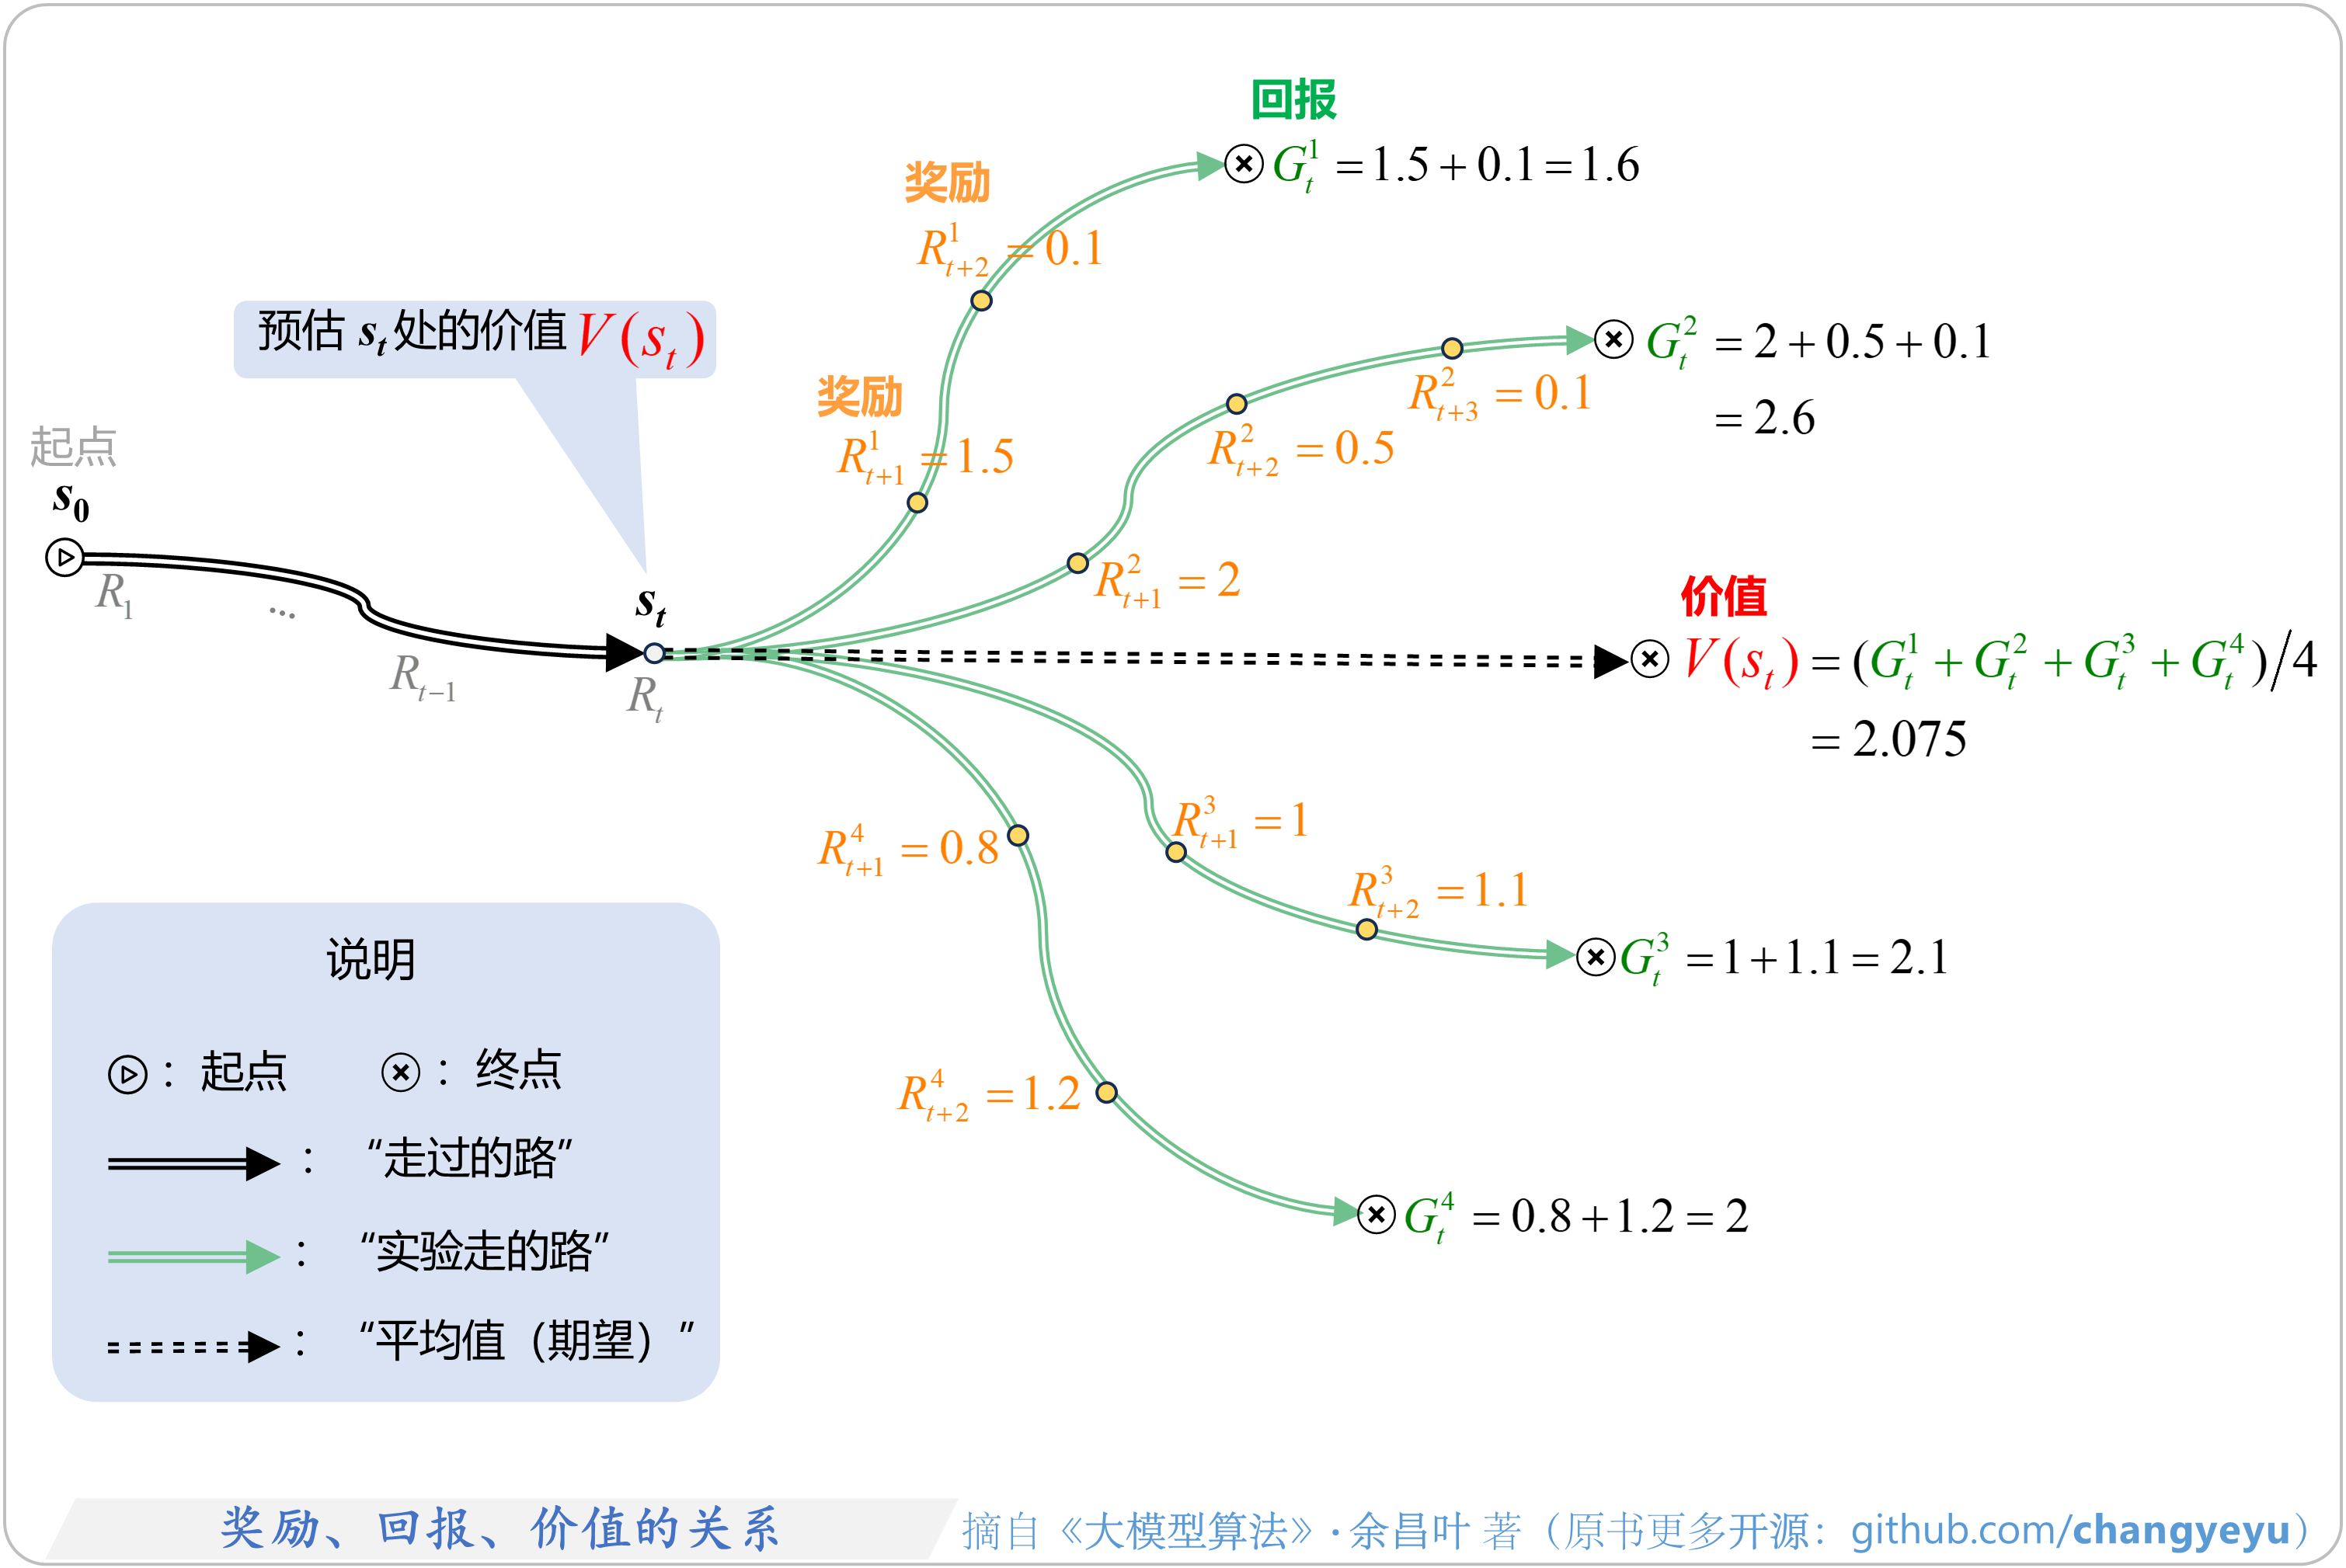
【强化学习基础】奖励(Reward)、回报(Return)、价值(Value)的关系
- 奖励(Reward)、回报(Return)和价值(Value)三者的关系如图所示。需要注意的是,此处假设折扣因子γ=1。
- (1)奖励(Reward):即时奖励,是在某一状态下获得的局部收益或短期收益。
- (2)回报(Return):未来回报,是从当前状态st开始计算,之后所有奖励的累积和,即未来的总收益。
- (3)价值(Value):价值是回报的期望值,即在所有可能的轨迹中,回报乘以其发生概率后的加权平均值,表示在平均情况下的未来总收益。

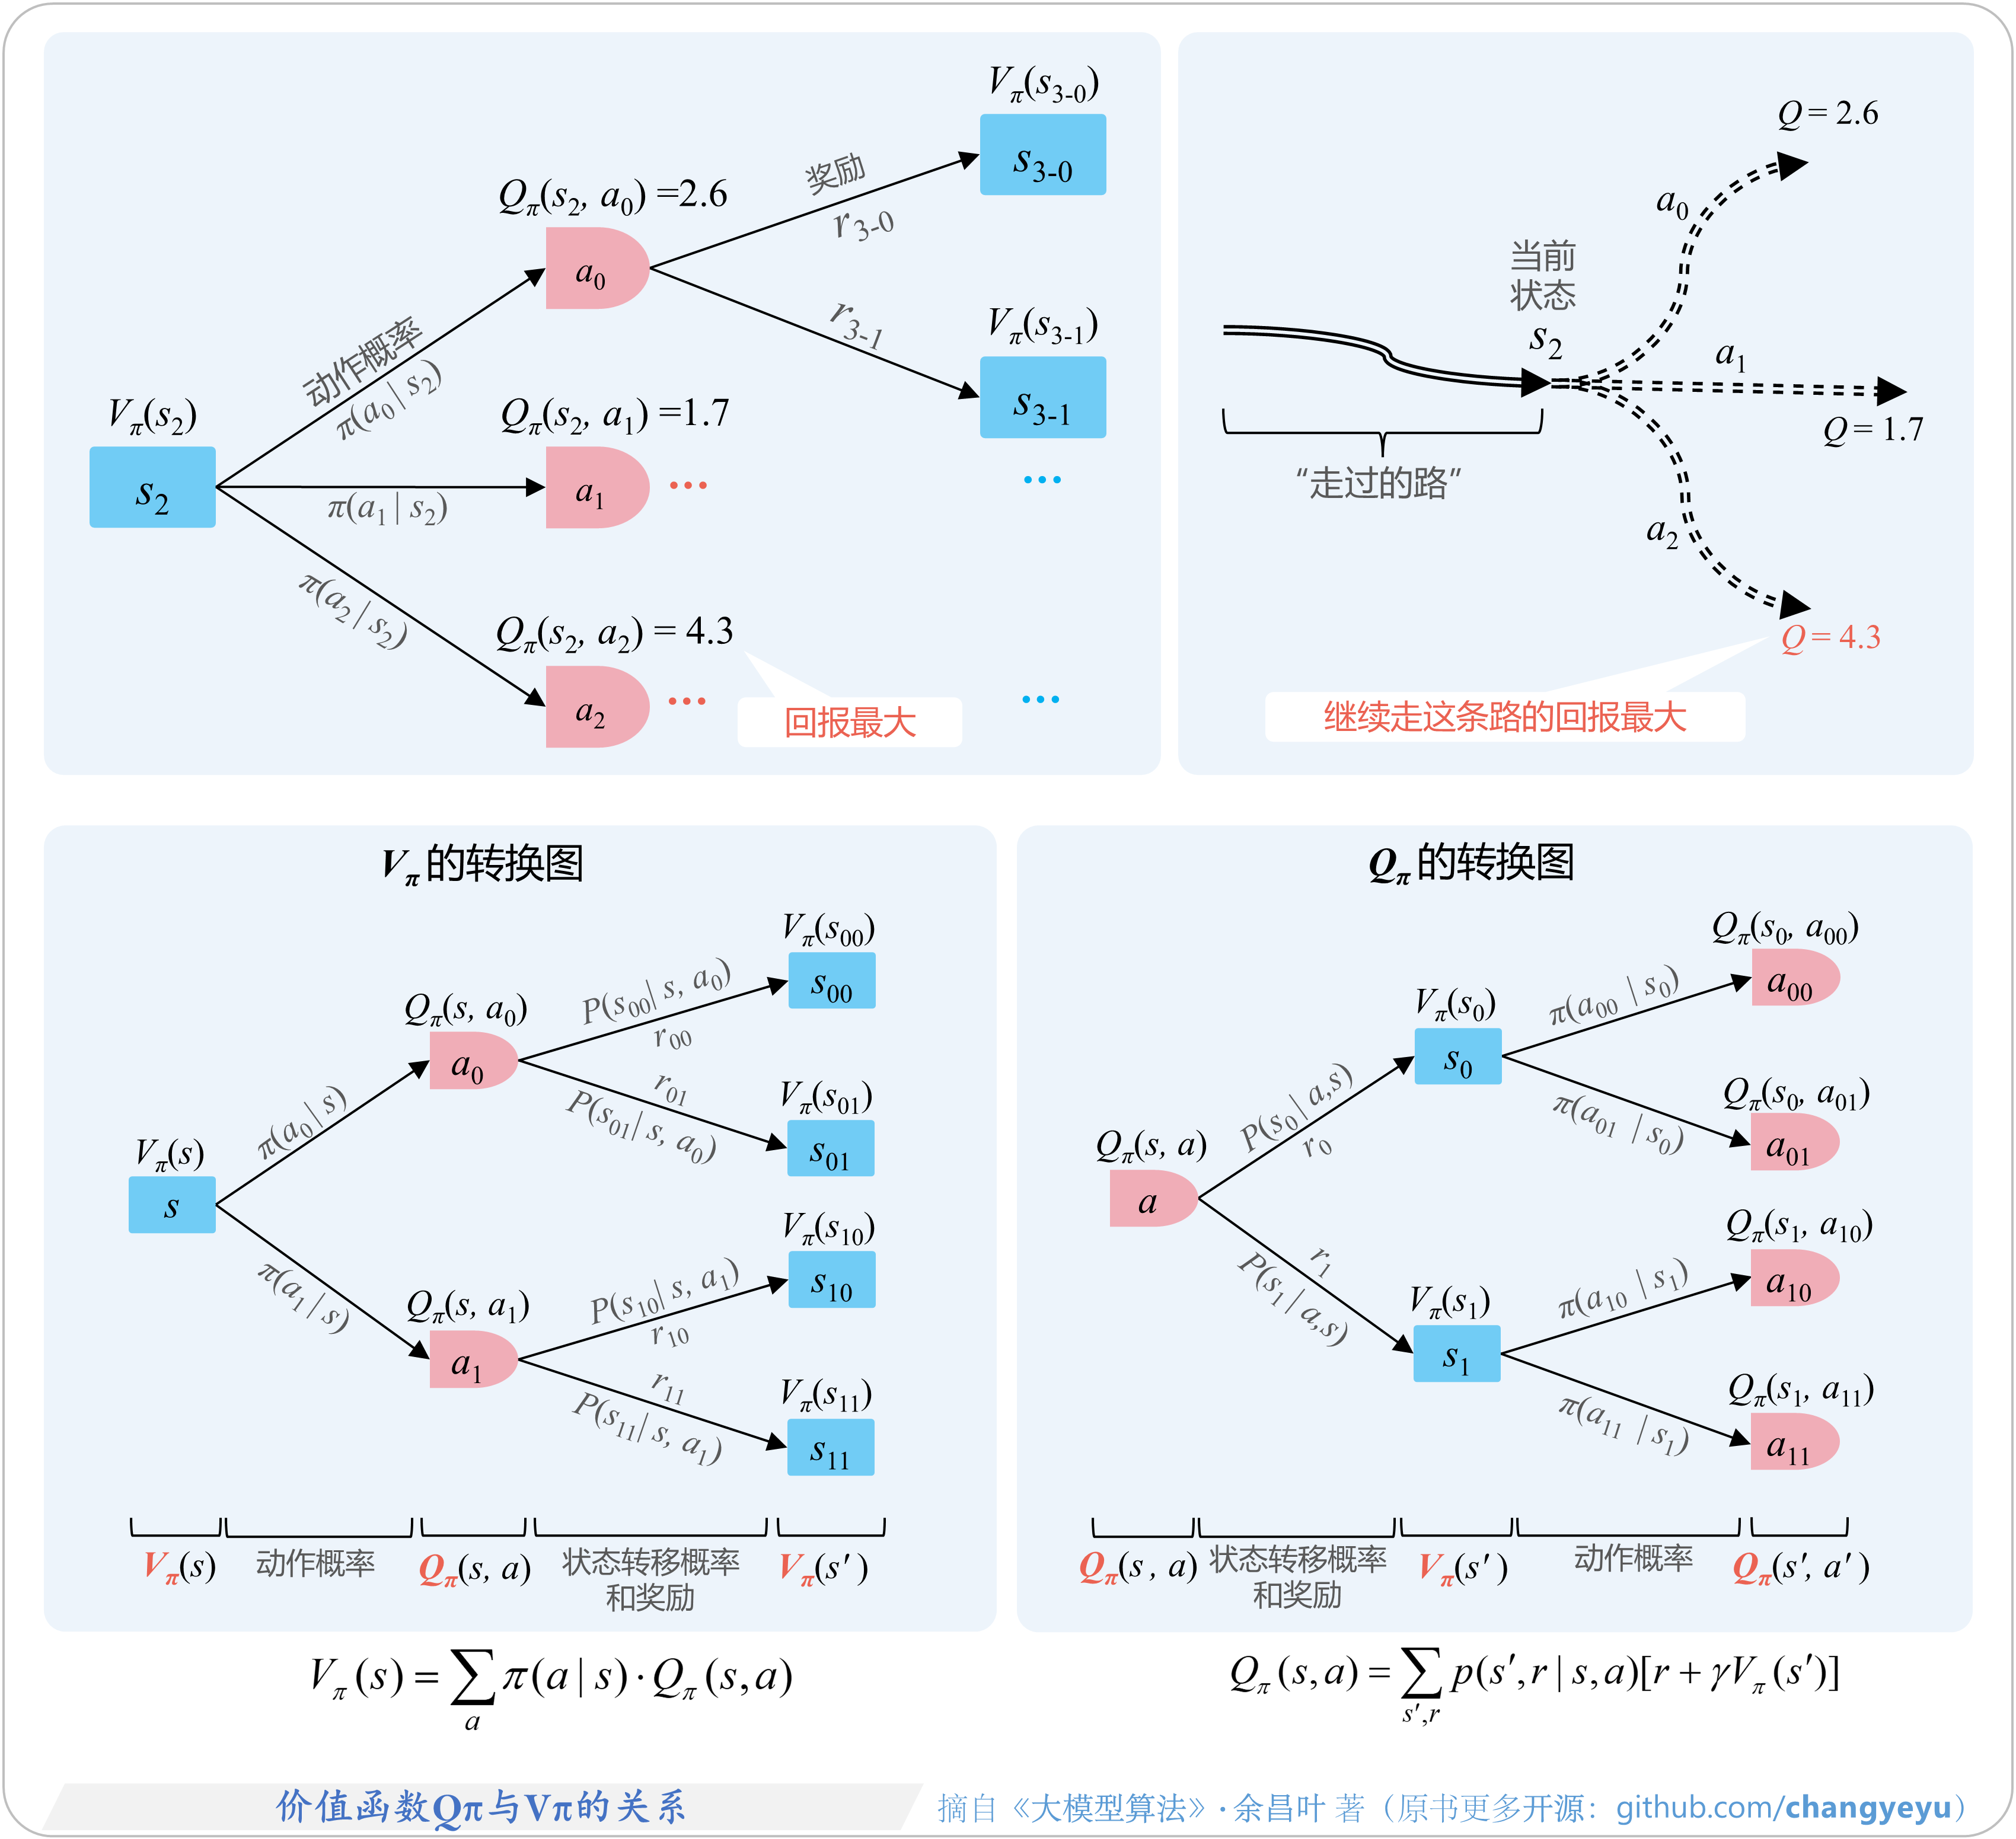
【强化学习基础】价值函数Qπ与Vπ的关系
- 动作价值函数(Action-Value Function)衡量在策略π下,智能体在状态s时采取动作 a后未来所能获得的回报的期望值,该期望值有时也泛称为Q值(Q-value),通常记为Qπ(s,a)
- 状态价值函数(State-Value Function),记为Vπ(s),表示在状态s下,遵循策略π时,智能体未来能够获得的回报的期望值。

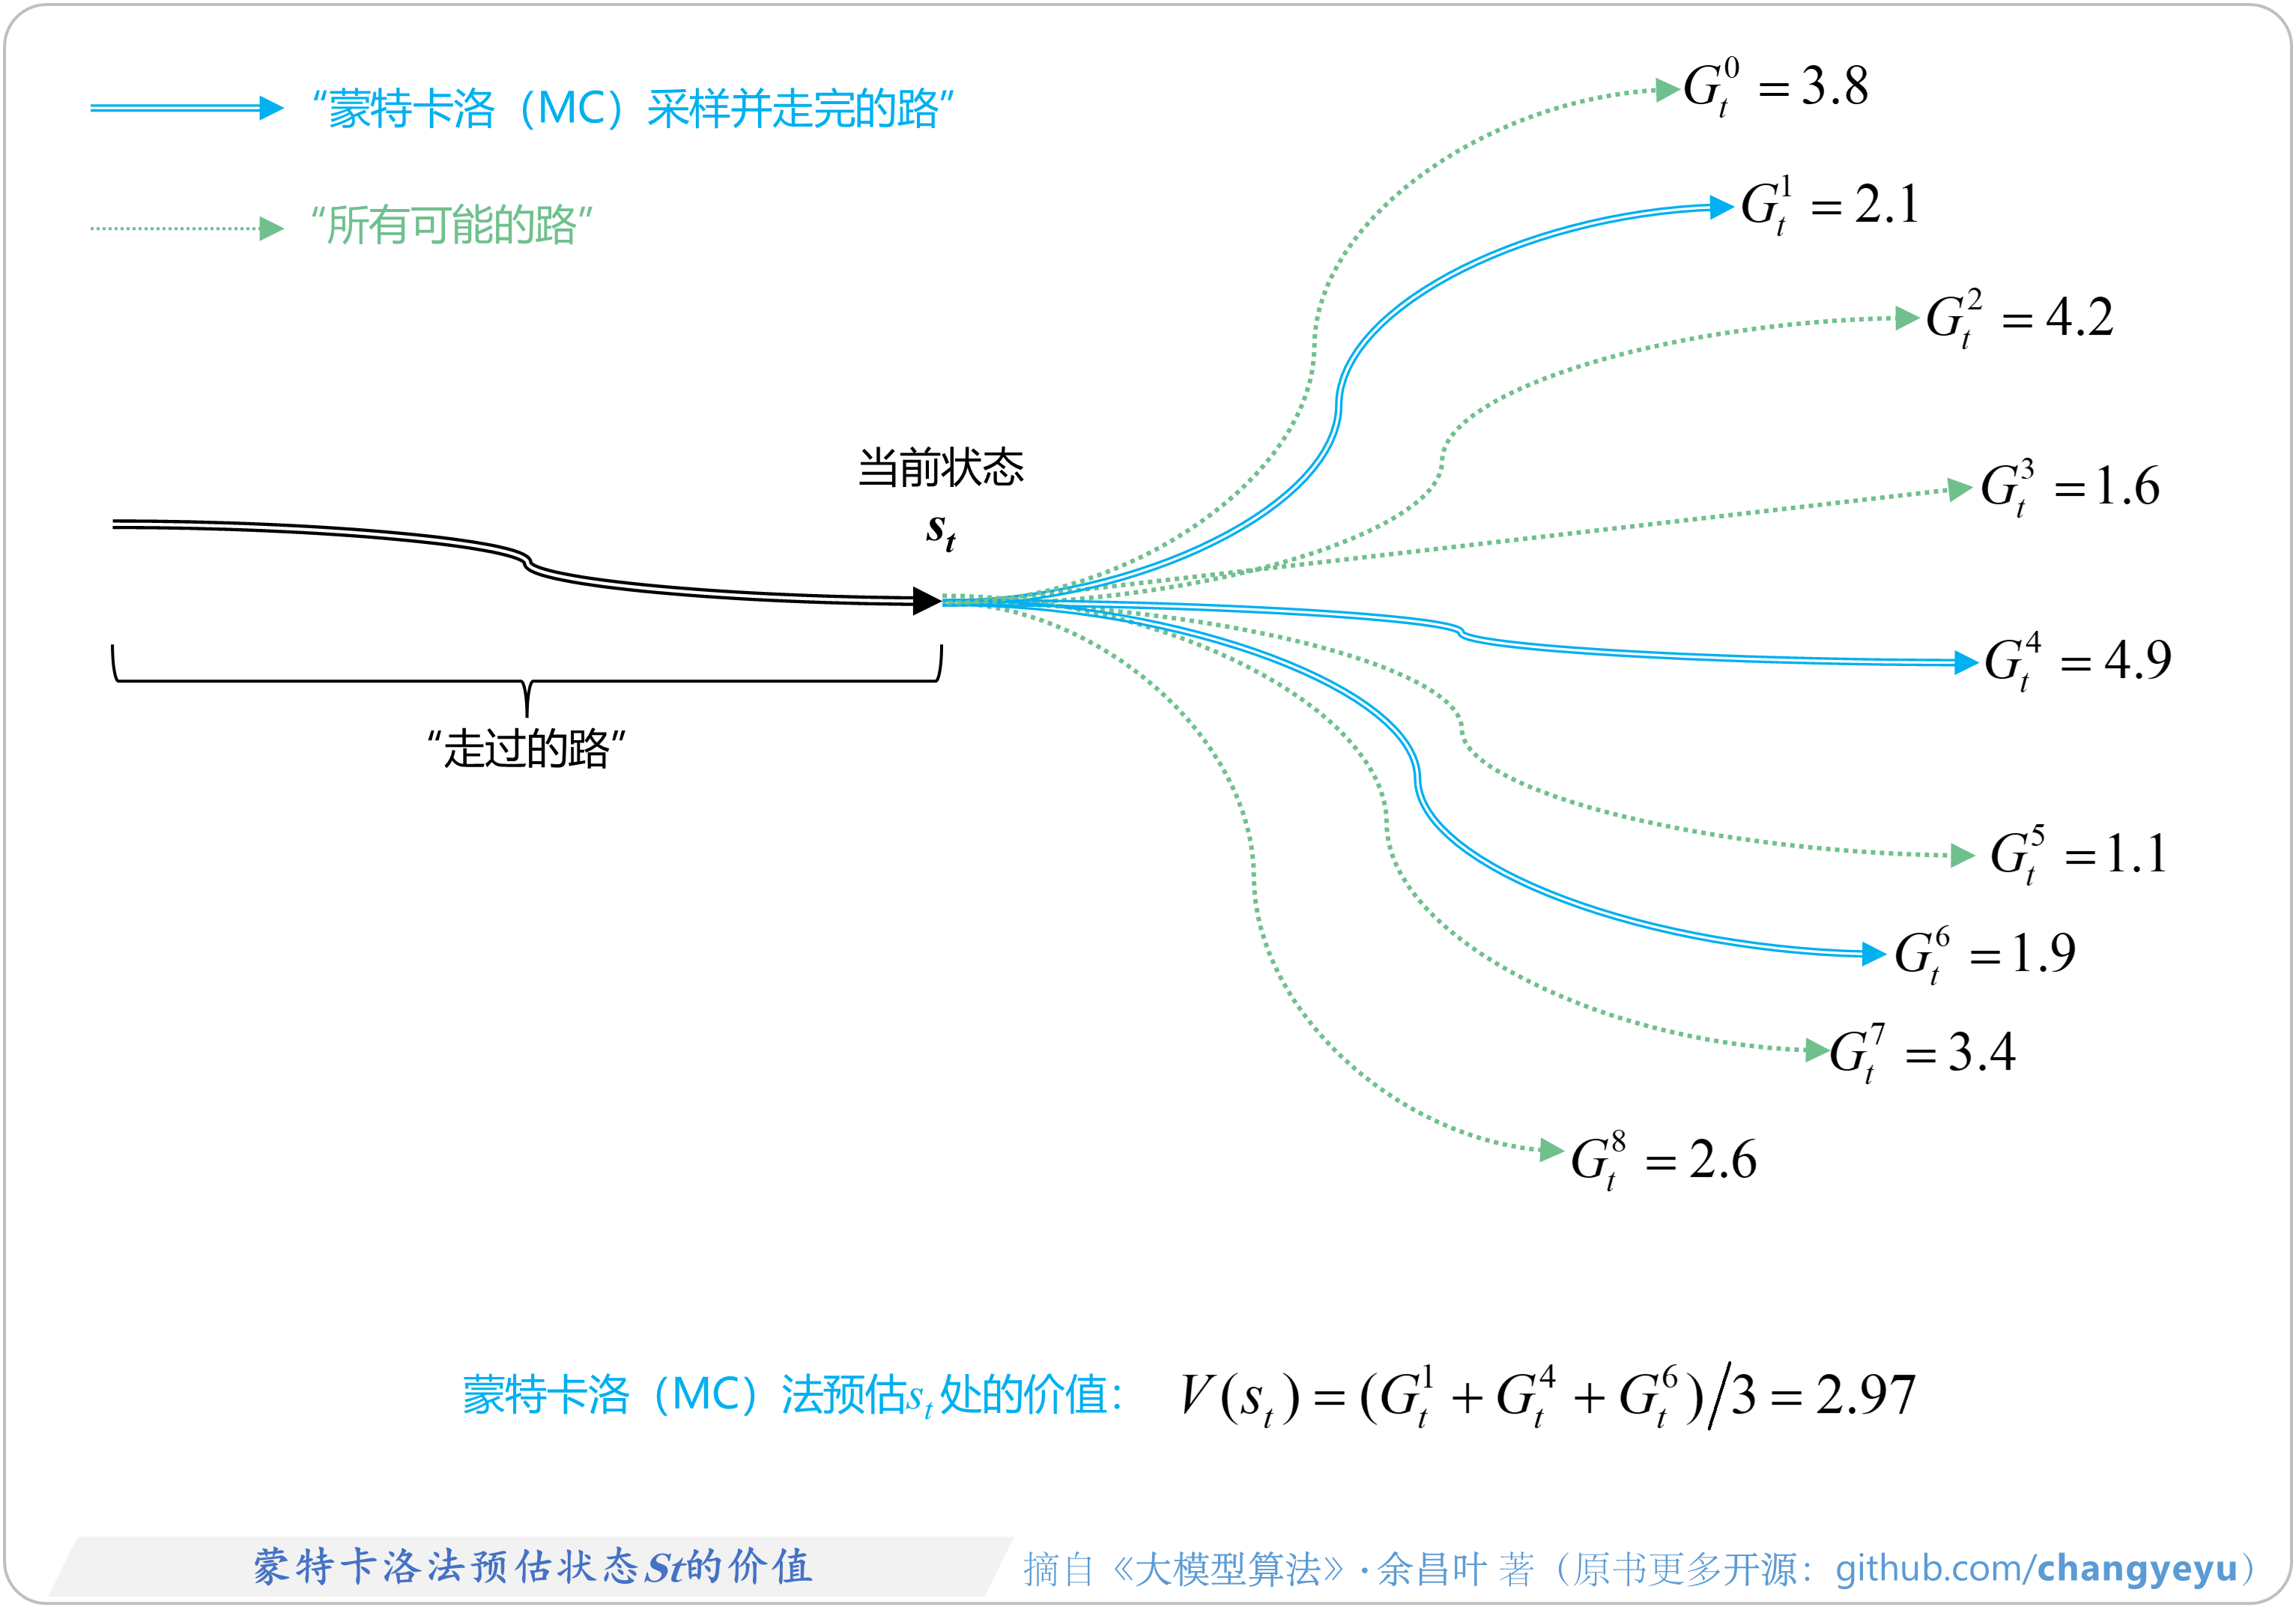
【强化学习基础】蒙特卡洛(Monte Carlo,MC)法预估状态St的价值
- 蒙特卡洛(Monte Carlo, MC)方法是一种基于随机采样的计算方法,利用随机采样来解决在原则上可能是确定性的难题。
- 在强化学习中,蒙特卡洛方法是指通过多次实际运行试验,获得多个实际的运行轨迹,根据这些结果来估计价值函数或优化策略,特别适用于那些环境模型未知或难以解析的问题。

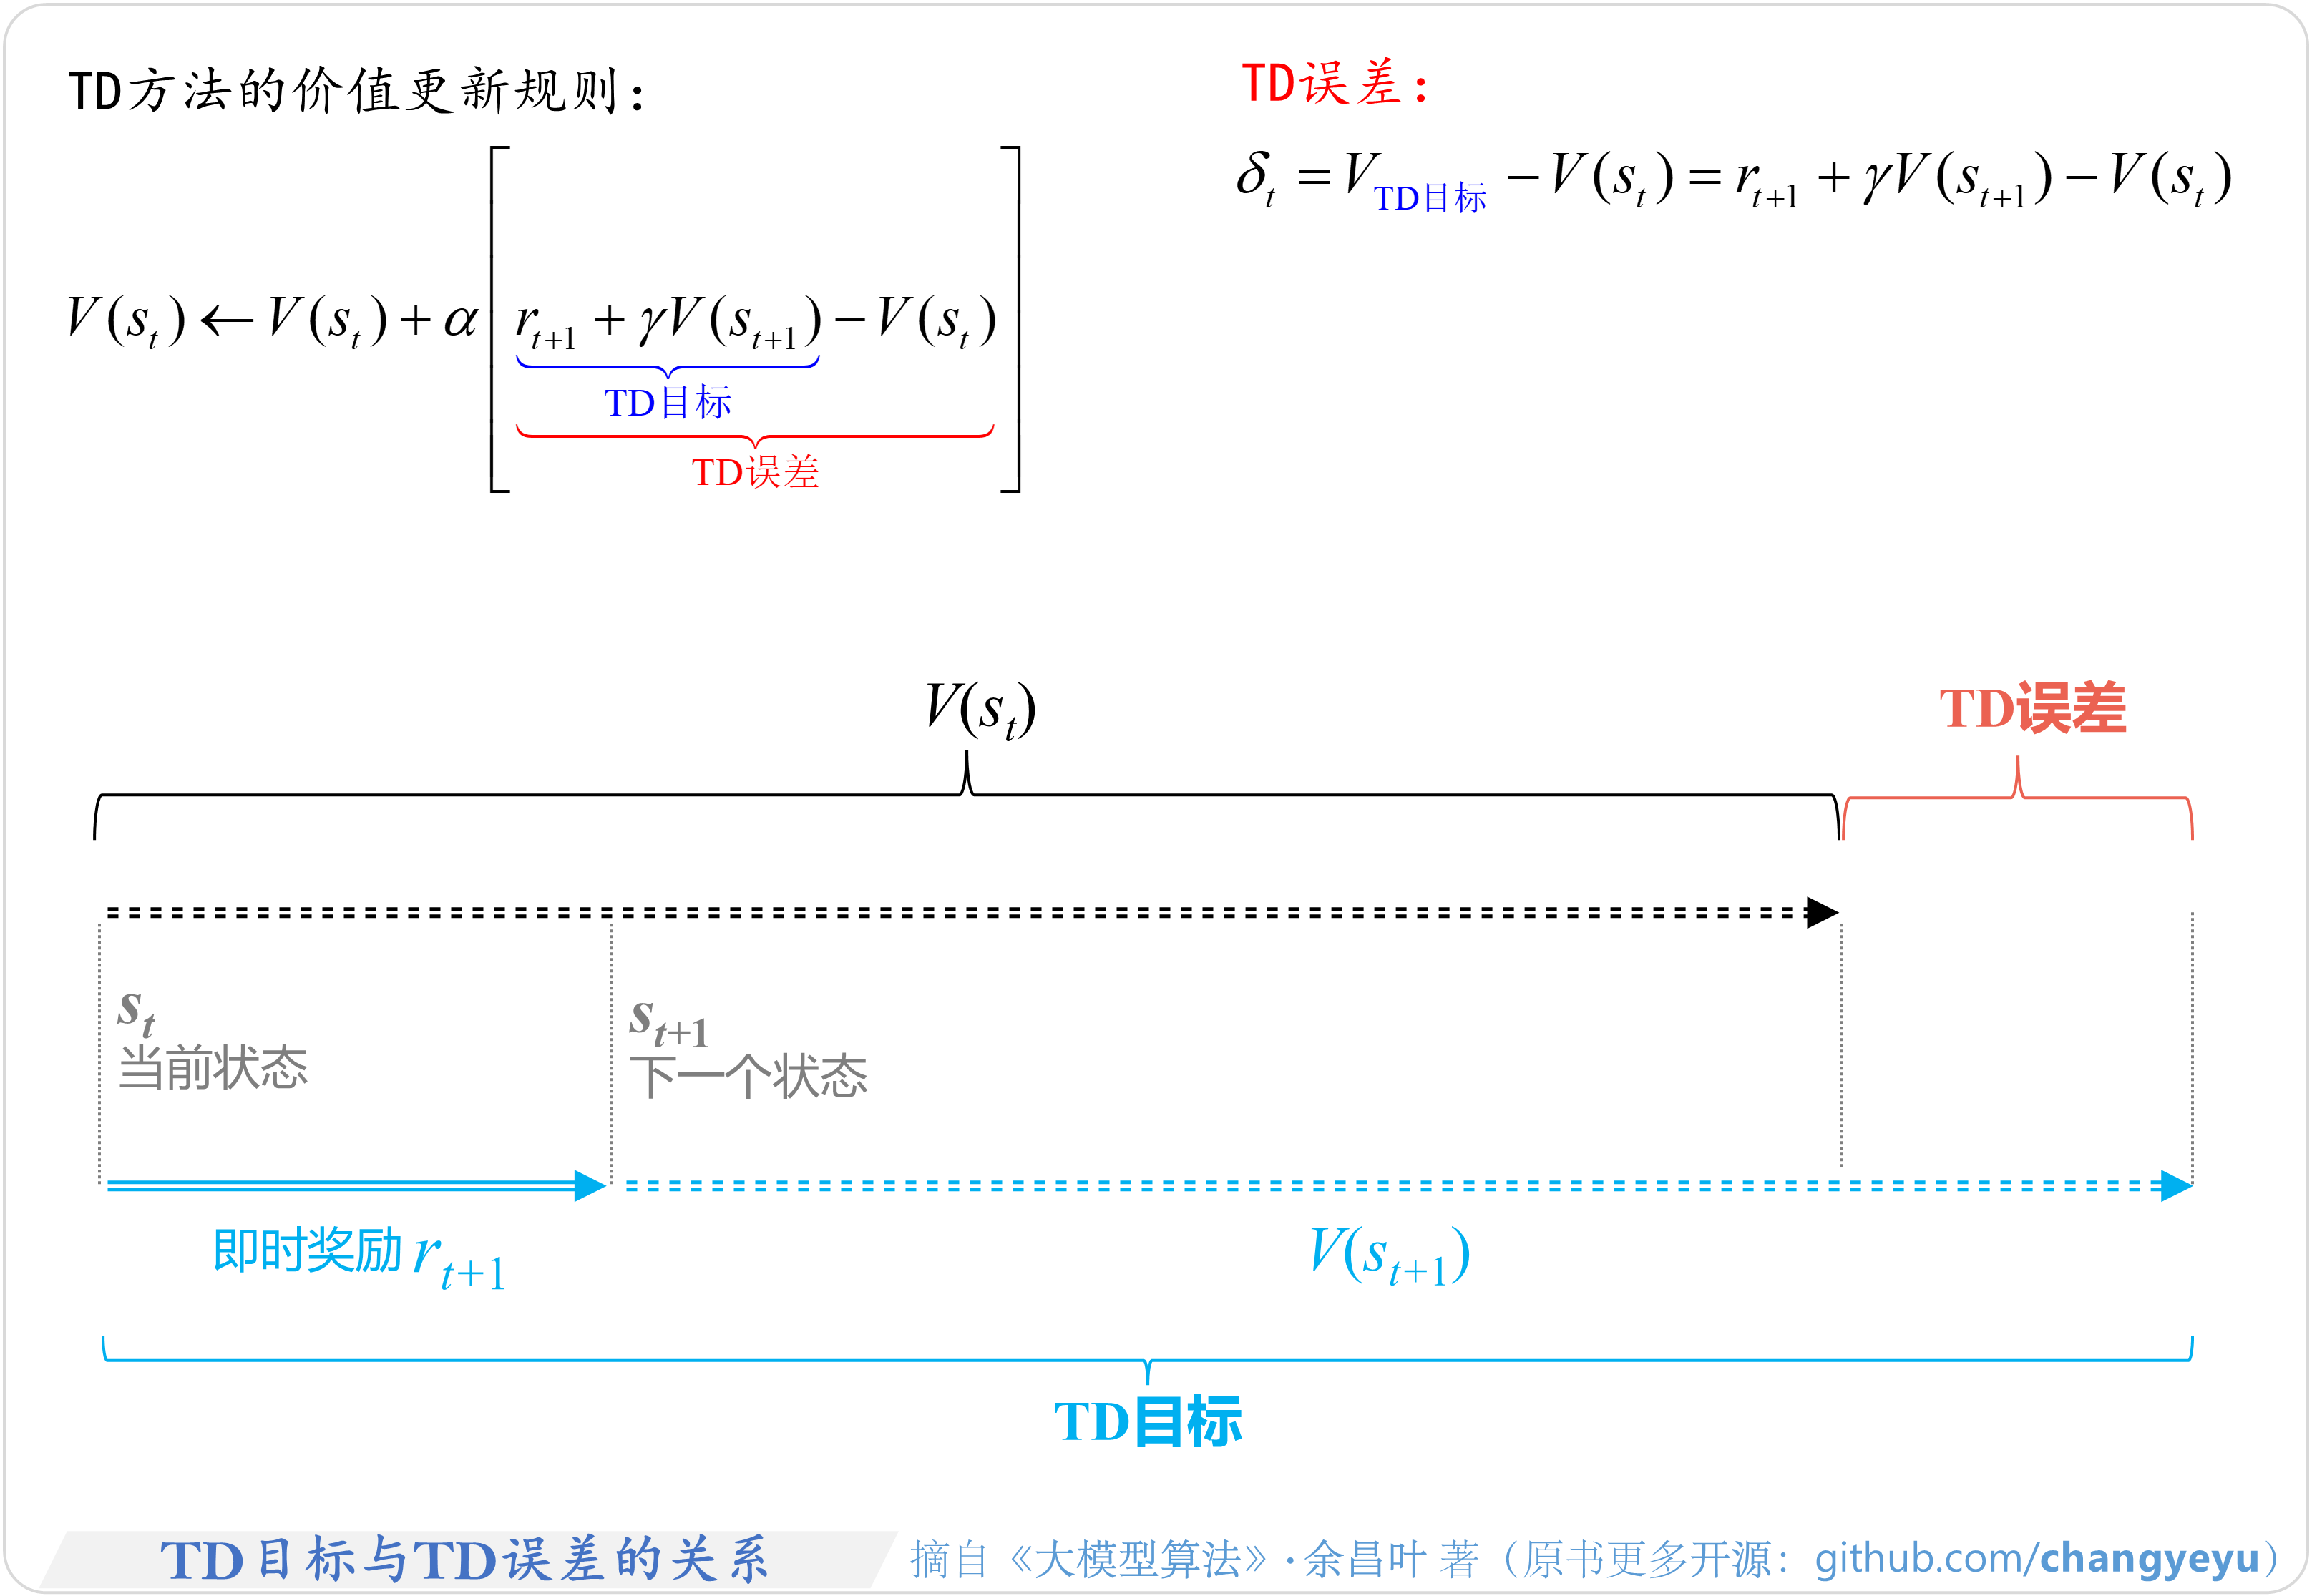
【强化学习基础】TD目标与TD误差的关系(TD target and TD error)
- TD error(TD误差)衡量了当前价值估计与TD目标之间的差异,它反映了当前估计与最新信息的不一致程度,指导价值函数的更新方向和幅度。
- TD target (TD目标)包含了最新的环境反馈信息rt+1,因此被认为比V(st)更接近真实值,通常将TD目标作为价值函数拟合的目标。TD目标与TD误差的关系如图所示。

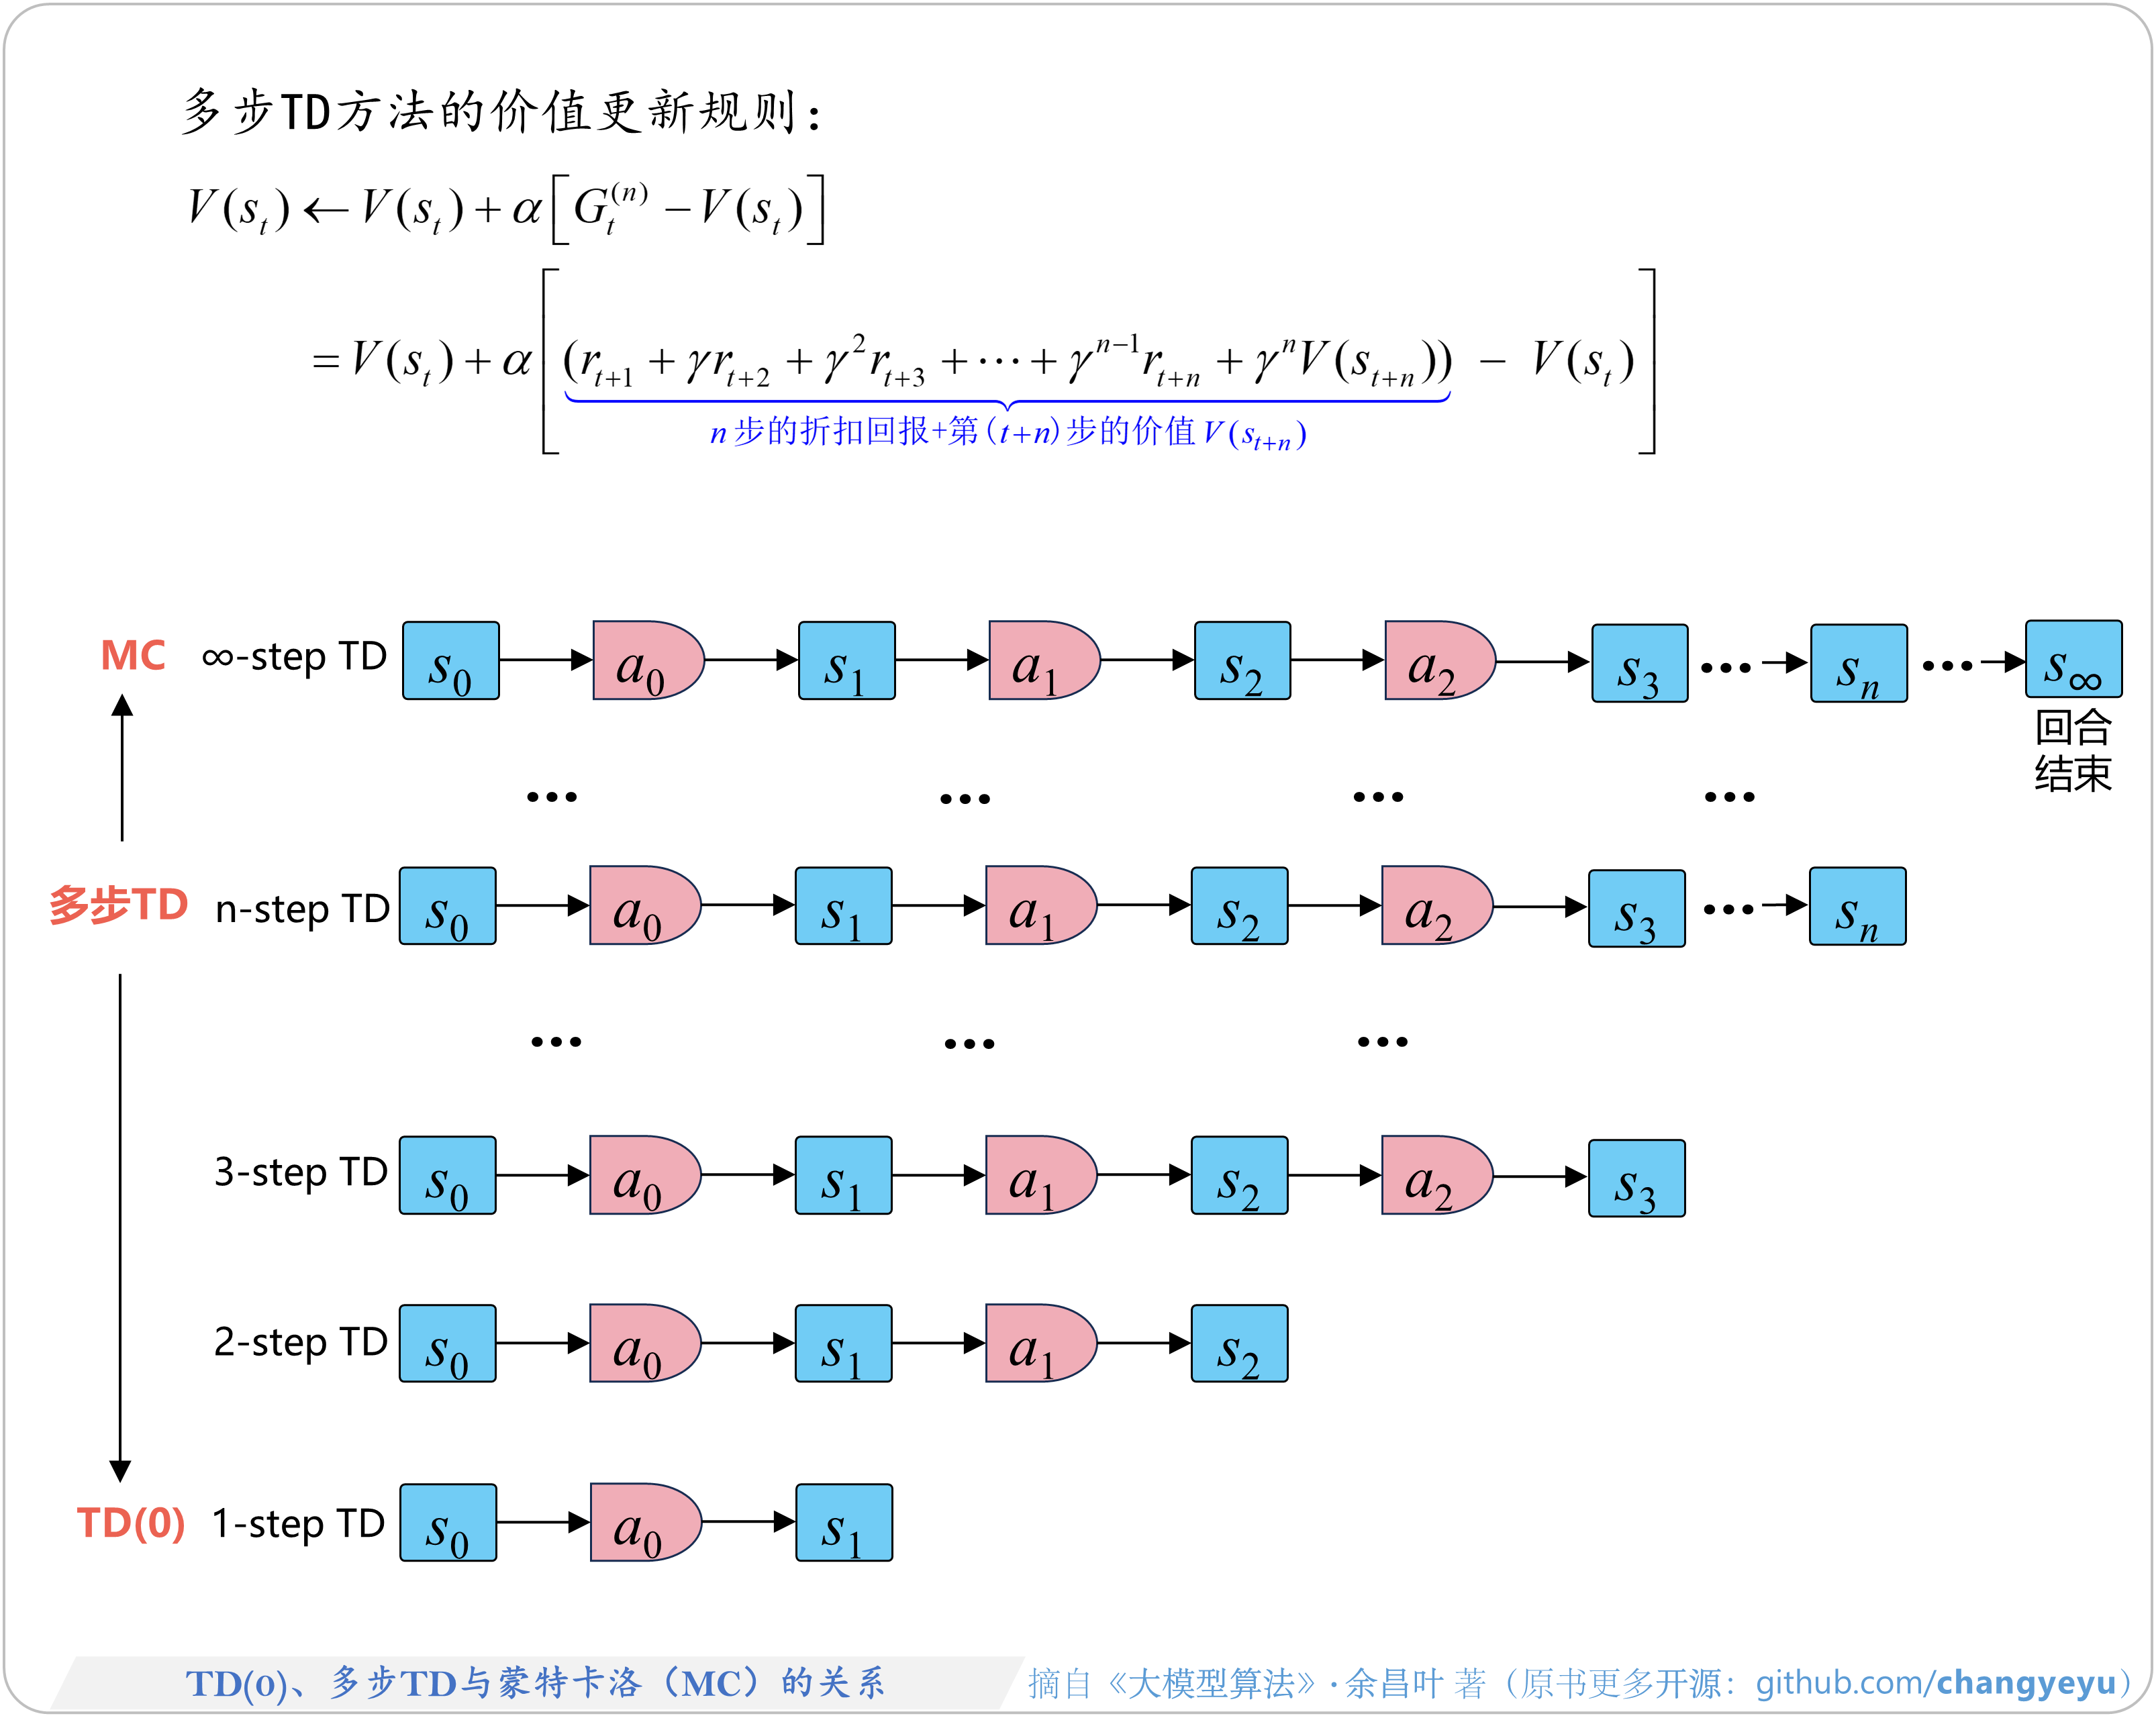
【强化学习基础】TD(0)、多步TD与蒙特卡洛(MC)的关系
- TD(0)、多步TD与蒙特卡洛方法之间存在紧密的联系。如图:
- 当步数n=1时,多步TD退化为TD(0);
- 当步数n趋近于无穷大时,多步TD退化为蒙特卡洛方法。

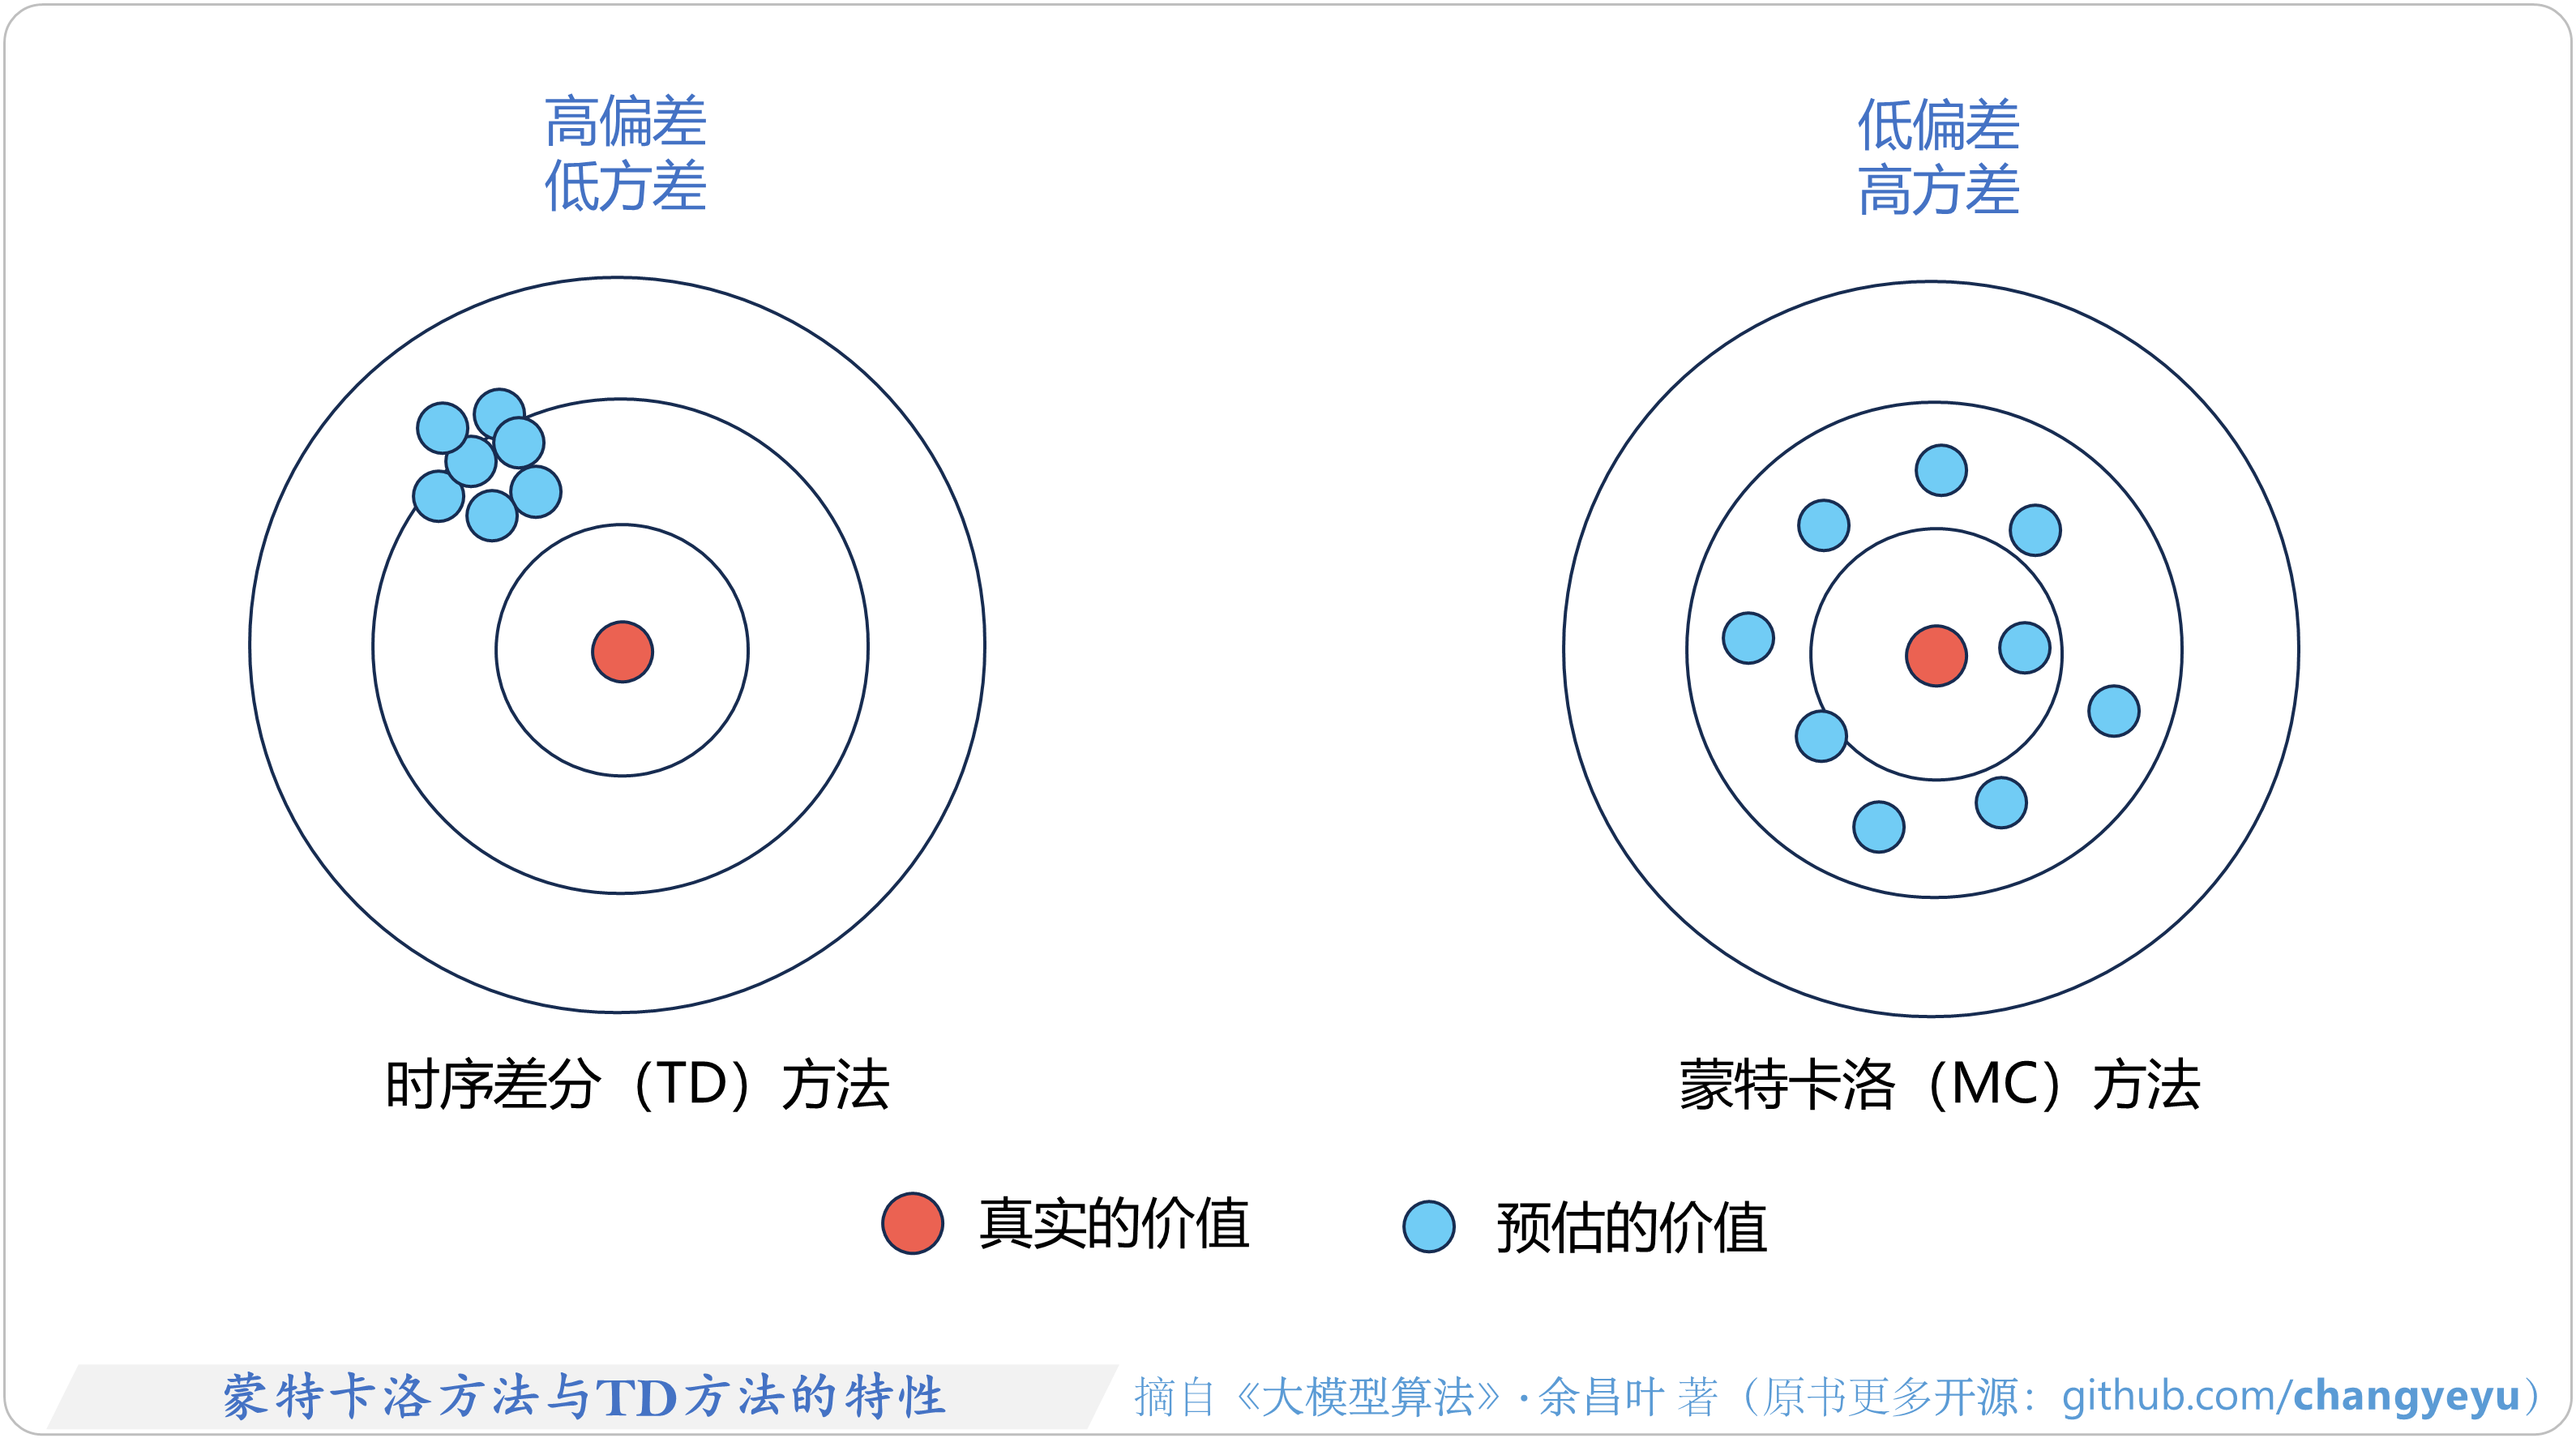
【强化学习基础】蒙特卡洛方法与TD方法的特性
- 蒙特卡洛方法和TD方法在估计价值时各有优劣:蒙特卡洛方法低偏差、高方差;TD方法高偏差、低方差。

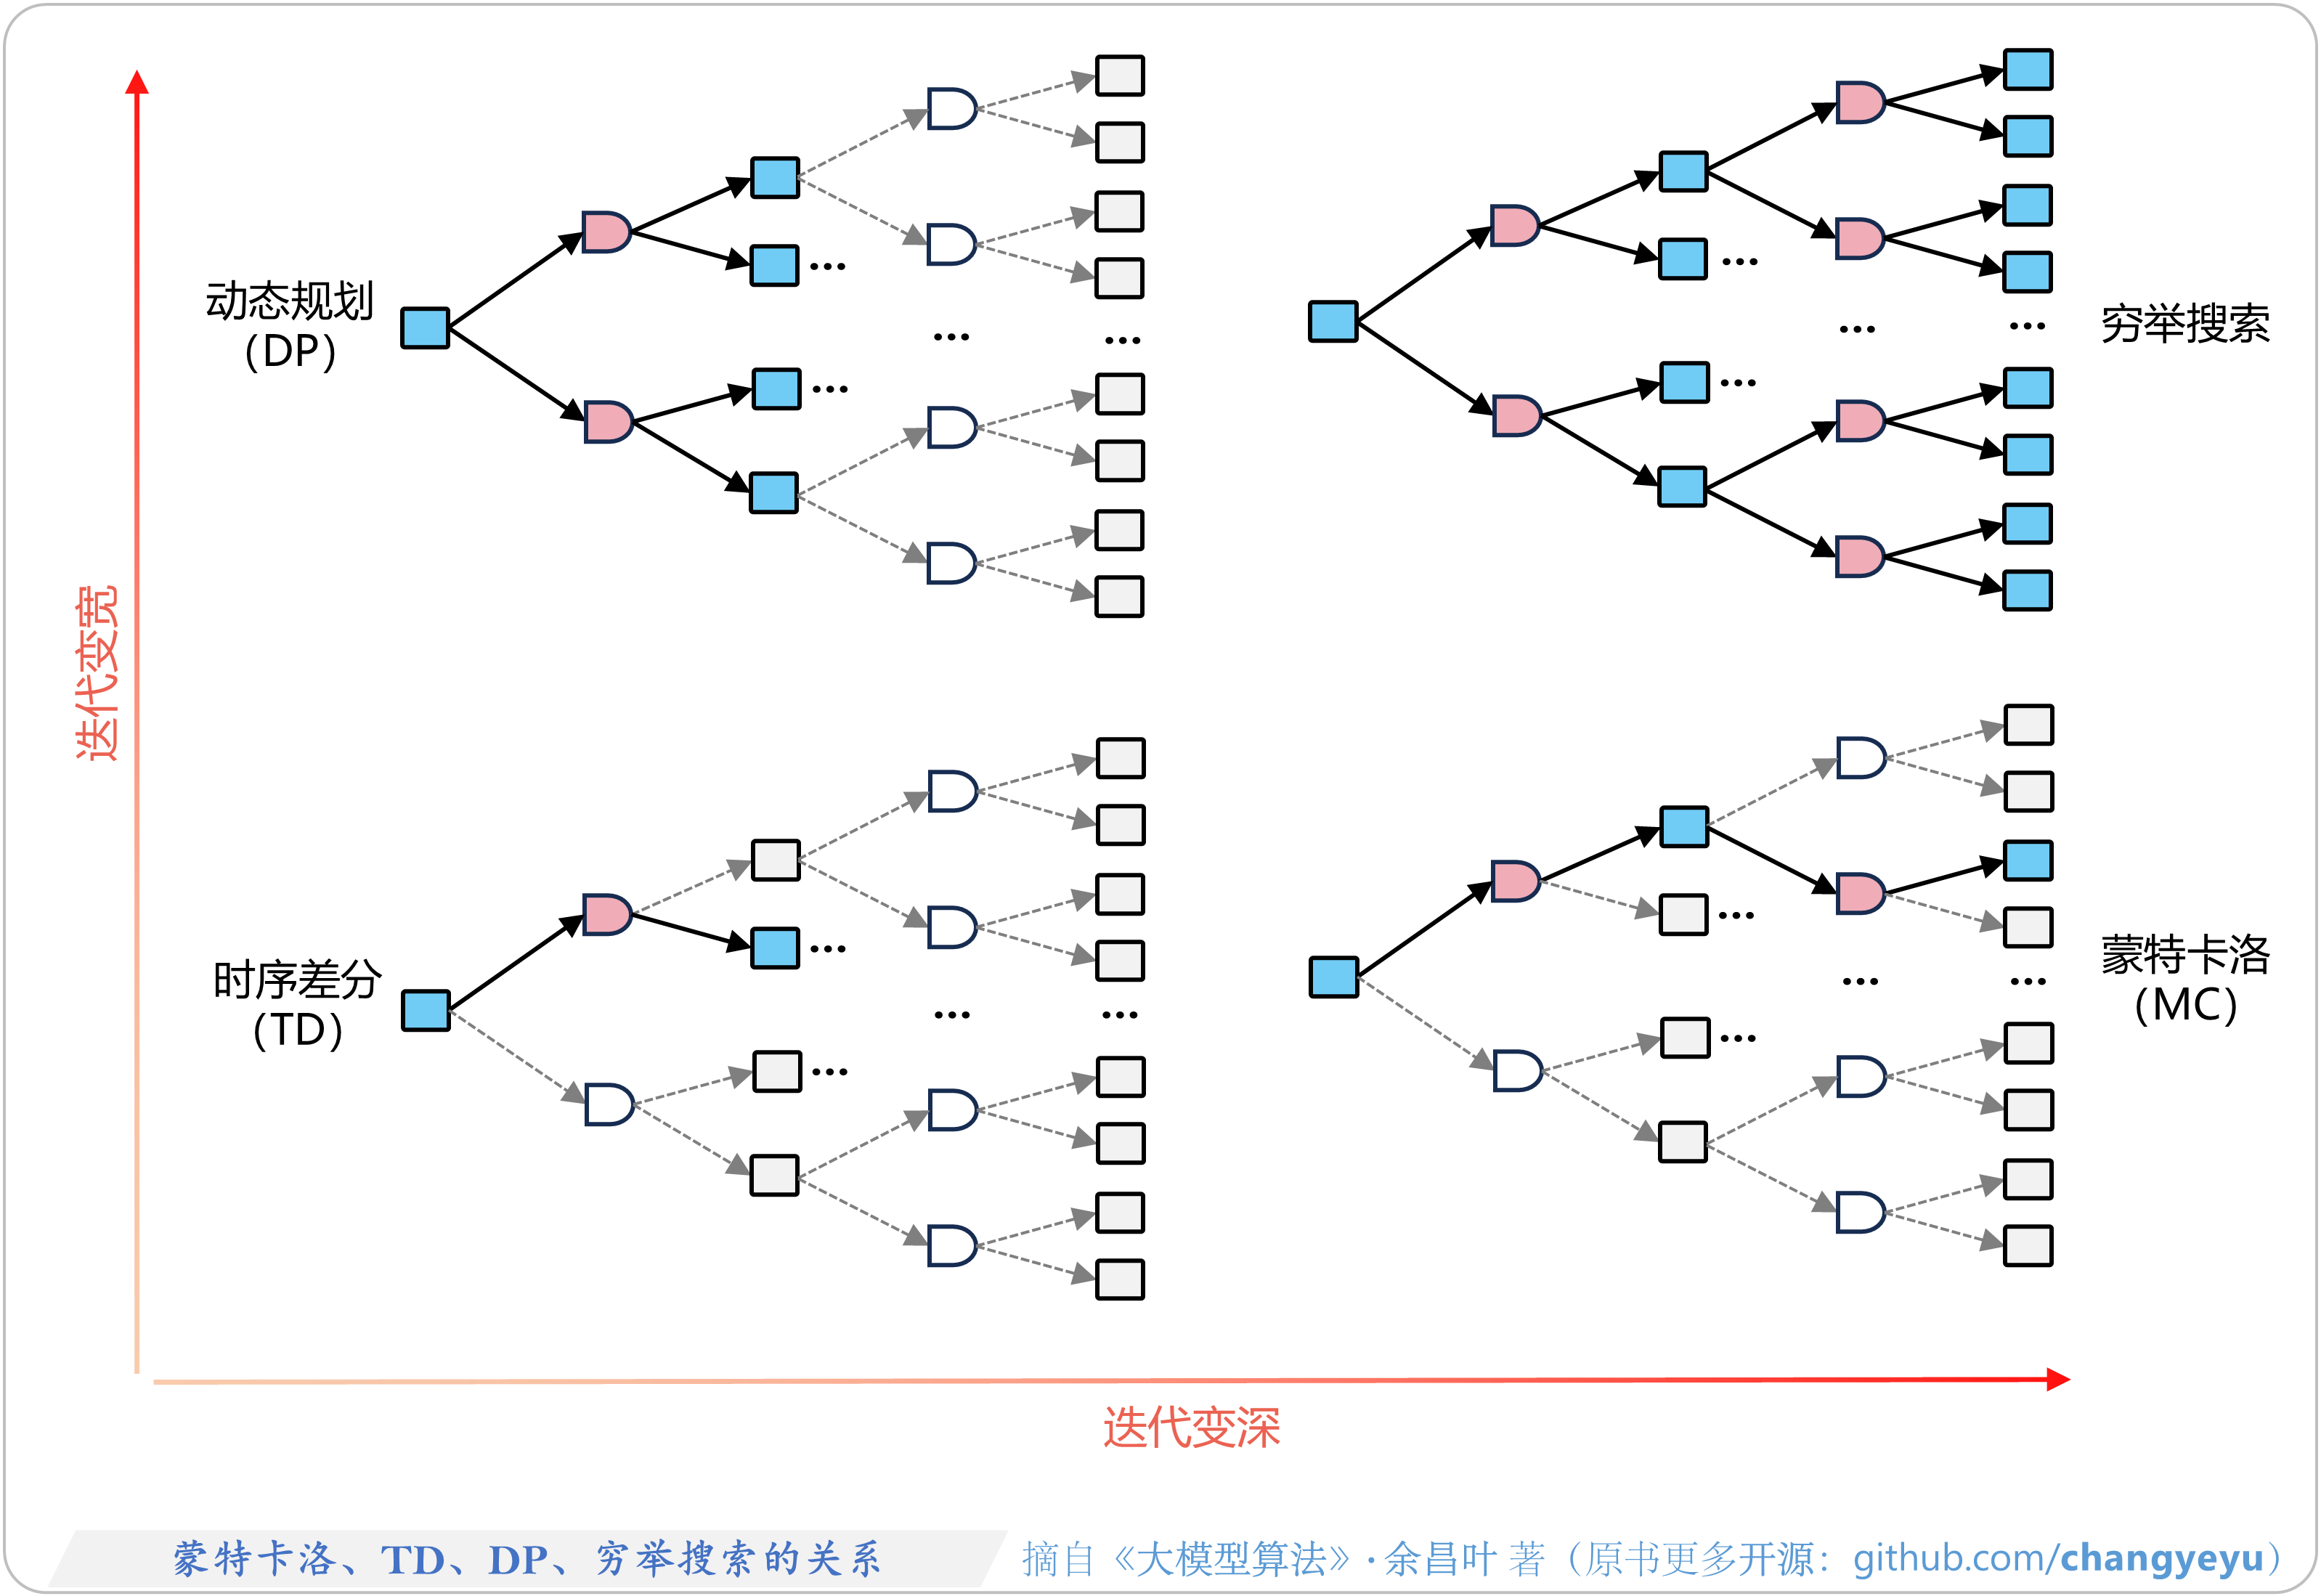
【强化学习基础】蒙特卡洛、TD、DP、穷举搜索的关系 [32]
- 在强化学习中,有四类方法可以进行价值估计与策略优化:蒙特卡洛、时序差分(Temporal Difference, TD)、动态规划(Dynamic Programming, DP)以及穷举搜索(Brute-Force Search)。
- 从深度搜索和广度搜索的视角看,它们的区别如图。

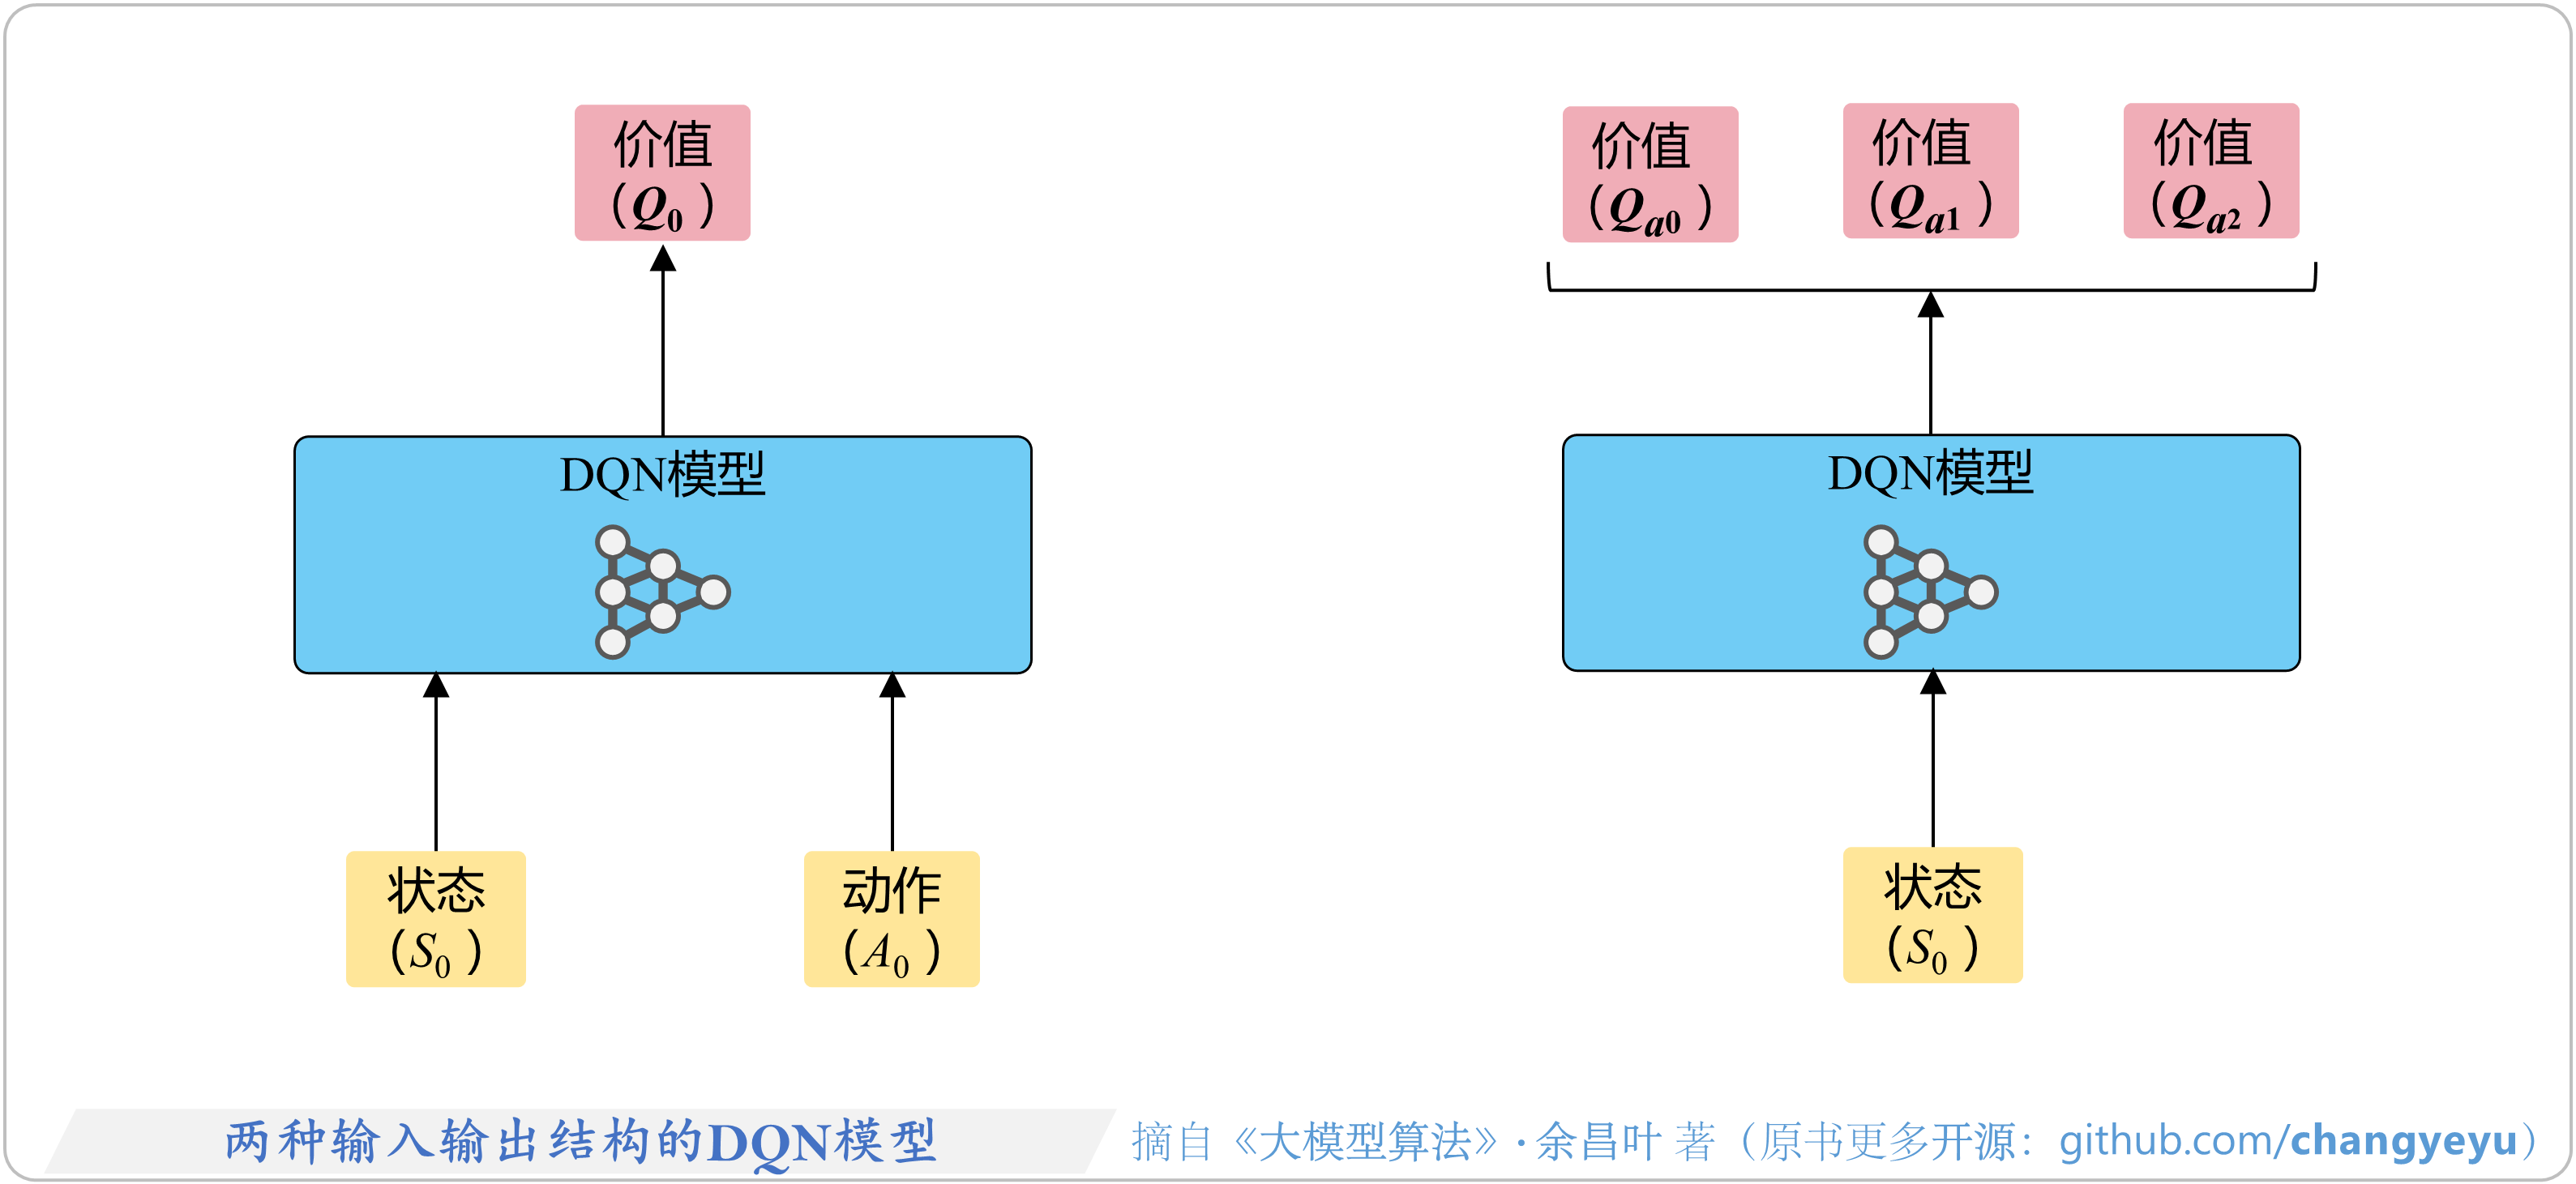
【强化学习基础】两种输入输出结构的DQN(Deep Q-Network)模型
DQN模型的输入输出结构有两种类型:
- (1)输入为当前状态(S0)和候选执行的动作(A0),输出为对应的价值Q0(未来回报的预估)。在实际应用中,也可以批量计算多个动作的价值Q。
- (2)输入为当前状态(S0),输出为动作空间中所有动作对应的价值Q。在实际应用中,通常选择具有最大价值的动作执行。
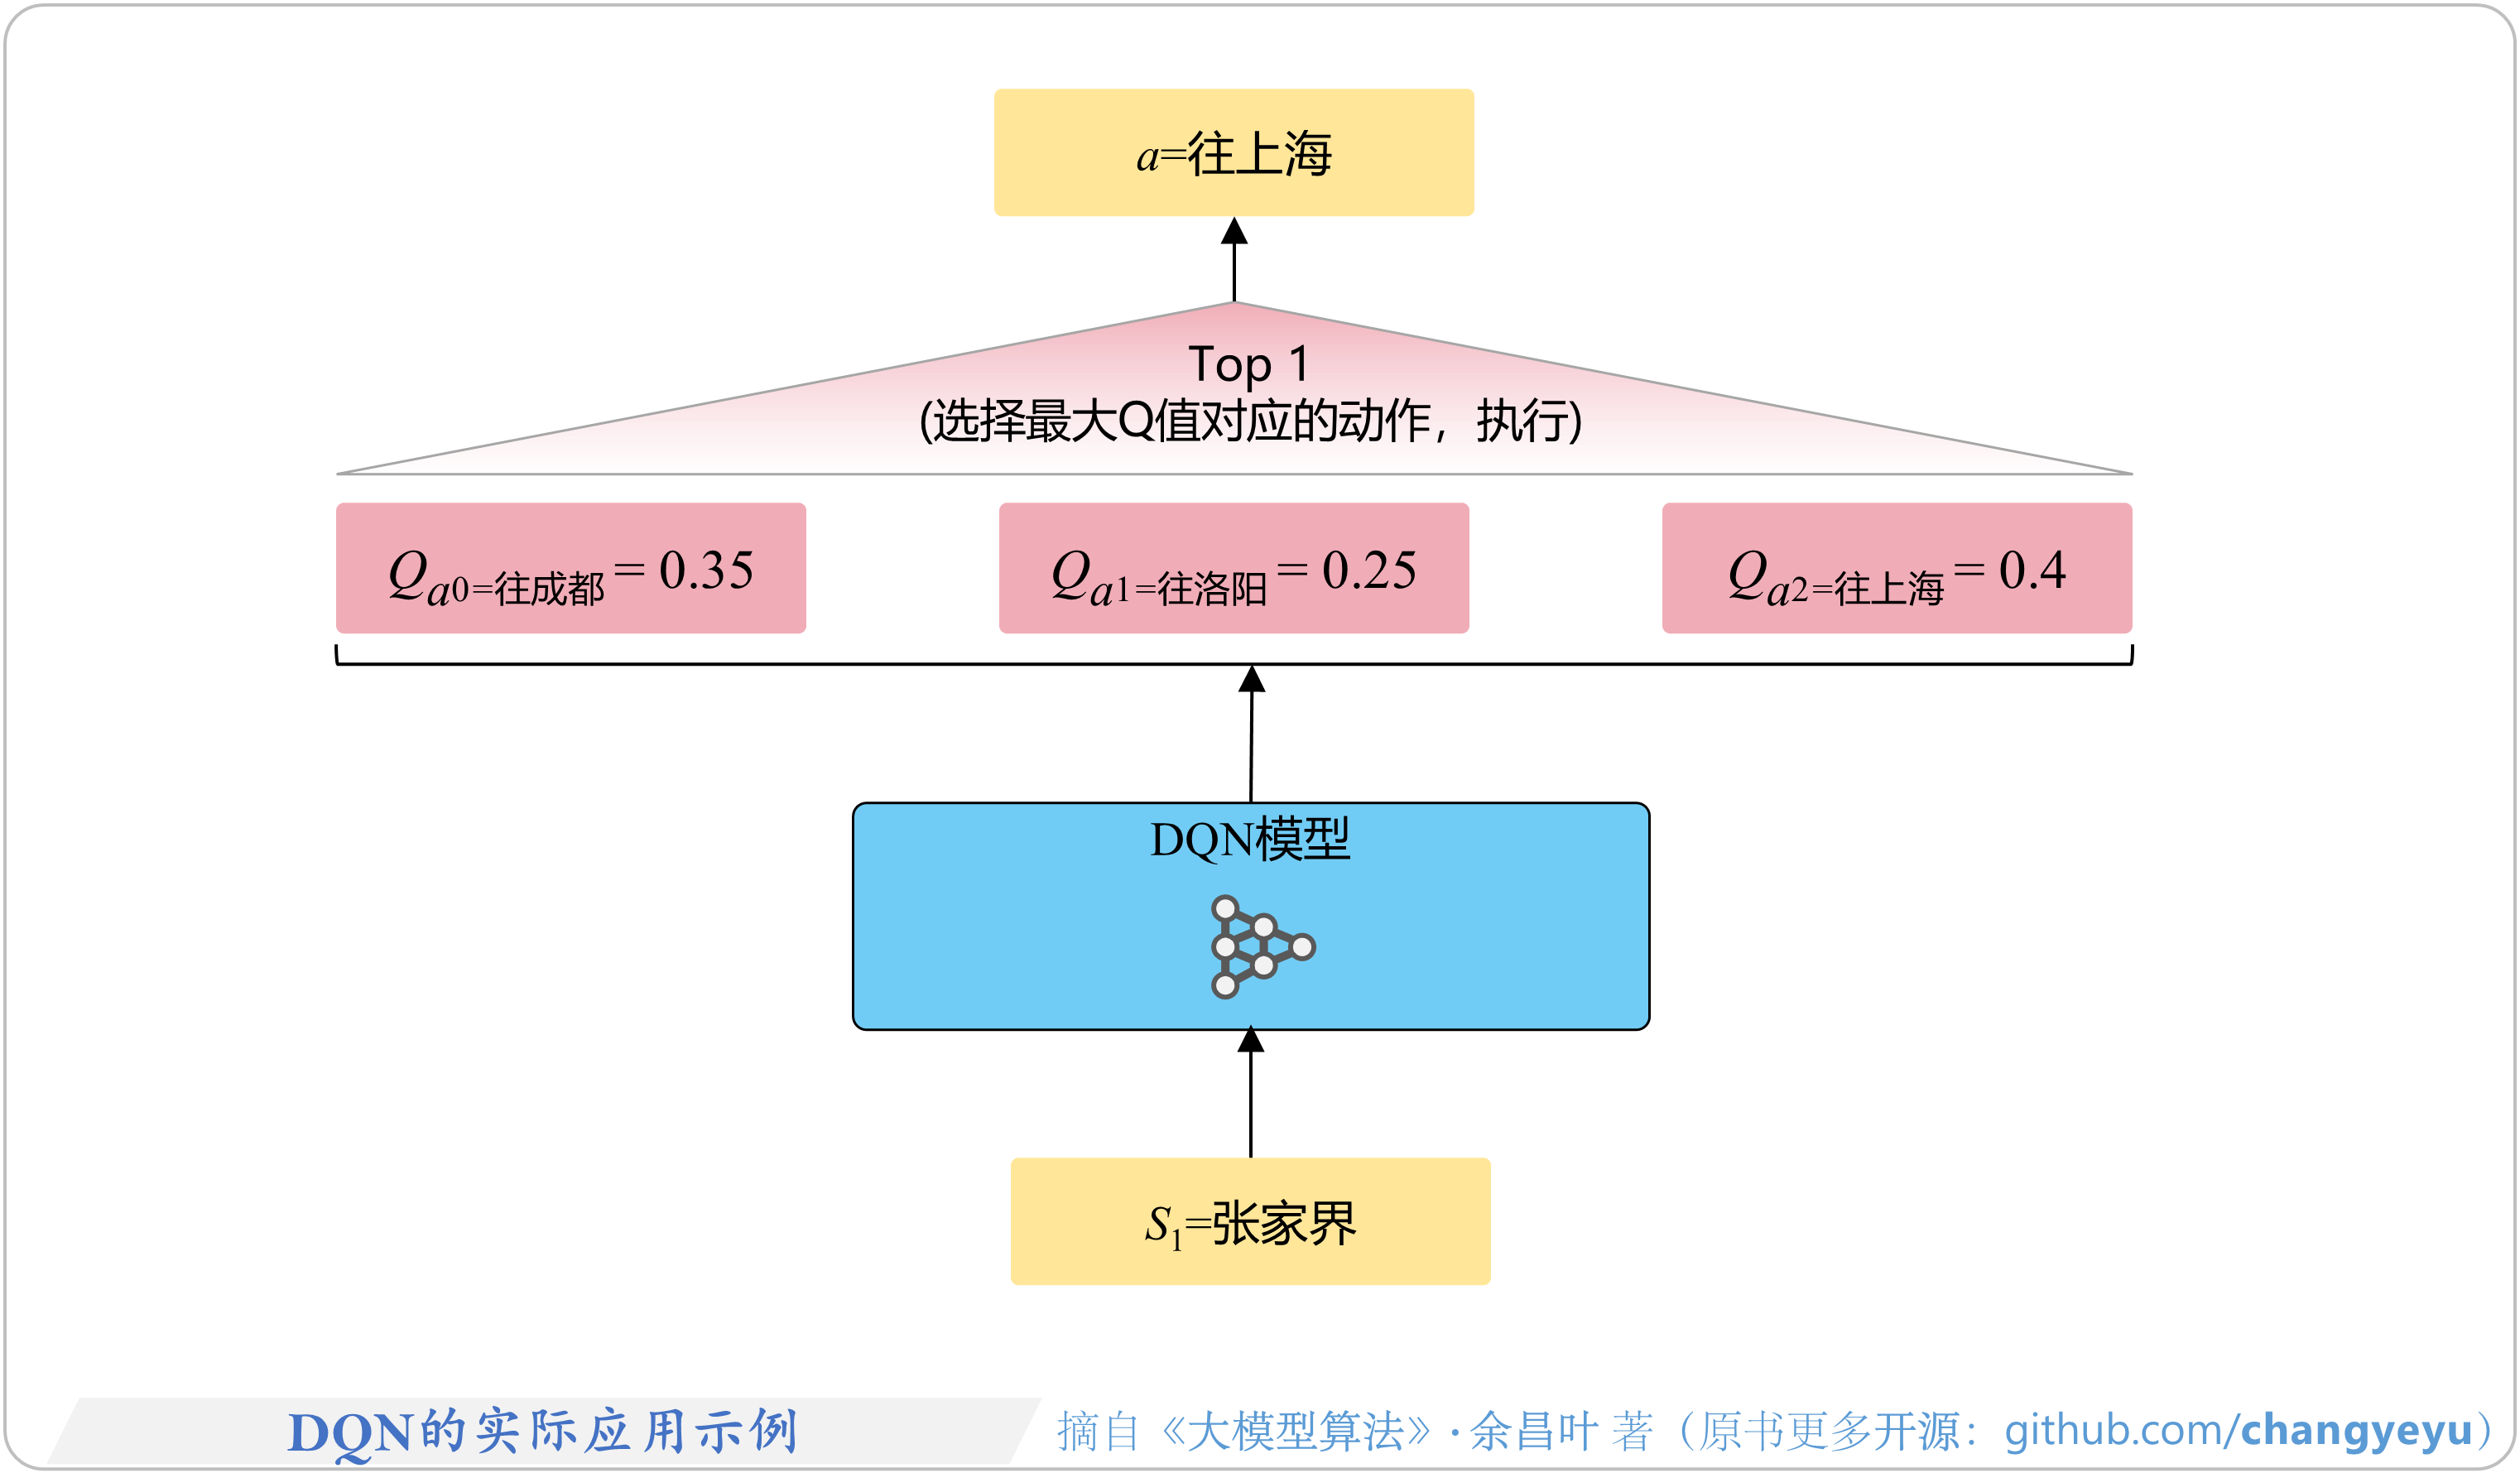
【强化学习基础】DQN的实际应用示例
- 训练完成后,DQN模型可部署到线上环境,帮助进行实际决策。
- 在推理时,如图所示,根据输出的价值Q选择最优动作执行。由于DQN是基于价值的强化学习算法,输出的值仅为价值Q,需要进一步转换为实际执行的动作A。常见的方法是从所有价值Q中选取最大值对应的动作,并作为最优动作执行。

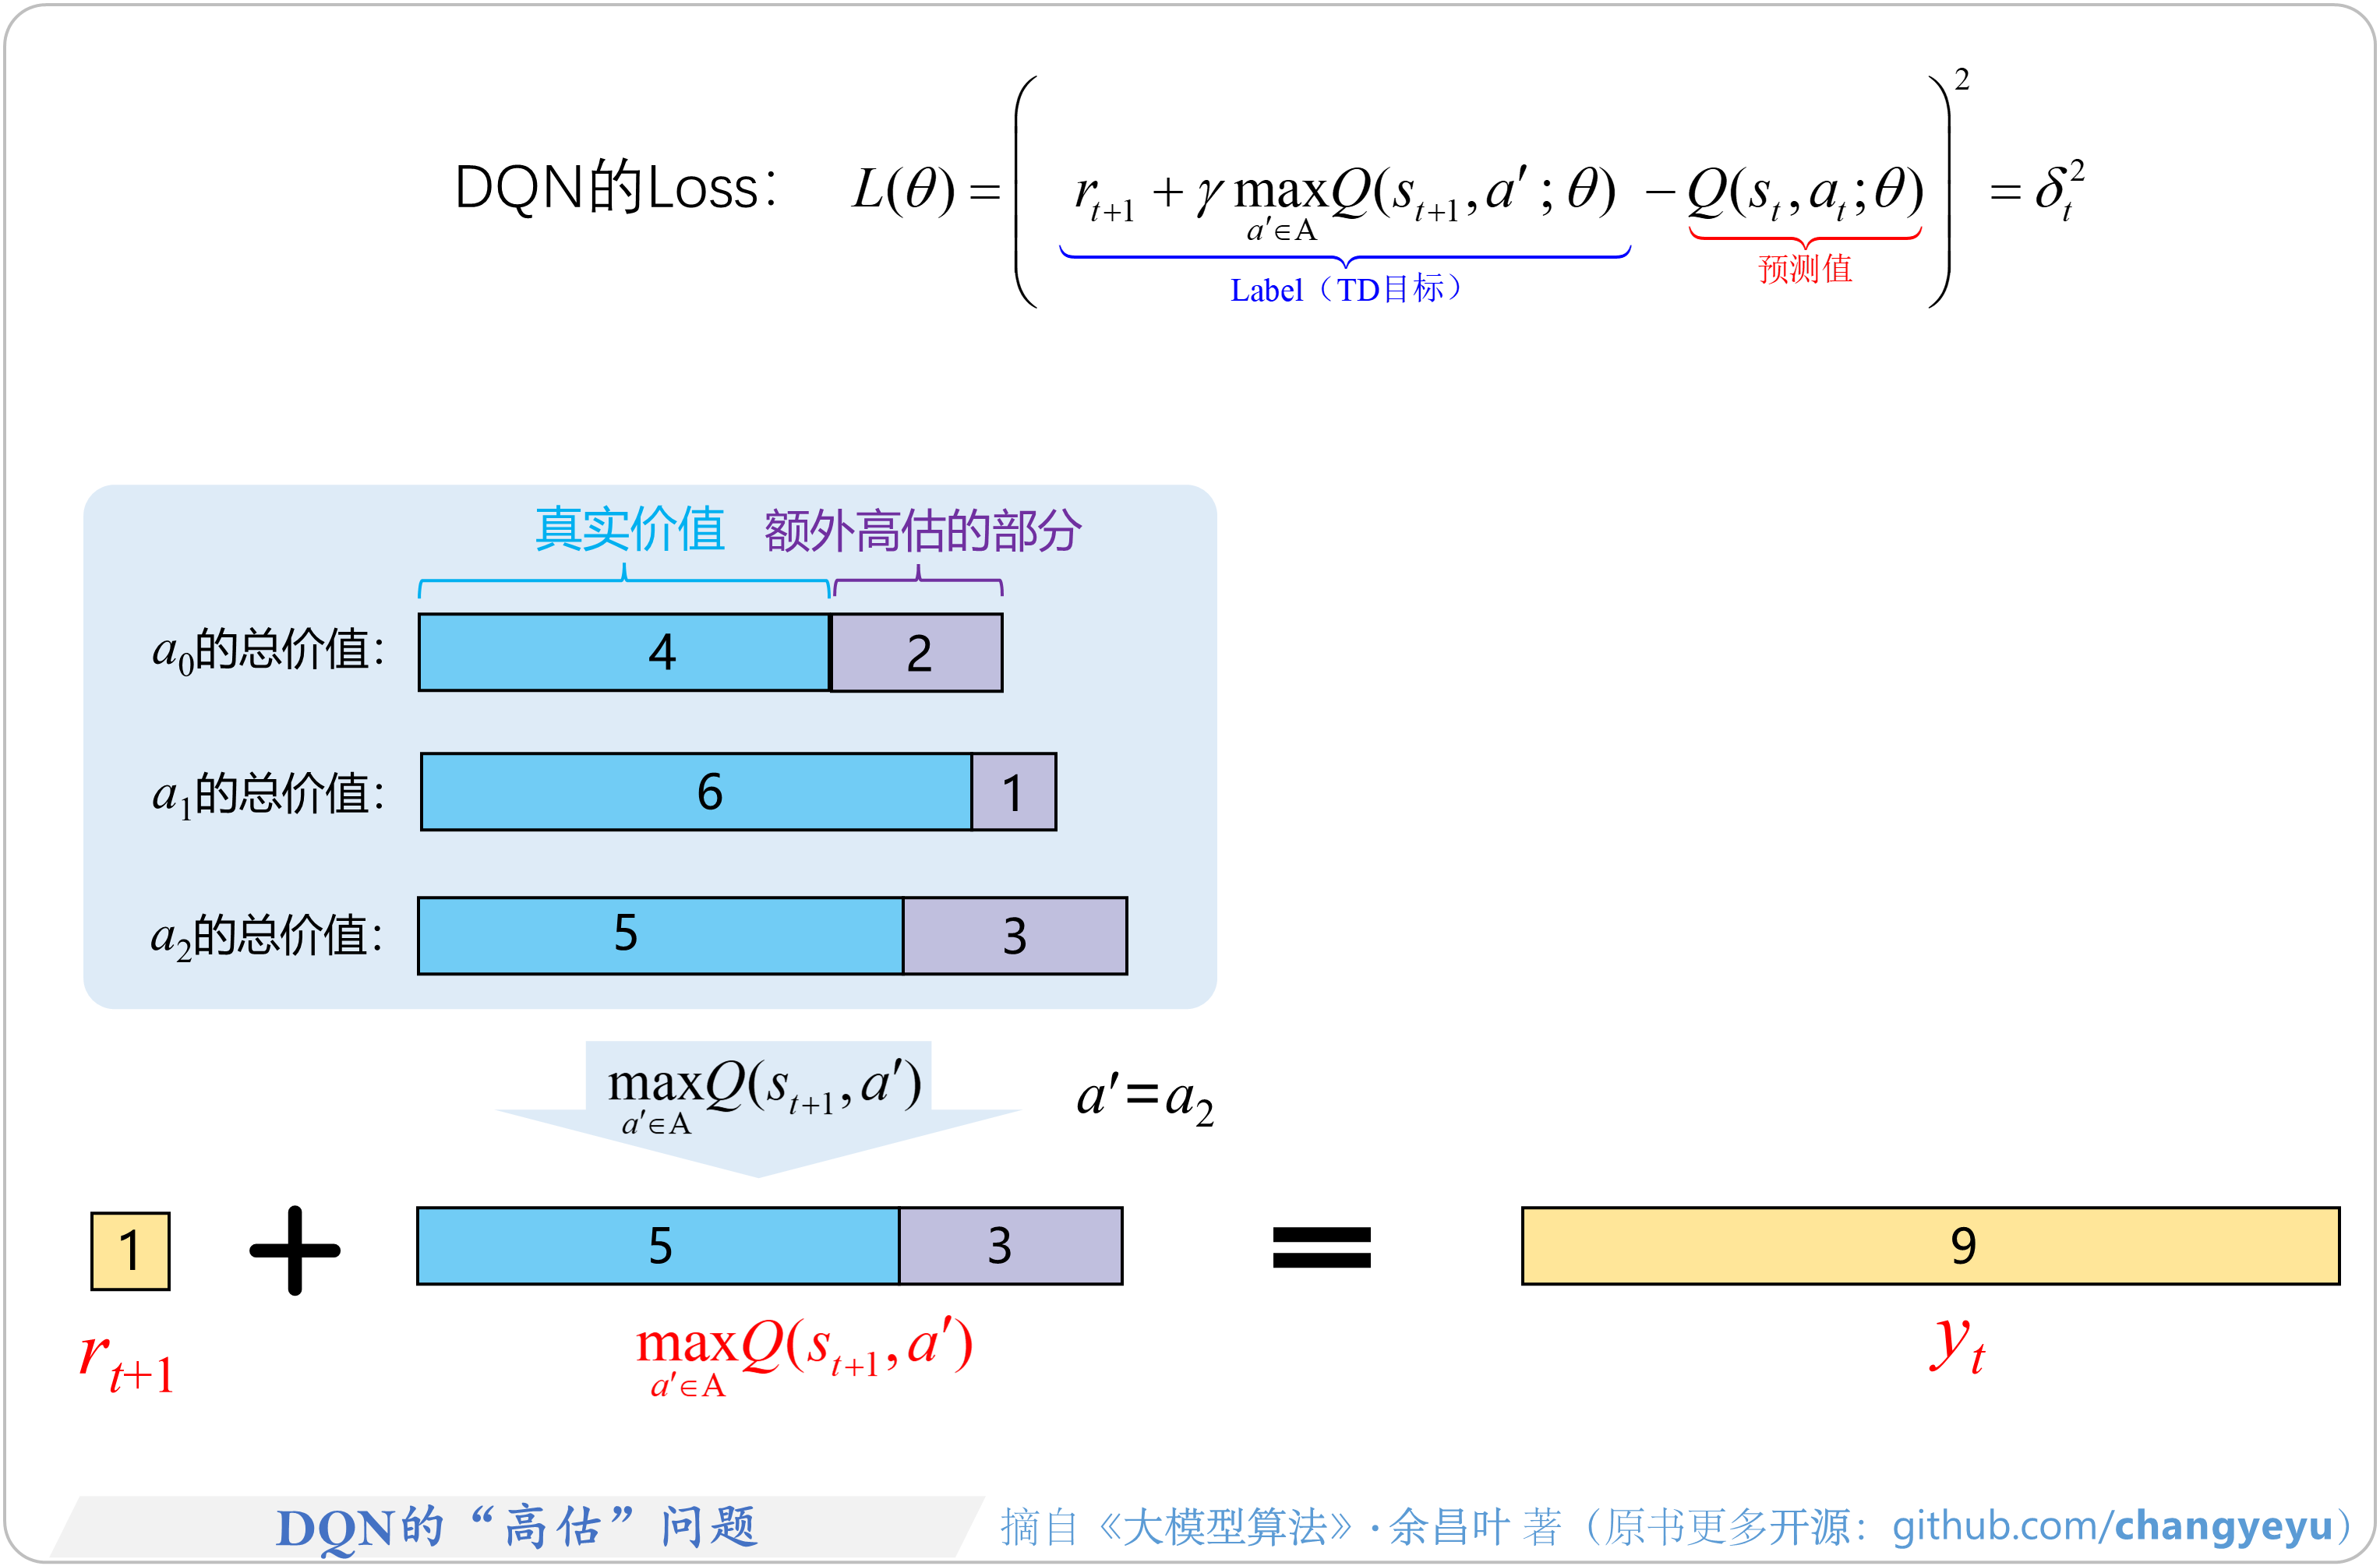
【强化学习基础】DQN的“高估”问题
- DQN算法的两大核心问题:(1)“高估”问题; (2)“狗追尾巴”问题。
- (1)高估问题:DQN在选择和评估动作时,动作价值Q常被过高估计,导致策略优化出现偏差,影响最终性能。这主要由于最大化操作中包含了高估部分的值,如图所示,最终目标价值yt中包含了额外高估的部分,并且这种高估会逐步累积。此外,这种高估是“非均匀”的,即不同动作的价值Q被高估的程度各不相同。
- (2)狗追尾巴问题:也称为自举问题,如式所示,DQN的训练过程可以看做一个“回归问题”,但是回归(要拟合)的目标yt总是在变,所以提升了训练的难度。在DQN中,计算目标价值 和当前状态st的价值预测值 使用相同的网络权重θ。由于回归的目标yt依赖于当前网络的权重θ,当网络权重更新后变为θ′;下一步训练时,计算出的价值预测值和回归的目标yt值将同步变化。这种动态相互依赖关系就像“狗追尾巴”一样,不断循环,导致优化过程容易不稳定,甚至难以收敛。

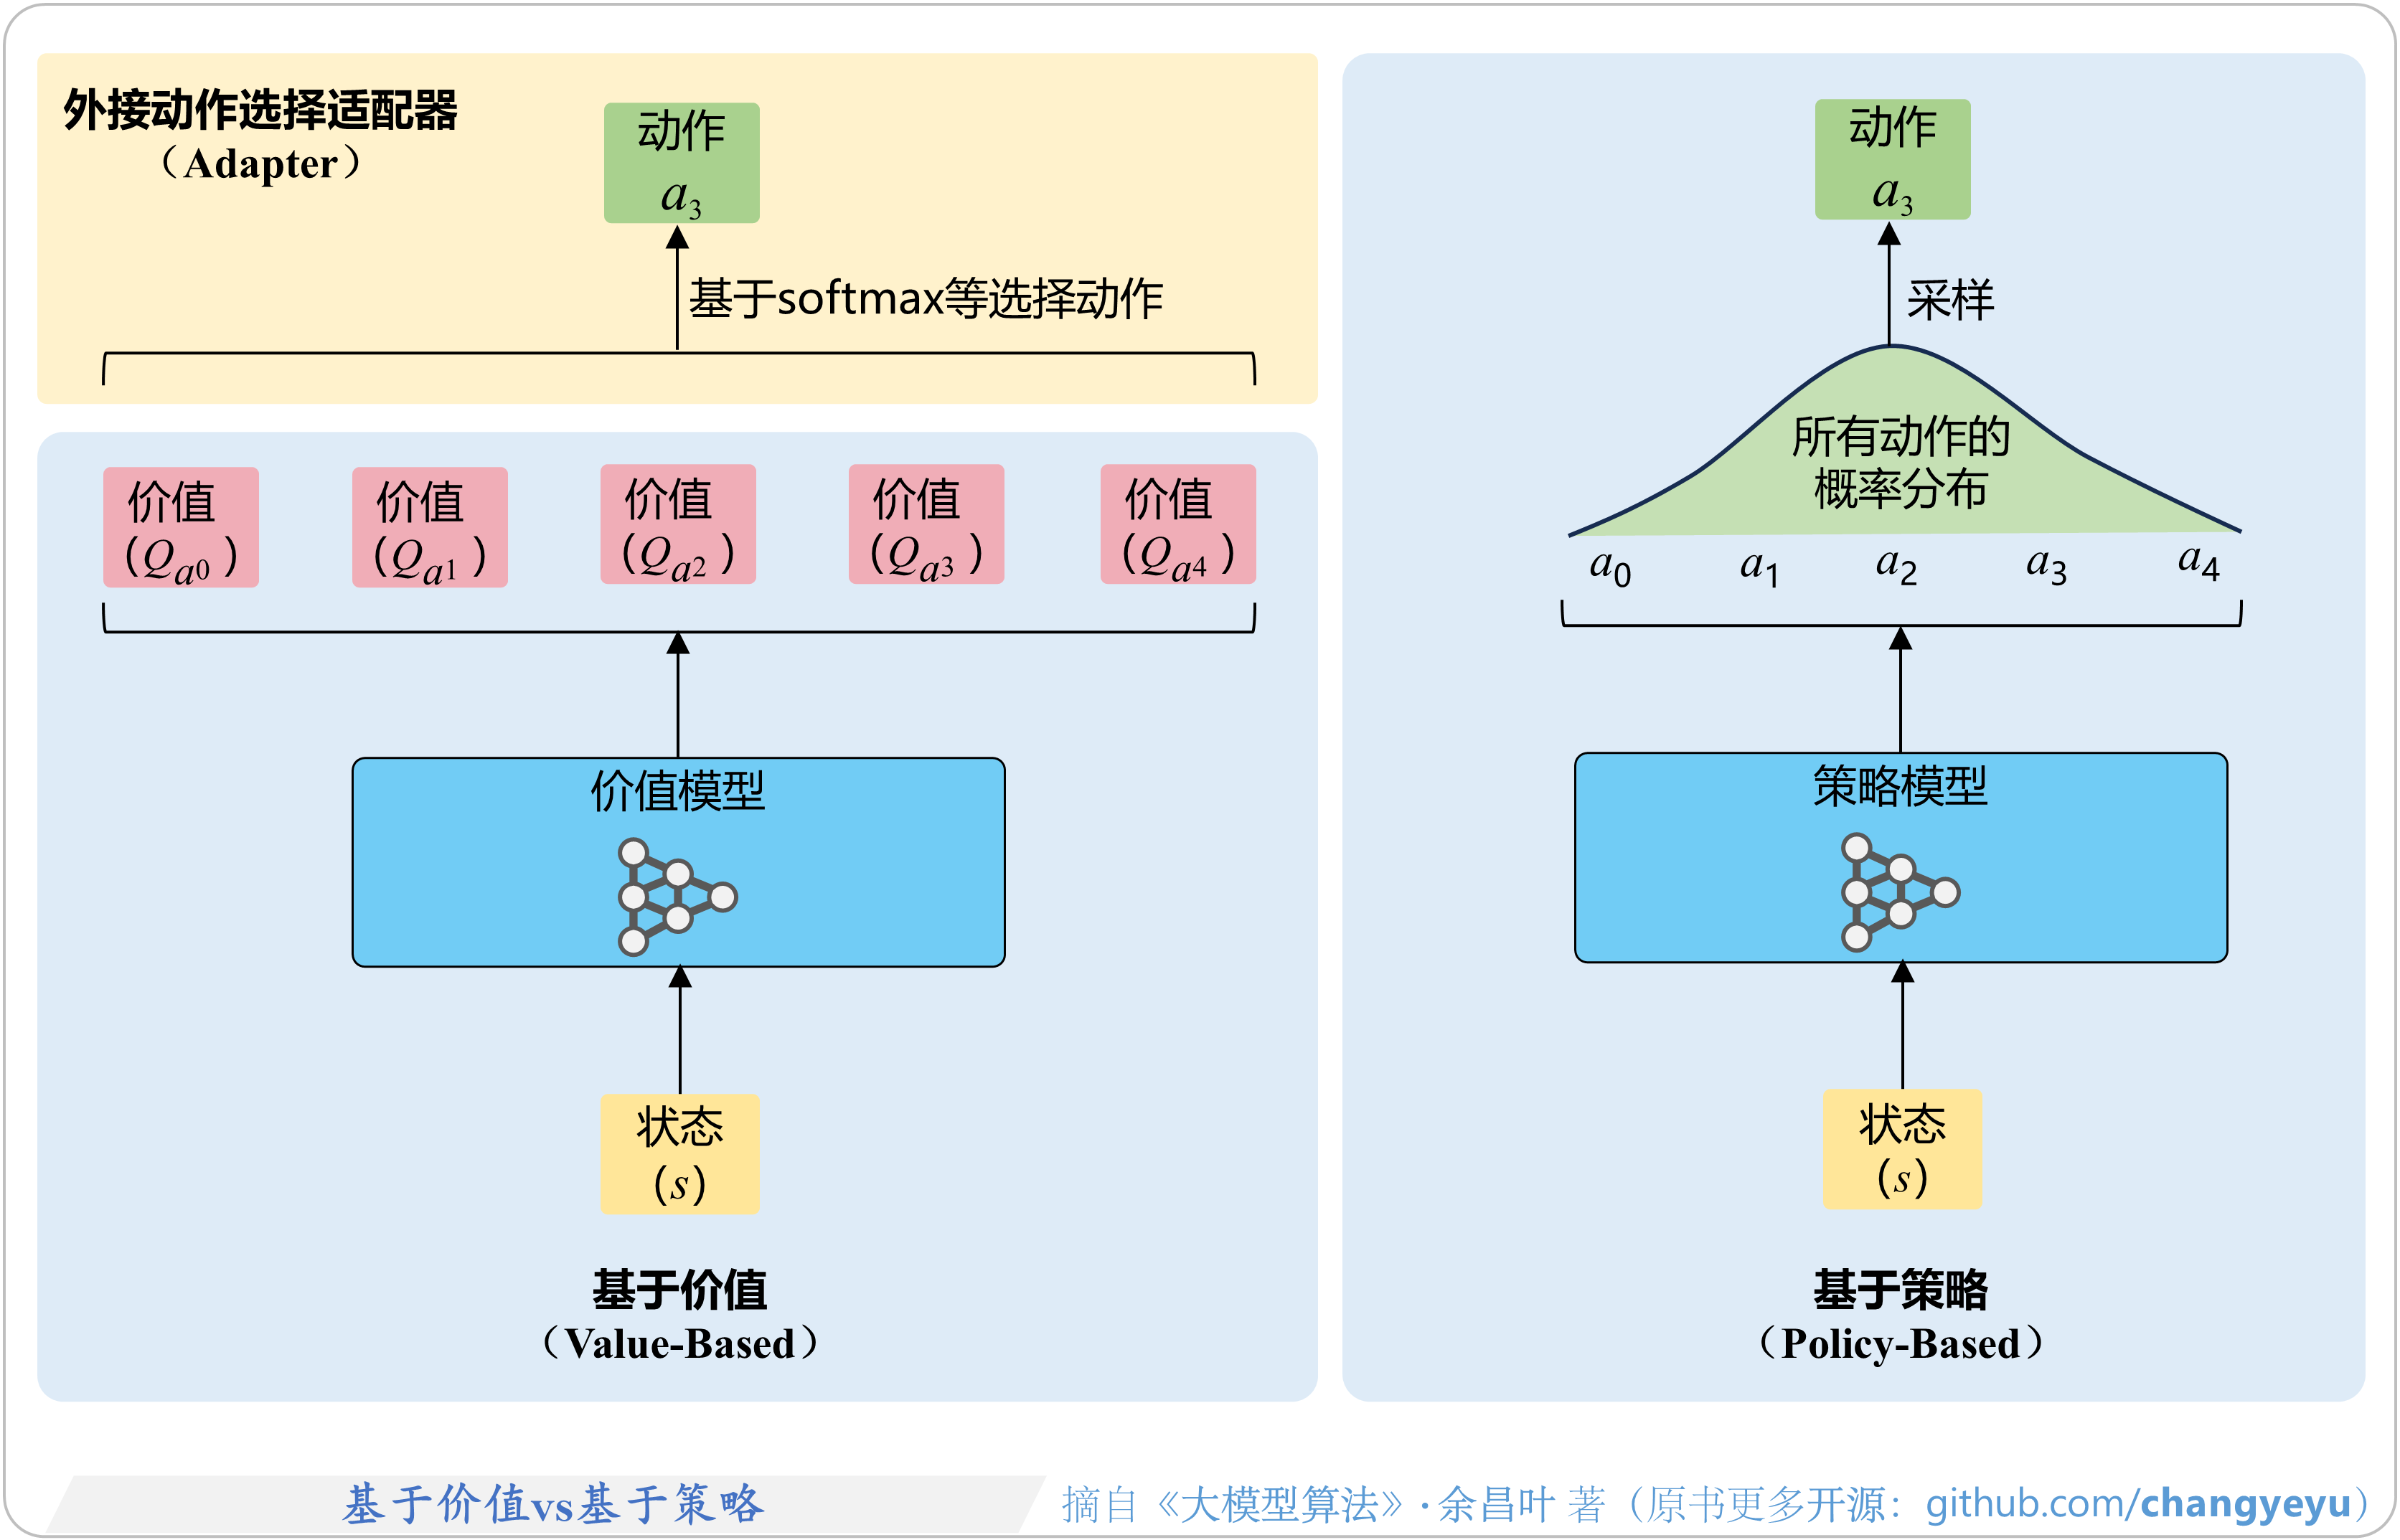
【强化学习基础】基于价值vs基于策略(Value-Based vs Policy-Based)
- 根据学习对象的不同:分为基于价值(Value-Based)、基于策略(Policy-Based)以及演员-评委(Actor-Critic)方法。
- 基于价值的算法通过估计各状态的价值函数(例如V或Q)来间接推导出最优策略;
- 基于策略的算法直接学习和优化策略函数π;
- 演员-评委方法则同时结合了基于价值和基于策略的特点。

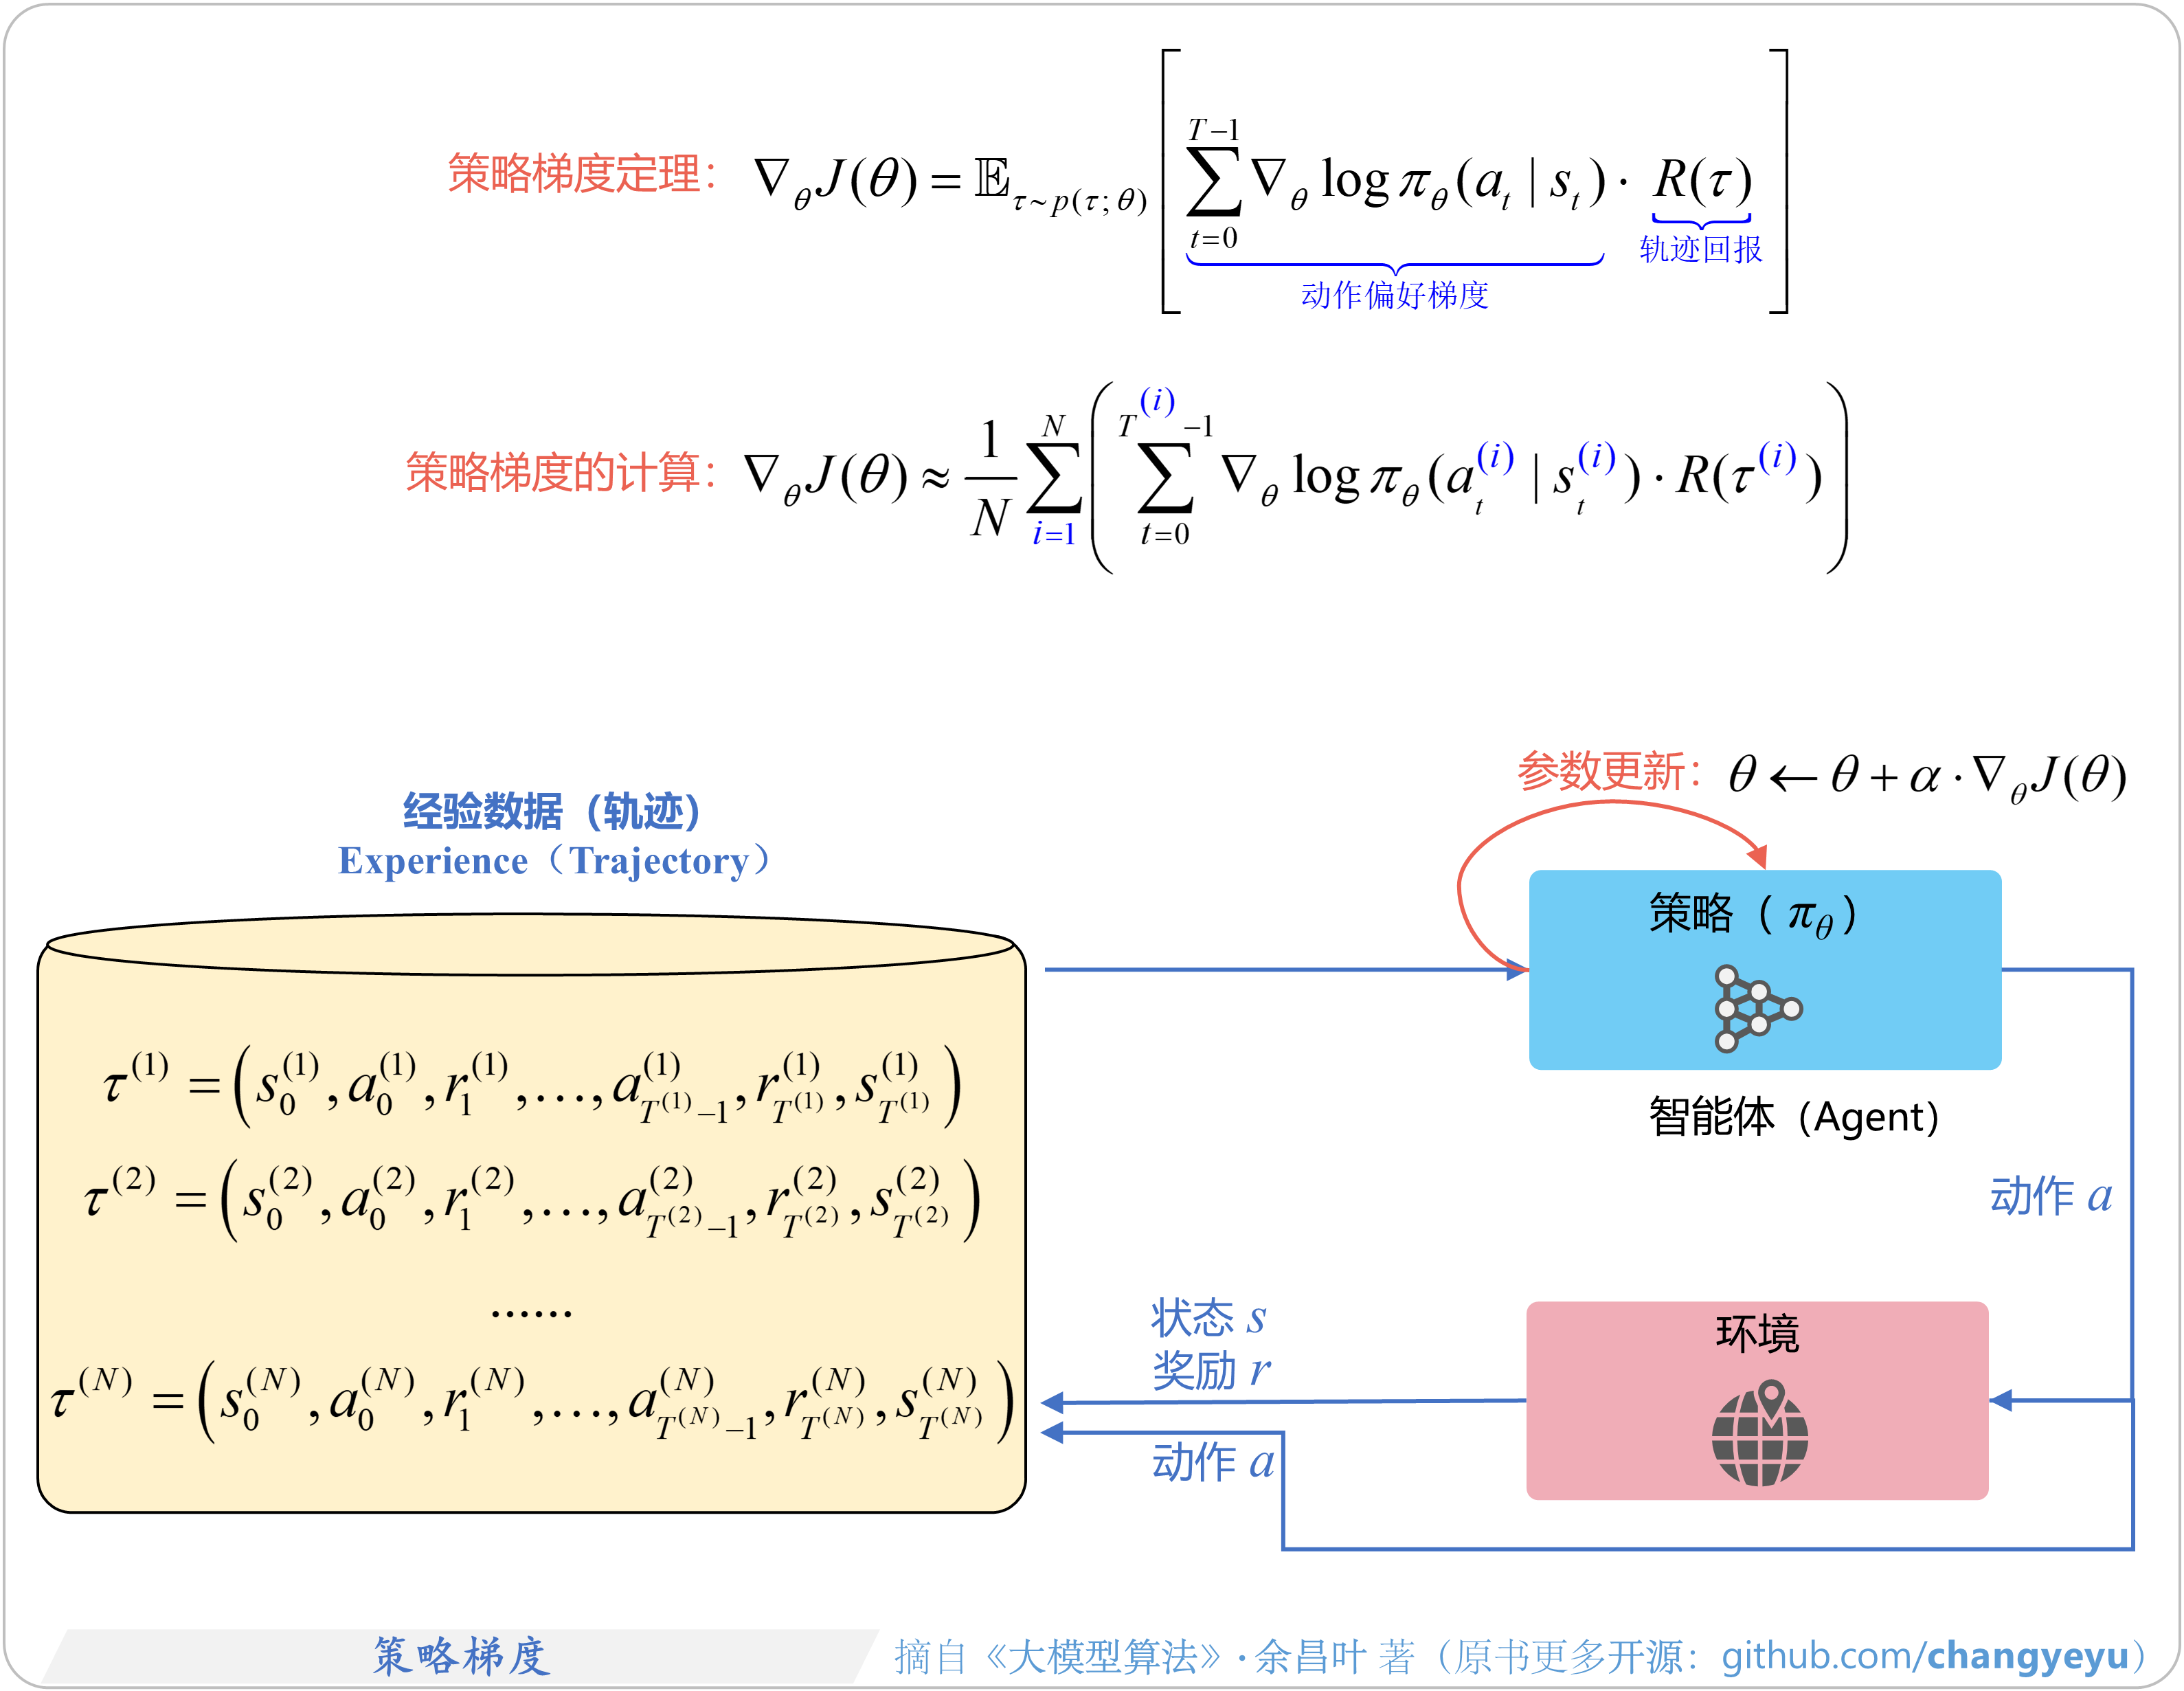
【强化学习基础】策略梯度(Policy Gradient)
- 策略梯度是强化学习众多算法的理论基石。例如,PPO算法、GRPO算法、DPG算法以及基于Actor-Critic架构的众多算法都建立于策略梯度之上。
- RL之父 Richard S. Sutton等人则在前人基础上进一步提出了更为严谨且系统化的策略梯度定理(Policy Gradient Theorem)。
- 与基于价值(Value-Based)的方法(例如DQN等)不同,通过直接优化策略以最大化回报(累积奖励),直接对策略函数进行参数化,并通过梯度上升或下降的方式优化策略参数。

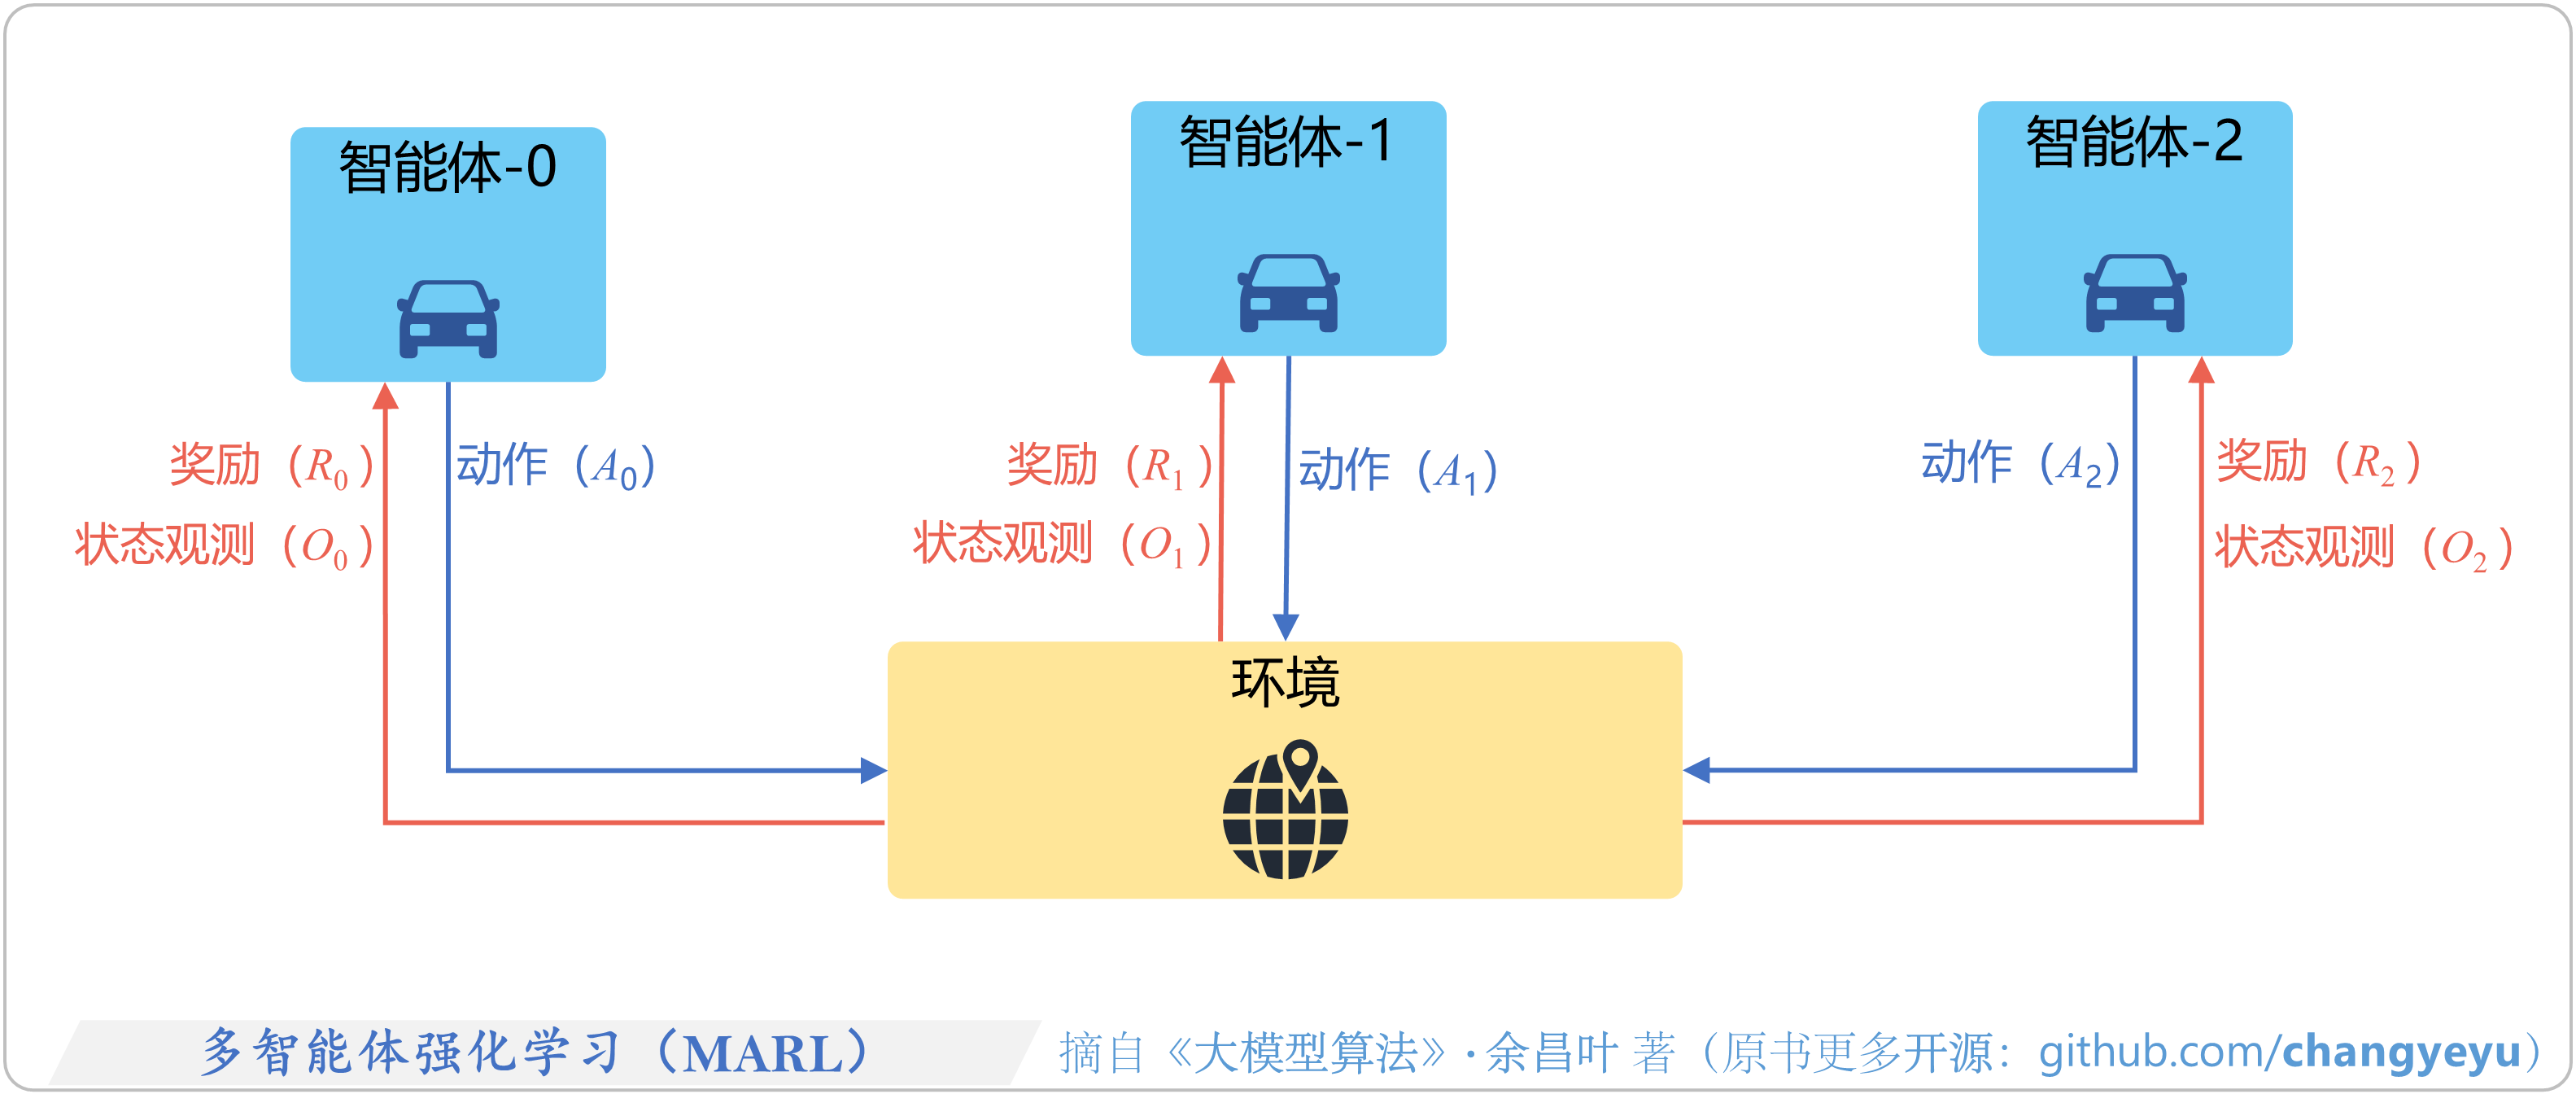
【强化学习基础】多智能体强化学习(MARL,Multi-agent reinforcement learning)
- 多智能体强化学习(Multi-Agent Reinforcement Learning,MARL)是强化学习的一个重要分支,旨在研究多个智能体在共享环境中通过交互(包括竞争与合作)学习最优策略的问题。
- 例如,DeepMind的研究团队开发的AlphaGo、AlphaZero和AlphaStar等,OpenAI开发的OpenAI Five,展示了多智能体强化学习的强大潜力。

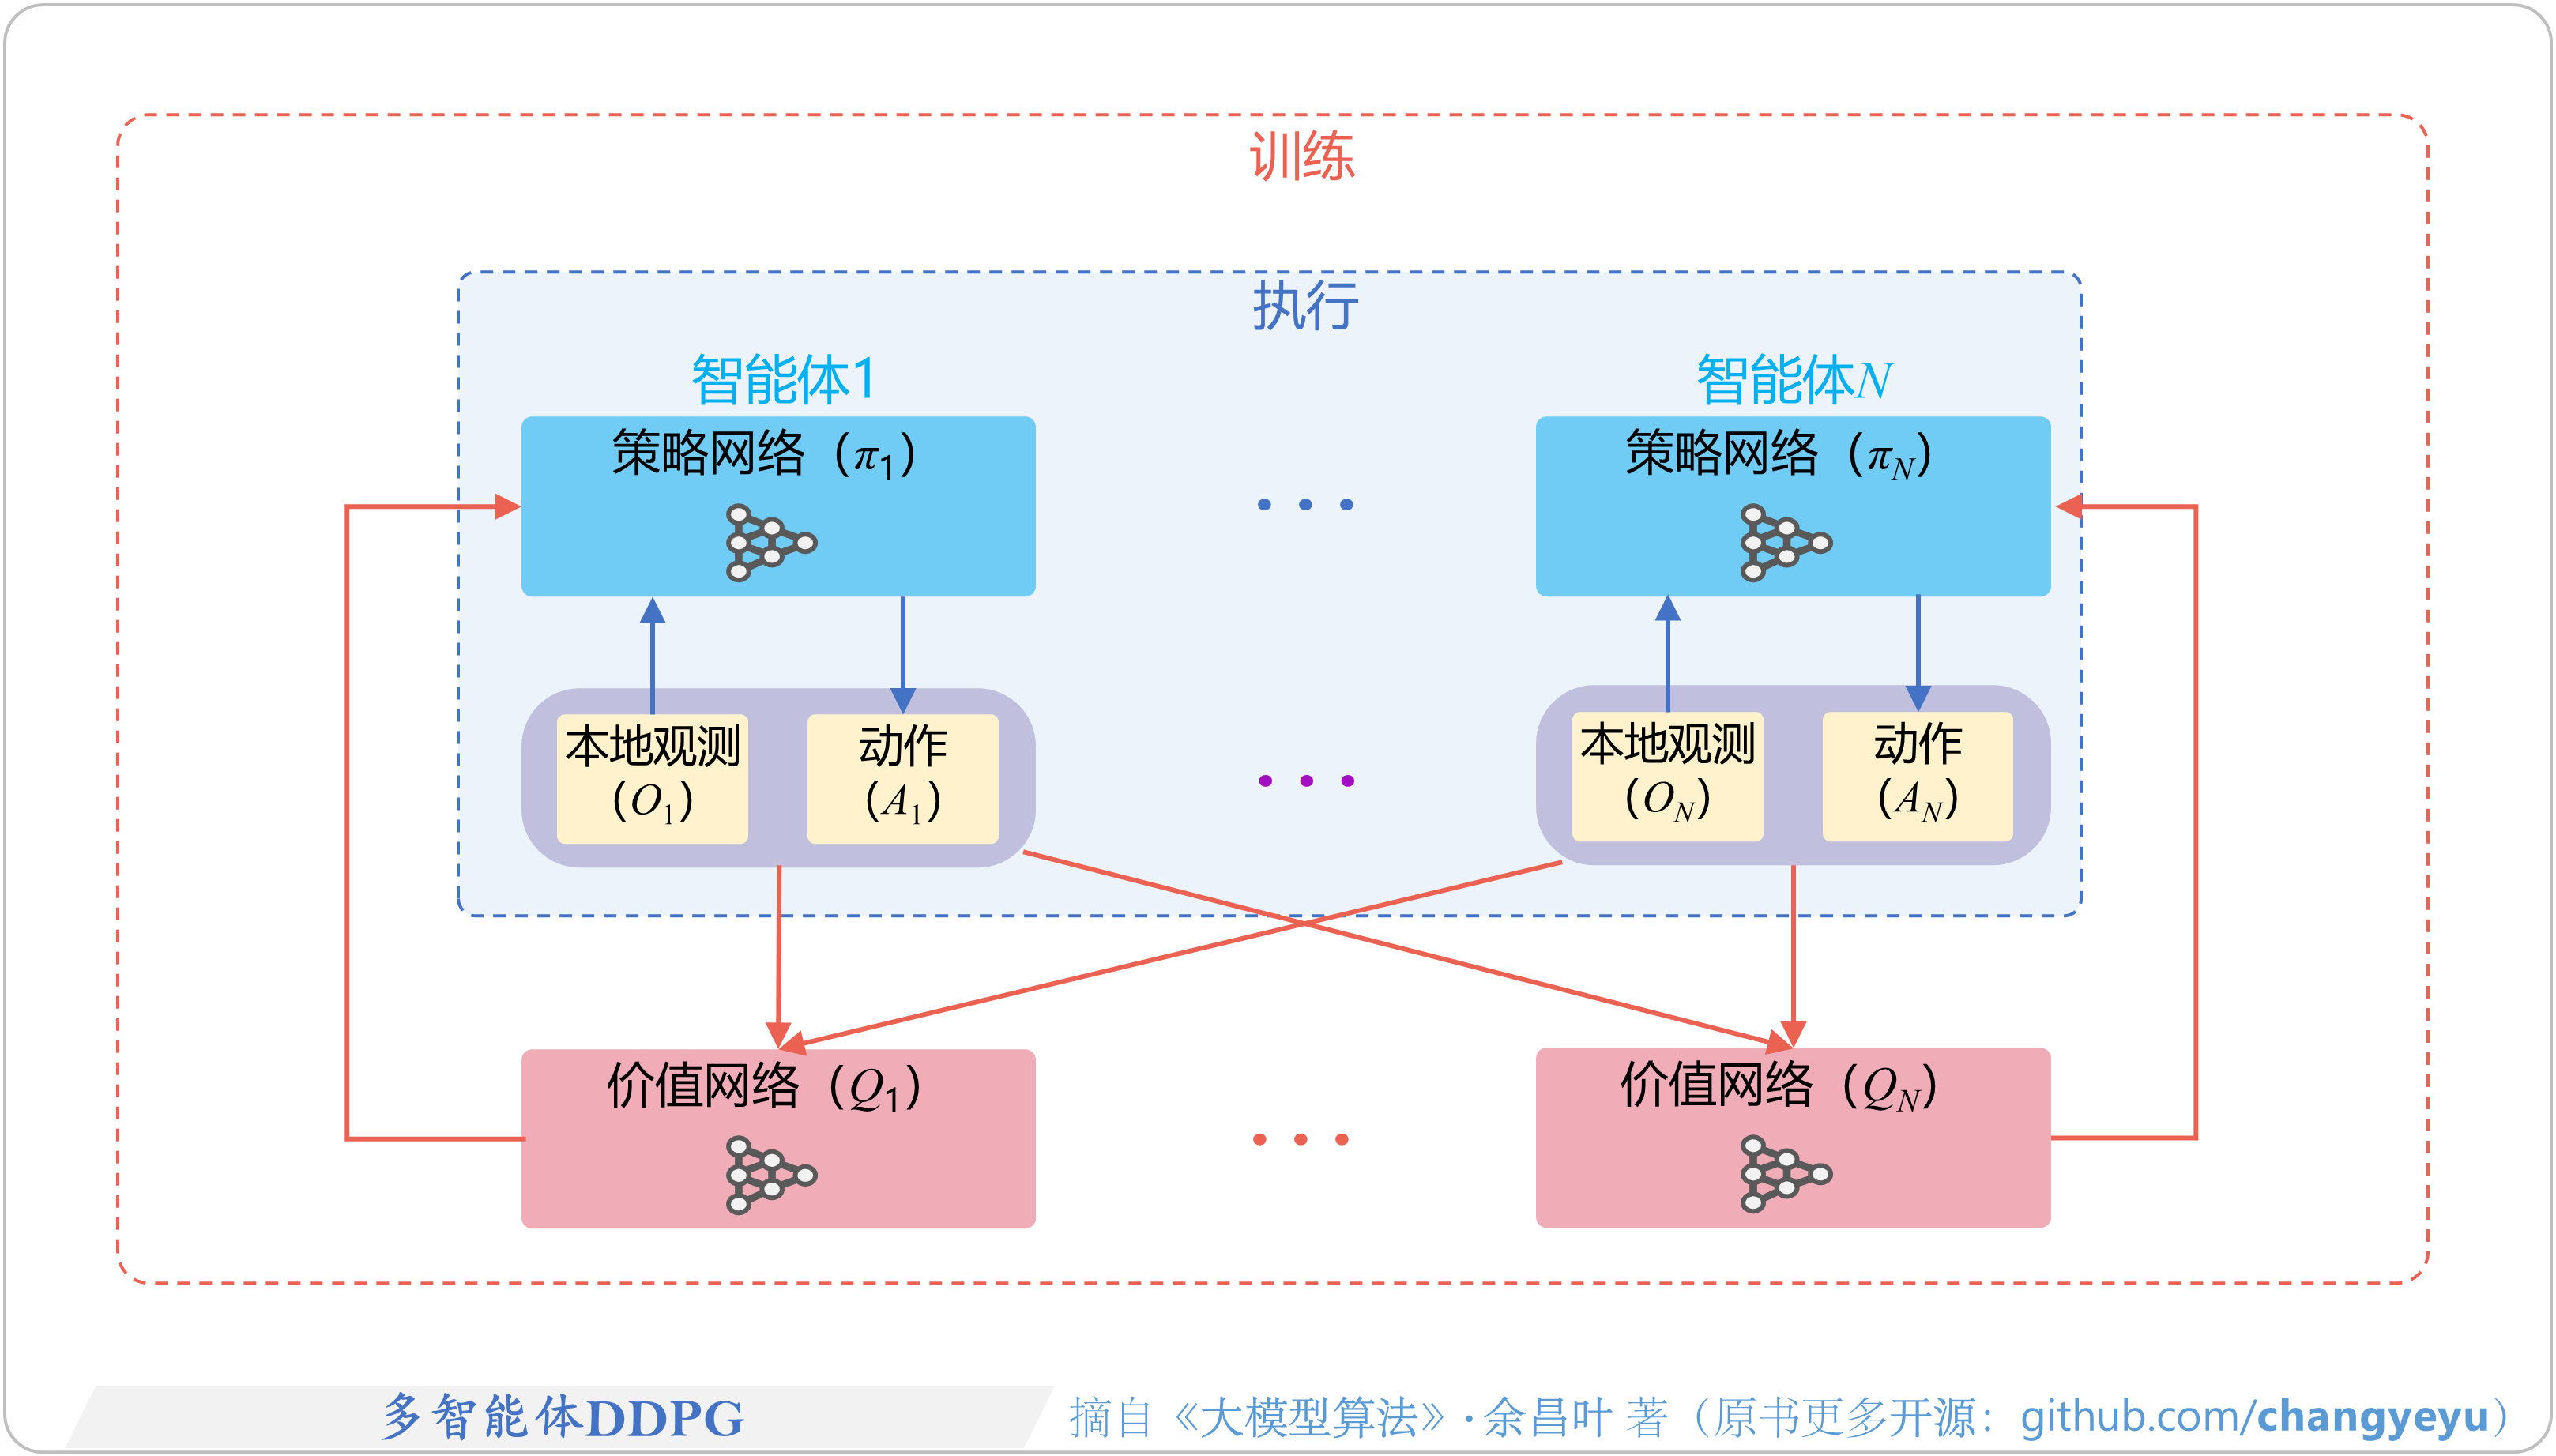
【强化学习基础】多智能体DDPG [41]
- MADDPG(Multi-Agent DDPG)由OpenAI等研究团队于2017年发表。
- 如图所示,描述了一个具有N个智能体的环境,包含N个策略网络(π1, π2,…, πN)和N个价值网络(Q1, Q2,…, QN),这些网络各自独立地进行学习。
- 价值网络Qi 接收所有智能体的动作(A1, A2,…, A N)和观测信息(O1, O2,…, ON)作为输入,并输出对应于第i个智能体的Q值。

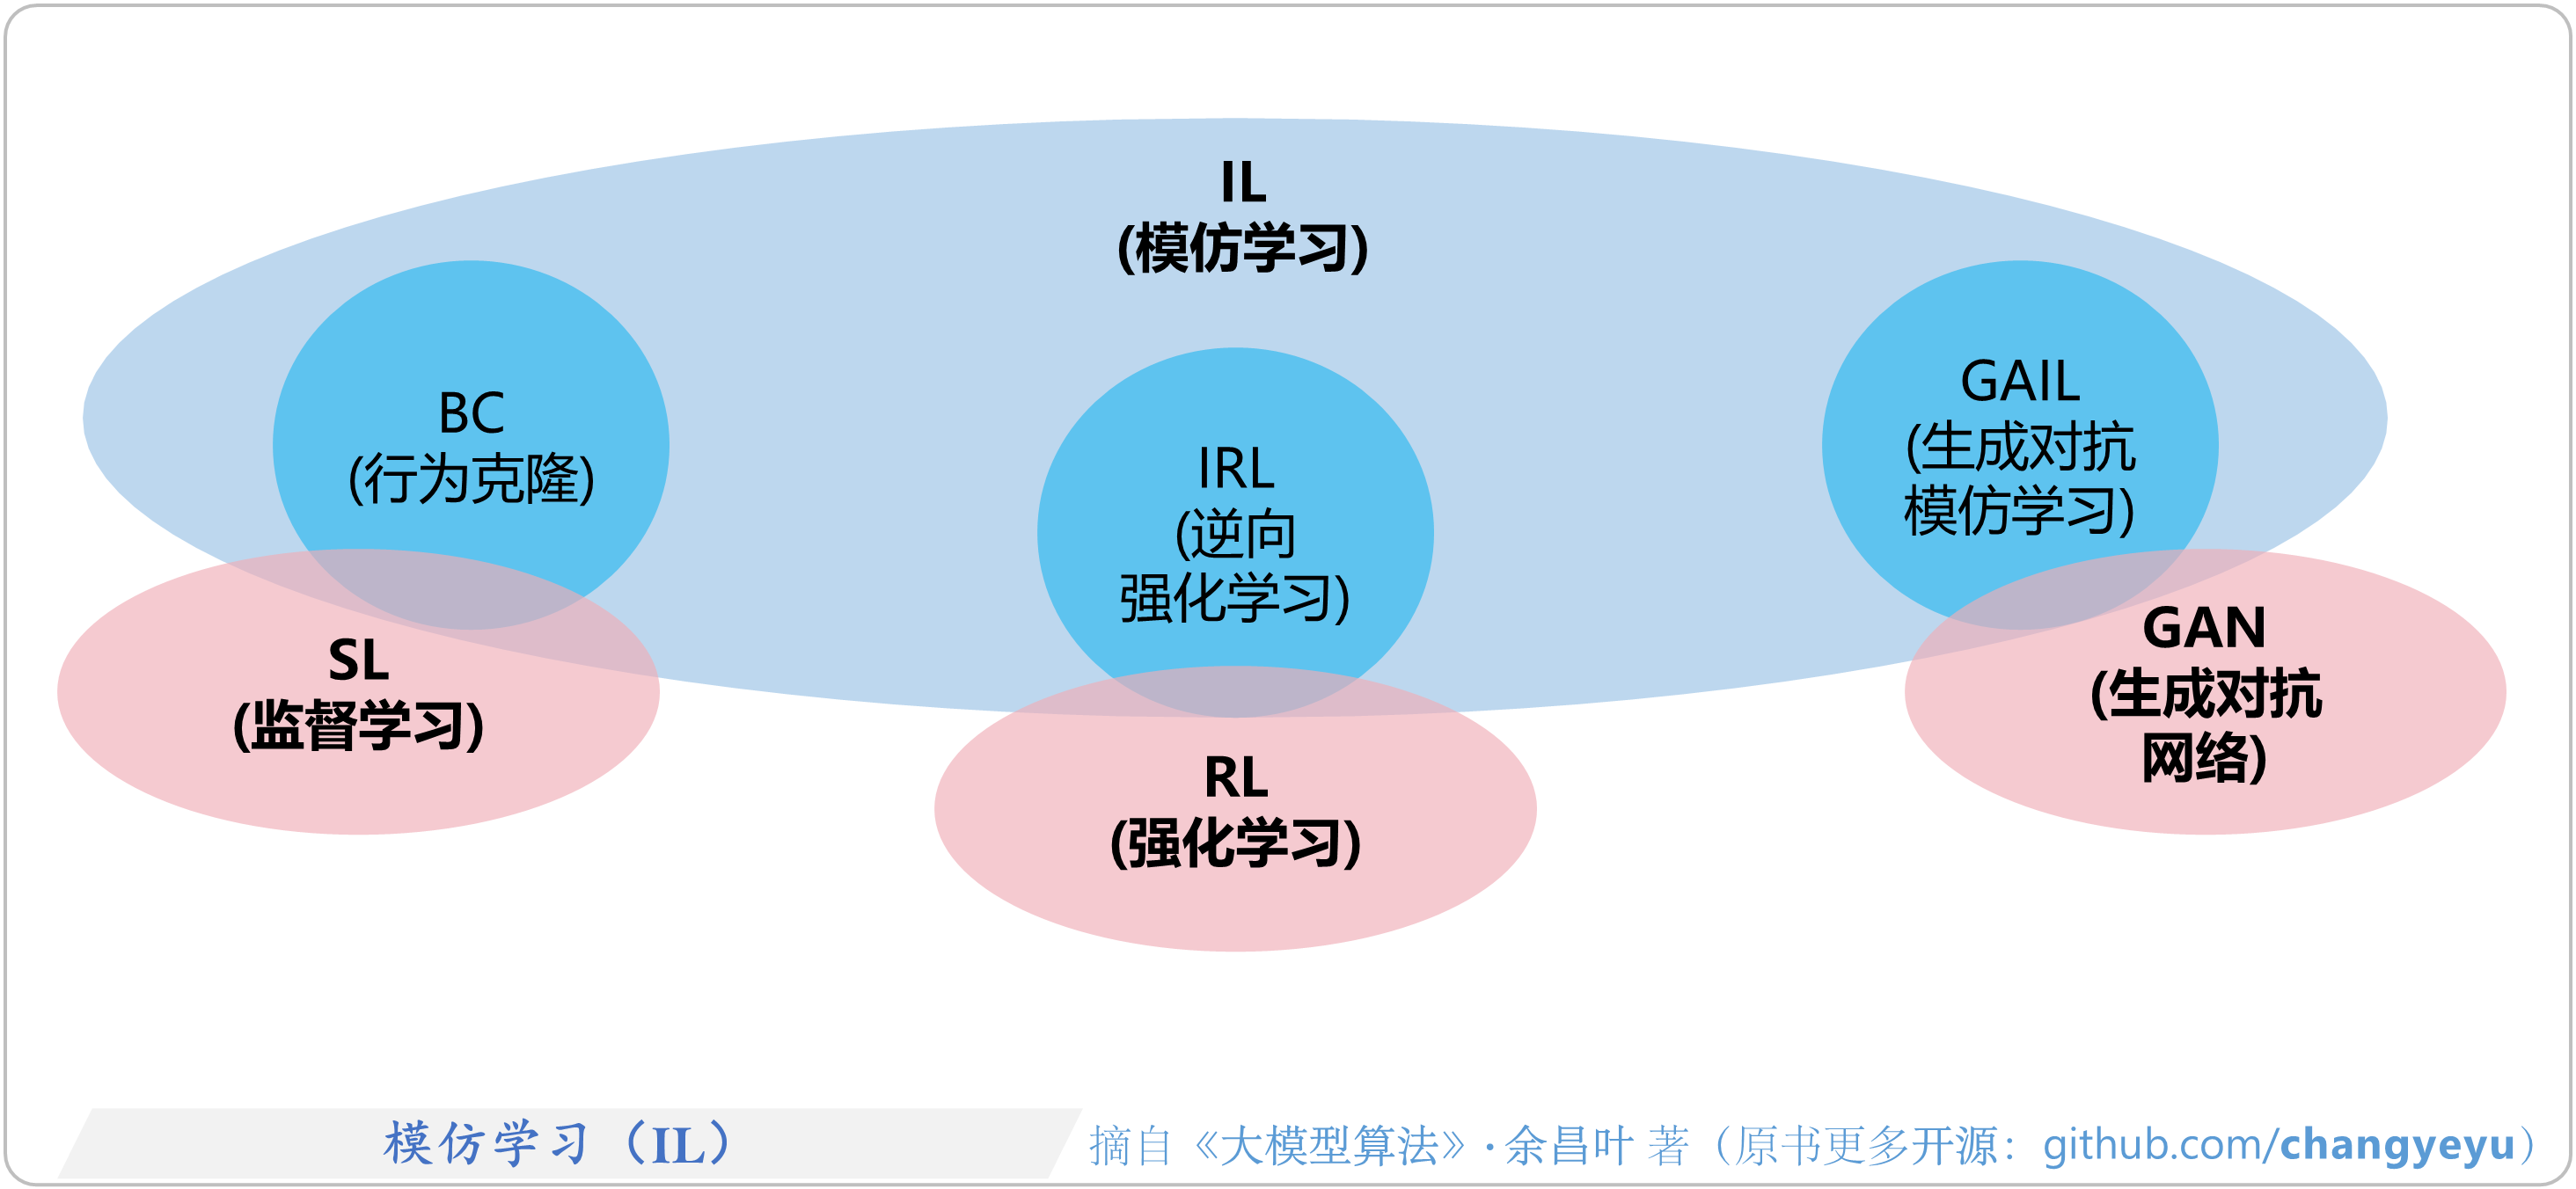
【强化学习基础】模仿学习(IL,Imitation Learning)
- 模仿学习(Imitation Learning,IL)是一种通过观察并模仿专家行为来学习复杂任务的机器学习方法。
- 与传统的强化学习不同,模仿学习无需明确的奖励函数,而是直接从专家的示范中学习策略。这种方法特别适用于那些难以手工设计奖励函数的任务场景。 常见的模仿学习算法主要分为三类:
- (1)行为克隆(Behavioral Cloning,BC):基于监督学习方法,直接从专家的状态-动作对中学习映射关系。
- (2)逆向强化学习(Inverse Reinforcement Learning,IRL):基于强化学习方法,通过推断奖励函数间接学习策略。
- (3)生成对抗模仿学习(Generative Adversarial Imitation Learning,GAIL):借鉴生成对抗学习的思想,通过对抗过程优化策略。

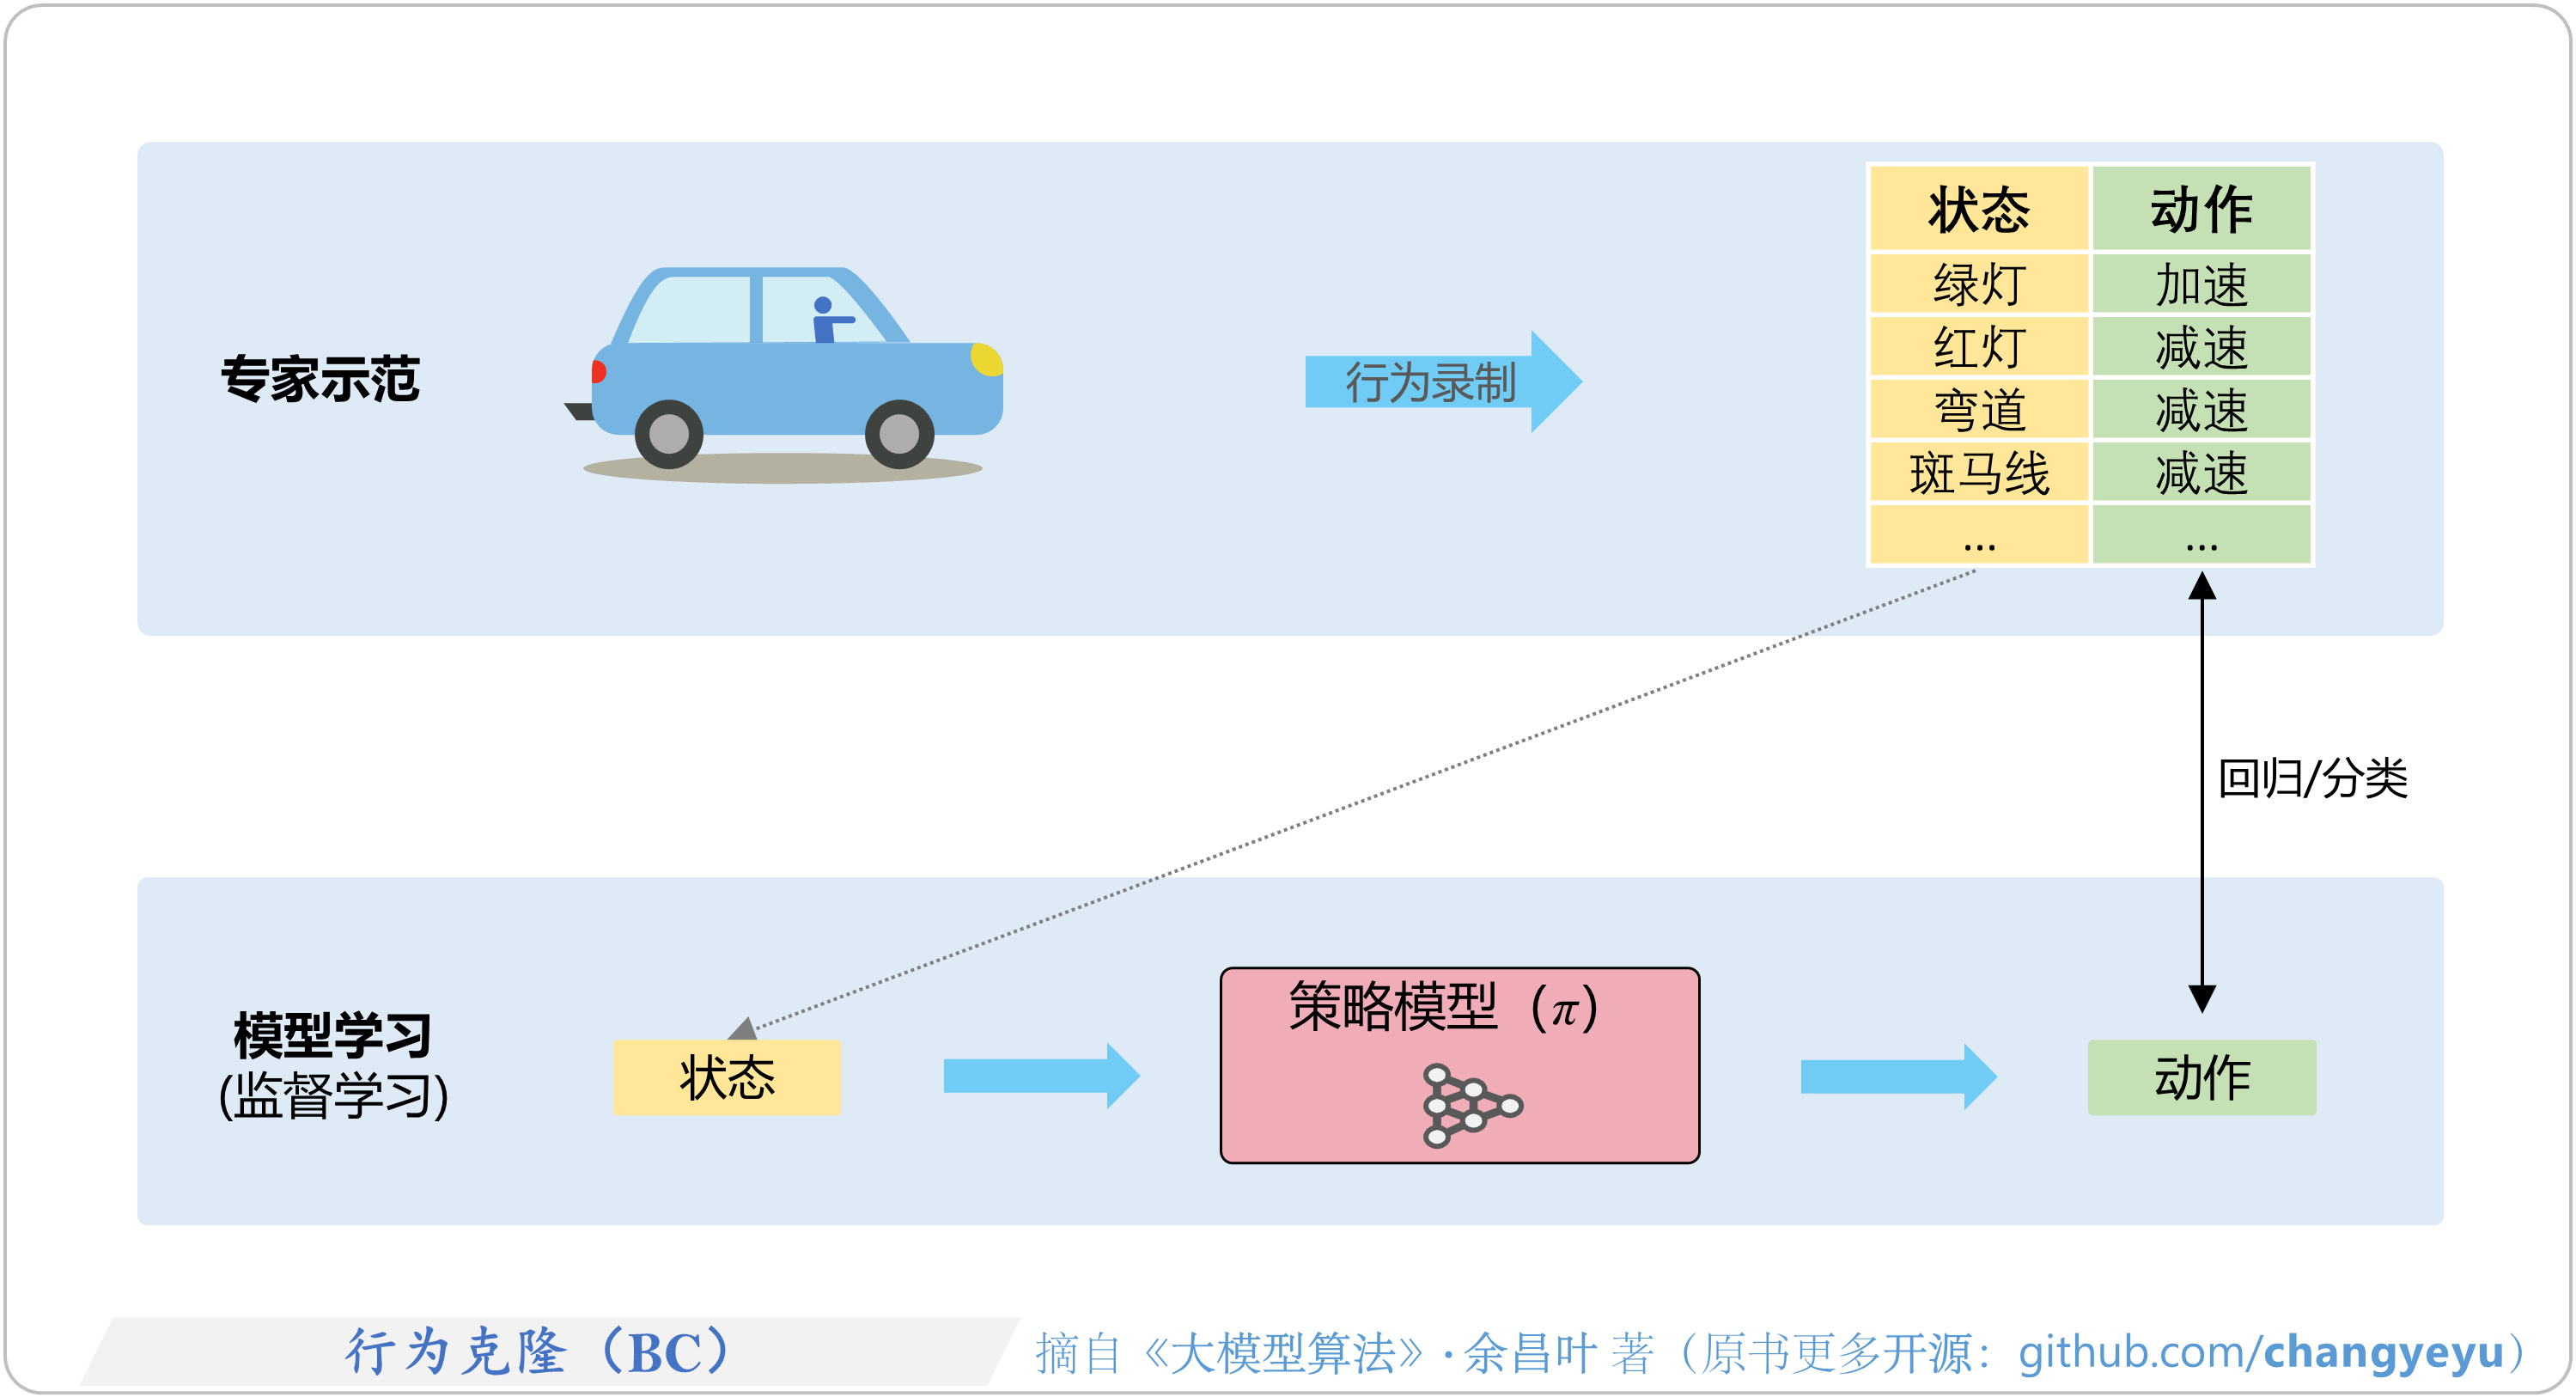
【强化学习基础】行为克隆(BC,Behavior Cloning)
- 行为克隆(Behavioral Cloning,BC)是一种结合了监督学习的机器学习方法,通过学习专家在不同状态(State)下采取的动作(Action)的映射关系来模仿专家的行为。
- 行为克隆将问题视为一个回归或分类问题,输入为环境的状态,输出为相应的动作。通过最小化预测动作与专家动作之间的误差,模型能够在类似状态下采取与专家相似的动作。

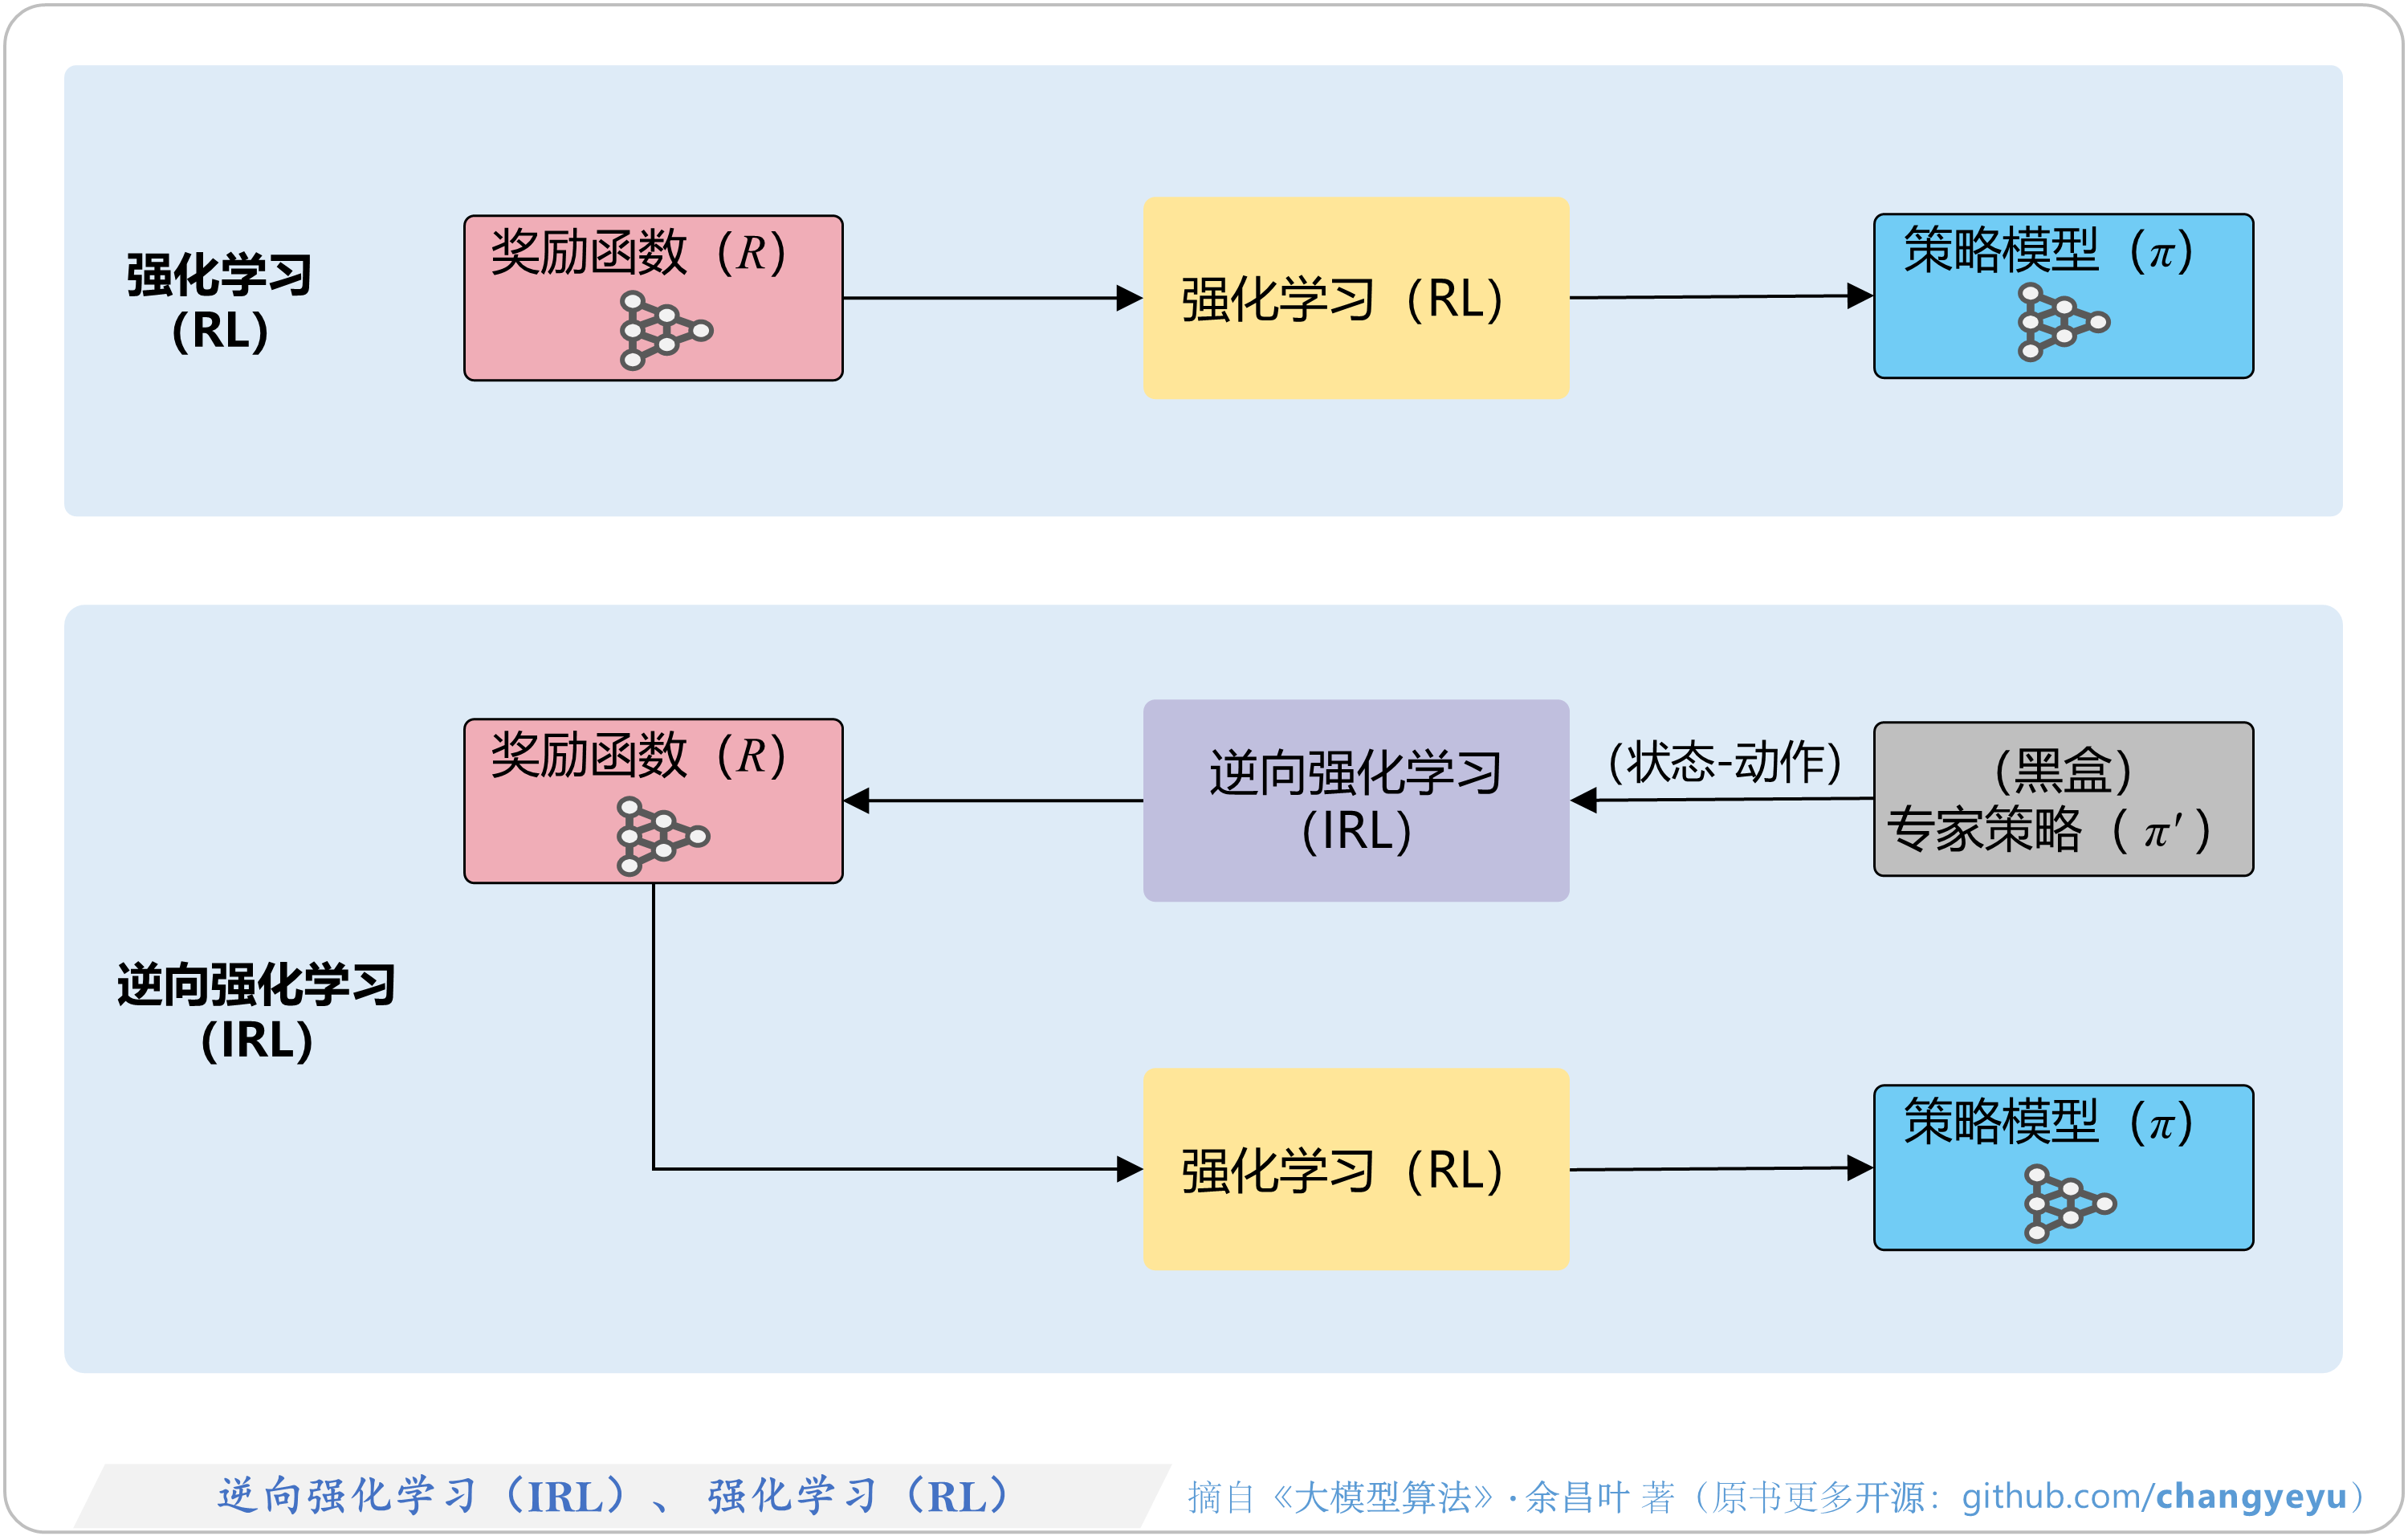
【强化学习基础】逆向强化学习(IRL,Inverse RL)、强化学习(RL)
- 逆向强化学习(Inverse Reinforcement Learning, IRL)指的是根据专家或智能体的行为,推断其背后的奖励函数,然后,基于此奖励函数学习最优策略。
- 这一过程与传统强化学习(RL)相反,后者通常是在已知奖励函数的情况下学习最优策略,而逆向强化学习则是在已知行为的基础上反推出奖励函数,再进一步学习策略。
- 吴恩达(Andrew Y. Ng)和Stuart Russell于2000年发表了《Algorithms for Inverse Reinforcement Learning》一文,系统性地阐述了逆强化学习的核心概念。

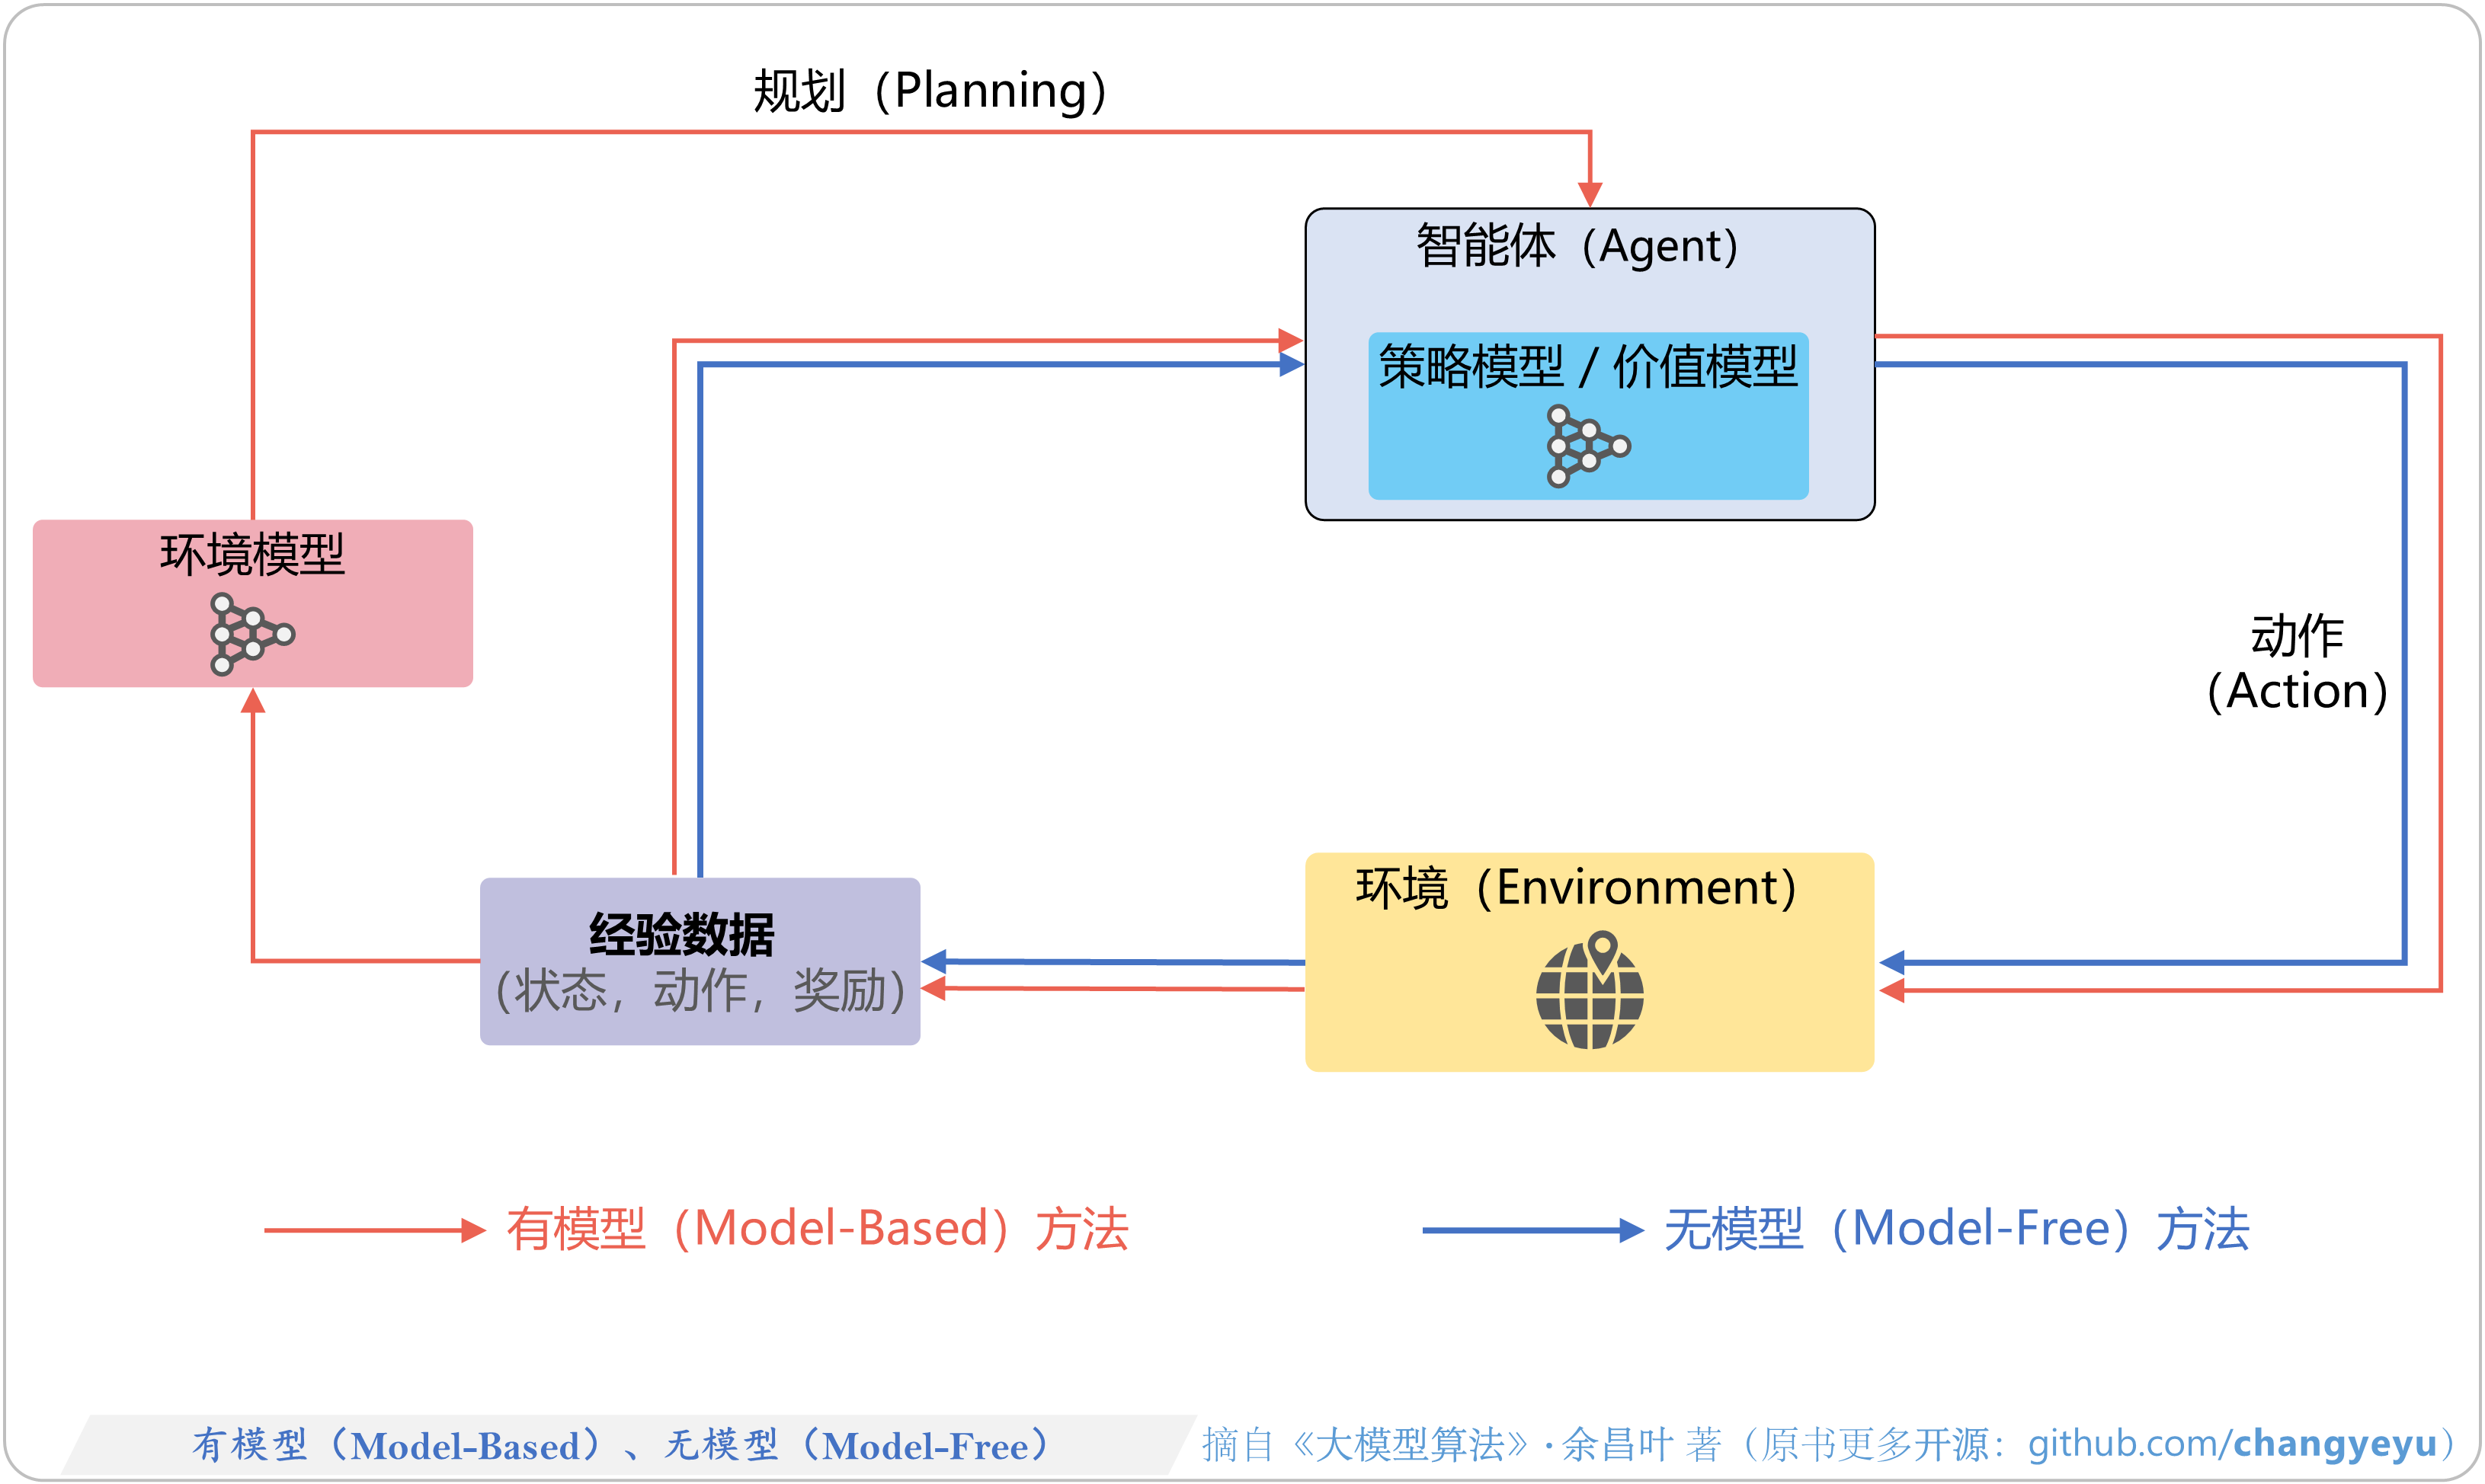
【强化学习基础】有模型(Model-Based)、无模型(Model-Free)
- 根据是否依赖环境模型:分为有模型(Model-Based)和无模型(Model-Free)的方法。
- 有模型的方法利用环境模型进行规划和决策;无模型的方法则直接通过与环境交互学习策略或价值函数。
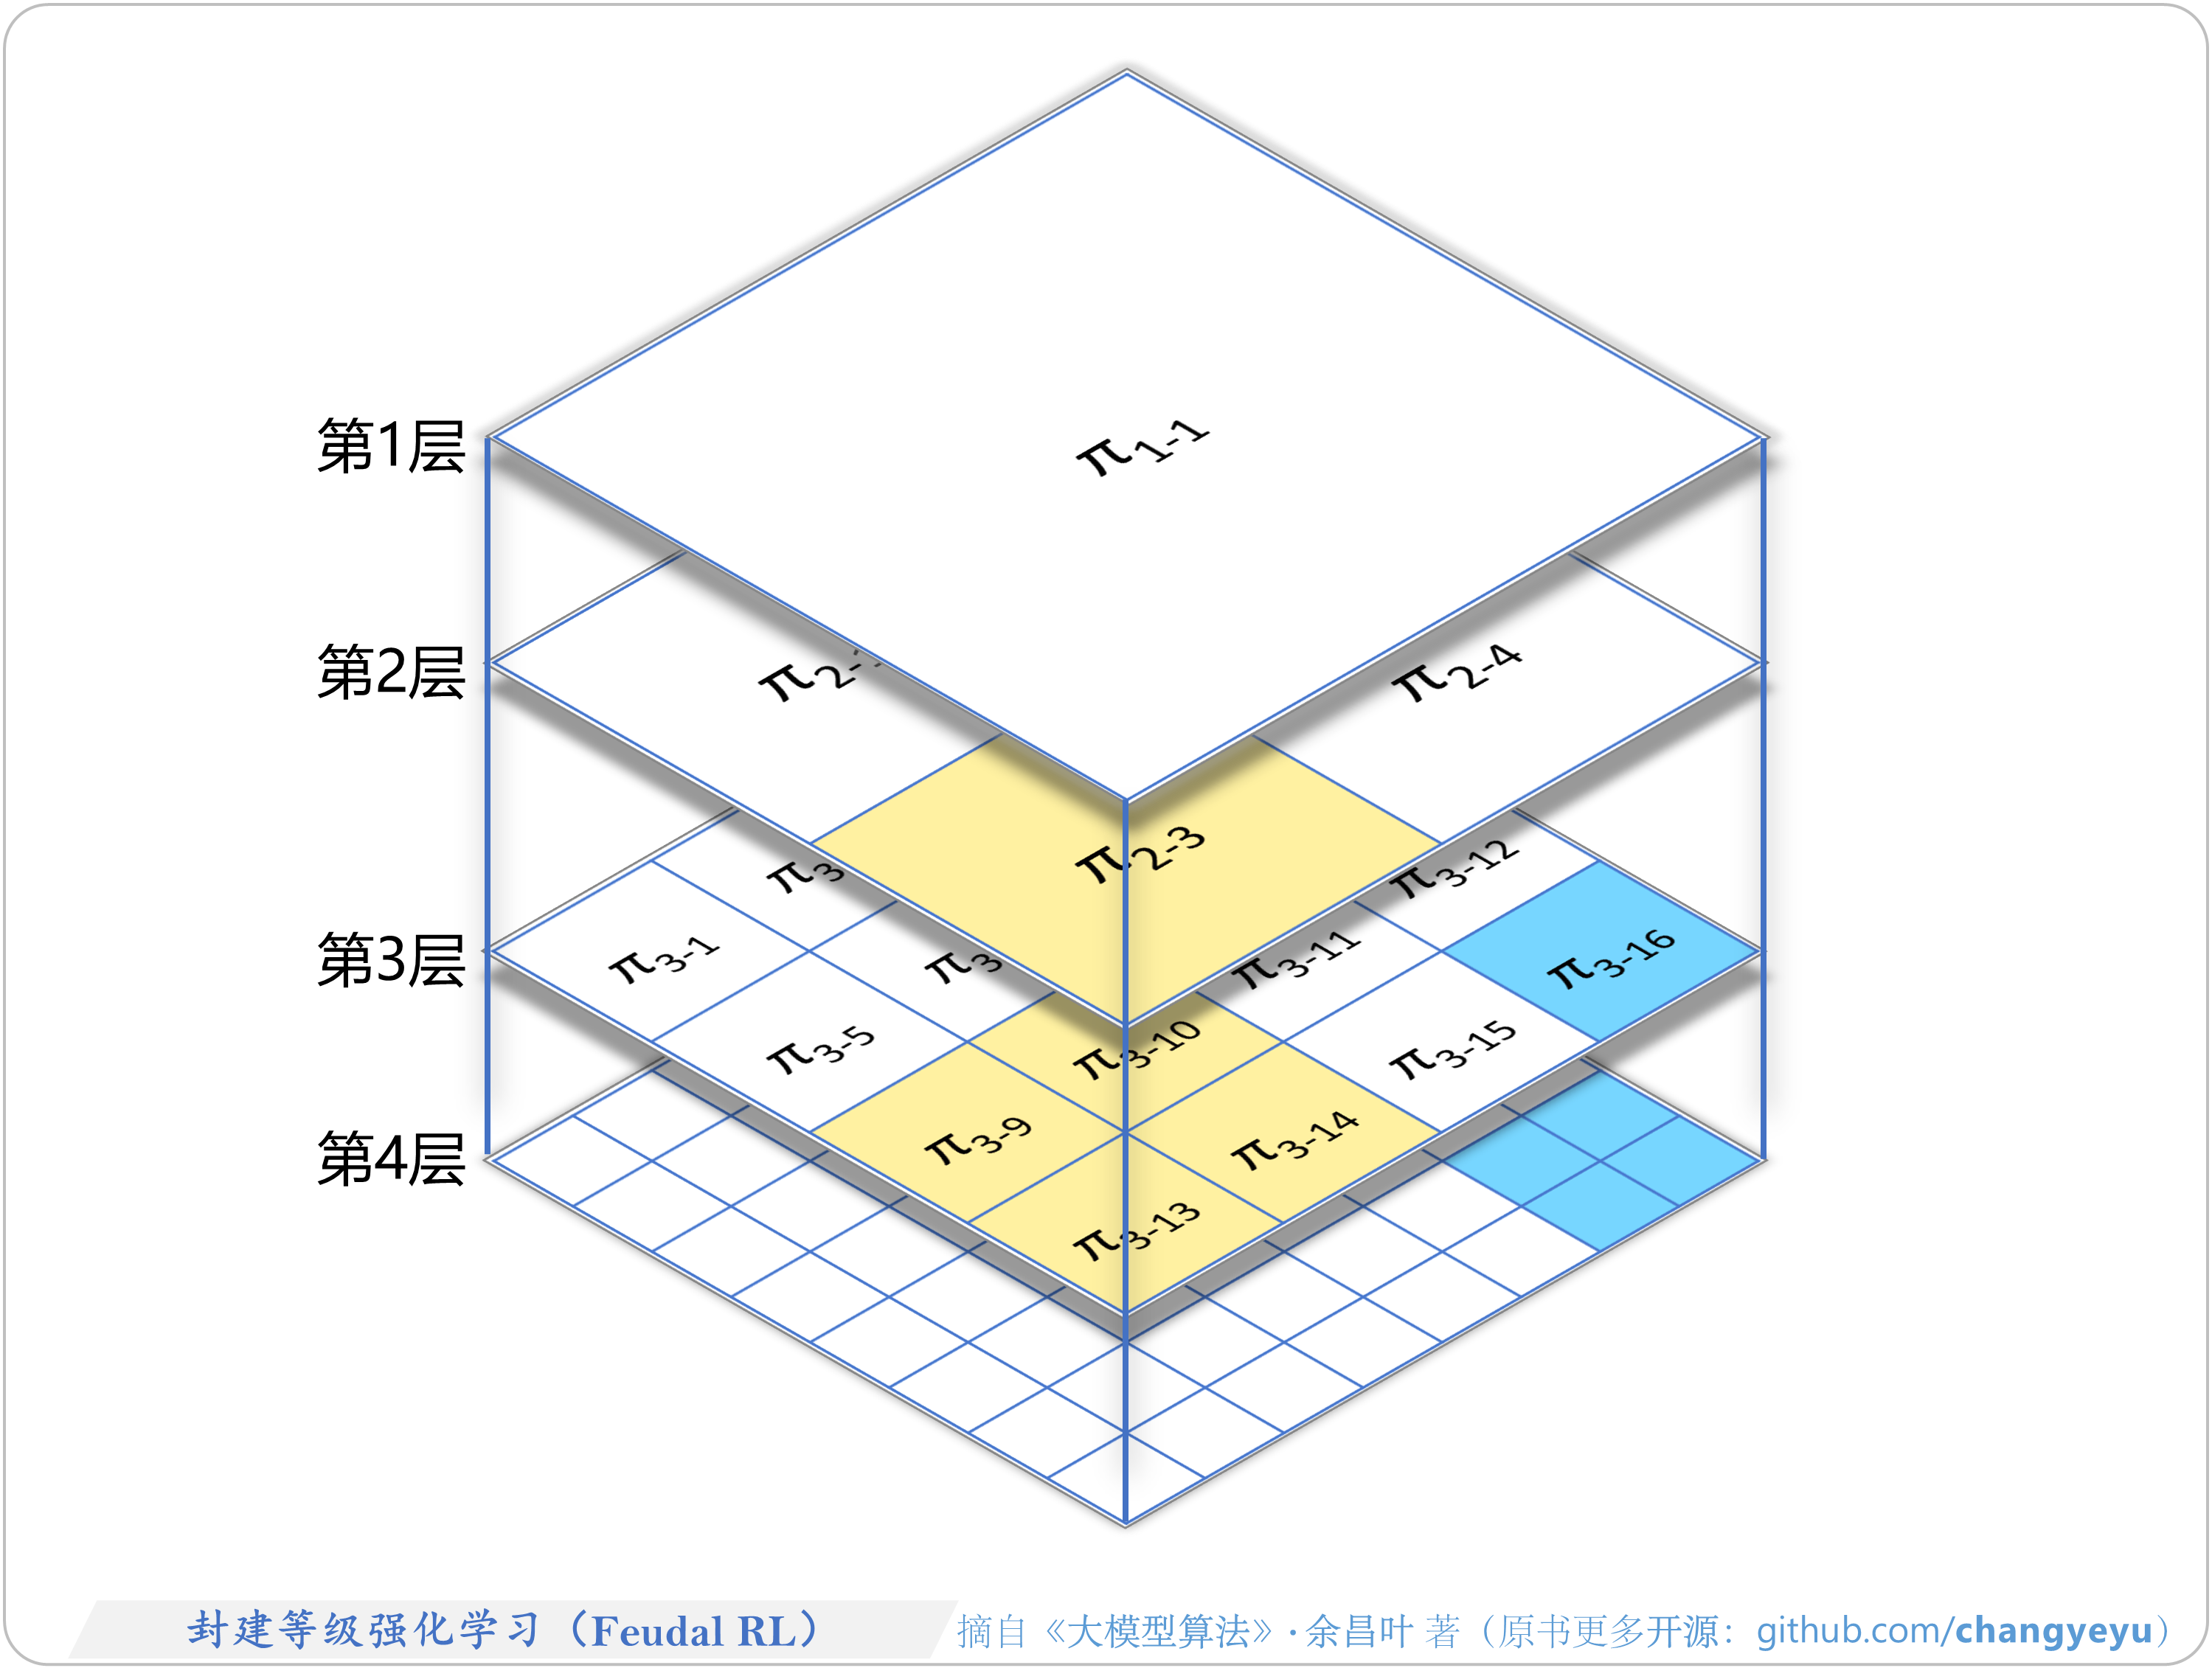
【强化学习基础】封建等级强化学习(Feudal RL)
- 分层强化学习(Hierarchical Reinforcement Learning, HRL)是一种分而治之的强化学习框架,通过将复杂的任务分解为多个层次的较小的子任务或子策略,使智能体能够在不同的抽象层次上学习和决策。
- 该领域发展至今,已经涌现出多种经典算法,例如,封建等级强化学习(Feudal RL)和MAXQ等算法。
- 封建等级强化学习(Feudal Reinforcement Learning, Feudal RL)最早由AI巨佬Geoffrey E. Hinton等人提出,Hinton因其在人工智能领域的突出贡献于2024年获得诺贝尔物理学奖。

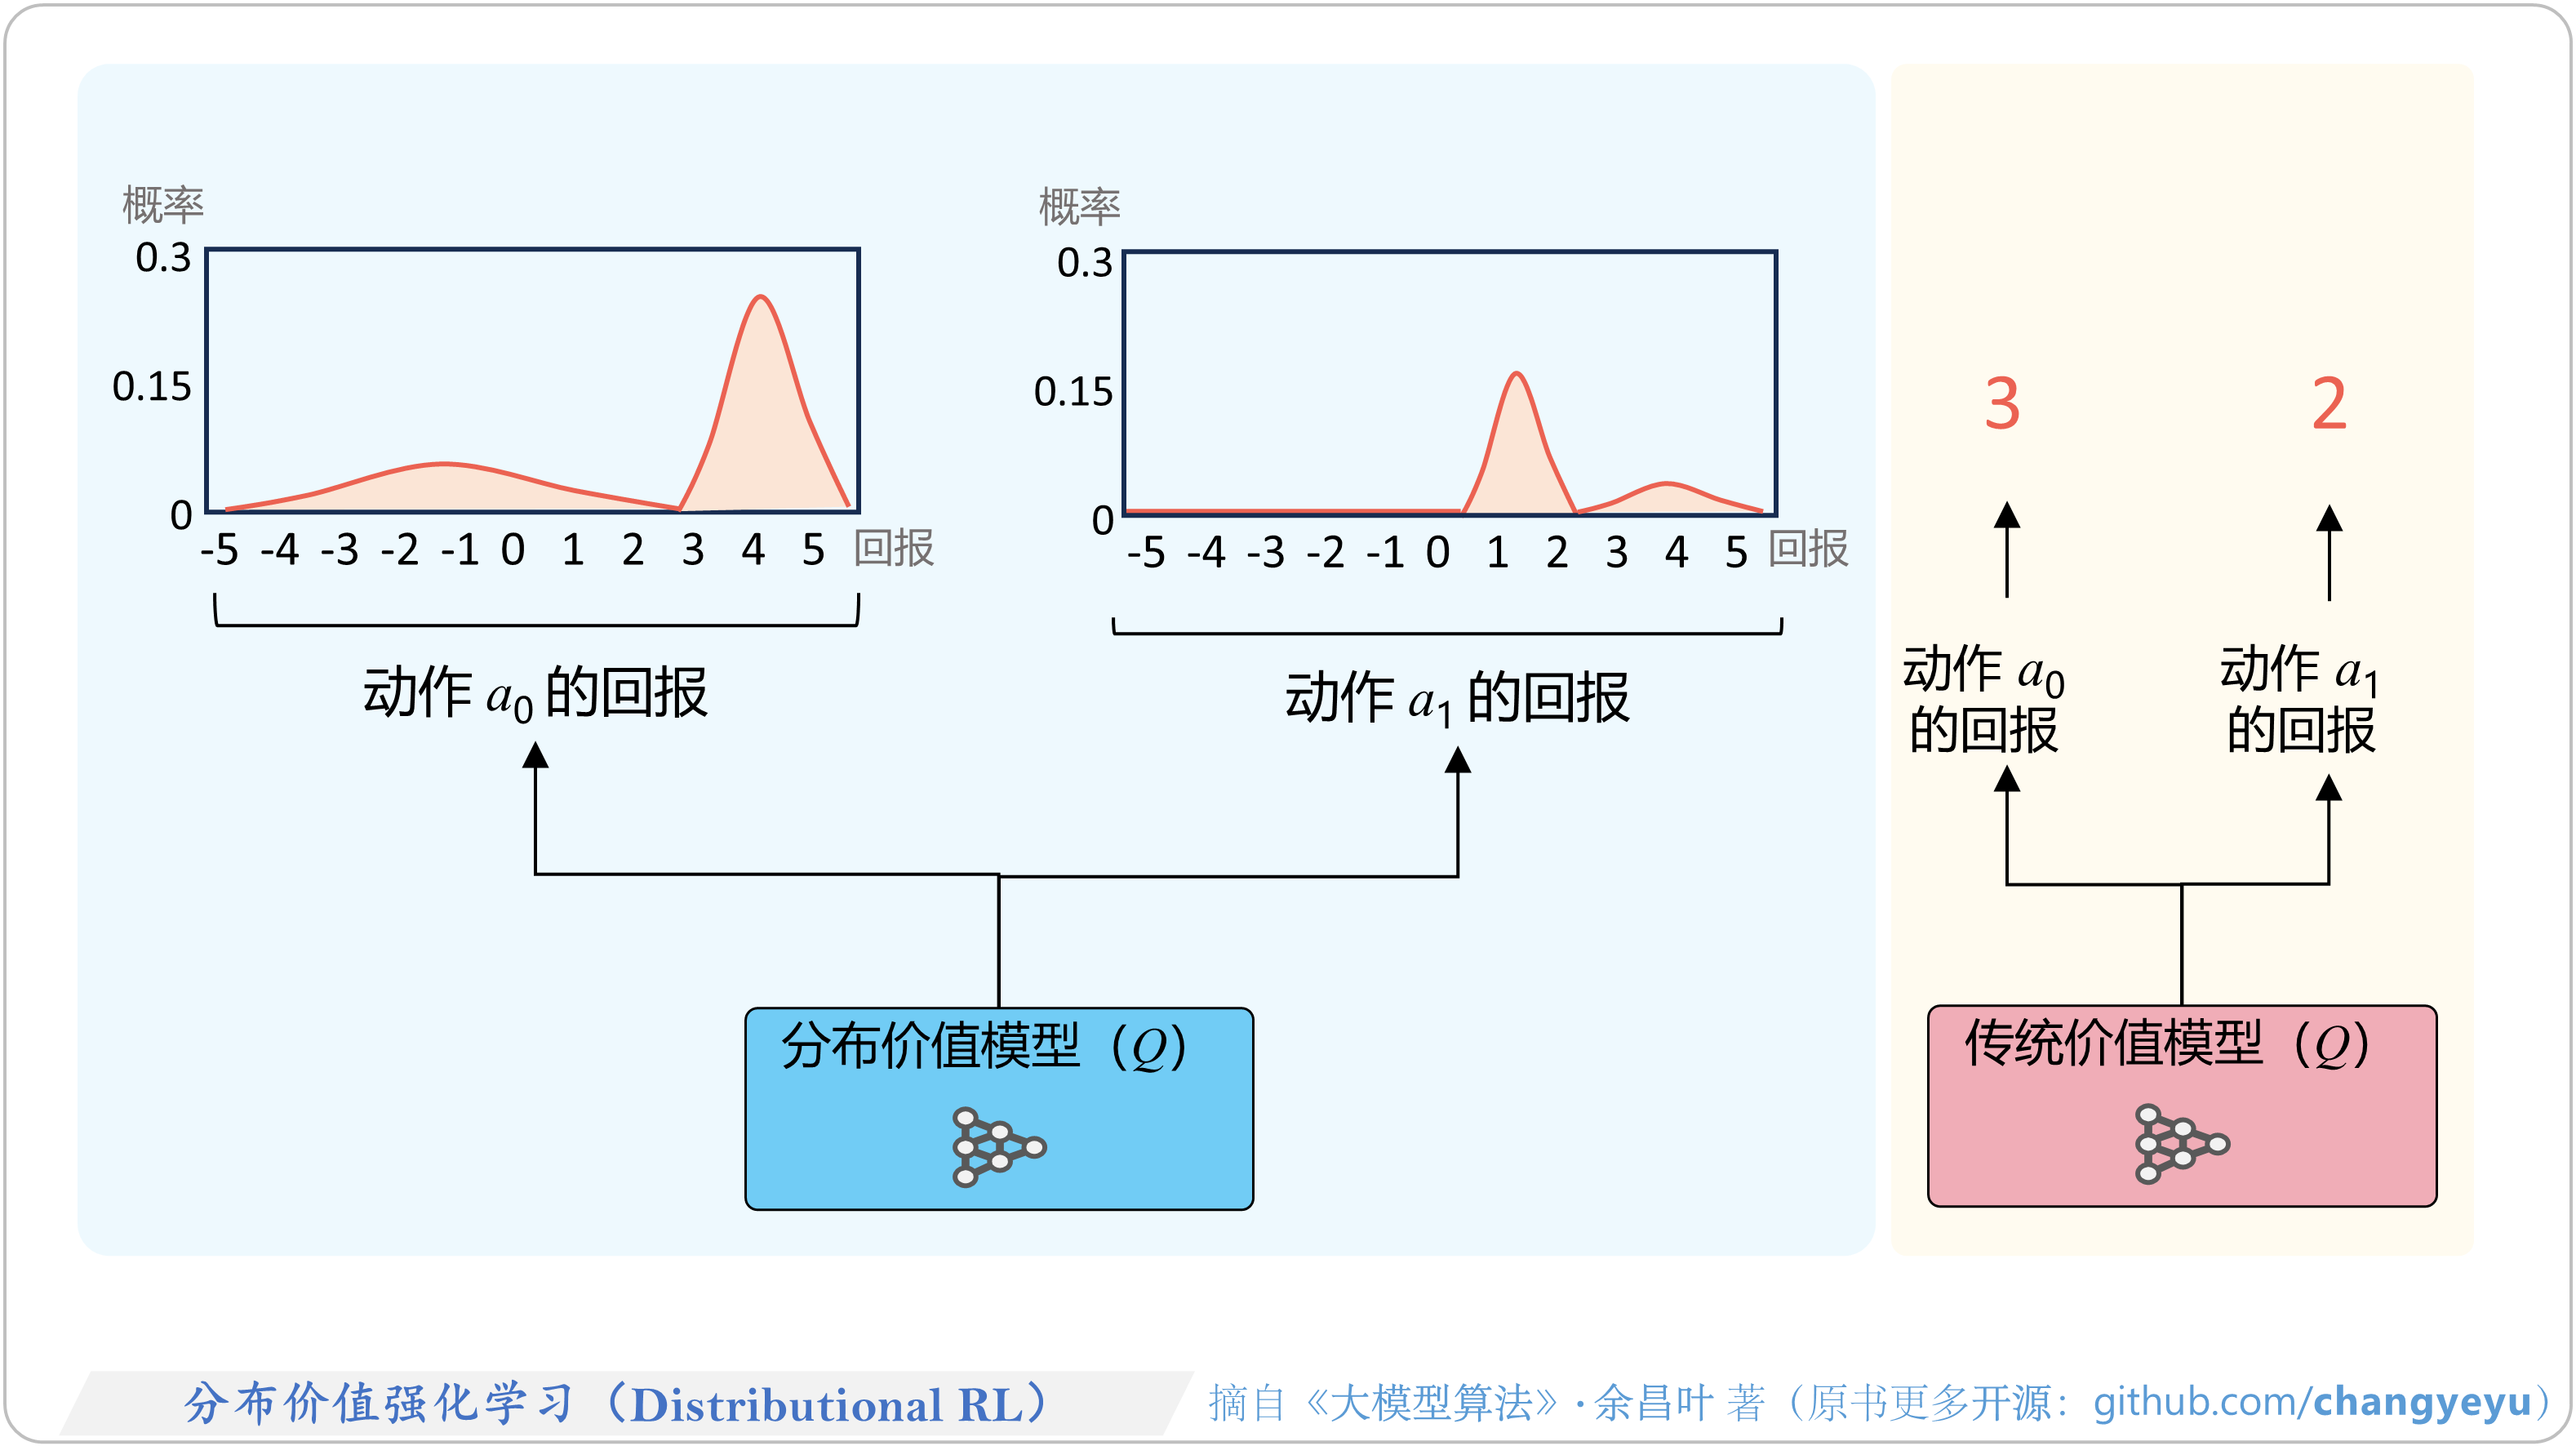
【强化学习基础】分布价值强化学习(Distributional RL)
- 分布价值强化学习(Distributional Reinforcement Learning)指的是直接对回报(累积奖励)的分布进行建模,而不仅仅是对其期望值进行估计。
- 分布价值模型包含了更丰富的价值信息,能够更全面地捕捉环境的不确定性,从而在策略优化和潜在风险管理等方面提供优势。
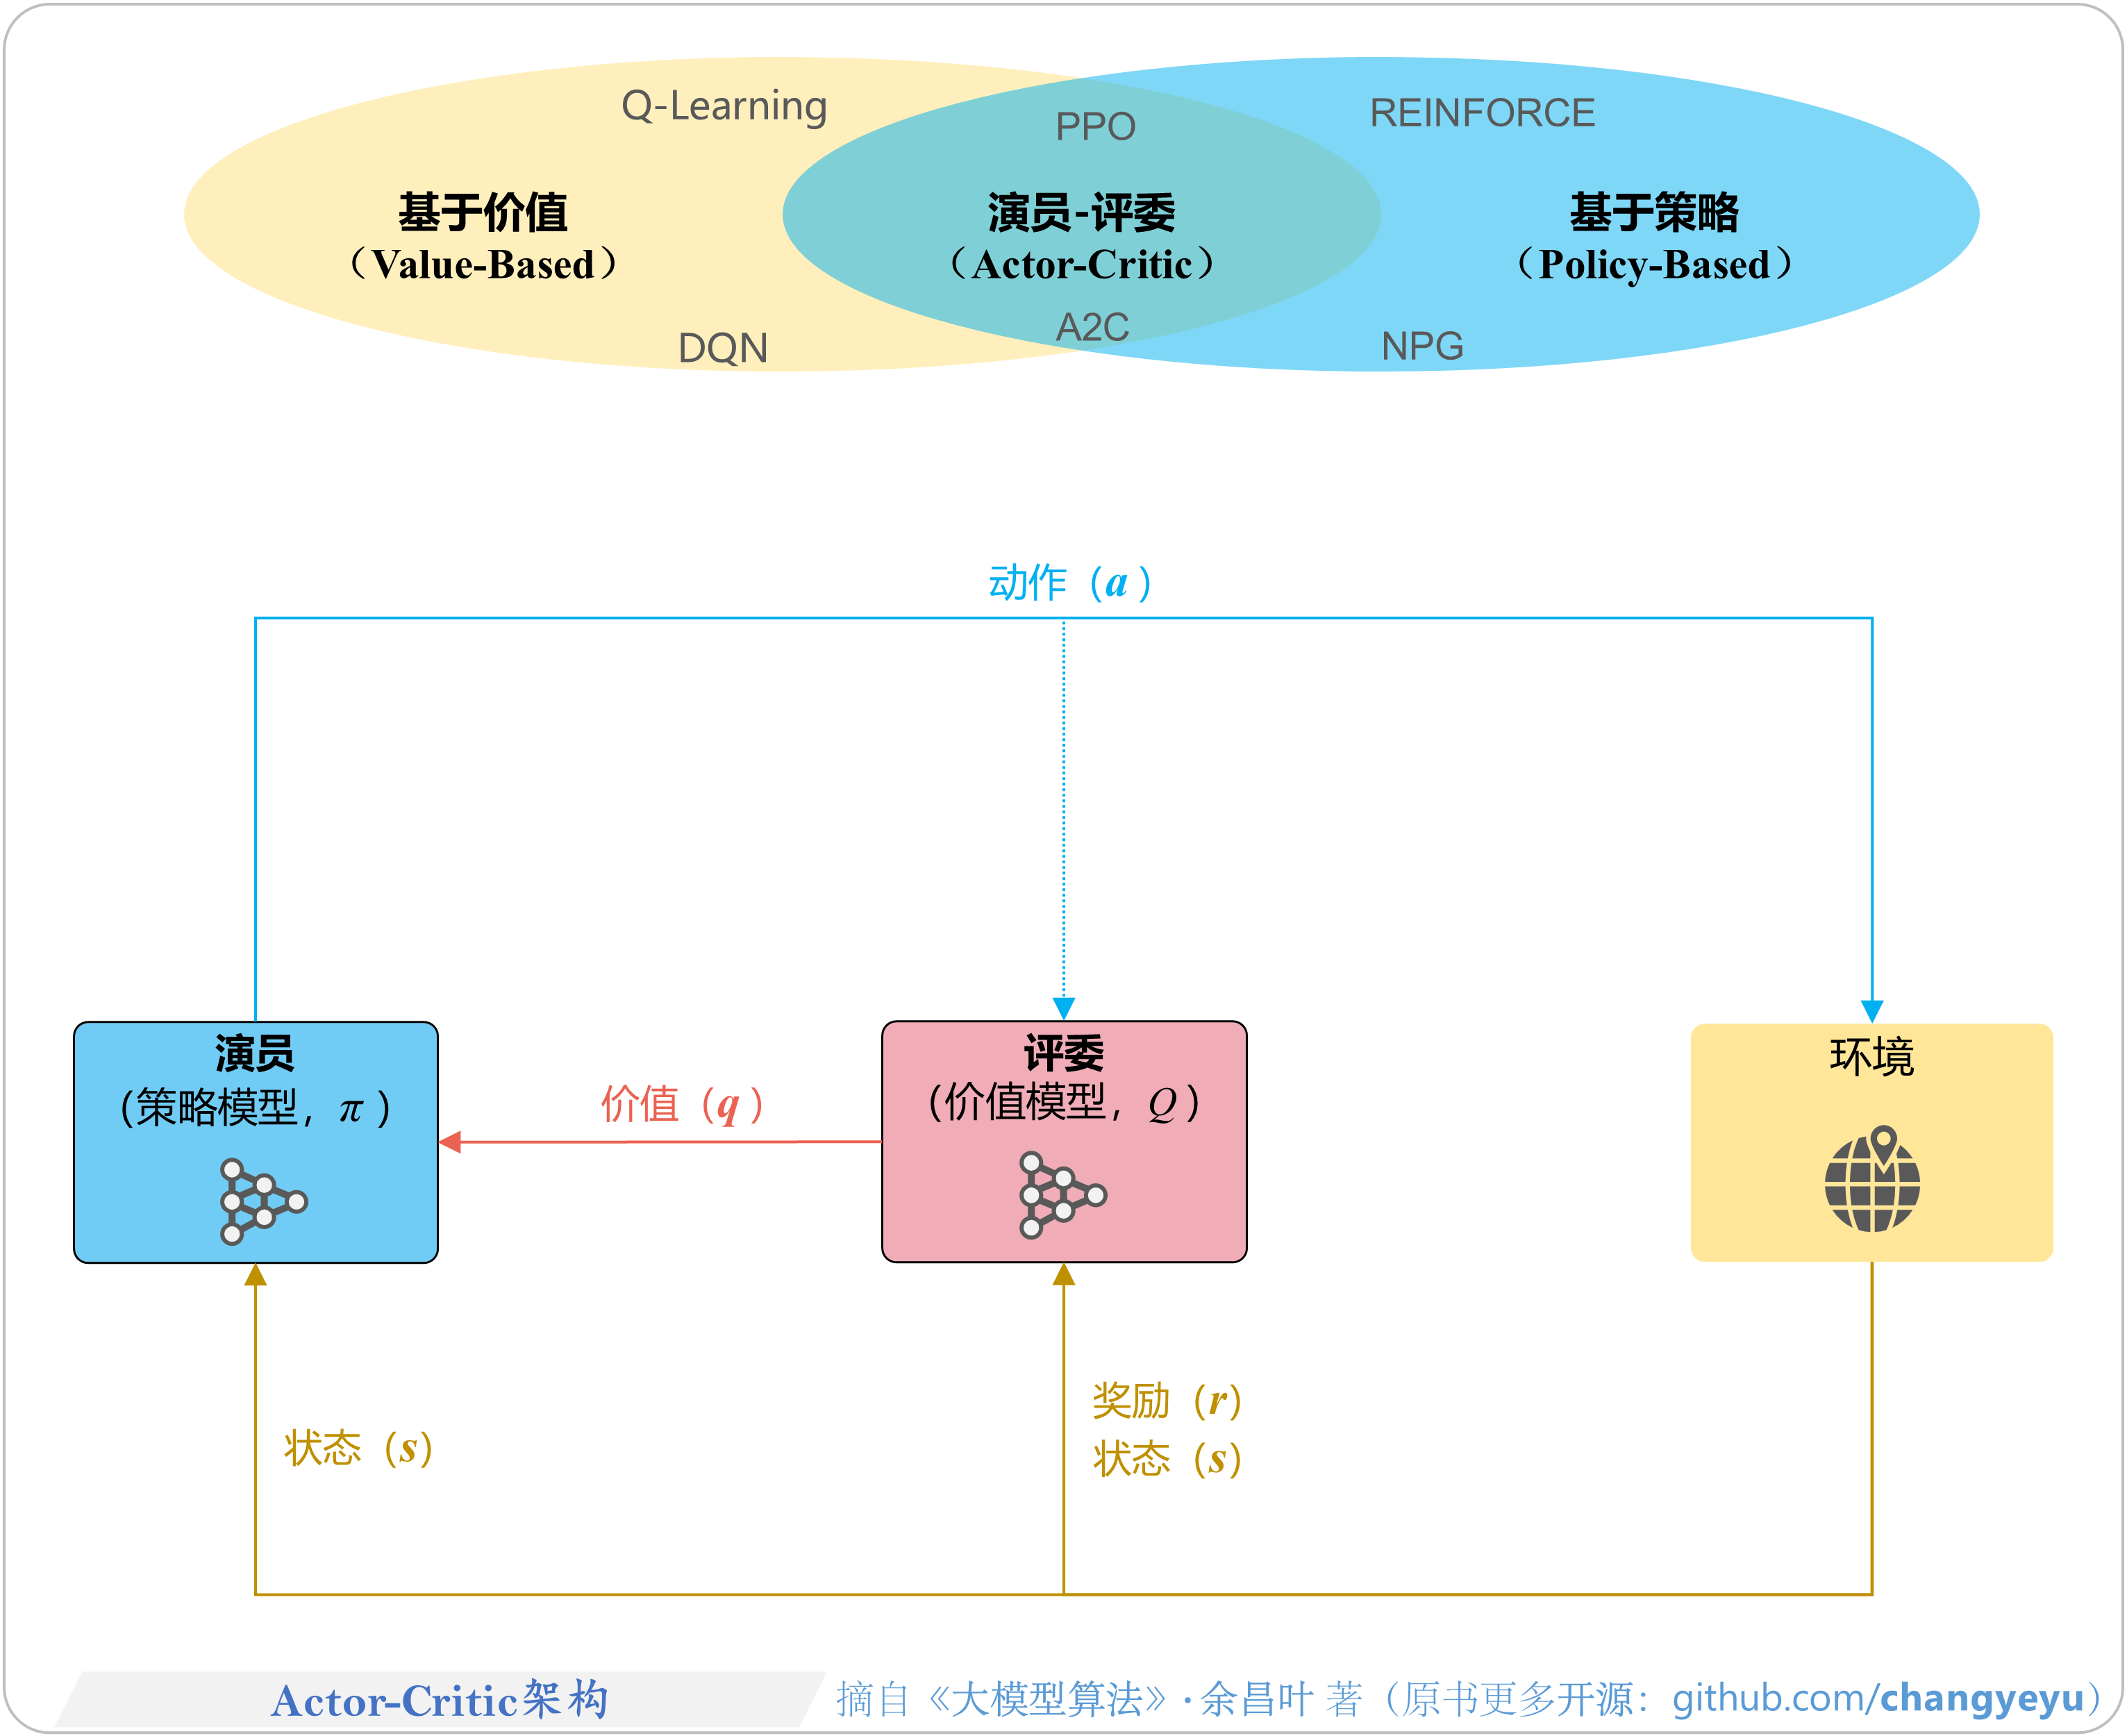
【策略优化架构算法及其衍生】Actor-Critic架构
- Actor-Critic架构(AC架构),即演员-评委架构,是一种应用极为广泛的强化学习架构。知名的PPO、DPG、DDPG、TD3等算法均基于Actor-Critic架构。
- (1)Actor(演员):对应于策略模型π,负责选择动作,直接输出策略π(a | s),即在给定状态s下选择动作a的概率分布。
- (2)Critic(评委):对应于价值模型Q,评估Actor执行的动作的好坏,这可以协助Actor逐步优化策略模型的参数。
- 该架构有效融合了基于策略(Policy-Based)和基于价值(Value-Based)的方法,结合了两种方法的优势,通过同时学习策略和价值函数来提升学习效率与稳定性,是一种混合型方法。

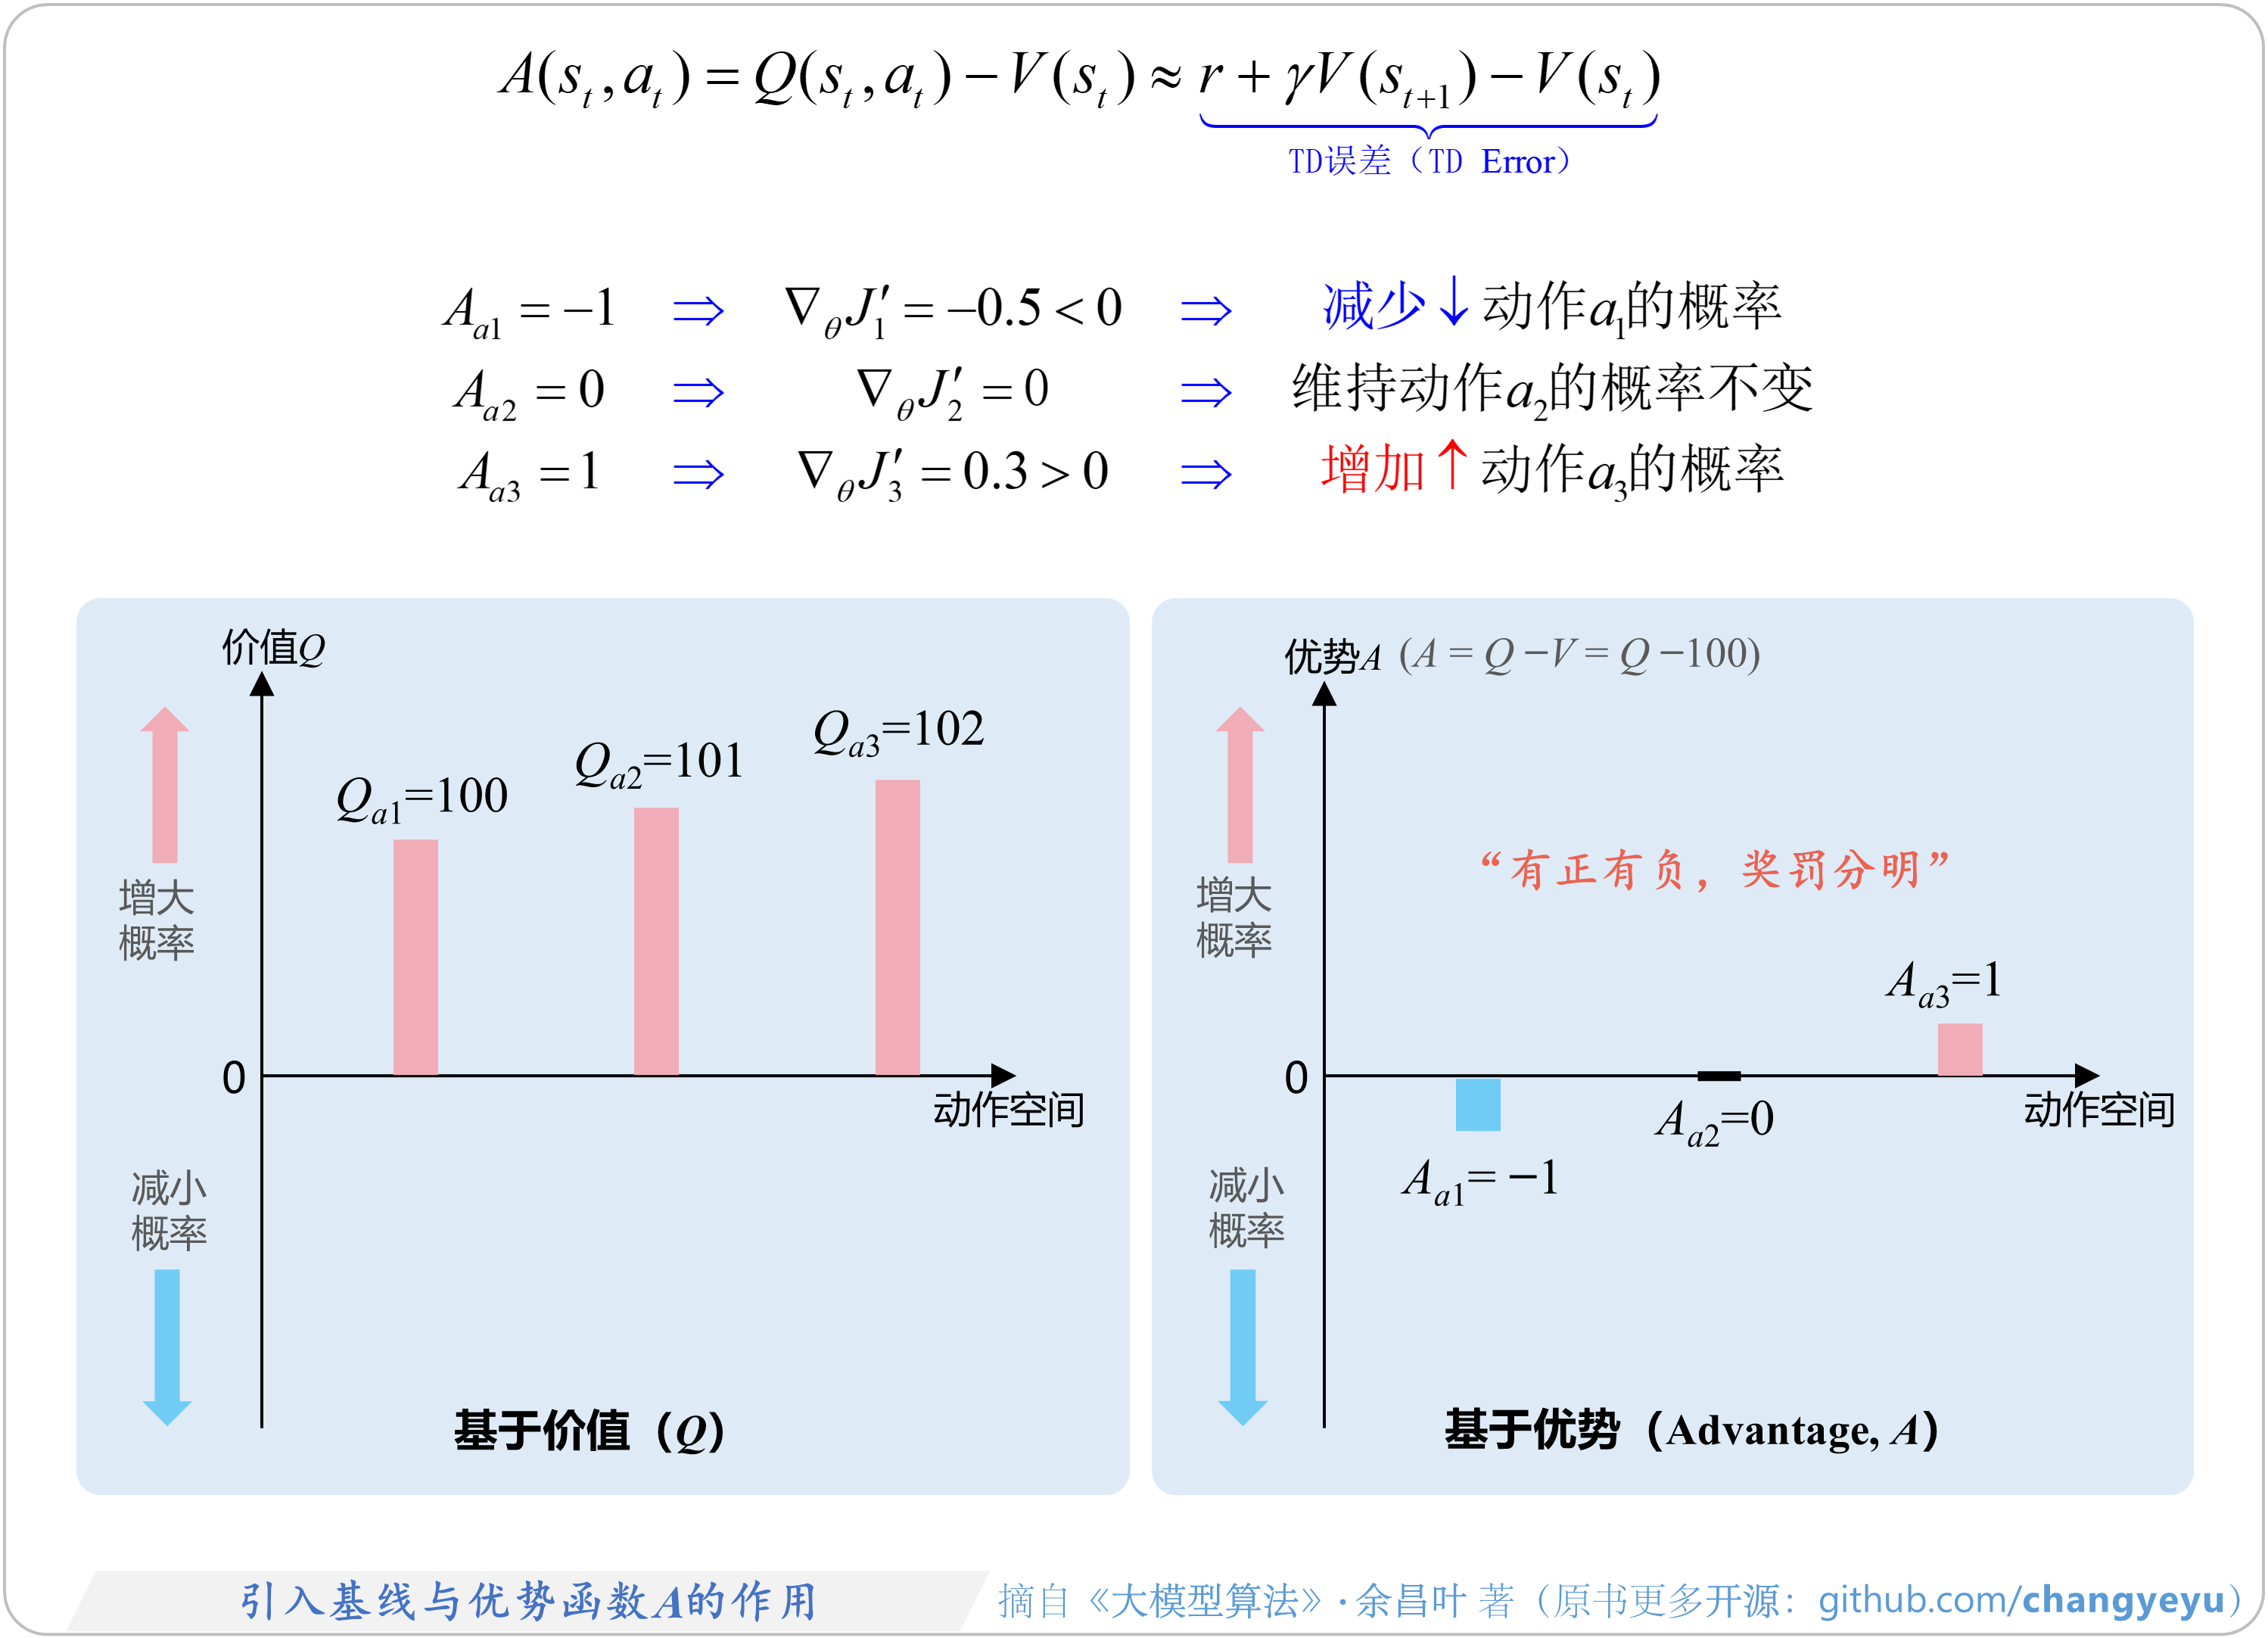
【策略优化架构算法及其衍生】引入基线与优势(Advantage)函数A的作用
- 基础版本的Actor-Critic架构存在高方差等问题。为了解决这些问题,A2C(Advantage Actor-Critic)方法在Actor-Critic的基础上引入基线(Baseline),并进一步构造了优势函数(Advantage Function)。
- (1)引入基线:基线通常采用状态价值函数V(s),即在状态s下的预期回报。将基线设为V(s),相当于在每个状态s下设定了一个平均水平。
- (2)构造优势函数:优势函数衡量在给定状态下,采取某一动作相对于“平均水平”的优劣,即某个动作a相对于特定状态下其他动作的相对优势。优势函数关注的是执行某个动作的相对优势,而非动作的绝对价值。

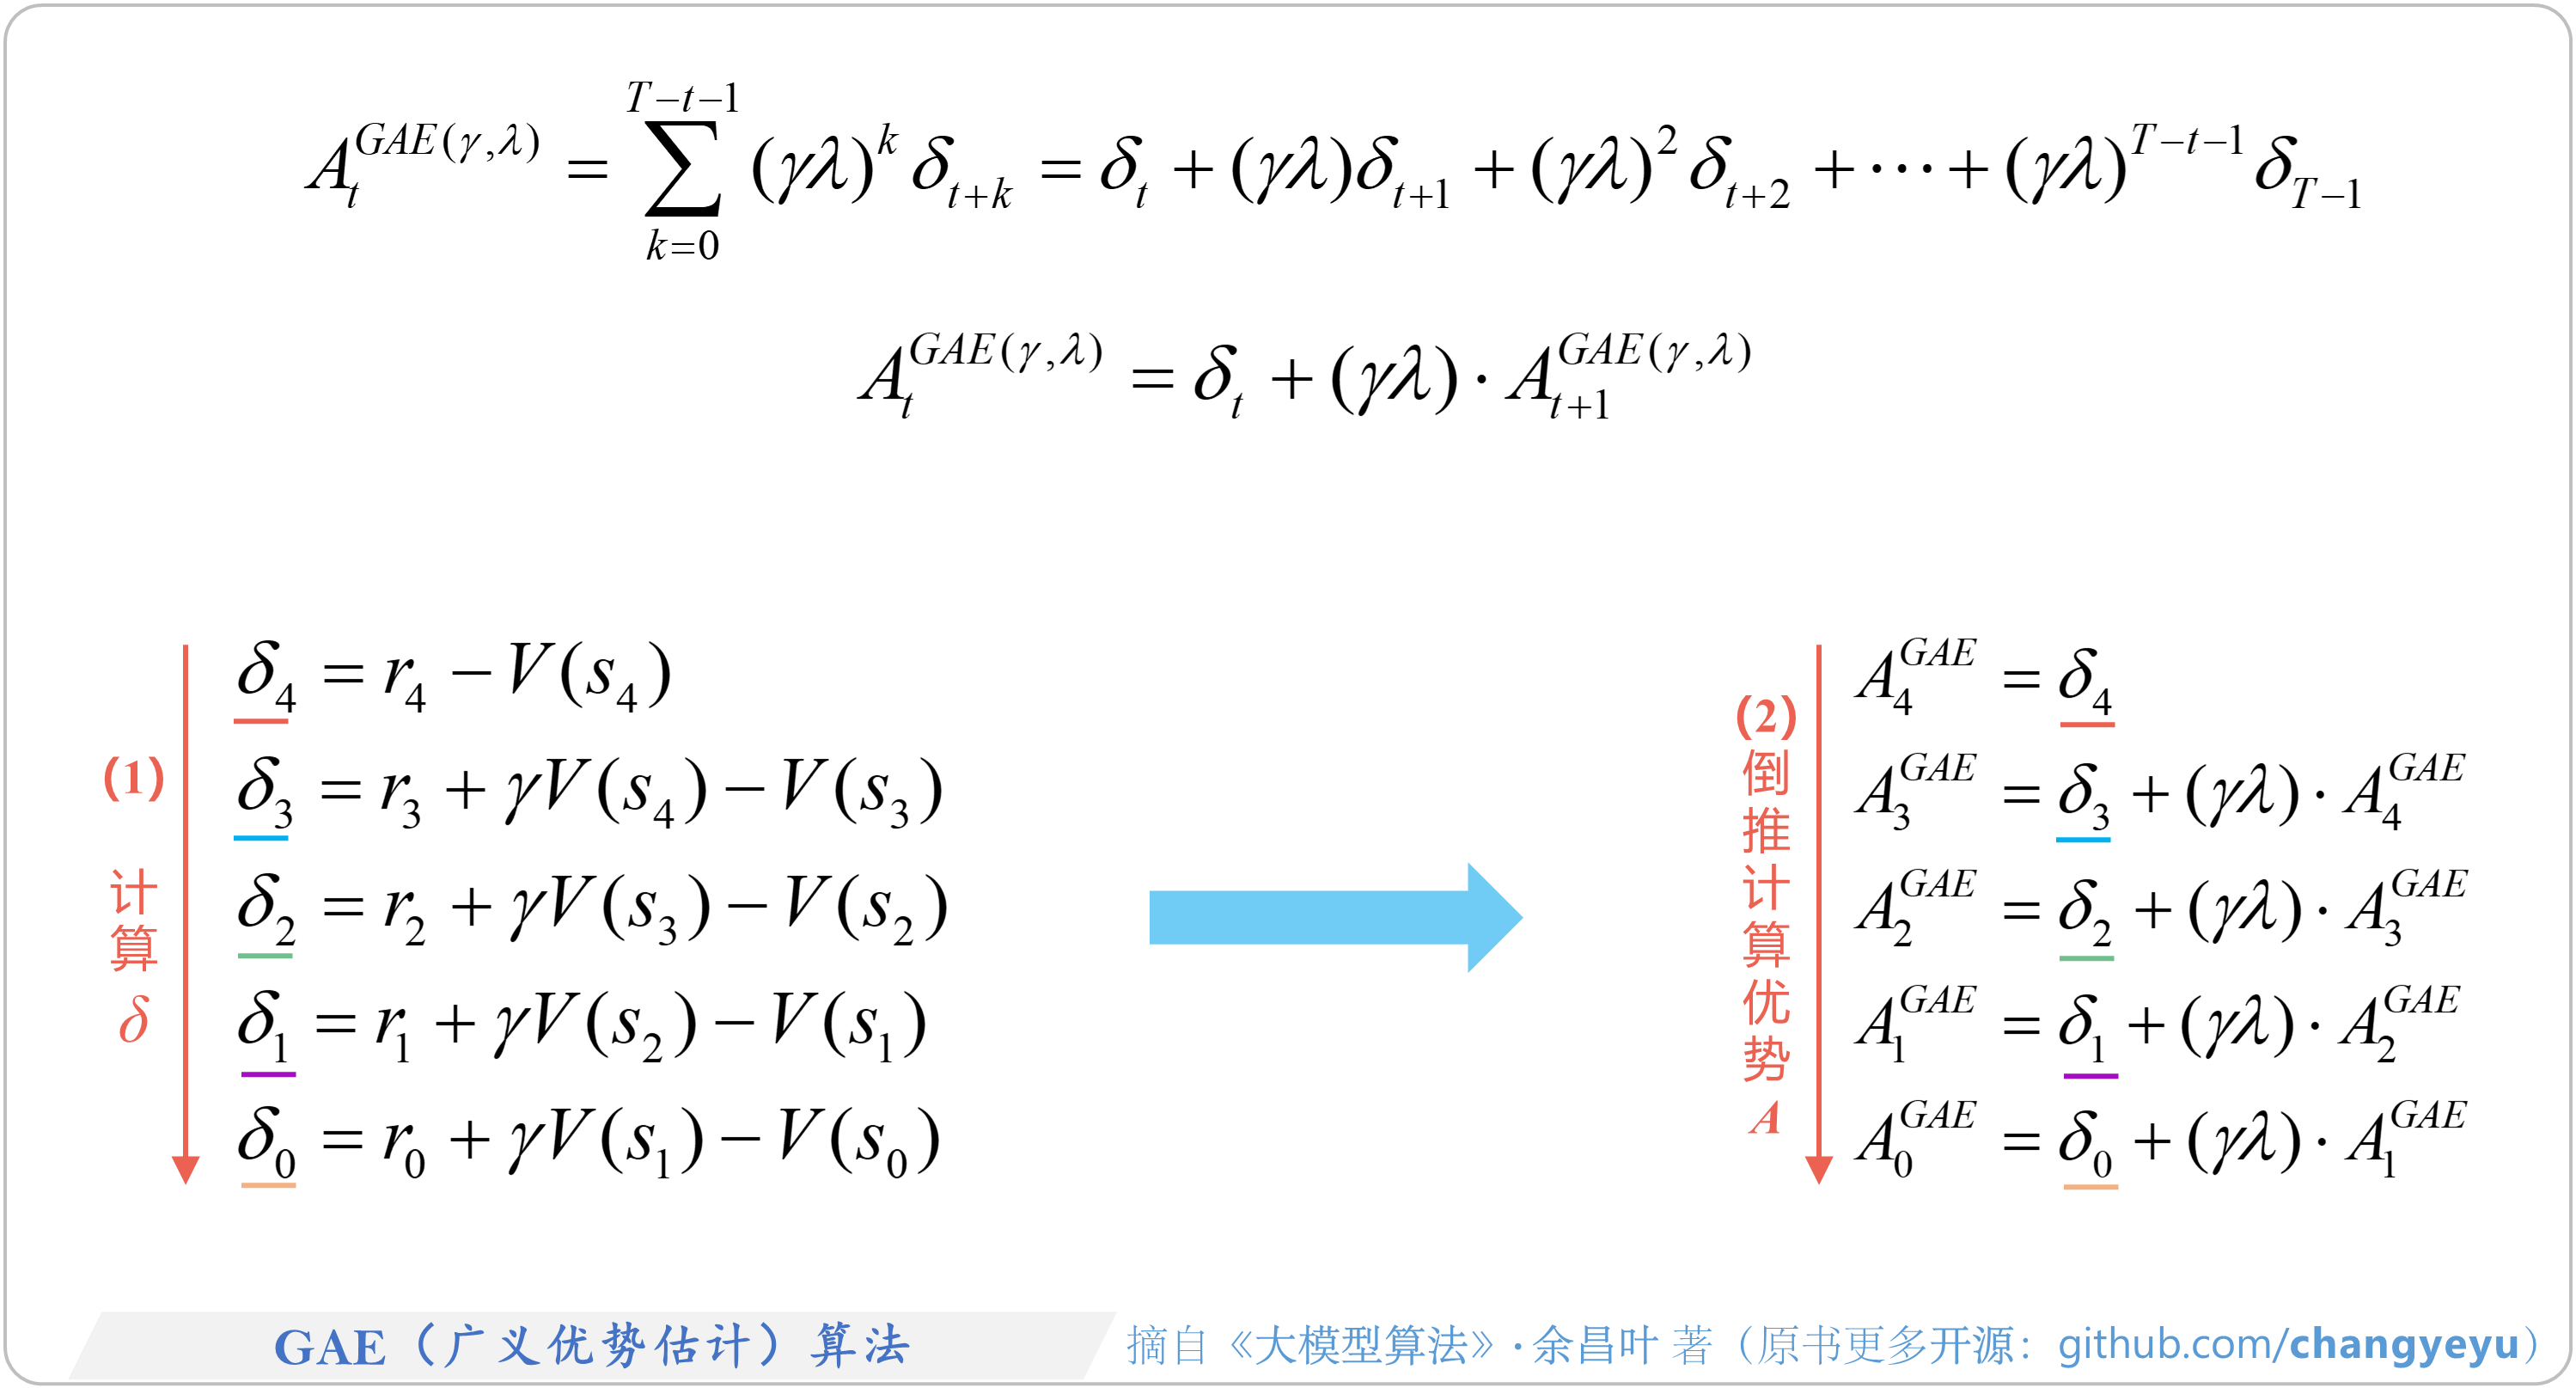
【策略优化架构算法及其衍生】GAE(广义优势估计,Generalized Advantage Estimation)算法
- GAE(Generalized Advantage Estimation, 广义优势估计)算法由RL巨佬John Schulman等发表。该算法是PPO等算法的关键组成部分。
- GAE算法借鉴了TD(λ)算法的思路,(TD(λ)如《大模型算法》5.3.3节所述)。TD(λ)算法通过调节λ因子在偏差和方差之间取得平衡,GAE算法也使用λ因子以达到类似的目的。
- GAE算法计算时,通常采用递归求解的方式进行。
- GAE算法的伪代码如下。算法 6.1 GAE 算法核心实现
import numpy as np

def compute_gae(rewards, values, gamma=0.99, lambda_=0.95):
    """
    参数:
        rewards (list 或 np.ndarray): 每个时间步收集到的奖励 r,形状为 (T,)
        values  (list 或 np.ndarray): 每个状态的价值估计 V,形状为 (T+1,)
        gamma   (float): 折扣因子 γ
        lambda_ (float): GAE 的衰减参数 λ
    返回:
        np.ndarray: 优势估计 A,形状为 (T,)。例如对于 T=5,A=[A0, A1, A2, A3, A4]
    """
    T = len(rewards)            # 时间步数 T,终止时间步为 t=T-1
    advantages = np.zeros(T)    # 优势估计数组,例如 [A0, A1, A2, A3, A4]
    gae = 0                     # 初始化 GAE 累计值为 0

    # 反向从时间步 t=T-1 到 t=0 进行迭代计算,总共迭代 T 次
    for t in reversed(range(T)):
        # δ_t = r_t + γ * V(s_{t+1}) - V(s_t)
        delta = rewards[t] + gamma * values[t + 1] - values[t]
        # A_t = δ_t + γ * λ * A_{t+1}
        gae = delta + gamma * lambda_ * gae
        advantages[t] = gae

    return advantages
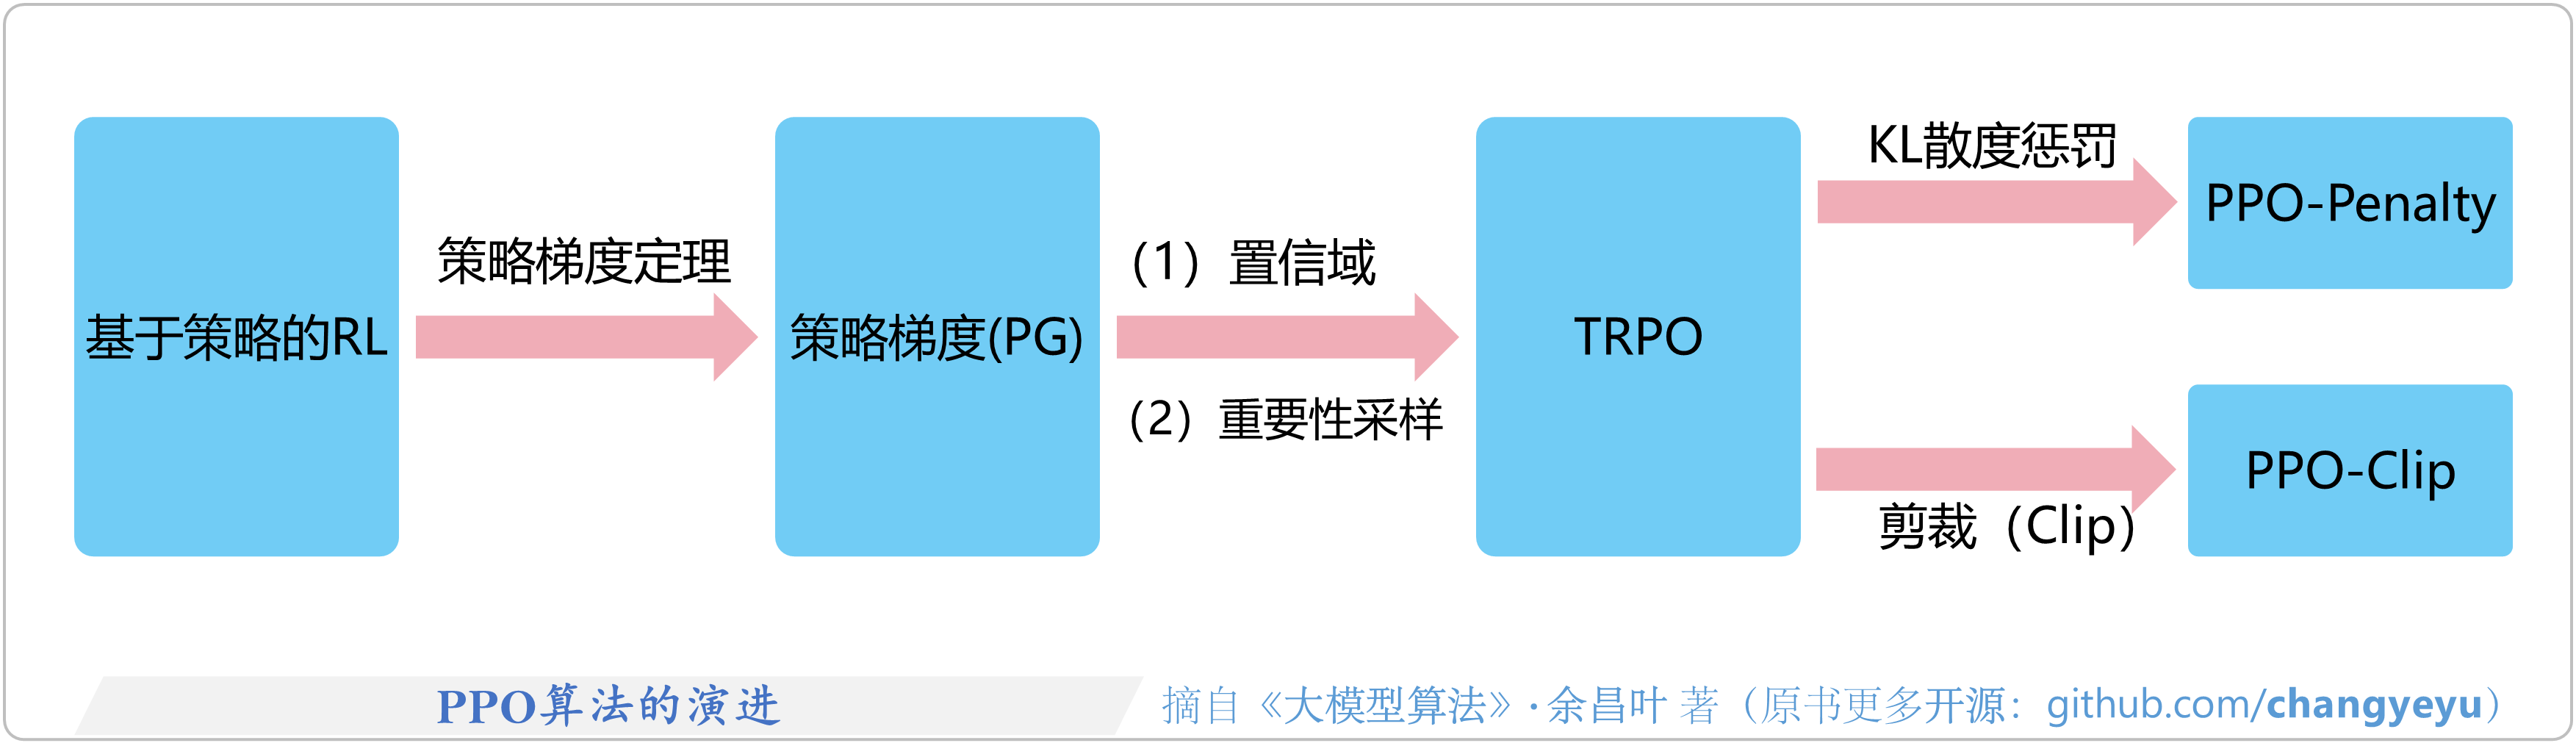
【策略优化架构算法及其衍生】PPO(Proximal Policy Optimization)算法的演进
- PPO(Proximal Policy Optimization,近端策略优化),有多种变体,例如PPO-Penalty和PPO-Clip,这些算法继承了部分TRPO算法的思想。
- PPO-Clip因其更优的效果而获得了更多关注和应用,因此通常所说的PPO即指PPO-Clip。

【策略优化架构算法及其衍生】TRPO(Trust Region Policy Optimization)及其置信域
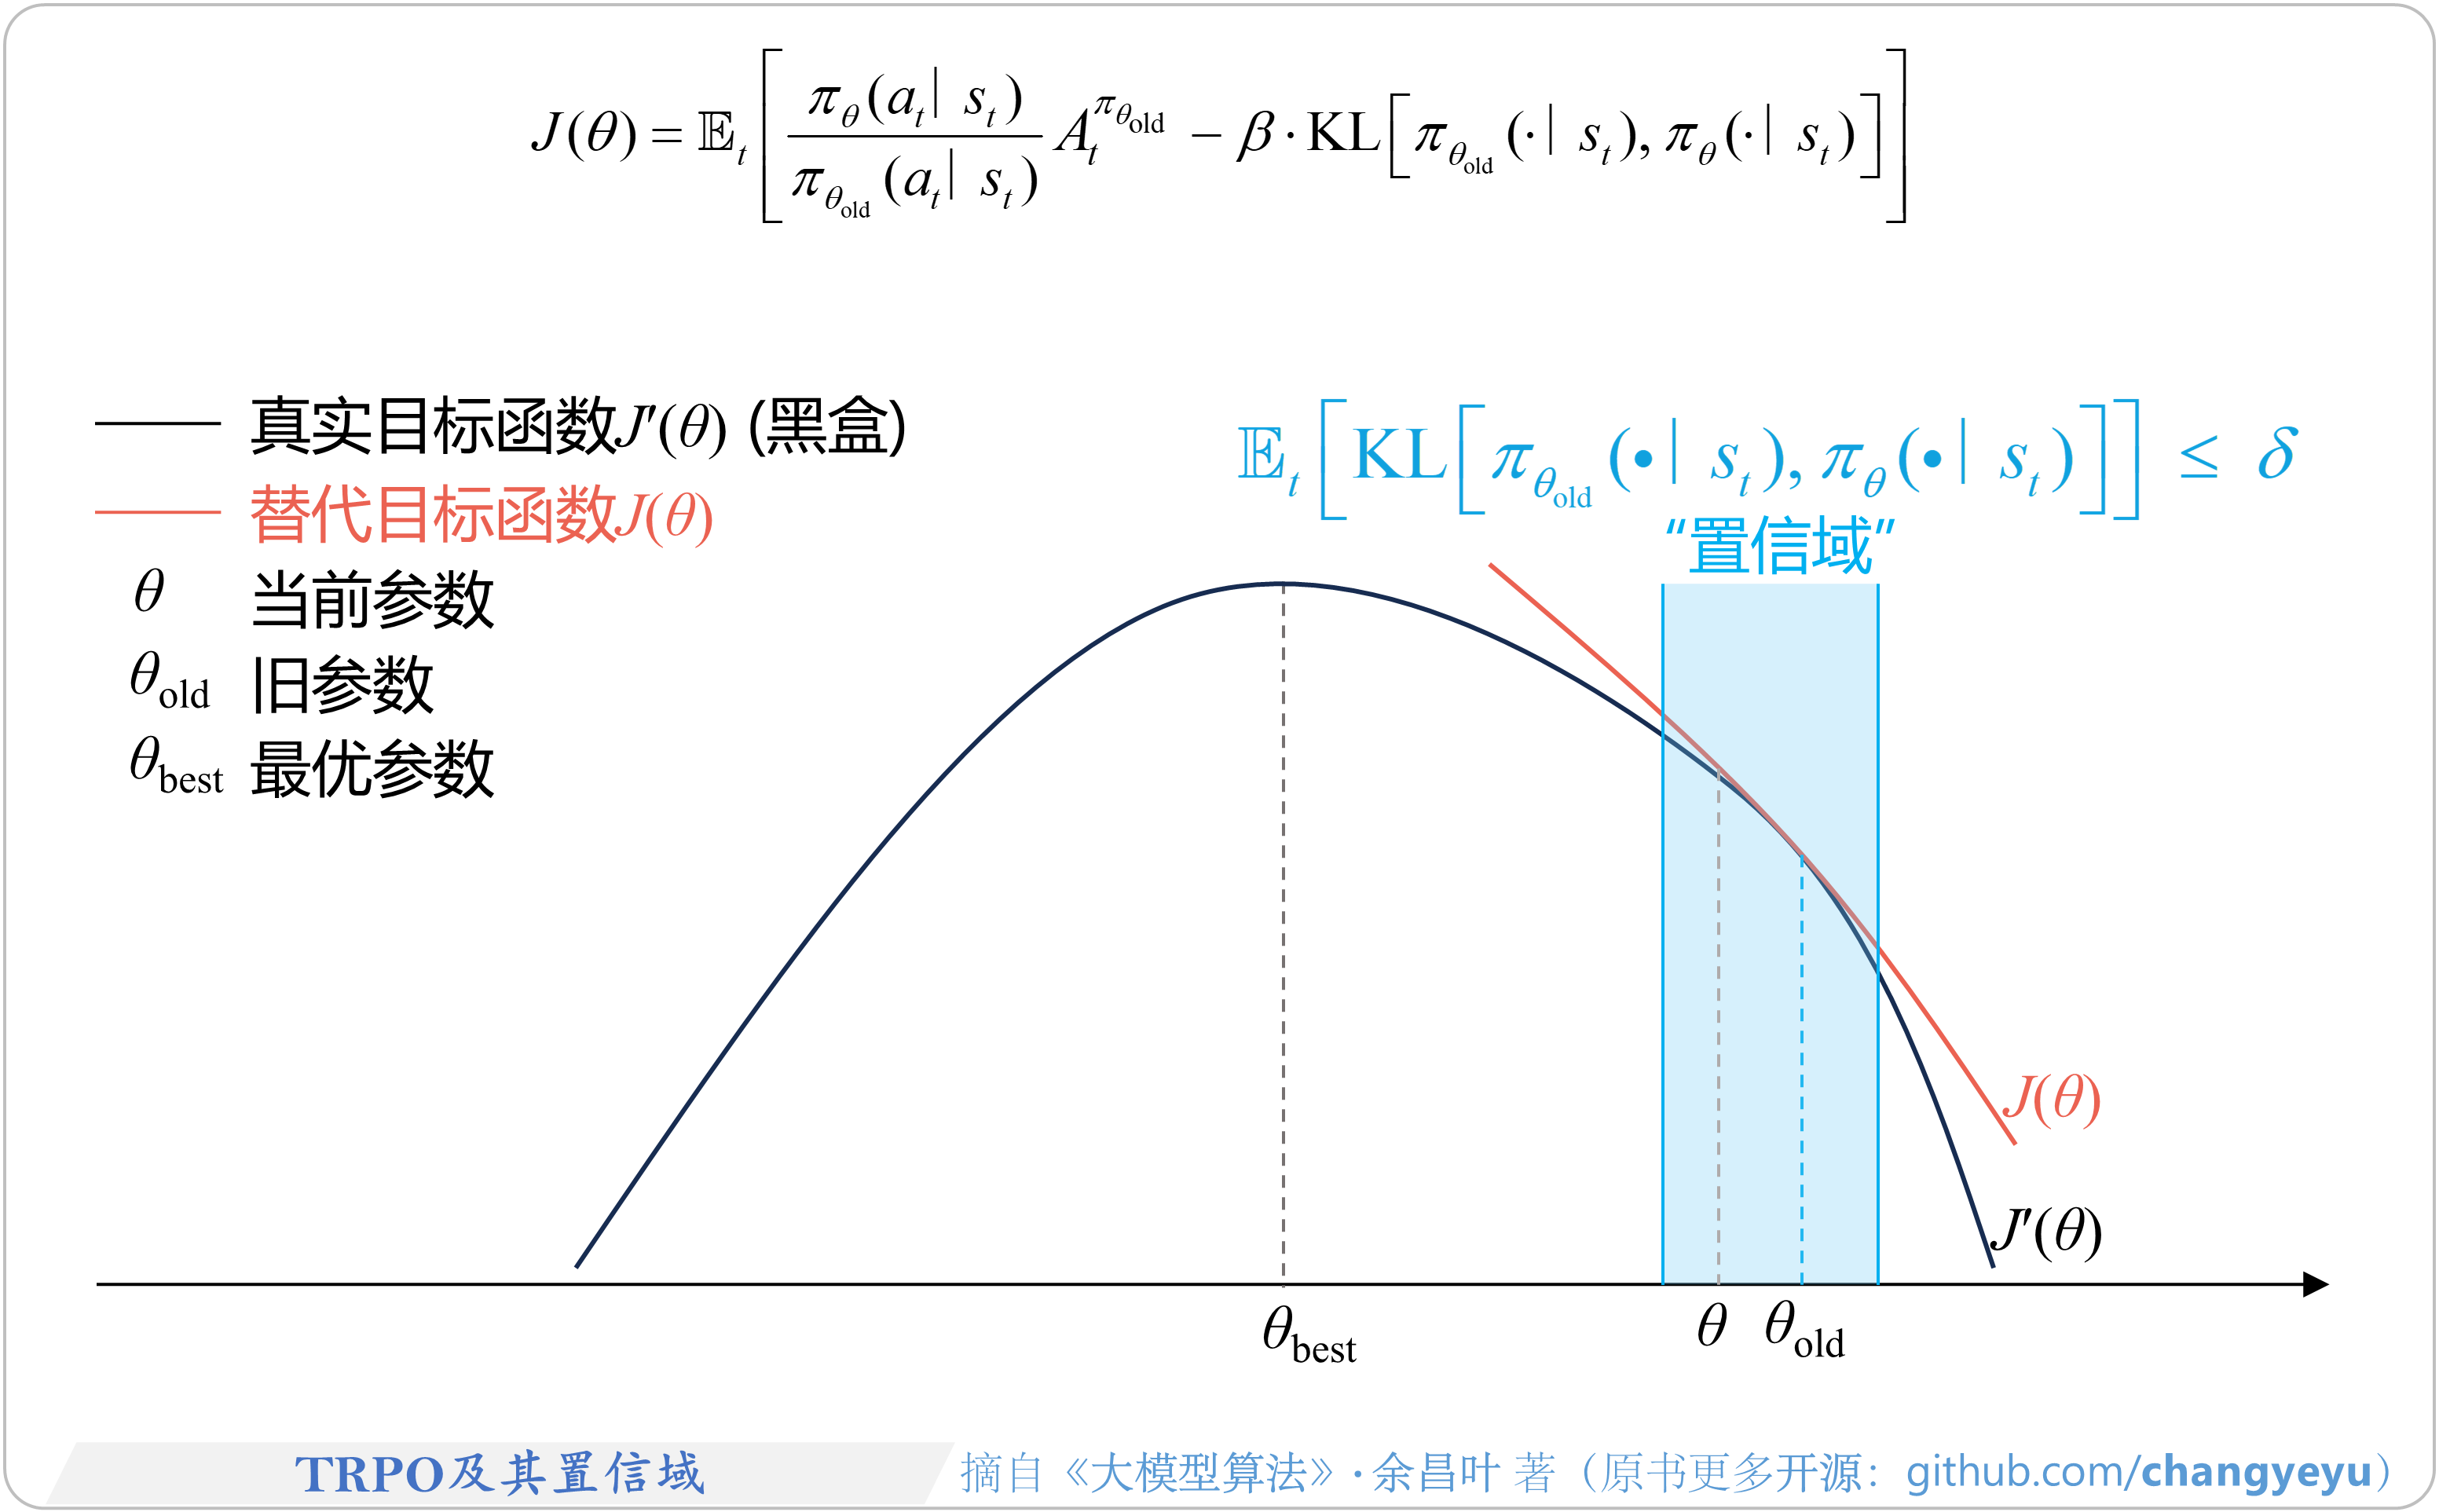
- TRPO(Trust Region Policy Optimization,置信域策略优化),可以说是PPO的前身。
- 该算法是对策略梯度算法的改进,基于两个核心概念:置信域和重要性采样(Importance Sampling)。虽然这两个概念并非在TRPO中首次提出,但TRPO将它们与策略梯度算法相结合,显著提升了算法的效果。
- TRPO的核心思想是在最大化目标函数J(θ)的同时,限制新旧策略之间的差异。

【策略优化架构算法及其衍生】重要性采样(Importance sampling)
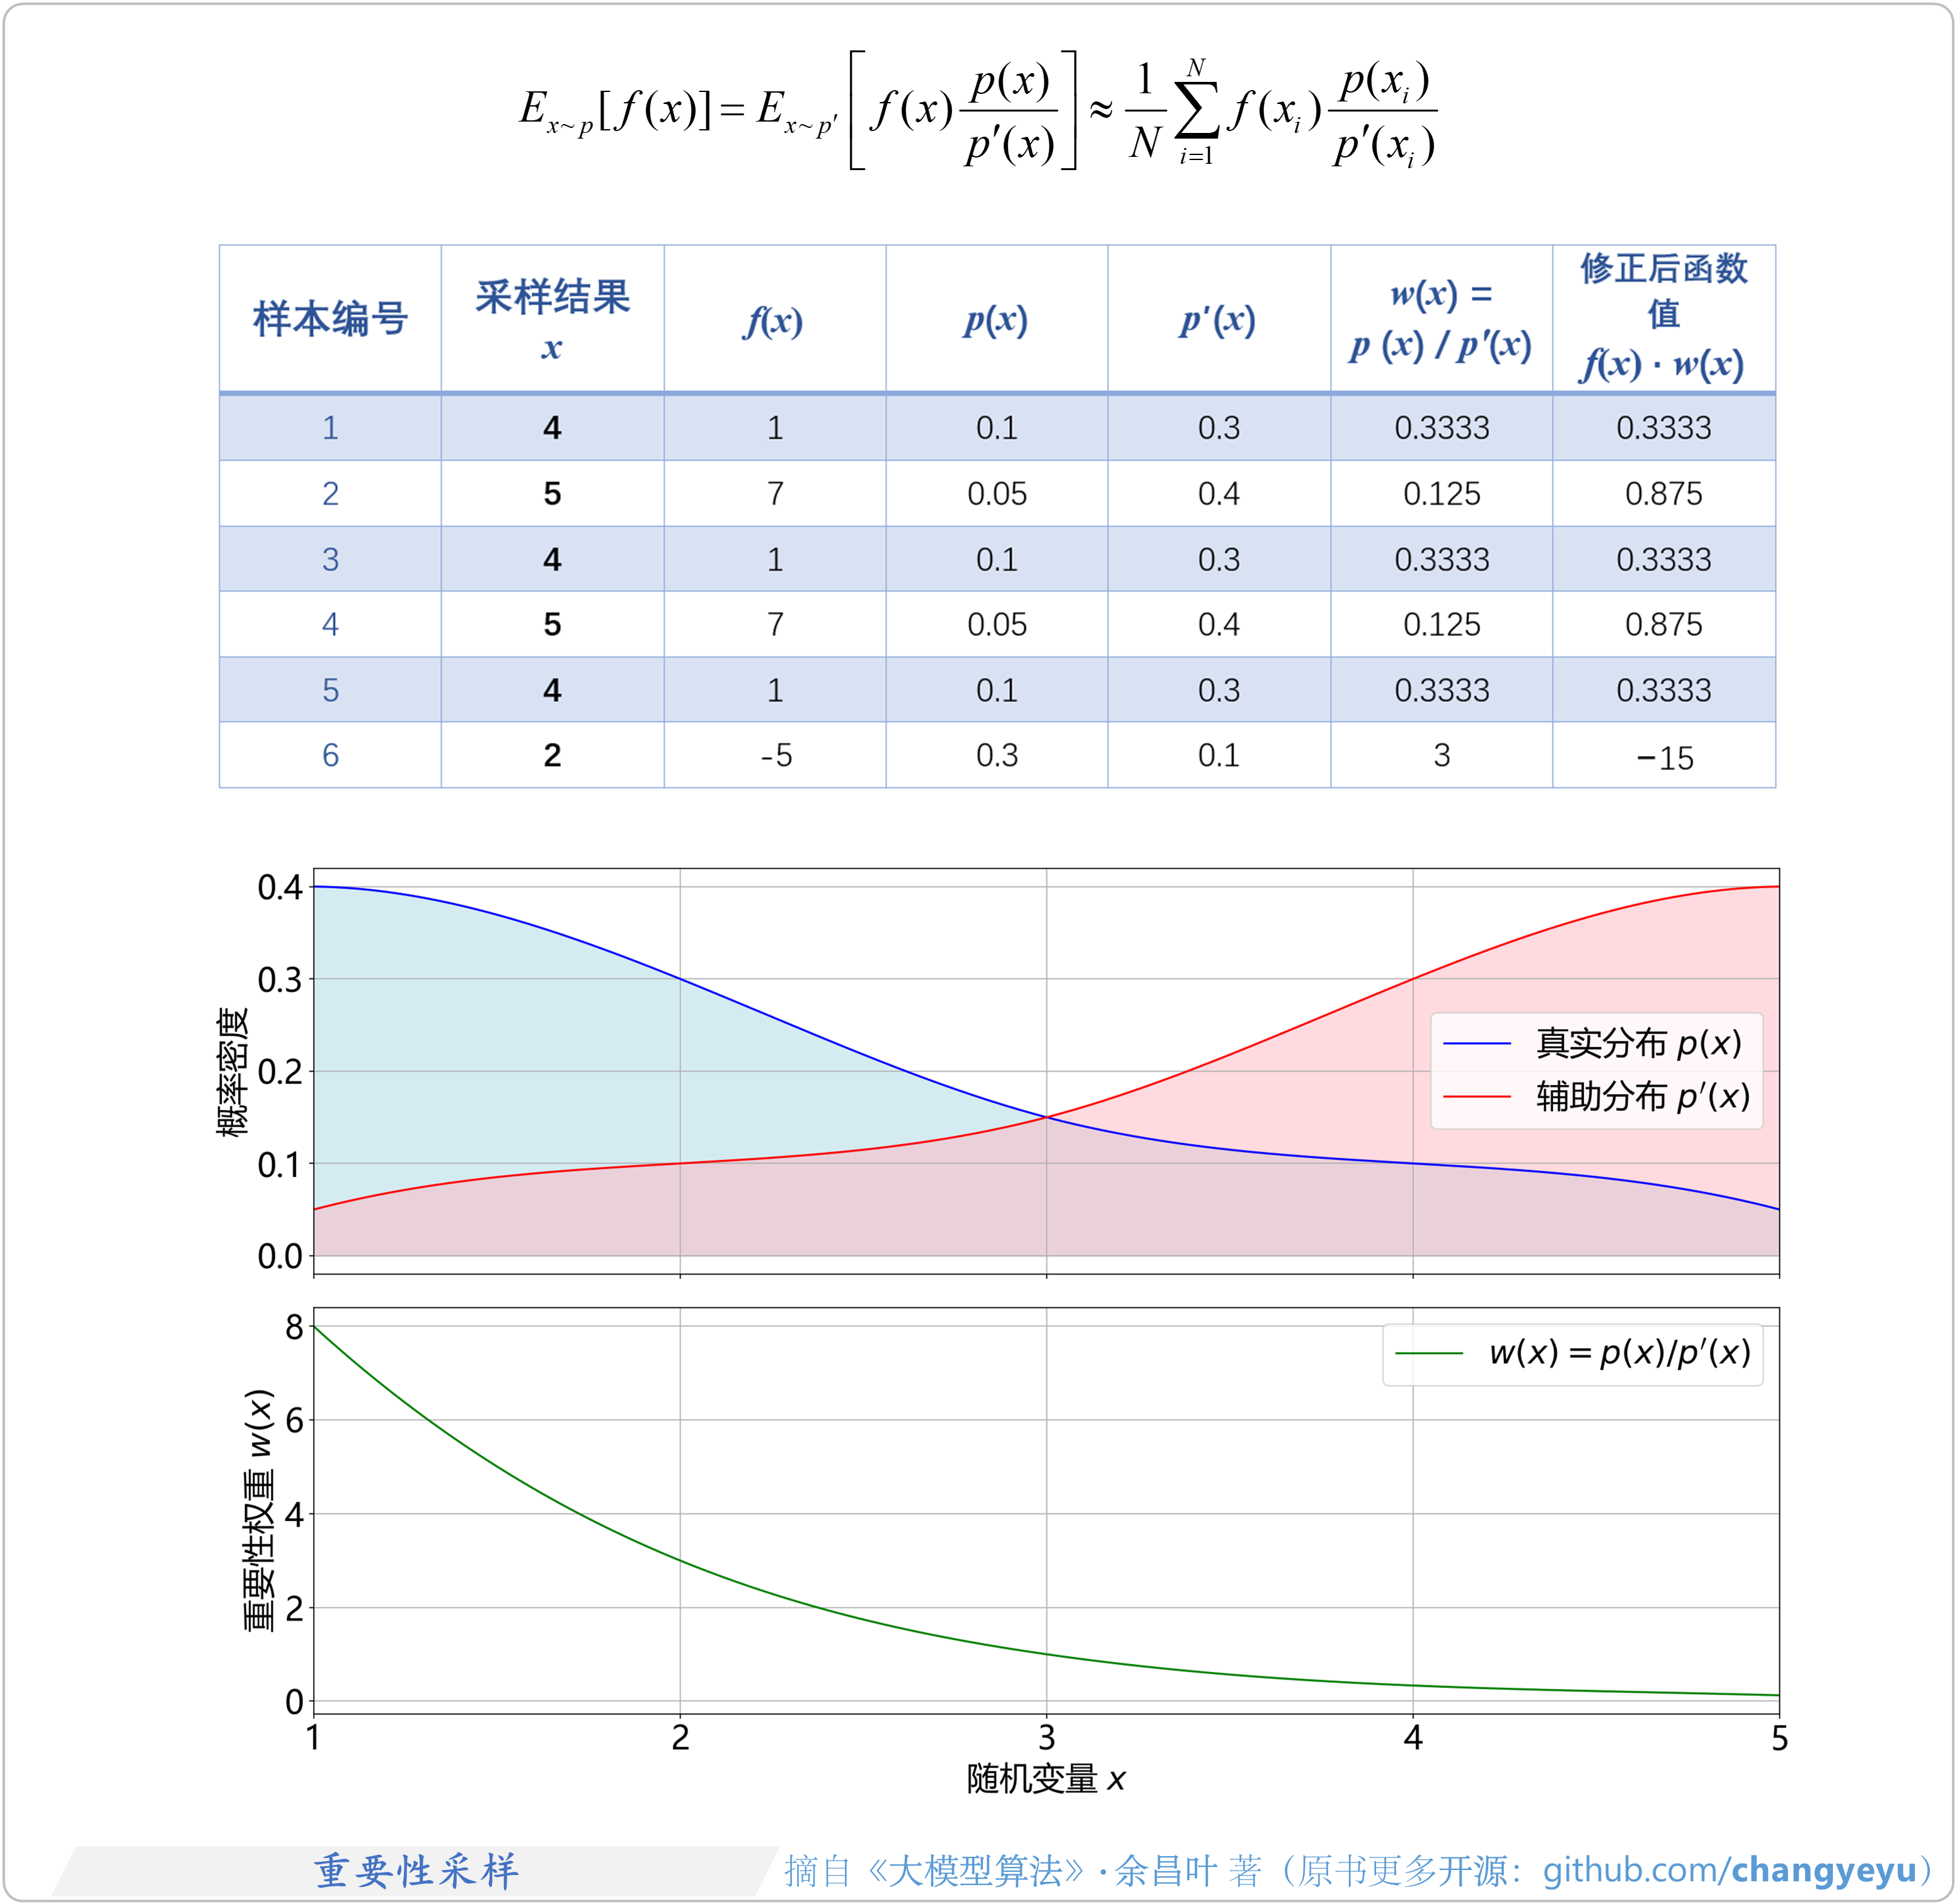
- 重要性采样在诸如TRPO和PPO等强化学习算法中具有关键作用,其主要功能是修正新旧策略之间的分布差异,使得可以利用旧策略所采集的数据来优化新策略。
- 重要性采样(Importance Sampling)是一种基于蒙特卡洛采样思想的方法,经常被用于估计期望值和积分。该方法基于辅助分布进行采样,并通过重要性权重对估计值进行修正,从而提高采样和估计的效率。
- 重要性采样需满足该条件:如果在某个x上p(x)的概率值大于0,那么p'(x)在同一个位置的概率也必须大于0(p'(x)不能为零,意味着该位置在p'(x)中也有可能性)。这是因为如果在p(x)非零的地方p'(x)= 0,那么在这些x上的贡献就无法通过p'(x)来采样计算,一些x的取值会在积分中丢失。

【策略优化架构算法及其衍生】PPO-Clip
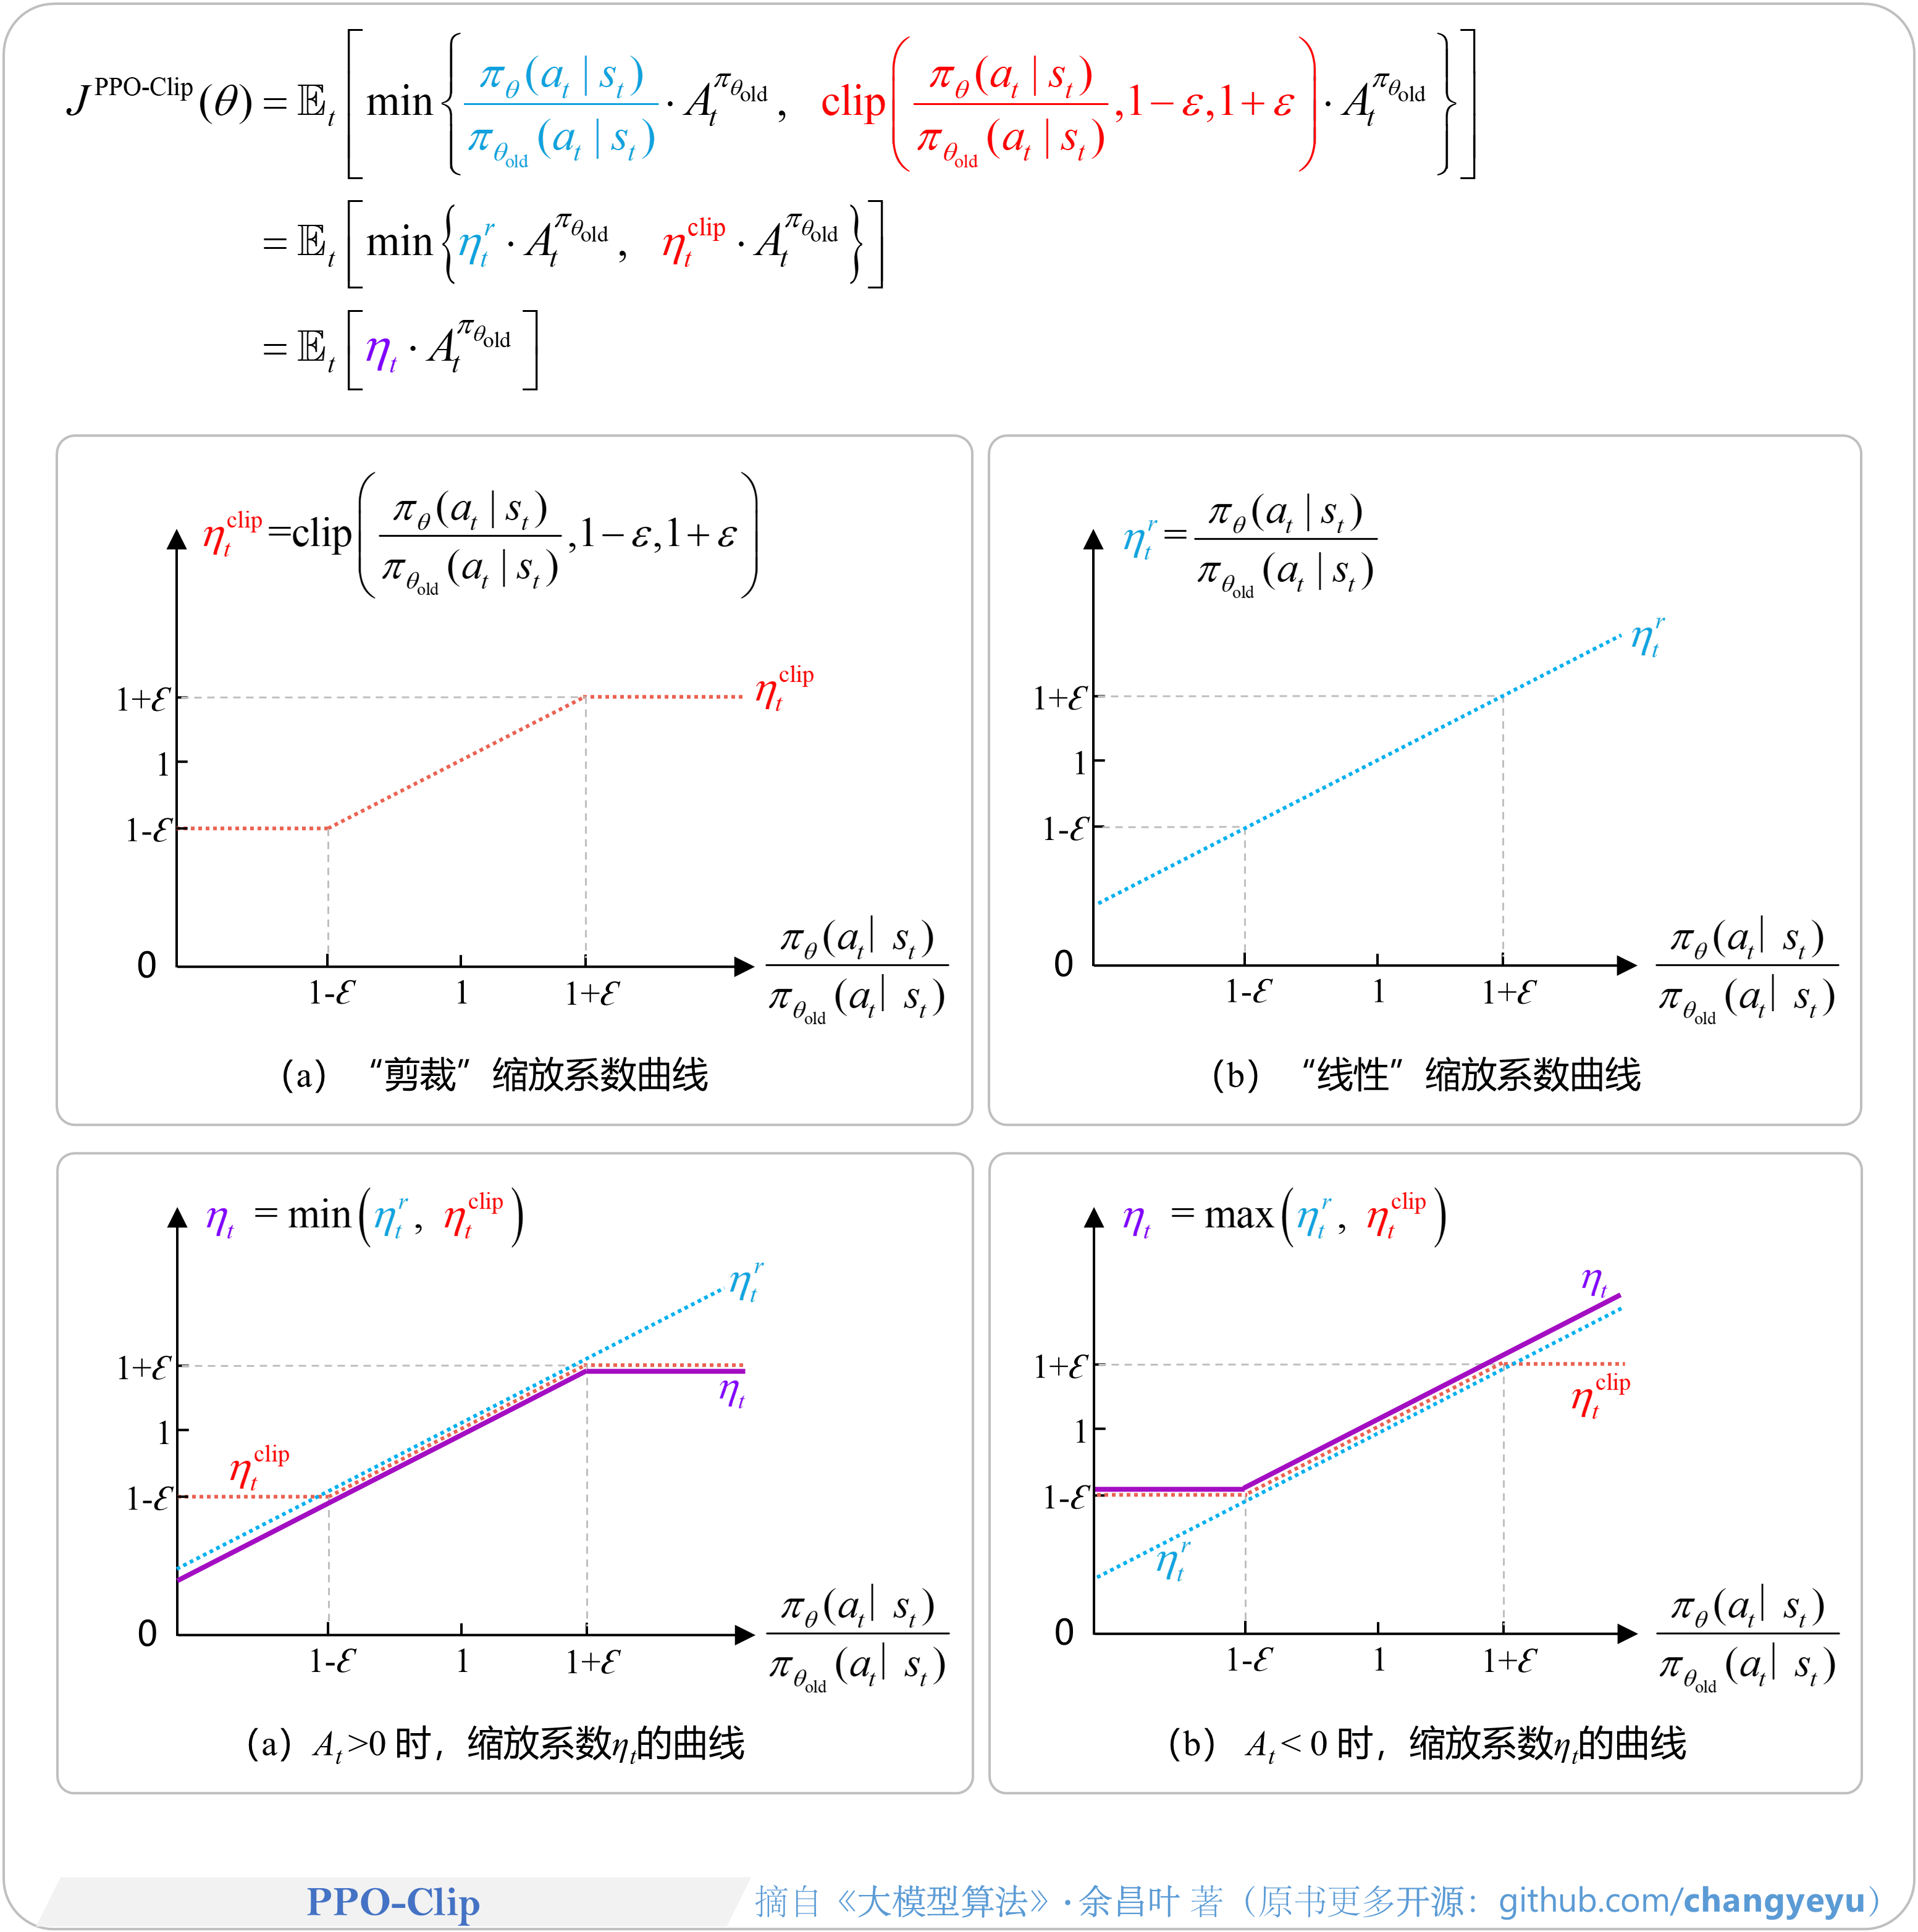
- 通常所说的PPO即指PPO-Clip(近端策略优化-剪裁)。
- PO-Clip的目标是最大化未来回报的期望,具体来说,通过最大化目标函数J(θ)来优化策略,PPO-Clip的目标函数如下图。
- clip与min操作的意义:意义如下图的曲线图,为清晰起见,对式中的部分项用两种缩放系数进行替换,可以分别称为“线性”缩放系数和“剪裁”缩放系数。
【策略优化架构算法及其衍生】PPO训练中策略模型的更新过程
- 如图简要展示了通用场景下PPO的训练流程及策略模型(Actor)参数θ的更新过程,其中价值模型(Critic)未在图中展示。PPO的训练流程主要包括以下两个阶段:
- (1)样本收集:基于旧策略收集样本,生成多条轨迹(经验),并存入回放缓冲区,供后续训练使用。
- (2)多轮PPO训练:将回放缓冲区中的所有样本随机打散,并划分为多个小批次(mini-batches),以便进行小批次训练。针对每个小批次(图中的“批次 1”、“批次 2”),分别进行一次训练与参数更新,总计完成mini_batch次训练。如果设置的ppo_epochs > 1,则重复利用回放缓冲区中的所有样本,再次随机打散并切分为小批次,重复上述训练过程ppo_epochs轮(图中的“第 1 轮”、“第 2 轮”)。通过对这一大批次样本的多轮训练,显著提升了样本的重复利用率。在第二阶段中,总计完成ppo_epochs×mini_batch次训练与参数更新。
- 以上两个阶段不断循环运行,每一次循环称为一个迭代(iteration)。经过多次迭代,直至完成所有PPO训练任务。

【策略优化架构算法及其衍生】PPO的伪代码
# 简写 R:rewards, V:values, Adv:advantages, J:objective, P:probability
for iteration in range(num_iterations):  # 进行num_iterations个训练迭代
    #【1/2】收集样本(prompt, response_old, logP_old, Adv, V_target)
    prompt_batch, response_old_batch = [], []
    logP_old_batch, Adv_batch, V_target_batch = [], [], []
    for _ in range(num_examples):
        logP_old, response_old  = actor_model(prompt)
        V_old    = critic_model(prompt, response_old)
        R        = reward_model(prompt, response_old)[-1]
        logP_ref = ref_model(prompt, response_old)

        # KL距离惩罚。注意:上面的R只取了最后一个token对应的奖励分数
        KL = logP_old - logP_ref
        R_with_KL = R - scale_factor * KL

        # 通过GAE算法计算优势Adv
        Adv = GAE_Advantage(R_with_KL, V_old, gamma, λ)
        V_target = Adv + V_old

        prompt_batch        += prompt
        response_old_batch  += response_old
        logP_old_batch      += logP_old
        Adv_batch           += Adv
        V_target_batch      += V_target

    # 【2/2】多轮PPO训练,多次参数更新
    for _ in range(ppo_epochs):
        mini_batches = shuffle_split( (prompt_batch, response_old_batch,
            logP_old_batch, Adv_batch, V_target_batch), mini_batch_size )

        for prompt, response_old, logP_old, Adv, V_target in mini_batches:
            logits, logP_new = actor_model(prompt, response_old)
            V_new            = critic_model(prompt, response_old)

            # 策略概率比: ratio(θ) = π_θ(a|s) / π_θ_old (a|s)
            ratios = exp(logP_new - logP_old)

            # 计算策略模型Loss
            L_clip = -mean( min( ratios * Adv,
                                clip(ratios, 1 - ε, 1 + ε) * Adv ) )

            S_entropy = mean( compute_entropy(logits) )  # 计算策略的熵

            Loss_V = mean((V_new - V_target) ** 2)   # 计算价值模型Loss

            Loss = L_clip + C1 * Loss_V - C2 * S_entropy # 总损失
            backward_update(Loss, L_clip, Loss_V) # 反向传播; 更新模型参数
【策略优化架构算法及其衍生】PPO与GRPO(Group Relative Policy Optimization) [72]
- GRPO(Group Relative Policy Optimization, 群体相对策略优化)是一种基于策略的强化学习算法,由DeepSeek团队提出,并已在DeepSeek、Qwen等模型的训练中得到应用。
- 传统的PPO方法除了训练策略模型外,还需额外构建一个规模相近的价值网络,这会显著增加计算和显存的开销。
- 如图所示,GRPO摒弃了单独的价值网络,并通过多项改进,在保留PPO核心思想的基础上,显著降低了训练所

MiniCPM-V
OpenBMB·Python
MiniCPM-V 是面壁智能开源的多模态视觉语言模型,能在手机、PC 等本地设备上完成看图、听音和对话交互,无需依赖云端。
多模态+4视觉语言模型
27126+412.1k202505272026-11-09 07:37 UTC

LLaVA
haotian-liu·Python
开源的多模态视觉指令微调模型,让 LLaMA 类大模型能看图对话,效果对标 GPT-4V,适合做图文问答和视觉助手。
视觉指令微调+4视觉语言模型
250772.8kv1.2.02024-08-12 09:52 UTC
screenpipe
screenpipe·Rust
持续录制电脑屏幕和音频,把日常工作流整理成可检索的记录,帮你找出值得自动化的环节,并为 AI 智能体提供上下文。
屏幕录制+4视觉语言模型
22335+762.3kapp-v2.7.1452026-11-10 00:40 UTC

Qwen3-VL
QwenLM·Jupyter Notebook
阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。
多模态大模型+4视觉语言模型
20190+151.9k2026-01-30 04:47 UTC