训练框架
大规模预训练与微调的框架。

统一加载和运行文本、视觉、音频、多模态的预训练模型,覆盖推理与训练,省去为每个模型重写代码的麻烦。
基于 Gradio 的 Stable Diffusion 网页界面,把文生图、图生图、局部重绘等能力做成可视化操作面板,不用写代码就能跑图像生成。
从零用 PyTorch 一步步实现类 ChatGPT 大语言模型,覆盖注意力机制、预训练、指令微调全流程,适合边跑代码边理解 LLM 内部原理。
开源计算机视觉库,提供图像处理、视频分析和深度学习推理的 C++ 接口,是视觉应用开发的基础设施。
老牌开源 OCR 引擎,用 LSTM 识别图片中的文字,支持上百种语言,适合做文档扫描和文本提取。

一套统一接口搞定 100+ 大语言模型和多模态模型的微调,支持 LoRA 等高效训练方式,省去为每个模型单独写训练脚本的麻烦。
用 PyTorch 逐行复现 60 多篇深度学习经典论文,代码旁配注释讲解,涵盖 Transformer、优化器、GAN、强化学习等,适合边读论文边对照实现学习。
面向人类友好的深度学习 API,用 Python 编写,可跑在 TensorFlow、JAX、PyTorch 上,帮开发者快速搭建和训练神经网络。

YOLO 系列官方实现库,一套 PyTorch 代码覆盖目标检测、实例与语义分割、图像分类、姿态估计和目标跟踪,训练到部署全流程打通。
用 5 秒语音样本克隆音色,实时合成任意文本的语音,基于 PyTorch/TensorFlow 的说话人编码与声码器流水线。

基于 PyTorch 的目标检测全家桶,覆盖训练、推理、实例分割、图像分类和模型导出,开箱即用,适合快速落地视觉任务。
一套可复用的计算机视觉工具库,提供目标检测、实例分割、分类等任务的标注处理、指标计算与可视化组件,帮开发者省去重复造轮子的时间。
把纸质文档扫描后自动 OCR、打标签并归档成可全文检索的个人文档管理系统,适合想彻底告别纸质文件柜的人。

分布式 AI 计算引擎,提供核心分布式运行时和一组 AI 库,用来加速机器学习负载、大模型推理与超参搜索。
基于 PyTorch 的深度学习优化库,通过 ZeRO、模型并行和混合专家等技术,让千亿到万亿参数模型的分布式训练与推理更省显存、更高效。
面向 LLM、RAG 和真实 AI Agent 应用的深度教程合集,用 Jupyter Notebook 带你从原理到落地跑通完整案例。
用 LLM 从非结构化文本中抽取结构化信息,并给出精确的原文出处定位和交互式可视化,方便核对抽取结果。

纯 JavaScript 实现的 OCR 库,基于 WebAssembly 在浏览器和 Node.js 中直接识别 100 多种语言的图片文字,无需后端服务。
跨平台机器学习框架,提供可定制的视觉、音频等实时流媒体处理方案,方便在移动端和桌面端搭建低延迟推理管线。
5 秒克隆任意人声,实时合成任意语音,基于 PyTorch 的语音克隆与文本转语音工具。
单次前向传播即可对任意文本做类型化选择、打分和是非判断的非自回归决策引擎,支持100多种语言,并按请求自动路由到合适的检查点。
基于 PyTorch 的扩散模型工具箱,统一加载和训练 Stable Diffusion、FLUX 等模型,做图像、视频、音频生成。
把 ONNX、PyTorch、Keras、CoreML 等格式的神经网络模型直接拖进浏览器就能看结构图,排查模型转换和层连接问题很方便。
Facebook AI Research Sequence-to-Sequence Toolkit written in Python.
输入一个主题,就能自动联网检索并生成带引用的长篇调研报告,省去人工查资料和整理成文的时间。
统一的 PyTorch 训练框架,让同一份代码在单卡到上万张 GPU 上都能跑,免去改代码就能做预训练和微调。
开箱即用的 OCR 工具,支持 80 多种语言和拉丁、中文、阿拉伯、天城文、西里尔等主流文字,几行 Python 代码就能把图片里的文字提取出来。
本地运行的简历匹配与生成工具,用 100+ 大模型解析简历、计算与职位描述的文本相似度,并生成 PDF 和求职信。
基于 PyTorch 的深度学习高层封装库,用少量代码就能训练出高精度模型,配套 notebook 教程降低入门门槛。
DeepSpeech is an open source embedded (offline, on-device) speech-to-text engine which can run in real time on devices ranging from a Raspberry Pi 4 to high power GPU servers.
基于 CTranslate2 重实现的 Whisper 语音转文字推理引擎,通过量化与高效推理大幅提速并降低显存占用,适合本地部署转录。
配套 B 站视频教程的深度学习图像处理实战代码库,用 PyTorch 和 TensorFlow2 覆盖图像分类、目标检测与分割的完整训练流程。
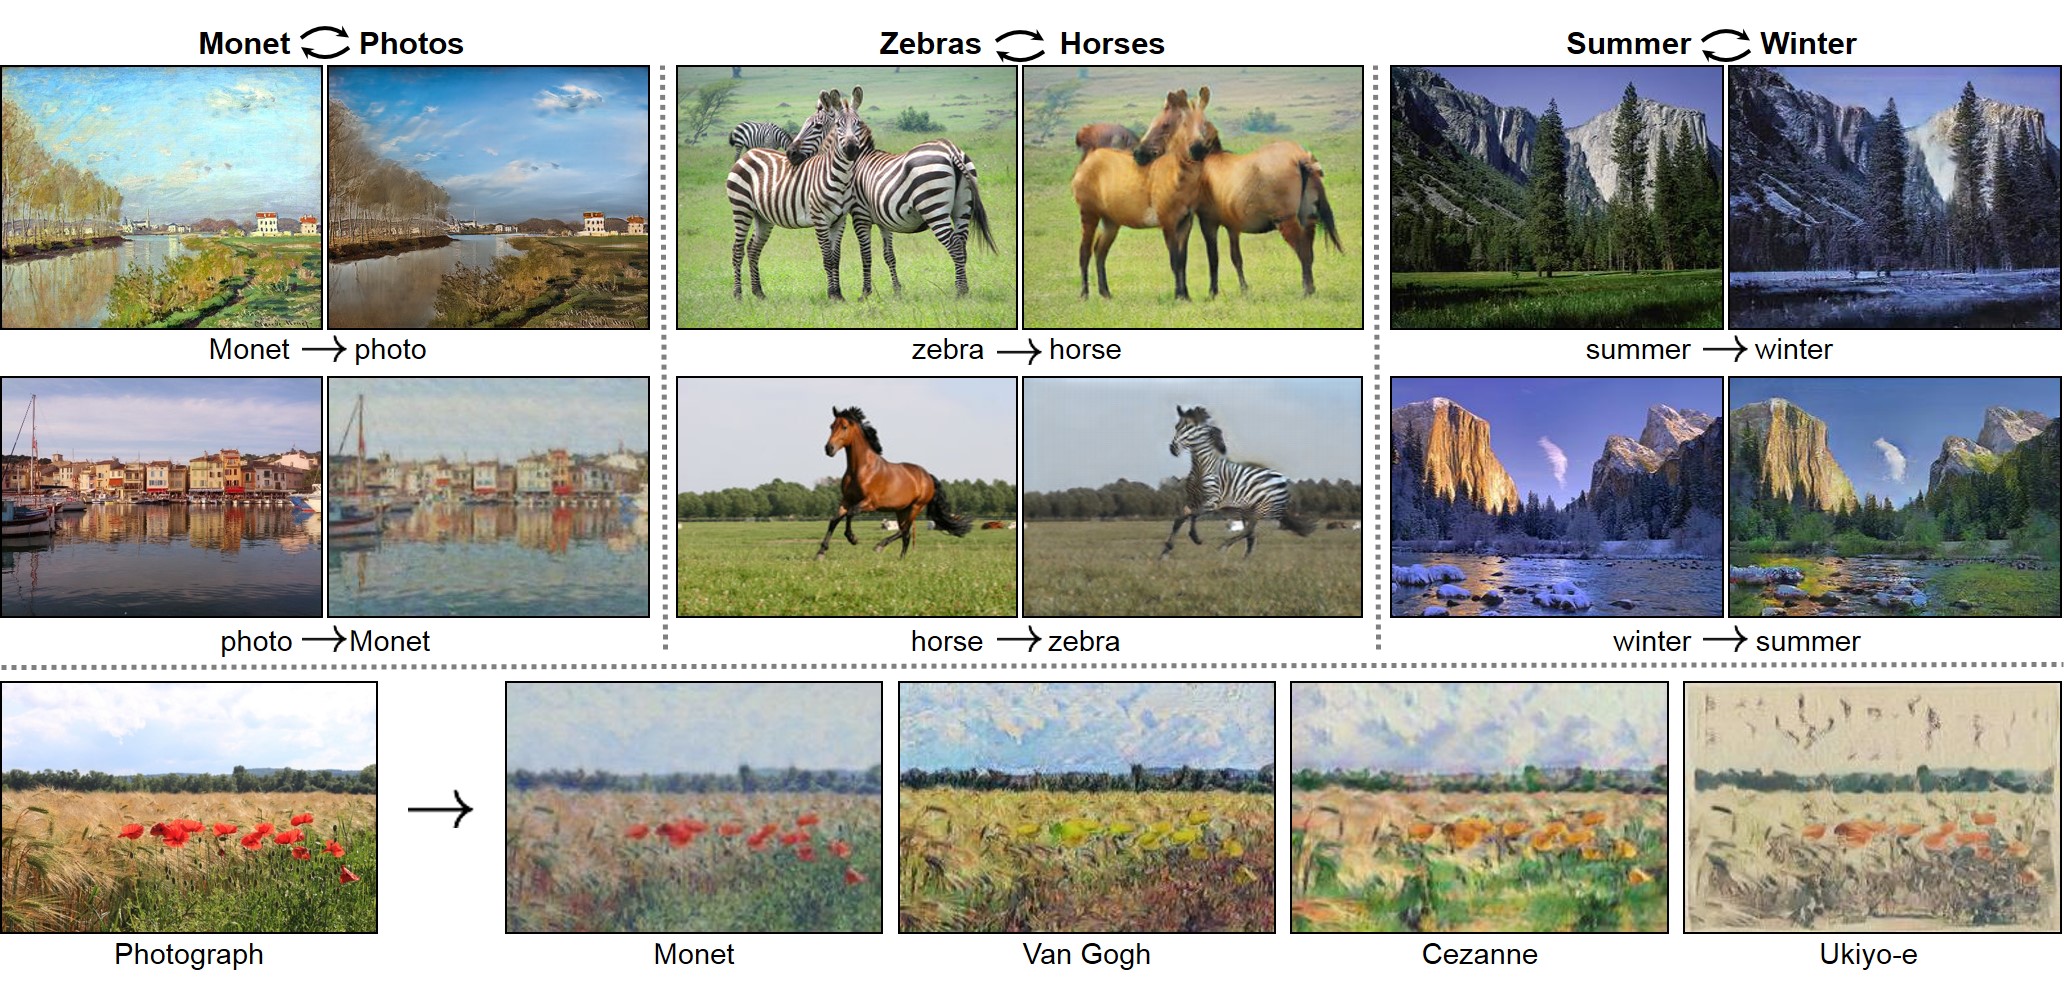
PyTorch 版 CycleGAN 与 pix2pix 实现,提供图像到图像翻译的完整训练与测试流程,支持无配对和有配对数据转换。
汇集土堆 PyTorch、李沐《动手学深度学习》、吴恩达深度学习和大模型 Agent 四套课程的中文笔记,适合系统入门深度学习与大模型应用开发。
面向手机端的高性能神经网络推理框架,针对 ARM 平台深度优化,让 Caffe、ONNX 等模型能在 Android/iOS 上低延迟运行。

每周更新的机器学习 Python 库排行榜,按类别和评分整理优质库,帮你快速找到 AutoML、深度学习、数据可视化等方向的趁手工具。
汇总 CVPR 2026 录用论文及其配套开源代码,方便计算机视觉研究者快速找到带实现的新工作并跟进复现。
汇总可私有化部署的中文大语言模型资源清单,覆盖小规模底座模型、垂直领域微调、数据集与教程,方便低成本选型落地。
持续录制电脑屏幕和音频,把日常工作流整理成可检索的记录,帮你找出值得自动化的环节,并为 AI 智能体提供上下文。

跨平台高性能推理与训练加速引擎,可直接加载 ONNX 模型,兼容 PyTorch、TensorFlow 等框架导出,解决模型在不同硬件上高效部署的问题。
微软出品的推荐系统实践库,提供从数据准备、模型训练到部署上线的完整示例和最佳实践,帮算法工程师快速搭建推荐与排序模型。
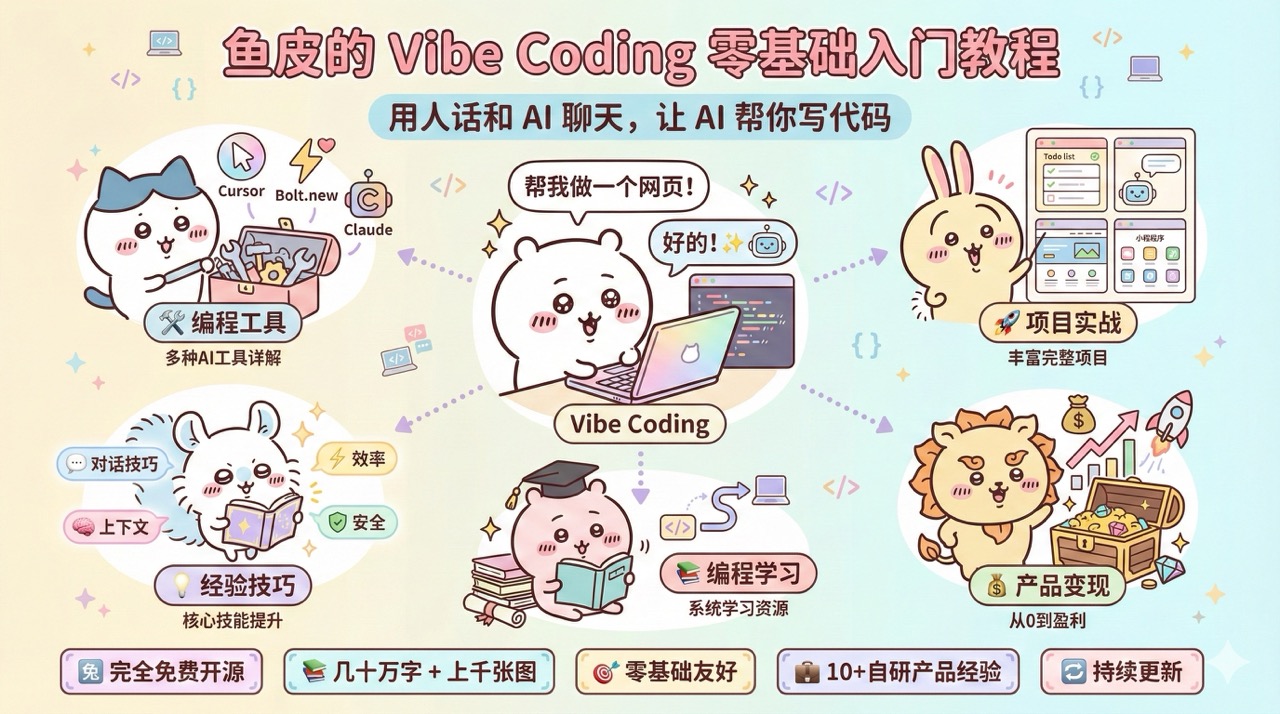
程序员鱼皮整理的 AI 资源大全与零基础教程,涵盖大模型玩法、Prompt 提示词、AI 编程工具和开发框架,帮新手快速上手 AI 技术。

ONNX 是开放的机器学习模型交换格式标准,让 PyTorch、TensorFlow、Keras 等框架训练出的模型能互相转换、跨平台部署。
开源金融大语言模型,提供训练好的模型和微调流程,用于金融情感分析、智能投顾等场景。
一份精选的机器学习生产化开源工具清单,覆盖模型部署、监控、版本管理和规模化扩展,帮你快速找到 MLOps 各环节的趁手工具。

一套纯 Markdown 的轻量技能包,让 Claude Code、Codex 等 LLM 智能体在无人值守时自主完成机器学习研究:跨模型评审、想法发现与实验自动化。
用深度学习快速准确地识别文件真实类型,不依赖扩展名,支持 MIME 检测,Rust 实现,可嵌入各类应用做内容安全与文件分类。

面向企业私有化部署的 AI 平台,可搭建智能体、助手和文档检索问答,支持多模型接入、深度研究与 API 连接。
NVIDIA 的大规模 Transformer 训练框架,支持张量并行、流水线并行等模型并行策略,用来在成百上千张 GPU 上高效预训练大语言模型。
汇总 GitHub 上 PyTorch 相关的模型、实现、辅助库和教程,帮你在一个清单里快速找到需要的深度学习资源。
用 PyTorch 从零实现的轻量级 vLLM,代码精简易读,适合学习大模型推理引擎的调度、KV Cache 和 PagedAttention 等核心机制。
Rust 写的张量库和深度学习框架,兼顾灵活性与效率,支持自动微分、跨平台后端和内核融合,可训练和部署神经网络。
一站式大模型训练框架,支持 600+ 纯文本大模型和 300+ 多模态大模型的 CPT、SFT、DPO、GRPO 等训练,可用 LoRA 等 PEFT 方式或全参数微调。
在 Google Colab 上一键跑起 Stable Diffusion WebUI 的笔记本合集,省去本地显卡和环境配置,直接在线出图、图生图、训练 LoRA 和 DreamBooth。
把 PDF、DOCX、图片等复杂文档解析成干净结构化数据,方便喂给语言模型做 RAG 和检索。
DataTalks.Club 出品的免费 MLOps 实战课程,覆盖模型部署、监控和工作流编排,帮你把机器学习模型从实验推到生产环境。
Fast and flexible image augmentation library. Paper about the library: https://www.mdpi.com/2078-2489/11/2/125
开源平台,用于构建和部署基于 GPT/LLM 的对话式 Agent,集成提示词编排、工具调用与多渠道发布,省去从零搭建对话机器人的重复工作。
RWKV 是一种兼具 RNN 与 Transformer 优势的语言模型架构,支持像 GPT 一样并行训练,推理时线性时间、常量显存、无限上下文,无需 KV 缓存。
基于 PyTorch 的轻量级 NLP 框架,几行代码就能完成命名实体识别、词性标注、语义角色标注等序列标注任务的训练与微调。