本项目功能未完善且未通过网络安全测评,请勿在生产环境使用;声纹识别需单独部署 voiceprint-api 服务并依赖 MySQL;本地 FunASR 较耗内存,低配环境建议全部走 API。
xiaozhi-esp32-server
xinnan-techMIT活跃维护为小智 ESP32 语音助手提供后端服务,快速搭建设备控制服务器,集成 Dify 与 MCP 能力。
本项目为xiaozhi-esp32提供后端服务,帮助您快速搭建ESP32设备控制服务器。Backend service for xiaozhi-esp32, helps you quickly build an ESP32 device control server.
v0.9.8发布于 2026-10-23 10:54 UTC11,235star +41 / 7 天3,825fork同步于 2026-11-10 17:29 UTC
docker 部署见 docs/Deployment.md 与 docs/Deployment_all.md,README 未给出可直接复制的最小命令 硬件要求按 README 说明
README 未说明具体显存或 GPU 型号要求;本地跑 FunASR 较耗内存,全部走 API 时资源占用低;全模块安装另需数据库资源。
为 xiaozhi-esp32 硬件提供自建后端服务,让你独立搭建 ESP32 语音助手服务器
为小智 ESP32 语音助手提供后端服务,快速搭建设备控制服务器,集成 Dify 与 MCP 能力。
核心能力
- 基于 MQTT+UDP 网关、WebSocket、HTTP 提供控制台与认证
- 支持流式 ASR、流式 TTS 与 VAD 语音活动检测
- 支持声纹注册识别,与 ASR 并行传递说话人身份给 LLM
- 接入多种 LLM/VLLM,支持函数调用意图识别与 MCP 工具
- 提供 Web 智控台管理用户、设备与系统配置
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
- v0.9.8最新正式版2026-10-23 · 2026-10-23 10:54 UTC
- 修复通讯录越权:读取、改别名、授权、解绑一律先校验设备归属,不属于当前用户的设备一律按查不到处理
- 修复 edge-tts 自 2026 年 10 月起被微软返回 403 造成的失声问题
- 修复已登录状态下仍能进入登录、注册等白名单页面的问题,路由守卫改为反向匹配
- 根治火山双流 TTS 的 4 个会话协议与监听竞态问题:会话等待 SessionStarted 确认、监听任务隔离跨连接、二进制协议解析四处修正、句尾替换词残留提前下发
- 修复 TTS 分句在引号内切开句子,引号被拆到两段或留下孤立标点
- 修复 SenseVoice 日语识别结果按词带空格,日文对话历史不再夹杂多余空格
- 唤醒词音频直接转 wav,跳过二次编解码;唤醒词缓存里保留的音频文件也能正常播放
- 管理端弹框统一为大弹框样式并收口宽高,关闭后可再次打开;7 处下拉框支持输入筛选;召回测试、切片、聊天记录弹框样式统一,回车不再刷新页面
- 修复临时事件循环结束后 HTTP 客户端未释放;管理端接口客户端生命周期对齐业务请求,重试内复用连接、safe_close 可打断重试
- 修复 pydub 找不到 ffmpeg,探针改为绑定当前解释器同目录的完整版 ffmpeg
- v0.9.72026-09-29 · 2026-09-29 02:04 UTC
查看更新说明
- 快照对话框新增代码对比视图,支持
v-code-diff斜体样式兼容与窄屏适配 - 阿里百炼 TTS 支持 workspace endpoints 与流式字幕同步
- 参数管理按命名空间聚合展示,支持分页拉全量并重置空态全选
- 豆包模型更新为
doubao-seed-2-0-lite-260215,DeepSeek 改为deepseek-v4-flash并关闭思考模式 - 合并 HA 设备控制插件为
hass_state模块,修复模块级插件展开与函数同名遗漏问题 - 根治
ManageApiClient单例 TOCTOU 竞态,修复连接池创建竞态与safe_close()空指针风险
- 快照对话框新增代码对比视图,支持
- v0.9.62026-07-24 · 2026-07-24 03:41 UTC
查看更新说明
- 在服务端增加了AEC(声学回声消除)功能,从此以后,单麦设备在编译环节开启了服务端AEC,也能实时打断了。消除了以往只有双麦设备才能实时打断的局限
- 增加智能体快照的历史记录功能,害怕提示词丢失的问题,得到缓解
- 解决了设备在跨时区使用时的时间显示和在线状态不一致的问题
- 优化了声纹称呼的提示词和注入逻辑,减少了模型每次回答都带说话人信息的情况
- v0.9.52026-06-30 · 2026-06-30 05:16 UTC
查看更新说明
- 优化智控台UI主题
- 优化基础系统提示词
- 增加mimimax超自然
粤语音色 - 修复已知漏洞
- v0.9.42026-06-03 · 2026-06-03 01:11 UTC
查看更新说明
- 增加设备之间相互呼叫,
网络电话功能 - 新增了
web_search联网搜索工具 - 将原来的测试页面
test_page独立成digital-human数字人模块,该模块具备唤醒对话功能 - 修复了一些bug
- 增加设备之间相互呼叫,
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。

适用人群 👥
本项目需要配合 ESP32 硬件设备使用。如果您已经购买了 ESP32 相关硬件,且成功对接过虾哥部署的后端服务,并希望独立搭建自己的
xiaozhi-esp32 后端服务,那么本项目非常适合您。
想看使用效果?请猛戳视频 🎥
警告 ⚠️
1、本项目为开源软件,本软件与对接的任何第三方API服务商(包括但不限于语音识别、大模型、语音合成等平台)均不存在商业合作关系,不为其服务质量及资金安全提供任何形式的担保。 建议使用者优先选择持有相关业务牌照的服务商,并仔细阅读其服务协议及隐私政策。本软件不托管任何账户密钥、不参与资金流转、不承担充值资金损失风险。
2、本项目功能未完善,且未通过网络安全测评,请勿在生产环境中使用。 如果您在公网环境中部署学习本项目,请务必做好必要的防护。
部署文档

本项目提供两种部署方式,请根据您的具体需求选择:
🚀 部署方式选择
| 部署方式 | 特点 | 适用场景 | 部署文档 | 配置要求 | 视频教程 |
|---|---|---|---|---|---|
| 最简化安装 | 智能对话、单智能体管理 | 低配置环境,数据存储在配置文件,无需数据库 | ①Docker版 / ②源码部署 | 本地跑 FunASR 较耗内存,全部走 API 时资源占用低 | - |
| 全模块安装 | 智能对话、多用户管理、多智能体管理、智控台界面操作 | 完整功能体验,数据存储在数据库 | ①Docker版 / ②源码部署 / ③源码部署自动更新教程 | 本地跑 FunASR 较耗内存,另需数据库资源,全部走 API 时资源占用低 | 本地源码启动视频教程 |
常见问题及相关教程,可参考这个链接
💡 提示:以下是按最新代码部署后的测试平台,有需要可烧录测试,并发为6个,每天会清空数据。
智控台地址: https://2662r3426b.vicp.fun
智控台(h5版): https://2662r3426b.vicp.fun/h5/index.html

服务测试工具: https://2662r3426b.vicp.fun/test/
OTA接口地址: https://2662r3426b.vicp.fun/xiaozhi/ota/
Websocket接口地址: wss://2662r3426b.vicp.fun/xiaozhi/v1/
🚩 配置说明和推荐
[!Note] 本项目提供两种配置方案:
入门全免费配置:适合个人家庭使用,所有组件均采用免费方案,无需额外付费。
流式配置:适合演示、培训、超过2个并发等场景,采用流式处理技术,响应速度更快,体验更佳。自
0.5.2版本起,项目支持流式配置,相比早期版本,响应速度提升约2.5秒,显著改善用户体验。
| 模块名称 | 入门全免费设置 | 流式配置 |
|---|---|---|
| ASR(语音识别) | FunASR(本地) | 👍XunfeiStreamASR(讯飞流式) |
| LLM(大模型) | glm-4-flash(智谱) | 👍qwen-flash(阿里百炼) |
| VLLM(视觉大模型) | glm-4v-flash(智谱) | 👍qwen3.5-flash(阿里百炼) |
| TTS(语音合成) | EdgeTTS(微软) | 👍HuoshanDoubleStreamTTS(火山流式) |
| Intent(意图识别) | function_call(函数调用) | function_call(函数调用) |
| Memory(记忆功能) | mem_local_short(本地短期记忆) | mem_local_short(本地短期记忆) |
如果您关心各组件的耗时,请查阅小智各组件性能测试报告,可按报告中的测试方法在您的环境中实际测试。
🔧 测试工具
本项目提供以下测试工具,帮助您验证系统和选择合适的模型:
| 工具名称 | 位置 | 使用方法 | 功能说明 |
|---|---|---|---|
| 音频交互测试工具 | main》digital-human》index.html | 在 main/digital-human 按其 README 装好依赖后执行 python start.py,然后访问 http://127.0.0.1:8006/index.html | 测试音频播放和接收功能,验证Python端音频处理是否正常 |
| 模型响应测试工具 | main》xiaozhi-server》performance_tester.py | 执行 python performance_tester.py | 测试ASR(语音识别)、LLM(大模型)、VLLM(视觉模型)、TTS(语音合成)等核心模块的响应速度 |
💡 提示:测试模型速度时,只会测试配置了密钥的模型。
功能清单 ✨
已实现 ✅

| 功能模块 | 描述 |
|---|---|
| 核心架构 | 基于MQTT+UDP网关、WebSocket、HTTP服务器,提供完整的控制台管理和认证系统 |
| 语音交互 | 支持流式ASR(语音识别)、流式TTS(语音合成)、VAD(语音活动检测),支持多语言识别和语音处理 |
| 声纹识别 | 支持多用户声纹注册、管理和识别,与ASR并行处理,实时识别说话人身份并传递给LLM进行个性化回应 |
| 智能对话 | 支持多种LLM(大语言模型),实现智能对话 |
| 视觉感知 | 支持多种VLLM(视觉大模型),实现多模态交互 |
| 意图识别 | 支持外挂的大模型意图识别、大模型自主函数调用,提供插件化意图处理机制 |
| 记忆系统 | 支持本地短期记忆、mem0ai接口记忆、PowerMem智能记忆,具备记忆总结功能 |
| 知识库 | 支持RAGFlow知识库,让大模型判断需要调度知识库后再回答 |
| 工具调用 | 支持客户端IOT协议、客户端MCP协议、服务端MCP协议、MCP接入点协议、自定义工具函数 |
| 指令下发 | 依托MQTT协议,支持从智控台将MCP指令下发到ESP32设备 |
| 管理后台 | 提供Web管理界面,支持用户管理、系统配置和设备管理;界面支持中文简体、中文繁体、英文、德语、越南语、巴西葡萄牙语显示 |
| 测试工具 | 提供模型响应性能测试工具和音频交互测试工具 |
| 部署支持 | 支持Docker部署和本地部署,提供完整的配置文件管理 |
| 插件系统 | 支持功能插件扩展、自定义插件开发;新增插件文件在下次设备连接时自动加载,改动已加载插件的代码需重启服务 |
正在开发 🚧
想了解具体开发计划进度,请点击这里。常见问题及相关教程,可参考这个链接
如果你是一名软件开发者,这里有一份《致开发者的公开信》,欢迎加入!
产品生态 👬
小智是一个生态,当你使用这个产品时,也可以看看其他在这个生态圈的优秀项目
本项目支持的平台/组件列表 📋
LLM 语言模型
| 使用方式 | 支持平台 | 免费平台 |
|---|---|---|
| OpenAI 接口调用 | 阿里百炼、火山引擎、DeepSeek、智谱、Gemini、科大讯飞、LM Studio | 智谱、Gemini |
| ollama 接口调用 | Ollama | - |
| dify 接口调用 | Dify | - |
| fastgpt 接口调用 | Fastgpt | - |
| coze 接口调用 | Coze | - |
| xinference 接口调用 | Xinference | - |
| homeassistant 接口调用 | HomeAssistant | - |
实际上,任何支持 OpenAI 接口调用的 LLM 均可接入使用。
VLLM 视觉模型
| 使用方式 | 支持平台 | 免费平台 |
|---|---|---|
| OpenAI 接口调用 | 阿里百炼、智谱ChatGLMVLLM | 智谱ChatGLMVLLM |
实际上,任何支持 OpenAI 接口调用的 VLLM 均可接入使用。
TTS 语音合成
| 使用方式 | 支持平台 | 免费平台 |
|---|---|---|
| 接口调用 | EdgeTTS、科大讯飞、火山引擎、腾讯云、阿里云及百炼、CosyVoiceSiliconflow、TTS302AI、CozeCnTTS、CustomTTS、OpenAITTS、MinimaxTTS | EdgeTTS、CosyVoiceSiliconflow(部分) |
| 本地服务 | FishSpeech、GPT_SOVITS_V2、GPT_SOVITS_V3、IndexStreamTTS、PaddleSpeechTTS | IndexStreamTTS、PaddleSpeechTTS、FishSpeech、GPT_SOVITS_V2、GPT_SOVITS_V3 |
VAD 语音活动检测
| 类型 | 平台名称 | 使用方式 | 收费模式 | 备注 |
|---|---|---|---|---|
| VAD | SileroVAD | 本地使用 | 免费 |
ASR 语音识别
| 使用方式 | 支持平台 | 免费平台 |
|---|---|---|
| 本地使用 | FunASR、SherpaASR、SherpaParaformerASR、VoskASR | FunASR、SherpaASR、SherpaParaformerASR、VoskASR |
| 接口调用 | FunASRServer、火山引擎、科大讯飞、腾讯云、阿里云及百炼、百度云、OpenAI ASR、GroqASR、Qwen3ASRFlash | FunASRServer |
Voiceprint 声纹识别
| 使用方式 | 支持平台 | 免费平台 |
|---|---|---|
| 接口调用 | 声纹识别服务(voiceprint-api) | - |
声纹识别需要单独部署 voiceprint-api 服务(基于 3D-Speaker),并依赖 MySQL,详见声纹识别启用指南
Memory 记忆存储
| 类型 | 平台名称 | 使用方式 | 收费模式 | 备注 |
|---|---|---|---|---|
| Memory | mem0ai | 接口调用 | 1000次/月额度 | |
| Memory | powermem | 本地总结 | 取决于LLM和DB | OceanBase开源,支持智能检索 |
| Memory | mem_local_short | 本地总结 | 免费 | |
| Memory | nomem | 无记忆模式 | 免费 |
Intent 意图识别
| 类型 | 平台名称 | 使用方式 | 收费模式 | 备注 |
|---|---|---|---|---|
| Intent | intent_llm | 接口调用 | 根据LLM收费 | 通过大模型识别意图,通用性强 |
| Intent | function_call | 接口调用 | 根据LLM收费 | 通过大模型函数调用完成意图,速度快,效果好 |
| Intent | nointent | 无意图模式 | 免费 | 不进行意图识别,直接返回对话结果 |
Rag 检索增强生成
| 类型 | 平台名称 | 使用方式 | 收费模式 | 备注 |
|---|---|---|---|---|
| Rag | ragflow | 接口调用 | 根据切片、分词消耗的token收费 | 借助RagFlow的检索增强生成功能,提供更准确的对话回复 |
鸣谢 🙏
| Logo | 项目/公司 | 说明 |
|---|---|---|
| 百聆语音对话机器人 | 本项目受百聆语音对话机器人启发,并在其基础上实现 | |
| 十方融海 | 感谢十方融海为小智生态制定了标准的通讯协议、多设备兼容性方案及高并发场景实践示范;为本项目提供了全链路技术文档支持 | |
| 玄凤科技 | 感谢玄凤科技贡献函数调用框架、MCP通信协议及插件化调用机制的实现代码,通过标准化的指令调度体系与动态扩展能力,显著提升了前端设备(IoT)的交互效率和功能延展性 | |
| huangjunsen | 感谢huangjunsen 贡献智控台移动端模块,实现了跨平台移动设备的高效控制与实时交互,大幅提升了系统在移动场景下的操作便捷性和管理效率 | |
| 汇远设计 | 感谢汇远设计为本项目提供专业视觉解决方案,用其服务超千家企业的设计实战经验,赋能本项目产品用户体验 | |
| 西安勤人信息科技 | 感谢西安勤人信息科技深化本项目视觉体系,确保整体设计风格在多场景应用中的一致性和扩展性 | |
| 代码贡献者 | 感谢所有代码贡献者贡献者,你们的付出让项目更加健壮和强大。 |
raylib
raysan5·C
用 C 写的轻量级游戏编程库,封装 OpenGL 等底层图形接口,让开发者不用折腾窗口、输入和渲染细节,专注写游戏逻辑,支持桌面、移动端和嵌入式平台。
游戏编程库+4IoT / 固件
35626+443.4k6.22026-11-10 08:11 UTC
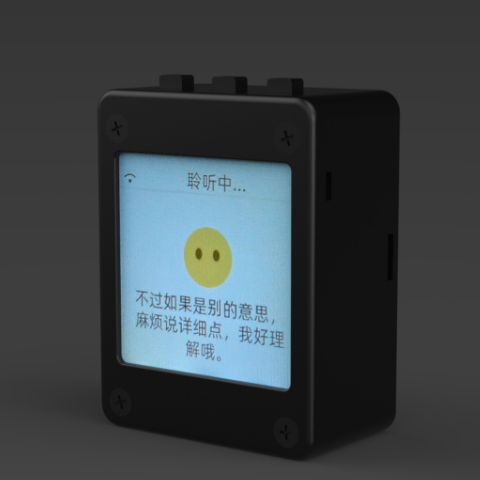
xiaozhi-esp32
78·C++
基于 MCP 协议、跑在 ESP32 上的聊天机器人固件,让单片机也能接入大模型对话与工具调用。
聊天机器人+4IoT / 固件
33006+1647.8kv2.5.22026-11-07 04:14 UTC
DeepSpeech
mozilla·C++
DeepSpeech is an open source embedded (offline, on-device) speech-to-text engine which can run in real time on devices ranging from a Raspberry Pi 4 to high power GPU servers.
IoT / 固件
267724.1k2025-06-19 12:52 UTC
Tasmota
arendst·C
给 ESP8266/ESP32 设备刷的替代固件,通过网页配置、OTA 升级和定时/规则自动化,用 MQTT、HTTP、串口或 KNX 实现完全本地控制。
ESP32+4IoT / 固件
24976+65.2kv16.0.02026-11-10 16:33 UTC