关键词:视觉语言模型

描述或关键词里包含「视觉语言模型」的项目,共 118 个。找不到想要的?试试完整搜索。

用搜索引擎找 →
MiniCPM-V
OpenBMB·Python

MiniCPM-V 是面壁智能开源的多模态视觉语言模型,能在手机、PC 等本地设备上完成看图、听音和对话交互,无需依赖云端。

多模态+4视觉语言模型进阶
27133+482.1k202505272026-11-09 07:37 UTC
LLaVA
haotian-liu·Python

开源的多模态视觉指令微调模型,让 LLaMA 类大模型能看图对话,效果对标 GPT-4V,适合做图文问答和视觉助手。

视觉指令微调+4视觉语言模型进阶
250752.8kv1.2.02024-08-12 09:52 UTC
Qwen3-VL
QwenLM·Jupyter Notebook

阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。

多模态大模型+4视觉语言模型进阶
20197+221.9k2026-01-30 04:47 UTC
PixelRAG
StarTrail-org·Python

把网页直接当像素图像来检索的 RAG 引擎,跳过 HTML 解析,靠视觉语言模型做原生搜索,适合构建多模态 Agent 的长期记忆。

像素级检索+4视觉语言模型进阶
10910+45983v0.4.02026-11-11 00:05 UTC
InternVL
OpenGVLab·Python

开源多模态大模型家族,视觉语言能力接近 GPT-4o,支持图像分类、图文检索、语义分割和视频理解等任务。
多模态大模型+4视觉语言模型进阶
10168792v1.5.02025-09-22 01:36 UTC
OpenRLHF
OpenRLHF·Python

基于 Ray 的高性能 RLHF 训练框架,支持 PPO、DAPO、REINFORCE++ 等算法与 vLLM 推理加速,可扩展地完成大模型和视觉语言模型的对齐后训练。
RLHF+4后训练 / RLHF硬核
10149+31.1kv0.11.22026-11-03 03:17 UTC
awesome-LLM-resources
WangRongsheng

汇总全球优质大模型学习资料,覆盖多模态生成、Agent、辅助编程、模型训练与推理、RAG 等方向,帮开发者快速找到教程、课程和实战资源。

大模型资源+4RAG 框架入门
9080+111.1k2026-11-01 12:01 UTC
Dolphin
bytedance·Python

字节跳动开源的文档图像解析模型,用异构锚点提示把 PDF 和图片里的版面、文字、表格一次性解析成结构化内容,适合喂给 RAG 或做文档分析。

文档解析+4文档解析 / OCR进阶
90677722026-03-25 06:34 UTC
minimind-v
jingyaogong·Python

用两小时从零训练一个 65M 参数的多模态视觉语言模型,代码和流程完整,适合低成本复现 VLM 训练与对话实验。

视觉语言模型+4视觉语言模型进阶
8829+5991v22026-10-27 07:03 UTC
VLM-R1
om-ai-lab·Python

用强化学习(GRPO)训练视觉语言模型做视觉理解,把 DeepSeek-R1 那套推理强化思路搬到多模态场景,适合研究 VLM 推理能力。

视觉语言模型+4视觉语言模型硬核
6045384v0.2.12026-07-07 01:50 UTC
mlx-vlm
Neywa-Labs·Python

在 Mac 上基于 Apple Silicon 用 MLX 跑视觉语言模型的推理与微调工具包,支持 LLaVA、Pixtral、Florence2 等多种 VLM,本地即可完成多模态任务。
视觉语言模型+4视觉语言模型进阶
5835+15887v0.7.122026-11-11 17:28 UTC
align-anything
PKU-Alignment·Python

一个用人类反馈对齐任意模态大模型的开源训练框架,支持文本、视觉语言等多模态模型的 DPO 和 RLHF 微调。
多模态对齐+4视觉语言模型
4670+15032025-11-27 06:50 UTC
star-vector
joanrod·Python

把位图转成 SVG 的视觉语言基础模型,将矢量化当作代码生成任务,输出高精度、可直接使用的 SVG 代码。

SVG生成+4视觉语言模型
4640+12652025-11-07 20:31 UTC
lmms-eval
EvolvingLMMs-Lab·Python

统一评测文本、图像、视频和音频任务的多模态大模型工具箱,一套流程跑完各类基准,省去为每个模态单独搭评测脚本的麻烦。

多模态评测+4模型评测
4491+1692v0.7.42026-11-11 09:36 UTC
Eagle
NVlabs·Python

Eagle 是一系列前沿视觉语言模型,主打以数据为中心的训练策略,能看图理解并回答多模态问题,适合做图文问答和视觉理解研究。

视觉语言模型+4视觉语言模型
3832+223732026-11-07 10:14 UTC
OXR
SoMarkAI·Python

开源文档解析模型,用强化自迭代(RSI)循环做后训练,在准确率和速度上达到 SOTA,适合给 LLM 和 Agent 做 OCR 与文档理解。

文档解析+4文档解析 / OCR
3774+1012532026-11-06 14:20 UTC
MiniMax-01
MiniMax-AI·Python

MiniMax 官方开源的文本大模型 MiniMax-Text-01 和视觉语言模型 MiniMax-VL-01,基于线性注意力架构,可用于长上下文理解与多模态推理。
线性注意力+4视觉语言模型
3473+33322025-07-07 12:24 UTC
Skywork-R1V
SkyworkAI·Python

Skywork-R1V 是昆仑万维开源的多模态视觉语言推理模型系列,基于强化学习训练,擅长图像理解与复杂推理任务。

多模态推理+4视觉语言模型
31732832026-07-29 03:11 UTC
DeepCamera
SharpAI·JavaScript

开源的 AI 摄像头与 NVR 监控平台,用本地 VLM 和 YOLO 做视频分析,并通过 Telegram、Discord、Slack 推送智能安防告警。
AI 摄像头+4智能家居
3139+3488v2026.32026-09-17 00:43 UTC
VLM_survey
jingyi0000

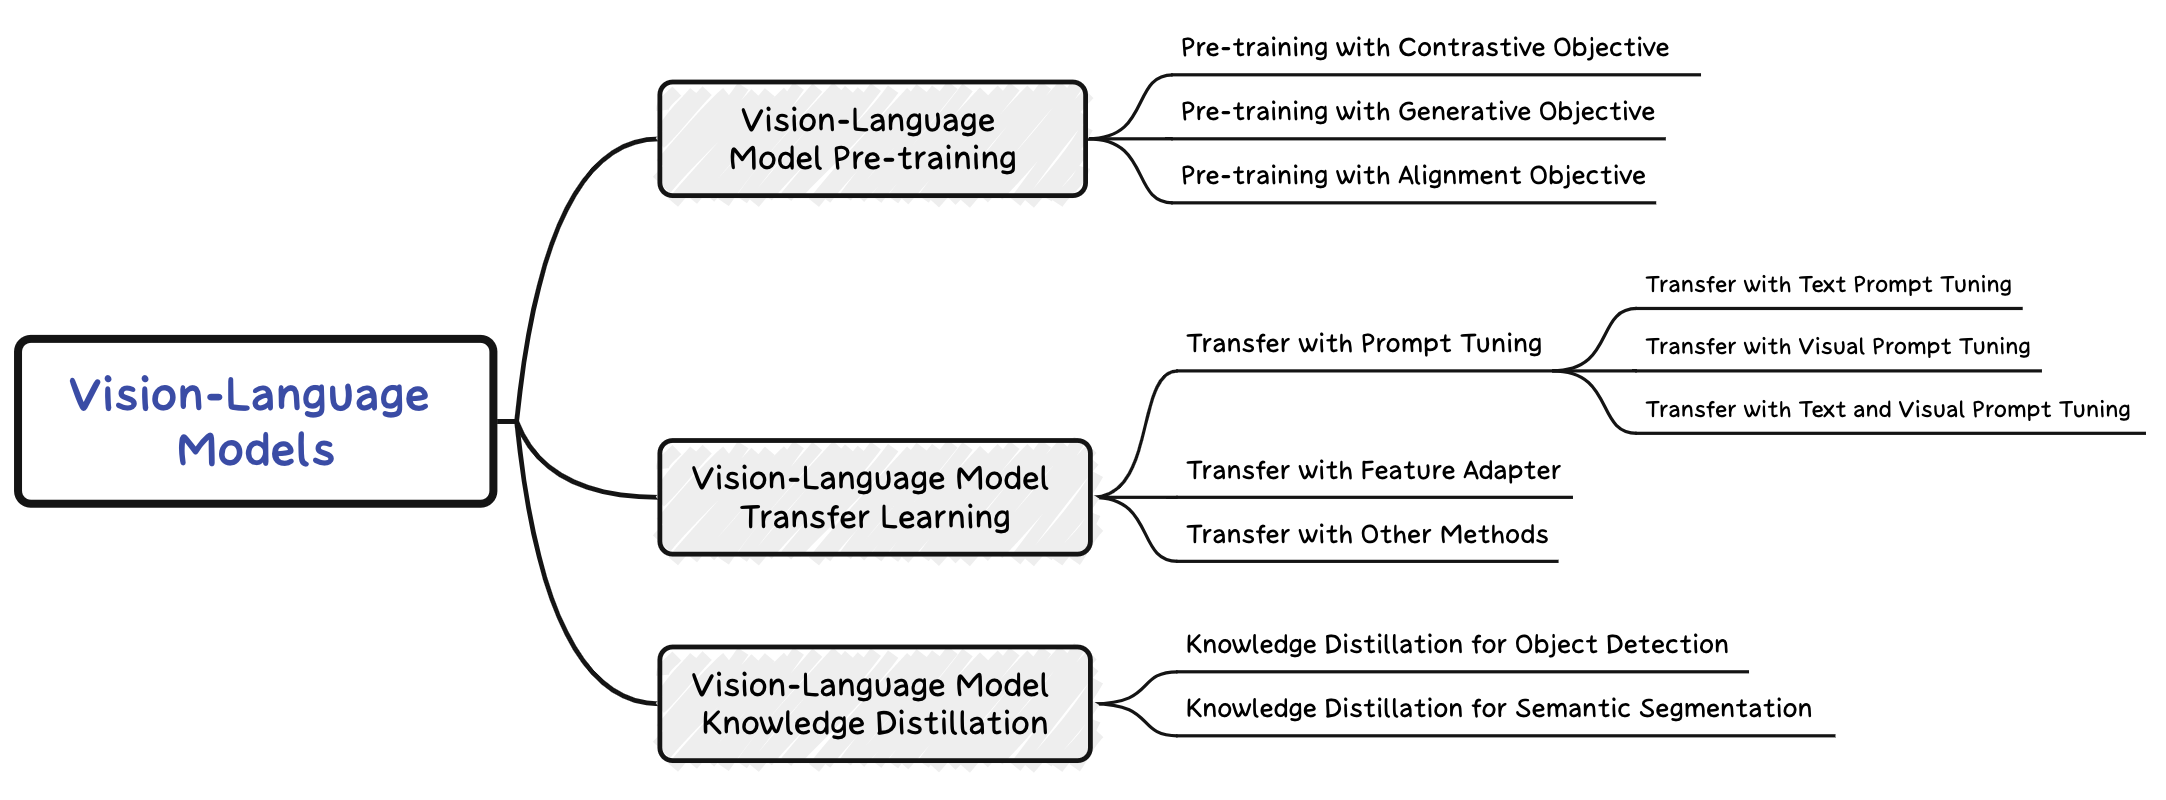
汇总视觉语言模型在视觉任务上的论文与资源清单,方便研究者快速跟进多模态预训练、迁移学习和知识蒸馏等方向的最新进展。

视觉语言模型+4视觉语言模型
3133+12372026-10-05 20:54 UTC
colpali
illuin-tech·Python

训练和推理 ColVision 系列视觉语言检索模型(ColPali、ColQwen2、ColSmol)的代码库,用多模态嵌入直接检索文档图像,省去 OCR 和文本解析步骤。

多模态检索+4RAG 框架
2847270v0.3.182026-09-21 23:54 UTC
maestro
roboflow·Python

一站式微调多模态模型的工具,支持 PaliGemma 2、Florence-2、Qwen2.5-VL 等,覆盖图像描述、目标检测和视觉问答任务,省去手写训练脚本的麻烦。

多模态微调+4零代码微调平台
26942261.0.02026-11-09 17:57 UTC
OmAgent
om-ai-lab·Python

一个多模态语言 Agent 开发框架,把视觉模型和 LLM 编排在一起,帮你快速搭出能看能听的原型并推向生产。

多模态Agent+4视觉语言模型
2670288v0.2.42026-10-16 15:37 UTC
GLM-V
zai-org·Python

GLM-4.6V/4.5V/4.1V-Thinking 系列视觉语言模型,通过可扩展强化学习提升多模态推理能力,支持图像理解、视频理解和图文问答。

视觉语言模型+4视觉语言模型
2404+21922026-11-06 02:36 UTC
deepseek-ocr.rs
TimmyOVO·Rust

用 Rust 写的多后端 OCR/视觉语言模型引擎,支持 DeepSeek-OCR、PaddleOCR-VL 等模型和 DSQ 量化,无需 Python 即可本地跑起兼容 OpenAI 的服务和命令行。

OCR+4文档解析 / OCR
2187169v0.6.0-stage2e2026-02-21 12:21 UTC
Qwen-VL-Series-Finetune
2U1·Python

开源微调 Qwen-VL 系列多模态大模型的实现,支持 Qwen2-VL、Qwen2.5-VL、Qwen3-VL 等版本,方便按自己的数据定制视觉语言模型。

多模态微调+4视觉语言模型
19802232026-09-09 16:55 UTC
video-search-and-summarization
NVIDIA-AI-Blueprints·Python

基于 GPU 加速的视频分析智能体参考架构,用视觉语言模型、LLM 和 RAG 实现长视频的实时告警、视觉问答与自动报告生成。

视频分析+4RAG 框架
1974+6419v3.3.02026-11-11 13:45 UTC
Awesome-LLM4AD
Thinklab-SJTU

汇总大语言模型、视觉语言模型、视觉-语言-动作模型和世界模型在自动驾驶领域的研究资源清单,持续更新,方便快速找到相关论文与项目。

自动驾驶+4视觉语言模型
19061152026-10-15 16:12 UTC
mllm
UbiquitousLearning·C++

在手机等移动设备上高效运行多模态大模型的 C++ 推理引擎,让视觉语言模型能在端侧低资源环境下完成推理。

多模态大模型+4视觉语言模型
16352212.0.02026-09-30 11:50 UTC
Seed1.5-VL
ByteDance-Seed·Jupyter Notebook

字节跳动开源的视觉语言基础模型,主打通用多模态理解与推理,在 60 个公开基准中有 38 项达到 SOTA,配套 Notebook 教程方便上手。

视觉语言模型+4视觉语言模型
1592652025-06-14 19:58 UTC
Ovis
ATH-MaaS·Python

Ovis 是一种多模态大语言模型架构,通过结构对齐视觉与文本嵌入,让模型能同时理解图像和文字,适合做视觉问答、图文对话等任务。
多模态大模型+4视觉语言模型
1537932026-07-15 14:04 UTC
thepipe
emcf·Python

用视觉语言模型从 PDF、Word、PPT 和扫描件等难搞文档里提取干净结构化数据,省去手工清洗的麻烦。

文档解析+4视觉语言模型
1529100v2.0.02026-09-28 01:07 UTC
describe-anything
NVlabs·Python

给图像和视频的指定区域生成详细描述的多模态模型,支持局部定位的细粒度 captioning,适合需要精确区域理解与描述的场景。

视觉语言模型+4视觉语言模型
1522952025-06-26 03:57 UTC
unblink
zapdos-labs·Go

用视觉语言模型做摄像头监控,能理解画面内容而不只是检测移动,适合替代传统 NVR 的简单告警。

视觉语言模型+4视觉语言模型
1518171main-build2026-03-09 09:42 UTC
awesome-vlm-architectures
gokayfem·Markdown

收录 200+ 视觉语言模型(VLM/MLLM)架构的图文目录,整理论文、结构图、训练配方、数据集和发布时间线,方便快速查阅和对比多模态模型设计。

视觉语言模型+4Agent 框架
1364+6572026-10-27 08:57 UTC
Awesome-Unified-Multimodal-Models
ATH-MaaS

汇总统一多模态模型的开源资源清单,涵盖图文生成、视觉语言模型等方向,方便快速查找和对比各类多模态大模型。

多模态大模型+4视觉语言模型
1324492026-03-24 09:52 UTC
joycaption
fpgaminer·Jupyter Notebook

从零构建的免费开源、无审查图像描述视觉语言模型,专为扩散模型训练生成高质量图片说明。

图像描述+4视觉语言模型
1300732026-02-24 20:48 UTC
UForm
unum-cloud·Cuda

轻量级多模态模型库,能同时理解多语言文本和图像,速度比 OpenAI CLIP 和 LLaVA 快 5 倍,适合做图文检索和内容生成。

多模态+4视觉语言模型
125276v3.1.42026-11-10 19:35 UTC
LLaVA-OneVision-2
EvolvingLMMs-Lab·Python

开源多模态训练框架,基于 Qwen3 等底座训练视觉语言模型,降低多模态模型训练门槛。

多模态训练+3视觉语言模型
1233+1782.02026-11-09 09:20 UTC
CogAgent
zai-org·Python

开源的端到端视觉语言模型 GUI 智能体,能看懂屏幕截图并直接操作图形界面,帮你自动完成电脑上的点击、输入等交互任务。
GUI智能体+4电脑 / 浏览器 Agent
11981062026-10-12 12:52 UTC
DoRA
NVlabs·Python

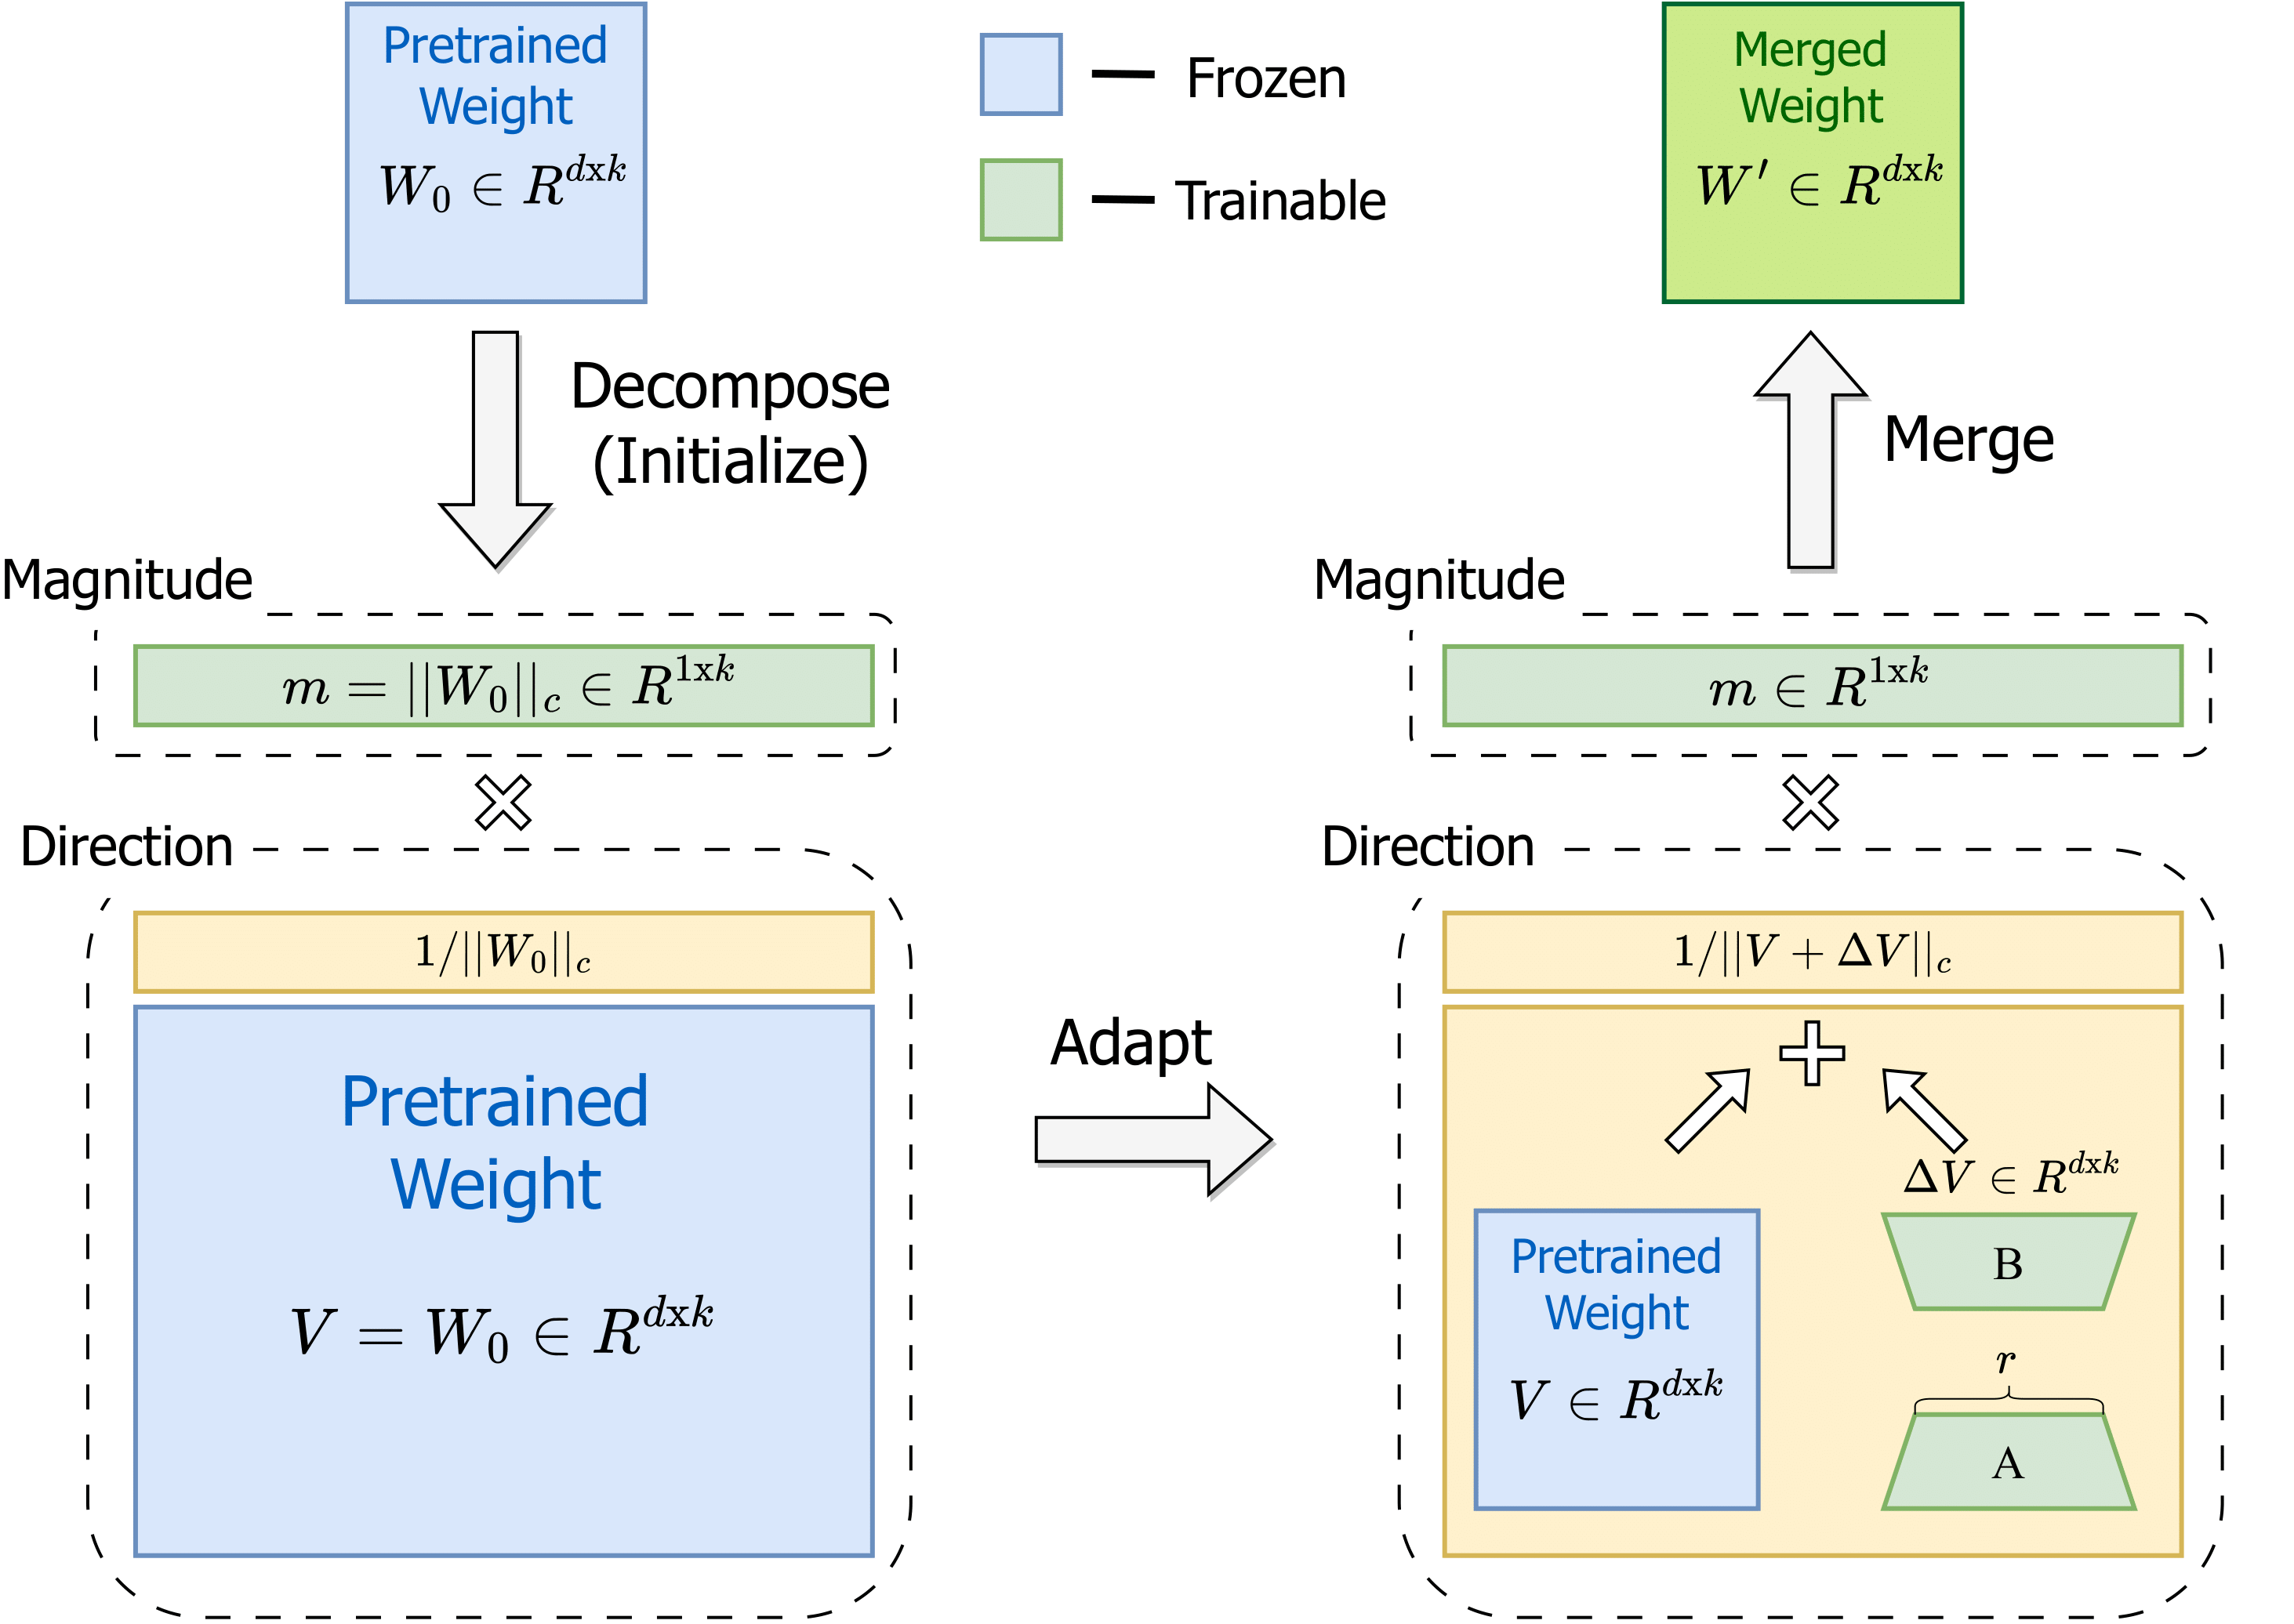
DoRA 是一种把权重分解为幅度和方向两部分再做低秩适配的微调方法,用更少的可训练参数逼近全量微调效果,适合大模型和视觉语言模型的高效微调。

低秩适配+4参数高效微调
1007702026-03-24 09:13 UTC
GamingAgent
lmgame-org·Python

用游戏当测试场来评估 LLM/VLM 智能体的框架,提供可复现的游戏环境和评测流程,方便对比不同模型在交互决策上的表现。

智能体评测+4电脑 / 浏览器 Agent
10041072025-11-16 20:16 UTC
VisRAG
OpenBMB·Python

基于视觉语言模型的无解析 RAG 方案,直接把文档当图片做检索和生成,省去 OCR 和版面解析环节,减少信息损失。
多模态检索+4RAG 框架
990+2802026-11-02 07:06 UTC
groundingLMM
mbzuai-oryx·Python

GLaMM 是首个能把自然语言回答和物体分割掩码无缝结合的多模态大模型,让模型在对话中直接指出并分割出提到的物体。
多模态大模型+4Agent 框架
969562026-09-05 16:56 UTC
NEO
EvolvingLMMs-Lab·Python

从零训练原生视觉语言模型的开源系列,去掉独立视觉编码器,让多模态理解与生成在统一架构里完成。
视觉语言模型+4视觉语言模型
925+4332026-11-11 08:16 UTC
top-cvpr-2025-papers
SkalskiP·Python

精选 CVPR 2025 最具影响力的计算机视觉论文合集,每篇附论文、代码和演示,方便快速跟进检测、分割、多模态等方向的前沿工作。
计算机视觉+4检测 / 分割
898462026-04-15 11:10 UTC
UniWorld
PKU-YuanGroup·Python

用高分辨率语义编码器把视觉理解与图像生成统一到一个模型里,既能读懂图片,也能做文生图和图像编辑。

视觉语言模型+4视觉语言模型
89431v2.0.02025-12-23 06:23 UTC
AlphaCLIP
SunzeY·Jupyter Notebook

Alpha-CLIP 是 CVPR 2024 提出的 CLIP 改进模型,通过引入 alpha 通道掩码让视觉语言模型能聚焦图像中指定区域,解决传统 CLIP 无法控制关注位置的问题。

视觉语言模型+4视觉语言模型
875572025-07-20 15:03 UTC
OpenCUA
xlang-ai·Python

OpenCUA 提供构建电脑操作智能体(CUA)的开放基础,包含数据集、基础模型和评测基准,让 GUI 自动化智能体有可复现的训练与评估方案。
电脑操作智能体+4模型评测
874110v1.0.02026-05-25 01:46 UTC
MOSS-VL
OpenMOSS·C++

开源 11B 参数的多模态视觉语言模型,专攻长视频和实时流式视频理解,可用于视频问答等场景。

视觉语言模型+4视觉语言模型
828+7452026-10-14 07:22 UTC
awesome-llm-and-aigc
coderonion

汇集大模型、视觉语言模型、视觉语言动作模型与 AIGC 相关的优质开源项目、数据集和应用,帮开发者快速找到所需资源。

大模型+4数据集托管
818812025-08-01 16:22 UTC
OmniLottie
OpenVGLab·Python

多模态指令驱动的矢量动画生成器,输入文字或图片即可输出可直接使用的 Lottie JSON 动画文件,省去手工制作矢量动画的繁琐流程。

矢量动画生成+4视觉语言模型
811422026-04-06 04:01 UTC
Awesome-Prompt-Adapter-Learning-for-VLMs-CLIP
zhengli97

整理 CLIP 等视觉语言模型上 prompt learning 与 adapter learning 方法的论文清单,方便做少样本、零样本分类的研究者快速找到相关工作和基线。

提示学习+4视觉语言模型
801442026-07-17 04:22 UTC
VLM2Vec
TIGER-AI-Lab·Python

把视觉语言模型变成通用多模态嵌入模型,配套 MMEB 系列基准,用于图文视频检索和 RAG 场景的表示学习评测。
多模态嵌入+4模型评测
704+165v2.0.12026-10-23 14:06 UTC
OmniVinci
NVlabs·Python

OmniVinci 是英伟达开源的全模态大模型,能同时理解视觉、音频和语言三种输入,适合做多模态联合推理与训练研究。

全模态大模型+4视觉语言模型
684552026-08-31 06:28 UTC
MiMo-VL
XiaomiMiMo

小米开源的视觉语言模型,能看图回答问题,适合做视觉问答和多模态理解任务。

视觉语言模型+3视觉语言模型
650332026-10-29 02:35 UTC
Seg-Zero
JIA-Lab-research·Python

基于认知强化学习、用推理链引导的文本指代图像分割方案,让多模态大模型先推理再分割,提升复杂场景下的分割精度。

图像分割+4视觉语言模型
645312026-01-17 04:46 UTC
ParseBench
run-llama·Python

面向 AI Agent 的文档解析评测基准,覆盖 OCR、PDF 解析和表格抽取,用统一指标对比不同模型与工具在真实文档上的解析效果。
文档解析+4模型评测
629+3135v1.0.72026-11-11 07:42 UTC
LAMDA-PILOT
LAMDA-CL·Python

基于预训练模型的持续学习工具箱,集成多种增量学习与终身学习算法,方便在视觉和视觉语言模型上做可复现的持续学习实验。

持续学习+4视觉语言模型
613692026-01-29 04:38 UTC
t2v_metrics
linzhiqiu·Python

用 VQAScore 给文生图、文生视频和文生 3D 模型打分的评测工具,基于视觉语言模型判断生成内容与文本提示是否匹配。

文生视频评测+4视觉语言模型
605752026-06-05 21:41 UTC

共 118 个,这里展示前 60 个。