标签:MoE 混合专家
技术标签,共 29 个项目。
面向大语言模型的高吞吐、低显存推理与服务引擎,通过 PagedAttention 等优化显著提升并发吞吐并降低显存占用,适合部署在线推理服务。

一套统一接口搞定 100+ 大语言模型和多模态模型的微调,支持 LoRA 等高效训练方式,省去为每个模型单独写训练脚本的麻烦。
基于 PyTorch 的深度学习优化库,通过 ZeRO、模型并行和混合专家等技术,让千亿到万亿参数模型的分布式训练与推理更省显存、更高效。
高性能大模型与多模态模型推理服务框架,通过优化注意力机制和调度策略提升吞吐与延迟表现,支持 Llama、DeepSeek、MoE 等主流模型部署。
一站式大模型训练框架,支持 600+ 纯文本大模型和 300+ 多模态大模型的 CPT、SFT、DPO、GRPO 等训练,可用 LoRA 等 PEFT 方式或全参数微调。
用 Python API 定义大模型,并借助 TensorRT 在 NVIDIA GPU 上做极致优化推理,还提供 Python/C++ 运行时来编排高性能服务。
用纯 C99 从零实现的 Kimi K3 推理引擎,单 CPU、8.24 GB 内存即可跑 2.78 万亿参数模型,不依赖 BLAS、框架或 GPU。
一本从硬件约束和模型架构出发、用定量推导讲透 LLM 推理与训练系统设计的开源书稿,附全书正文、PDF 和配套计算工具,适合想搞懂 AI Infra 底层账怎么算的工程师。

面向 LLM 推理服务的高性能 CUDA 内核库,提供注意力、MoE 等算子的 JIT 实现,用来加速 GPU 上的大模型推理。
一个面向 LLM 的推理优化代理,通过 API 网关接入,自动套用思维链等推理策略来提升模型回答质量并降低调用成本。
在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。
在 AMD Strix Halo 上本地跑 Qwen3.8-Flash-Next 和 NPU 小模型,用同一端口同时提供 OpenAI 与 Anthropic 兼容 API,让本地推理像调前沿云服务一样顺手。
Halo 是 White Circle 开源的大模型与多模态模型训练框架,支持分布式训练、LoRA 微调、MoE 和异步强化学习,方便搭建和扩展训练流程。
YOLO-Master 是腾讯开源的实时目标检测模型,用专家混合(MoE)搭配专用 Transformer 提升检测精度与速度,支持检测、分割和分类任务。
在免费 Kaggle TPU v5e-8 上跑 GLM-5.3-Flash 320B MoE 和 Qwen3.8-27B 等前沿大模型,自研 JAX 推理引擎支持 262k 长上下文和前缀缓存,可接入 Claude Code 等编码代理。
纯 Rust + CUDA 实现的大模型推理引擎,不依赖 PyTorch,兼容 OpenAI 接口,可部署 Qwen3 到 Kimi-K2 等模型。
纯 C 写的本地大模型推理引擎,靠 MoE 稀疏激活和 NVMe 流式加载,让 32GB 笔记本跑 80B 模型,速度全面超过 llama.cpp。
在 16–64 GB 内存的 Apple Silicon Mac 上,从 SSD 流式加载 105 GB 的 4-bit 大模型跑推理,纯 Swift + MLX/Metal 实现,离线无需 Python。
面向 AI 秋招的中英双语面试速查表,覆盖机器学习、大模型、扩散模型与智能体,可生成单文件 HTML 随时翻阅,另附学术主页生成器。
在 RTX 5090 / RTX PRO 6000(sm_120)上跑 DeepSeek-V4.1-Flash 等前沿 MoE 大模型的 vLLM 适配方案,支持 GPU+CPU 混合推理和 2-bit 专家量化。
Krasis 是一个混合式 LLM 推理运行时,通过 CPU+GPU 协同把大模型跑在显存有限的消费级显卡上,支持 MoE 和 GGUF 模型。
在单张 RTX 4090 加 110GB 内存的游戏 PC 上本地跑 552B 的 DeepSeek-V4.1-Flash 做编码智能体,MoE 专家分层放在显存、锁页内存和 NVMe 上,兼容 OpenAI 与 Anthropic API。
MindSpore 官方的大模型实战课程,带你从 BERT、GPT 一路动手实现到 ChatGLM、LLaMA2,适合系统学习大模型原理与训练推理。
基于 vLLM 的 NUMA 扩展推理引擎,充分利用 CPU 和内存资源降低显存占用,支持 MOE 大模型混合推理与 GPU/NUMA 并行。
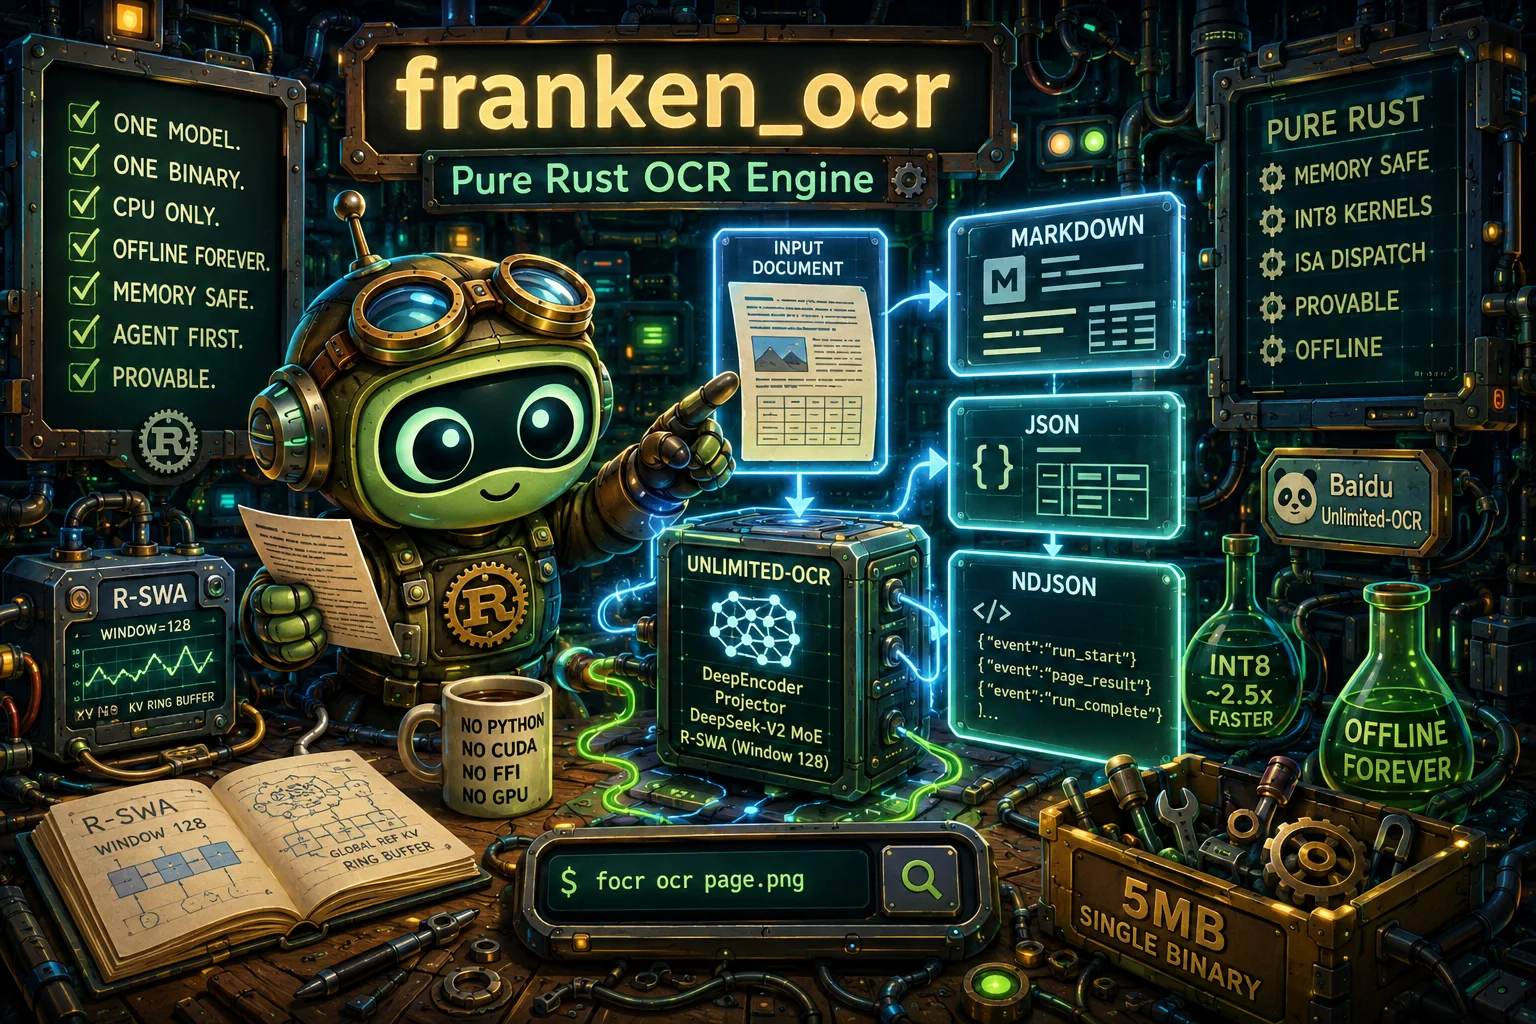
纯 Rust 实现的 CPU 端 OCR 引擎,跑百度 Unlimited-OCR 这个 3B MoE 视觉语言模型,自带 int8 定制算子,不依赖 ML 框架、Python 或 GPU。

自动化调整大模型对齐行为的工具,支持直接干预、LoRA 和 MoE 专家级消融,并用 Optuna 多目标搜索调参。

用 PyTorch 从零手写现代 LLM 架构、训练与推理的实战课程,配套可直接运行的 notebook,适合边跑边学大模型原理。
用 Rust + CUDA 写的 SSD 流式推理引擎,让消费级 16GB 显卡也能跑 743B 级 MoE 大模型,自动测 PCIe 带宽并分配注意力与热专家。
从零手写的 LLM 推理引擎,实现分页 KV 缓存、连续批处理、投机解码和 CUDA 图等优化,并提供 OpenAI 兼容服务接口。