量化

INT4 / FP8 / GGUF 等量化方案。

headroom
headroomlabs-ai·Python

在工具输出、日志、文件和 RAG 片段进入 LLM 前先做压缩,编码 Agent 省约 20% token,JSON 省 60-95%,答案不变。提供库、代理和 MCP 服务器三种用法。

上下文压缩+4量化
79264+2196.2kv0.43.12026-11-10 05:09 UTC
llmfit
AlexsJones·Rust

一条命令就能从数百个模型和供应商里筛出适合你硬件配置的本地大模型,省去逐个试跑和查显存的麻烦。

本地推理+4量化
38868+1412.5kv1.1.202026-11-09 21:31 UTC
PaddleNLP
PaddlePaddle·Python

基于飞桨的 NLP 与大模型开发库,提供丰富模型库,覆盖 BERT、ERNIE、LLaMA 等,支持分布式训练、压缩和文档智能等任务。

大模型开发库+4量化
12987+13.0krl-v1.0.02026-05-23 02:54 UTC
bitsandbytes
bitsandbytes-foundation·Python

让大模型在普通显卡上跑起来的 PyTorch 量化库,支持 8-bit 和 4-bit 权重压缩,也是 QLoRA 微调背后的核心依赖。

量化+4量化
85369420.50.22026-11-02 14:36 UTC
shimmy
Michael-A-Kuykendall·Rust

纯 Rust 实现的 WebGPU 推理引擎,原生支持 GGUF 模型,兼容 OpenAI API,无需 Python 和 llama.cpp,单个二进制文件即可在任意 GPU 上跑本地大模型。

推理引擎+4量化
6015+3587v2.6.62026-11-09 18:48 UTC
pngquant
kornelski·C

用有损量化把 PNG 压到原体积的几分之一,肉眼几乎看不出差别,适合给网页和 App 里的图片瘦身。

PNG压缩+4量化
5774+15082026-10-27 17:23 UTC
SageAttention
thu-ml·Cuda

量化注意力算子库,在语言、图像、视频模型上比 FlashAttention 快 2-5 倍且不损失端到端精度,可直接替换加速推理。

量化注意力+4量化
4003+4549v2.0.12026-01-17 17:43 UTC
llm-compressor
vllm-project·Python

面向 vLLM 生产推理的 LLM 压缩工具,支持量化等压缩算法,把大模型压小以便高效部署。
模型压缩+4量化
3958+67310.10.0.52026-11-10 04:22 UTC
SimpleMem
aiming-lab·Python

给 LLM Agent 用的长期记忆系统,通过压缩和知识图谱把文本与多模态历史高效存下来,让 Agent 跨会话记住关键信息。

长期记忆+4量化
3872414v0.3.02026-07-24 07:40 UTC
llm-awq
mit-han-lab·Python

AWQ 是一种激活感知的权重量化方法,能在几乎不损失精度的情况下把大模型压到 4bit,并配合高效推理内核显著降低显存占用、提升推理速度。
权重量化+4量化
36633282025-07-17 19:44 UTC
OGAM
off-grid-ai·TypeScript

在手机或 Mac 上离线跑 GGUF 大模型、视觉识别、Whisper 语音转文字和 Stable Diffusion 生图,支持工具调用与局域网服务,无需账号和 API Key。

离线推理+4量化
3361+14335v0.0.1222026-11-09 14:44 UTC
ao
pytorch·Python

PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。

量化+4大模型推理服务
3025+2681v0.18.02026-11-10 00:56 UTC
ComfyUI-nunchaku
nunchux-ai·Python

把 Nunchaku 的 4-bit 量化扩散模型推理接进 ComfyUI,让 FLUX 等模型在低显存下也能快速出图。

量化推理+4量化
2931171v1.2.12026-09-06 23:20 UTC
maid
Mobile-Artificial-Intelligence·TypeScript

一个跨平台本地大模型聊天客户端,通过统一界面连接 llama.cpp 本地模型以及 Anthropic、OpenAI、DeepSeek、Ollama 等远程服务。

本地推理+4量化
2767+5307v3.0.02026-10-29 06:11 UTC
cortex.cpp
janhq·C++

Local AI API Platform

量化
27471712025-07-04 07:38 UTC
project-maya
mw00·C++

在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。
本地推理+4量化
2746+97387v1.1.572026-11-09 22:53 UTC
aimet
qualcomm·Python

面向已训练神经网络模型的量化与压缩库,提供剪枝、量化等高级技术,帮助在部署前压缩模型体积、降低推理开销。

模型量化+4量化
2744+14772.43.02026-11-10 03:59 UTC
gptq
IST-DASLab·Python

GPTQ 是 ICLR 2023 论文的官方实现,能在训练后把 GPT 类大模型量化到 3/4 比特,几乎不掉精度,大幅降低显存占用和推理成本。

训练后量化+4量化
23942082024-03-27 01:46 UTC
comfyui_LLM_party
heshengtao·Python

在 ComfyUI 里搭建 LLM Agent 的框架,接入 MCP、GraphRAG、语音合成与 OCR 节点,兼容 OpenAI 接口的各类模型和本地 GGUF 模型。

Agent 框架+4量化
2389210v0.6.02026-07-29 18:05 UTC
AutoAWQ
casper-hansen·Python

AutoAWQ implements the AWQ algorithm for 4-bit quantization with a 2x speedup during inference. Documentation:

量化
23443112025-05-11 08:52 UTC
Awesome-Efficient-LLM
horseee·Python

整理大模型高效化研究的资源清单,汇总量化、剪枝、知识蒸馏等压缩与加速方向的论文和工具,方便快速找到降低推理成本的方法。

大模型压缩+4量化
20481722025-06-17 02:35 UTC
intel-extension-for-pytorch
intel·Python

A Python package for extending the official PyTorch that can easily obtain performance on Intel platform
量化
20083232026-03-30 08:35 UTC
Atomic-Chat
AtomicBot-ai·TypeScript

本地运行的 AI 聊天应用与推理引擎,基于 llama.cpp 加载 GGUF 开源权重模型,完全离线、保护隐私,支持 Apple Silicon 桌面端。
本地推理+4量化
1972+16231v2.3.52026-11-09 17:10 UTC
AngelSlim
Tencent·Python

腾讯开源的模型压缩工具包,支持量化、投机解码和扩散模型加速,帮你在部署大模型时降低显存占用、提升推理效率。

模型压缩+4量化
1788+2197v0.5.02026-10-31 02:47 UTC
StartLux-Decision
StartLuxLabs·Python

一套 0.8B 到 27B 的开源决策模型,一次前向就能为每个选项给出校准概率,只在不确定时才输出简短思考;配套 vLLM、llama.cpp 和 MLX 推理引擎。
决策模型+4量化
1707+39163v1.1.02026-10-23 06:42 UTC
auto-round
intel·Python

Intel 开源的模型量化工具,用训练后量化的低成本达到量化感知训练级别的精度,支持 int4、GGUF、MXFP4 等格式,可直接对接 vLLM、SGLang 推理。

模型量化+4量化
1700201v0.16.12026-11-10 05:41 UTC
nobodywho
nobodywho-ooo·Rust

跨平台本地大模型推理引擎,支持 Godot、Flutter、Expo 等客户端,让 LLM 在任意设备上高效离线运行。

推理引擎+4量化
1672+1100nobodywho-swift-v6.0.02026-11-09 13:17 UTC
PaddleSlim
PaddlePaddle·Python

飞桨生态下的模型压缩与架构搜索库,提供剪枝、量化、蒸馏和 NAS 等能力,帮你在部署前把深度模型压小提速。

模型压缩+4量化
1614351v2.6.02026-01-04 09:30 UTC
brevitas
Xilinx·Python

基于 PyTorch 的神经网络量化库,支持训练后量化和量化感知训练,方便把模型部署到 FPGA 等硬件上做加速。

神经网络量化+4量化
1593259v0.13.32026-11-06 16:12 UTC
model-optimization
tensorflow·Python

面向 Keras 和 TensorFlow 的模型压缩工具包,通过量化和剪枝把训练好的模型压小、跑得更快,方便部署到移动端和边缘设备。

模型压缩+4量化
1582348v0.8.12026-11-08 07:08 UTC
OuteTTS
edwko·Python

OuteTTS 模型的推理接口,支持 GGUF 和 Transformers 后端,方便本地跑文本转语音。

语音合成+4量化
14401180.4.22026-03-23 08:31 UTC
overlay-translator
ciddwd·Kotlin

无需 ROOT 的安卓屏幕实时翻译工具,通过端侧或云端 OCR 识别游戏、视觉小说和漫画中的文字,再用离线 LLM 或在线翻译服务把译文直接叠加显示在画面上。

屏幕翻译+4量化
1268+1857v0.4.82026-10-30 11:38 UTC
SpargeAttn
thu-ml·Cuda

免训练稀疏注意力方案,可直接接入任意模型推理,加速 LLM、视觉 Transformer 和视频生成,无需重新训练即可降低注意力计算开销。

稀疏注意力+4量化
12671082026-02-25 00:07 UTC
nncf
openvinotoolkit·Python

面向 OpenVINO 推理的神经网络压缩框架,提供量化、剪枝和混合精度训练,把模型压小提速后再部署。

模型压缩+4量化
1218314v3.4.02026-11-09 18:58 UTC
z80ai
HarryR·Python

把对话语言模型压到 2-bit 量化,小到能在 8 位 Z80 处理器上跑,用 Python 训练后导出成 CP/M 的 .COM 程序,让老电脑也能聊天。

2-bit量化+4量化
113648v0.22026-04-29 13:43 UTC
optimum-quanto
huggingface·Python

PyTorch 量化后端,接入 Optimum 生态,支持多种量化方案,帮你在推理和训练中压缩模型、降低显存占用。

量化后端+4量化
1056102v0.2.72026-10-26 09:45 UTC
time-to-first-token
patchy631·HTML

一份 10 周、每天 30 分钟的 LLM 推理服务与优化学习路线,覆盖 vLLM、SGLang、量化、投机解码和基准测试,帮工程师系统入门推理加速。
推理服务+4大模型推理服务
10551202026-08-14 19:39 UTC
OmniQuant
OpenGVLab·Python

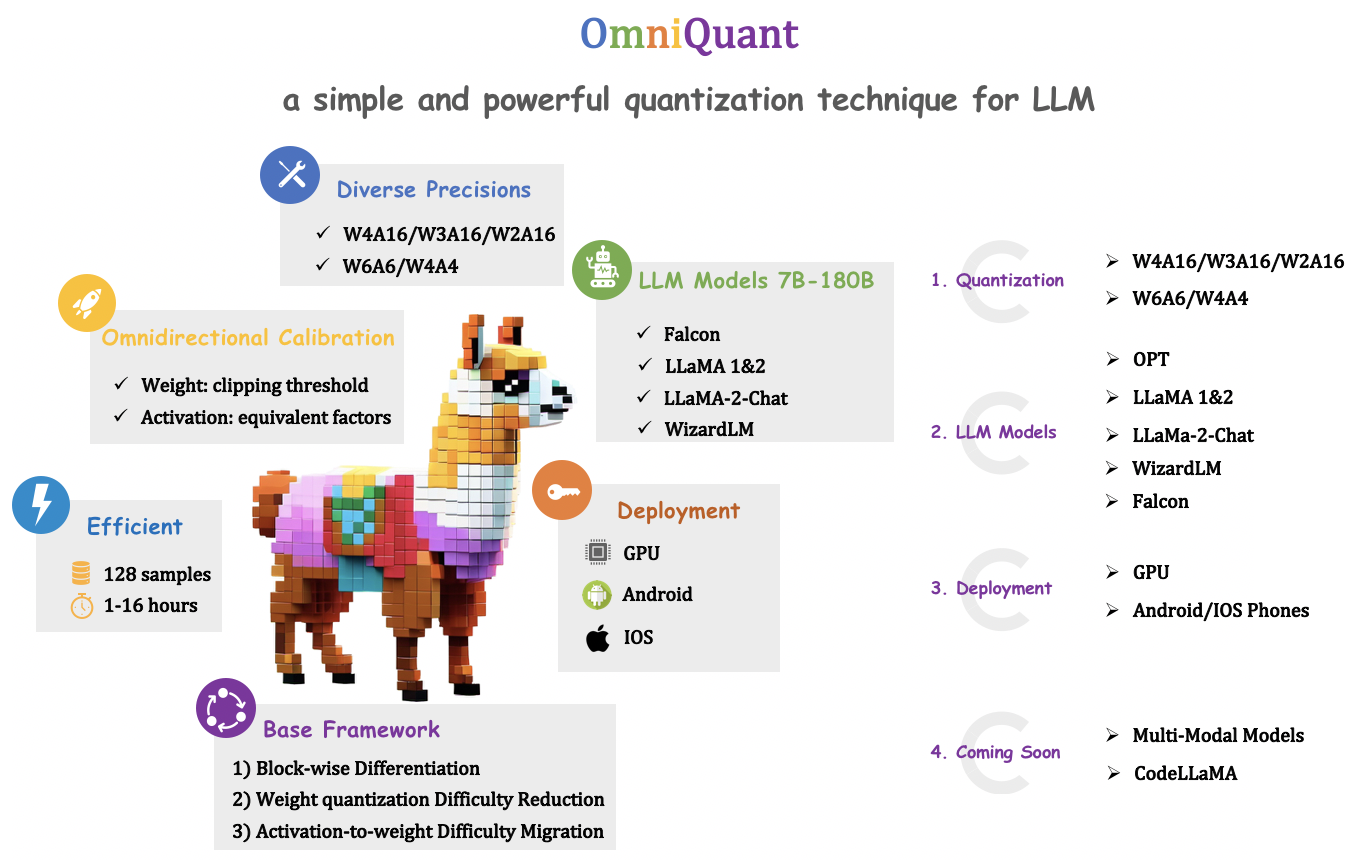
一种简单又强大的大模型量化技术,通过可学习权重裁剪和等价变换,在保持精度的同时把 LLM 压到低比特,方便部署推理。

大模型量化+4量化
96893v0.0.12025-11-26 07:22 UTC
hqq
dropbox·Python

HQQ 是一种无需校准数据的大模型量化方法,官方实现支持几行代码把 LLM 压到低比特,省显存还能保持精度。

模型量化+4量化
96294v0.2.8.post12026-02-26 12:50 UTC
jev
feder-cr·C++

在笔记本 CPU 上本地跑二分类、多选和带概率打分的决策模型,是 Jev 和 Microsoft-Decision-1 的开源替代,支持 GGUF 量化推理。

本地推理+4量化
954+4147jevos-v52026-10-18 16:09 UTC
libimagequant
ImageOptim·Rust

把 RGBA 像素转换成高质量调色板图像的量化库,是 pngquant 等 PNG 压缩工具的核心,能在保持画质的同时大幅减小图片体积。

调色板量化+4量化
9381402026-06-21 02:27 UTC
LLM.swift
eastriverlee·Swift

用 Swift 写的轻量本地大模型推理库,能在 macOS、iOS、watchOS、tvOS、visionOS 上直接跑 GGUF 模型,代码简单易读,方便苹果生态应用集成。

本地推理+4量化
883127v3.0.32026-07-19 06:04 UTC
llama3.java
mukel·Java

用纯 Java 实现的 Llama 3 及后续版本推理引擎,无需原生依赖即可在 JVM 上跑大模型,适合 Java 项目直接集成。

Java推理引擎+4量化
816952026-04-24 16:38 UTC
hailo_model_zoo
hailo-ai·Python

Hailo 官方预训练模型库,提供面向 Hailo-8 边缘 AI 加速器的模型、量化工具和完整评估环境,方便直接部署到端侧设备。

边缘AI+4量化
72388v5.5.02026-11-01 07:42 UTC
janas
prabanta-dev·C

纯 C 写的本地大模型推理引擎,靠 MoE 稀疏激活和 NVMe 流式加载,让 32GB 笔记本跑 80B 模型,速度全面超过 llama.cpp。
推理引擎+4量化
686+2071v2026.11.102026-11-10 00:28 UTC
yzma
hybridgroup·Go

用纯 Go 直接调用 llama.cpp 做本地推理,支持 CUDA、Metal、ROCm 硬件加速,覆盖 Linux、macOS、Windows 和 WebAssembly,方便在 Go 应用里嵌入大模型。

本地推理+4量化
672+228v1.32.02026-11-07 22:53 UTC
DFloat11
LeanModels·Python

面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
无损压缩+4量化
666402025-11-24 09:46 UTC
SINQ
huawei-csl·Python

SINQ 是一种即插即用的 LLM 量化方法,能把任意大模型压小并尽量保住精度,适合显存吃紧时部署 DeepSeek、Qwen 等模型。

模型量化+4量化
635512026-05-08 10:07 UTC
ComfyUI_VLM_nodes
gokayfem·Python

把 Qwen3-VL、Florence-2、InternVL 等视觉语言模型接进 ComfyUI 的节点包,顺带支持开放词表检测、SAM 分割、视频时序推理和 GGUF 量化加载。

视觉语言模型+4量化
592632026-08-08 09:32 UTC
qkeras
google·Python

基于 TensorFlow Keras 的量化深度学习库,支持量化感知训练,方便把模型部署到 FPGA、ASIC 等硬件加速器上。

量化训练+4量化
585108v0.9.02026-02-23 18:00 UTC
token-optimizer-mcp
ooples·JavaScript

一个 MCP 服务器,能统计各 AI 编程代理节省了多少 token、优化上下文,并在 16 种 CLI 客户端间共享本地实时知识图谱。
token 优化+4量化
577+273v7.9.02026-11-10 02:49 UTC
QeRL
NVlabs·Python

QeRL 通过量化让强化学习训练 32B 大模型只需单张 H100 显卡,大幅降低大模型 RL 微调的显存门槛。
强化学习+4量化
527522026-03-30 05:39 UTC
Xolotl
Indras-Mirror·C++

在单张 RTX 4090 加 110GB 内存的游戏 PC 上本地跑 552B 的 DeepSeek-V4.1-Flash 做编码智能体,MoE 专家分层放在显存、锁页内存和 NVMe 上,兼容 OpenAI 与 Anthropic API。
本地推理+4量化
500+20622026-11-09 07:32 UTC
Qwen3.6-27B-AEON-Ultimate-Uncensored-DFlash
AEON-7·Python

基于 Qwen3.6-27B 做去审查与能力增强的 abliteration 模型,配合 NVFP4 量化和 DFlash 投机解码,在 DGX Spark 上优化长上下文草稿接受率,附多种 HF 变体与 Docker 部署。

去审查模型+4量化
491552026-10-06 01:33 UTC
mct-model-optimization
SonySemiconductorSolutions·Python

面向边缘受限硬件的神经网络压缩工具包,提供量化感知训练和训练后量化等高级量化压缩能力,帮研究者把模型高效部署到资源紧张的设备上。

模型压缩+4量化
45081v2.6.12026-11-04 01:45 UTC
OneCompression
FujitsuResearch·Python

面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。

模型压缩+4量化
44522v1.4.12026-11-02 03:17 UTC
KIVI
jy-yuan·Python

免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。

KV Cache 量化+4大模型推理服务
438582025-11-20 20:34 UTC
quant.cpp
quantumaikr·C

纯 C 实现的 LLM 推理库,零依赖单头文件,通过无损 KV cache 压缩把上下文长度拉长到 7 倍,适合嵌入到资源受限环境。

LLM推理+4量化
40644v0.13.02026-04-26 11:15 UTC
StartLux-Prism
StartLuxLabs·Python

在 NVIDIA GPU 上为 StartLux-Decision 模型提供快速精确推理,支持 int8 和 4-bit 量化的 GGUF 权重,延迟比 vLLM FP8 低至 5.3 倍且答案逐位一致。

推理引擎+4量化
396+4652026-10-27 04:32 UTC
awesome-compression
datawhalechina

面向零基础读者的模型压缩教程,系统讲解剪枝、量化、知识蒸馏、低秩分解和神经架构搜索等让大模型变小变快的方法。

模型压缩+4量化
38945V1.0.02025-11-25 06:59 UTC