后训练 / RLHF
SFT、奖励建模、PPO / GRPO / DPO 等对齐训练。
基于 PyTorch 的深度学习优化库,通过 ZeRO、模型并行和混合专家等技术,让千亿到万亿参数模型的分布式训练与推理更省显存、更高效。
面向大模型后训练的强化学习框架,用混合编程模型把 RLHF 训练流程编排得灵活又高效,方便扩展和跑大规模实验。
用强化学习训练 Transformer 语言模型的全流程库,覆盖 SFT、奖励建模到 PPO/DPO 等 RLHF 算法,省去自己拼训练管线。
基于 Ray 的高性能 RLHF 训练框架,支持 PPO、DAPO、REINFORCE++ 等算法与 vLLM 推理加速,可扩展地完成大模型和视觉语言模型的对齐后训练。
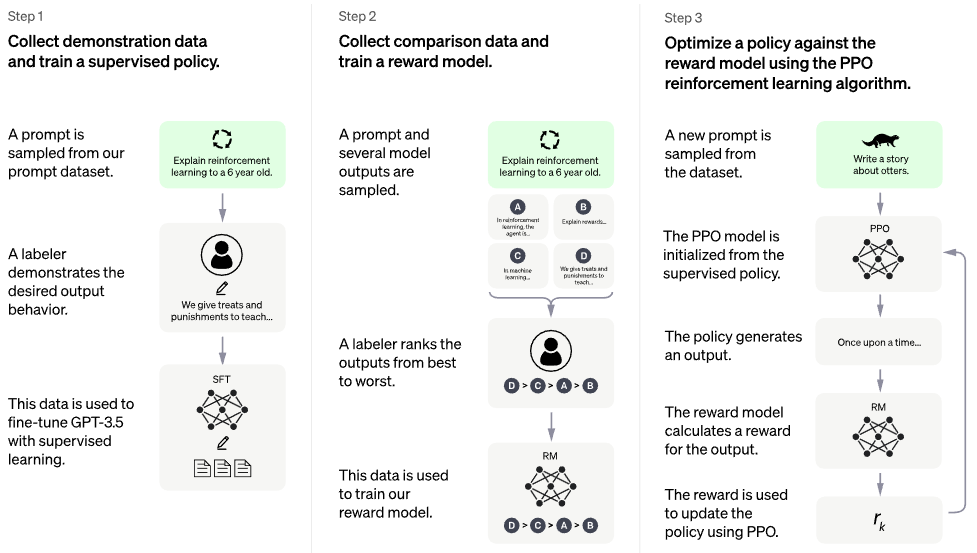
在 PaLM 架构上实现 RLHF 人类反馈强化学习,复现 ChatGPT 式训练流程,适合研究大模型对齐与强化学习微调。
用 ChatGPT 同款流程训练医疗大模型,覆盖增量预训练、有监督微调、RLHF、DPO、ORPO、GRPO 全链路,开箱即可复现。
提供一套稳健的训练配方,用人类和 AI 偏好数据对齐语言模型,涵盖 SFT、DPO 等流程,帮你把基座模型调成听话好用的助手。
基于 Llama3 的中文后训练模型与配套工具,提供中文微调权重、训练脚本和部署方案,让开发者能直接跑起中文对话模型。
用 PyTorch 从零手写实现 65 道大厂 ML/AI 面试真题,配 Jupyter Notebook、自动评分器和 MCP AI 导师,适合系统刷题备战机器学习面试。
一个能自我进化的照片编辑智能体,通过编辑器和评估器协同优化,让多模态大模型学会像修图师一样自动调色和修图。
面向机器人操作的自进化智能体训练方案,通过后训练和递归自我改进,在成功率提升14%的同时把 token 消耗降低65%。