AI · 算法工程
共 1,644 个仓库 · Python
AnglE 是一个训练和推理句向量模型的 Python 库,在 STS 和 MTEB 榜单上达到 SOTA,适合做语义相似度、稠密检索和 RAG 场景的向量化。
给 Claude Code 装上 Elixir/Phoenix/LiveView 专家团队,26 个专职 agent 并行调研、自动验证和审查代码,把开发经验沉淀成可复用知识。
统一的多模态大模型,能高效理解图像、高分辨率图像和视频,用极少的视觉 token 完成多模态推理,适合显存和算力受限的场景。
面向视频场景的空间超级感知多模态大模型,专注提升视觉语言模型对视频中空间关系的理解与推理能力。
一套统一的视觉 SLAM 评测框架,把主流 VSLAM 系统和公开数据集整合到同一套流程里,省去逐个配置环境、跑对比实验的麻烦。
给 AI 智能体用的加密离线长期记忆库,一键安装,带记忆图谱界面,支持各类操作系统和主流 Agent,让记忆的生成、存储和检索更高效。
在 MiniMax H3 生成的视频里逐帧追踪并裁剪小尺寸人脸,用 H3 精修后再拼回原画面,解决远景人脸模糊、细节丢失的问题。
面向机器人操作任务的统一大脑模型,把抽象指令逐步落到具体动作,配套官方推理代码,可直接用于具身智能研究。
输入一个创意,多智能体流水线自动完成编剧、分镜、画面到成片,生成完整短剧视频,可接入 Seedance、Kling、Veo、Sora 等视频模型。
从多视角立体视觉出发,前馈式快速重建可泛化的高斯泼溅表示,无需逐场景优化即可合成新视角。
基于 Azure AI Search 和 gpt-4o-realtime 的语音 RAG 示例,让语音助手能实时检索知识库并生成带依据的对话回答。
基于节点编辑器的图像处理应用,用拖拽连线的方式搭建和对比不同处理流程,适合做算法验证和效果比较。
把 UI 设计稿直接转成高质量 React 代码的多模态系统,靠视觉语言建模和自动数据合成打通设计与前端开发。
在 NVIDIA DGX Spark 上快速启动、管理和停止 LLM 推理服务,支持 vLLM、SGLang、llama.cpp 等后端,省去手动配置环境的麻烦。
统一模型,从单目视频中同时重建动态人体与三维场景,输出带时间维度的4D结果,可用于人体姿态估计与场景理解。
用 Streamlit 搭建的论文问答应用,把 arXiv 论文切块存入 Redis 向量库,结合 LangChain 与 OpenAI 实现检索增强问答,还能用语义缓存减少重复调用。
一本覆盖 LLM Agent 全流程的实战手册,提供 60+ 代码骨架、教程、生态指南和评测工具,帮你从零搭建、部署并理解智能体系统。
从零实现的大模型蒸馏与推理服务引擎,包含自定义 Triton/CUDA 算子、FSDP 蒸馏、分页 KV 连续批处理、投机解码和 Rust 网关,适合研究推理加速与可解释性。
用深度学习和传统手工特征做多视图图像匹配,为 COLMAP 等 SfM 软件提供高质量匹配结果,支持高分辨率图像和带旋转的图像,提供命令行和图形界面。
基于层次化知识图谱的 Graph RAG 系统,把文档组织成分层结构来提升检索增强生成的召回与准确度,开箱即用。
一站式微调视频生成模型的工具库,支持文本到视频等扩散模型,方便做内容创作和视觉艺术定制。
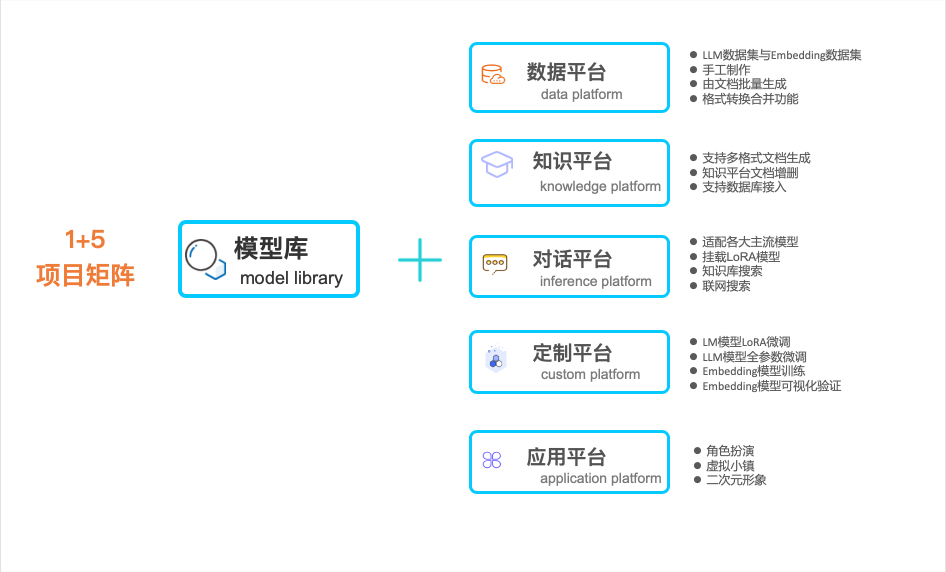
把主流大模型 API 和开源模型统一到一个 WebUI 里,覆盖知识库、数据库、角色扮演、文生图、LoRA 微调、数据集制作等全流程工具。
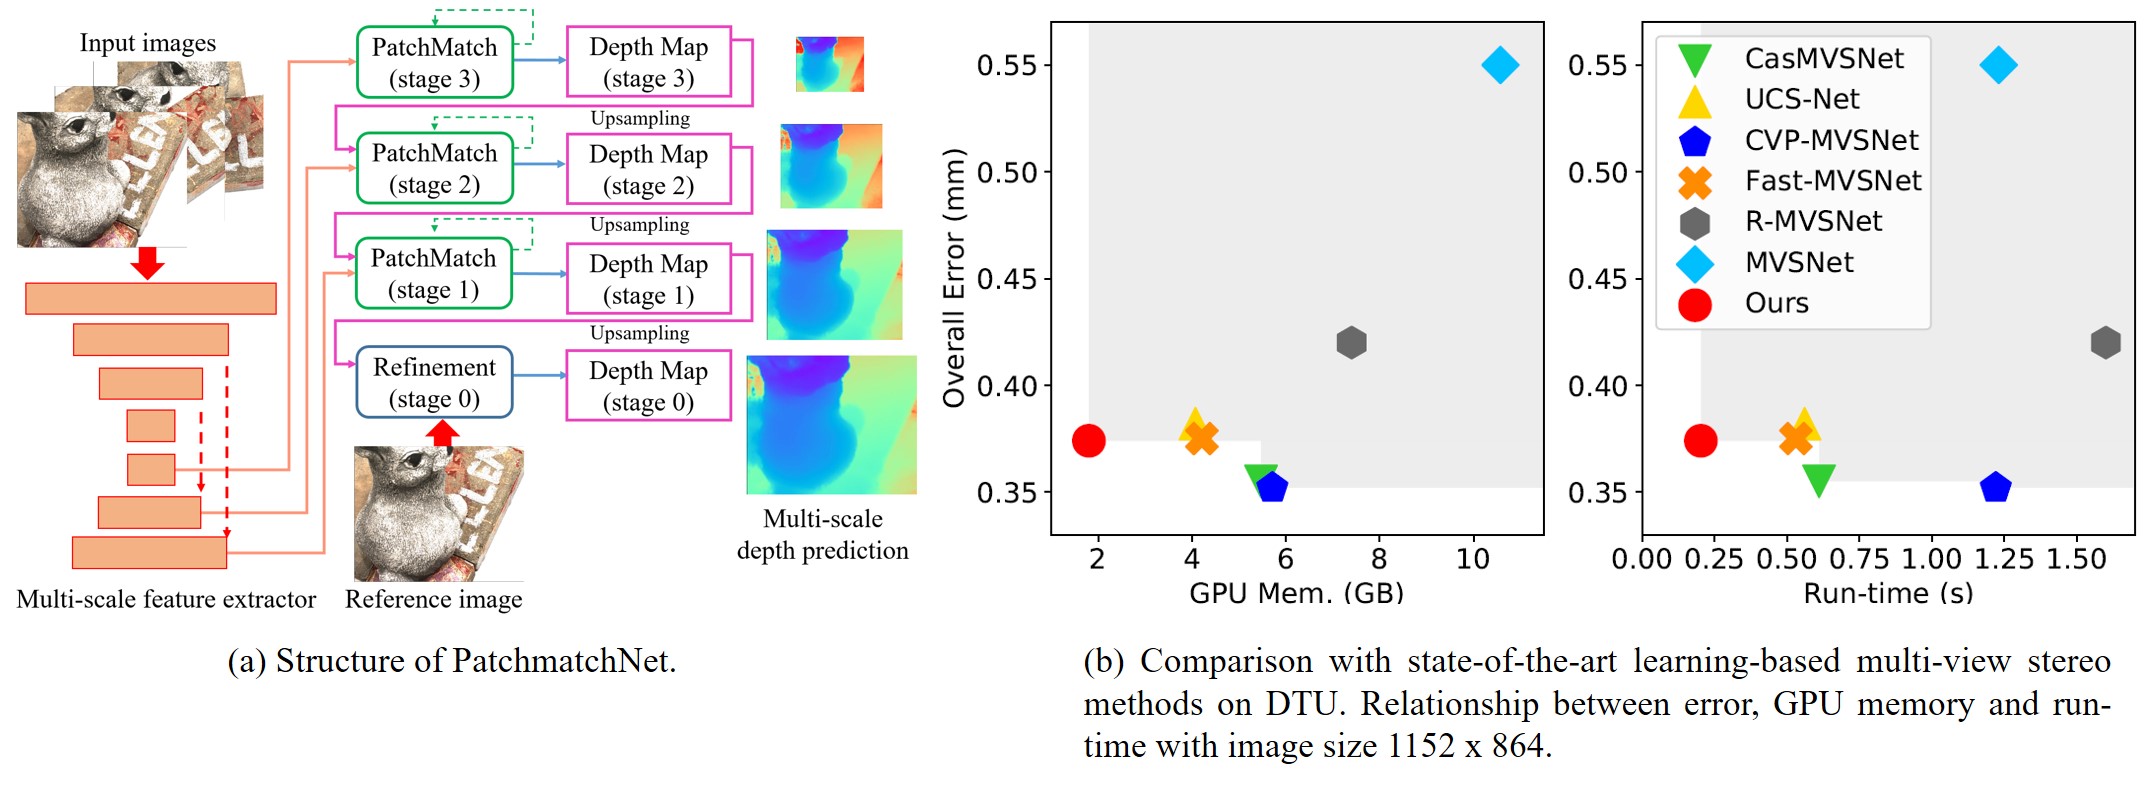
PatchmatchNet 是 CVPR 2021 Oral 的官方实现,用可学习的 Patchmatch 做多视图立体匹配,从多张图片重建稠密三维点云。
提供各行业专用的 Pydantic schema 集合,让视觉语言模型按统一结构输出 JSON,省去手写解析和字段对齐的麻烦。