评估 · 实验 · MLOps
共 240 个仓库 · 一年内有推送
VBench 是 CVPR2024 收录的视频生成评测基准,用多维指标客观衡量文生视频模型的质量,帮研究者横向对比不同生成方案。
Postgres 里的可扩展向量检索扩展,pgvecto.rs 的继任者,主打快速、省磁盘,适合在现有数据库里直接做大规模向量搜索。

一套 Linux 系统性能排查工具集,能像 X 光一样透视进程、CPU 和 I/O 的真实运行状态,快速定位卡顿和异常热点。
腾讯开源的 Node.js 服务端 Web 监控与日志采集方案,能捕获请求链路和运行时数据,帮开发者定位线上问题、做可观测性分析。
在终端里实时查看 Apple Silicon Mac 的 CPU、GPU、内存和功耗占用,类似 top 但针对 M 系列芯片优化,适合跑本地模型时盯资源。
开源机器学习数据库,提供特征平台,为训练和推理计算一致的特征,解决特征工程与线上线下特征不一致的问题。
开源 MLOps 平台,把数据、模型训练、流水线和在线服务串成一条自动化链路,方便在 K8s 和 CI/CD 环境里持续交付机器学习应用。
面向 ggml 生态的开源 LLM/VLM 负载均衡与推理服务平台,用更少组件和简单部署在 CPU/GPU 上自托管大模型,可替代 llm-d 等方案。
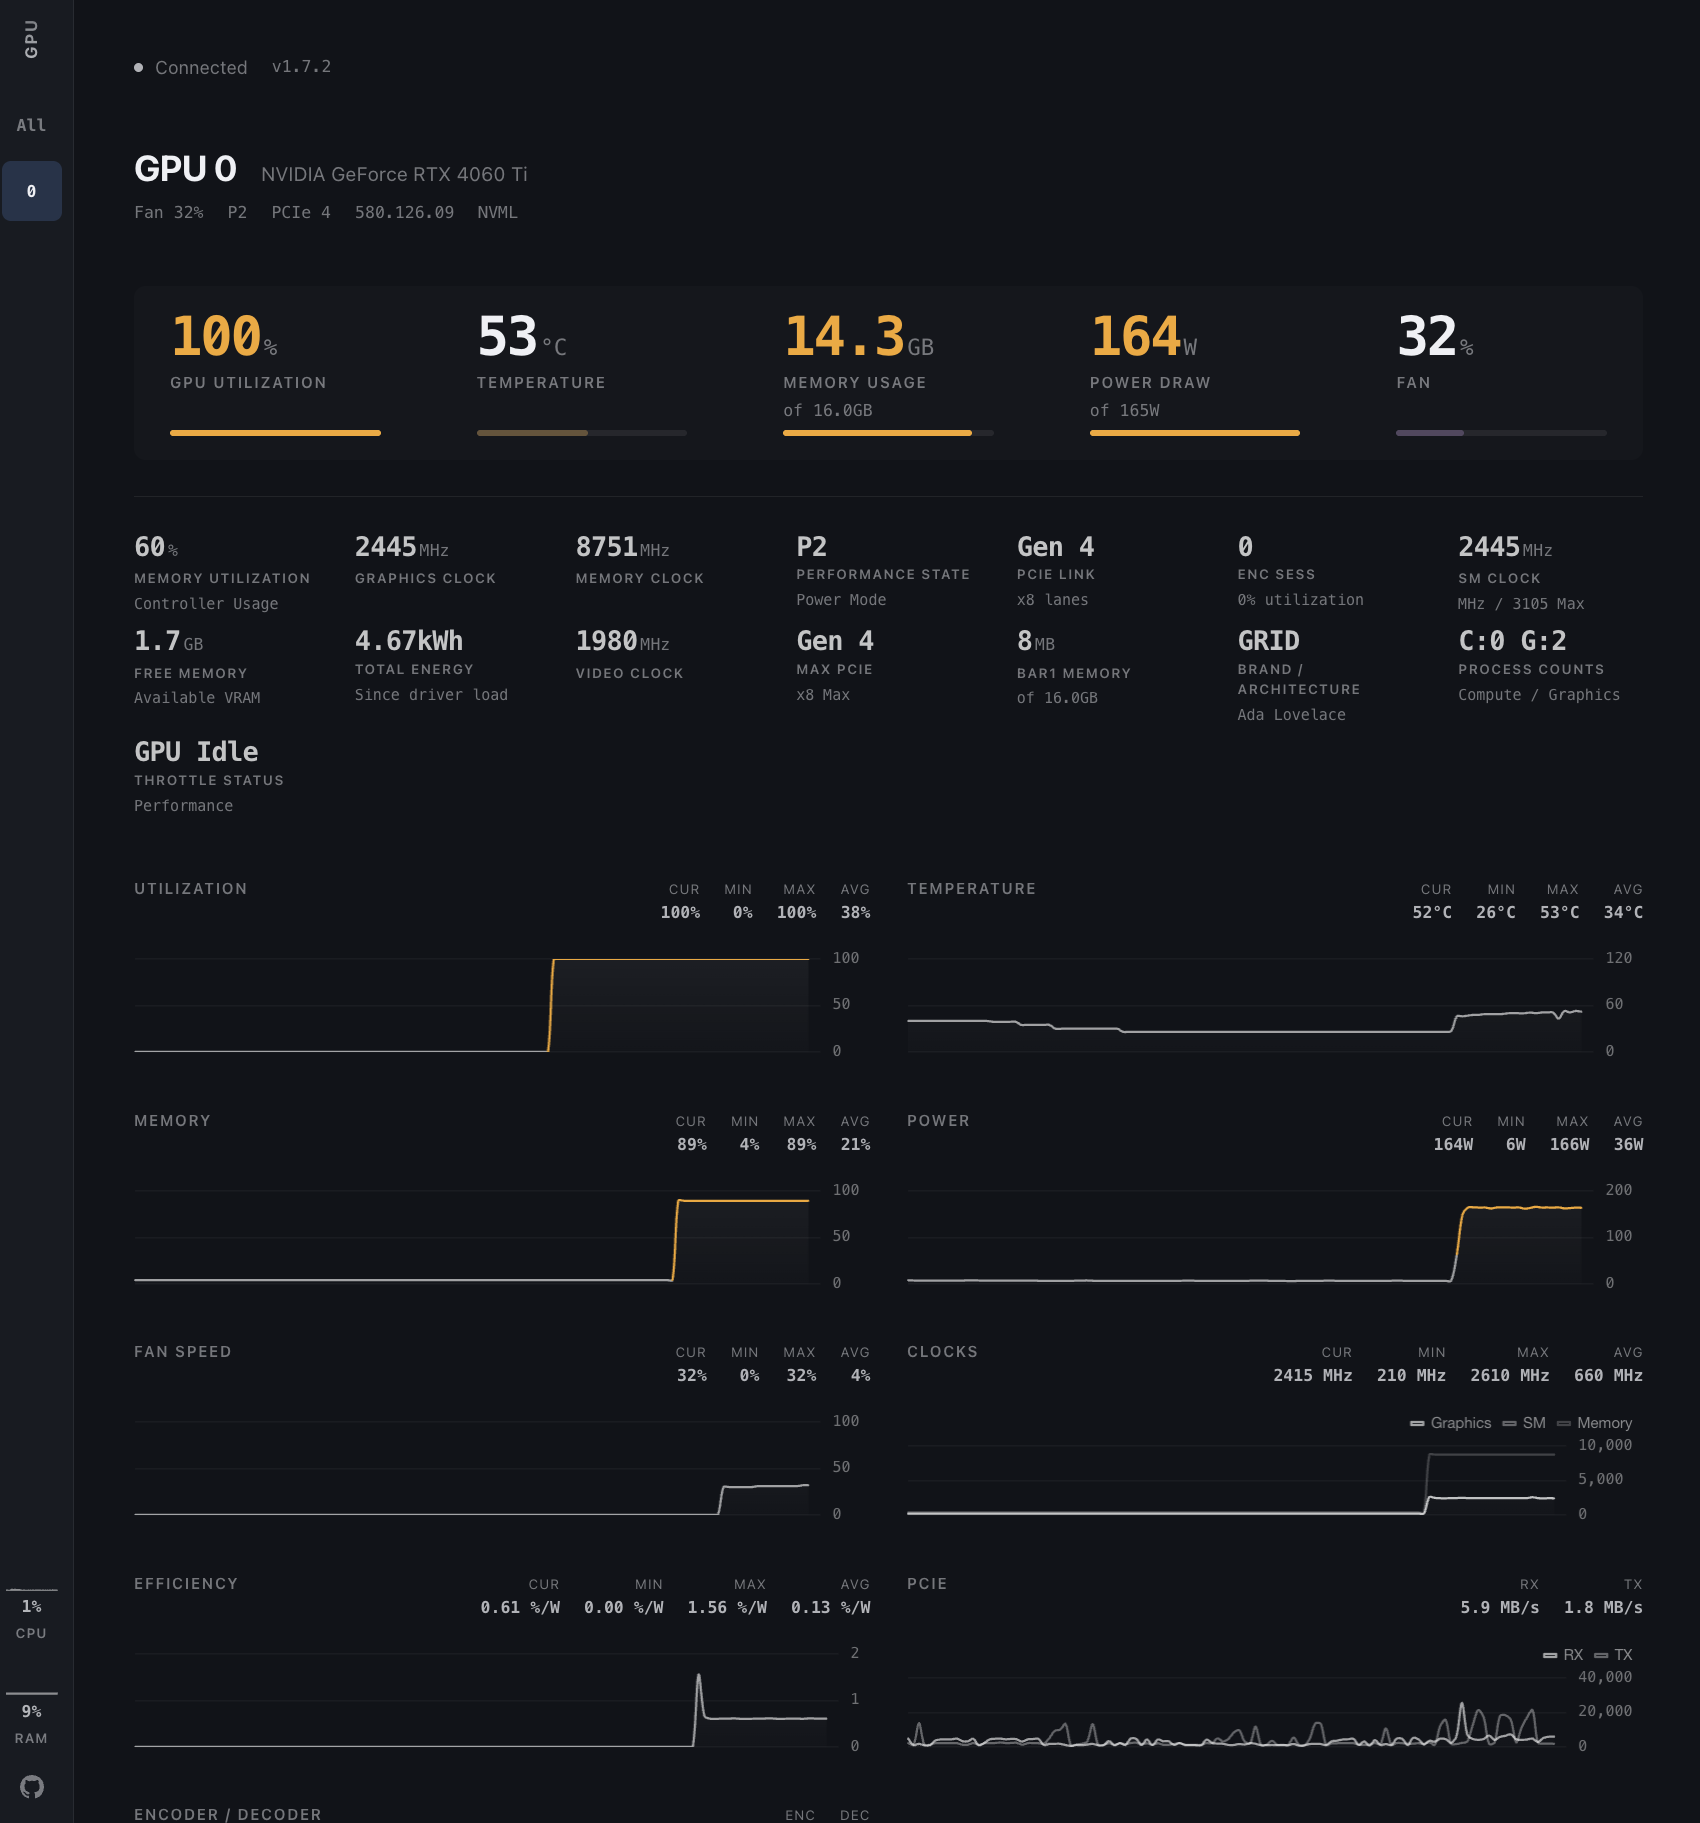
实时监控 NVIDIA GPU 的 Web 仪表盘,用图表展示显存、利用率、温度等指标,方便运维和 MLOps 排查显卡状态。
面向机器学习工程与研究的智能体,能对接 arXiv 和 Papers with Code 检索论文,生成代码与研究方案,并支持 OpenAI、Anthropic、Gemini、Ollama 等模型。

把 Spark、scikit-learn 等训练好的机器学习流水线导出成统一格式,脱离原框架直接部署到生产环境做推理。
用 Python 对多目标跟踪器做基准评测,计算 CLEAR MOT 等标准指标,方便横向对比不同跟踪算法的效果。
Ruby 的类型安全数据校验库,用声明式 schema 和规则定义校验逻辑,支持类型强制转换,适合在数据入库前做结构化校验。
一个可直接用于生产的 MLOps Python 包模板,集成 MLflow、scikit-learn、Pydantic、Pandera 和 uv,帮你快速搭起带实验追踪与数据校验的机器学习工程骨架。
给 LLM 应用接入 OpenTelemetry 埋点,统一采集 OpenAI、LangChain、LlamaIndex 等框架的调用链路,方便做可观测和排障。
从任意文本自动抽取实体与关系并生成知识图谱的 Python 工具,附带基准测试,方便用 LLM 构建和评测图谱抽取流程。
用逼真的合成对话模拟来诊断和优化 LLM Agent 的框架,帮助开发者在真实上线前发现并修复 Agent 的薄弱环节。
把 AI/ML 模型打包成可直接上线的推理服务,省去手写 Docker 和部署脚本的麻烦,一条命令就能跑起来。
自动扫描图像数据集,找出重复、模糊、曝光异常等质量问题,帮你在训练前把数据清洗干净。
向量数据库性能与性价比基准测试工具,支持多种向量库的统一压测和结果对比,方便选型时横向评估。

桌面版 MCP 客户端,把各家 LLM API 和 MCP 工具统一编排到一个界面里,方便快速试用和评估不同模型。
把电子表格变成 AI 流水线:在单元格里串联提示词和模型,实时对比 LLM 输出,多人协作迭代 AI 应用。
在内存中对 brotli、lz4、zstd、zlib 等开源压缩器做统一跑分对比,方便按速度和压缩比挑选合适的压缩算法。

Linux 系统和进程监控工具,能记录并回放 CPU、内存、磁盘、网络等资源使用情况,方便事后排查性能瓶颈。