机器人与具身智能
共 61 个仓库 · 一年内有推送
快速、鲁棒且可扩展的点云配准库,支持 LiDAR、RGB-D 等 3D 数据,并提供 ROS2 SLAM 示例,用于解决三维建图与定位中的配准问题。
系统梳理视觉自回归模型的研究综述(TMLR 2025),覆盖图像生成、多模态、点云、运动预测等方向,帮研究者快速理清技术脉络与加速方法。
面向具身智能的一站式 VLA 工程平台,打通数据、模型训练到真机部署全流程,省去自己拼装工具链的麻烦。
X-VLA 是 ICLR 2026 论文的官方实现,用软提示 Transformer 构建可扩展的跨具身视觉-语言-动作模型,让同一套策略能迁移到不同机器人本体上做操作任务。
汇总动态场景下 SLAM 与终身建图的研究资源,覆盖激光、视觉和多传感器融合方案,方便快速跟进相关论文与代码。
面向 LiDAR 里程计的鲁棒 ICP 算法,专门解决走廊、隧道等几何退化场景下位姿估计失准的问题,是 IEEE RA-L 2025 的 SOTA 方案。
一个不依赖传感器专门建模的鲁棒 LiDAR-惯性里程计,直接融合激光雷达与 IMU 数据估计位姿并建图,适合机器人 SLAM 场景。
把 Depth Anything V3 单目深度估计模型封装成 ROS2 节点,用 TensorRT 加速推理,从相机图像直接输出米制深度图和点云。

基于 Open3D 的 C++ 点云图优化 SLAM 系统,为机器人提供激光雷达建图与定位能力,可接入 ROS 使用。
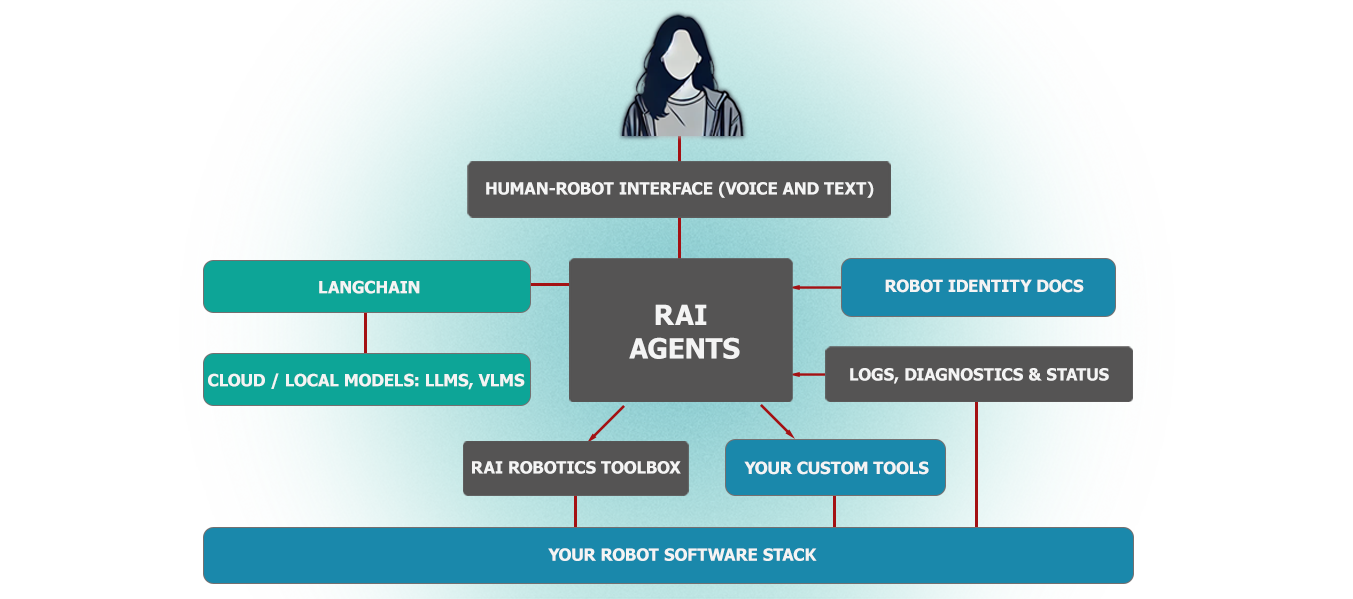
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
一套统一的视觉 SLAM 评测框架,把主流 VSLAM 系统和公开数据集整合到同一套流程里,省去逐个配置环境、跑对比实验的麻烦。

把 Webots 机器人仿真器和 ROS 2 打通的官方软件包,提供示例、定位、导航、SLAM 和运动规划接口,方便在仿真里快速搭建和调试机器人程序。
开箱即用的 LiDAR SLAM 系统,用 Python 实现,能直接完成激光雷达建图与定位,省去繁琐配置。
汇总自动驾驶领域的视觉-语言-动作(VLA)模型资源,梳理其发展脉络与未来方向,方便快速了解该方向的研究与落地进展。
面向多轮视觉语言模型智能体的世界模型强化学习框架,让 VLM Agent 在交互中通过 RL 训练提升多轮决策能力。
仅用一段 MP4 监控录像和对应的谷歌地图位置,就能重建出数字孪生风格的三维交通场景,把画面里的车辆投影到真实地理坐标上。
把视觉语言模型直接改造成机器人操作策略,无需改动架构就能训练出顶尖的视觉-语言-动作模型。
MapEval 是一个统一的 SLAM 建图评估框架,用点云配准和 Wasserstein 距离等指标,稳健高效地给激光点云地图打分,方便做 SLAM 基准对比。
基于点、线、面特征的稀疏视觉 SLAM 系统,支持单目、RGB-D 和双目相机,在保持建图与定位精度的同时提升效率。
SuperVINS 是面向弱光、低纹理等恶劣成像条件的实时视觉惯性 SLAM 框架,把深度学习特征点融入传统 VINS 流程,提升跟踪鲁棒性。
Patchwork++ 的 ROS/ROS2 封装,用于激光雷达点云的快速地面分割与地面点剔除,方便直接接入机器人感知流程。

面向通用机器人策略的空间引导视觉-语言-动作框架,把视觉语言模型和动作输出打通,让机器人能按空间指令执行操作任务。

基于 ROS 2 的紧耦合激光雷达惯性 SLAM 包,融合 NDT/GICP 点云配准与 IMU 数据,用于机器人在复杂环境中的实时定位与建图。
一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。