推理与服务
共 540 个仓库 · 近 4 个月有推送

一个命令行工具,通过 OAuth 代理在 Claude 多账号、Gemini、Copilot 和 OpenRouter 的 300+ 模型之间快速切换,带可视化面板和远程代理支持,零配置即可上手。
Lingvo 是 Google 开源的序列建模框架,用 TensorFlow 搭建语音识别、机器翻译、语言模型等 NLP 任务,支持分布式 GPU 训练。
基于 Whisper 的多语言语音识别工具,能输出词级时间戳和置信度,方便做字幕对齐和逐词定位。
给 Claude Code、Codex 等 AI 编码代理提供持久化统一记忆层,用 Markdown 存内容、Milvus 做向量检索,让代理跨会话记住上下文。
给 paperless-ngx 文档管理系统接上大模型,用 LLM 和视觉 OCR 自动识别扫描件内容、生成标题和标签,让文档数字化更省事。

把 Claude、Codex 等多家 LLM 的 API 统一成一个入口的聚合网关,方便个人集中管理和切换不同模型服务。

用 Go 写的高性能无状态声明式 API 网关,把后端微服务统一收口,负责路由、聚合和协议转换,适合云原生场景做统一入口。
在 Mac 上跑 Qwen 3.8 等大模型的原生推理引擎,靠 MTP 投机解码把速度拉到 125 tok/s,16GB 内存也能跑 27B 模型,并提供 OpenAI/Anthropic 兼容的本地服务。
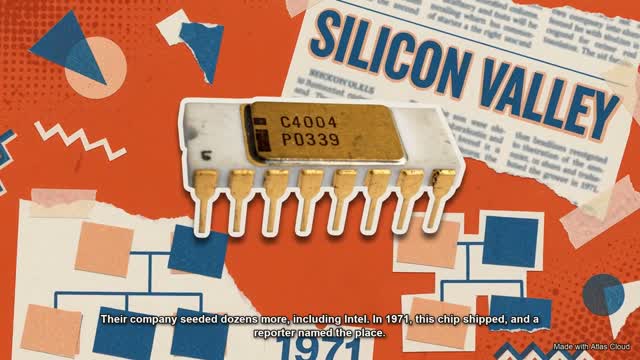
输入一个主题就能自动生成 Vox 风格的拼贴解说视频,从脚本、素材到 ffmpeg 合成全流程跑通,适合做科普短视频。
让大参数 Qwen 模型在消费级显卡上跑得动、跑得快:通过 vLLM 补丁和重量化流水线,单张 24GB 卡即可服务 27B 模型,并附完整基准测试。
微软推出的本地 AI 推理运行时,基于 ONNX Runtime 在设备端跑聊天补全和语音转文字模型,支持 GPU 加速,不用联网也能用。

Hugging Face 官方 JavaScript 客户端库,让前端和 Node.js 项目直接调用 Hub 模型管理、推理 API 等能力,无需自己封装 HTTP 请求。
把音视频内容快速转成结构化 Markdown 笔记,先用 ASR 转写,再交给大模型整理成条理清晰的文本。
把任意电脑或边缘设备变成计算机视觉推理服务器,一条命令部署目标检测、分类、实例分割等模型,省去自己搭服务的麻烦。
开源复现并扩展 Google Research 的 PaperBanana,用多智能体自动生成学术论文配图、示意图和研究可视化,还能做幻灯片。

Milvus 官方实战教程库,用 Jupyter Notebook 演示以图搜图、音频检索、分子搜索、视频分析和 RAG 问答等非结构化数据处理方案。

用 Qwen3-ASR、Whisper 和本地 LLM 给日语音视频自动生成字幕,靠 TEN-VAD 和降噪处理应对嘈杂背景音。
用大模型从编译后的二进制程序还原并验证 C/C++ 源码,把反编译、源码恢复和校验串成自动化流程,适合逆向工程和安全分析场景。

ailia SDK 的预训练模型合集,覆盖动作识别、人脸检测、背景移除、语音处理等任务,拿来就能跑推理,省去自己找模型和调参的功夫。

基于 Envoy Gateway 构建的生成式 AI 统一接入网关,把各家 LLM 和推理服务的调用收敛到一套路由与鉴权入口,方便在 Kubernetes 上统一管理。

面向 AI 原生应用的分布式向量搜索引擎,支持混合检索和 RAG 场景,帮你在海量向量里快速找到相关内容。

把视频按场景切分、去重抽帧并配上字幕文本,让 Claude 等大模型真正「看懂」视频内容,支持 URL 或本地文件,全程本地运行。
把预训练句向量模型蒸馏成轻量静态词向量,推理速度极快、无需 GPU,适合大规模文本向量化和检索场景。
0.9B 参数的多语言长音频转写模型,能同时输出说话人分离、时间戳和声学事件标记,适合做会议记录和字幕生成。