推理与服务
共 540 个仓库 · 近 4 个月有推送
系统梳理大模型推理中 KV Cache 优化的综述仓库,按系统与架构视角归纳显存占用和吞吐瓶颈的各类优化方法,适合做推理加速选型时查阅。
用 Python 编写推理引擎的实验性库,面向 LLM 服务场景,支持 CUDA/GPU 加速,方便快速搭建和试验自己的推理后端。

把 LLM 应用从原型推进到生产环境的框架,集成了 LangChain、MLflow、OpenAI 和 Vertex AI,方便管理提示词与模型部署。
把训练好的 sklearn、XGBoost 等 ML 模型直接暴露成 LLM Agent 可调用的工具,省去自己写胶水代码,让 Agent 能调用传统模型做预测。
基于 Nuxt UI 和 Vercel AI SDK 的聊天机器人模板,开箱即用,帮开发者快速搭建带流式对话的 AI 聊天界面。
轻量高效的全模态强化微调框架,支持 GRPO、DAPO 等算法,用奖励模型驱动 LLM 和多模态 VLM 训练。
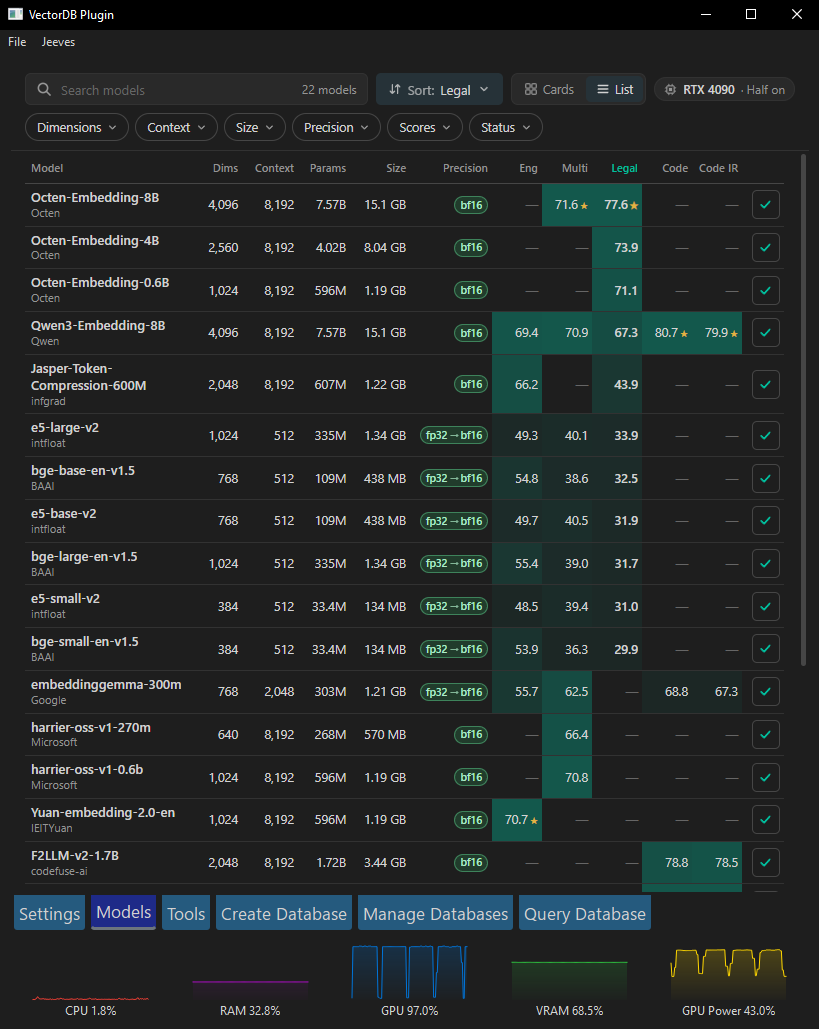
把本地文档和音视频文件建成向量库,用自然语言提问就能检索并回答,适合搭建私有 RAG 问答。
用 LLM 自动审查 Pull Request 的代码差异,并把评审意见直接评论到 PR 上的 GitHub Action,省去人工逐行看 diff 的功夫。
把 git diff 变成带讲解的引导式浏览,用只读 TUI 像资深工程师那样逐段读懂代码改动,适合新人上手和代码评审。
一个统一 API 网关,用一把密钥即可调用 Claude、GPT、Gemini、Grok、DeepSeek 等主流大模型,并提供无审查、去对齐变体,兼容 OpenAI 与 Anthropic 接口,按 token 计费。
自托管的 AI 网关,把私有 RAG、自然语言查数据库和工具调用智能体统一到一个入口,方便在内部环境安全接入大模型。
自托管的 CLIProxyAPI 控制台,统一管理 AI 供应商与客户端密钥,并实时观测流式调用遥测和模型成本快照。
基于 DuckDB 的 TypeScript 数据分析库,能快速处理表格、地理空间、图网络和向量相似度检索,还支持 AI 与 Google Sheets 集成。
给 Claude Code 加钩子的本地代理,能拦截并改写请求与响应,支持自定义模型名和按逻辑智能路由模型。
用消费级硬件在本地搭建并运行大语言模型和聊天机器人,支持 llama-cpp-python、vLLM 和 RAG 检索增强。
纯 Rust 实现的大模型推理引擎,不依赖 PyTorch 和 Python 运行时,主打极快推理速度,适合部署 Qwen 等模型和构建 Agent 服务。
轻量级 LLM 基础设施代理和负载均衡器,能在本地与远程推理后端之间做智能路由、自动故障转移和统一模型发现。
开源语音识别模型 Phonon-2 和 Phonon-1,提供命令行工具以及 CPU、CUDA 镜像,支持低比特量化和 MLX 加速,方便本地部署语音转文字。
在终端里跑自主 AI 代理做渗透测试和攻击性安全评估,省去手动串联工具,适合红队快速验证目标。
统一的多模型 LLM 网关,把 Claude、Gemini、DeepSeek 等上游统一接入,提供权重负载均衡、可观测性和调用费用追踪,适合多模型混用场景。
用大语言模型抓取、聚合、过滤并重写 RSS 订阅源,再对外提供内容服务,适合做新闻聚合与内容改写实验。
给 Grok2API 和 CPA 的出站链路加质量守卫,通过代理恢复、隔离、迁移和运维界面,解决代理不稳定导致的请求失败问题。
在本地设备上跑大语言模型的推理引擎,靠 X-Bit 量化把模型压小,让 Llama、Gemma 这类模型在资源有限的机器上也能流畅生成。
自托管的 OpenAI 兼容 LLM 网关,统一接入多家模型供应商,支持故障转移、密钥轮换和内置管理后台,帮团队稳定调度模型请求。