推理与服务
共 679 个仓库 · 一年内有推送
面向 .NET 开发者的 OpenAI API 封装库,可在 C# 项目里直接调用 ChatGPT、DALL·E、Whisper 和 Azure OpenAI 服务。
用大模型对 Tesseract 的 OCR 结果做纠错、智能分块和 Markdown 排版,把扫描 PDF 转成干净可读的文本,支持本地或 API 模型。
给 JADX 反编译工具加装 MCP 服务端插件,让大模型能直接读取和分析反编译出的 Java 代码,辅助逆向工程与安全审计。
基于 PySide6 的 faster-whisper 图形界面,让语音转文字不用敲命令行,支持 VAD 和 WhisperX 等能力。

面向大语言模型的高性能推理框架,主打高效、灵活和易用,支持 DeepSeek 等模型在 GPU 上做推理服务部署。
面向文本嵌入、重排、CLIP、CLAP 和 ColPali 模型的高吞吐低延迟推理服务引擎,适合把向量化和重排模型部署成线上 API。
把韩文 HWP/HWPX、PDF、Office 和扫描件统一转成 Markdown,还能做新旧对照、保留格式编辑、回写 HWPX 和公文校验,提供库、CLI 和 MCP 接口。
面向 Blackwell 架构 GPU 的高速 LLM 推理引擎,支持 DeepSeek、Kimi、GLM 等模型,主打极致推理吞吐与低延迟。
给 Whisper 语音识别模型套上 Gradio 网页界面,上传音视频就能自动生成字幕,省去命令行操作。

一个命令行工具,通过 OAuth 代理在 Claude 多账号、Gemini、Copilot 和 OpenRouter 的 300+ 模型之间快速切换,带可视化面板和远程代理支持,零配置即可上手。
Lingvo 是 Google 开源的序列建模框架,用 TensorFlow 搭建语音识别、机器翻译、语言模型等 NLP 任务,支持分布式 GPU 训练。
基于 Whisper 的多语言语音识别工具,能输出词级时间戳和置信度,方便做字幕对齐和逐词定位。
给 Claude Code、Codex 等 AI 编码代理提供持久化统一记忆层,用 Markdown 存内容、Milvus 做向量检索,让代理跨会话记住上下文。
给 paperless-ngx 文档管理系统接上大模型,用 LLM 和视觉 OCR 自动识别扫描件内容、生成标题和标签,让文档数字化更省事。

把 Claude、Codex 等多家 LLM 的 API 统一成一个入口的聚合网关,方便个人集中管理和切换不同模型服务。

一个用 Rust 写的 API 平台,把搜索、推荐、RAG 和数据分析打包在一起,底层接 PostgreSQL 和 Qdrant 向量库,省去自己拼装检索链路的麻烦。

用 Go 写的高性能无状态声明式 API 网关,把后端微服务统一收口,负责路由、聚合和协议转换,适合云原生场景做统一入口。
在 Mac 上跑 Qwen 3.8 等大模型的原生推理引擎,靠 MTP 投机解码把速度拉到 125 tok/s,16GB 内存也能跑 27B 模型,并提供 OpenAI/Anthropic 兼容的本地服务。
输入一个主题就能自动生成 Vox 风格的拼贴解说视频,从脚本、素材到 ffmpeg 合成全流程跑通,适合做科普短视频。
让大参数 Qwen 模型在消费级显卡上跑得动、跑得快:通过 vLLM 补丁和重量化流水线,单张 24GB 卡即可服务 27B 模型,并附完整基准测试。
微软推出的本地 AI 推理运行时,基于 ONNX Runtime 在设备端跑聊天补全和语音转文字模型,支持 GPU 加速,不用联网也能用。

Hugging Face 官方 JavaScript 客户端库,让前端和 Node.js 项目直接调用 Hub 模型管理、推理 API 等能力,无需自己封装 HTTP 请求。
EAGLE 系列投机解码算法的官方实现,通过草稿模型加速大语言模型推理,在几乎不损失生成质量的前提下显著提升吞吐。
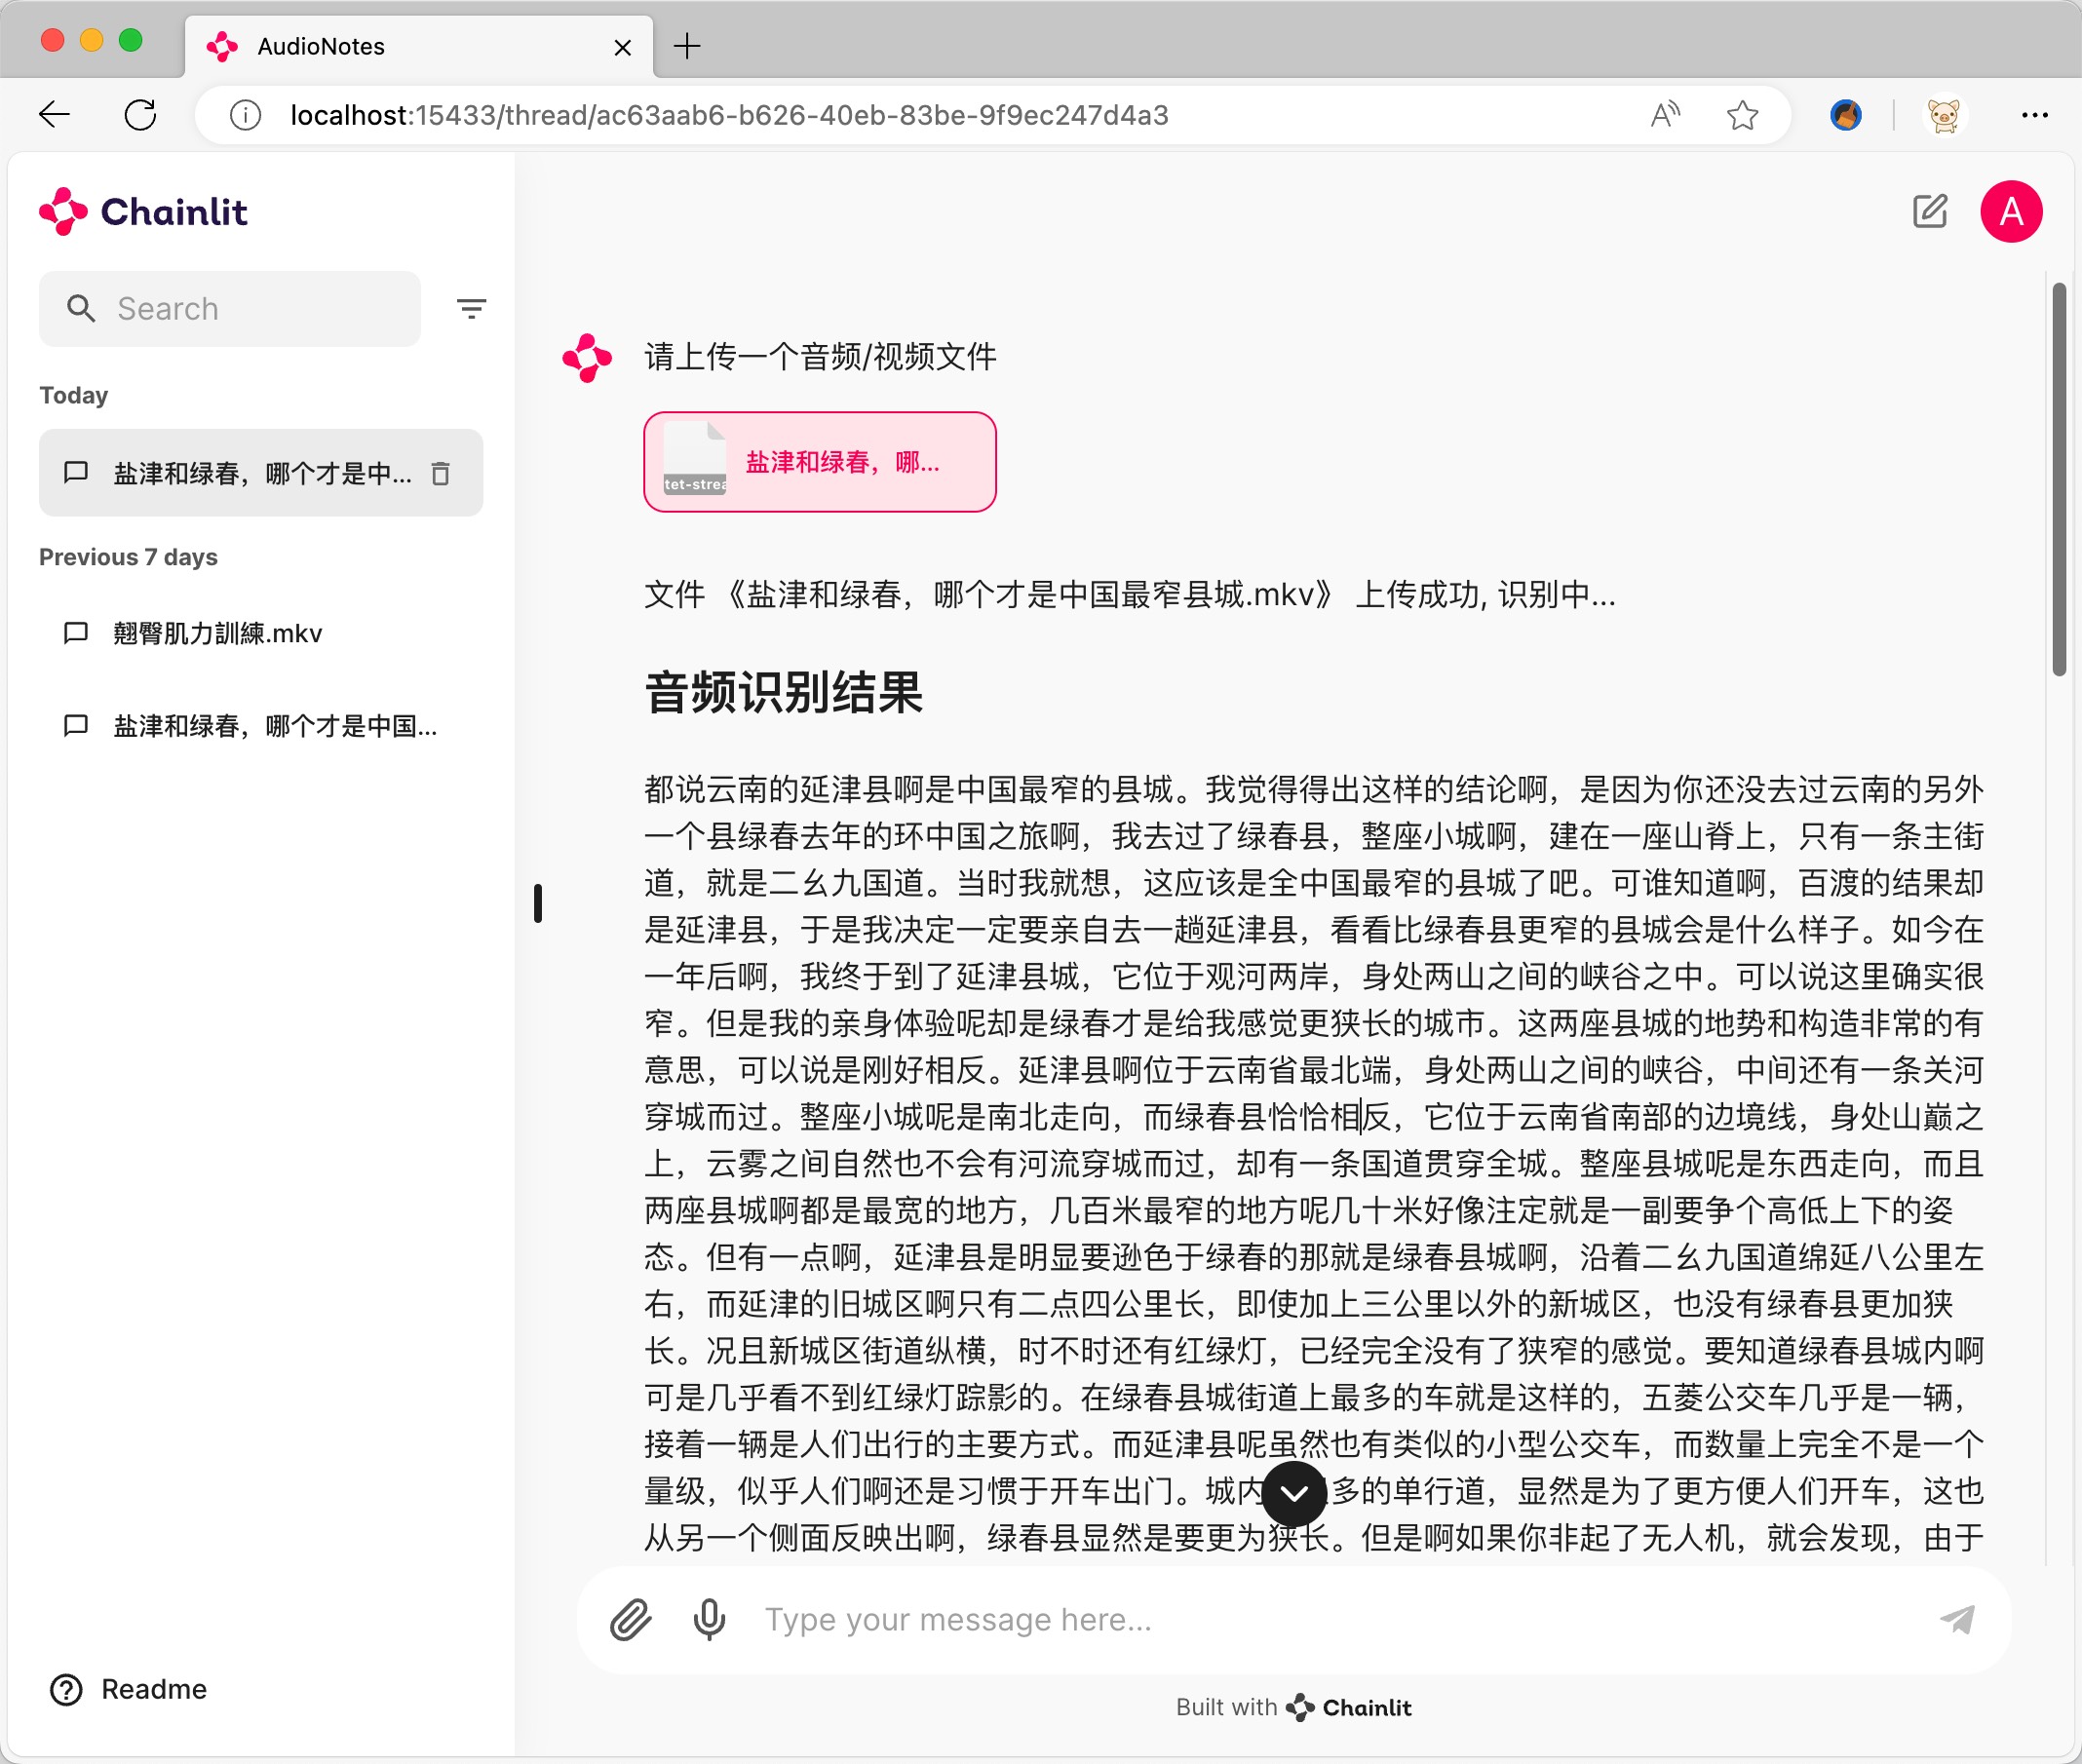
把音视频内容快速转成结构化 Markdown 笔记,先用 ASR 转写,再交给大模型整理成条理清晰的文本。