推理与服务
共 751 个仓库
面向 XLA 设备(先支持 TPU,后续扩展 GPU)的大模型推理引擎,主打高吞吐和低显存占用,适合在 JAX 生态里跑 Llama、Gemma 等模型。
字节跳动开源的模型编译方案,基于 MLIR/LLVM 把 PyTorch、ONNX、TensorFlow 等模型编译到多种硬件上运行,解决跨平台部署和推理性能问题。
基于 txtai 的检索增强生成示例,把向量检索和大模型结合起来,让你用自己的数据做问答和洞察分析。
用嵌入向量做 GitHub 仓库推荐,并生成更清晰的 Star 历史图表,帮开发者发现值得关注的项目。

用 Rust 写的开源 AI 网关,单二进制自带控制台,统一路由、鉴权、预算和观测 OpenAI、Anthropic、Gemini、Bedrock 等各家 LLM 调用。
整理 RAG(检索增强生成)相关的论文、工具和资源清单,帮你在 LLM 应用里快速找到检索增强的落地方案。
在 Mac 上用 MLX 本地跑视觉和文本嵌入模型的 Python 包,方便给 RAG 和检索应用生成向量,不用依赖云端 API。
面向 iPad 和 iPhone 的开源端侧 AI 智能体工作台,在设备本地跑 Linux、终端、Python/Node.js、Git 和 3D/CAD 编辑,支持自带密钥接入大模型。
给 OpenAI 请求加一层隐私代理,自动检测并脱敏提示词中的 PII 等敏感信息,让调用大模型时不泄露用户数据。
面向大模型的一站式压缩 Python 包,集成量化与 QEP 等技术,可压缩模型体积并接入 vLLM 加速推理部署。
用统一接口调用 Anthropic、Cohere 等多家大模型,省去分别对接各家 API 的麻烦,适合快速搭建 LLM 应用。
免调优的 KV Cache 2bit 非对称量化方案,能大幅压缩大模型推理时的显存占用,让长上下文推理在有限显存下跑起来。

自托管的 AI 网关与推理防火墙,为 Agent 提供身份与访问管理,拦截提示注入并审计调用,防止 LLM 被滥用。

自托管的 AI API 网关,把 Claude Code、Codex、Gemini 的 API Key 和订阅账号汇到一个端点,统一做故障转移、协议转换和成本统计。
面向 Redis 的 AI 原生 Python 客户端,把向量检索、缓存和 RAG 所需的数据操作封装成简单接口,省去自己拼装底层命令。
暂无描述
系统讲解大模型推理与部署的理论与实践,涵盖量化、LoRA、剪枝、知识蒸馏等模型压缩与优化技术,适合想上手 LLM 部署的开发者学习。
用大模型自动给科研论文打标注,结合向量检索定位相关内容,省去人工逐篇阅读和整理文献的功夫。
开源的 Agent 运行时,让团队在自己的基础设施上部署智能体,全程掌控运行环境与数据。
系统梳理大模型推理中 KV Cache 优化的综述仓库,按系统与架构视角归纳显存占用和吞吐瓶颈的各类优化方法,适合做推理加速选型时查阅。
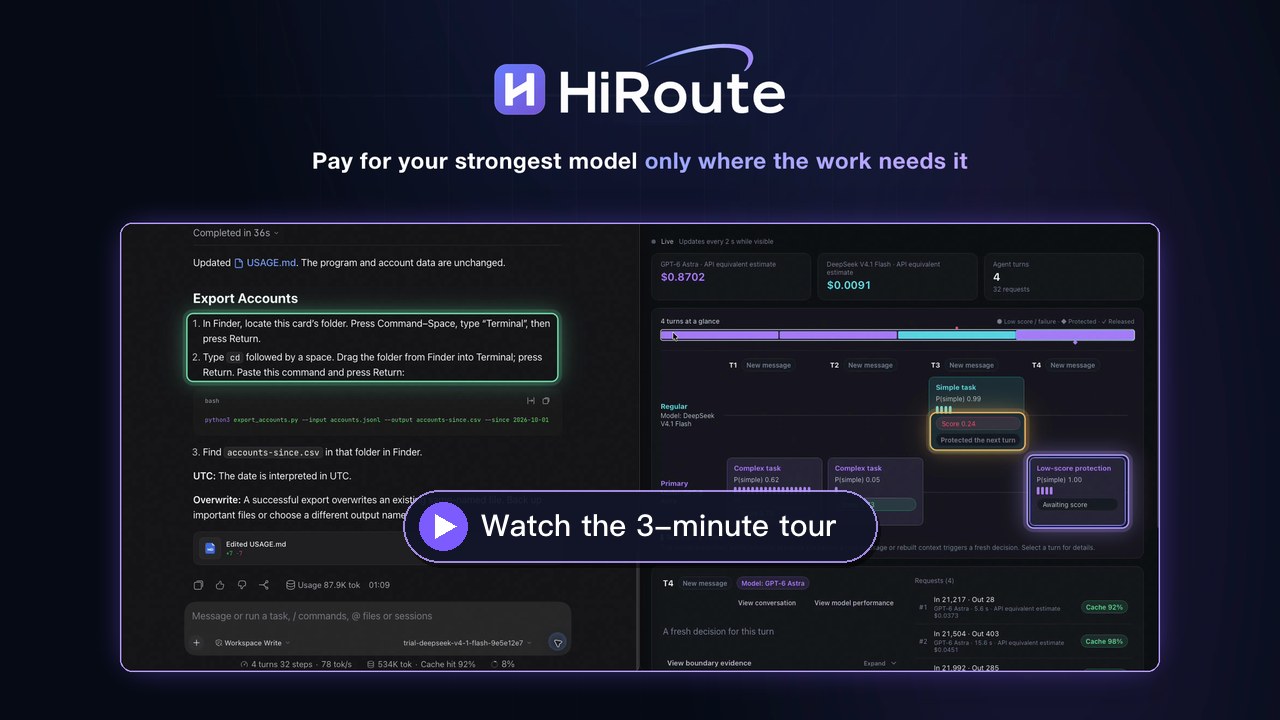
本地模型路由器,把日常 agent 任务分给便宜模型,难题留给最强模型,让 Codex 和 Claude Code 订阅更耐用、更省钱。
用 Python 编写推理引擎的实验性库,面向 LLM 服务场景,支持 CUDA/GPU 加速,方便快速搭建和试验自己的推理后端。
用大模型做主题建模的提示词框架,自动从文本语料中生成可读的主题描述并分配文档标签,替代传统 LDA 类方法。
Stream-Omni 是一个类 GPT-4o 的多模态对话模型,支持文本、图像、语音任意组合的实时交互,可用于语音问答和多模态聊天场景。