多模态生成

共 261 个仓库 · 近 4 个月有推送
打开分类页
Phosphene
mrbizarro·Python

在 Apple Silicon Mac 上离线跑 LTX-2.5 和 MiniMax H3,做带声音的文本/图片转视频、对口型和角色 LoRA 训练,不用云端和 API key。

本地视频生成+4视频生成
366+5557v5.0.162026-11-10 21:13 UTC
FIBO
Bria-AI·Python

首个开源的 JSON 原生文生图模型,用结构化 JSON 输入实现可控、可预测且版权合规的图像生成。

文生图+4图像生成
359222026-11-03 14:06 UTC
lora-dataset-studio
perfectgf·Python

本地一站式 LoRA 训练工作台,从单张照片或大批图片构建角色、风格、概念数据集,自动打标并用 ai-toolkit 训练,支持多模型 checkpoint 对比。

LoRA 训练+4图像生成
350+1042v2026.11.122026-11-09 18:22 UTC
Meissonic
viiika·Python

用掩码生成式 Transformer 做高分辨率文生图的官方实现,把非自回归架构重新拉回实用水平,兼顾生成效率与画质。
文生图+4图像生成
347112026-10-21 13:41 UTC
ComfyUI-MiniMaxH3-Director
seesee75-commits·Python

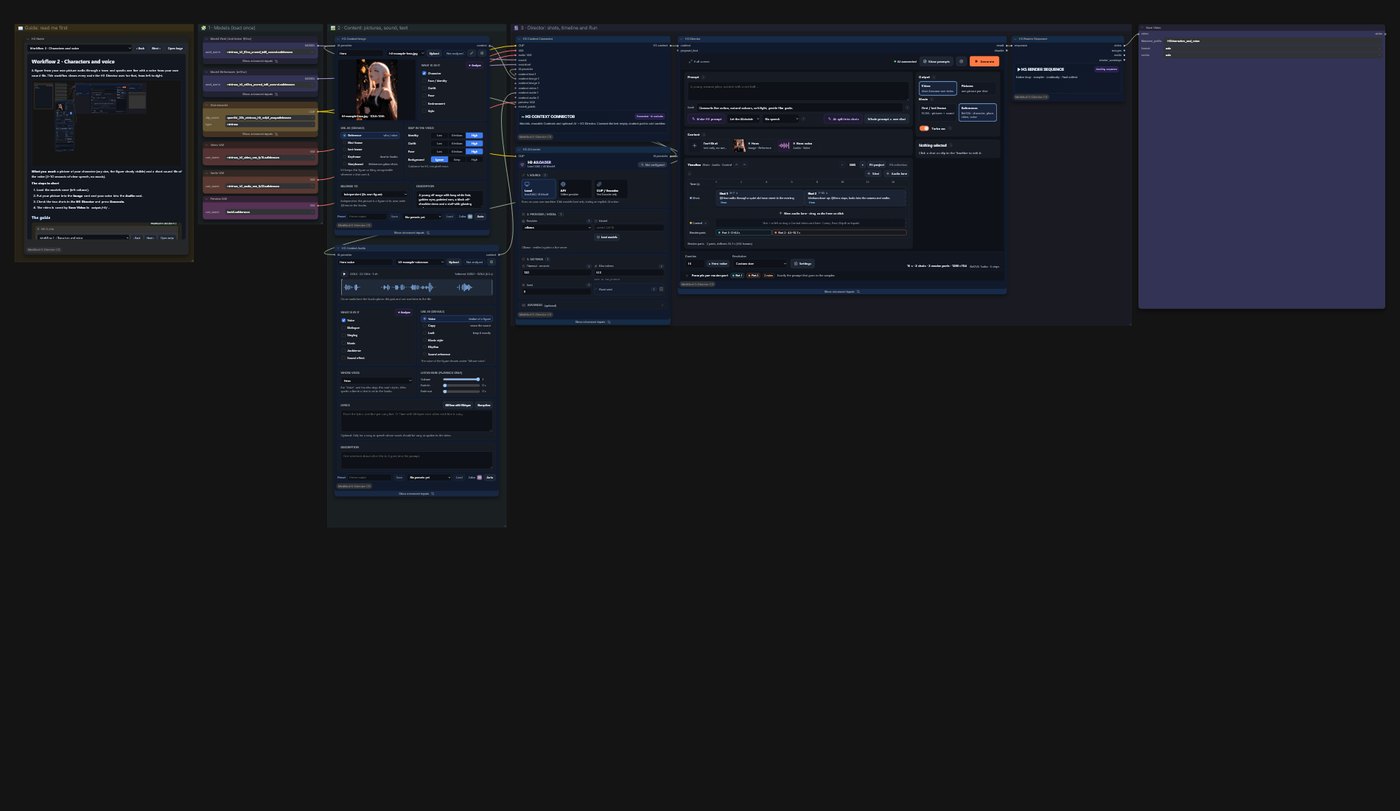
在 ComfyUI 里给 MiniMax H3 视频模型加了一条时间轴编辑器,用分镜提示词、首尾关键帧、图/视频/音频参考和联合音频来编排镜头,还能实时预览采样、重拍和镜头串联。

时间轴编辑器+4视频生成
346+242v1.0.12026-11-03 07:43 UTC
sdk
vargHQ·TypeScript

用 JSX 声明式描述视频,统一调用 Kling、Flux、ElevenLabs、Veed 等模型生成视频、图像和配音,省去逐个对接各家 API 的麻烦。

视频生成+4语音
343+224cli-v0.21.02026-11-01 00:59 UTC
AI-Influencer-Generator
SamurAIGPT·Jupyter Notebook

开源 AI 网红生成器,用 FLUX 等模型批量生成可定制的虚拟人物形象,适合做社交媒体内容创作。

虚拟网红+4图像生成
342892026-08-02 09:37 UTC
awesome-seedance-2.5-api-prompts
Anil-matcha

整理 Seedance 2.5 视频生成 API 的提示词、参数与调用示例,帮开发者快速上手字节跳动的图生视频能力。

视频生成+4视频生成
329572026-10-06 21:47 UTC
vox-ai-motion-graphics-generator
Anil-matcha·Python

输入一个主题就能自动生成 Vox 风格的纸片拼贴解说视频,脚本、关键帧、动画、配音、配乐和字幕全流程搞定,还能作为 Claude Code 等编程智能体的技能调用。

解说视频生成+4语音
321562026-09-02 15:19 UTC
Clip-Anything
SamurAIGPT·Python

用自然语言提示从任意视频中精准截取片段,省去手动拖时间轴找画面的麻烦,适合快速产出短视频素材。
视频剪辑+4视频生成
314602026-07-21 10:05 UTC
Loomic
fancyboi999·TypeScript

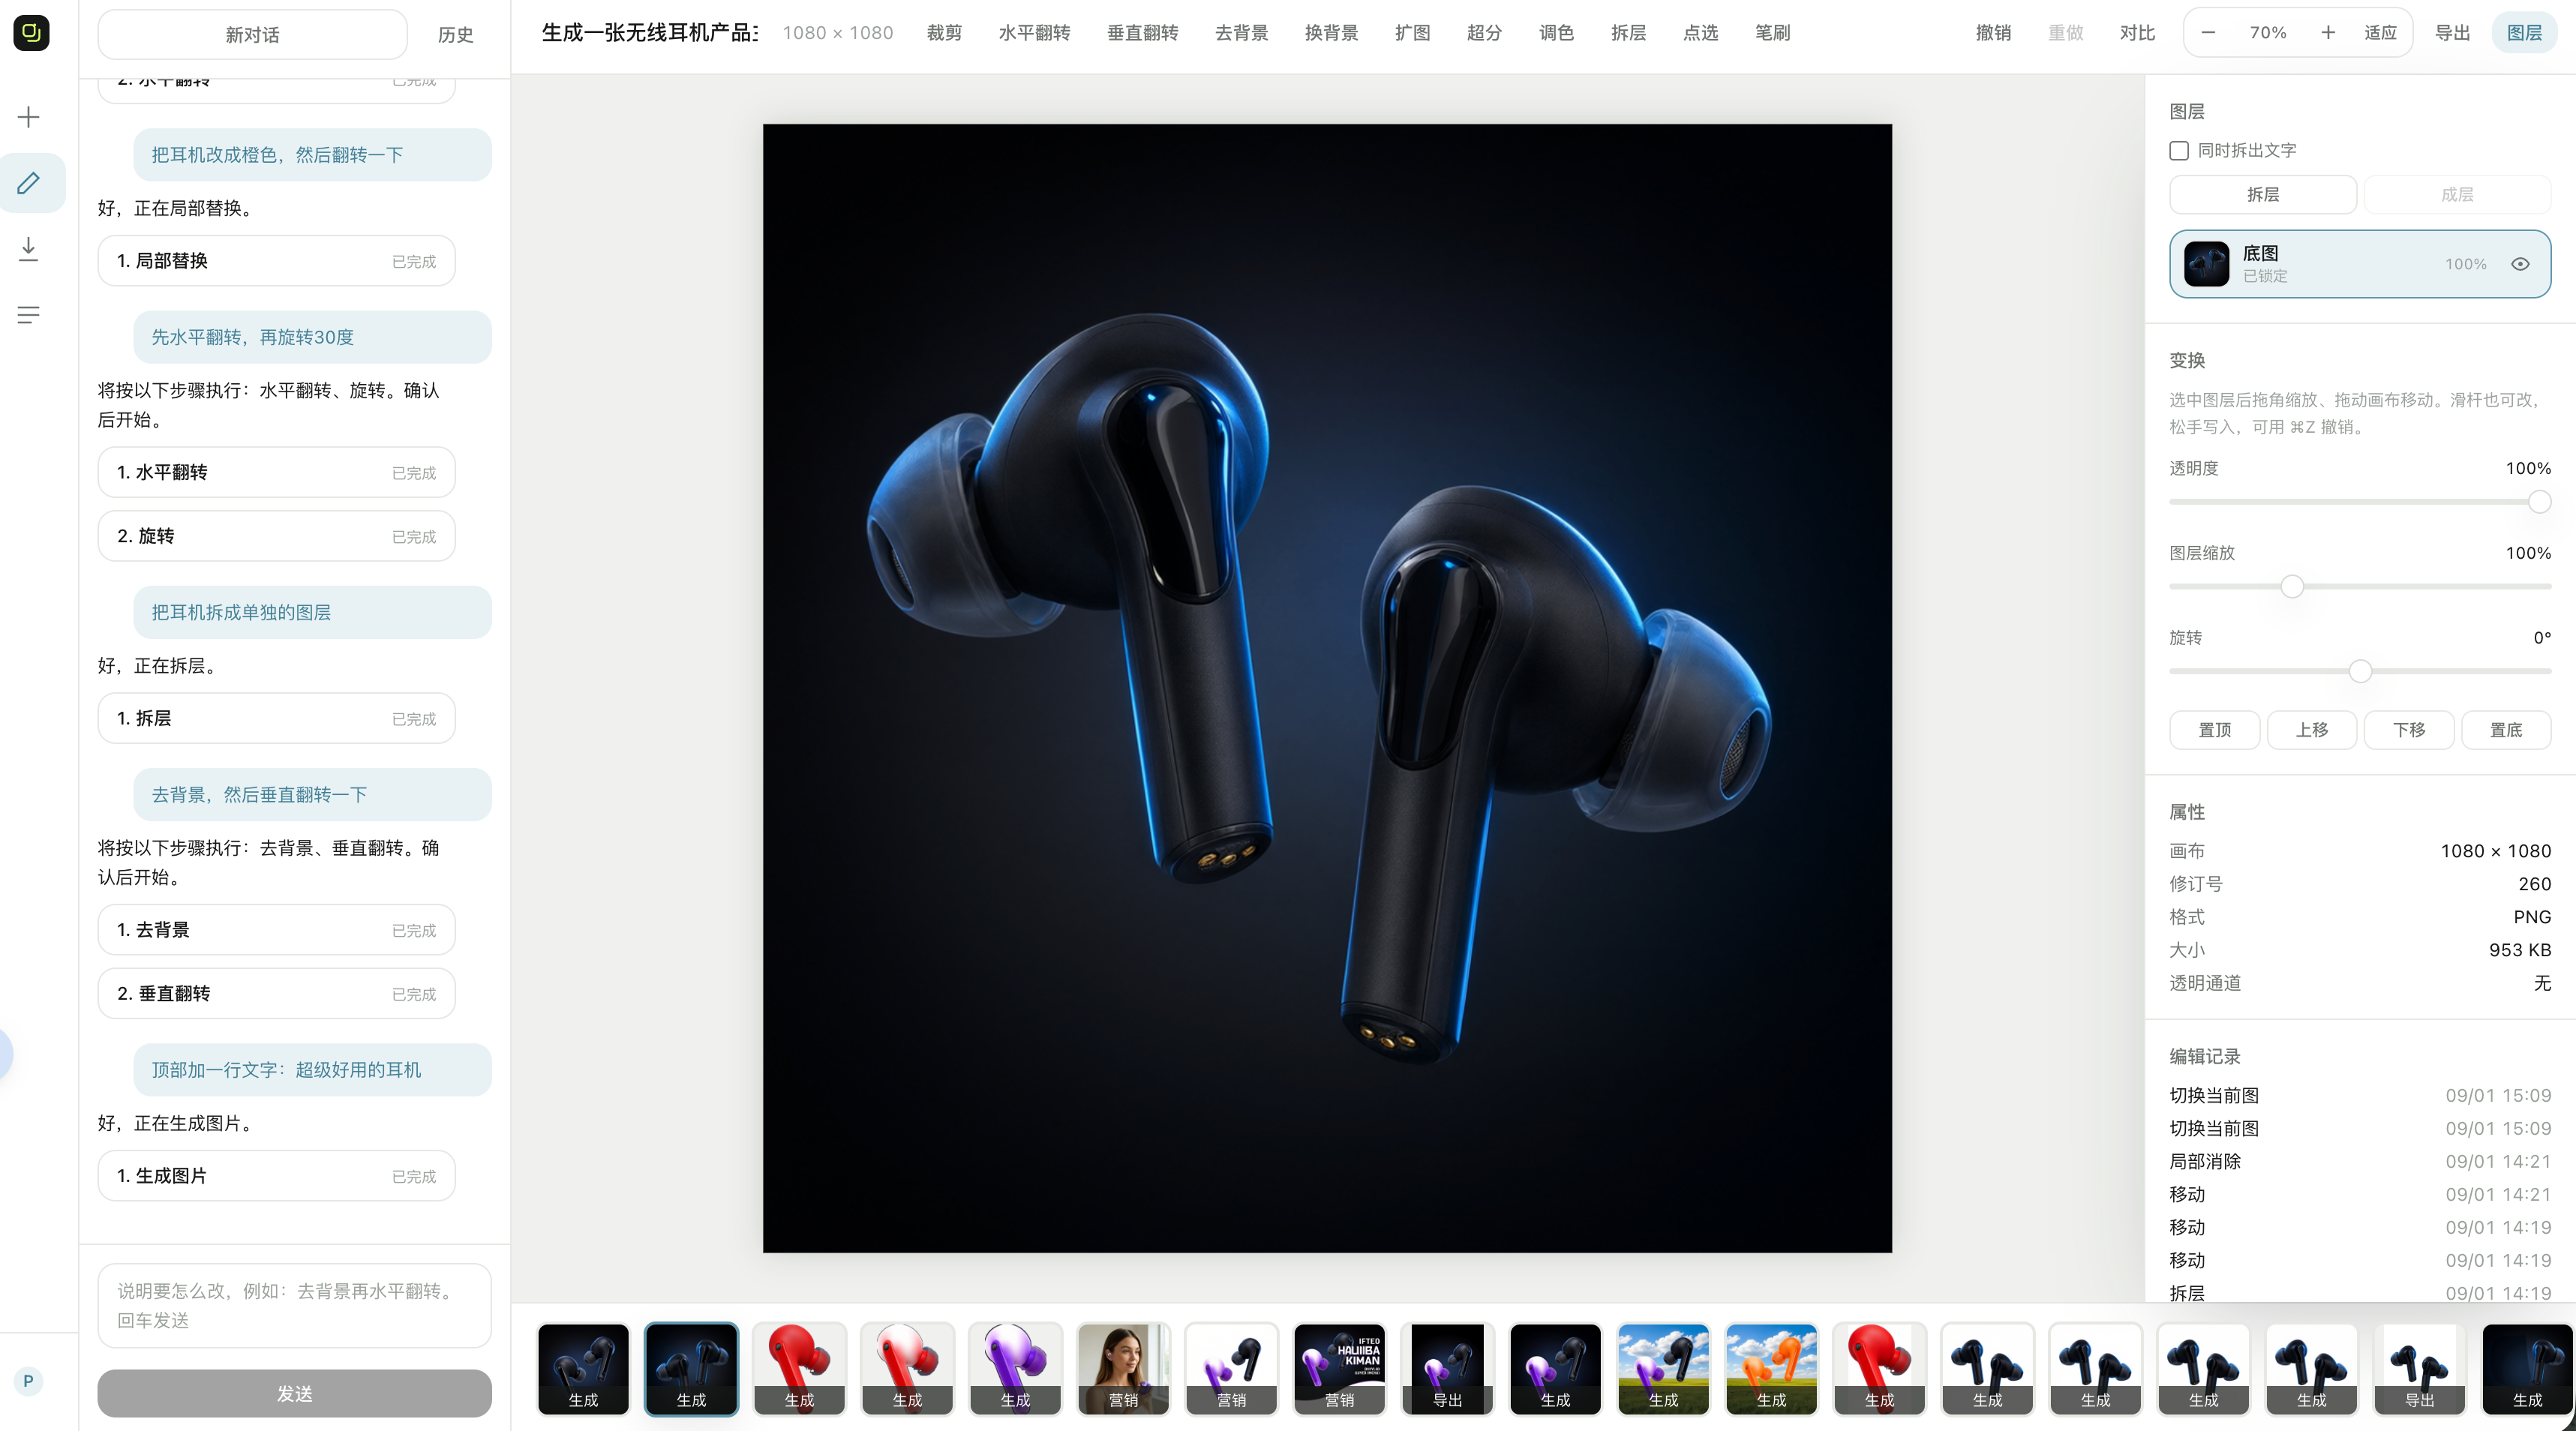
开源的 AI 画布设计助手,在无限画布上通过对话生成和编辑图片、视频,可替代 Lovart、Canva AI 等商业设计工具。
AI 画布+4图像生成
308622026-09-30 15:51 UTC
ai-picture-editor
yuyuanweb·Python

基于 React 19 + FastAPI + LangChain/LangGraph 的 AI 修图智能体,用自然语言驱动 21 种编辑工具完成抠图、图层拆分、区域编辑和文生图,配套教程带你一周掌握 AI Agent 全栈开发。
AI修图+4图像生成
306672026-09-16 08:39 UTC
Mix-Studio
BlackMixture·JavaScript

基于 ComfyUI 的响应式 AI 创作工作台,在电脑或手机上流畅运行调优好的图像与视频生成工作流,适合自托管使用。

图像生成+4图像生成
304+237v1.3.02026-10-26 13:51 UTC
NIGHTRUN
hardrave·Rust

让 PC 开机直接进入大模型运行环境,基于 Rust 的 UEFI 常驻方案,底层不需要操作系统,省去启动系统开销。

UEFI+4视觉语言模型
304292026-07-27 19:40 UTC
i1
zlab-princeton·Python

一套完全开源的强文本到图像扩散模型训练配方,提供 JAX 和 PyTorch 实现,方便复现和二次开发。
文本到图像+4图像生成
294192026-08-16 07:14 UTC
x-unet
lucidrains·Python

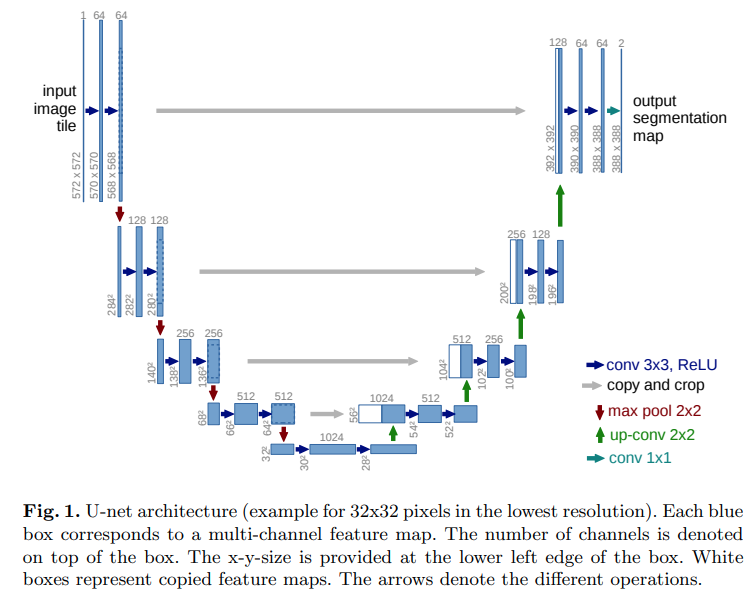
实现带高效注意力的 U-Net,并融合最新研究改进,适合图像生成和分割任务的训练与微调。
U-Net+4图像生成
294230.4.02026-09-23 02:12 UTC
SparseVLMs
Gumpest·Python

SparseVLM 是 ICML'25 与 TPAMI'26 论文的官方实现,通过稀疏化视觉 token 来降低视觉语言模型的计算开销,提升多模态推理效率。

视觉语言模型+4视觉语言模型
28922v2.02026-07-30 11:23 UTC
OmTrackVLA
om-ai-lab·Python

面向视觉-语言-动作模型(VLA)的可复现开源研究项目,聚焦目标跟踪类 VLA,提供训练与评测代码,方便复现和对比实验结果。

视觉语言动作模型+4具身智能 / VLA
289162026-07-21 05:58 UTC
lighthouse
line·Python

面向视频/音频片段检索与高光检测的可复现 Python 库,统一多模态流程,方便研究者快速复现和对比实验结果。

视频片段检索+4视觉语言模型
27222v1.22026-11-01 13:05 UTC
seedance-2.0-api
apiframe-ai

字节 Seedance 2.0 视频生成 API 的调用示例,覆盖文生视频和图生视频两种模式,方便开发者快速接入。

视频生成+4视频生成
25912026-08-14 22:11 UTC
flow-agent
kodelyx·JavaScript

封装 Google Flow 的 CLI 工具,用命令行批量生成 Nano Banana Pro 图片和 Omni Flash 视频,并支持 MCP v2 与 OpenAI API 接入。

命令行工具+4图像生成
25781v1.0.02026-09-25 05:35 UTC
texel-studio
EYamanS·Python

用工具调用方式逐笔绘制像素画的 AI 智能体,靠形状、噪点和逐像素控制作画,而非扩散模型生成,适合做游戏素材。
像素画生成+4图像生成
252+2462026-10-12 18:04 UTC
Crayotter
idwts·Python

基于多模态大模型的视频剪辑智能体,能把文字需求直接变成成片,自动完成剪辑、合成与全流程视频生产。

视频剪辑+4视频生成
252+112v1.1.02026-10-31 08:35 UTC
FreeFuse
yaoliliu·Python

多主体 LoRA 融合方法,在测试时通过自适应 token 级路由把多个 LoRA 组合起来,让扩散模型一次生成多个指定主体。

LoRA 融合+4图像生成
250+1232026-11-06 05:53 UTC