多模态生成
共 372 个仓库 · 一年内有推送
OmniVinci 是英伟达开源的全模态大模型,能同时理解视觉、音频和语言三种输入,适合做多模态联合推理与训练研究。
一套面向财经科技短视频的 AI 制作技能包,覆盖选题设计、找片截图、配音、渲染和混音,帮内容创作者快速产出华尔街风格的解读短片。
面向 LLM 和扩散 Transformer 的无损压缩方案,在 GPU 推理时压缩模型权重、降低显存占用,同时保持输出完全一致。
给无声视频自动配上生动且与画面同步的音效,基于扩散模型实现视频到音频的拟音合成。
开源的扩散式语言模型,专攻代码生成,一并放出预训练、评测、推理代码和模型权重,方便直接复现和二次开发。
小米开源的视觉语言模型,能看图回答问题,适合做视觉问答和多模态理解任务。
基于认知强化学习、用推理链引导的文本指代图像分割方案,让多模态大模型先推理再分割,提升复杂场景下的分割精度。
把语言模型直接当作统一的多模态生成器,用自回归方式同时做文本到图像生成,省去额外扩散模型。
开源 AI 视频工作台,可接入任意模型或本地 ComfyUI,让 Claude Code、Codex、Cursor 通过 MCP 指挥分镜、参考图、生成和真实时间轴上的可编辑初剪,项目与密钥全部留在本地。
基于扩散模型的指令式视频编辑方案,配套高质量合成数据集,解决视频编辑训练数据稀缺、难以规模化的问题。
把单个知识点自动做成带旁白、逐句标注出处的知识短片,基于 Claude Code 技能,内置 44 套视觉风格,代码逐帧渲染成片。
面向智能体的创意工作台,把图像生成、图像处理和动态图形等模型接入统一界面,方便在创作流程中直接调用多种多模态生成能力。
把 GPT Image 2 生成的图片接入 Seedance 2.5 做图生视频的工作流指南,含提示词与 API 调用示例,帮你快速跑通从出图到成片的流程。
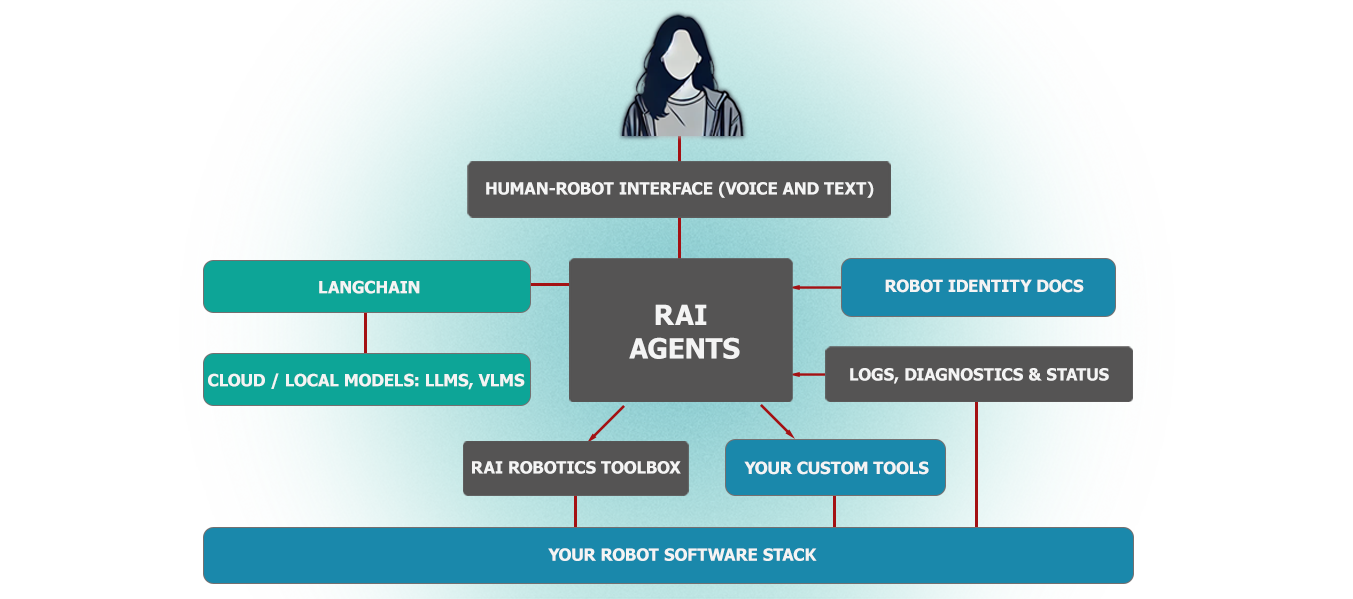
面向物理 AI 机器人的厂商无关智能体框架,基于 ROS 2 工具执行复杂动作、场景任务、自由接口调用、日志摘要和语音交互。
基于预训练模型的持续学习工具箱,集成多种增量学习与终身学习算法,方便在视觉和视觉语言模型上做可复现的持续学习实验。
用 VQAScore 给文生图、文生视频和文生 3D 模型打分的评测工具,基于视觉语言模型判断生成内容与文本提示是否匹配。
把角色的脸、身材、服装和声音打包进一个 .char 文件,让同一个角色在不同扩散模型和视频生成工具里保持一致,省去反复调参对齐的麻烦。
收录 150 条 GPT Image 2.5 社区提示词,覆盖 9 类使用场景,每条都标注原作者和出处,可直接拿来生成图片。
面向视频场景的空间超级感知多模态大模型,专注提升视觉语言模型对视频中空间关系的理解与推理能力。
把 reMarkable2 电子纸平板变成视觉大模型的输入画板,手写或画图后直接发给 ChatGPT、Claude、Gemini 识别与对话。
一堆可直接在 Google Colab 上跑的生成式 AI 笔记本,覆盖 ComfyUI 工作流、Flux Kontext、混元、LTX 视频等图生图与图生视频玩法,省去自己配环境。
在 MiniMax H3 生成的视频里逐帧追踪并裁剪小尺寸人脸,用 H3 精修后再拼回原画面,解决远景人脸模糊、细节丢失的问题。

给 Payload CMS 装的 AI 插件,在后台直接做文本生成、AI 写作、翻译和图像生成,省去接第三方服务的麻烦。
提供各行业专用的 Pydantic schema 集合,让视觉语言模型按统一结构输出 JSON,省去手写解析和字段对齐的麻烦。