多模态生成

共 372 个仓库 · 一年内有推送

打开分类页
Qwen3-VL
QwenLM·Jupyter Notebook

阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。

多模态大模型+4视觉语言模型进阶
20191+161.9k2026-01-30 04:47 UTC
pyvideotrans
jianchang512·Python

把视频从一种语言翻译成另一种语言,自动生成配音和字幕并嵌入视频,适合做视频本地化和跨语言内容分发。

视频翻译+4语音推理进阶
19700+322.4kv4.182026-11-11 04:26 UTC
Wan2.1
Wan-Video·Python

开源的大规模视频生成模型,支持高质量文生视频,为 AIGC 视频创作提供可用的生成能力。

视频生成+4视频生成进阶
17415+134.0k2026-03-05 09:38 UTC
awesome-gpt-image-2-API-Prompts
Evolink-AI·Python

收录 GPT-Image-2 图像生成 API 的调用方式与提示词范例,帮开发者快速接入并调出理想出图效果。

图像生成+3图像生成入门
17397+111.7k2026-07-18 06:23 UTC
stable-diffusion-webui-colab
camenduru·Jupyter Notebook

在 Google Colab 上一键跑起 Stable Diffusion WebUI 的笔记本合集,省去本地显卡和环境配置,直接在线出图、图生图、训练 LoRA 和 DreamBooth。

Stable Diffusion+4图像生成入门
158892.6k0.0.172025-12-16 05:49 UTC
F5-TTS
SWivid·Python

基于流匹配的语音合成模型官方实现,只需一段参考音频就能克隆音色并生成流畅自然的语音,适合做零样本 TTS 和语音克隆。

语音合成+4语音进阶
15560+292.3k1.1.222026-11-03 15:05 UTC
OpenCreator
krillinai·TypeScript

面向创作者的开源 AI 工作台,集视频下载、翻译配音、转录、图像与视频生成、剪辑于一体,支持 120 多种语言,适合做 YouTube、TikTok 等社媒内容本地化。

视频翻译+4图像生成进阶
14294+771.6kv3.3.12026-11-10 06:14 UTC
open_clip
mlfoundations·Python

开源实现的 CLIP 多模态模型,提供图像-文本对比学习训练与预训练权重,支持零样本图像分类和跨模态检索。
多模态嵌入+4多模态嵌入进阶
14256+81.3kv4.2.22026-11-10 18:05 UTC
YuE
multimodal-art-projection·Python

开源音乐生成基础模型,用符号规划、零样本翻唱和智能体编辑从歌词生成完整歌曲,适合研究音乐生成与风格迁移。

音乐生成+4语音硬核
13379+2131.5kyue2-music-v1.2.02026-11-01 05:46 UTC
HunyuanVideo
Tencent-Hunyuan·Python

腾讯混元开源的大规模视频生成框架,基于扩散 Transformer 把文本提示直接生成连贯视频,适合做文生视频研究和应用落地。

视频生成+4视频生成硬核
12754+161.4k2026-10-08 08:57 UTC
edge-tts
rany2·Python

用 Python 直接调用微软 Edge 的在线语音合成服务,无需安装 Edge 浏览器或密钥,即可把文本转成自然语音。
语音合成+3语音入门
12513+321.2k7.3.12026-10-14 09:30 UTC
moonshine
moonshine-ai·C++

超低延迟的语音转文字、意图识别和语音合成工具,用来搭建语音助手和语音交互界面,响应快、适合实时对话场景。

语音识别+4语音推理进阶
11469+41658v0.1.62026-11-10 23:51 UTC
LTX-Video
Lightricks·Python

LTX-Video 是 Lightricks 开源的视频生成模型,支持文生视频和图生视频,基于 DiT 扩散架构,可快速生成高质量短视频。

视频生成+4视频生成进阶
11356+161.2k2026-11-02 19:25 UTC
PixelRAG
StarTrail-org·Python

把网页直接当像素图像来检索的 RAG 引擎,跳过 HTML 解析,靠视觉语言模型做原生搜索,适合构建多模态 Agent 的长期记忆。

像素级检索+4视觉语言模型进阶
10901+36981v0.4.02026-11-11 00:05 UTC
pyannote-audio
pyannote·Jupyter Notebook

基于 PyTorch 的说话人日志神经网络组件库,提供语音活动检测、说话人变化检测、重叠语音检测和说话人嵌入等预训练模块,方便搭建说话人分离与识别流程。
说话人日志+4语音进阶
10779+171.1k4.0.72026-11-09 05:43 UTC
runanywhere-sdks
RunanywhereAI·C++

一套能在手机和边缘设备上本地跑大模型、扩散模型和多模态推理的生产级 SDK,覆盖 Android、iOS、Flutter,省去自己搭推理链路的麻烦。

端侧推理+4图像生成进阶
10338+1415cpp-desktop-v0.20.432026-11-10 22:05 UTC
Sana
NVlabs·Python

SANA 是英伟达开源的高效扩散生成模型与配套训练推理引擎,支持文生图、文生视频和世界模型,用线性注意力和 NVFP4 量化在低显存下实现快速生成。

扩散模型+4视频生成进阶
9807+22803streamrender-h3-examples-v12026-11-10 07:19 UTC
anomaly-detection-resources
yzhao062·Python

一份持续更新的异常检测资源大全,汇总书籍、论文、视频和工具箱,覆盖传统方法与最新的 LLM、VLM 工作,适合快速入门和跟进前沿。
异常检测+4时序预测入门
9449+81.8k2026-03-02 04:42 UTC
MobileAgent
X-PLUG·Python

基于多模态大模型的 GUI 智能体家族,能看懂手机和电脑界面并自动点击操作,帮你完成跨 App 的自动化任务。

GUI 智能体+4视觉语言模型硬核
9374+29422026-11-03 05:27 UTC
so-vits-svc-fork
voicepaw·Python

基于 so-vits-svc 改进的歌声与语音转换工具,支持实时变声、更友好的操作界面和更多功能,适合做 AI 翻唱和音色克隆。
语音转换+4语音进阶
93281.2kv4.3.02026-11-10 18:57 UTC
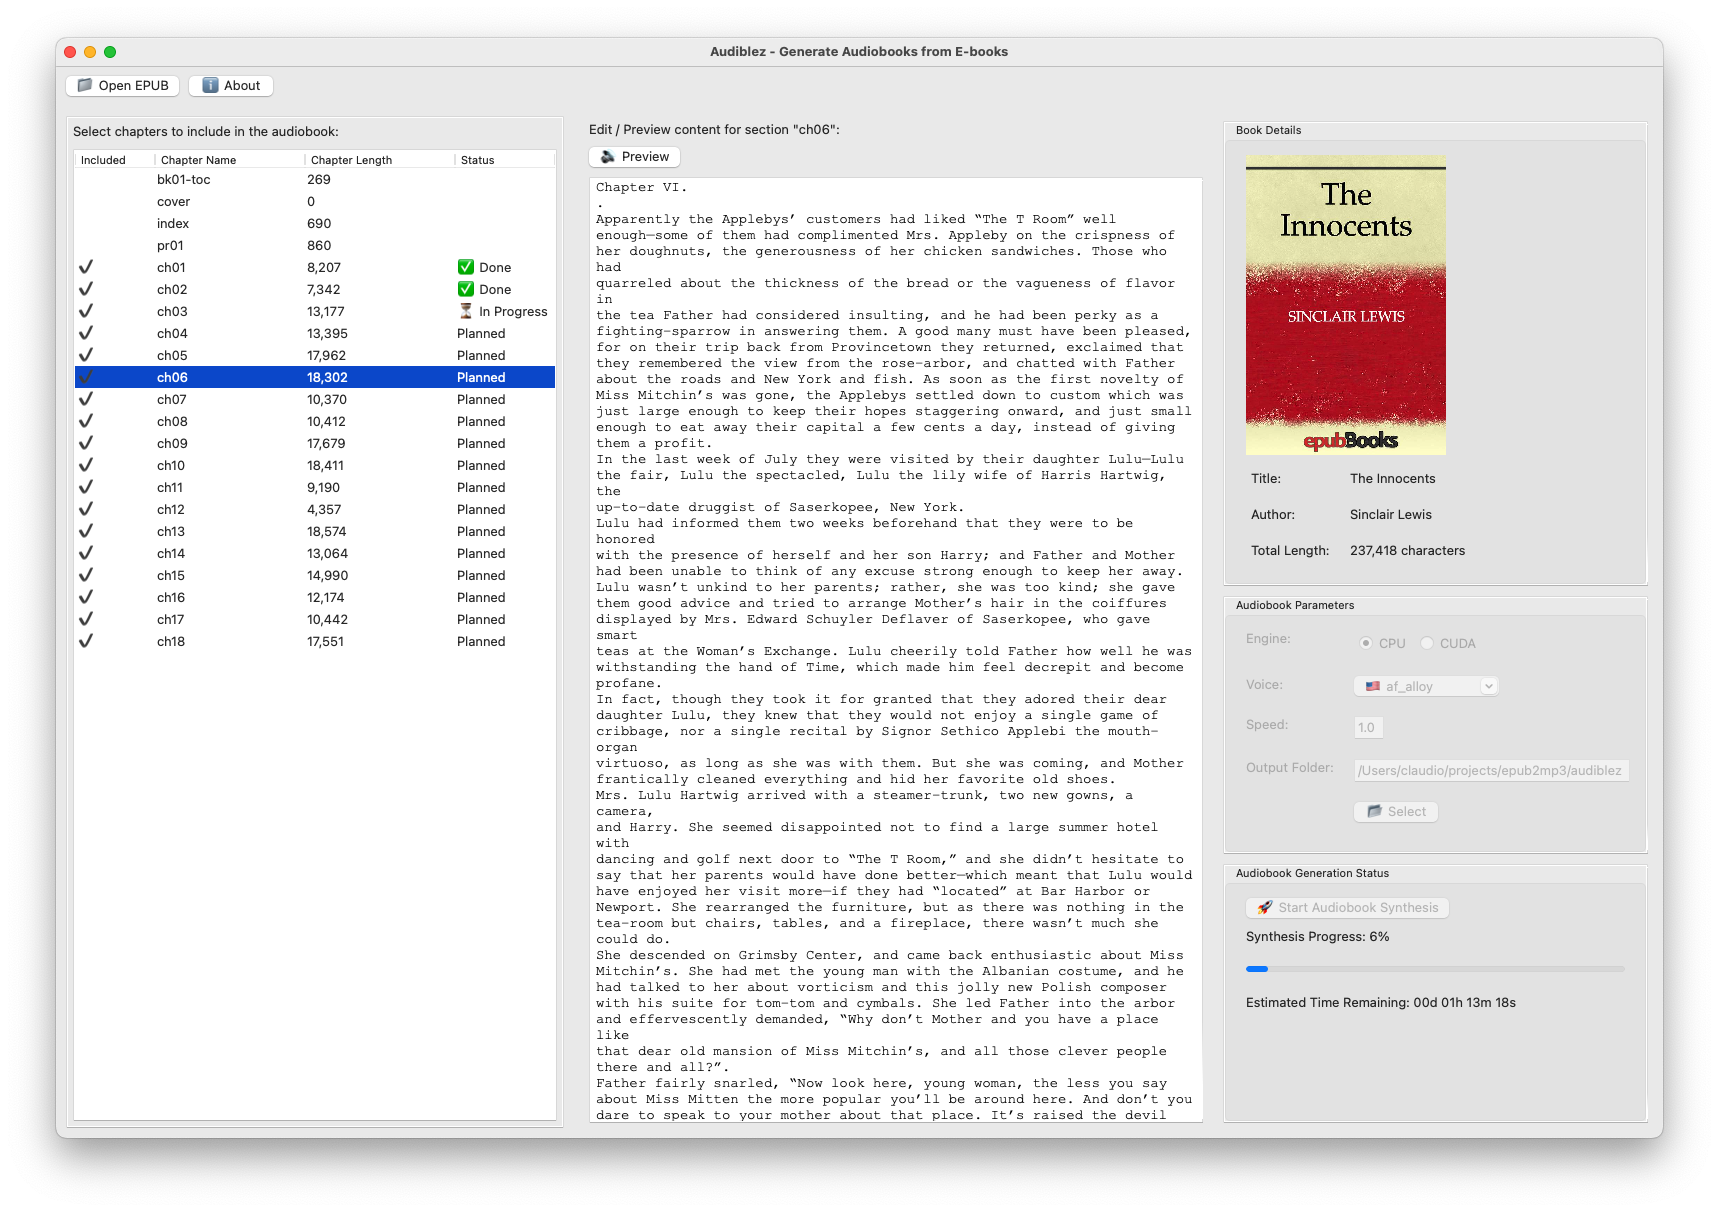
audiblez
santinic·Python

把 EPUB 电子书转成有声书的 Python 工具,基于 Kokoro 语音合成模型,适合想批量制作个人音频书的人。

有声书生成+4语音进阶
8870+157732026-02-27 19:06 UTC
minimind-v
jingyaogong·Python

用两小时从零训练一个 65M 参数的多模态视觉语言模型,代码和流程完整,适合低成本复现 VLM 训练与对话实验。

视觉语言模型+4视觉语言模型进阶
8827+3990v22026-10-27 07:03 UTC
Bert-VITS2
fishaudio·Python

基于 VITS2 骨干网络和多语言 BERT 的语音合成模型,能生成自然度较高的多语种语音,适合做 TTS 训练与推理。

语音合成+4语音硬核
88011.3kJP-Exta2026-11-09 19:24 UTC
EmotiVoice
netease-youdao·Python

多音色、支持提示词控制情感与风格的语音合成引擎,输入文本即可生成带情绪表现力的自然语音,适合做有声内容和虚拟人配音。

语音合成+4语音硬核
8542+2762v0.32026-09-03 08:30 UTC