多模态生成
共 290 个仓库 · Python
面向流式视频场景的空间智能框架,用测试时训练让多模态大模型持续理解三维空间关系,解决长视频中空间推理能力退化的问题。
面向视频/音频片段检索与高光检测的可复现 Python 库,统一多模态流程,方便研究者快速复现和对比实验结果。
把视觉语言模型和强化学习整合到同一个框架里,用于自动驾驶策略训练,并在 CARLA 仿真中验证安全性。
RoboRefer 是面向机器人场景的空间指代推理视觉语言模型官方实现,让机器人能理解「把左边那个杯子递给我」这类带空间关系的指令。
基于多模态大模型的视频剪辑智能体,能把文字需求直接变成成片,自动完成剪辑、合成与全流程视频生产。
用 TensorRT 加速 ComfyUI 的图片放大节点,把 ESRGAN、Real-ESRGAN 等放大模型跑出 2~4 倍速度,适合出图后处理提速。
用工具调用方式逐笔绘制像素画的 AI 智能体,靠形状、噪点和逐像素控制作画,而非扩散模型生成,适合做游戏素材。

多主体 LoRA 融合方法,在测试时通过自适应 token 级路由把多个 LoRA 组合起来,让扩散模型一次生成多个指定主体。
汇总自动驾驶场景生成与分析方向的基础模型论文,涵盖扩散模型、大语言模型和多模态模型,持续更新最新研究进展。
基于基础模型的医学图像分析代码库,涵盖MAE预训练、Mamba状态空间模型、视觉语言模型与医学报告生成,为医学影像研究提供可复用的模型实现。

用强化学习(GRPO)训练视觉语言模型生成更细粒度、更密集的图像描述,解决普通 caption 模型描述过于笼统的问题。
一套面向 AI 编程助手的生成式媒体技能包,让 Claude、Cursor 等助手能直接产出高质量图片、视频、音频和语音内容。
面向视觉语言模型的对齐与安全研究代码库,提供对抗攻击方法,用于评估多模态基础模型的鲁棒性和可信度。
用强化学习对扩散模型做后训练,支持文生图、文生视频和图生视频,主打高效、稳定、可扩展。
把 fal.ai 上 1400 多个图像、视频、音频和 LLM 模型接进 ComfyUI 的自定义节点,自带缓存和费用控制,方便在本地工作流里直接调用云端生成能力。
把视觉预训练扩展到 4K 分辨率,让视觉语言模型在高清图像上也能高效训练和推理。
Iris-3B 是一个 3B 参数的扩散 Transformer,直接在像素空间生成图像、无需 VAE;同一预训练先验微调后还能做单目深度估计和 4 倍图像修复。
把扩散模型的去噪步骤拆到多张卡上异步并行执行,无需重新训练就能显著加速 Stable Diffusion 等文生图、文生视频模型的推理。
为 ComfyUI 提供 MiniMax H3 文生图、参考图编辑和 Qwen 细节精修的节点与实测工作流,开箱即用。
在官方 DocVQA 基准上让智能体自动迭代 Qwen3-VL 的训练代码,省去手工调参和实验设计,支持 NVIDIA 多卡与 Apple Silicon。
用 CSS Flexbox 布局语法在 Python 里生成图片,支持渐变、阴影和文字排版,适合批量出图或程序化设计。
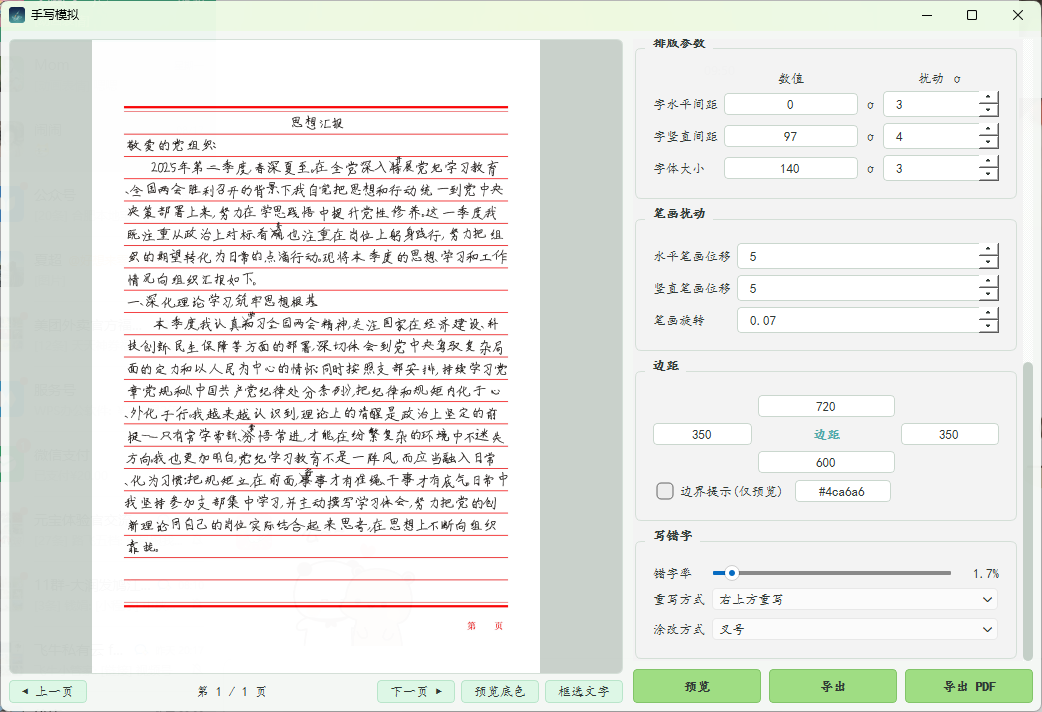
把普通文本渲染成逼真的手写体图片,支持手写字体、信纸背景和字距行距笔画随机扰动,提供 GUI 和 CLI 两种用法。
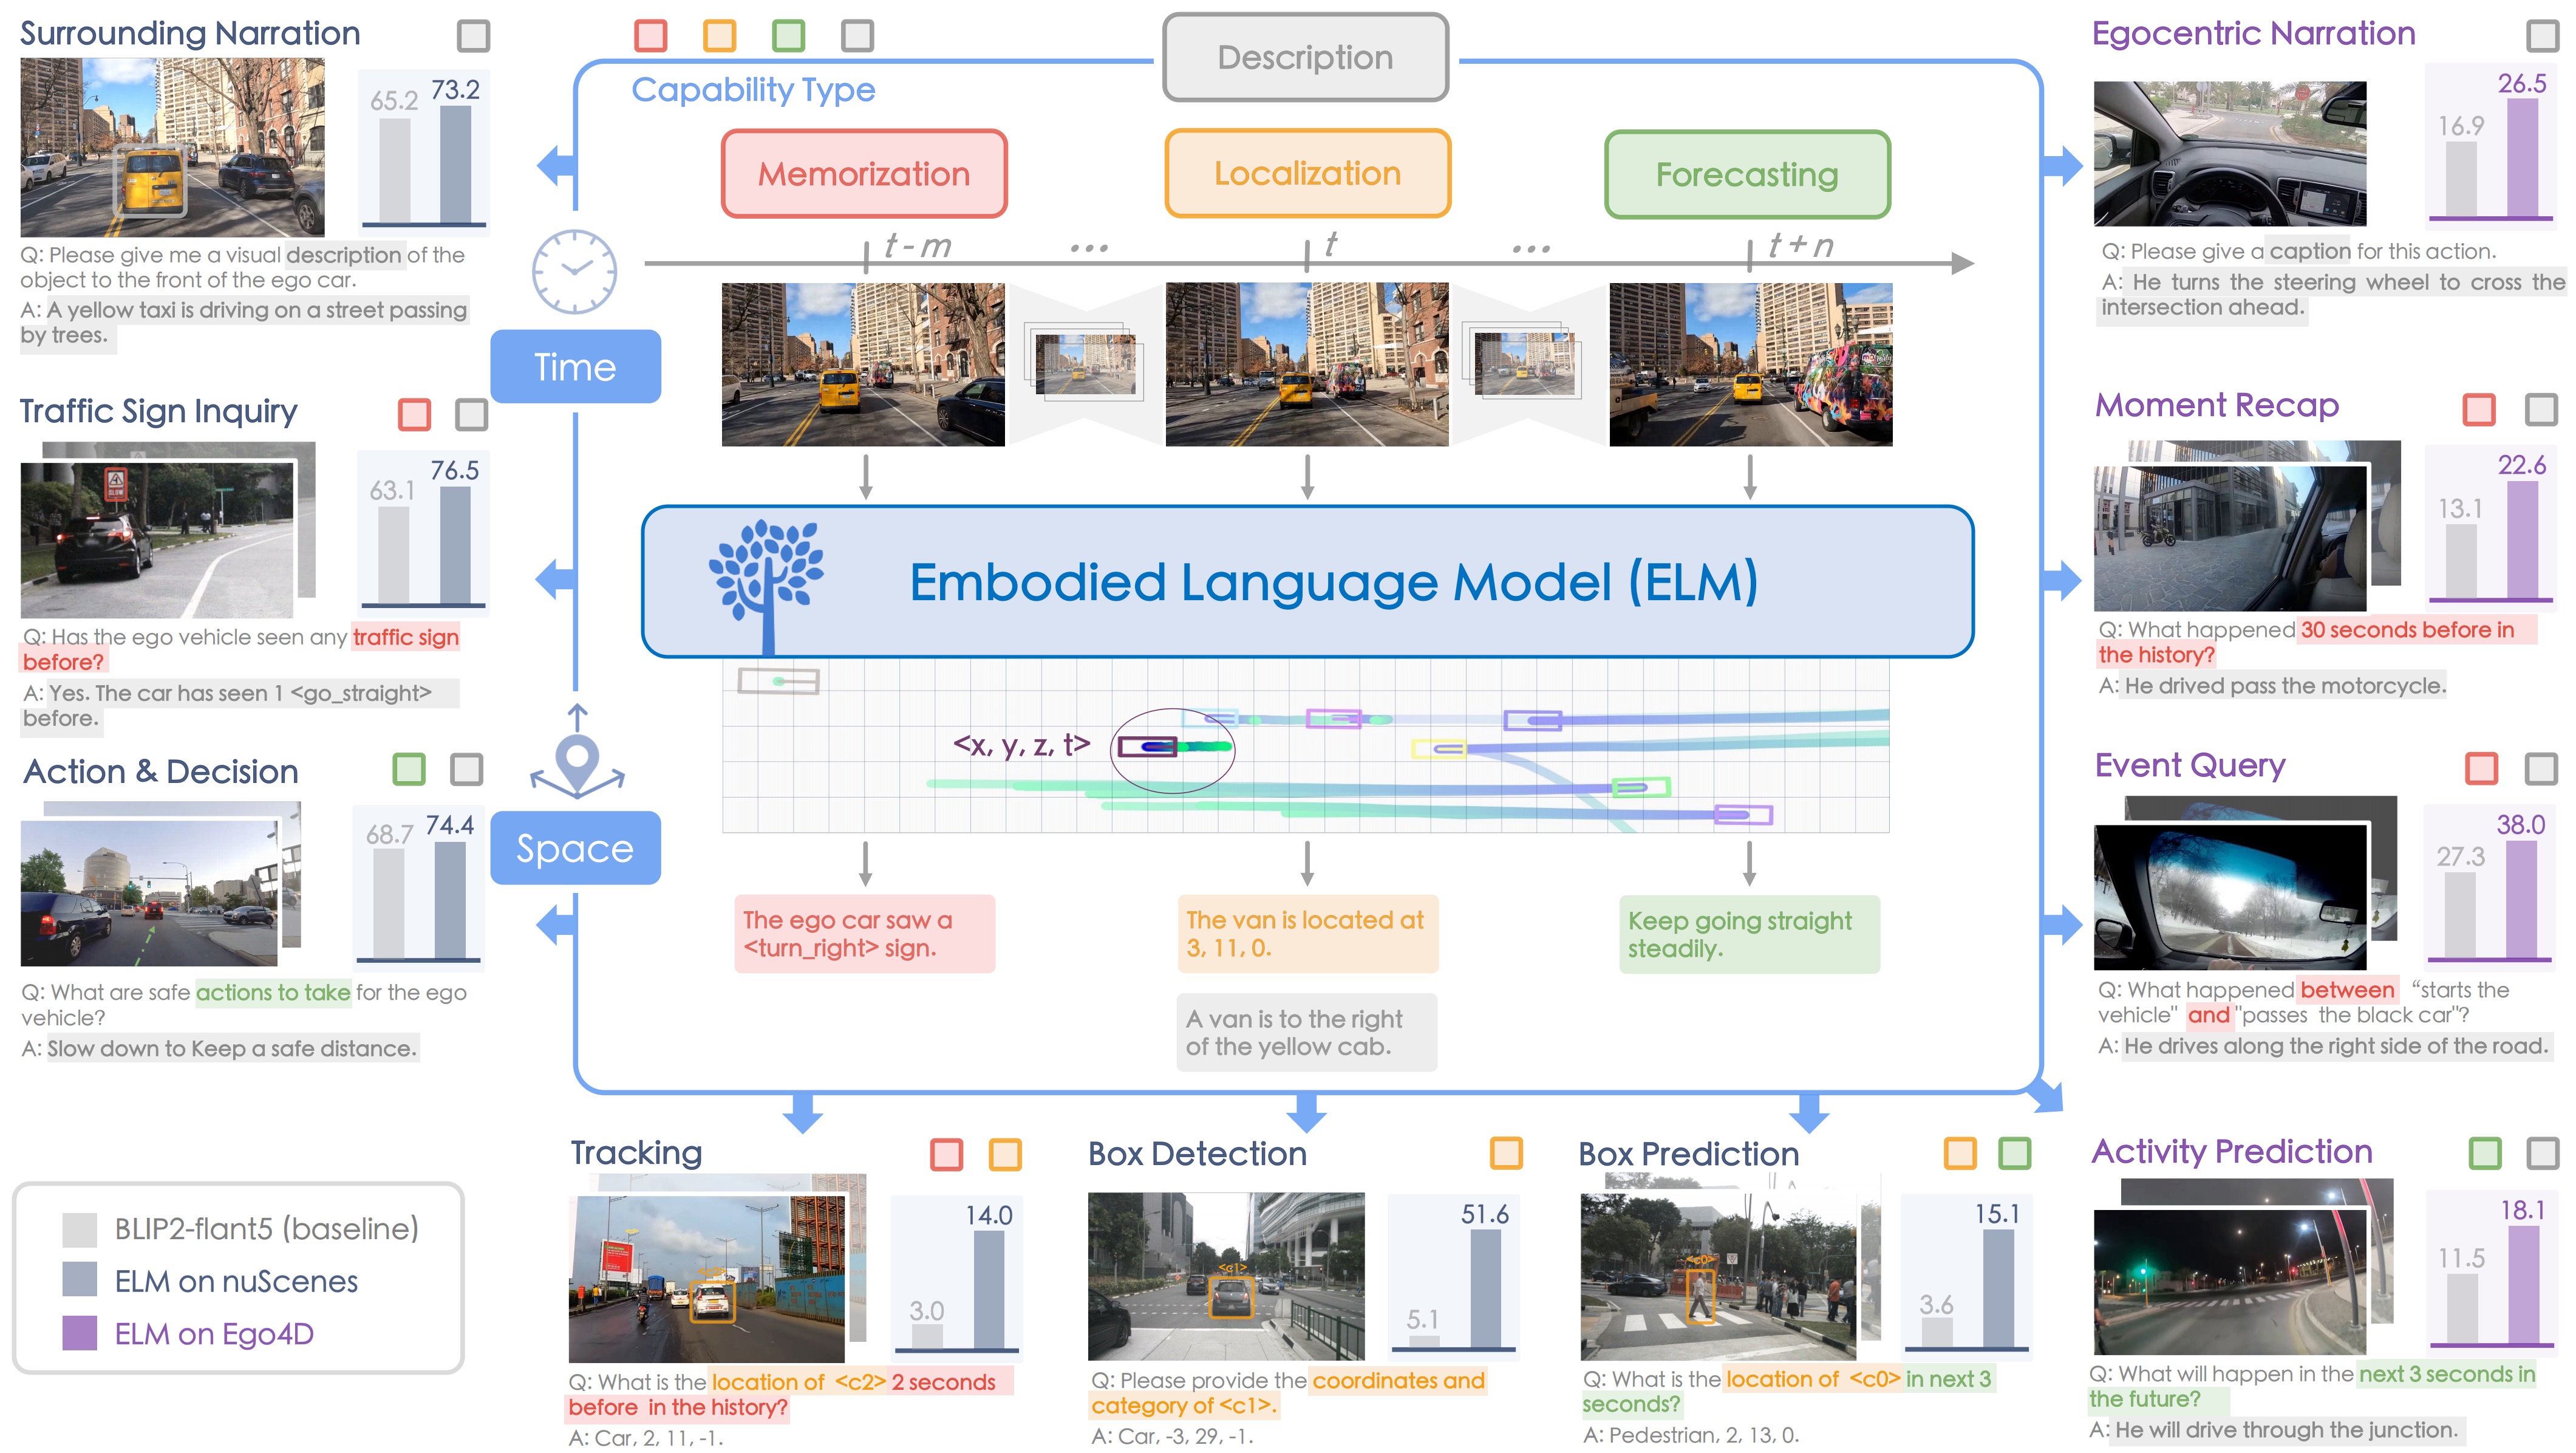
面向自动驾驶场景的视觉语言基础模型,通过多模态理解把驾驶画面转成可推理的语义描述,为端到端驾驶提供感知与决策支持。
把 Qwen-Image-2.1 的文生图和多图编辑提示词按阿里官方规范自动改写优化,让 AI Agent 出图更准。