检索与 RAG
共 183 个仓库 · Python

一套可直接在 Colab、Kaggle、Binder 上跑的免费 AI 实战课程,覆盖 RAG、AI Agent、文档抽取、模型验证和 EU AI Act 合规,每节课都带自动评分。
把各类文档抽取、解析成结构化分块,直接喂给 AI Agent 和 RAG 流水线,省去自己写清洗和切分逻辑。
开源文档解析模型,用强化自迭代(RSI)循环做后训练,在准确率和速度上达到 SOTA,适合给 LLM 和 Agent 做 OCR 与文档理解。

面向超长视频的检索增强生成框架,让大模型能直接和你上传的视频对话,解决长视频内容理解与精准问答的问题。
面向地理空间数据的 AI 工具包,基于 PyTorch 提供遥感影像分割、地球观测分析等深度学习模型的训练与推理能力。

面向文档 AI 的 Python 工具箱,把 OCR、版面分析和表格识别串成流水线,方便从扫描件和 PDF 里抽取结构化内容。
开箱即用的漫画 AI 翻译桌面工具,自动完成日韩英漫画的 OCR 检测、原文擦除、翻译、图像修复和译文排版,并带可视化编辑器调整文本样式。
基于 CNN/ResNet/DenseNet 加 GRU/LSTM 与 CTC/交叉熵的验证码识别模型训练工具,专注训练环节,帮你快速产出可用的验证码 OCR 模型。
把 PDF、Word、PPTX 等文档和图片通过 OCR 加 Ollama 模型解析成结构化 JSON 或 Markdown,还能自动匿名化、清除 PII 敏感信息。
用大模型从文档里自动抽取实体和关系,生成可交互的知识图谱,省去手工梳理和建模的麻烦。
开箱即用的 AI Agent 微服务,用 Docker 一键部署,内置对话、函数调用和 MCP 客户端,帮你快速搭出可扩展的智能助手后端。
一套用来测试和实验提示词的开源工具,支持 OpenAI、LLaMA 等大模型以及 Chroma、Weaviate 等向量数据库,方便对比不同提示词的效果。
不用搬数据就能做企业知识检索和 RAG,跨 100+ 应用联合搜索并直接生成答案,几分钟即可部署。
用大模型对 Tesseract 的 OCR 结果做纠错、智能分块和 Markdown 排版,把扫描 PDF 转成干净可读的文本,支持本地或 API 模型。
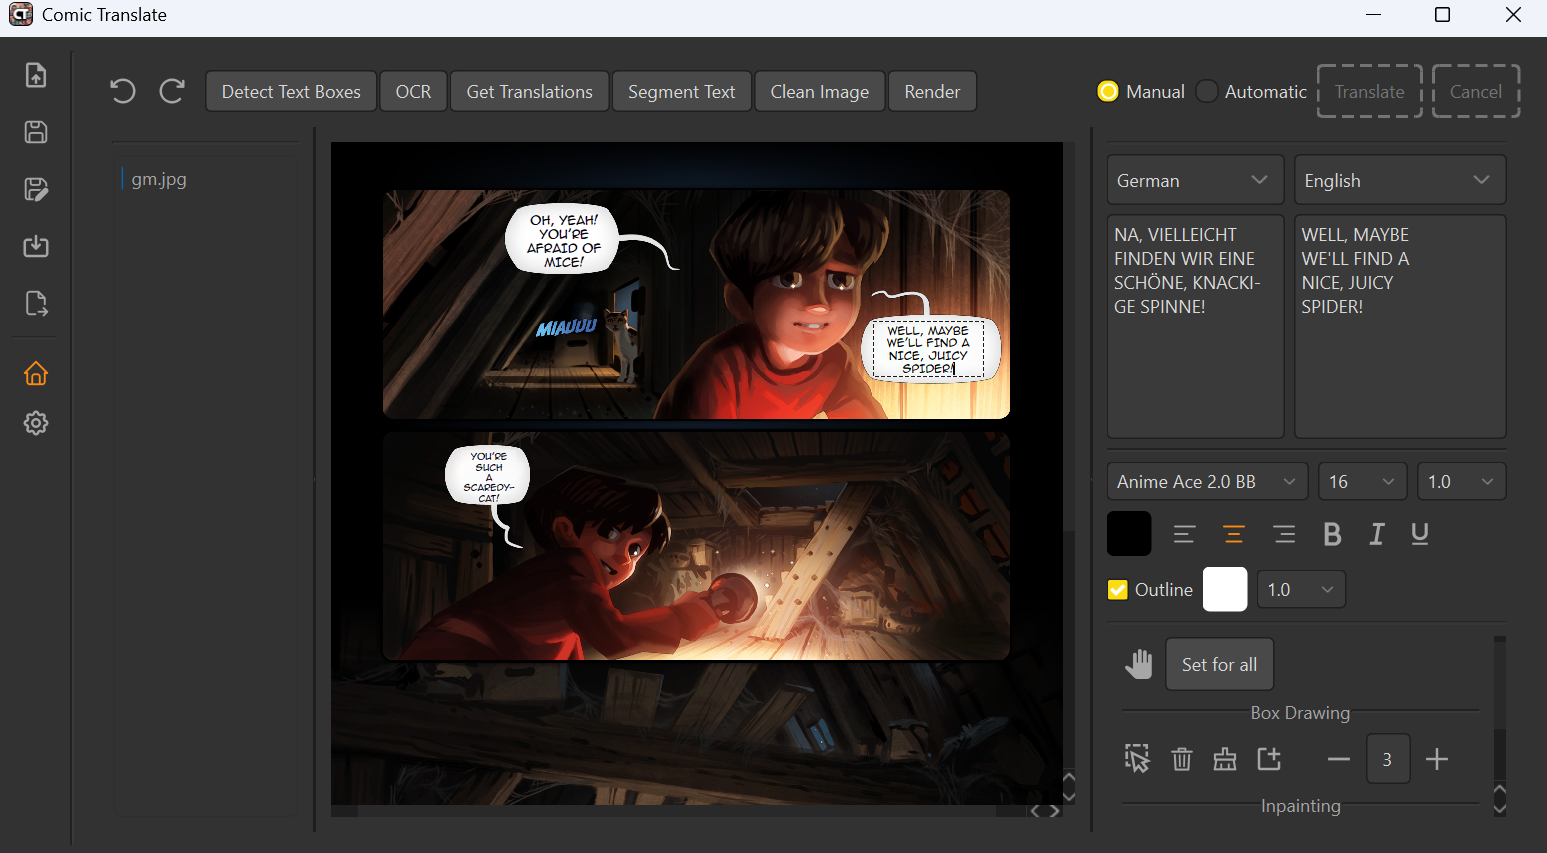
自动翻译漫画、日漫、韩漫等图片与 PDF/EPUB/CBR/CBZ 文件,集成 OCR、图像修复和机器翻译,支持多语言多格式。
开源且注重隐私的屏幕历史记录工具,可替代 Windows Recall,通过 OCR 和语义搜索随时找回你过去看过的内容。
基于 CTPN 做中文场景文字检测、CRNN+CTC 做识别的端到端 OCR 老项目,适合拿来跑通中文自然场景文字识别的完整流程。
Open Source Document Management System for Digital Archives (Scanned Documents)

面向 Agent 的 AI 治理平台,用上下文图谱管理知识、上下文和 Agent 运行时,让 Agent 行为可追溯、可管控。
一种新的 RAG 检索架构,用知识图谱和向量检索构建知识库,让人和 Agent 都能高效查询结构化知识。
训练和推理 ColVision 系列视觉语言检索模型(ColPali、ColQwen2、ColSmol)的代码库,用多模态嵌入直接检索文档图像,省去 OCR 和文本解析步骤。
面向日文漫画的 OCR 工具,能识别漫画中的对话气泡和拟声词等文字,基于 Transformers 实现,适合做漫画翻译或文本提取。
截图后直接识别图中文字并复制到剪贴板,省去手动输入,支持多平台,适合从图片、PDF 或界面中快速提取文本。
在保留原始版面、公式和结构的前提下翻译 PDF,适合科研论文和技术文档,避免译文打乱排版。