检索与 RAG
共 183 个仓库 · Python

Qdrant 向量搜索引擎的官方 Python 客户端,方便在 Python 项目里接入向量检索,做相似度搜索和 RAG 应用。

用扩散模型做医学图像器官分割与重建,把去噪扩散思路引入分割任务,适合医学影像研究和训练微调。
给代码仓库装上大脑的代码智能问答工具,能接入 Claude Code、Cursor、Codex 等 IDE 和命令行,用知识图谱检索帮你快速理解和查询整个代码库。

基于 DGL 的高性能知识图谱嵌入学习库,支持在超大规模图谱上训练 TransE、RotatE 等嵌入模型,兼顾易用性与可扩展性。
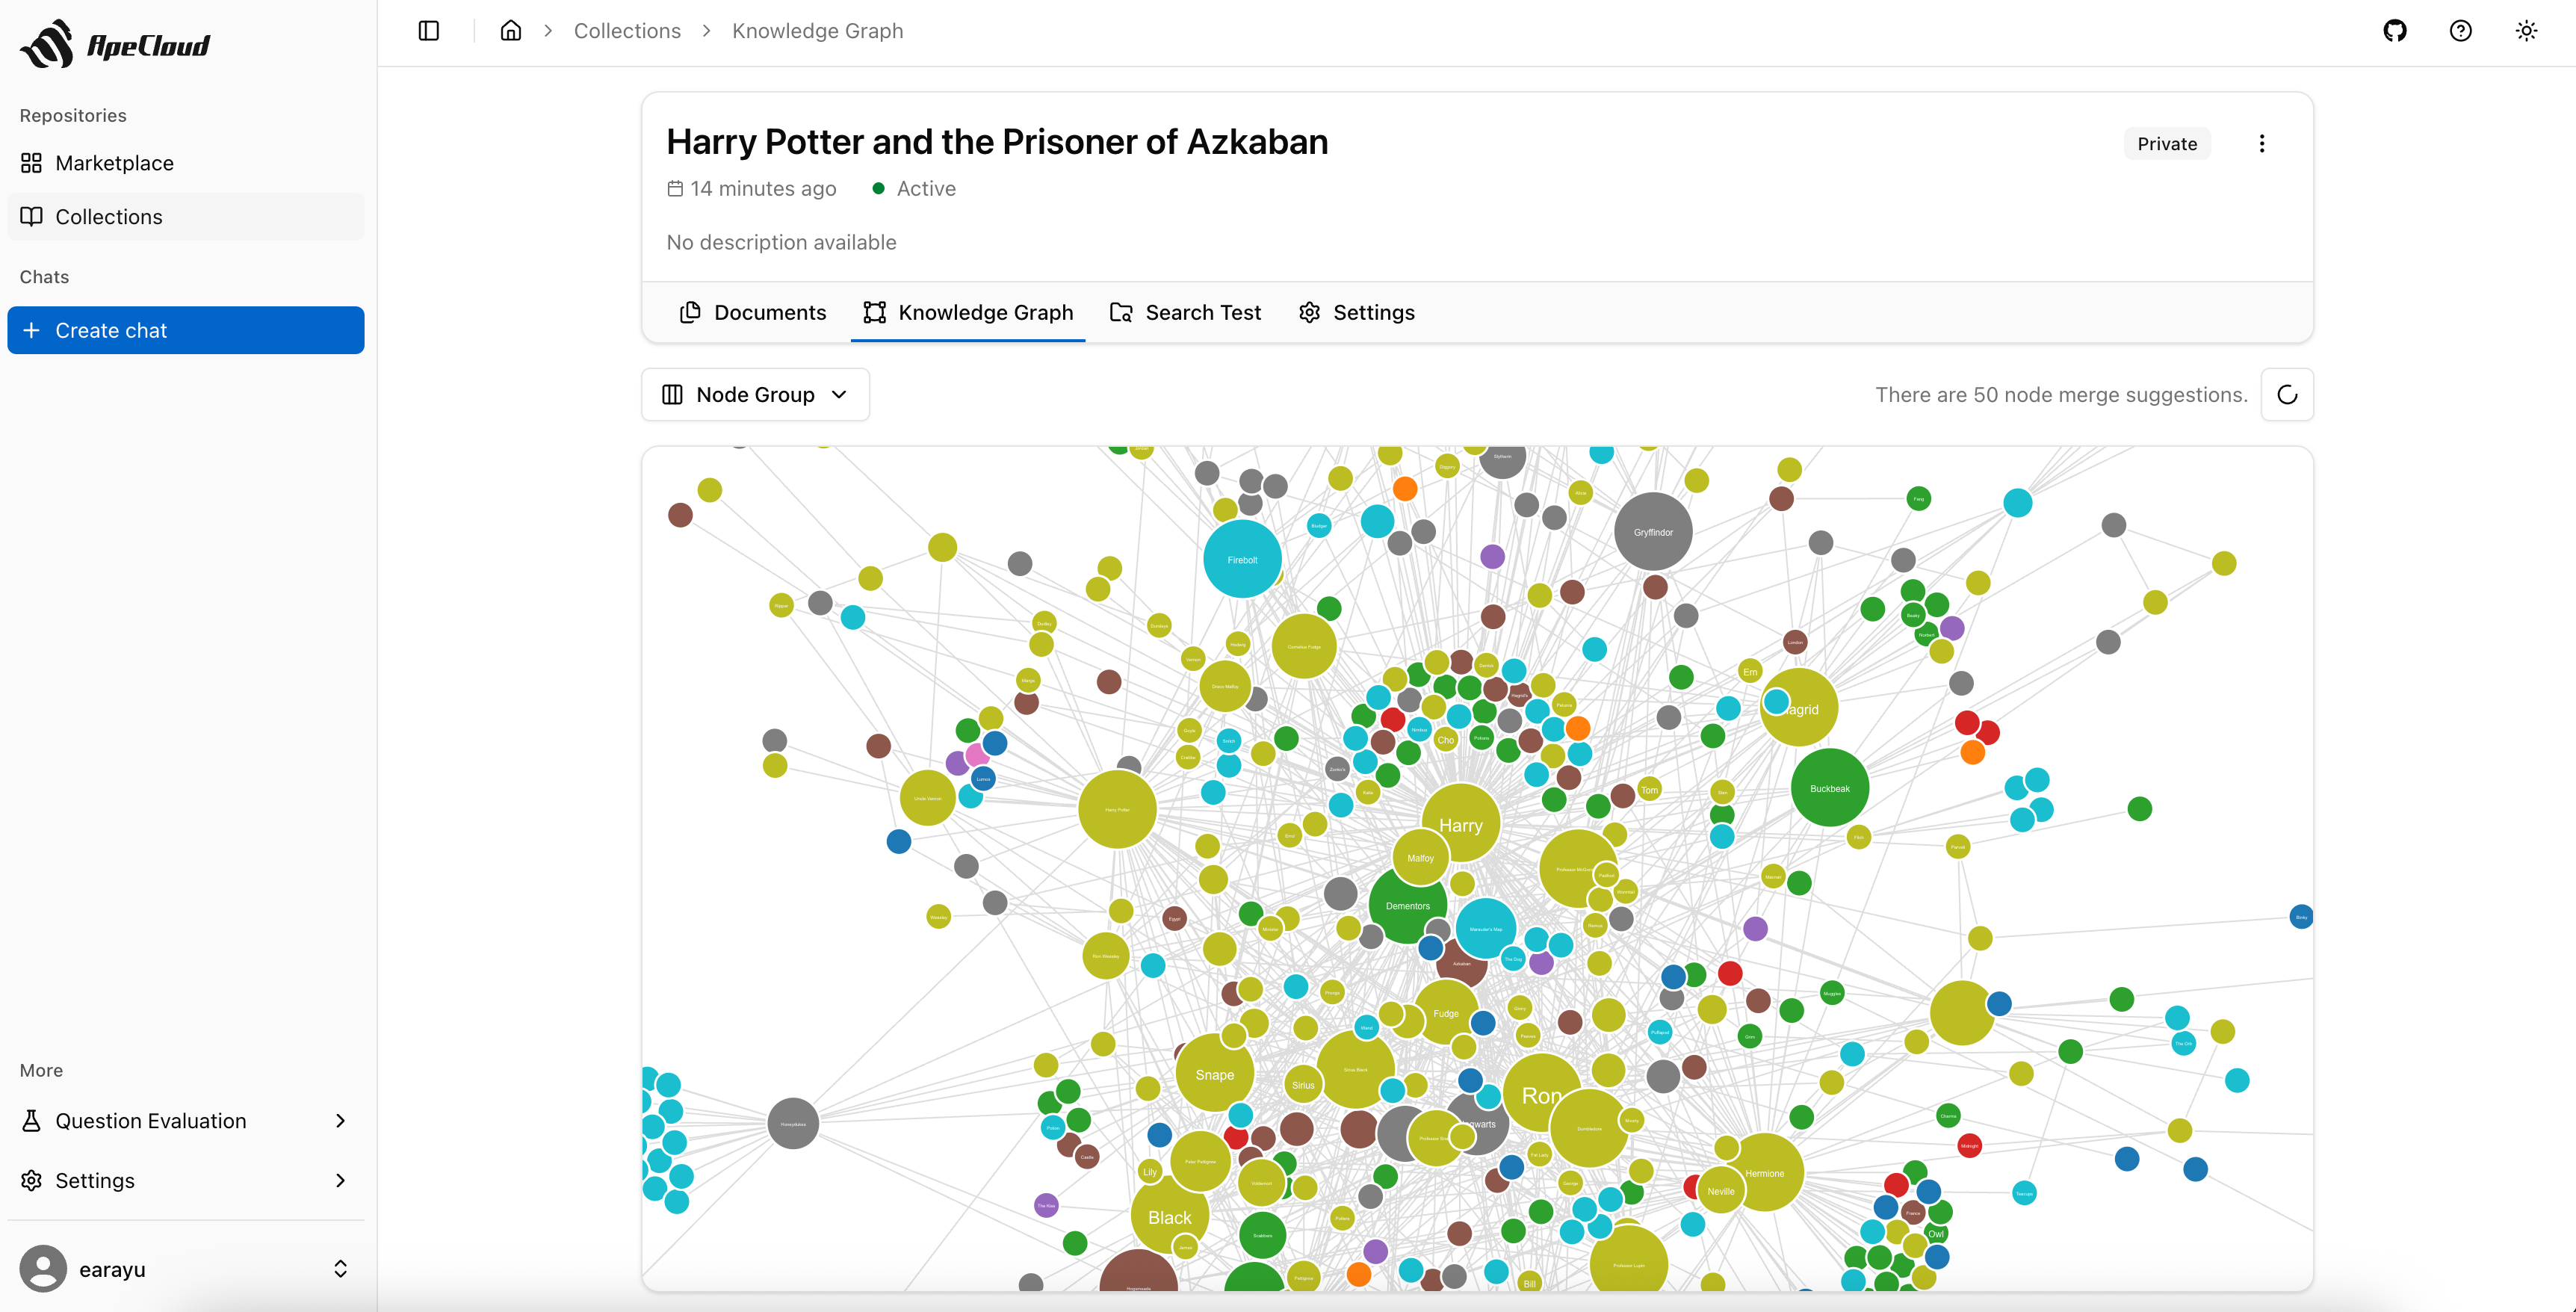
面向生产环境的 GraphRAG 系统,支持多模态索引、AI 智能体和 MCP 协议,可在 K8s 上弹性部署,帮团队把知识图谱与检索增强真正落地。
把 Gemini、Grok、豆包、元宝等平台的原生 AI 搜索能力聚合成统一接口,一次查询即可拿到科技趋势、行业舆情和热点信息,方便接进自己的 Agent 和工作流。
TrustRAG 是一个强调可靠输入与可信输出的 RAG 框架,帮你在检索增强生成流程里控制数据质量、减少幻觉,适合搭建可溯源的知识问答系统。
基于知识图谱为 LLM 微调合成高质量问答数据,把结构化知识转成训练语料,缓解监督微调数据稀缺。
轻量级 Python RAG 工具包,用 DuckDB 或 PostgreSQL 就能搭起检索增强生成,省去部署向量数据库的麻烦。

面向企业审计场景的可审计 AI 智能体平台,让智能体基于证据工作、工具调用受管控,并内置评测、人工复核与整改交付流程。
统一 RAG 检索环节的微调工具,覆盖 Embedding、ColBERT 和 ReRanker 三类模型,省去分别搭训练流程的麻烦。
用 Python 和 SQLite 搭建的个人知识图谱工具,把零散、异构的资料整理成带语义关联的主题网络,适合信息密集的研究和调查项目。
给 Claude Code 加持久记忆:用 Obsidian 和 Graphify 建代码库知识图谱,把每轮对话 token 消耗最多降 71.5 倍。
基于 FalkorDB 图数据库构建 GraphRAG 应用的 Python SDK,把知识图谱和向量检索结合起来,让大模型问答更准确、可规模化。
轻量极速的重排序库,为搜索和 RAG 检索管线提供基于 LLM 与 cross-encoder 的 listwise/pairwise 精排,几乎不增加延迟。
基于视觉语言模型的无解析 RAG 方案,直接把文档当图片做检索和生成,省去 OCR 和版面解析环节,减少信息损失。
用大模型从文本中自动抽取实体与关系,构建带时间维度的知识图谱,适合做 RAG 检索和结构化知识沉淀。
用多查询生成和倒数排名融合(RRF)提升 RAG 检索质量,附带 NFCorpus/BEIR 评测脚本,方便对比不同检索策略的效果。
用 Python 写的透明 RAG 参考实现,把 FAISS 向量检索和 BM25 关键词检索做混合召回再重排,配 Gradio 界面和 FastAPI 接口,方便本地搭文档问答。
把 PDF 等非结构化文档转成经过校验、可查询的知识图谱,方便做 RAG 和文档关系分析。
面向医学影像的智能标注与主动学习工具,在 3D Slicer 等客户端里边标注边训练模型,减少人工勾画工作量。

本地离线运行的便携式 OCR 软件,用 DeepSeek-OCR-2 模型直接在你自己机器上识别图片和 PDF,适合不想把文档传到云端的场景。
DIPY 是 Python 的 3D/4D 医学影像处理库,覆盖扩散、灌注与结构成像,提供配准、去噪、机器学习和可视化等通用方法。
面向循证医学信息检索的图谱 RAG 系统,把医学知识组织成图结构再结合大模型检索,让回答有据可查、可溯源。