图像与影音工具
共 75 个仓库 · Python
基于 Python 和 OpenCV 的视频场景切换检测工具与库,能自动识别视频中的镜头切换和转场,方便做视频分段、剪辑和内容分析。
把手绘网站草图直接转成 HTML 代码的 Keras 模型,用图像描述架构实现,适合快速把线框图变成可运行页面原型。

生成带恶意载荷的 PDF 测试文件,用来验证 PDF 阅读器、转换器和 Web 应用是否会触发回连、SSRF、XSS、NTLM 凭据窃取或数据外泄。
用 Python 封装 Google Earth Engine,在 Jupyter/Colab 里做交互式地理空间分析与可视化,省去手动拼 GEE 代码的麻烦。
跨平台高性能视频处理 Python 库,封装 FFmpeg、OpenCV 等后端,支持多线程实时推流、HLS 直播、摄像头与屏幕捕获。

纯 Python 的 PDF 库,能读取、生成和修改 PDF 文件,还内置排版能力,适合在代码里直接拼装报表、发票等文档。

在 ComfyUI 里用 SeedVR2 模型做视频超分放大,把低分辨率视频一键提升到高画质,省去单独搭推理流程的麻烦。
从视频里精确截取带内嵌字幕的画面,直接生成 3:4 社交长图,省去手动找帧和排版字幕的麻烦。
Python 里做小波变换的库,支持连续和离散小波,处理信号与图像的去噪、压缩、特征提取都能用。
基于 Kokoro 模型的命令行语音合成工具,支持多语言、音色混合,可直接把 EPUB 电子书和 PDF 文档转成有声书或播客音频。

Python 抠图库,用闭式解、KNN 和学习式方法从图像中估计前景透明度,输出带 alpha 通道的精细抠图结果。
ComfyUI 的节点扩展套件,把图像处理、滤镜、遮罩、文本逻辑、数值、潜空间、文件、3D 场景和动画等操作封装成节点,方便在 ComfyUI 工作流里直接调用。
用字幕文件自动翻译视频文本,再通过 AI 语音合成生成配音音轨,并按字幕时间轴对齐口型,省去手动配音和打轴的麻烦。
Toolbox of models, callbacks, and datasets for AI/ML researchers.
在 Streamlit 应用里直接接入 WebRTC,实现摄像头视频和麦克风的实时采集与处理,不用自己搭信令服务器。
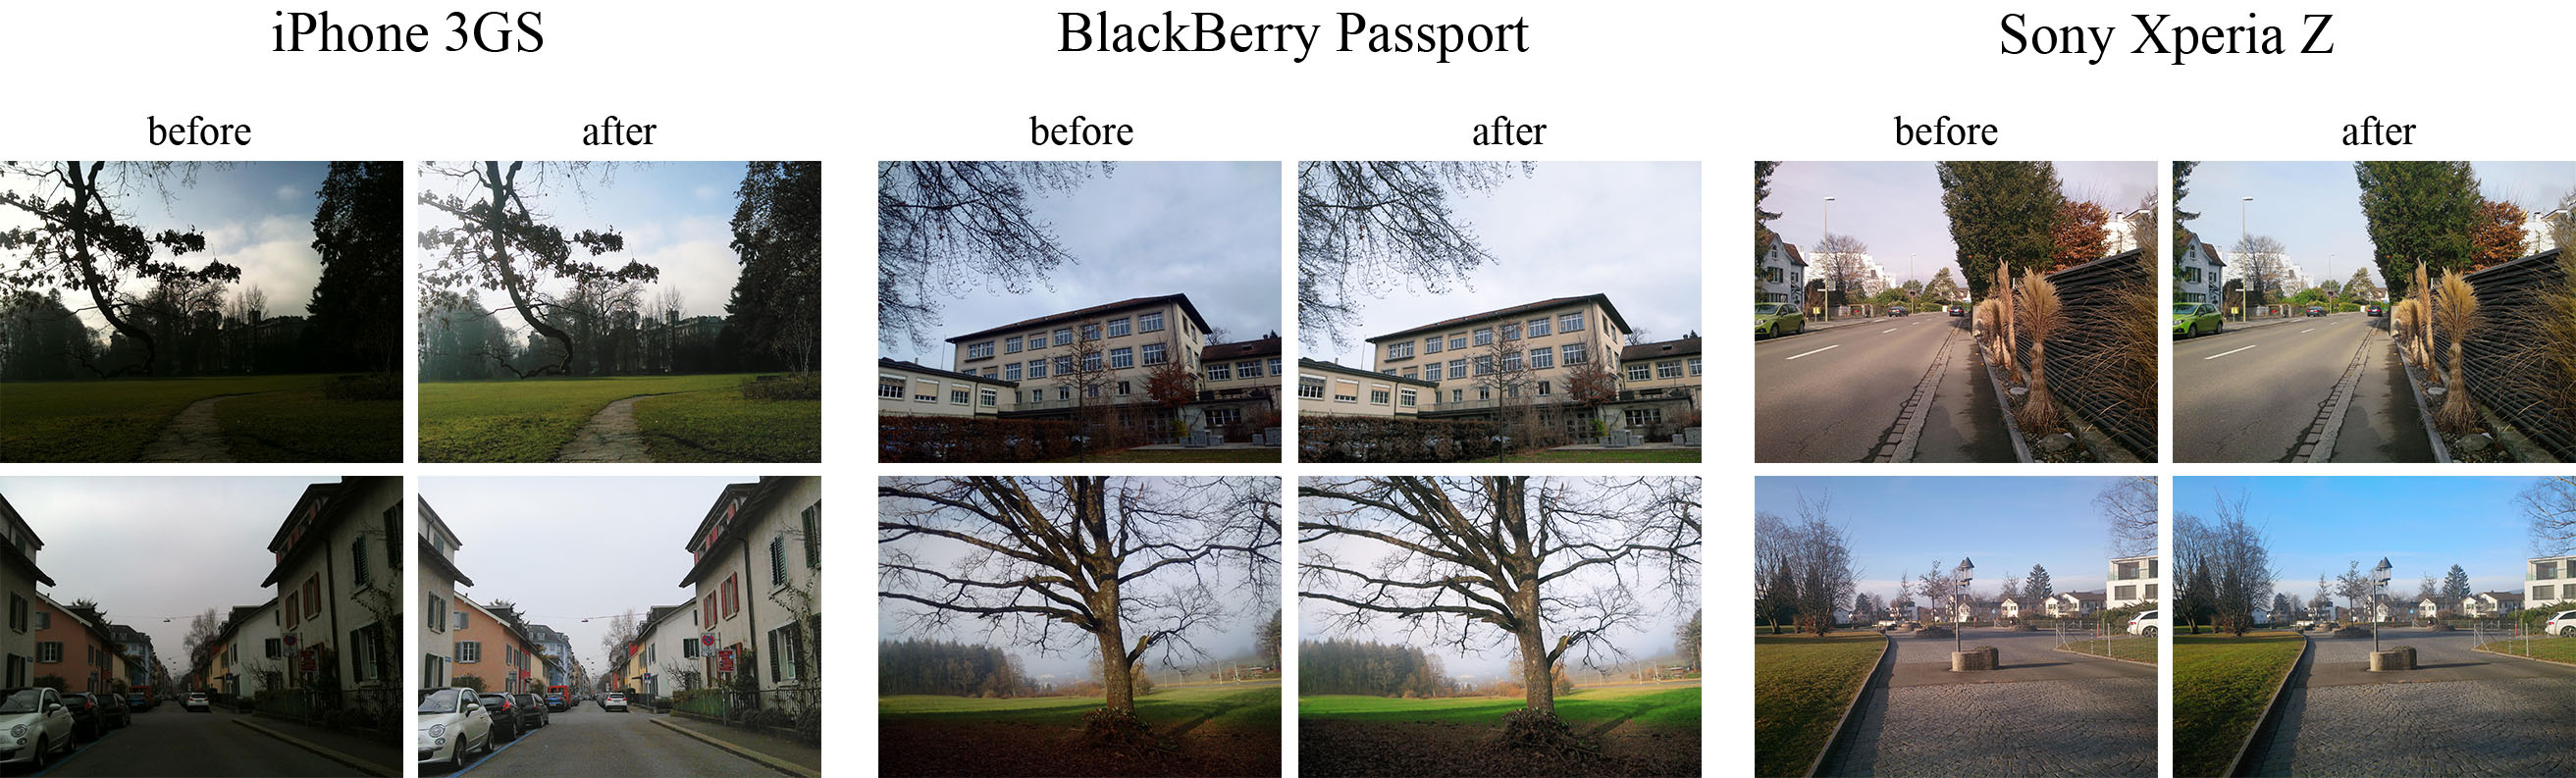
用深度卷积网络自动提升照片画质,提供预训练模型和训练代码,可把手机照片修出单反质感。
基于 OpenAI Whisper 及其变体的字幕生成工具,提供网页界面、命令行和 Python 包三种用法,可自动为音视频生成字幕。

用 Python 实现的图像信号处理器(ISP),把传感器原始数据加工成可用的图像,适合做相机成像流程的算法验证与二次开发。
多后端 Whisper 语音转文字工具,支持本地文件或 URL 输入,在 Mac ARM 上做了速度优化,安装简单且完全离线私有。
Python 抠图 SDK,支持本地 ONNX 模型和云端两种方式去除图片背景,几行代码就能集成到图像处理流程里。
基于 InSPyReNet(ACCV 2022)的抠图工具,能一键去除图片和视频背景,输出带透明通道的结果。
纯 Python 实现的超快跨平台截图库,基于 ctypes 直接调用系统接口,能一次抓取多个显示器画面,适合做屏幕采集和自动化工具。
用 Python 写的远控木马(RAT),通过 Discord 远程操控目标机器,附带图形化构建器,能一键生成带键盘记录和密码抓取功能的恶意程序。
用扫描仪或手机拍照快速、准确地批改 OMR 答题卡,自动识别选择题填涂并评分,适合考试阅卷场景。