训练与微调
共 329 个仓库 · 近 4 个月有推送
面向 NVIDIA GPU 的深度学习推理调优工具包,帮助把训练好的模型调优并部署到 TensorRT、ONNX Runtime 等推理后端上跑得更快。

自动化调整大模型对齐行为的工具,支持直接干预、LoRA 和 MoE 专家级消融,并用 Optuna 多目标搜索调参。
在 Apple Silicon Mac 上本地运行 Phi-3、Phi-3.5 和 Phi-4 视觉与语言模型,基于 MLX 和 Metal 加速,支持微调、LoRA 与多智能体编排。

用 PyTorch 从零手写现代 LLM 架构、训练与推理的实战课程,配套可直接运行的 notebook,适合边跑边学大模型原理。
把家里已有的多台电脑组网成 AI 内网,统一跑大模型推理和微调训练,兼容 OpenAI 接口,适合本地部署和 homelab 场景。
在神经网络层面实时干预基础模型的输出,用 PyTorch 和 Jupyter Notebook 做液态神经网络与注意力机制的可视化微调实验。
基于 FastAI 和 PyTorch 的模型压缩工具,提供剪枝、蒸馏和量化,帮你在边缘设备上跑更小更快的神经网络。
汇总视频深度估计与立体视频转换模型的排行榜,方便按指标对比 Depth Anything、DepthCrafter、StereoCrafter 等方案的优劣。

系统梳理大模型有害微调攻击的综述,汇总攻击与防御方法,帮安全研究者快速掌握微调带来的对齐失效风险。
面向机器人操作的自进化智能体训练方案,通过后训练和递归自我改进,在成功率提升14%的同时把 token 消耗降低65%。
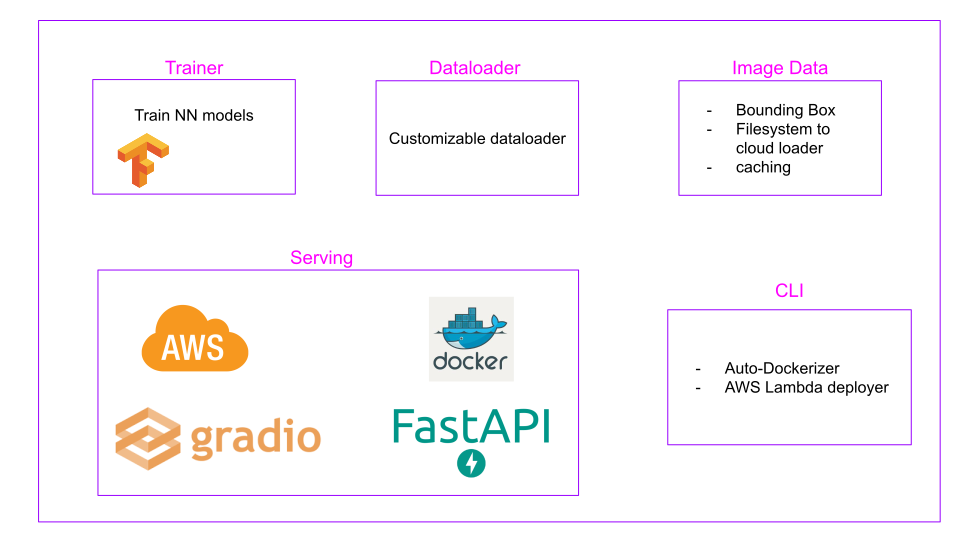
一站式深度学习全栈库,把模型搭建、FastAPI 接口开发和模型部署串起来,还带 GradCAM 可解释性分析,省去自己拼装各环节的麻烦。
NVIDIA Alpamayo 的开发者配方库,提供自动驾驶与机器人模型的微调、强化学习后训练、量化和部署现成方案,省去从零搭建流程的麻烦。
一站式实时视觉训练与部署框架,覆盖目标检测、关键点估计、实例与语义分割,支持导出 TensorRT、ONNX、OpenVINO、CoreML 到边缘设备。
微软 Florence-2 视觉语言模型的非官方实战笔记本合集,覆盖推理、自动标注和微调,方便快速上手做目标检测、OCR 等视觉任务。
基于 C++ 和 TensorRT 的 RF-DETR 推理引擎,支持目标检测与实例分割,可在 NVIDIA GPU 和 Jetson 上以 FP32/FP16/INT8 量化部署。
面向 ROS2 机器人的 GPU 加速目标检测包,基于 TensorRT 和 Triton 推理深度学习模型,可在 Jetson 上实时运行。
面向 Hailo 边缘 AI 芯片的预训练模板应用流水线,基于 GStreamer 搭建,开箱即用,省去从零拼装视频推理链路的麻烦。