视觉与 3D
共 464 个仓库
基于曼哈顿世界假设的神经隐式三维重建方法,利用场景中互相垂直的平面结构约束,从多视角图像重建室内房间的稠密几何。

ARCTIC 数据集官方工具链,提供下载、预处理、可视化和模型训练脚本,用于手物交互与手部追踪研究。
用稀疏视角图像在几秒内重建大规模三维场景,把体素与高斯泼溅结合成 VoxSplats 表示,适合快速生成可渲染的城市场景。
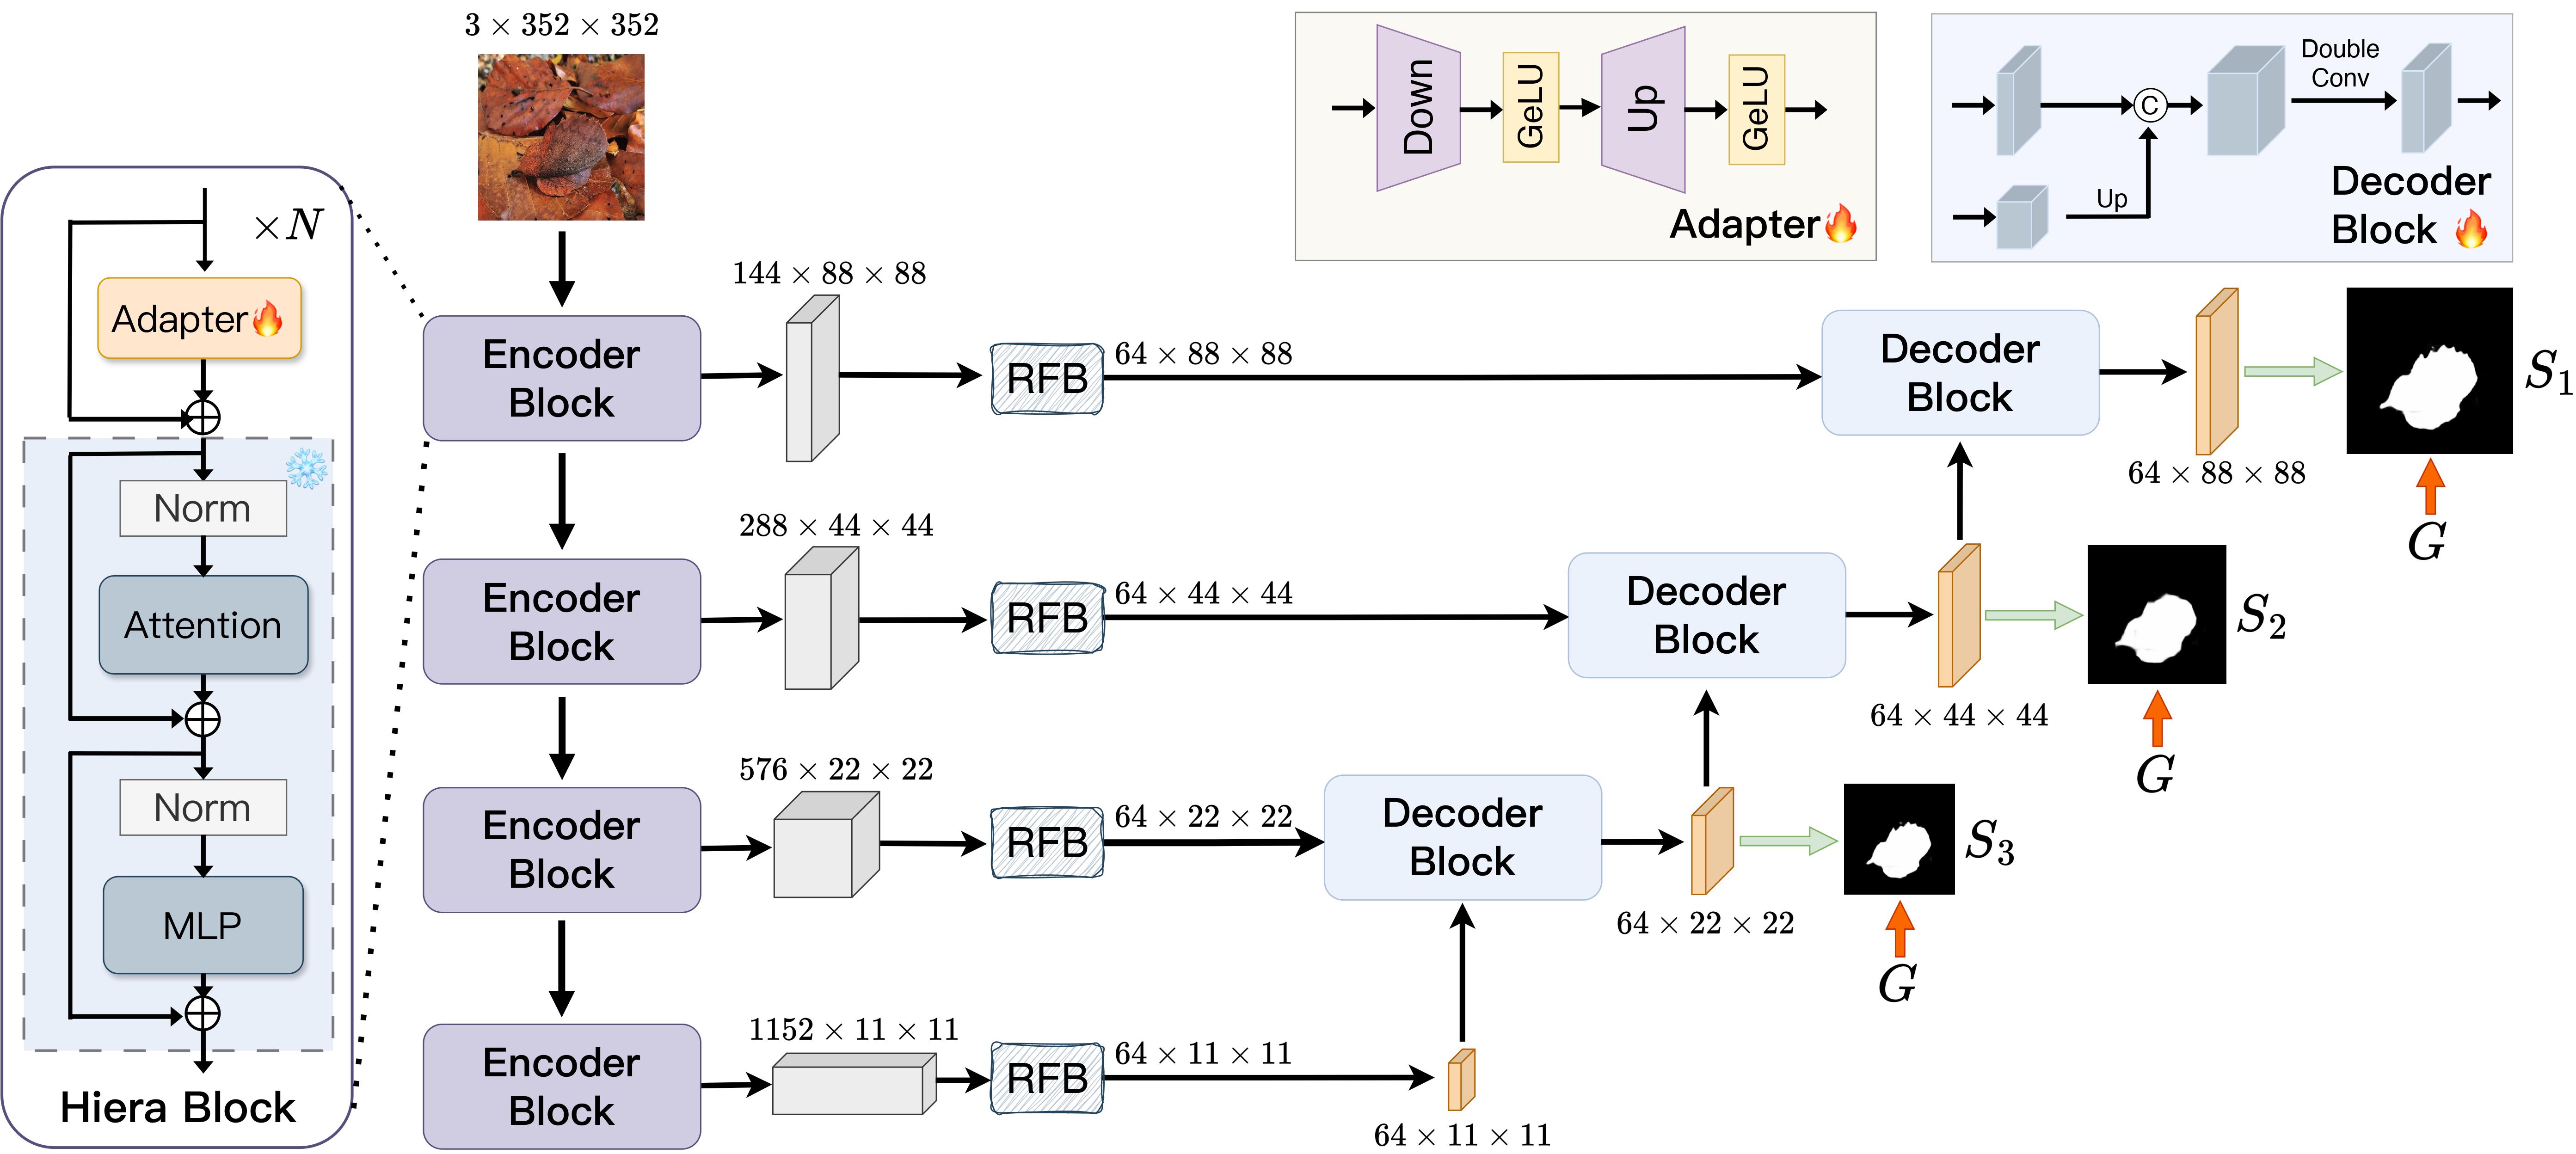
把 Segment Anything 2 当作强编码器接上 U-Net 解码器,做自然图像和医学图像分割,覆盖伪装目标、息肉、海洋动物等场景。
用代码和 AI 智能体从 OpenStreetMap 数据程序化生成旧金山等城市的 3D 数字孪生场景,在浏览器里通过 Three.js 和 WebGL 实时渲染。

基于 GTSAM 的端到端运动恢复结构(SfM)框架,从多视角图像中重建三维场景与相机位姿。
基于 Three.js 的 3DGS 高斯泼溅查看器,支持标注、测量和预设 LOD 渲染,方便在网页端浏览和操作三维重建场景。
用手机拍几秒视频就能实时重建可驱动的三维头部数字人,基于 instant-ngp 加速神经体积渲染,秒级完成建模。

基于 Vulkan 的 3D 高斯泼溅高级查看器,集成光栅化、光线追踪与网格着色器等多种渲染方式,用于实时可视化三维高斯场景。
Ultralytics 官方 Flutter 插件,让 Android 和 iOS 应用直接跑 YOLO 实时推理,覆盖检测、分割、分类、姿态与深度估计等视觉任务。
CVPR 2022 发布的大规模 3D 头部对齐数据集,提供密集、准确、多样的标注,用于从单张图像重建 3D 人脸和头部。
整理基于辐射场(NeRF、3DGS)的 3D 编辑论文清单,方便研究者快速定位并跟进这一方向的进展。
基于 SAM2 的视觉目标跟踪记忆模块,通过抑制干扰物来提升跟踪稳定性,适用于复杂场景下的单目标跟踪。
仅用一段 MP4 监控录像和对应的谷歌地图位置,就能重建出数字孪生风格的三维交通场景,把画面里的车辆投影到真实地理坐标上。
每天自动汇总 arXiv 上 VLN、VLA、世界模型、SLAM、高斯泼溅与非线性优化等具身智能方向的最新论文,方便快速跟进前沿进展。

整理基于 ROS 的移动机器人学习资源清单,覆盖 SLAM、里程计、导航与操作等方向,方便快速找到入门和进阶资料。
收集伪装目标检测(COD)相关论文、数据集和代码的资源清单,方便研究者快速找到隐蔽场景下目标检测与分割的资料。

把 Stereolabs ZED 双目相机接入 ROS 的官方封装包,提供图像、深度、位姿和点云等话题,方便在机器人系统里做立体视觉与 SLAM 开发。

从单目视频里同时重建关节手和物体的三维姿态与形状,无需预扫描物体模板或手物交互训练数据,适合做手物交互建模与AR/VR研究。
MapEval 是一个统一的 SLAM 建图评估框架,用点云配准和 Wasserstein 距离等指标,稳健高效地给激光点云地图打分,方便做 SLAM 基准对比。

用 Rust 重写的日语形态素分析器,也是新一代 SudachiPy 的底层实现,提供分词和词性标注,比原版更快、更省内存。

CVPR 2023 发布的大规模真实世界多视角图像数据集,覆盖 238 类物体,可直接用于训练 NeRF、3D 高斯泼溅和三维重建模型。
FaceLit 是 CVPR 2023 的官方实现,用 GAN 和 NeRF 生成可重打光的三维人脸,让生成的人脸能按任意光照条件渲染。
低成本手持式激光雷达-惯性-视觉融合 3D 传感器,为机器人和具身智能提供实时建图与三维重建能力。