Python
2,038 个项目 · 全站第 1 / 91算法与数据侧的默认语言:生态最全,训练、推理脚本、数据处理都绕不开它。
主要方向推荐一个 Python 项目
按一级分类统计;另有 4 个项目尚未分类全部项目 2038
按 star 排序 · 第 9 / 43 页面向科研文档的高精度 RAG 问答工具,能从论文中检索答案并给出引用出处,适合做文献调研和科学问答。
把 Claude Code 变成游戏 Mod 开发助手,提供侦察、逆向工程、fal 生成美术/3D/音频、游戏内测试和演示视频等技能与 MCP 工具,几乎能改任何 PC 游戏。
本地优先的深度研究问答系统,接 llama.cpp、Ollama 等本地或云端模型,聚合 arXiv、PubMed 及私有文档等十余个检索源,全程加密。
用纯 RNN 架构的 RWKV 语言模型驱动的开源聊天机器人,效果对标 ChatGPT,可在本地部署运行。

自动抓取并持续更新免费 Clash、V2Ray、Trojan、SSR 等订阅链接,省去手动找节点的麻烦,适合需要科学上网的用户直接导入客户端使用。
一份持续更新的异常检测资源大全,汇总书籍、论文、视频和工具箱,覆盖传统方法与最新的 LLM、VLM 工作,适合快速入门和跟进前沿。
一站式搞定 Qwen、Gemma 等开源大模型和多模态模型的微调(SFT/RL)、评测与部署,零代码也能上手。
基于多模态大模型的 GUI 智能体家族,能看懂手机和电脑界面并自动点击操作,帮你完成跨 App 的自动化任务。
完全离线运行的 Python 多智能体框架,面向高监管团队和想在本地跑 AI 的人,不用联网也能搭建智能体。
基于 so-vits-svc 改进的歌声与语音转换工具,支持实时变声、更友好的操作界面和更多功能,适合做 AI 翻唱和音色克隆。

基于 OpenSPG 引擎和大模型构建的逻辑推理与检索框架,用逻辑形式引导专业领域知识库做事实问答,解决传统 RAG 向量相似度检索在多跳推理上不可靠的问题。
静态扫描基础设施即代码、容器镜像和开源包,在构建阶段提前发现云配置错误与安全漏洞,避免上线后出问题。

基于 PyTorch 的深度概率编程库,用 Python 写贝叶斯模型,支持变分推断和 MCMC,适合做不确定性建模与生成模型研究。

字节跳动开源的文档图像解析模型,用异构锚点提示把 PDF 和图片里的版面、文字、表格一次性解析成结构化内容,适合喂给 RAG 或做文档分析。

医学影像分割的深度学习工具箱,开箱即用,能自动配置训练流程,在 CT、MRI 等 3D 数据上达到竞赛级精度。
追踪 3D Gaussian Splatting 研究进展的论文与资源精选列表,帮你在快速爆发的 3DGS 领域里快速找到关键工作和实现代码。
Python 语音识别库,统一封装多种在线和离线引擎与 API,几行代码就能把音频转成文字,省去逐个对接各家服务的麻烦。
开源免费的跨平台 B 站视频下载工具,支持多线程加速、音视频分离、弹幕与元数据获取,还能自定义命名和分类整理。
A sound cloning tool with a web interface, using your voice or any sound to record audio / 一个带web界面的声音克隆工具,使用你的音色或任意声音来录制音频
把训练好的模型快速封装成推理 API 和任务队列,支持 LLM 应用与多模型流水线,省去自己搭服务框架的麻烦。
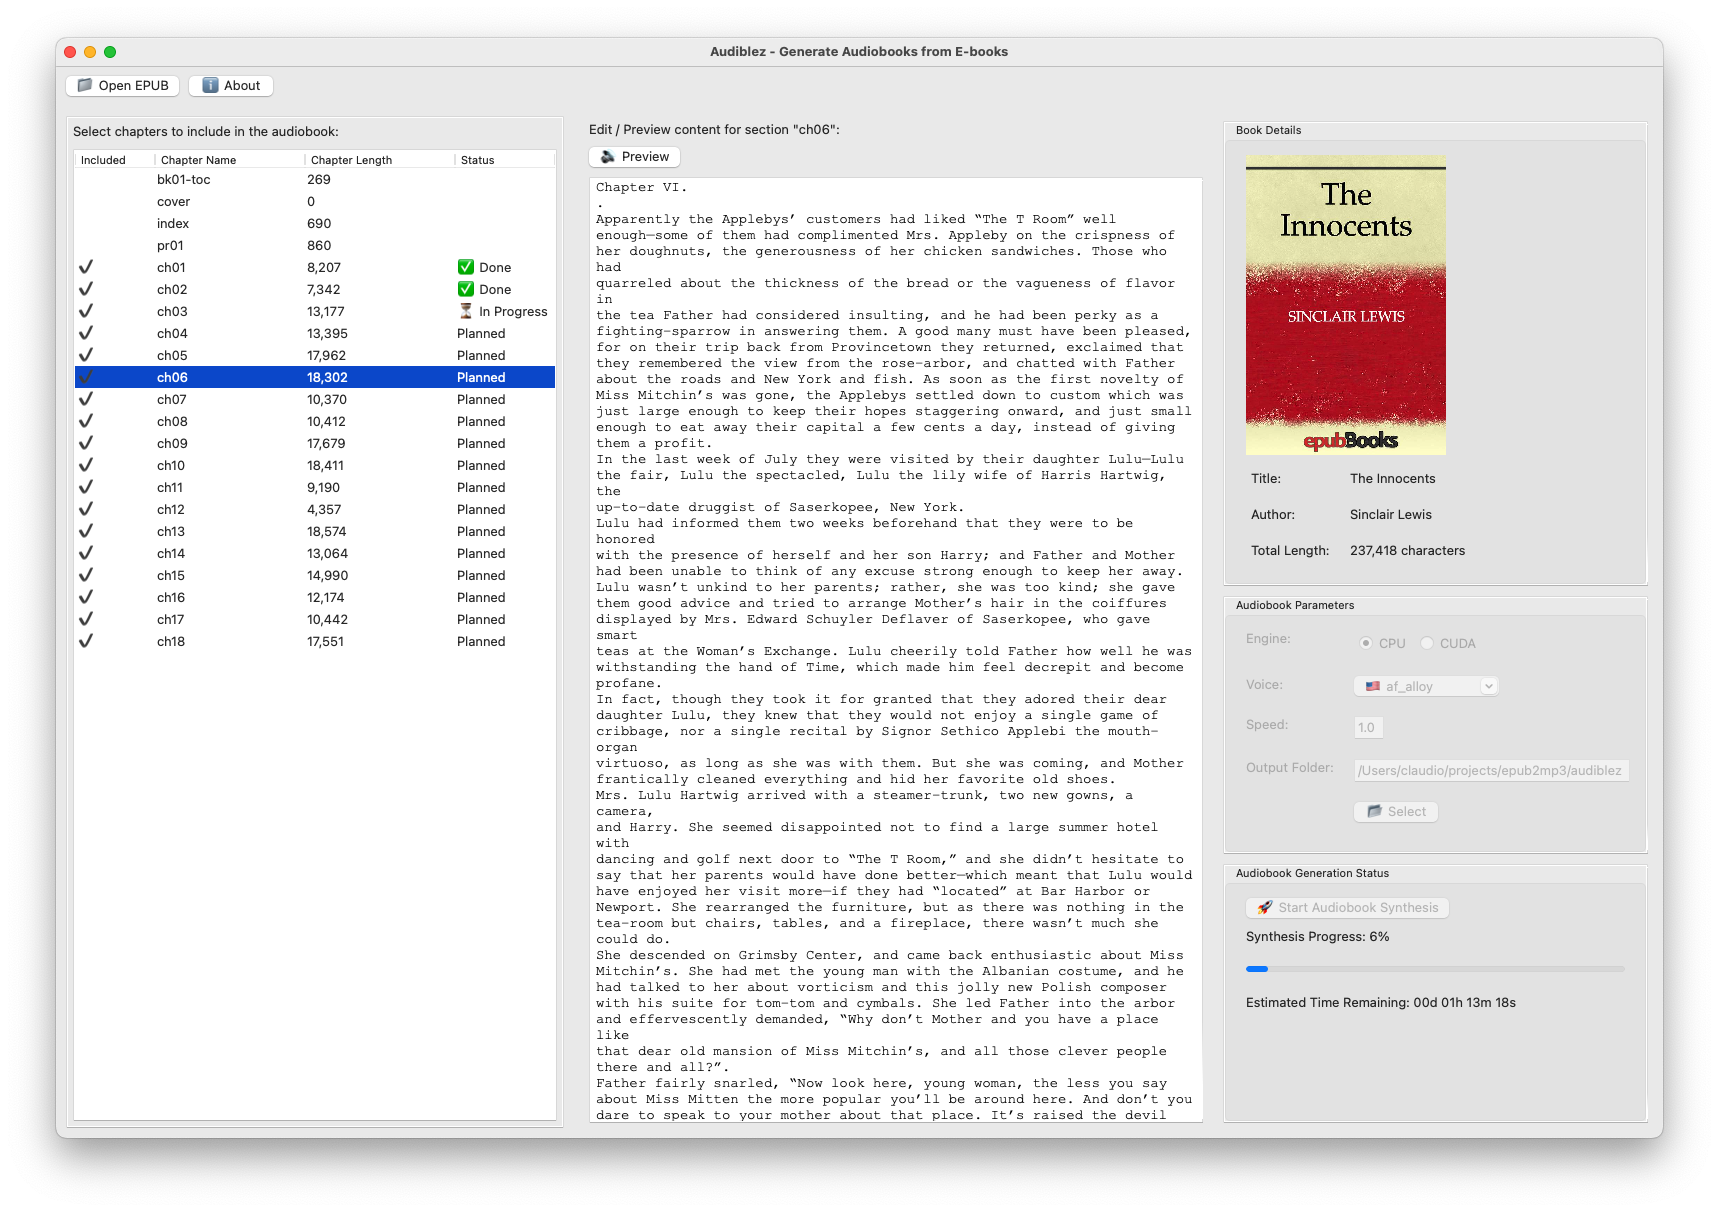
把 EPUB 电子书转成有声书的 Python 工具,基于 Kokoro 语音合成模型,适合想批量制作个人音频书的人。
Accelerate local LLM inference and finetuning (LLaMA, Mistral, ChatGLM, Qwen, DeepSeek, Mixtral, Gemma, Phi, MiniCPM, Qwen-VL, MiniCPM-V, etc.) on Intel XPU (e.g., local PC with iGPU and NPU, discrete GPU such as Arc, Flex and Max); seamlessly integrate with llama.cpp, Ollama, HuggingFace, LangChain, LlamaIndex, vLLM, DeepSpeed, Axolotl, etc.
基于 PyTorch 的医学影像深度学习工具包,提供数据加载、预处理、网络结构和评估等组件,帮研究者快速搭建医疗影像 AI 流程。

用两小时从零训练一个 65M 参数的多模态视觉语言模型,代码和流程完整,适合低成本复现 VLM 训练与对话实验。
基于 VITS2 骨干网络和多语言 BERT 的语音合成模型,能生成自然度较高的多语种语音,适合做 TTS 训练与推理。
实时监控 Claude Code 的用量,预测额度消耗并在接近上限时提前告警,帮你在终端里随时掌握 token 使用情况。

面向 Android 设备的全栈控制平台,集成 WebRTC 远程桌面、UI/OCR 自动化、一键 MITM 抓包和内置 Frida,适合多设备集群的自动化测试与逆向分析。
一份三语(繁中/英文/简中)的 Agentic AI 学习路线图,从 LLM 基础一路讲到多智能体系统,收录 240+ 精选资源和动手示例,适合系统入门 AI Agent。
一套免费的 Claude 技能集,能逆向分析任意应用、复刻重建并测试修 bug,还能按用户反馈改进,适合独立开发者快速克隆产品。

面向 OPC 和中小微企业的自媒体获客智能体,用多智能体协作自动完成内容抓取、RPA 操作和营销获客流程。
一条命令就能从 Google 图片批量抓取几百张图片,支持按颜色、尺寸等条件筛选,适合快速搭建图像数据集。
用 Python 写的可扩展音乐服务器,能接入本地文件和各种流媒体服务,统一管理和播放音乐,适合自建家庭音乐中心。

自托管的 YouTube 媒体服务器,自动下载订阅频道视频并建立本地索引,用 Elasticsearch 提供搜索和播放,解决视频收藏与离线观看需求。
多音色、支持提示词控制情感与风格的语音合成引擎,输入文本即可生成带情绪表现力的自然语音,适合做有声内容和虚拟人配音。

让大模型在普通显卡上跑起来的 PyTorch 量化库,支持 8-bit 和 4-bit 权重压缩,也是 QLoRA 微调背后的核心依赖。

基于 ONNX Runtime、OpenVINO、PaddlePaddle 等多家推理后端的 OCR 工具包,支持多语言识别,方便在不同硬件上快速部署文字检测与识别。
给 GDB 加上现代化调试体验的增强插件,为 Linux 上的漏洞利用开发和逆向工程师提供高级调试能力。

基于深度学习的中文语音识别系统,用 CNN+CTC 把中文语音转成文字,适合搭建本地语音转写服务。

用 Python 写的开源深度研究工具,能对私有数据做推理式检索,替代闭源深度研究方案,支持接入 Milvus 和多种大模型。

提供可插拔的 Python 和 C++ 多目标跟踪模块,集成 BoT-SORT、ByteTrack、OC-SORT 等 SOTA 算法,支持轴对齐与旋转框跟踪。
一站式爬虫工具箱,能自动抓取并导出 GitHub、邮箱、电商、运营商、社交平台等几十个网站的个人数据,帮用户把散落各处的数据拿回自己手里。
基于苹果 MLX 框架的语音处理库,在 Apple Silicon 上高效完成语音合成、语音识别和语音转换,适合本地跑多模态语音任务。
给 LLM 加一层语义缓存,相似问题直接命中缓存结果,省下重复调用 API 的钱和时间,已集成 LangChain 和 llama_index。
在 Jupyter 里交互式可视化 BERT、GPT-2、RoBERTa 等 Transformer 模型的注意力权重,帮助理解模型内部机制。
基于 Stream 边缘网络快速搭建语音与视觉智能体,可接入任意模型或视频源,实现超低延迟的实时多模态交互。
LMDeploy 是面向大模型的高效推理与服务工具包,支持模型压缩、部署和在线服务,内置 TurboMind 推理引擎和 CUDA 算子,可加速 Llama、InternLM 等模型的推理。
扫描代码库生成健康评分、自动文档和 Git 分析,还能找出死代码并通过 MCP 输出架构决策,帮团队和 AI 快速看懂项目现状。
给一个示例 URL,自动学习网页结构并生成抓取规则,省去手写解析逻辑,适合快速采集相似页面的数据。