需 Python>=3.6.4、PyTorch>=1.8.0(torchvision>=0.9.0)、CUDA>=10.2;用 use_modelscope=True 自动下载模型前需先装 modelscope 包;训练前需把图文数据转成 base64 tsv+jsonl 并用 build_lmdb_dataset.py 序列化为 LMDB。

Chinese-CLIP
OFA-SysMIT更新放缓中文版 CLIP 预训练模型,支持中文图文跨模态检索和表征生成,可直接用于图文匹配、零样本分类等任务。
Chinese version of CLIP which achieves Chinese cross-modal retrieval and representation generation.
暂无版本6,041star +4 / 7 天551fork同步于 2026-11-10 11:34 UTC
pip install cn_clip
pip install -r requirements.txt 硬件要求按 README 说明
README 未给出具体显存要求;代码示例按 torch.cuda.is_available() 自动选 GPU 或 CPU,CPU 可跑推理;CUDA 版本需 >= 10.2。
需要 CUDA
中文版 CLIP,用约 2 亿中文图文对训练,帮你快速做中文图文特征提取与跨模态检索
中文版 CLIP 预训练模型,支持中文图文跨模态检索和表征生成,可直接用于图文匹配、零样本分类等任务。
核心能力
- 提供 pip 安装的 cn_clip API,几行代码算图文相似度
- 开源 RN50 到 ViT-H/14 共 5 个规模预训练模型
- 支持 MUGE、Flickr30K-CN、COCO-CN 跨模态检索 finetune
- 支持零样本图像分类与 ELEVATER 中文评测
- 支持 ONNX、TensorRT、CoreML 部署及 FlashAttention 训练加速
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
暂无 release 数据(可能没有发版,或尚未同步)。
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。
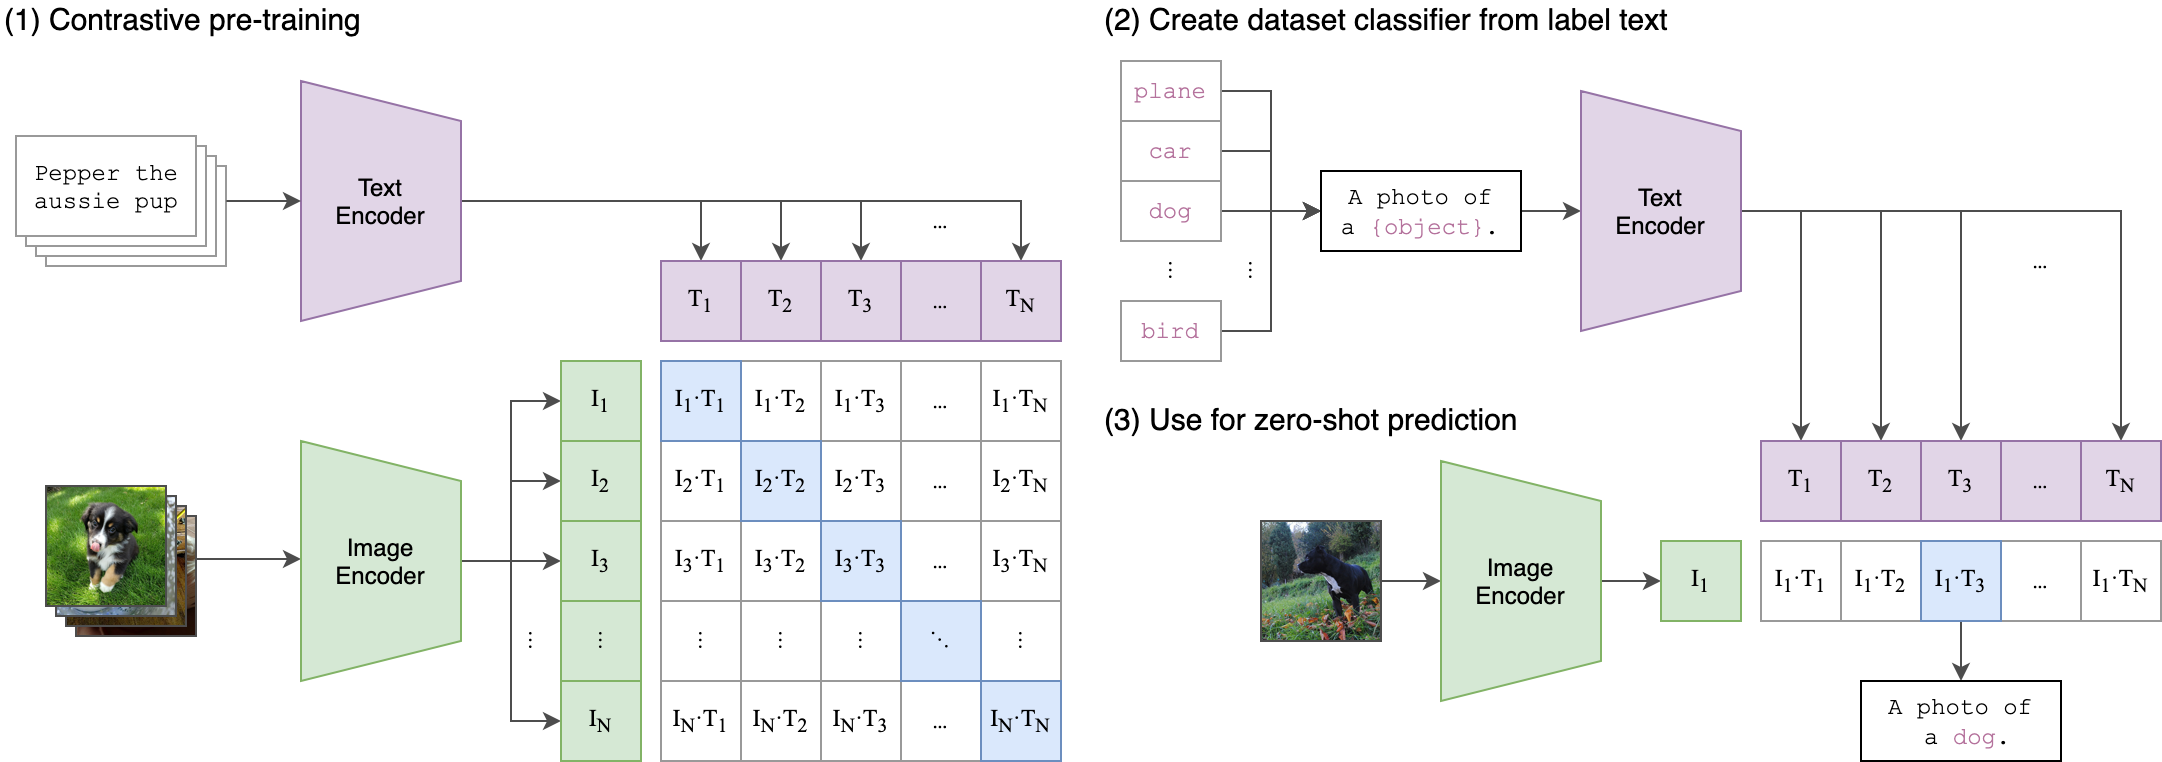
本项目为CLIP模型的中文版本,使用大规模中文数据进行训练(~2亿图文对),旨在帮助用户快速实现中文领域的图文特征&相似度计算、跨模态检索、零样本图片分类等任务。本项目代码基于open_clip project建设,并针对中文领域数据以及在中文数据上实现更好的效果做了优化。本项目提供了API、训练代码和测试代码,下文中将详细介绍细节。
新闻
- 2023.11.30 Chinese-CLIP添加了转换Pytorch模型为coreml格式的转换脚本,用于部署。(感谢@manymuch贡献代码❤️)
- 2023.9.8 Chinese-CLIP支持了基于ModelScope库的知识蒸馏微调功能。(感谢阿里云PAI团队@wuziheng和@Jaskr616同学贡献代码❤️)
- 2023.5.9 Chinese-CLIP适配Pytorch2.0。
- 2023.3.20 新增对比学习的梯度累积支持,可模拟更大batch size的训练效果
- 2023.2.16 新增FlashAttention支持,提升训练速度,降低显存占用,详见flash_attention.md
- 2023.1.15 新增部署ONNX和TensorRT模型支持(并提供预训练TensorRT模型),提升特征推理速度,满足部署需求,详见deployment.md
- 2022.12.12 新增实现FLIP训练策略,在finetune训练时可激活使用(感谢@zwkkk同学贡献代码❤️)
- 2022.12.3 公开ELEVATER图像分类数据集的中文版本,详见数据文档
- 2022.12.1 Chinese-CLIP模型代码&特征提取API,同步合入Huggingface transformers🤗代码库
- 2022.11.22 新增零样本图像分类代码,可支持ELEVATER benchmark零样本分类评测任务
- 2022.11.3 新增RN50,ViT-H-14模型,公开技术报告
- 2022.9.22 新增ViT-L-14,ViT-L-14-336模型
- 2022.7.13 新增图文特征提取快速API,几行代码快速调用中文CLIP模型,计算图文特征&相似度
- 2022.7.8 Chinese-CLIP项目正式开源,开源图文检索代码
模型及实验
模型规模 & 下载链接
Chinese-CLIP目前开源5个不同规模,其模型信息和下载方式见下表:
- 🤗 Hugging Face Hub
- 🤖 魔搭社区
实验结果
针对图文检索任务,我们在MUGE Retrieval、Flickr30K-CN和COCO-CN上进行了zero-shot和finetune的实验。针对图像零样本分类,我们在ELEVATER的10个数据集上进行了实验。实验结果如下表所示。篇幅所限,我们这里给出baseline模型和Chinese-CLIP的最优规模模型结果,关于Chinese-CLIP各规模的详细结果指标,请详见Results.md。
MUGE Text-to-Image Retrieval (Official Validation Set):
Flickr30K-CN Retrieval (Official Test Set):
COCO-CN Retrieval (Official Test Set):
Zero-shot Image Classification:
开始用起来!
安装要求
开始本项目前,需先检查是否满足下列环境配置要求:
- python >= 3.6.4
- pytorch >= 1.8.0 (with torchvision >= 0.9.0)
- CUDA Version >= 10.2
运行下列命令即可安装本项目所需的三方库。
pip install -r requirements.txt
API快速上手
下面提供一段简单的代码示例说明如何使用中文CLIP的API。开始使用前,请先安装cn_clip:
# 通过pip安装
pip install cn_clip

# 或者从源代码安装
cd Chinese-CLIP
pip install -e .
安装成功后,即可通过如下方式轻松调用API,传入指定图片(示例)和文本,提取图文特征向量并计算相似度:
import torch
from PIL import Image

import cn_clip.clip as clip
from cn_clip.clip import load_from_name, available_models
print("Available models:", available_models())
# Available models: ['ViT-B-16', 'ViT-L-14', 'ViT-L-14-336', 'ViT-H-14', 'RN50']

device = "cuda" if torch.cuda.is_available() else "cpu"
# 如本地模型不存在,自动从ModelScope下载模型,需要提前安装`modelscope`包
model, preprocess = load_from_name("ViT-B-16", device=device, download_root='./', use_modelscope=True)
model.eval()
image = preprocess(Image.open("examples/pokemon.jpeg")).unsqueeze(0).to(device)
text = clip.tokenize(["杰尼龟", "妙蛙种子", "小火龙", "皮卡丘"]).to(device)

with torch.no_grad():
    image_features = model.encode_image(image)
    text_features = model.encode_text(text)
    # 对特征进行归一化,请使用归一化后的图文特征用于下游任务
    image_features /= image_features.norm(dim=-1, keepdim=True)
    text_features /= text_features.norm(dim=-1, keepdim=True)

    logits_per_image, logits_per_text = model.get_similarity(image, text)
    probs = logits_per_image.softmax(dim=-1).cpu().numpy()

print("Label probs:", probs)  # [[1.268734e-03 5.436878e-02 6.795761e-04 9.436829e-01]]
我们也准备了部署ONNX和TensorRT模型的相关支持,流程详见deployment.md。
如果你不满足于仅仅使用API,欢迎继续阅读本文档,了解如何使用我们的项目进行CLIP模型的训练和测试。
教程
下文将包括跨模态检索教程(包含finetune和inference,及KNN计算等)以及零样本图像分类教程。
跨模态检索
代码组织
下载本项目后, 请创建新的文件夹 ${DATAPATH} 以存放数据集、预训练ckpt、以及finetune产生的模型日志&ckpt。推荐工作区目录结构如下:
Chinese-CLIP/
├── run_scripts/
│   ├── muge_finetune_vit-b-16_rbt-base.sh
│   ├── flickr30k_finetune_vit-b-16_rbt-base.sh
│   └── ...           # 更多finetune或评测脚本...
└── cn_clip/
    ├── clip/
    ├── eval/
    ├── preprocess/
    └── training/

${DATAPATH}
├── pretrained_weights/
├── experiments/
├── deploy/	      # 用于存放ONNX & TensorRT部署模型
└── datasets/
    ├── MUGE/
    ├── Flickr30k-CN/
    └── .../          # 更多自定义数据集...
准备工作
这里我们提供预训练模型参数的下载方式,以及进行finetune前对数据进行的预处理过程
预训练CKPT
请参考前文模型规模 & 下载链接部分,下载对应模型ckpt(.pt后缀文件即可)。推荐将下载的ckpt文件存放于${DATAPATH}/pretrained_weights/目录下。
数据集格式预处理
为了与Chinese-CLIP代码适配,同时保证数据处理和读取的效率,我们建议将训练&评测使用的图文数据集统一组织成如下的方式:
${DATAPATH}
└── datasets/
    └── ${dataset_name}/
        ├── train_imgs.tsv      # 图片id & 图片内容
        ├── train_texts.jsonl   # 文本id & 文本内容,连同匹配的图片id列表
        ├── valid_imgs.tsv
        ├── valid_texts.jsonl
        ├── test_imgs.tsv
        └── test_texts.jsonl
其中${dataset_name}代指数据集名称(如MUGE)
为保证文件处理效率,我们不是将图片以大量的小文件方式存放,而是将训练/验证/测试图片以base64形式分别存放在${split}_imgs.tsv文件中。文件每行表示一张图片,包含图片id(int型)与图片base64,以tab隔开,格式如下:
1000002 /9j/4AAQSkZJ...YQj7314oA//2Q==
将图片原始文件转换为base64的方式非常简单,请执行以下python代码:
from PIL import Image
from io import BytesIO
import base64

img = Image.open(file_name) # 访问图片路径
img_buffer = BytesIO()
img.save(img_buffer, format=img.format)
byte_data = img_buffer.getvalue()
base64_str = base64.b64encode(byte_data) # bytes
base64_str = base64_str.decode("utf-8") # str
文本信息及图文对匹配关系则保存在${split}_texts.jsonl文件。文件每行是一行json,格式如下:
{"text_id": 8428, "text": "高级感托特包斜挎", "image_ids": [1076345, 517602]}
对于测试集只有文本,不知道图文对匹配关系的情况,每行的image_ids字段处理为空列表即可,即"image_ids": []。
最后,我们还需要将tsv和jsonl文件一起序列化,转换为内存索引的LMDB数据库文件,方便训练时的随机读取
python cn_clip/preprocess/build_lmdb_dataset.py \
    --data_dir ${DATAPATH}/datasets/${dataset_name}
    --splits train,valid,test
例如对于MUGE数据集,则${dataset_name}设为MUGE,--splits指定需要转换的数据集划分,以逗号不加空格分隔。转换后,数据集文件夹下会对应增加以下LMDB序列化文件
${DATAPATH}
└── datasets/
    └── ${dataset_name}/
        └── lmdb/
            ├── train
            │   ├── imgs
            │   └── pairs
            ├── valid
            └── test
为了降低上手难度,我们也提供了按上述步骤预处理好的数据压缩包,直接下载解压并放置于${DATAPATH}/datasets/目录下即可:
模型finetune
在此我们介绍训练的步骤,方便其他用户了解模型细节,使用我们提供的中文CLIP预训练模型进行finetune。基于MUGE和Flickr30K-CN两个下游检索数据集,我们提供了训练样例脚本run_scripts/muge_finetune_vit-b-16_rbt-base.sh和run_scripts/flickr30k_finetune_vit-b-16_rbt-base.sh。运行脚本同时支持单机(单卡或多卡)和多机分布式训练,请在运行前,先根据脚本开头的指引注释,填写好分布式相关配置,之后运行如下命令即可开始训练(多机训练请在各机器上都运行命令)。对于显存不足的情况,可以考虑激活配置项中的重计算策略。训练产生的log和模型ckpt文件,会自动保存在用户指定的目录下:
cd Chinese-CLIP/
bash run_scripts/muge_finetune_vit-b-16_rbt-base.sh ${DATAPATH}
相关的训练配置项包括:
- 分布式
WORKER_CNT: 训练的机器个数GPUS_PER_NODE: 每个机器上的GPU个数
- 训练/验证数据
train-data: 训练数据LMDB目录,准备LMDB数据文件的预处理流程见上。val-data: 验证数据LMDB目录,指定为None时,则不进行训练过程中的验证。num-workers: 训练集数据处理(DataLoader)的进程数,默认为4。valid-num-workers: 验证集数据处理(DataLoader)的进程数(如果进行验证),默认为1。
- 训练超参数
vision-model: 指定视觉backbone, 从["ViT-B-16", "ViT-L-14", "ViT-L-14-336", "ViT-H-14", "RN50"]选择。text-model: 指定文本backbone, 从["RoBERTa-wwm-ext-base-chinese", "RoBERTa-wwm-ext-large-chinese", "RBT3-chinese"]选择。context-length: 文本输入序列长度。warmup: warmup步数。batch-size: 训练时单卡batch-size。(请保证训练样本总数 > batch-size * GPU数,至少满足1个训练batch)lr: 学习率。wd: weight decay。max-steps: 训练步数,也可通过max-epochs指定训练轮数。freeze-vision: 是否freeze视觉backbone。use-augment: 是否使用AutoAugment对图片进行数据增强。valid-batch-size: 验证时单机batch-size。(请保证验证集样本总数 > batch-size * GPU数,至少满足1个验证batch)valid-step-interval和valid-epoch-interval: 验证step/epoch频率,指定为-1时则在训练中不进行验证。grad-checkpointing: 使用重计算策略,在前向过程中不保存中间结果,以训练时间换取更小的显存开销,适用于显存不足的情况。(store_true参数,直接在脚本中加上--grad-checkpointing即可,目前要求Pytorch>1.8.0)mask-ratio: 参照FLIP的策略,在finetune时可指定随机mask一定比例的图像patch,以降低显存开销、加快训练速度。默认为0.0,即不激活这一策略。use-flash-attention: 使用FlashAttention,可在不影响效果的条件下为Chinese-CLIP的finetune过程显著提速以及降低显存占用。(store_true参数,配置好环境后,在脚本中加上--use-flash-attention即可,请详见flash_attention.md)accum-freq: 梯度累积频率,默认为1。指定为大于1的整数时开启对比学习梯度累积,模拟更大的batch size。如果单卡batch size为m,则总的batch size为accum_freq * m * GPU数。gather-with-grad: 是否在分布式训练时进行带有完整梯度的特征gather,默认关闭。
- 输出选项
name: 指定输出路径。超参日志, 训练日志以及产出ckpt均会存放至${DATAPATH}/experiments/${name}/。save-step-frequency及save-epoch-frequency: 存ckpt的步数或轮数间隔。report-training-batch-acc: 日志是否报告训练图到文&文到图batch准确率。
- 权重读取相关选项
resume: 权重读取的路径。示例脚本中指定为预训练ckpt路径,也可以指定为用户自己finetune的ckpt路径做继续训练。reset-data-offset: 是否从此前的数据断点续跑。如batch size或GPU卡数超参改变,建议打开此选项。reset-optimizer: 是否使用optimizer state。
训练完毕,log 会自动存在${DATAPATH}/experiments/${name}/out_${timestamp}.log,训练log格式如下所示:
2022-12-11,20:40:34 | INFO | Rank 0 | Global Steps: 1/735 | Train Epoch: 1 [1024/250880 (0%)] | Loss: 2.371020 | Image2Text Acc: 49.90 | Text2Image Acc: 48.73 | Data Time: 1.039s | Batch Time: 3.625s | LR: 0.000000 | logit_scale: 4.605 | Global Batch Size: 1024
验证log格式如下所示:
2022-12-11,20:42:47 | INFO | Rank 0 | Validation Result (epoch 1 @ 150 steps) | Valid Loss: 0.502810 | Image2Text Acc: 84.95 | Text2Image Acc: 84.26 | logit_scale: 4.605 | Valid Batch Size: 128
注意: 对比学习的训练收敛和稳定性和总batch size相关。如您使用更小的batch size(相比默认配置128 per-GPU * 8 GPU),建议使用更小的学习率。我们推荐使用更多的GPU和更大的batch size以取得更好的效果。
预测及评估
我们提供特征提取、以及图文检索任务评估的流程,具体如下:
图文特征提取
目前本代码支持使用GPU单卡进行图文特征提取,请参考使用以下命令。我们也提供了部署ONNX和TensorRT模型,加速特征推理的支持,详见deployment.md。
cd Chinese-CLIP/
export CUDA_VISIBLE_DEVICES=0
export PYTHONPATH=${PYTHONPATH}:`pwd`/cn_clip

split=valid # 指定计算valid或test集特征
resume=${DATAPATH}/pretrained_weights/clip_cn_vit-b-16.pt

python -u cn_clip/eval/extract_features.py \
    --extract-image-feats \
    --extract-text-feats \
    --image-data="${DATAPATH}/datasets/${dataset_name}/lmdb/${split}/imgs" \
    --text-data="${DATAPATH}/datasets/${dataset_name}/${split}_texts.jsonl" \
    --img-batch-size=32 \
    --text-batch-size=32 \
    --context-length=52 \
    --resume=${resume} \
    --vision-model=ViT-B-16 \
    --text-model=RoBERTa-wwm-ext-base-chinese
产出图文特征默认将保存于${DATAPATH}/datasets/${dataset_name}目录下,图片特征保存于${split}_imgs.img_feat.jsonl文件,每行以json存储一张图片的特征,格式如下:
{"image_id": 1000002, "feature": [0.0198, ..., -0.017, 0.0248]}
文本特征则保存于${split}_texts.txt_feat.jsonl,格式如下:
{"text_id": 248816, "feature": [0.1314, ..., 0.0018, -0.0002]}
KNN检索
对于小规模的学术检索数据集,我们提供一个简单的KNN检索实现,便于计算文到图、图到文检索的top-k召回结果(tips:如想仿照我们在项目中搭建检索demo,建议基于中文CLIP模型产出图文特征后,结合开源工程框架clip-retrieval搭建前后端服务。)
对于文到图检索(文本召回相关图片),请运行以下命令:
cd Chinese-CLIP/
split=valid # 指定计算valid或test集特征
python -u cn_clip/eval/make_topk_predictions.py \
    --image-feats="${DATAPATH}/datasets/${dataset_name}/${split}_imgs.img_feat.jsonl" \
    --text-feats="${DATAPATH}/datasets/${dataset_name}/${split}_texts.txt_feat.jsonl" \
    --top-k=10 \
    --eval-batch-size=32768 \
    --output="${DATAPATH}/datasets/${dataset_name}/${split}_predictions.jsonl"
产出的结果保存在指定的jsonl文件中,每行表示一个文本召回的top-k图片id,格式如下:
{"text_id": 153915, "image_ids": [5791244, 1009692167, 7454547004, 3564007203, 38130571, 2525270674, 2195419145, 2503091968, 4966265765, 3690431163]}
对于图到文检索(图片召回相关文本),类似地,请运行以下命令:
split=valid # 指定计算valid或test集特征
python -u cn_clip/eval/make_topk_predictions_tr.py \
    --image-feats="${DATAPATH}/datasets/${dataset_name}/${split}_imgs.img_feat.jsonl" \
    --text-feats="${DATAPATH}/datasets/${dataset_name}/${split}_texts.txt_feat.jsonl" \
    --top-k=10 \
    --eval-batch-size=32768 \
    --output="${DATAPATH}/datasets/${dataset_name}/${split}_tr_predictions.jsonl"
产出结果每行表示一个图片召回的top-k文本id,格式如下:
{"image_id": 977856234, "text_ids": [156914, 157914, 158914, 155914, 156179, 158907, 157179, 154179, 154914, 154723]}
Recall计算
我们提供了评测脚本计算检索任务的Recall@1/5/10,同时给出mean recall(Recall@1/5/10的平均数)。运行如下命令即可获取分数:
对于文到图检索,请运行命令:
split=valid # 指定计算valid或test集特征
python cn_clip/eval/evaluation.py \
    ${DATAPATH}/datasets/${dataset_name}/${split}_texts.jsonl \
    ${DATAPATH}/datasets/${dataset_name}/${split}_predictions.jsonl \
    output.json
cat output.json
对于图到文检索,请先运行下面的命令,将图文对标注的jsonl文件由文到图的格式转为图到文:
python cn_clip/eval/transform_ir_annotation_to_tr.py \
    --input ${DATAPATH}/datasets/${dataset_name}/${split}_texts.jsonl
完成后,请运行命令:
split=valid # 指定计算valid或test集特征
python cn_clip/eval/evaluation_tr.py \
    ${DATAPATH}/datasets/${dataset_name}/${split}_texts.tr.jsonl \
    ${DATAPATH}/datasets/${dataset_name}/${split}_tr_predictions.jsonl \
    output.json
cat output.json
打印出的结果格式将如下:
{"success": true, "score": 85.67, "scoreJson": {"score": 85.67, "mean_recall": 85.67, "r1": 71.2, "r5": 90.5, "r10": 95.3}}
关于整套跨模态检索的训练和测试流程,我们以MUGE检索数据集(多模态电商图文挑战赛)为例,也提供了一个包含上述全部流程并可运行的Jupyter Notebook(下载链接),欢迎大家上手实践。
零样本图像分类
本部分介绍如何使用Chinese-CLIP实现零样本图像分类,以零样本图像分类Benchmark ELEVATER中的数据集为例。ELEVATER是由多个知名的分类数据集(包括CIFAR-10、CIFAR-100、MNIST等)组成的评测集合,评测模型在这些数据集上的零样本效果。我们在实验中,给其中每个数据集准备了中文版本的prompt、类别标签连同原始图片,详见数据文档,用于测试Chinese-CLIP模型。更多关于该benchmark的详情请点击链接。大家也可以参考我们提供的流程,仿照在自己的中文分类数据集准备数据并进行测试。
准备工作
首先将数据按照如下格式进行准备。由于零样本图像分类仅需测试,因此只需要准备好测试集和预训练模型参数,按照如下目录结构,存放在用户指定的${DATAPATH}下:
${DATAPATH}
├── pretrained_weights/
└── datasets/
    └── ${dataset_name}/
        ├── label_cn.txt
        └── test/
	    ├── 000/ # label id,如label个数大于10,则将其向左补零到3位数保证字典序
	    │   ├── image_0003.jpg # 图片样本,命名无特殊要求
	    │   ├── image_0005.jpg
	    │   └── ...
	    ├── 001/
	    │   ├── image_0001.jpg
	    │   ├── image_0002.jpg
	    │   └── ...
	    └── 002/
	        ├── image_0003.jpg
	        ├── image_0005.jpg
	        └── ...
	    ...
测试集保证test文件夹内数据按照label对应的id进行划分,并保证id为字典序(10以上的多位数,需向左补零label.zfill(3), 如001,002等)。label_cn.txt为数据标签,每行一个标签名,如下所示:
手风琴
飞机
锚
...
每行的标签对应的label id为行号-1,如第1行的标签的id为0,第二行的标签的id为1。如果标签总数大于10,则统一向左补零到3位数,比如标签个数为100,标签id则为000-099。用户需为每个label id生成对应的文件夹,并将标注该label的样本放入其中。我们以ELEVATER中的CIFAR-100数据集为样例,请访问数据集🤗OFA-Sys/chinese-clip-eval或点击🤗链接下载处理好的数据。如果想尝试在其他ELEVATER包含的数据集上测试Chinese-CLIP,请参见我们的数据文档。
预测和评估
我们准备了预测脚本,请查看run_scripts/zeroshot_eval.sh。运行命令例子如下:
bash run_scripts/zeroshot_eval.sh 0 \
    ${DATAPATH} ${dataset_name} \
    ${vision_model} ${text_model} \
    ${ckpt_path} ${index_file}
其中各参数意义为:
- 第一个入参
0为GPU id DATAPATH参见上面的准备工作部分,根据实际位置输入对应路径dataset_name参见上面的准备工作部分,输入评测的数据集目录名,如cifar-100vision_model为指定模型类型,选项包括["ViT-B-32", "ViT-B-16", "ViT-L-14", "ViT-L-14-336", "RN50", "ViT-H-14"]text_model包括["RoBERTa-wwm-ext-base-chinese", "RoBERTa-wwm-ext-large-chinese", "RBT3-chinese"]ckpt_path为模型预训练ckpt的完整路径index_file(可选,仅提交ELEVATER官网评测需要指定),请参见数据文档
例如,用ViT-B/16规模预训练模型进行评测CIFAR-100,则运行(${DATAPATH}需根据实际情况替换):
bash run_scripts/zeroshot_eval.sh 0 \
    ${DATAPATH} cifar-100 \
    ViT-B-16 RoBERTa-wwm-ext-base-chinese \
    ${DATAPATH}/pretrained_weights/clip_cn_vit-b-16.pt
返回结果会打印top-1的准确率。
Result:
zeroshot-top1: 0.6444
在CIFAR-100上,ViT-B/16规模的Chinese-CLIP预期应该达到64.4%。我们在ELEVATER上其他规模、其他数据集的零样本分类结果,请详见Results.md。
同时,程序还会存下一个json文件用于提交ELEVATER官方用,json文件内容如下所示:
{"model_name": "CN-CLIP-ViT-B-16", "dataset_name": "cifar-100", "num_trainable_params": 0, "num_params": 188262913, "num_visual_params": 86192640, "num_backbone_params": 188262913, "n_shot": 0, "rnd_seeds": [123], "predictions": "prediction probability tensor [size: (1, 10000, 100)]"}
其中包括模型名model_name、数据集名称dataset_name、总参数量num_params、视觉塔的参数量num_visual_params等模型的meta信息,以及模型输出结果,即模型的预测概率tensor,size为[1, 样本数, 标签个数]。
零样本分类在线Demo
基于我们集成于Huggingface transformers的特征提取API,我们在Huggingface Model Hub🤗提供了在线简单尝试零样本图像分类的demo(Hosted inference API),各个模型规模的demo链接见下,欢迎尝试!
- OFA-Sys/chinese-clip-vit-base-patch16
- OFA-Sys/chinese-clip-vit-large-patch14
- OFA-Sys/chinese-clip-vit-large-patch14-336px
- OFA-Sys/chinese-clip-vit-huge-patch14
- (12.10日更新🔥)基于Huggingface Spaces部署的新版demo:demo页面同时包含上述4个模型规模可选,支持输入自定义prompt模板,欢迎试用
引用
如果觉得本项目好用,希望能给我们提个star并分享给身边的用户,欢迎给相关工作citation,感谢支持!
@article{chinese-clip,
  title={Chinese CLIP: Contrastive Vision-Language Pretraining in Chinese},
  author={Yang, An and Pan, Junshu and Lin, Junyang and Men, Rui and Zhang, Yichang and Zhou, Jingren and Zhou, Chang},
  journal={arXiv preprint arXiv:2211.01335},
  year={2022}
}