README 未给出安装步骤,需先查阅 wiki 文档确认部署依赖;部分大模型推理能力(如 openjourney、gpt3、SD 系列)标注需购买 aihub;旧仓库 tencentmusic/cube-studio 已不再同步更新,应使用当前仓库。
cube-studio
data-infra活跃维护开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
cubestudio开源云原生一站式机器学习/深度学习/大模型AI平台/MaaS/mlops/人工智能平台/训推平台,算法全链路流程,多租户,算力租赁平台,token中转,拖拉拽任务流pipeline编排,多机多卡分布式训练,超参搜索,推理服务,VGPU虚拟化,云边端协同,边缘计算,自动化标注平台,deepseek等大模型sft微调/奖励模型/强化学习训练,vllm/ollama/mindie大模型多机推理,私有知识库llmops智能体,AI模型市场,支持国产异构算力调度,昇腾/寒武纪/海光/摩尔/沐曦等,支持ib/roce/RDMA,信创支持
v2026.09.01发布于 2026-10-12 12:57 UTC2,604star +8 / 7 天224fork同步于 2026-11-10 11:43 UTC
README 未给出安装命令,部署方式见 https://github.com/data-infra/cube-studio/wiki 硬件要求按 README 说明
README 未说明具体显存要求;平台支持 T4/V100/A100 等英伟达卡型,并适配昇腾 NPU、海光 DCU、寒武纪、摩尔线程、沐曦、昆仑芯等国产算力,同时支持 x86/ARM CPU 架构。
支持 Apple Silicon昇腾 / Ascend
国产云原生一站式 AI 平台,覆盖从数据标注到训练、推理与大模型微调的全链路
开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
核心能力
- 拖拉拽 Pipeline 编排任务流,支持定时调度与补录
- 多机多卡分布式训练,支持超参搜索与 TensorBoard
- vLLM/Ollama/MindIE 大模型多机推理与统一网关
- vGPU 虚拟化与共享、独占多种 GPU 占用模式
- 适配昇腾、寒武纪、海光、沐曦等国产异构算力
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
- v2026.09.01最新正式版2026-10-12 · 2026-10-12 12:57 UTC
一、核心新特性
1. Agent 模式(全新)
- 新增 Agent 内核
myapp/utils/agent/:事件构造器、LLM 客户端工厂、Agent 循环(run_agent/run_agent_once)、Skill 加载器与 Skill 模板。 - 内置 Skill:知识库检索、SQLLab(ChatBI)、AIHub 应用调用、ECharts 绘图、文生图。
- 支持 NLP2Skill:自然语言自动路由到对应 Skill。
- 新增 Agent 配置模型与视图:CRUD + 多轮流式对话 SSE 端点;前端新增
ChatReact页面与流式渲染。 - 检索能力升级为 agentic 工具集(
search/read/list/find),支持 file/code 查询、多词 AND、正则匹配,并带 ReDoS 防护、软链逃逸防护、读取字节上限、目录越界校验。 - 会话偏好中不再下发密钥与 key;Agent 调用链路参数长度优化。
2. 知识库
- 新增
knowledge_file模型与知识库空间 / 索引 / 存储三层实现。 - 搜索结果由平铺改为目录树结构。
- 修复同义词搜索不准的问题。
- 支持一键优化索引。
- 支持 PDF 扫描件转 Markdown 入库。
- 联网搜索的搜索词同步显示。
3. Token 中转站与服务网关
- 新增 Token 中转站:
token_model(可售模型目录,管理员上架配价)、token_usage(按 用户 + 网关 + 秘钥 + 模型 聚合用量),配套前端ModelMarket/MyTokenKey/TokenModelManage页面。 - 服务网关支持 Claude Code。
- 外部服务同时支持 OpenAI 与 Anthropic 接口类型,可用模型列表包含外部服务。
- 上游 Anthropic 健康度探测。
- 用户自定义 OpenAI URL / Key 时,模型列表查询走用户自己的配置。
- 网关指标与显示优化、prompt 模板 bug 修复。
4. 计量计费与审批
- Token 租赁与扣费逻辑完整落地。
- 余额显示与扣款优化,支付配置项独立。
- 账单补充微信支付 / 支付宝第三方交易号。
- 修复每日按需计量账单状态;计量明细列宽优化。
- 新增
Approval审批页面、审批单通知,申请审核机制完善。
5. 异构算力与调度
- HAMi vGPU:修复卡数统计、新增
N*M乘法语法、统一 vGPU 资源解析;对接现有 HAMi 方法。 - 异构算力(含昇腾)租赁支持,新增 vLLM 昇腾示例;显存租赁值修正。
- 支持自定义
gpu=true机器标签。 - 修复 GPU 利用率弹性伸缩、不同优先级服务之间算力调节的 bug。
- 基础 GPU 镜像 CUDA 版本升级。
- LLaMA-Factory 升级到 CUDA 12.6 并支持单机多卡训练。
6. 数据与标注
- 自动化标注从 PaddleOCR 切换为多模态大模型标注:支持批量预测、并发优化、矩形框标准化、超参数传递、上传图片、在配置中指定模型地址与 Token;DeepSeek 默认模型切换为多模态模型。
- 新增示例:PDF 标注、无人机自动化标注与无人机训练任务流。
- 数据集支持配置训练集 / 测试集 / 评估集。
- 数据集详情页支持导入到个人目录。
- 离线库表新增连接串 + 列信息 + 只读数据预览(
MetadataPreview)。 - DataX 优化;异常值检测任务模板优化。
- 新增任务模板:
llama-factory、llm-distillation、llm-safety-eval、opencompass、yolo26。 - 大模型评估支持在线服务;模型蒸馏与数据蒸馏优化。
7. 平台与通用界面
- 通用增删改查界面:支持 page 模式新增 / 修改、子参数、"打开目录"参数类型、编辑字段自动进详情列、搜索框宽度修正。
- 模型支持上线 / 下线(
model.model_status)。 - 推理服务测试按钮合并进操作按钮。
- 新增
service_pipeline服务编排表,服务编排 / Pipeline 多项优化。 - Ollama 部署优化。
- 任务流所需资源评估优化;机器学习算法支持展平参数。
二、安全与稳定性
- 修复 XSS 漏洞(command 处理)。
- 修复后端固定前缀 bug;登录重定向改走后端接口。
- 用户密码复杂度限制、密码校验与加密优化、密钥字段脱敏。
- Pod 查看权限放开给管理员(原先仅创建者可见)。
- 消息管理开放给所有用户。
- 存储挂载前校验 CSI 驱动,缺失的集群跳过并汇总提示。
- 自定义命名空间逻辑优化。
- 达梦数据库对接优化、PostgreSQL 记录更新、Pika 兼容。
- 日志保留时间 10 天 → 30 天。
- 报错数据回滚、构建报警优化。
三、变更与移除
config.py/project.py移动到myapp/目录下。- Chat 模块 service 类型
openai改为chat。 - 移除旧版
chat-embedding。 - 移除 SparkJob 相关代码。
- 移除 AIHub 异步推理。
- 移除 mock 数据处理。
- Key / Value 变量简写为
k/v。 - 清理大量冗余代码与文档,压缩大图片。
四、升级注意事项
-
执行数据库迁移:
myapp db upgrade新迁移f7a3c1d9b2e4包含:- 新增表:
service_pipeline、token_model、token_usage、knowledge_file model表新增model_status(上线 / 下线状态,存量数据默认online)metadata_table新增 uri 列- chat 相关表新增
skills/max_steps列 - owner 列长度放宽
MySQL 旧
myapp/migrations/versions-mysql/迁移目录已清理。 - 新增表:
-
配置文件路径变更:
config.py/project.py已移动到myapp/目录下,部署时需同步调整MYAPP_CONFIG与挂载路径。 -
镜像升级到 20260901 版本:基础 GPU 镜像、LLaMA-Factory、LabelStudio、YOLO26 的 tag 均已更新。
-
Chat service 类型字段由
openai改为chat,存量数据需确认并迁移。
- 新增 Agent 内核
- v2026.06.012026-07-26 · 2026-07-26 05:27 UTC
查看更新说明
智能对话 & AI 助手
- 重构智能对话模块,从 Flask 模板迁移至 React 前端主体
- 智能对话支持联网搜索、知识库召回内容显示
- 支持文件上传对话、图片上传对话
- 智能对话支持卡片式交互展示
- 智能问答按钮支持拖动
- 对话界面支持配置化,支持设置 base URL 和 token
- 对话 models 接口对接,支持查询可用模型接口
- 支持搜索网页和召回文档的返回
- 智能对话支持中英文切换
- 优化 DeepSeek 返回 none 的问题
- 支持智能体问答配置
- 优化问答消息反馈机制
📊 数据分析 & 数据血缘
- 新增数据血缘功能:支持数据血缘链路追踪与可视化
- 新增数据大屏:前后端完整实现,支持展示顺序配置
- 数据计算分析支持模型注册和部署
- 数据计算分析支持导入导出
- 优化数据分析建模全流程
- 优化血缘链路展示
- 优化 EChart 任务可视化
🏷️ 标注平台(Label Studio)
- 支持标注平台对接训练流程
- 标注数据导入支持导出成 COCO、YOLO、YOLOv8_OBB 格式
- 支持时间序列标注示例
- 支持标注中打分功能
- Label Studio 支持 Cube 全量秘钥(不限前 40 位)
- 初始化标注平台 admin token 和 webhook
- 支持 webhook 触发运行
- 定时清理空白标注项目
- 修复标注平台初始化相关问题
🧠 模型训练 & 推理
训练
- 升级 LlamaFactory 任务模板,优化训练指标可视化
- 支持寒武纪 LlamaFactory 微调
- 支持寒武纪 vLLM 推理和训练
- 优化 Ray 超参搜索全流程
- 深度学习分布式多机多卡任务模板镜像合并
- 特征处理任务模板镜像合并与修复
- 增加 sklearn 任务模板
- 优化 R1 模型微调
推理 & 模型管理
- 新增 AIHub 异步推理
- 升级模型转化,支持转化到 ONNX、OpenVINO、NCNN、MNN、TFLite、RKNN、Engine、Lib
- 升级 YOLO26,支持 RTSP 多路视频流
- 增加大模型性能评估(OpenCompass 支持多数据集选择)
- 模型列表支持卡片式展示
- 优化 AIHub 流推理和注册
- 支持模型 MD5 校验
- 替换默认模型为 Qwen3.5
🌐 服务网关
- 新增安全围栏功能:支持输入输出安全检测、超参数设定
- 服务网关支持联网搜索
- 支持推理服务限流功能、IP 限流
- 增加 IP 黑白名单
- 支持获取客户端真实 IP(内网/公网)
- 服务网关支持外部 OpenAI 接口
- 增加服务网关昨日数据监控指标
- 优化安全围栏服务配置
🎨 前端体验
UI 风格
- 优化蓝色风格主题
- 支持多风格切换
- 增加左侧侧边栏
卡片式视图
- 数据集、Notebook、镜像、模型列表均支持卡片式显示
- 修复卡片式操作的批处理问题
国际化
- 新增阿拉伯语和葡萄牙语支持
- 支持多语言动态切换
- 优化中英文翻译
门户 & 导航
- 新增门户应用,支持 iframe 嵌入 Cube
- 全局跳转优化,尽量在原地跳转
- 优化首页「我的列表」
- 任务流实例界面支持横屏/竖屏展示
- 登录页文字描述优化
表单 & 交互
- 前端支持直接上传文件
- 支持 select2 参数类型、多选类型
- upload 参数类型兼容正则校验
- 支持模糊匹配名称搜索
- 优化搜索字段过滤
- 数据集导入、模型导入、标注导入支持对象选择
🔐 权限 & 安全
- 支持项目组审核员角色
- 优化任务的查看和添加权限
- 维表内容权限设定
- 暂停/恢复任务流增加权限限制
- 增加 Pod YAML 查看的权限限制
- 支持设置查询权限
- 控制管理员 link 的访问权限
- 优化认证,对内部组件放行
- 去除前端 cookie 校验
- 优化签名长度
- 接口调用时的权限控制优化
🏗️ 基础设施 & 平台
数据库
- 优化达梦数据库对接
- 优化 KingBase 数据库对接与部署
- 优化 PostgreSQL 数据库对接
- SQLLab 支持达梦、高斯数据库查询
缓存 & 中间件
- 支持 Redis 哨兵模式
- 支持 Pika 替代 Redis
部署 & 运维
- 优化边缘集群部署
- 升级到 Node 22 构建工具
- 升级任务模板中 Kubernetes 版本到 1.28
- 在线 IDE 支持 Claude Code 对接内网大模型
- 在线构建不修改原有 entrypoint 和 cmd
- 配置独立前端页面支持
- 支持多前端部署
- 前端静态文件不保留 Git,Logo 替换方案优化
- 优化 Dockerfile pip 包版本管理
- 支持备份目录
Pod & 容器管理
- Pod log 界面和 debug 界面切换为前端控制
- Pod 列表界面支持前后端分离
- 增加 Pod YAML、Event 可视化
- 优化 Pod 详情页显示
📋 任务 & 工作流
- 为 Workflow 增加 project_id 字段
- 固化任务流支持可选/可填参数
- 镜像构建、Notebook、任务、任务流、服务挂载支持
{{creator}}模板变量 - Python 任务模板支持长文本编写
- 镜像支持分类
- 增加动态规划和线性规划的示例
- 增加直接问答质量评价示例
- 增加 AI-Doc 部署
- 增加申请审批流
- 优化审批单流程
- 优化清理任务与空白任务流清理
- 资源额度限制的值支持小数
- 增加 max_exec_duration 属性
🐛 Bug 修复
- 修复任务流中任务打不开的 bug
- 修复 python 类型的任务保存 bug
- 修复 SQLLab 的 bug
- 修复上传按钮异常
- 修复跳转异常
- 修复滚动升级的 bug
- 修复组成员添加不能设置用户名的 bug
- 修复编排界面模板列表查询 bug
- 修正有效期报错
- 修正版本字段限制
📝 其他优化
- 去除数据 ETL 功能(模块精简)
- 去除非必要 Flask 模板
- 去除冗余前端代码
- 合并 job template 的两个路由
- 优化个人信息界面 UI
- 优化监控看板
- 优化任务模板帮助文档
- 优化参考网页和文献展示
- 优化 GitHub 登录流程
- 优化 TIKTOKEN_CACHE_DIR 缓存地址配置
- 换行符统一更新为 LF
- 优化代码书写格式
- v2026.03.012026-05-09 · 2026-05-09 06:15 UTC
查看更新说明
1) 智能对话与大模型能力增强
- 增加输入输出安全围栏、离线安全评估。
- 新增/增强链路:SFT 数据处理、Qwen TTS。
2) 多租户与权限治理
- 持续推进多租户支持(2月多次提交)。
- 增加只读
public角色与接口权限配置,后端权限控制优化。 - 单点登录增加 admin 登录方式。
- 项目组与资源组关系增强(单项目组可绑定多个资源组)。
3) 任务模板与训练/推理流水线
- 大量任务模板文档与帮助信息优化(“优化任务模板的帮助文档”高频)。
- 新增/升级模板:
sklearn、llamafactory,并支持大模型剪枝及 ChatGLM/Qwen 微调模板。 - 超参搜索(尤其 Ray)在 3 月集中优化。
- 增加
max_exec_duration、调度优先级、任务运行跳转体验等。
4) 基础设施与版本升级
- Kubernetes 默认/模板版本升级到
1.28,Python SDK 更新到28.1.0。 vgpu升级到2.8.0,volcano升级到v1.14.0。- 支持
triton-llm部署并优化部署方式。 - 升级 MindIE 镜像,优化数据库升级策略。
5) 数据库与国产化/硬件适配
- 支持达梦数据库初始化与建库,后续持续优化。
- 数据库类型、变量名、外键查询等多处修正。
- 增加百度昆仑芯与摩尔线程适配;YOLO 多目标跟踪 NPU 适配优化。
6) 前端与体验优化
- 首页、个人详情页、任务可视化、EChart 展示、下载/搜索交互等持续打磨。
- 修复多处前端与交互问题(冗余代码清理、状态刷新、弹窗 URL、子视图问题等)。
- v2026.01.012026-02-03 · 2026-02-03 13:58 UTC
查看更新说明
一、AIHub 功能与界面优化
- 优化 AIHub Markdown 显示问题
- AIHub 部署为推理服务类型离线场景问题修复
- AIHub 应用优化
- AIHub 文档优化
- AIHub Demo 支持 HTTPS 限制
- AIHub 数据处理任务模板增加
二、大模型与推理服务优化
- 大模型对话优化
- 大模型微调可选值优化
- 大模型可选值模型优化
- 推理服务优化
- 推理服务模型地址支持
{{creator}} - 去除 VLLM 的 AIHub
- 升级 LLaMAFactory 镜像版本及相关任务模板
- 升级 ML-Server 镜像版本
- 优化 ML-Server 推理服务部署
- 优化 Torch-Server 推理
- 去除不使用的大模型
- 去除部分过时模型
- QwQ-32B 更换为 Qwen3 模型
- 修复 Token 限制
三、服务网关与接口优化
- 服务网关优化(重复项合并)
- 服务网关支持代理 Embedding 接口
- 支持按照 Header 分流
- 支持通过环境变量设置是否禁用服务流量转发
四、部署与集群优化
- 优化部署
- 优化海光部署
- 优化 DCU 兼容
- 优化卸载脚本
- 优化多集群 K8s 客户端线程安全问题
- 修复 K8s 客户端使用线程安全后 Watch 组件的 Bug
- 接口中增加 Pod IP
- 支持摩尔线程
- 升级到 20260101 版本
- 升级新版本
- Argo 镜像使用内网镜像
- 修正 Redis 镜像地址
- 修复部分连线不可用的情况
五、文档与注释优化
- 优化文档
- 优化注释
- 修正文档
- 增加示例合集
- 优化示例
- 增加加解密注释
- 增加初始化任务
- 增加任务模板加密启动
- 去除冗余代码
六、安全与权限优化
- 优化加密
- 添加 OAuth2 认证
- 在线 IDE SSH 增加防暴力破解
- 优化 SSH 代理
- 去除泛域名 SSH 代理
- 普通用户不能添加其他人进组
- 数据集下载权限控制
- 优化权限问题
- 固化任务模板不可修改
- 安全响应添加
七、监控与性能优化
- 优化 LLM 指标监控
- 增加 TPS、E2E、首 Token 时延、单 Token 平均时延(ms)
- 优化整体资源自动使用缓存
- 优化监控
- 优化 Pod 子状态
- 处理 Gevent 模型性能
- 优化定时清理测试服务状态
- 优化 Watch 监控
八、任务模板与自动化标注
- 优化任务模板描述
- 增加图片质量评估任务模板
- 优化 NLP 数据处理任务模板
- 增加 PaddleOCR-VL 任务模板
- 增加万物识别自动化标注
- 增加图片转文档的自动化标注
- 优化自动化标注
- 优化 PaddleOCR-VL 自动化标注
- 优化 PaddleOCR-VL AIHub 应用
- 增加 PaddleOCR-VL 内容提取任务模板
- 增加 PaddleOCR AIHub 应用
- 万物识别自动化标注支持 XML 设置可信参数门限
- 增加结构化数据标注能力
- 增加结构化数据标注示例
- 支持大模型万物边界线和遮罩识别
- 添加 Dino 和 Dino-SAM 万物分隔模型
- 修正万物分隔 GPU 占用
九、数据处理与 NLP 能力
- 优化数据处理,增加 NLP 数据分析、问答对抽取、问答对扩展等
- 增加 NLP 数据分析能力
- 优化判断文件格式的代码
十、开发环境与工具优化
- VS Code 支持默认中文
- 优化 VS Code 汉化
- 升级 Jupyter 镜像,支持汉化
- 升级 Jupyter 镜像,支持汉化(重复项合并)
- Grafana 默认中文简体(重复项合并)
- Notebook 默认不显示续期
- Notebook Stop 同时关闭 Commit 的 Pod
- RStudio 首页跳转 Bug 修复(重复项合并)
十一、数据库与记录优化
- 优化数据库记录
- 优化部署数据库写入可能出错的地方
- 记录保存成功的时间
- 记录 Save 成功时间
- 修正某些类型数据库 Skip 是关键字的问题
十二、配置与初始化优化
- 优化初始化
- 优化默认值
- 修改初始化示例
- 任务模板添加初始化
TASK_RESOURCE_RDMA=0环境变量 - 优化任务过期时间配置
- 优化报警描述
- 优化模板描述
十三、其他修复与优化
- 修复文字 Bug
- 优化报错打印
- 去除非必要文件
- 优化端口暴露
- 优化模拟数据
- 去除 NXTime
- 优化 AIPod 标签
- 修正域名下的虚拟服务配置
- 优化标注初始化
- 修正推送给管理员的消息记录
- 优化 MindFormer 镜像版本
- 优化 MindIE 模型的发布功能
- 增加 MindIE Qwen 推理
- 修正 Argo 镜像使用内网的镜像
- 支持增加模拟数据
- v2025.09.012025-10-27 · 2025-10-27 12:41 UTC
查看更新说明
一、 核心功能与模块优化
-
模型训练与推理框架支持
- 优化mindie模型的发布功能
- 模型推理类型支持mindie
- 增加mindie qwen推理
- 优化mindie推理
- 支持mindie分布式
- mindie多机推理 host模式,特权模式
- 修正ollama部署时api访问模型名的问题
- 修正大模型推理的启动命令
- 优化mindie模型的发布功能
- 优化llamafactory 分布式训练
- 增加llamafactory分布式示例
- 升级llama factory 支持多模态大模型训练
- 升级gpt5
- 支持vllm推理框架
- 丰富模型量化支持“gptq","awq","gguf","hf_quantize”
- 添加模型蒸馏任务模板
- 支持模型转换任务模板
- 增加opencompass模型评估
- 优化opencompass任务模板
- 优化llm评估
-
任务模板与Pipeline
- 修复union-join-data 任务模板
- 修复mpi的任务模板
- 修复任务模板的复制功能
- 优化任务模板构建
- 优化分布式pytorch任务模板
- 任务参数支持可选可填参数类型
- 任务模板参数支持正则表达式
- 任务调试时的资源值为用户填写资源值而不使用任务模板环境变量
- 在任务模板中优化分布式任务的挂载
- 特征处理和机器学习算法任务模板合并在一起
- 合并机器学习模板和特征处理模板
- 完善sklearn的任务模板
- 增加汇总sklearn的任务模板
- 修正pipeline编辑没有修改项目组的问题
-
AIHub应用与Demo
- 优化aihub示例
- 优化aihub 推理参数 必要性
- 优化用户自定义aihub项目组时aihub demo的问题
- aihub应用要能直接打开jupyter界面
- 修复aihub应用 页面 管理服务按钮链接
- 去除不使用的大模型
- 去除部分过时的模型
- 去除chatglm任务模板
- 去除open webui
- 去除不使用的大模型
- 去除部分过时的模型
- 去除aihub非必要代码
- 去除视频人体分隔的aihub
- 优化模拟数据
- 支持增加模拟数据
-
Notebook / 在线IDE
- jupyter ssh 端口统一为22
- notebook支持绑定机器和非在线ide模式打开
- notebook开放端口缩小为2个
- notebook可以直接打开输入框中输入的目录
- 修复 任务模板 打开目录直接显示文本文件
- 优化notebook保存功能
- 优化notebook保存报错提醒
- 优化notebook pod 健康检查
- 对于没有部署的notebook 不进行状态查询
- 增加去除conda版本的在线ide
- 默认不启动matlab ide
- 修复在线vscode 远程ssh没有启动的问题
- 兼容旧版本vscode
- notebook, pipeline, service, inference支持nfs挂载配置
二、 部署与基础设施
-
多集群与资源管理
- k8s 看板 监控支持多集群
- 机器资源,pod运行,整体资源 信息接口暴露
- 优化整体资源
- 优化整体资源的显示问题
- 整体资源支持模拟数据
- 整体资源 pod 资源占用量 没有request的时候就用limit
- 优化整体资源的加载速度
- 支持节点批量删除
- 支持不同集群单独指定K8S_NETWORK_MODE等参数
- 修复多集群部署时缓存冲突的问题
- 修复多集群时的缓存问题
- 镜像构建和aihub支持多集群
- notebook 多集群创建时 没有项目组信息
- 支持边缘集群模式部署
-
监控、日志与清理
- 优化watch监控
- 优化监控
- 升级监听记录
- 升级grafana看板 支持containerd的运行时
- 减少日志打印
- 去除aihub的pysnooper.snoop打印
- 优化清理
- 优化限额配置和清理不正常的服务
- 优化定时清理notebook的bug
- 添加定制清理 历史log和workflow runhistory等记录
- 修复监听不到外界kill pod的信号
- prometheus查询设置timeout
-
Pod与容器管理
- 优化deployment查询
- 优化pod查询
- 优化pod子状态
- 优化pod标签
- 优化k8s查询
- 修复查询终止pod cache bug
- 还没有通过健康检查的状态为Starting
- 接口中增加pod_ip
- 分布式任务-1 gpu占用模式,需要特权
- 修正aihubpod的标签
-
镜像与构建
- 优化docker打包
- 优化dockerfile
- 优化dockerfile 多架构构建时架构默认值的问题
- 优化docker build构建
- 支持dockerfile在线构建能力
- 控制镜像构建权限
- 修正镜像管理中在线构建的注释
- 构建加密镜像方法
- 禁用用户自己填的镜像名
- 修正mindformer的镜像版本
- 优化yolo镜像
- 升级新的yolov8镜像版本
- 添加npu pytorch镜像
- argo镜像使用内网的镜像
三、 安全、权限与认证
-
认证与权限控制
- 添加oauth2认证
- jwt公钥私钥存储
- 优化权限问题
- 优化pod 界面访问权限控制
- 普通用户不能添加其他人进组
- 创建pod支持设置权限
- 数据集下载权限控制
- 标注平台用户token设定和api访问
- mnt dataset等软链的静态文件,都需要通过用户认证
- 对于跨集群的话,cookie认证就可以去掉
-
安全加固
- 在线ide ssh增加防暴力破解
- 优化加密
- 去除泛域名ssh代理
- 优化ssh代理
- 优化xss禁用
- 去除非必要前端
- 去除冗余代码,添加安全响应
- 去除非必要脚本
- 限制批量上传的文件格式
- 修复登录跳转漏洞
- 删除401报错
- yolo视频跟踪aihub 支持npu
- yolov8 安全验证修复
四、 用户体验与界面
-
界面优化与交互
- 优化flash自动消失
- 优化列表字段宽度
- 优化显示宽度
- 优化显示
- 详情展示更多字段
- 优化中英文
- 优化中英文翻译
- 优化配置描述
- 优化帮助地址使用配置文件
- 修正中文错别字
- 修复文字bug
- 优化弹窗样式和自动刷新
- 修复弹窗markdonw渲染 code 黑色背景
- 测试按钮设置为右边漂浮
- 修复测试按钮显示问题
- 不使用自动刷新。
- 泛域名可点击状态显示
- 优化外键关联时的空白问题
- 优化pod list界面
- 新增pod list界面
- 优化json类型,不自动格式化
-
路由与代理
- 优化路由
- 优化https时的跳转
- 优化登录重定向
- 修复rstudio首页跳转bug
- 修正域名下的虚拟服务配置
- 内外网域名的代理
- 支持ssh 通过泛域名中转
- 修复ingress的bug
- expose批量替换为expose_api
五、 硬件与国产化支持
-
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。
不再同步更新旧仓库 tencentmusic/cube-studio
CubeStudio
CubeStudio 是一款国产化、云原生的一站式开源人工智能平台,同时覆盖传统机器学习、深度学习与大模型全链路(MLOps / MaaS / 算力调度 / 训推平台),开源协议 MIT,开源免费商用,开源版本已有数千家企业私有化部署。平台提供多租户与算力纳管调度、算力租赁与 Token 中转站、拖拉拽 Pipeline 任务流编排、多机多卡分布式训练、超参搜索、推理服务、vGPU 虚拟化、云边端协同与边缘计算、图文音多模态自动化标注、大模型 SFT 微调 / 奖励模型 / 强化学习训练、vLLM / Ollama / MindIE 大模型多机推理、私有知识库 / LLMOps / 智能体、AI 模型市场,以及从数据到上线的全流程模型部署。原生适配昇腾、寒武纪、海光、摩尔线程、沐曦等国产异构算力与 x86 / ARM CPU 架构,支持 IB / RoCE / RDMA 高速网络及信创私有化、内网离线部署。
帮助文档
https://github.com/data-infra/cube-studio/wiki
开源共建
学习、部署、体验、开源建设、商业合作 欢迎来撩。或添加微信luanpeng1234,备注<开源建设>
整体架构

功能清单
| 模块分组 | 功能 | 功能描述 |
|---|---|---|
| 用户权限 | SSO单点登录 | 账号密码注册自动登录支持对接公司账号体系AUTH_OID/AUTH_LDAP/AUTH_REMOTE_USER等登录注册方式,支持消息推送增加登录验证,强密码,远程用户,登录频率限制,密码密文传输显示等 |
| 用户权限 | 项目组管理 | AI平台需要通过项目划分,支持配置相应项目组用户的权限,任务/服务的挂载,资源组,集群,服务代理,项目组内角色控制,支持用户和项目组删除,支持为项目组指定命名空间,项目组支持绑定多个资源组,支持设置组内用户可用资源组 |
| 用户权限 | 用户管理角色管理/权限管理 | 管理平台用户的基本信息,组织架构,支持账号密码,rbac权限体系增加修改和删除,清理等操作的历史记录,支持菜单权限控制支持只读者public角色,支持控制角色可访问接口,以及接口访问类型支持多租户(多个用户公司) |
| 算力调度 | 数据大屏 | 支持全局,项目组,个人级别的任务pod的分布情况 |
| 算力调度 | 多资源组/多集群 | 支持划分多资源组,支持docker运行时,支持多k8s集群,支持ipvs网络模式,支持containerd容器运行态,支持边缘集群模式 |
| 算力调度 | gpu调度能力 | 提供多种规格的资源支持不同的使用场景,cpu/gpu等 支持T4/V100/A100等多种卡型支持gpu禁用模型,共享模式,独占模式,vgpu模式,支持虚拟化占用显存设定,英伟达支持指定卡序号,支持gpu调度binpack调度策略,支持ib/roce的rdma协议 |
| 算力调度 | 支持多种算力 | 平台底层外部组件支持arm架构,前后端镜像支持arm架构,任务模板支持arm架构,notebook镜像支持arm架构,超参搜索支持arm架构,aihub应用70%支持arm架构支持调度海光dcu,华为npu算力,壁仞,沐曦、寒武纪、摩尔线程,百度昆仑芯 |
| 算力调度 | 算力市场 | 支持算力市场机器空闲状态查看,支持按需占用,和包月包日模式租赁 |
| 算力调度 | 租赁实例 | 支持租赁启动pod实例管理,开关机释放等,支持查看当前租赁信息和使用费用ssh登录信息等支持包月账单的管理 |
| 算力调度 | 计量计费功能 | 1、支持平台资源限制的分配和查看项目组资源限制,用户资源限制、任务资源限制,项目组下个人的资源限制,包括开发资源,训练资源、推理资源等额度限制限制在notebook,docker构建,pipeline,超参搜索,内部服务,推理服务中的生效限制支持单任务,并行任务总和和历史任务总和等方法2、提供统一的开发、训练、推理服务资源监控,从用户、项目、任务角度分析模型资源分配及使用情况3、支持自定义计费模式,通过计量结果自定义获取计费值4、按需占用日结账单,产生用户每日账单费用和明细 |
| 算力调度 | 机器资源管理 | web界面控制机器调度类型,所属资源组,是否启动rdma,是否启动vgpu,可用任务场景等 |
| 算力调度 | 存储盘管理 | 支持web界面添加存储盘,支持项目组绑定,notebook pipeline 推理服务,直接在pod中挂载外部分布式存储支持nfs,cfs,oss,nas,cos,glusterfs,cephfs,s3/minio |
| 基础能力 | 网络 | 支持80、非80端口,支持公网/域名,支持反向代理和内网穿透方式访问,支持https |
| 基础能力 | 数据库存储 | 支持外部mysql/postgres/OceanBase/人大金仓/达梦作为元数据库(不含标注模块) |
| 基础能力 | 国际化能力 | mlops支持配置多语言配置,目前支持8国语言翻译 |
| 数据管理 | 数据地图 | 元数据库表管理,指标,维表 |
| 数据管理 | 数据计算 | sqllab交互查询,支持mysql,postgresql,clickhouse,hive,presto,达梦数据库等计算引擎,支持数据分析建模 |
| 数据管理 | 数据集管理 | 允许用户随时上传样本集(图片、音频、文本等),对表格数据支持数据集一键探索功能 |
| 数据标注 | 数据标注 | 支持图/文/音/多模态各类型标注能力支持分布式存储打通mlops平台支持项目组权限控制,支持普通用户标注草稿,审核员核定,标注质量打分,导入导出批量删除设置等区分角色的权限控制标注任务分配目前支持8国语言翻译labelstudio标注数据导入pipeline支持从数据集模块导入和导出到数据集模块支持pg/人大金仓数据库支持项目状态管理和webhook |
| 数据标注 | 数据标注 | 支持自动化标注:支持目标识别,目标边界识别,目标遮罩识别,图片分类,图片描述,ocr,支持图片转markdown,关键点检测,视频多目标跟踪,多说话人语音分隔,语音识别,结构化数据标注支持视觉大模型自动化标注:支持目标识别万物识别,支持目标边界检测万物分隔,支持目标遮罩万物分隔支持大模型自动化标注:文本分类,文本翻译,命名实体识别,阅读理解,问答,摘要提取,答案排序 |
| 在线开发 | 镜像功能 | 镜像仓库/镜像管理/在线构建镜像同时提供平台所有镜像,包括模板镜像/服务镜像/notebook镜像/gpu基础环境的构建方法和构建后镜像,支持同一仓库多个秘钥配置,支持在线镜像构建 |
| 在线开发 | notebook | 支持基于开源的Jupyterlab/vscode汉化版,提供在线的交互式开发调试工具提供多种可选环境ide和开发示例,支持资源类型选择支持大数据版本,机器学习版本,深度学习版本大数据版本支持用户信息,hdfs客户端,hive客户端和spark客户端支持ssh remote与notebook对接远程开发,方便快速将本地代码提交到平台的训练环境ssh jumpproxy,单端口开放支持gpu,cpu,内存,监控,支持git交互支持自定义notebook镜像,便于封装公司自己的notebook多环境notebook,支持R语言/julia语言/python2.7/python3.6/python3.7/python3.8/python3.9/python3.10环境和cube-studio专有环境在线ide支持claude code对接内网或国内模型支持tensorboard任务可视化notebook支持环境镜像保存jupyter支持密码保护notebook支持整卡占用,虚拟卡占用,gpu共享占用notebook支持指定调度机器支持华为npu算力的在线jupyter开发支持海光dcu算力的在线jupyter开发支持沐曦算力的在线jupyter开发支持notebook启动自动初始化支持notebook自动清理,续期 |
| 模型训练 | 拖拉拽任务流编排调试 | 提供拖拽式交互开发环境,支持开发者以拖拽的方式完成业务逻辑的PIPLINE支持单任务调试,训练支持多种资源规格(CPU、GPU等),支持卡型的选择,超时重试等,任务支持独占和共享占用gpu分布式任务模板支持单任务调试用户镜像而非模板镜像支持rdma资源占用支持gpu不同厂商,不同卡型的占用分布式任务模板支持gpu型号透传,rdma资源透传,拉取秘钥透传pipeline调试,支持定时调度,补录,并发限制,超时,实例依赖等,任务管理,workflow实例管理,资源监控,支持任务输入输出,任务流全局常量,文本/图片/csv/json/表格/echart结果可视化,支持workflow暂停和恢复支持单任务和pipeline运行中任务监听端口提供运行中服务监听能力定时调度支持最大保留实例数pipeline支持任务流优先级 |
| 模型训练 | 主流功能算子 | 基础算子:自定义镜像,逻辑节点,python数据同步:数据集导入(支持huggingface/魔塔数据集),datax,datax-import,模型导入(支持huggingface/魔塔模型),datax-import支持mysql,postgresql,clickhouse |
| 模型训练 | 主流功能算子 | 特征处理:-数据合并,包含union、join操作-去除重复样本-数据变换,包括boxcox转换、二值化、数据类型转换、dct变换、根据函数转换、ma移动平均、多项式展开-非数值型变量处理,包括hash、根据统计量转换、one-hot-异常值检测-获取变量的统计量-去除值过于单一的变量-删除缺失率过高的值-删除缺失率过高的值-填充缺失值-数据离散化,等宽、等频、聚类离散化-标准化、正则化、归一化,有最大绝对值归一化、最大最小归一化、z_score标准化-索引处理,包含增加索引、索引转列、列索引重命名-排序-执行sql-hadamard乘积-特征组合,用于衍生特征-降维,包括pca降维和卡方降维-特征重要性,通过随机森林、逻辑回归、xgboost等模型计算特征重要性,可计算特征的iv值、互信息值、方差等-特征向量间的相关性计算-数据拆分,包括列内拆分、列间拆分、行间拆分、svd奇异值分解-采样,包括随机采样、分层采样、过采样、欠采样 |
| 模型训练 | 主流功能算子 | 数据处理工具:volcanojob/ray分布式数据处理,hadoop模板支持hadfs,hive命令,spark命令文本数据处理:paddleocr-vl pdf/doc/图片等提取为markdown,markdown提取问答对,问答扩展,清理异常数据,过滤数据,替换隐私数据,文本数据统计图像数据处理:图片质量评估、图片去噪声,图片缩放,图片标准化,图片裁剪,图片均衡化,图片的空间转换,图片变换(旋转,平移,缩放,翻转视频处理:分布式媒体下载,视频提取图片,视频提取图片 |
| 模型训练 | 主流功能算子 | 传统机器学习:sklearn单机,ray-sklearn分布式,xgb单机训练推理传统机器学习算法:ar/arima时间序列算法/random-forest/random-forest-regression/lr/lightgbm/knn/kmeans/gbdt/decision-tree//pca/lda/catboost/xgb,超参搜索 |
| 模型训练 | 主流功能算子 | 分布式深度学习框架:tf/pytorch |
| 模型训练 | 主流功能算子 | 模型处理:模型评估,模型格式转换模型服务化:模型注册,模型离线处理,模型部署 |
| 模型训练 | 算子自定义 | 支持算子自定义,通过web界面操作将自定义算法代码镜像,注册为可被他人复用的pipeline算子,自定义任务模板额外支持int型,float型,list型,bool型,json型,子类型支持workdir类型,image类型,select-input,select2,project类型,支持参数tip提醒 |
| 模型训练 | 链路共享 | 面向非AI背景的用户提供自动学习服务,用户选择某一个场景之后,上传训练数据即可自动开始训练和模型部署,支持示例pipeline任务流导入导出 |
| 模型训练 | 自定义镜像 | 面向高级 AI 开发者,提供自定义训练作业(执行环境 + 代码)功能 |
| 模型训练 | 自动调参 | 基于单机/分布式自动超参搜索 |
| 模型训练 | TensorBoard作业 | 实时/离线观察模型训练过程中的参数和指标变化情况 |
| 模型管理推理服务 | 内部服务 | 支持开发或运维工具快捷部署,提供mysql-web,postgresql web,mobgo web, redis web,neo4j,rstudio等开源工具,支持ollama,xinference大模型推理 |
| 模型管理推理服务 | 模型管理 | 模型管理用于对模型多版本管理,支持模型发布为推理服务,支持模型指标可视化 |
| 模型管理推理服务 | 推理服务 | 支持ml/tf/pytorch/tentortrt/onnx常规模型的多版本的0代码发布支持gpu卡型选择,支持vgpu,独占,共享占用,支持cpu/mem/gpu等弹性伸缩,支持服务优先级,支持随机分流和header分流,限流,流量复制,sidecar配置,支持泛域名配置,支持配置文件挂载,启动目录/命令/环境变量/端口/指标/健康检查等支持调试环境/生产环境支持域名/ip代理多种形式支持服务负载指标监控支持多版本服务滚动升级和回滚支持远程模型路径提供ml/tf/pytorch/tentortrt/onnx常规模型推理服务镜像支持用户自定义模型推理镜像支持定时伸缩容支持配置服务的jwt认证功能支持推理服务在线测试 |
| 监控 | 整体资源 | 所有集群,所有计算机器的使用情况,包括机器的所属集群,所属资源组,机器ip,cpu/gpu类型和卡型,当前cpu/内存/gpu的使用率所有集群,所有计算pod的使用情况,包括pod所属集群,所属资源组,所属命名空间,调度ip,pod名称,启动用户,cpu,gpu,内存的申请使用率整体资源页面,支持管理员批量删除 |
| 监控 | 监控体系 | 所有机器的gpu资源的使用情况,所有机器的内存/cpu/网络io/磁盘io的负载情况,所有pod的内存/cpu/gpu/网络io负载情况所有推理服务的内存/cpu/gpu/qps/吞吐/vgpu负载情况支持ib流量监控支持首页消息提醒,支持企业微信,钉钉,飞书群聊消息推送消息报警记录,统一webhook接口npu监控 |
| AIHUB | 应用sdk | 提供CubeStudio sdk,提供模型开发规范和使用规范 |
| AIHUB | 应用sdk | 提供web端模型应用体验,支持api推理 |
| AIHUB | 应用sdk | 提供开发多个python cuda版本的基础镜像 |
| AIHUB | 预训练模型 | 提供视觉,听觉,nlp,多模态等400+预训练模型,提供预训练模型的模型加载和推理能力,可直接一键部署服务,并提供api |
| AIHUB | 模型市场 | aihub应用对接CubeStudio平台进行卡片式展示 |
| AIHUB | 模型一键开发 | 提供一键转notebook开发,提供符合当前模型所需环境的jupyter |
| AIHUB | 模型一键微调 | 支持一键转pipeline微调链路,包括示例数据集下载,微调,模型注册,模型部署,支持微调后模型部署 |
| AIHUB | 模型一键部署web | 提供模型一键部署提供手机端和pc端web界面和api,和demo示例弹窗演示,支持部署成推理服务 |
| AIHUB | 模型自动化标注 | 支持部署对接labelstudio自动化标注 |
| AIHUB | pipeline对接aihub | aihub注册算子,可以将代码目录注册成aihub市场应用aihub调用算子,可以调用aihub的应用 做数据处理 |
| 大模型 | 大模型分布式多机多卡 | 分布式多机多卡训练和加速框架:mpi/colossalai/deepspeed/horovod/megatron/mindformer/mxnet/paddlejob/mindspore分布式训练 |
| 大模型 | 支持大模型推理aihub形式 | (需购买aihub):支持openjourney/gpt3/yuan/sd-v2/sd-v1.5/Stable Cascade/Stable Diffusion XL/部署 |
| 大模型 | 支持大模型推理 | 支持vllm大模型推理,支持推理加速+流式openai接口支持分布式多机多卡vllm大模型推理deepseek,qwen2,chatglm4等模型推理示例支持llm大模型服务对话测试支持mindie昇腾大模型推理服务 支持 910b和310p算力支持mindie分布式推理支持昇腾/海光/沐曦/寒武纪/摩尔线程/昆仑芯适配的大模型推理支持大模型网关,支持统一入口,秘钥设定,qps/tps限速,黑白名单,token限额,有效期设定,多类型秘钥认证,重试,提示词模板,参数值映射,参数值固化,流量监控:qps、失败率/tps/输入token量/输出token量/e2e/ttft/tpos指标监控 |
| 大模型 | 支持大模型微调 | 支持deepseek/chatglm4/qwen2/llama3 lora微调, mindformers微调模型,支持llama-factory 大模型sft/奖励模型/强化学习,支持npu适配的llama-factory,支持dcu适配llama-factory,支持沐曦适配llama-factory |
| 大模型 | 支持大模型量化评估剪枝 | 支持大模型量化功能,支持opencompass大模型评估,支持大模型剪枝 |
| 大模型 | 智能对话 | 提供支持多场景对话,支持责任人权限,提示词模板构建,推理接口配置,llm问答,tips等设置 |
| 大模型 | 智能对话 | 支持清空,修改问题,删除问答对,答案重试,反馈,上传图片多模态问答,切换模型,修改系统提示词,用户提示词模板,修改对话超参数、多窗口对话等,支持问答复制,代码答案下载支持展示检索知识库记录支持安全问答检测 |
| 大模型 | 智能对话 | 支持aihub应用接口模式 |
技术背景
传统算法落地流程:从申请机器,配置环境,拉取数据,处理数据,算法训练,调试,模型测试,服务化上线全流程,算法工程师在上面的每个环节都浪费了很多时间,而不是把精力主要集中在算法模型的构建上。

如上图所示,工程师在数据、开发、训练、部署各环节被迫处理大量非算法本质的问题:
- 外环(重复性工程环节):申请算力(CPU/GPU 机器利用率低、存储持续增长)、环境准备(环境人手一份、框架版本各自为战)、代码开发(代码与机器强绑定)、任务调试(GPU 利用率分布不均、CPU/GPU 需求永远不够)、定时调度(监控靠 crontab)、任务编排(协同靠语言交流、数据流转靠分散 COS 存储)、推理上线(工程化现学现卖、利用率峰值阻塞)、A/B 实验(流量分流 + 复制)。
- 工程化问题:① 资源算力问题——算力资源无法复用、资源抢占时资源浪费、资源整体利用率低;② 工作内容定时重复——模型变动少、只是周期数据更新;③ 框架多样、版本多样——TF、PyTorch、XGB 等各类框架及版本混杂。
- 技术性问题:④ 训练耗时问题——数据量大、训练非常耗时,训练模型大,单机无法承载,模型更新速度慢;⑤ 超参搜索问题——无法多机并行化,脚本运行时间长;⑥ 模型服务化——模型服务化的负载均衡与伸缩、GPU 服务资源无法隔离、资源浪费。
cubestudio 一站式的机器学习平台,正是从平台架构上系统性地解决上述工程化与技术性问题,做了一系列更贴近用户实用化的考虑。
行业现状

现状:
- 数据智能化 + 大模型带来 AI 平台刚性需求,AI 已成为数字经济时代的核心生产力。
- 智能化转型仍处早期,一般解决方案不具备 AI 平台能力。
- 出于数据安全与算力成本考虑,数据和算力都不想上云。
难点:
- 专业门槛高、多学科交叉,人才稀缺、人才培养周期长。
- 投入产出比不明朗,资金投入大而回报不清晰。
- 应用被"内卷"式重复建设裹挟,难以找到适合自己的落脚点。
自主可控:
- 代码自主可控,可自主改造定制,满足 To B 交付的定制需求。
- 支持私有化部署,平台与算法私有化交付。
- 算力可控,支持异构国产 GPU/NPU 等,满足信创要求,不受国外政策影响。
产品定位

平台定位:如上图所示,cubestudio 位于"大数据平台"与"智能体开发平台"之间,作为一站式 AI / MLOps / 训推 / MaaS 平台承上启下,向上承接大数据平台的数据资产,向下输出到智能体开发平台,贯通数据清洗、标注、在线开发、训练、评估、推理发布、算力调度全链路。
- 容器云底座:支持 Kubernetes、Rancher、KubeSphere、KubeEdge、K3S、TKEStack 等多种容器云环境。
- 异构算力:可运行于超算 / 云算力 / IDC 内网 / 一体机、虚拟机、物理机之上,纳管 NVIDIA、AMD、昇腾(Ascend)、寒武纪(Cambricon)、海光(HYGON)、摩尔线程、沐曦(METAX)等国产及主流异构算力。

cube-studio 是开源的云原生一站式机器学习 / 深度学习 / 大模型 AI 平台,核心能力包括:
- SSO 登录,多租户 / 多项目组,大数据平台对接
- 标注平台自动化标注、数据集管理
- Notebook 在线开发,拖拉拽任务流 Pipeline 编排
- 多机多卡分布式算法训练、超参搜索,大模型 SFT / 奖励模型 / 强化学习训练
- 推理服务 VGPU、大模型服务网关、弹性伸缩、负载均衡、资源负载监控
- AI 应用商店、智能体应用、私有知识库
- 私有化部署,多集群调度、边缘计算、支持异构国产 CPU/GPU/NPU 芯片,支持 RDMA
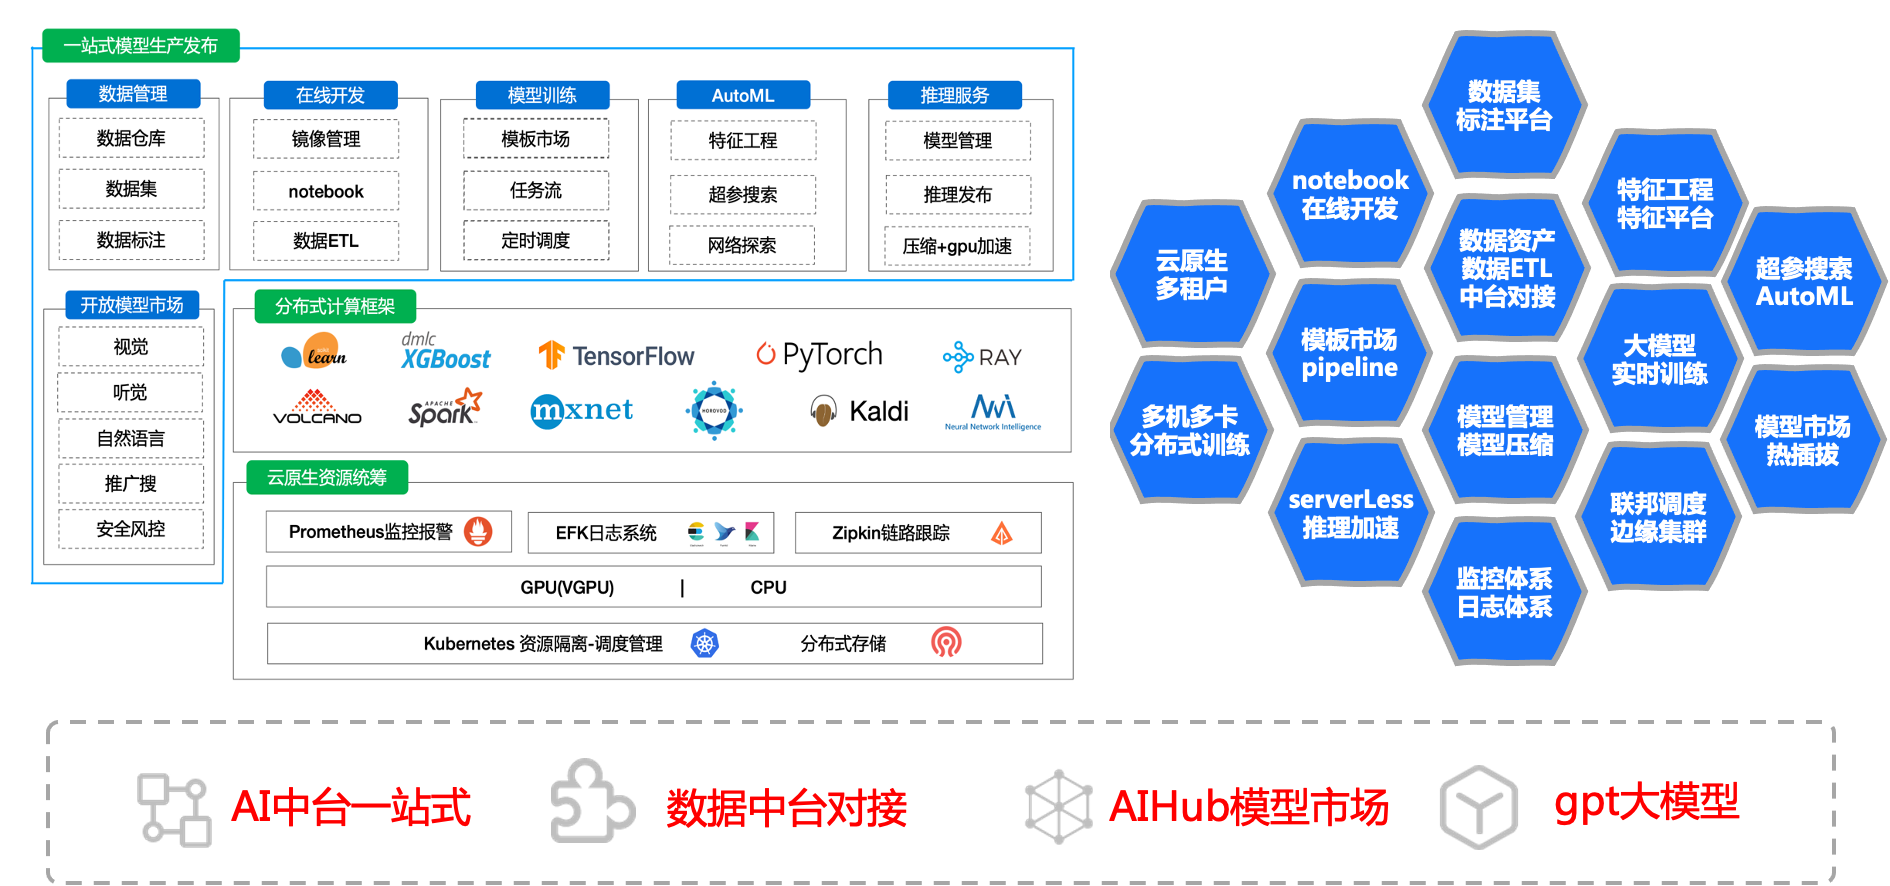
产品技术架构

一站式 MLOps 平台,自底向上分层(对应上图左侧):
- 底座:Kubernetes 算力调度(amd64 / arm64 / VGPU / RDMA)+ 分布式存储。
- 云原生异构算力调度:纳管 NVIDIA、AMD、昇腾、寒武纪、海光、摩尔线程、沐曦等异构算力。
- 分布式计算框架:内置 scikit-learn、TensorFlow、PyTorch、Ray、Spark、飞桨、Volcano、DeepSpeed、Colossal-AI、Horovod、MindSpeed、MindSpore 等。
- 算力纳管:用户角色、计量计费、算力租赁。
- 数据资产:SQL 计算、数据集、标注平台。
- 在线开发:镜像开发、Notebook、特征 ETL。
- 模型训练:模板市场、任务流编排、多机多卡。
- 推理服务:模型管理、推理发布、服务网关。
- 智能体:模型市场、智能对话。
- 任务模板:数据导入、数据处理、模型训练、模型处理、服务发布。
- 模型市场(AIHub)覆盖领域:机器视觉、自然语言、语音音频、多模态、大模型。
右侧六边形为平台核心能力集:云原生多租户、机器管理 / 存储管理、数据集 / 标注平台、数据血缘 / 数据 ETL、模板市场 / Pipeline 编排、超参搜索 / 大模型评测、notebook 在线开发、多机多卡分布式训练、大模型微调 / 强化学习、多机推理 / 服务网关、模型市场 / Token 中转、智能体 / 智能对话、国产异构算力租赁、VGPU / RDMA 等。
业务流程架构

基于平台实际模块拆分的一站式 MLOps / AI 平台业务流程,自左向右、自上而下分为六大阶段闭环:
- 平台部署与资源准备:创建 / 加入项目组(项目分组、组成员)→ 配置角色与权限(admin / gamma / creator / ops / dev)→ 绑定资源环境(集群 / 资源组、挂载 / 代理 IP)→ 安全与访问配置(菜单权限、Token、API 认证、秘钥)→ 完成平台初始化(通知、项目就绪)。
- 数据资产与样本准备:数据接入(本地上传 / 数据库 / 文件系统 / 已有数据集)→ 数据探索与分析(SQLLab 探索、统计、可视化)→ 数据处理与预处理(清洗、去重、转换、特征工程)→ 标注与自动化标注(Label Studio、大模型辅助标注)→ 数据同步与备份(Cloud Storage / Sync / 导出)。
- 在线开发与算法构建:镜像准备(镜像仓库 / 在线构建 / 镜像管理)→ 在线开发环境(Notebook / JupyterLab / VSCode / RStudio)→ 代码开发与调试(Git / SSH / Debug / TensorBoard)→ 任务 ETL 与数据开发(数据处理、自定义算子、输入输出管理)→ 开发沉淀(代码 / 脚本 / 组件 / 模板复用)。
- 模型训练与评测:新建 Pipeline / 任务模板(拖拽编排、设定依赖)→ 配置训练资源(CPU / GPU / NPU / vGPU / RDMA)→ 运行训练实例(调度、日志、资源使用、中止重试)→ 模型评测(基础指标 / 业务指标对比分析)→ 是否达标? 达标则进入模型注册(版本、指标、文件地址);未达标则进入调参优化(超参搜索 / 数据优化 / 算法优化 / 重新训练),回到配置训练资源形成迭代闭环。
- 模型管理与服务化发布:模型归档与版本管理(模型定义 / 评测报告 / 签名 / 版本)→ 创建推理服务(模型发布命令、环境配置、端口、健康检查)→ 部署环境选择(测试环境 / 预发环境 / 生产环境)→ 灰度发布与治理(A/B、流量分流、滚动升级、回滚、权限控制)→ 推理加速与接口(OpenAI 兼容)→ 业务系统调用(API / SDK / Web 应用 / OpenAI 接口)。
- 运维监控与持续迭代:整体资源看板(集群 / 节点 / GPU / 存储)→ Prometheus / Grafana 监控(主机、进程、流量、GPU 等)→ 服务 QPS / 吞吐 / 延迟监控(性能、成本监控)→ 告警推送(邮件、企业微信、钉钉)→ 效果复盘与再训练(迭代优化、新数据接入、模型更新),闭环回到数据与训练阶段。
功能模块

以 cube-studio 开源 MLOps / AI 平台为核心,功能模块覆盖从底座算力到大模型应用的全链路。按用户实际使用路径,可归纳为九大能力域,依次为:用户与权限 → 算力纳管 → 在线开发 → 数据管理与标注 → 模型训练 → 推理服务 → 监控 → AIHub 模型市场 → 大模型,另有贯穿全栈的国产化支持能力。
- 项目空间与权限管理:项目分组、模板分类、用户与角色(admin / gamma / creator / ops / dev)、机器 / 存储资源配置、安全设置(K8s / Grafana 链接)。
- 数据资产与标注:SQLLab 数据探索、库表 / 指标 / 维表管理、数据集管理、标注平台、自动化标注与数据备份。
- 在线开发:镜像仓库 / 构建 / 管理、Notebook / JupyterLab、VSCode 在线开发、任务 ETL / 任务管理、Git / TensorBoard / 多环境。
- 模型训练与 Pipeline:任务模板、拖拽式 Pipeline 编排、定时调度 / 运行实例、分布式训练(PyTorch / DeepSpeed / MPI / Ray)、NNI 超参搜索。
- 服务化与模型发布:整体资源、内部服务、模型管理、推理服务、灰度 / A-B / 回滚。
- 数据智能与大模型:GPT 配置、私有知识库、AIHub 模型市场、开源大模型部署、微调 / 智能问答 / vLLM OpenAI 接口。
- 平台能力底座:多集群 / 边缘部署、多用户 / 项目组隔离、CPU / GPU / NPU / MLU / vGPU / RDMA、监控告警(Prometheus / Grafana)、OpenID / LDAP / OA / API 开放。
一、用户与权限
统一账号接入与多租户隔离,是平台安全登录与资源分权的入口。
- SSO 单点登录:对接公司账号体系(AUTH_OID / AUTH_LDAP / AUTH_REMOTE_USER 等)完成登录注册;统一的管理员与用户消息推送;提供登录验证、强密码、远程用户、登录频率限制、密码密文传输等安全增强。
- 项目组管理:按项目组划分资源与权限,配置组内用户权限、任务 / 服务挂载、资源组、集群与服务代理;支持用户与项目组删除、为项目组指定命名空间、绑定多个资源组、设置组内可用资源组。
- 用户 / 角色 / 权限:管理用户信息、组织架构、账号密码与 RBAC 权限体系;含操作历史记录、菜单权限控制、只读 public 角色、接口访问与类型控制,以及多租户(多公司隔离)。
二、算力调度
以 Kubernetes 为底座,云原生统筹 CPU/GPU/NPU 异构算力,实现多集群、多资源组的隔离调度与计量。
- 算力调度:云原生统筹 CPU/GPU 等算力,支持 docker / containerd 运行时;支持划分多资源组、多 K8s 集群、多地部署;支持英伟达 / 海光 / 华为 / 寒武纪 / 摩尔 / 沐曦 / 壁仞等异构算力,及私有化 / 边缘集群 / Serverless 集群模式;支持鲲鹏 ARM64、RDMA(IB/RoCE)、vGPU 虚拟化显存与整卡 / 共享 / 独占多种占用模式。
- 资源限额与数据大屏:平台 / 项目组 / 用户 / 任务 / 组内个人多级资源限制,覆盖 notebook、镜像构建、pipeline、超参搜索、内部服务与推理服务;数据大屏可视化全局 / 项目组 / 个人级别的任务 Pod 分布。
- 机器与存储管理:Web 界面控制机器调度类型、资源组归属、RDMA/vGPU 开关与可用场景;添加存储盘并绑定项目组,notebook / pipeline / 推理服务直接挂载外部分布式存储,支持 NFS、CFS、OSS、NAS、COS、GlusterFS、CephFS、S3/MinIO。
- 算力市场与计量:机器空闲查看、按需 / 按时租赁、自定义镜像启动实例、企业租赁;共享存储盘创建扩容与账单;租赁 Pod 开关机 / 释放 / SSH 登录 / 镜像保存;按用户 / 项目 / 任务维度的按量计量、日结账单,支持微信 / 支付宝 / 对公支付。
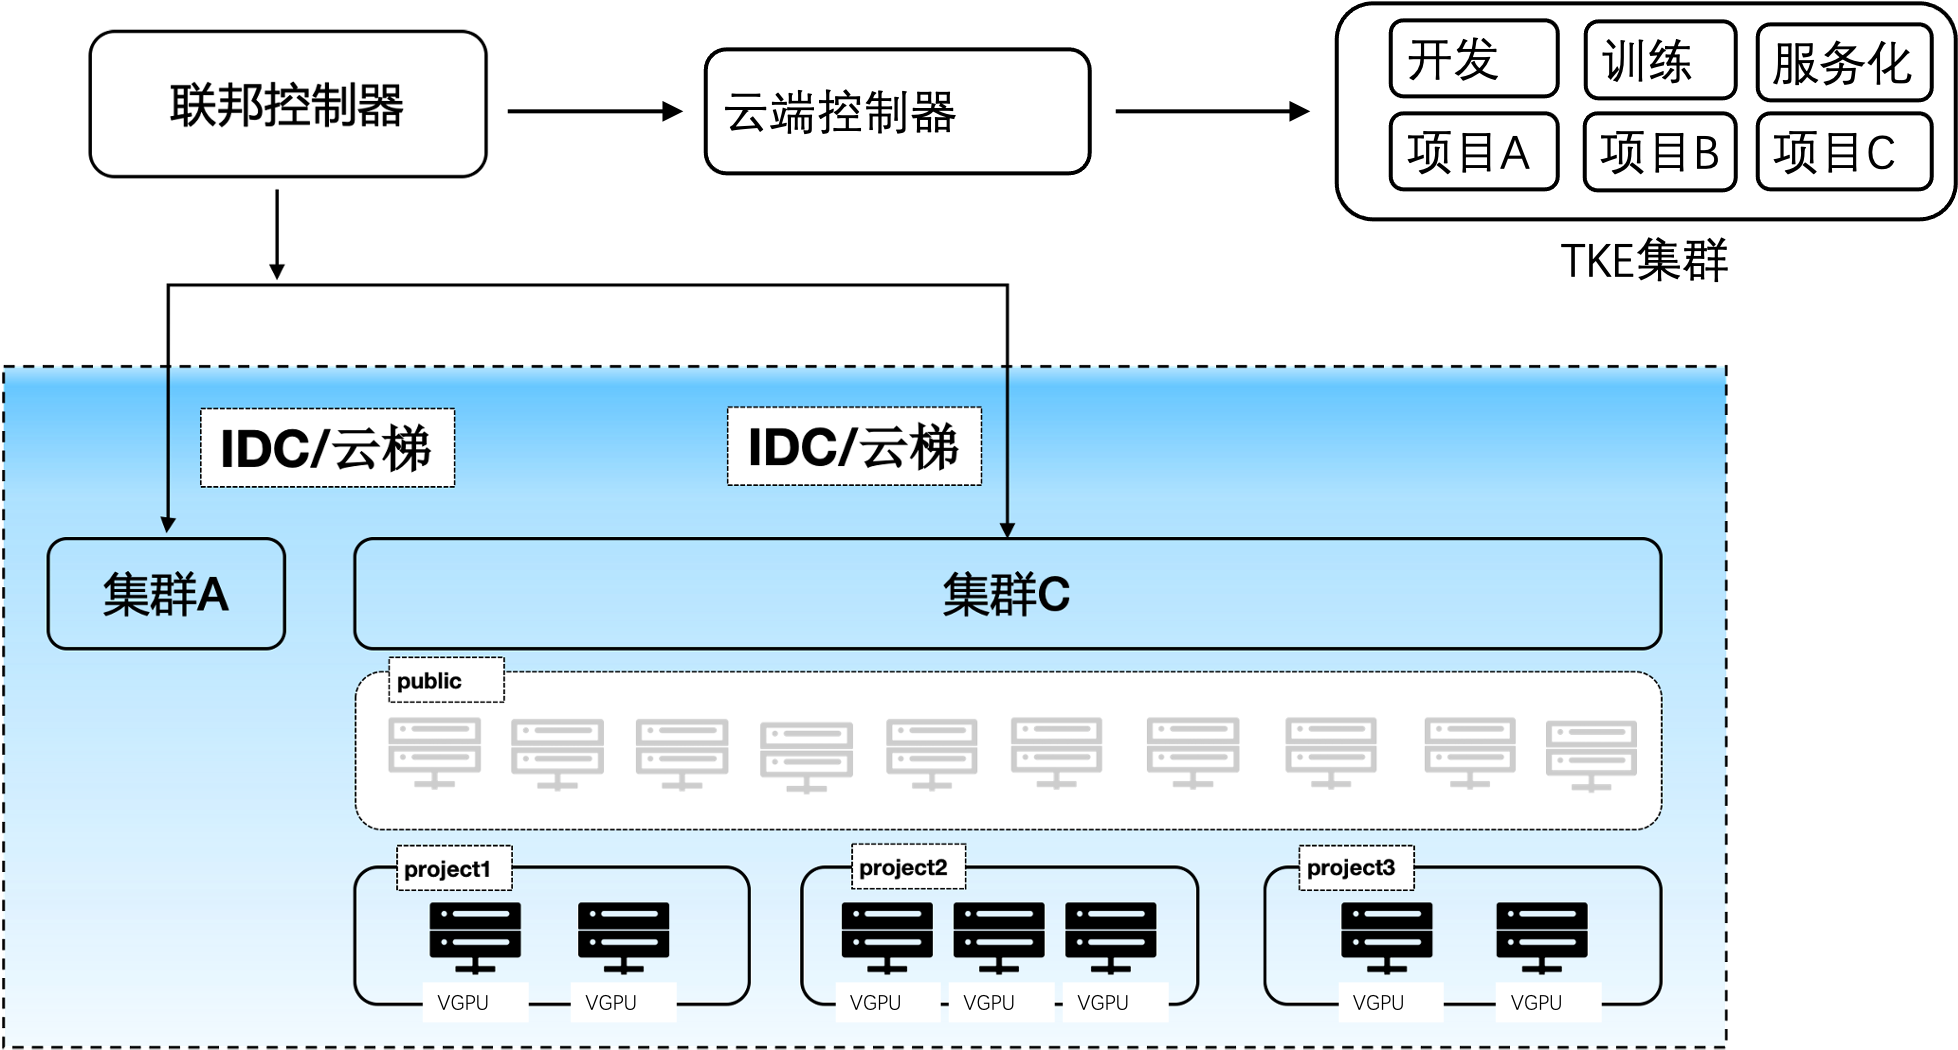
多集群管控
单个 k8s 集群的部署拓扑图:

cubestudio 支持多集群调度,可同时管控多个训练或推理集群。单集群内既能隔离一个项目组的在线开发、训练、推理,也能隔离同一 k8s 集群下多个项目组的算力;不同项目组算力间具备动态均衡能力,可在公共算力池与私有化算力池间共享,做到成本最低化。
分布式存储
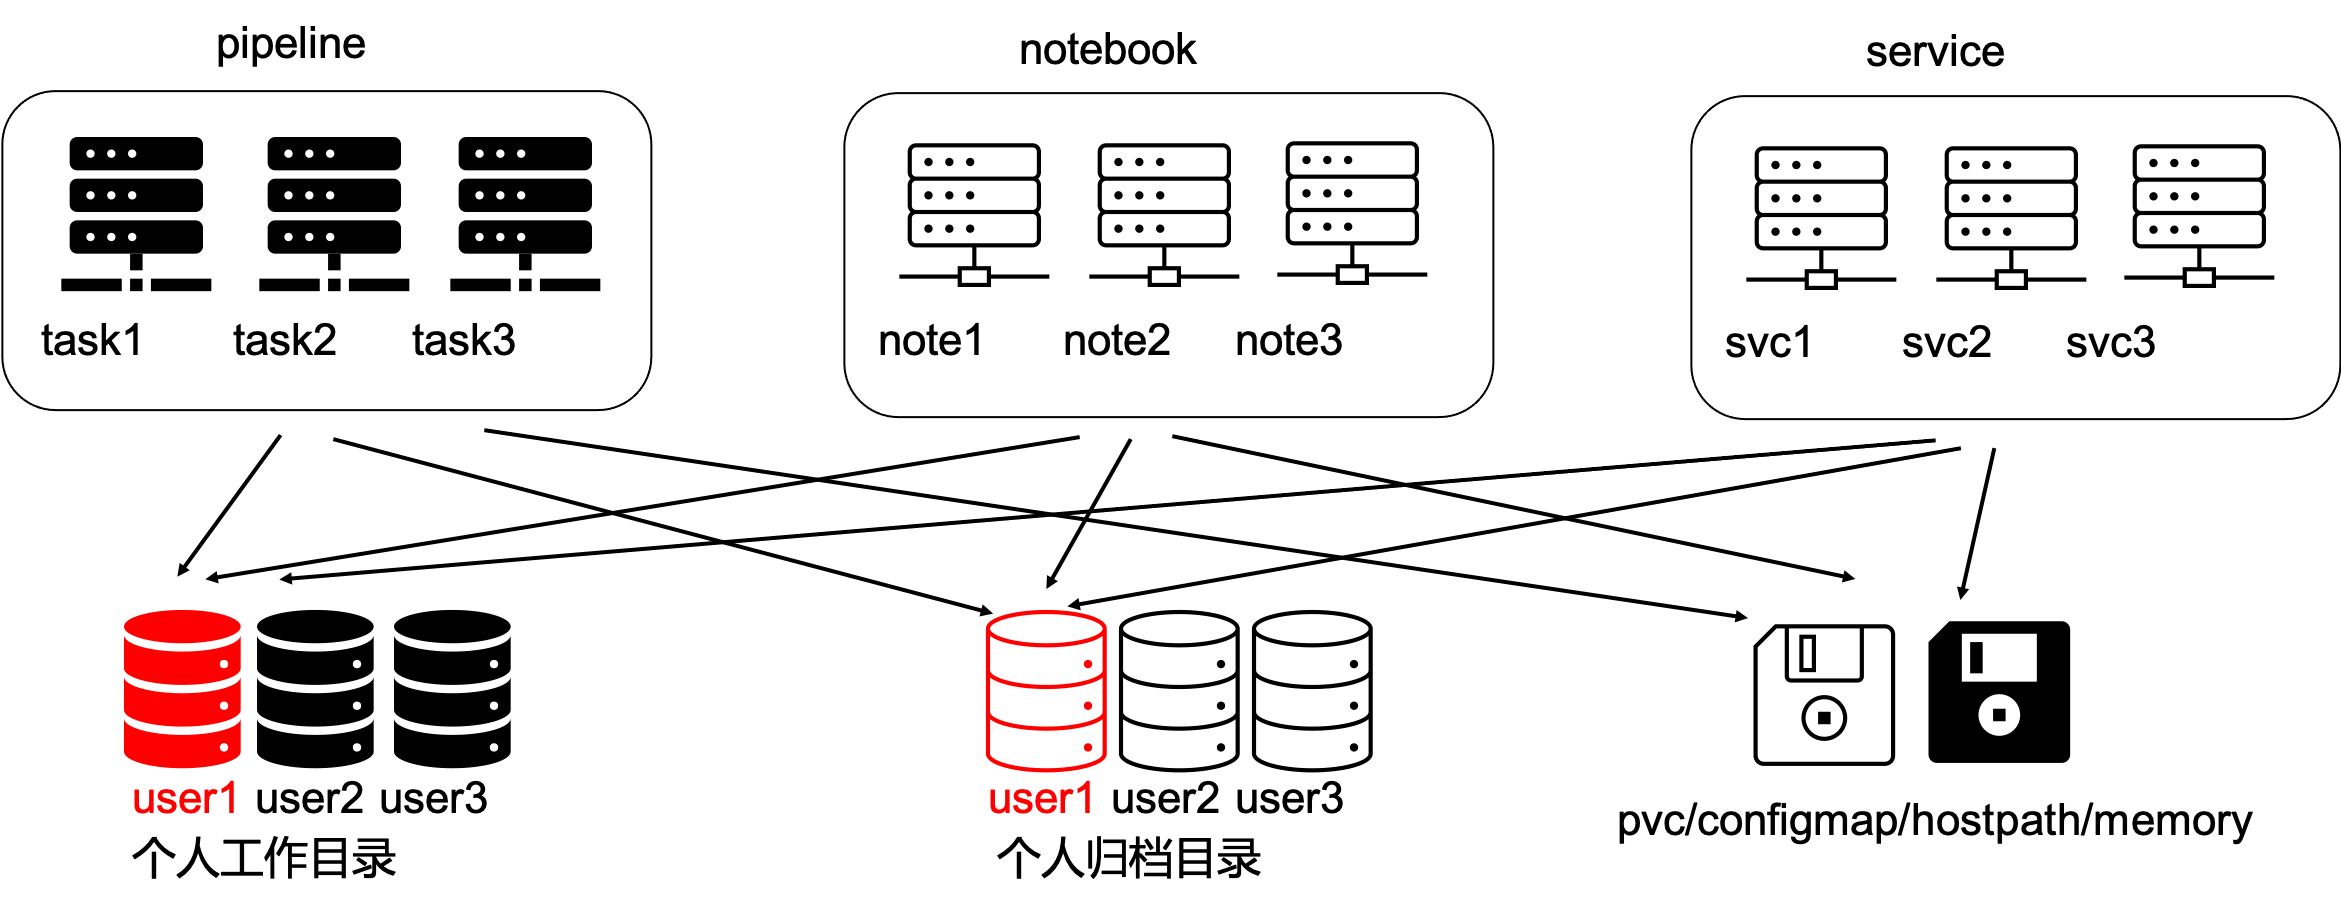
cubestudio 自动为用户挂载个人目录,同一用户在平台任意位置启动的容器,其个人子目录均为 /mnt/$username;可将 pvc/hostpath/memory/configmap 挂载为容器目录,并在项目组中配置默认挂载,实现组内共享同一目录等功能。
三、在线开发
浏览器即开发,多种在线 IDE 与镜像能力,无需本地安装。

- 在线 IDE:基于 JupyterLab / VSCode 的在线交互开发,支持 Matlab、RStudio 等多种 IDE 类型,定期清理续期、环境保存;Jupyter 内置 cube-studio SDK,含 Julia、R、Python、PySpark 多内核版本。
- 多语言与插件:支持 C++、Java、Conda 等多种语言,及 TensorBoard / Git / GPU 监控等插件;SSH remote 与 Notebook 互通,可本地开发;提供汉化 IDE、大数据版内置 HDFS/Hive/Spark 客户端、SSH jumpproxy 单端口、多 Python 版本、在线对接 Claude Code、整卡 / 虚拟卡 / 共享 GPU 及华为 NPU / 海光 DCU / 沐曦在线开发。

- 镜像功能:镜像仓库 / 管理 / 在线构建,通过 Web Shell 在浏览器中完成构建;提供 notebook、inference、gpu、python 等各版本基础镜像;支持同一仓库多秘钥配置与在线镜像构建。
四、数据管理与标注
打通数据接入、探索、标注与数据中台,为算法提供高质量样本。
- 数据地图与计算:元数据库表、指标、维表管理;SQLLab 交互查询,支持 MySQL、PostgreSQL、ClickHouse、Hive、Presto、达梦等计算引擎与数据分析建模。
- 数据集管理:随时上传图片 / 音频 / 文本等样本集,支持表格数据一键探索与详情预览。
可视化数据标注

- 支持图 / 文 / 音 / 多模态 / 大模型多种类型标注,含用户管理、任务分发、项目组权限控制(草稿 / 审核 / 质量打分 / 批量导入导出);打通分布式存储与 MLOps 平台,与数据集模块互通。
- 自动化标注对接 AIHub 模型市场:目标识别、目标边界识别、目标遮罩识别、图片分类、图片描述、OCR、关键点检测、视频多目标跟踪、多说话人语音分隔、语音识别。
- 大模型自动化标注:文本分类、文本翻译、命名实体识别、阅读理解、问答、摘要提取、答案排序等。
数据中台对接

为加速 AI 算法平台的使用,cube-studio 支持对接公司原有数据中台,包括数据计算引擎 SQLLab、元数据管理、维表管理、数据 ETL、数据集管理,提供数据资产开发工具与数据 ETL 可视化链路。
五、模型训练
拖拉拽编排 ML 全流程,标准化算子 + 分布式训练 + 超参搜索,覆盖机器学习 / 深度学习 / 大模型。
拖拉拽建模流程

- ML 全流程:数据导入、数据预处理、超参搜索、模型训练、模型评估、模型注册、服务上线,覆盖机器学习 / 深度学习 / 大模型全流程。
- 灵活开放:便捷的拖拉拽方式编排算法 DAG,支持单任务与 Pipeline 整体等多种调试运行方式。
- 丰富多样的计算任务模板,支持自定义模板。
- 分布式计算:便捷的多机多卡分布式训练,通过标准化方式提供分布式计算与训练能力,提升大规模计算落地效率。
另支持多卡型 / RDMA / 多厂商 GPU 占用、独占共享占用、分布式模板调试用户镜像;任务输入输出与全局常量;文本 / 图片 / CSV/JSON / 表格 / echart 结果可视化;workflow 暂停恢复、运行中端口服务监听、定时调度最大保留实例数、任务流优先级。
多层次多类型算子

平台以 Kubernetes 为算力底座,向上纳管多种主流计算与训练框架,对外沉淀为标准化算子库,形成"底座 — 框架 — 算子 — 场景"分层能力:
- 框架底座:统一编排 PyTorch、TensorFlow、scikit-learn、Horovod、Ray、DeepSpeed、Spark、Volcano、MindSpore、飞桨(PaddlePaddle)等训练与分布式加速框架。
- 算子分层:由基础功能、特征处理、数据处理、传统机器学习、分布式深度学习、预置模型、模型服务化直至大模型训练/微调/量化评估等构成标准化算子库,如下表:
| 算子分层 | 能力说明 |
|---|---|
| 主流功能算子 🟢 | 基础算子(自定义镜像、逻辑节点、python);数据同步(数据集导入、模型导入)。支持 HuggingFace/魔搭数据集与模型导入,datax / datax-import(MySQL/PostgreSQL/ClickHouse)。 |
| 特征处理算子 🔵 (pipeline 算子) | 数据合并/去重/变换(boxcox、二值化、DCT、多项式展开等)、非数值变量处理、异常值检测、统计量、缺失值处理与填充、离散化、标准化/归一化、索引处理、排序、执行 SQL、特征组合、PCA/卡方降维、特征重要性(随机森林/逻辑回归/XGBoost,IV/互信息/方差)、相关性计算、数据拆分、多种采样。 |
| 数据处理工具 🟢 | volcanojob / ray 分布式数据处理、媒体分布式下载与视频提取图片。Hadoop(HDFS/Hive/Spark);文本处理(paddleocr-vl 提取 Markdown、问答对提取扩展、清理/过滤/隐私替换/统计);图像处理(质量评估、去噪、缩放、标准化、裁剪、均衡化、空间与几何变换)。 |
| 传统机器学习 ⭐🟢 | sklearn 单机、ray-sklearn 分布式、XGB 单机训练推理;AR/ARIMA、随机森林(含回归)、LR、LightGBM、KNN、KMeans、GBDT、决策树、PCA、LDA、CatBoost、XGB 及超参搜索。 |
| 分布式深度学习 🟢 | TF / PyTorch 分布式多机多卡训练框架。 |
| CV/NLP/语音预置模型 ⭐🟢 | OCR 文字检测识别(paddleocr)、实例分割(swinb)、图像分类(vit)、文本分类(structbert)、语音合成 TTS(paddlespeech)。 |
| 模型处理与服务化 🟢 | 模型注册、离线处理、部署。模型评估、模型格式转换。 |
| 分布式多机多卡训练 | MPI / Colossal-AI / DeepSpeed / Horovod / Megatron / MindFormer / MXNet / PaddleJob / MindSpore 分布式训练加速框架。 |
| 大模型微调 | DeepSeek/ChatGLM/Qwen/LLaMA LoRA 微调、MindFormers 微调;LLaMA-Factory 大模型 SFT/奖励模型/强化学习;NPU/DCU/沐曦适配的 LLaMA-Factory。 |
| 量化 / 评估 / 剪枝 | 大模型量化;OpenCompass 大模型评估;大模型剪枝。 |
- 场景覆盖:营销场景、金融风控、用户推荐、广告场景、搜索场景、目标识别、视频跟踪、OCR、命名实体识别、翻译、语音识别、语音合成、多模态、生成式 LLM、对话式 LLM、文生图、RAG、Embedding 等,支持自定义算子扩展。
模板自定义

如上图所示,模板机制贯穿"标准化 — 注册 — 模板库 — 编排"全流程:
- 模板标准化 → 注册:将算法能力标准化后完成"构建镜像、注册模板、配置使用参数",沉淀为可复用组件;模板支持 int/float/list/bool/json 型,子类型支持 workdir/image/select-input/project 型与参数 tip 提醒。
- 模板库:统一纳管存储(COS / MinIO / HDFS)、框架(PyTorch / XGB / TFJob 等)与领域能力(视觉 / 听觉 / 推广搜),形成能力资产库。
- 编排:通过"选择模板 → 构建配置 task → 构建配置 pipeline → 编译调试 → 定时运行 → 监控报警"快速搭建应用,落地到数据导入、分布式训练、模型校验、模型部署等环节。
其核心价值:相比非模板开发建立应用成本更低、无需从零开发平台;模板标准化后迁移迭代只需迁移配置模板;算法与工程分离,避免重复开发。
流水线调试

- Pipeline 调试支持定时执行、补录、并发限制、超时、实例依赖等。
- Pipeline 运行支持任务间变量输入输出、全局变量、流向控制、模板变量、数据时间等。
- Pipeline 运行支持任务结果可视化:图片、CSV/JSON、ECharts 源码可视化。
分布式训练
- 支持 TF / PyTorch 分布式多机多卡训练框架,通过标准化方式提供大规模计算与训练能力。
超参搜索

- 界面化呈现训练各组数据,通过图形界面直观展示,支持单机 / 分布式自动超参搜索。
- 减少调参过程的枯燥感,让调参更生动,无需丰富经验即可实现更精准的参数控制调节。
# 上报当前迭代目标值
nni.report_intermediate_result(test_acc)
# 上报最终目标值
nni.report_final_result(test_acc)

# 接收超参数为输入参数
parser.add_argument('--batch_size', type=int)
六、推理服务
零代码将模型发布为在线推理服务,支持多集群、异构 GPU、弹性伸缩与灰度治理。

- 模型管理:模型多版本管理、指标可视化,支持在 Pipeline 中注册并一键发布为推理服务,含灰度发布、版本回退。
- 推理服务:支持 ML/TF/PyTorch/TensorRT/ONNX/Triton/LLM 模型零代码发布;GPU 卡型选择、CPU/Mem 弹性伸缩、泛域名、配置挂载、启动命令 / 环境变量 / 端口 / 健康检查;调试与生产环境、资源与流量监控;支持 vGPU / 独占 / 共享、GPU 弹性伸缩、服务优先级、随机 / header 分流、限流、流量复制、sidecar、多版本滚动升级与回滚、JWT 认证、定时伸缩容与在线测试;支持 vLLM / MindIE 大模型分布式推理。
- 内部服务:快捷部署 mysql-web、redis-web、neo4j、rstudio 等开发运维工具,及 ollama、xinference 大模型推理。
七、监控

平台提供从底层资源到任务运行的全链路监控与主动报警能力:
- 资源监控(K8s Dashboard):可视化查看 Pod、Ingress、Service、ConfigMap、PVC、Secret、StorageClass、集群等资源;实时展示每个 Pod 的名称、标签、所在节点、运行状态、重启次数、CPU 使用率(cores)、内存使用(bytes)与创建时间。
- 资源大盘(Prometheus / Grafana):按 namespace / node / pod 维度聚合全局资源使用,提供 Memory / CPU / GPU 使用率时序曲线与申请值 / 使用峰值统计;覆盖机器 GPU / 内存 / CPU / 网络 IO / 磁盘 IO 负载、Pod 与推理服务的 QPS / 吞吐 / vGPU 负载、IB 流量与 NPU 监控,便于容量评估与资源优化。
- 运行通知与报警:Pipeline / Workflow 任务在 Running、Succeeded、Failed 等状态变更时主动推送通知,消息含名称、namespace、状态、起止时间及 Pod 详情跳转链接;支持各 task 耗时统计与调度优化建议,报警可推送至邮件、企业微信、钉钉、飞书,并提供统一 webhook 接口。
八、AIHub 模型市场

面向模型复用与快速落地的模型市场,一键部署 / 开发 / 微调:
- 定义标准模型应用开发框架,对接 MLOps 平台实现模型的一键部署 / 开发 / 微调。
- 系统自带机器视觉 / 自然语言 / 语音音频 / 多模态 400+ 通用预训练模型,覆盖绝大多数行业场景,可按需自行扩充。
- 生态兼容:同时支持 Hugging Face、魔搭 ModelScope、飞桨生态及自研模型,实现部署 / 开发 / 微调 / 上线全链路。

- 一键部署:AIHub 模型一键部署为 Web 端应用,手机端 / PC 端皆可,实时查看模型应用效果(含 PC 版、手机 / 微信版),并可对外提供 API 或部署为推理服务。
- 一键开发:点击"模型开发"即可进入 Notebook 进行代码二次开发。
- 一键微调:点击"训练"转 Pipeline 微调链路(示例数据下载 → 微调 → 模型注册 → 部署),加入自有数据即可贴合自身场景。

- 标注与编排对接:部署对接 LabelStudio 做自动化标注;代码目录可注册为 AIHub 应用,Pipeline 亦可调用 AIHub 应用做数据处理。
九、大模型
面向大模型训练、微调、推理、评估与智能对话的完整能力。
自动化标注

- 借助大模型进行常规 NLP 任务的自动化标注(问答、阅读理解、命名实体识别、翻译、概要提取、文本分类等)。
- 支持问答数据、阅读理解问答、问答排序等大模型 / 奖励模型语料数据标注。
- 同时覆盖 audio 语音(语音识别、说话人分隔)、chat 会话(意图识别)、视觉(图片描述、OCR)等多模态自动化标注。
大模型微调(分布式框架)

- 支持 TFJob / PyTorch / PaddleJob / MindSpore / MXNet 等分布式训练框架。
- 支持 DeepSpeed / Megatron / ColossalAI / Horovod / MPI 等分布式加速框架。
大模型微调(模型与硬件)

- 支持 DeepSeek / ChatGLM / Qwen 等 full/LoRA 微调,支持 LLaMA-Factory 100+ LLMs。
- 支持大模型量化,大模型 SFT / 奖励模型 / 强化学习训练、大模型评估(OpenCompass)、大模型剪枝。
- 支持 RDMA,支持 IB/RoCE 底层,支持国产 GPU 卡,不同 GPU 厂商 / 卡型选择。
推理部署

- 以 AIHub 形式部署开源文生图大模型,支持 vLLM / Ollama / MindIE / Xinference 等多种部署形式。
- 支持 vLLM / MindIE 单机多卡 / 多机多卡推理加速,形成 OpenAI 流式接口。
- 支持大模型网关:秘钥匹配、限速、黑白名单、Token 限额、统计监控、有效期设定等,并提供 QPS / 失败率 / TPS / 输入输出 token / TTFT 等流量监控。
私有知识库

- 支持对接外部 LLM 服务厂商接口,支持对接内部预训练模型或微调模型 LLM 服务接口。
- 可为某个聊天场景配置私有知识库文件,支持主题分割、语义 embedding、意图识别、概要提取、多路召回、排序等多种功能融合。
AIGC 与智能对话

- AIGC:将智能会话与 AIHub 相结合,例如文生图模型与聊天会话结合,输入提示词即可一键生成图片。
- 机器人:智能会话可与微信公众号 / 企业微信 / 钉钉机器人打通,并可在机器人中使用知识库。
- 智能对话:支持多场景对话、提示词模板、多模态(图片)问答、切换模型、对话超参数、多窗口对话、检索知识库记录展示与安全问答检测。
国产化支持

平台原生支持国产化平台部署,以满足客户对国产化产品的安全可信要求。
国产 AI 算力,一站调度
平台原生支持主流国产 AI 芯片,屏蔽底层异构差异,让训练、微调、推理无缝跑在国产算力上:
- 华为昇腾 NPU(310 / 310P / 910B,支持虚拟化切分)
- 海光 DCU(支持整卡、共享与虚拟化多种占用模式)
- 寒武纪 MLU、沐曦、摩尔线程、百度昆仑芯、壁仞
配套提供国产算力的整卡 / 共享 / 虚拟卡灵活调度、NPU 专属监控看板、RDMA 高速互联,以及昇腾 MindIE 推理、NPU/DCU/沐曦适配的 LLaMA-Factory 大模型微调等开箱即用能力。
国产数据库,无缝对接
- 平台元数据库:支持达梦 DM8、人大金仓 KingBase、OceanBase 等国产数据库,替代 MySQL 作为平台底座。
- SQLLab 数据查询:内置对达梦、GaussDB 高斯等国产数据库的交互式查询与在线分析建模,与 MySQL、PostgreSQL、ClickHouse、Hive 等统一体验。
国产 CPU 与 ARM 架构
全栈适配鲲鹏等 ARM64 国产 CPU:平台底层组件、前后端、任务模板、Notebook 开发环境、超参搜索均提供 ARM 版本镜像,AI 应用商店约 70% 应用支持 ARM,真正做到国产芯片上"拿来即用"。
国产操作系统与私有化部署
采用容器化 + Kubernetes 交付,应用与操作系统解耦,可运行于国产 ARM 服务器与信创软硬件环境,支持全离线私有化部署,满足党政、金融、能源等行业的自主可控与安全合规要求。

Paddle
PaddlePaddle·C++
飞桨核心框架,提供深度学习与机器学习的高性能单机及分布式训练能力,并支持跨平台部署,适合工业级模型开发。
深度学习框架+4国产 NPU
24139+16.0kv3.4.02026-11-10 09:44 UTC
gpustack
gpustack·Python
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
GPU 集群管理+4国产 NPU
6009+20730v2.3.02026-11-10 08:04 UTC
mindspore
mindspore-ai·C++
华为开源的深度学习训练与推理框架,覆盖移动端、边缘和云场景,主打国产 NPU 生态适配。
深度学习框架+4国产 NPU
4722+37472026-10-28 08:28 UTC
vllm-ascend
vllm-project·Python
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
昇腾+4国产 NPU
3069+122.7kv0.30.02026-11-10 11:21 UTC