国产 NPU
昇腾等国产加速卡的软件栈。

飞桨核心框架,提供深度学习与机器学习的高性能单机及分布式训练能力,并支持跨平台部署,适合工业级模型开发。
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
华为开源的深度学习训练与推理框架,覆盖移动端、边缘和云场景,主打国产 NPU 生态适配。
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
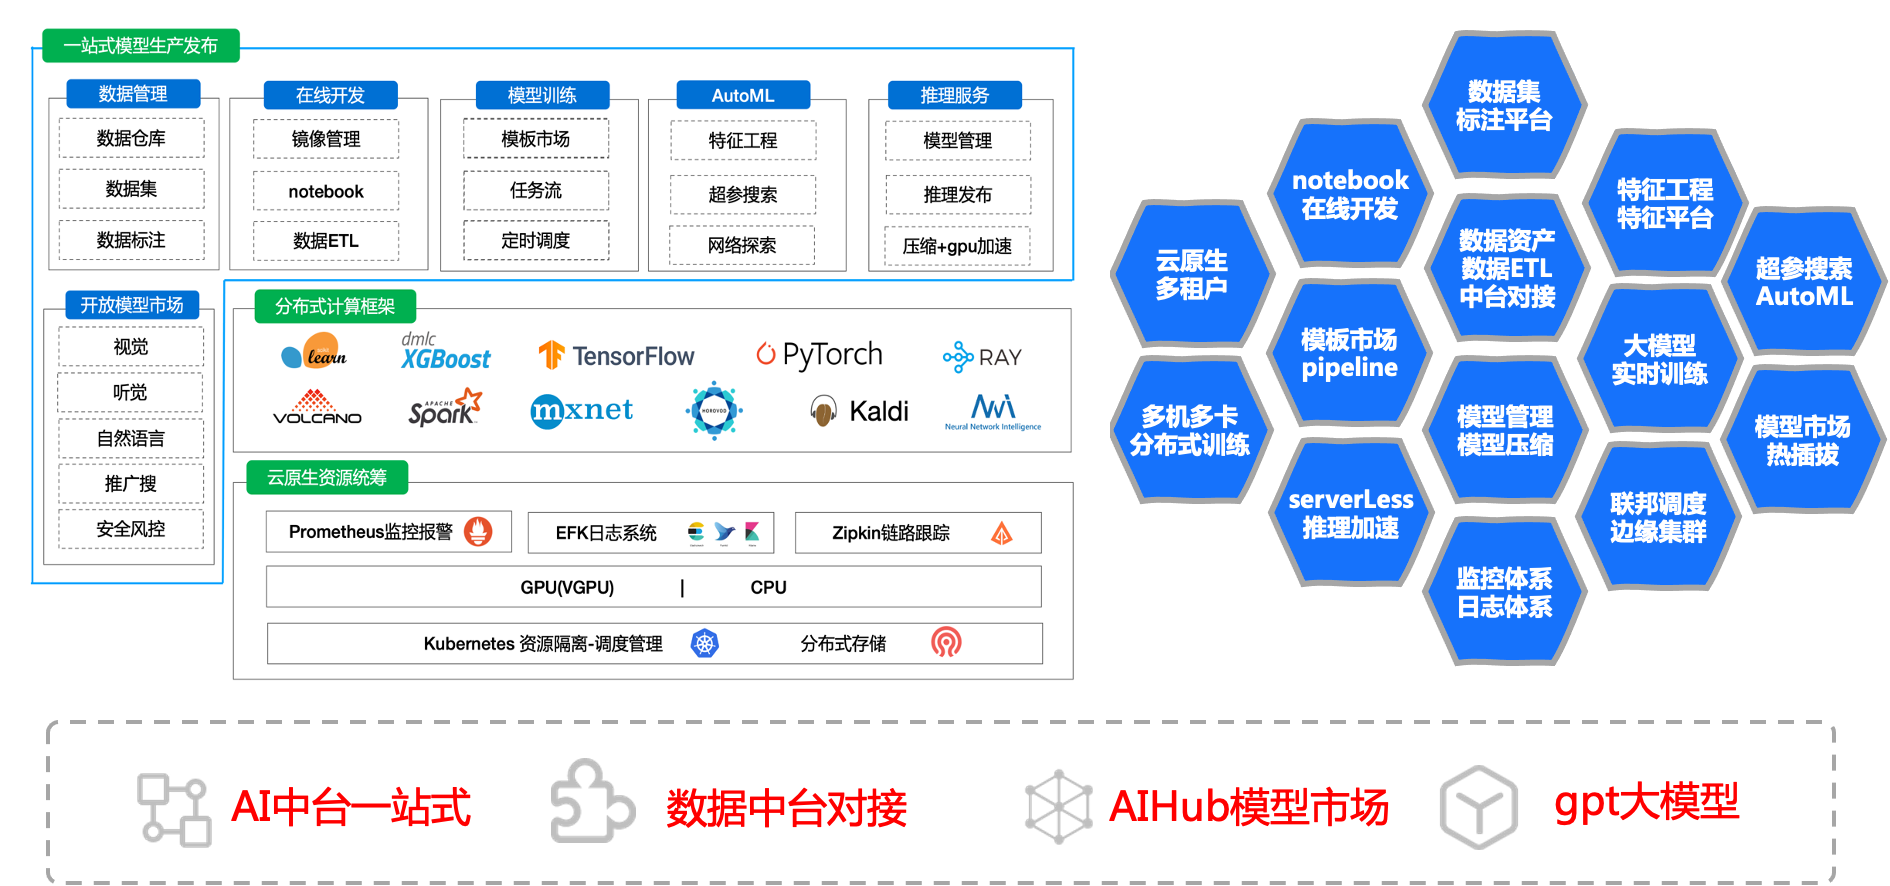
开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
专为 AMD Ryzen AI NPU 深度优化的本地大模型推理引擎,几分钟内就能在 AMD NPU 上跑起 LLM,省去繁琐配置。
一款简单易用、高性能的 AI 部署框架,支持 ONNX Runtime、MNN、昇腾等多种推理后端,用低代码方式把深度学习模型和生成式 AI 应用部署到各类硬件上。
面向 Windows 开发者的开源示例库,演示如何用本地模型和 API 给 Windows 应用加上 AI 能力,覆盖 ONNX Runtime、DirectML 和 NPU 加速。
基于 PyTorch 的推荐模型训练框架,封装了 CTR 预估、生成式推荐等常用算法,开箱即用且方便扩展,支持昇腾 NPU 和 ONNX 导出。
Xilinx 官方运行时库,让 AIE 和 FPGA 加速卡在 Linux 上跑起来,提供驱动、用户态 API 和编译工具链,方便把 AI 负载卸载到 Versal、Ryzen AI 等硬件。
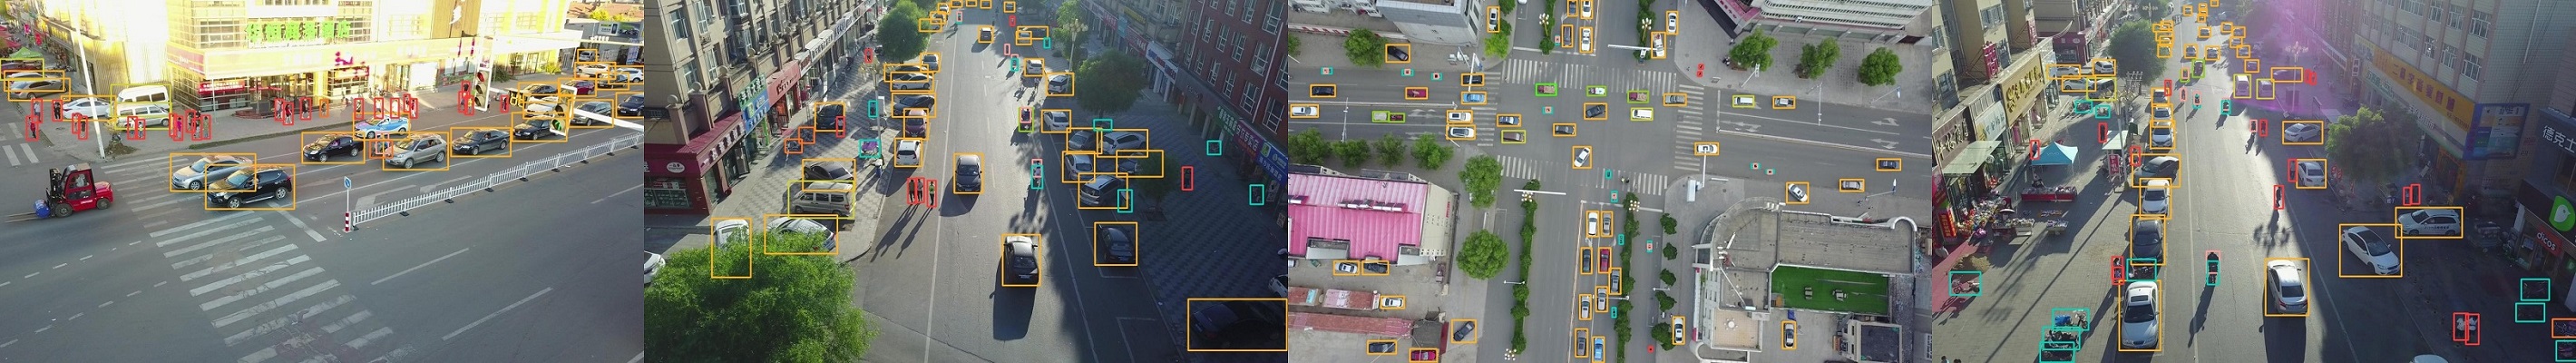
面向边缘设备的实时无锚框目标检测器,精度不错,支持 ONNX、MNN 及 RK3588、昇腾等国产 NPU 部署。

一站式虚拟化管理平台,用 Go 编写,统一管理 Proxmox VE、LXD/Incus(含 GPU)、Docker、Podman、KubeVirt 等多种虚拟化与容器运行时。
把 LLM 推理中的 KV Cache 持久化到 DRAM、SSD 或 NFS 并跨请求复用,减少重复计算,加快推理速度,兼容昇腾 NPU 和 CUDA GPU。
爱芯元智 AI SoC 的示例代码集合,提供 YOLO 系列等视觉模型在 NPU 上的部署样例,帮开发者快速跑通模型推理。
西北工业大学本科、硕士、博士学位论文的 LaTeX 模板,按学校排版规范生成封面、目录和参考文献,省去手动调格式的麻烦。
在 RK3588 等瑞芯微芯片上快速装好并调用 NPU 的脚本工具,省去手动配置驱动和运行环境的麻烦,方便直接跑神经网络和 LLM 推理。
ONNXim 是一个周期级多核 NPU 模拟器,能快速仿真 DNN 推理在 NPU 上的执行过程,帮助评估和优化硬件设计。