README 未给出具体安装命令,需到官网 Quick Install 按系统和硬件选择对应版本;不同芯片后端需安装各自对应的安装包,不能混用

Paddle
PaddlePaddleApache-2.0活跃维护飞桨核心框架,提供深度学习与机器学习的高性能单机及分布式训练能力,并支持跨平台部署,适合工业级模型开发。
PArallel Distributed Deep LEarning: Machine Learning Framework from Industrial Practice (『飞桨』核心框架,深度学习&机器学习高性能单机、分布式训练和跨平台部署)
v3.4.0发布于 2026-09-11 12:54 UTC24,139star +1 / 7 天6,018fork同步于 2026-11-10 11:23 UTC
pip install paddlepaddle 硬件要求按 README 说明
README 未说明具体显存、CPU 或 GPU 型号要求,仅提到支持异构多芯片适配,具体硬件条件需查阅官方安装文档
国产开源深度学习框架,覆盖单机分布式训练与跨平台部署
飞桨核心框架,提供深度学习与机器学习的高性能单机及分布式训练能力,并支持跨平台部署,适合工业级模型开发。
核心能力
- 统一动态图与静态图,自动搜索分布式并行策略
- 同一框架打通大模型训练与推理,代码可复用
- 提供高阶自动微分、复数运算与傅里叶变换
- 内置神经网络编译器,兼顾训练效率与推理灵活
- 统一适配多种异构芯片,接口标准化可插拔
容易踩的坑
内容由模型根据 README 生成,可能不完整或不准确,以官方文档为准。看原文 README
- v3.4.0PaddlePaddle 3.4.0 Release Notes最新正式版2026-09-11 · 2026-09-11 12:54 UTC
重要更新
飞桨框架 3.4 版本围绕大模型训练的训练效率、算子正确性、稳定性以及国产硬件适配等关键领域持续迭代。本版本新增面向大规模分布式训练的高性能 Muon 优化器;持续打磨核心算子的数值精度,并针对大模型训练中高频出现的大 Shape Tensor、0-Size Tensor 场景做了系统性的正确性排查与修复,进一步夯实大模型训练的稳定性与正确性。同时,生态兼容能力与昆仑芯 XPU 适配持续深化,开发体验和推理部署能力同步提升。需要说明的是,本版本是最后一个提供 Windows 系统支持的版本。
训练效率提升
- Muon 优化器:新增 Muon 优化器,基于 batched GEMM、对称 GEMM 等技术对 Newton-Schulz 正交化过程做了高性能优化,并具备大规模并行训练能力。
- 基于 VMM 的 Allocator v2:新增基于 CUDA 虚拟内存(VMM)的 best-fit 分配器 v2,支持大/小内存池分离查询与全 block 信息查询,改善 MoE 等动态显存场景下的碎片管理,显著减少显存碎片,并提供高性能的碎片整理能力。
- FP8 量化能力增强:fp8_quant_blockwise 等 FP8 量化算子新增 ue8m0 scale 数据类型支持,并将适用范围扩展到非 128 对齐 block、大 Tensor 等场景。
正确性增强
- 核心算子精度提升:系统性提升 matmul、linear、reduce 系列、elementwise 系列、activation 系列算子,以及 AdamW、layer_norm、rms_norm、group_norm、conv 等核心算子的计算精度。
- 大 Shape Tensor 与 0-Size 正确性增强:系统性修复大 Shape Tensor 上的 int32 索引溢出,以及 0-Size Tensor 引发的 CUDA error(9)、段错误等正确性问题,全面保障大 Shape Tensor 与 0-Size 场景下的训练稳定性。
开发体验优化
- 动转静(SOT)持续增强:SOT 全面支持 Python 3.11–3.14,新增多种字节码指令的处理能力,并实现与 PyTorch 对齐的反向 DFS 遍历调度。
国产硬件深度适配
- 昆仑芯 XPU:新增 batched_gemm 与 CUDA Graph 支持,深度适配 DeepEP buffer 及 bkcl 通信库(支持 w4a8/w8a8 量化),并新增 complex128 数据类型支持。
- 海光 DCU:将 CUDA native API 适配为 HIP native API,并在 ROCm 上为 conv 系列算子注册 bfloat16 kernel,进一步完善国产芯片适配并提升推理性能。
1. 训练效率提升
分布式策略优化(61 项)
- 通信与计算重叠:新增 p2p 通信与数据并行权重更新/重计算之间的重叠,并支持上下文并行、FlashMaskV3 场景下的通信计算重叠(5 项):#79709, #79522, #79357, #78783,#78184
- 流水线并行:合入 PaddleFleet 流水线并行实现,支持 MTP 权重共享、参数 offload 与显存优化(11 项):#79692, #79551, #79394, #78688, #78680, #78449, #78437, #78230, #78229, #77852, #77812
- Muon 优化器:新增基于 Newton-Schulz 正交化的优化器,并完善其分布式 sharding 支持、通信优化与 bf16/fp32 混合参数处理,同时通过 batched Newton-Schulz 迭代、对称 GEMM 等手段优化性能(16 项):#79688, #79538, #79512, #79485, #79020, #78987, #78953, #78856, #78828, #78748, #78335, #78928,#79741, #79715, #79495, #79048
- 分布式训练其它优化与增强:Sharding 重建、显存/内存优化、启动脚本健壮性提升等(6 项):#79634, #78522, #78310, #77459, #77152, #76591
- FlexCheckpoint:增强权重转换与重组能力,覆盖 AOA、safetensors、DCP 加载、3D CommGroup 重分片等场景(10 项):[#78818]
- v3.3.0PaddlePaddle 3.3.0 Release Notes2026-01-31 · 2026-01-31 07:13 UTC
查看更新说明
重要更新
飞桨框架 3.3 版本在大模型训练效率、开发体验及国产硬件适配等关键领域持续突破创新,在计算显存高效利用、训推衔接转换、生态兼容性、调试效率、国产硬件适配等方面带来多项重要升级,全面提升大模型训推能力。
训练效率突破
- FlashMaskV3升级:深度优化稀疏注意力掩码计算FlashMaskV3计算内核,性能全面超越FlexAttention,算子性能最高领先2.1 倍;原生支持上下文并行并引入计算负载均衡机制,分布式场景算子性能相比Megatron-LM快80%,全面强化长文训练能力。
- FlexCheckpoint参数自动切分重组系统:基于首创的轻量级描述语言AOA (All in One Arrow),支持从单卡视角灵活描述复杂的权重转换关系,并自动推导分片映射;通过跨机通信的高并发与负载均衡调度,在大参数规模下权重转换性能相比Megatron-LM领先1.2倍以上,有效解决大模型训推不同阶段参数转换的成本与效率难题。
- 虚拟内存动态碎片整理:引入基于虚拟内存技术的显存分配机制,可根据运行时显存占用情况动态进行碎片整理。在主流MoE模型训练中,显存碎片率从超过10%降至最低3%,显著提升显存利用率。
开发体验优化
- 生态兼容:通过框架API、算子注册、执行调度等关键链路的兼容设计,实现无缝衔接使用外部生态算子,支持FlashInfer、FlashMLA、DeepGEMM、DeepEP、TorchCodec和SonicMoE等社区高性能模块的高效集成应用。
- 动态图调试能力升级:新增动态图前反向计算图可视化功能,支持导出算子调用栈与张量MD5校验信息;系统优化关键路径日志,新增局部日志打印功能,提升调试信息丰富度与获取便捷性。
- 显存观测工具:新增显存观测功能,可视化显存池中内存块分布,支持追踪特定代码段的显存申请/释放与全局状态,助力大模型显存异常的精准定位与处置。
国产硬件深度适配
- 昆仑芯 XPU:系统完善MoE场景适配,为相关算子新增bool、bfloat16、complex64数据类型支持,并对FlashAttention、DeepEP、Profiler等模块进行深度适配。
- 海光 DCU:支持 Hygon数学库后端,进一步优化海光芯片推理性能。
1. 执行调度机制
针对大模型预训练、后训练与推理阶段中,因分布式策略及组网差异导致的权重转换困难,飞桨FlexCheckpoint机制创新提出高效的权重重组方法与灵活的模型编辑原语AOA,为模型研发到生产全流程提供高效、统一的分布式参数转换与重组支持。该机制全面适配训推衔接、跨策略断点续训、生态兼容格式加载导出、强化学习参数同步等多种场景下的权重转换需求,并在大参数规模场景下实现超越Megatron-LM 1.2倍以上的转换性能,从根本上解决了分布式参数转换成本高、效率低的难题。 在显存管理方面,针对MoE模型因专家路由动态性导致的显存碎片率高、资源浪费严重等问题,本版本推出了基于虚拟内存管理技术的高性能VMM Allocator。该分配器可在模型运行期间根据系统显存使用情况,动态自适应执行碎片整理,显著提升显存利用效率。 飞桨3.3版本持续深耕自动并行与AI编译器技术。在自动并行架构中新增对FSDP等策略的支持,并增强了动态Shape流水线并行功能;面向科学计算场景,实现了对高阶导数的支持,并拓展了相关算子切分推导规则的覆盖范围,进一步提升了自动并行架构的通用性与易用性。此外,围绕推理场景,优化了AI编译器CINN及动转静SOT功能,显著提升易用性与执行调度性能。
新特性
- FlexCheckpoint支持在线合并参数功能。#75613, #76510
- 实现基于虚拟内存管理技术的高性能VMM Allocator。#75323, #76222, #76223, #76389, #76430, #76454, #76523, #76544, #76730, #76793, #77196
- 自动并行支持高阶微分。#75689
- 自动并行支持FSDP策略。#76113, #76868
- 自动并行优化与增强argsort,bmm,elementwise,index_select,matmul,softmax,tile,transpose等算子的自动切分推导。#74826, #74829, #75036, #75044, #75050, #75095, #75246, #75265, #75555
- 动转静支持局部捕获控制流。#75548、#76198
- 动转静支持Python 3.14版本相关语法。 #75853, #75879, #75971,#76072, #76257,#76288, #76320, #76416, #76451,
- v3.2.2PaddlePaddle 3.2.2 Release Notes2025-12-08 · 2025-12-08 01:34 UTC
查看更新说明
重要更新
飞桨框架3.2.2版本在分布式并行、算子机制、硬件适配三个方面完成多项优化与升级,进一步提升框架性能与稳定性。
1. 分布式训练
- 优化 FlexCheckpoint 的重切分通信流程; 为 paddle.nn.Layer 新增 full 接口, 用于返回完整模型参数; 支持加载 HuggingFace 开源格式的 Checkpoint。(#76249, #76291)
- 为 group_sharded_optimizer_stage2 优化器新增 sharded_state_dict 函数。#76311
- 为 paddle.load 接口修复加载 safetensor 文件 device_id 参数错误及 core_dump 问题。#76317
- 新增 PipelineDatasetPreprocessor 机制,消除流水线并行策略中可能出现的内存泄漏问题。 #76260
2. 算子机制
- 修复针对 BFloat16 list 场景下的 to_tensor 精度问题。 #76242
3. 硬件适配
- 修改了独立的 XPU 内存监控模块,以确保与最新的内存监控逻辑保持一致。 #76056
4. 贡献者名单
qw86972190, xingmingyyj, zhangbo9674, zhangyuqin1998
Important Updates
PaddlePaddle Framework version 3.2.2 features multiple optimizations and upgrades across Distributed Parallelism, Operator Mechanism, and Hardware Adaptation to further enhance the framework's performance and stability.
1. Distributed Training
- Optimized the communication process for re-sharding in FlexCheckpoint; added the full interface to paddle.nn.Layer for returning complete model parameters; supported loading Checkpoints in the HuggingFace open-source format. (#76249, #76291)
- Added the sharded_state_dict function to the group_sharded_optimizer_stage2 optimizer. #76311
- Fixed errors regarding the device_id parameter and a core dump issue when loading safetensor files using the paddle.load interface. #76317
- Introduced the PipelineDatasetPreprocessor mechanism to eliminate potential memory leak issues in the pipeline parallelism strategy. #76260
2. Operator Mechanisms
- Fixed a precision issue in to_tensor for BFloat16 list scenarios. #76242
3. Hardware Adaptation
- Modified the independent XPU memory monitoring module to ensure consistency with the latest memory monitoring logic. #76056
4. List of Contributors
qw86972190, xingmingyyj, zhangbo9674, zhangyuqin1998
- v3.2.0PaddlePaddle 3.2.0 Release Note2025-09-08 · 2025-09-08 13:41 UTC
查看更新说明
重要更新
飞桨框架3.2版本在大模型训练推理性能、硬件适配、主流大模型及高性能加速库的支持上进一步提升。
- 大模型训练方面,飞桨框架在计算、并行策略、容错能力三方面进行了升级:
- 从基础计算性能层面,提出了存算重叠的稀疏掩码注意力计算FlashMask V3,极致优化Attention的计算效率,同时还实现了高效的FP8混合精度效果无损训练技术。
- 在分布式并行策略层面,提出了动态自适应的显存卸载策略,实现存算最优均衡,再结合创新设计的显存友好的流水线并行调度,进一步降低显存开销。
- 增强了框架原生的容错能力,实现了大规模集群训练容错系统,可在不影响训练效率的前提下在线监测静默数据损坏等难以察觉的故障,并实现了高可用的检查点容灾方法,降低中断恢复损失。
- 在硬件适配方面,面向类CUDA芯片,全面升级插件式适配方案。
- 在设备资源的管理调度和高性能集合通讯库方面,针对类CUDA芯片做了管理接口升级和通信能力的增强,特别增强了分布式通信能力,使XCCL对齐NCCL的各结构体和功能。
- 新增了类CUDA算子注册机制。以沐曦适配为例,在复用GPU算子内核的基础上,仅需一行代码即可完成算子内核注册。经过统计计算,算子内核的复用率最高可以达到92%,可大幅降低硬件适配成本。
- 使用体验方面,重点提升了兼容能力,包括开发接口兼容业界用法、safetensors模型格式兼容、和第三方高性能加速库的兼容。
- 新增和修改开发接口兼容业界用法,新增系列API和别名,新增参数别名,新增专有和通用的参数。
- 全面兼容 Safetensors 模型格式。新增 FlexCheckpoint 机制,支持跨分布式策略、跨模型结构间自动实现参数重切分,可显著降低权重转换成本,进而提升大模型端到端的训练与推理研发效率。
- 系统性增强了接口兼容与算子注册能力,实现了高性能加速库一键导入,无需修改代码直接复用于飞桨的模型训练与推理加速过程中。
1. 用户体验
新特性
- 新增API:
paddle.msort、paddle.ravel、paddle.nn.functional.dropout1d、paddle.Tensor.type_as、paddle.Tensor.requires_grad、paddle.view_as_complex、paddle.view_as_real、paddle.nn.Parameter、paddle.broadcast_shapes、paddle.range、paddle.as_tensor、paddle.scatter_reduce/scatter_reduce_、paddle.scatter_add、paddle.tensor、paddle.softmax、paddle.Tensor.softmax、paddle.rand_like、paddle.is_autocast_enabled、paddle.get_autocast_gpu_dtype、paddle.Tensor.repeat、paddle.permute。#74421,#74439,#74444,#74454,#74459,#74491、#74466,#74438,#74594,#74542,#74694,#74564,#74540,#74586,#74651,#74807,#74632,#74834,#74952,#74772,#74441,#74561,#74525 - 新增
paddle.compat.*一系列API,支持业界的通用用法,便于迁移代码,包括paddle.compat.median、paddle.compat.nanmedian、paddle.compat.softmax、paddle.compat.sort、paddle.compat.split、paddle.compat.min/max、paddle.compat.Unfold。#74865,#74874 - 新增初始化一系列API,支持业界通用的参数初始化方式,包括
paddle.nn.init.kaiming_uniform_、paddle.nn.init.xavier_uniform_、paddle.nn.init.uniform_、paddle.nn.init.kaiming_normal_、paddle.nn.init.xavier_normal_、paddle.nn.init.normal_、paddle.nn.init.calculate_gain、paddle.nn.init.constant_、paddle.nn.init.dirac_、paddle.nn.init.eye_、paddle.nn.init.ones_、paddle.nn.init.orthogonal_、paddle.nn.init.trunc_normal_、paddle.nn.init.zeros_。#74478 - API新增参数别名用法,例如既可以输入
x,也可以输入input,用法更为灵活。包括paddle.maximum、paddle.minimum、paddle.sqrt、paddle.topk、paddle.polar、paddle.stack、paddle.cos、paddle.floor、paddle.log、paddle.pow、paddle.rsqrt、paddle.sign、paddle.sin、paddle.multiply、paddle.where等。[#74683](https://github.com/PaddlePaddle/Paddle/p
- 大模型训练方面,飞桨框架在计算、并行策略、容错能力三方面进行了升级:
- v3.1.1PaddlePaddle 3.1.1 Release Note2025-08-21 · 2025-08-21 06:19 UTC
查看更新说明
重要更新
飞桨框架3.1.1版本围绕大模型训练全流程进行了系统性强化,通过体系化修复大模型场景下算子数值精度和功能等底层稳定性问题,结合API的日志系统规范化与单元测试全覆盖,显著提升大模型训练的正确性和稳定性;性能层面,在提高部分关键框架API和FP8场景下的量化计算效率的同时增强分布式训练场景下FP8量化和流水线并行效率,大幅提升训练吞吐。扩展自动并行架构的切分推导覆盖范围;推理部署提高兼容性的同时进一步增强EP并行推理能力;整体上在保持API兼容性的基础上构建出更稳健、高效的大模型研发技术底座。
算子与执行体系正确性、稳定性增强:系统化修复0-size、大shape Tensor、CPU/GPU 精度一致性问题,保障大模型训练正确性、稳定性。 FP8相关算子优化: 进一步提升FP8相关量化和计算融合算子的性能,并调整了部分算子的sm使用量,提升FP8混合精度训练效率 大模型训练更稳更快:系统性优化了Slice相关场景的执行效率,大幅提升Slice相关操作性能;修复流水线场景下的参数同步问题、新增Sharding场景的FP8参数量化能力和DualPipe下的极致通信计算重叠能力,保障并行训练稳定高效。同时增强自动并行架构下的切分推导能力增强自动并行切分效率。 推理部署:新增支持safetensors加载功能,EP并行方面对internode_ll_two_stage进行了功能增强助力进一步提升推理效率。
1. 用户体验升级
在3.1版本中,主要对大模型场景下常用的的多个API进行了补充,并且系统化修复了API日志以及部分代码实现问题。
新特性
- 新增API
paddle.device.device_guard,动态图的设备切换上下文管理器。#73964 - 新增API
paddle.Tensor.bool、paddle.Tensor.float16、paddle.Tensor.half、paddle.Tensor.bfloat16、paddle.Tensor.float32、paddle.Tensor.float、paddle.Tensor.float64、paddle.Tensor.double、paddle.Tensor.int8、paddle.Tensor.char、paddle.Tensor.uint8、paddle.Tensor.byte、paddle.Tensor.int16、paddle.Tensor.short、paddle.Tensor.int32、paddle.Tensor.int、paddle.Tensor.int64、paddle.Tensor.long、paddle.Tensor.complex64、paddle.Tensor.complex128、paddle.Tensor.cfloat、paddle.Tensor.cdouble,支持灵活的数据类型切换。#74416 - 新增API
paddle.msort,支持多维数组的排序。#74421 - 新增API
paddle.ravel、paddle.Tensor.ravel,支持对Tensor进行拉平。#74439,#74454 - 新增API
F.dropout1d,支持对Tensor沿指定维度进行随机丢弃。#74444 - 新增API
paddle.Tensor.type_as。#74459 - 新增API
paddle.Tensor.mul_、paddle.autograd.Function、paddle.argwhere。#74493 - 新增API
paddle.nn.MultiLabelMarginLoss。#73538 - 新增API
paddle.is_autocast_enabled、paddle.get_autocast_gpu_dtype。#74441 - 新增Tensor属性
paddle.Tensor.requires_grad。#74491
问题修复
- 修复
Tensor.place之间比较的问题。#73532 - 修复
F.adaptive_log_softmax_with_loss的问题。#73554 - 修复
Tensor.__radd__、Tensor.__rmul__相关问题。#73833 - 修复API的 0-size 相关问题。#73874
- 修复
_DataLoaderIterMultiProcess、_DataLoaderIterSingleProcess的问题。#73931 - 修复
paddle.nanmedian的问题。#74263 - 修复
paddle.eigh的问题。#73349 - 修复
paddle.arange的问题。#74159
功能增强
paddle.cumprod支持设置dim为None。#74106paddle.zeros/zeros_like/ones/ones_like/eye/empty/empty_like/full/full_like支持device、dtype、requires_grad等更多参数。#74477paddle.ones支持shape为可变参数的用法。#74494F.gelu的approximate参数支持字符串格式。#74485F.scaled_dot_product_attention支持输入为3D。#73804
文档
其他
- 代码风格相关的优化。
- 新增API
用户点评
登录用户的真实使用记录,可按版本和硬件筛选共 0 条
还没有人点评。第一个说出真实体验的人最有价值。


Welcome to the PaddlePaddle GitHub.
PaddlePaddle, as the first independent R&D deep learning platform in China, has been officially open-sourced to professional communities since 2016. It is an industrial platform with advanced technologies and rich features that cover core deep learning frameworks, basic model libraries, end-to-end development kits, tools & components as well as service platforms. PaddlePaddle originates from industrial practices with dedication and commitments to industrialization. It has been widely adopted by a wide range of sectors including manufacturing, agriculture, enterprise service, and so on while serving more than 23.33 million developers, 760,000 companies and generating 1,100,000 models. With such advantages, PaddlePaddle has helped an increasing number of partners commercialize AI.
Installation
Latest PaddlePaddle Release: 3.3
Our vision is to enable deep learning for everyone via PaddlePaddle. Please refer to our release announcement to track the latest features of PaddlePaddle.
Install Latest Stable Release or Nightly Release
For detailed information about installation, please view Quick Install
PaddlePaddle New Generation Framework 3.2
-
Unified Dynamic/Static Graphs and Automatic Parallelism
By requiring only minimal tensor partitioning annotations based on a single-card configuration, PaddlePaddle automatically discovers the most efficient distributed parallel strategy. This significantly reduces the costs of industrial development and training, enabling developers to focus more intently on model and algorithm innovation.
-
Integrated Training and Inference for Large Models
The same framework supports both training and inference, achieving code reuse and seamless integration between these stages. This provides a unified development experience and maximum training efficiency for the entire large model workflow, offering the industry a superior development experience.
-
High-Order Differentiation for Scientific Computing
Provides capabilities such as high-order automatic differentiation, complex number operations, Fourier transforms, compilation optimization, and distributed training support. It facilitates scientific exploration in fields including mathematics, mechanics, materials science, meteorology, and biology, substantially improving the speed of solving differential equations.
-
Neural Network Compiler
Adopting an integrated framework design, it supports efficient training and flexible inference for diverse models, including generative and scientific computing models. It achieves an effective balance between computational flexibility and high performance, significantly lowering performance optimization costs.
-
Heterogeneous Multi-Chip Adaptation Features a mature and complete unified adaptation solution for multiple hardware types. Through standardized interfaces, it abstracts the variations in development interfaces across different chip software stacks, realizing a pluggable architecture.
Documentation
We provide English and Chinese documentation.
-
You might want to start from how to implement deep learning basics with PaddlePaddle.
-
So far you have already been familiar with Fluid. And the next step should be building a more efficient model or inventing your original Operator.
-
Our new API enables much shorter programs.
-
We appreciate your contributions!
Open Source Community
- Github Issues: bug reports, feature requests, install issues, usage issues, etc.
- Many of our contribution events offer varying levels of mentorship from experienced community members, please check the events in the pinned issues, and consider attending.
- Community Blog: https://pfcc.blog/
- See more details about PaddlePaddle community at community.
Copyright and License
PaddlePaddle is provided under the Apache-2.0 license.
gpustack
gpustack·Python
统一管理 GPU 集群,调度 vLLM、SGLang 等推理引擎做高性能模型服务,还能按需开出可 SSH 登录的 GPU 实例。
GPU 集群管理+4国产 NPU
6009+20730v2.3.02026-11-10 08:04 UTC
mindspore
mindspore-ai·C++
华为开源的深度学习训练与推理框架,覆盖移动端、边缘和云场景,主打国产 NPU 生态适配。
深度学习框架+4国产 NPU
4722+37472026-10-28 08:28 UTC
vllm-ascend
vllm-project·Python
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
昇腾+4国产 NPU
3069+122.7kv0.30.02026-11-10 11:21 UTC
cube-studio
data-infra·Python
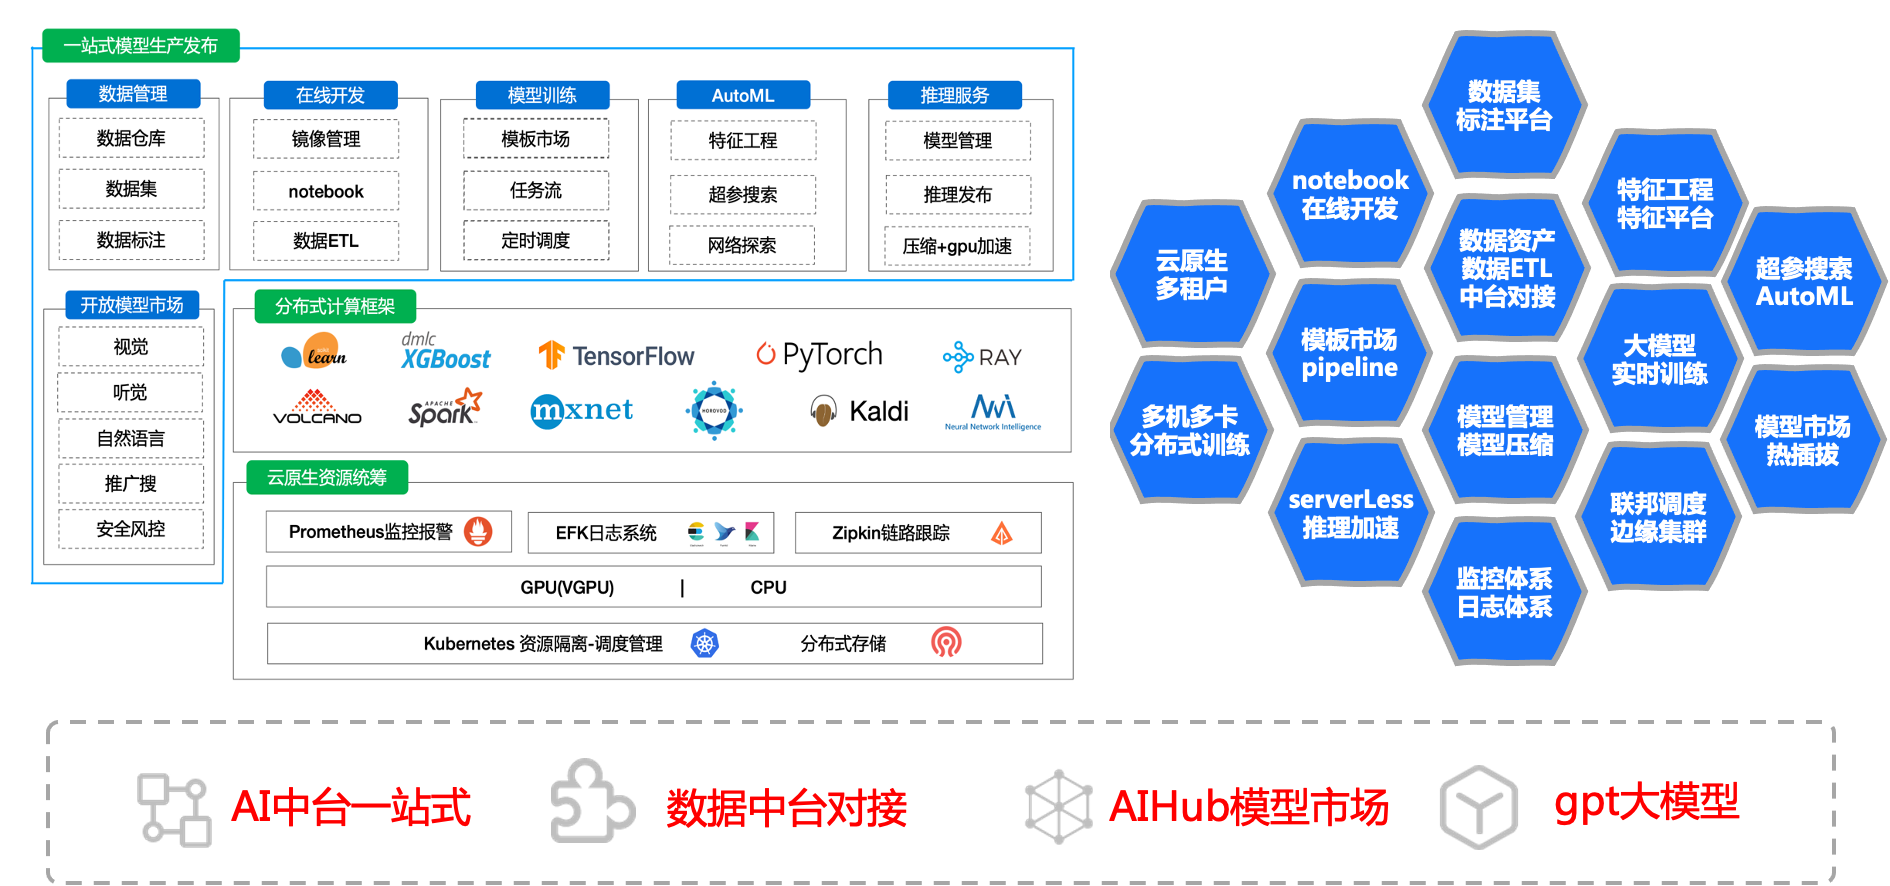
开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
云原生AI平台+4国产 NPU
2604+8224v2026.09.012026-10-12 12:57 UTC