关键词:视频生成
描述或关键词里包含「视频生成」的项目,共 130 个。找不到想要的?试试完整搜索。
输入一个主题或关键词,就能自动完成文案生成、素材匹配、配音字幕和视频合成,一键产出高清短视频,省去手工剪辑的麻烦。
用 HTML 写动画,再通过 Puppeteer 和 FFmpeg 渲染成视频,专为 AI Agent 生成动态视频内容设计。
基于 PyTorch 的扩散模型工具箱,统一加载和训练 Stable Diffusion、FLUX 等模型,做图像、视频、音频生成。
自托管的多模型 AI 图像与视频生成工作台,聚合 Flux、Midjourney、Kling、Sora 等 600+ 模型,无内容过滤,可替代闭源视频平台。
用命令行自动生成短视频并批量发布到 YouTube、Twitter,还能自动发送推广邮件,把线上赚钱流程串成一条自动化流水线。
基于 ComfyUI 的全自动短视频生成引擎,串联文生图、语音合成与视频生成,一条流水线把创意直接做成短视频。
开源视频生成模型,用高效架构和训练方案降低高质量视频制作门槛,让普通开发者也能训练和部署文生视频模型。

开源 AI 短剧与漫剧创作平台,把剧本、分镜、角色场景资产、图像和视频生成串在无限画布上,用 AI Agent 和可视化工作流完成从创意到成片,支持本地部署和自选模型。

开源的大规模视频生成模型,支持高质量文生视频,为 AIGC 视频创作提供可用的生成能力。
让视频扩散模型在普通显卡上也能跑起来,通过帧打包技术大幅降低显存占用,实现实用的长视频生成。
面向影视生产的工业级 AI Agent 平台,用可控的智能体工作流把短剧、分镜到实拍级视频的制作流程串起来。

面向创作者的开源 AI 工作台,集视频下载、翻译配音、转录、图像与视频生成、剪辑于一体,支持 120 多种语言,适合做 YouTube、TikTok 等社媒内容本地化。
用 MoviePy 自动生成 YouTube Shorts 短视频,结合 ChatGPT 写脚本、配素材,一条命令就能出片,省去手动剪辑的麻烦。
开源文生视频和图生视频模型,CogVideoX 支持从文本或图片生成视频,适合搭建视频生成推理服务。
腾讯混元开源的大规模视频生成框架,基于扩散 Transformer 把文本提示直接生成连贯视频,适合做文生视频研究和应用落地。
LTX-Video 是 Lightricks 开源的视频生成模型,支持文生视频和图生视频,基于 DiT 扩散架构,可快速生成高质量短视频。
面向全模态模型的高效推理框架,支持图像、视频、音频生成与多模态模型服务,基于 PyTorch 提供统一的推理与部署能力。
通用 AIGC 视频引擎,把剧本到成片串成一条流水线,覆盖漫剧、广告、电商和乙游等场景,省去多工具拼接的麻烦。

一站式 WebUI,基于 Diffusers 和 PyTorch 统一完成 AI 图像与视频生成、打标和后期处理,省去在多个工具间切换的麻烦。
自部署的 AI 视频工作台,能把小说和剧本自动拆成角色、场景、道具资产与分镜,生成视频并导出剪映草稿,还支持跨镜头一致性和多供应商费用追踪。
用 Stable Diffusion 做音频驱动唇形同步,让视频或虚拟人像的口型与语音对齐,适合做数字人和视频配音。
把长视频自动剪成 9:16 竖屏短视频,用 LLM 挑高光片段、Whisper 转写、自动裁切,免费无水印,替代 Opus Clip 等付费服务。

汇总视频生成、编辑等方向的扩散模型资源清单,方便快速查找和跟进相关论文与项目。
把任意脚本自动生成多风格火柴人动画视频,自动配画面、配音、字幕和音效,适合做无露脸 YouTube 频道。
开箱即用的视频扩散模型工具箱,支持文生视频和图生视频,重点解决高质量视频训练数据不足的问题。
统一视频生成推理与后训练框架,支持扩散模型加速、蒸馏和微调,帮你在有限算力下更快跑出视频。

腾讯混元推出的轻量级视频生成模型,支持文生视频和图生视频,在较小参数规模下也能生成高质量视频,适合显存和算力有限的场景部署。
把 LTX-Video 视频生成模型接入 ComfyUI 的插件,用节点式工作流就能跑文生视频和图生视频。
把视频扩散模型的推理速度提升 100–200 倍,靠一致性蒸馏、稀疏线性注意力和 SageAttention 等系统级优化,让视频生成真正跑得动。
MAGI-1 是一个大规模自回归视频生成模型,把视频拆成片段逐段预测生成,适合需要长时序连贯性的视频创作场景。

一站式本地 AI 桌面工作台,把聊天、图像与视频生成、编码智能体整合进单个免费应用,Windows/Linux 免 Docker、免终端、免云端即可跑。
收录可直接复制的 AI 图像与视频提示词,每条都附真实生成效果和来源,还提供用 agent 编辑视频的配方。
生成、驱动并定时发布 AI 角色形象,支持 LoRA 训练、图像与视频生成,把角色创作和内容排期串成一条工作流。
输入任意主题,自动生成带 TTS 旁白、字幕和章节进度条的黑底动态图形讲解视频,支持中英文,每帧都用 Remotion 代码绘制。
轻量级图像与视频生成推理框架,支持 Wan、Hunyuan、LTX 等主流视频模型及自回归扩散模型,降低多模态生成模型的部署与推理门槛。
在普通电脑上跑 MiniMax H3 视频生成,最低 8GB 显存加 16GB 内存就能用,还会根据硬件自动选择加速方案。
面向图像、视频、音频扩散模型的通用微调工具箱,支持 Stable Diffusion、Flux 等模型,帮你在自有数据上快速训练出定制生成模型。
用置信度感知的姿态引导,从单张参考图生成高质量人体动作视频,解决动作视频生成中姿态不准、画面抖动的问题。
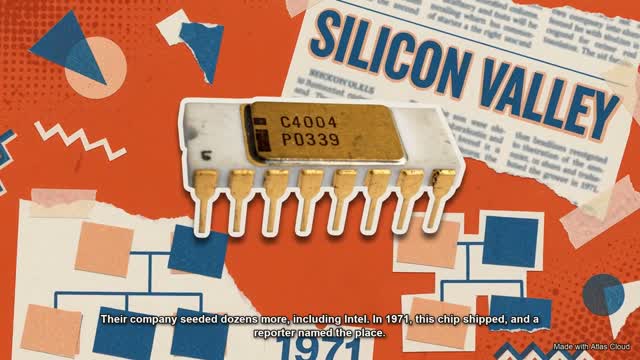
输入一个主题就能自动生成 Vox 风格的拼贴解说视频,从脚本、素材到 ffmpeg 合成全流程跑通,适合做科普短视频。
在 Apple Silicon 上用 MLX 原生跑 FLUX、Qwen-Image 等前沿图像与视频生成模型,省去 PyTorch 依赖,让 Mac 本地出图更顺畅。
收录 840+ 条 Seedance 视频生成提示词案例,每条可溯源原始帖,附跨模型复测与可安装 AI 视频技能,帮创作者快速找到能直接用的提示词。
把代码生成过程自动转成教学视频,靠多智能体协作完成脚本、代码和画面编排,适合做编程课程或技术讲解素材。
能实时生成长视频的扩散模型,支持图生视频和交互式长上下文生成,解决长视频生成速度慢、画质难兼顾的问题。
给一段喜欢的视频,就能生成风格一致的新视频;由 Claude Code 或 Codex 多智能体协作完成规划、制作和审阅。
把一句想法丢进对话,就能自动完成脚本、配图、配音到成片的 AI 视频生成多智能体系统,适合快速产出短片。
腾讯混元开源的图生视频模型,基于 HunyuanVideo 构建,支持自定义控制,把静态图片转成连贯视频。
VBench 是 CVPR2024 收录的视频生成评测基准,用多维指标客观衡量文生视频模型的质量,帮研究者横向对比不同生成方案。
浏览器里就能用的开源预演(previs)工具,可快速搭建场景、摆角色姿势、编排镜头与剪辑,再把同一套镜头交给 AI 视频模型生成。
基于 OpenAI Whisper 及其变体的字幕生成工具,提供网页界面、命令行和 Python 包三种用法,可自动为音视频生成字幕。
用自然语言加无限画布编排 AI 视频创作流程,把剧本拆解、分镜、素材生成到合成串成可编辑的工作流,支持自托管。
基于扩散模型生成逼真说话人像视频,通过连贯运动合成让口型与头部动作自然同步,适合做数字人播报和虚拟主播。
把 MiniMax 的语音合成、文生图、文生视频等生成能力封装成 MCP 服务,让 Claude 等支持 MCP 的客户端直接调用。
MIMO 是一个可控角色视频合成模型,通过空间分解建模把人物和场景拆开处理,让用户能对角色动作和画面进行精细控制。
Phantom 是一个文本到视频生成模型,通过跨模态对齐保持主体一致性,让生成视频中的角色或物体在不同镜头间保持统一外观。
Prism 是腾讯混元提出的动态稀疏注意力框架,让视频-音频联合生成模型能原生训练到 2K 分辨率,解决高分辨率多模态生成算力吃紧的问题。

基于扩散模型的时间流逝视频生成模型,能把文本提示变成物体随时间逐渐变形的延时视频,还配套了专门的延时数据集。
免训练稀疏注意力方案,可直接接入任意模型推理,加速 LLM、视觉 Transformer 和视频生成,无需重新训练即可降低注意力计算开销。
上传一张商品图,AI 自动提炼卖点、写种草脚本并配上画面配音字幕,批量生成抖音、快手、小红书、TikTok Shop 带货短视频,可本地部署、无水印。
拆解抖音爆款知识短片,自动生成导演分镜表、配音效并一键出片,适合批量做知识类短视频。
腾讯混元开源的多模态定制视频生成架构,支持音频驱动、图生视频和视频编辑,可按输入条件生成定制化视频内容。
共 130 个,这里展示前 60 个。