模型评测
基准测试与自动化评估。
开源 LLM 应用可观测与评估平台,能追踪调用链路、跑评测实验,帮团队定位问题并持续优化提示词和模型效果。
命令行基准测试工具,能对任意 shell 命令做多次运行统计,自动给出耗时分布和置信区间,方便比较不同实现的性能差异。
开源 AI 工程平台,覆盖智能体、大模型和传统机器学习,帮团队调试、评估、监控和优化生产级 AI 应用,同时控制成本并管理模型与数据访问权限。
用声明式配置对提示词、Agent 和 RAG 做自动化评测与红队渗透测试,支持多模型横向对比,可接入命令行和 CI/CD。
面向 LLM 应用、RAG 和 Agent 工作流的可观测与评测平台,提供全链路追踪、自动评估和生产级监控看板,帮团队定位问题并持续优化效果。
一个 Python 的 LLM 评测框架,提供开箱即用的评估指标,帮你在开发和上线前系统检验大模型输出质量。
面向 LLM 应用的自动化评测工具,用合成测试集和多种指标量化 RAG 与生成效果,帮你在上线前发现质量问题。
统一评测语言模型少样本能力的框架,支持多种任务和模型,方便横向对比不同模型的性能表现。
OpenCompass 是一个大模型评测平台,支持 OpenAI、Qwen、DeepSeek 等主流模型,覆盖知识、推理、代码、长上下文等 100+ 数据集,帮你系统化地跑分对比。
一行代码接入的 LLM 可观测性平台,能监控大模型调用、追踪成本与延迟,并支持评估和实验对比,方便排查线上问题。
开源的 LLM Agent 评测与测试库,能自动扫描模型和智能体的安全、公平性、幻觉等风险,帮团队在上线前发现并修复问题。
面向 AI Agent 全生命周期的优化平台,覆盖开发调试、效果评估到线上监控,帮团队把 Agent 从能跑打磨到稳定可用。
统一评测文本、图像、视频和音频任务的多模态大模型工具箱,一套流程跑完各类基准,省去为每个模态单独搭评测脚本的麻烦。
用 Python 评估里程计和 SLAM 轨迹精度,支持 EuRoC、KITTI 等数据集,输出 ATE、RPE 等指标并可视化对比。
中文语言理解测评基准,提供数据集、基线模型、预训练模型和排行榜,用于统一评估中文 NLU 模型能力。

轻量可定制的大模型评测框架,支持 LLM、VLM、AIGC 和 RAG 的效果评估与性能压测,帮团队快速跑通基准测试。
面向 RAG 研究的 Python 工具包,内置多种检索增强生成算法、数据集和评测基准,方便快速复现和对比实验。
跨语言、跨模态的嵌入模型评测基准,覆盖检索、聚类、重排序等任务,帮你选型对比不同 embedding 模型的实际效果。
专为 AI Agent 打造的开源可观测性平台,提供链路追踪、评估和数据分析,帮开发者定位 Agent 运行中的问题并持续优化效果。
在真实操作系统环境里评测多模态智能体的基准平台,支持开放式任务,覆盖 GUI 操作、命令行和代码生成等场景。
Inspect 是一个用 Python 编写的大语言模型评测框架,帮助研究者系统化地设计、运行和分析模型评估实验。
可视化编程环境,用来对 LLM 提示词做压力测试和效果对比,方便快速验证不同提示方案的表现。
斯坦福 CRFM 出品的 Python 评测框架,对基础模型和大语言模型做全面、可复现、透明的基准测试,方便横向对比模型能力。
面向小型本地大模型的编码智能体测试框架,基于终端基准评估代码生成与工具调用能力,方便对比不同小模型的实际表现。
VBench 是 CVPR2024 收录的视频生成评测基准,用多维指标客观衡量文生视频模型的质量,帮研究者横向对比不同生成方案。
Efficient Retrieval Augmentation and Generation Framework
用 Python 对多目标跟踪器做基准评测,计算 CLEAR MOT 等标准指标,方便横向对比不同跟踪算法的效果。
从任意文本自动抽取实体与关系并生成知识图谱的 Python 工具,附带基准测试,方便用 LLM 构建和评测图谱抽取流程。
用逼真的合成对话模拟来诊断和优化 LLM Agent 的框架,帮助开发者在真实上线前发现并修复 Agent 的薄弱环节。
向量数据库性能与性价比基准测试工具,支持多种向量库的统一压测和结果对比,方便选型时横向评估。

桌面版 MCP 客户端,把各家 LLM API 和 MCP 工具统一编排到一个界面里,方便快速试用和评估不同模型。
在内存中对 brotli、lz4、zstd、zlib 等开源压缩器做统一跑分对比,方便按速度和压缩比挑选合适的压缩算法。
持续基准测试平台,在 CI 中自动追踪代码性能变化,防止性能回归,适合关注代码质量的团队。
OpenCUA 提供构建电脑操作智能体(CUA)的开放基础,包含数据集、基础模型和评测基准,让 GUI 自动化智能体有可复现的训练与评估方案。
在浏览器里跑安卓模拟器,为移动 GUI 智能体提供可验证、高并发的评测与在线强化学习训练环境。
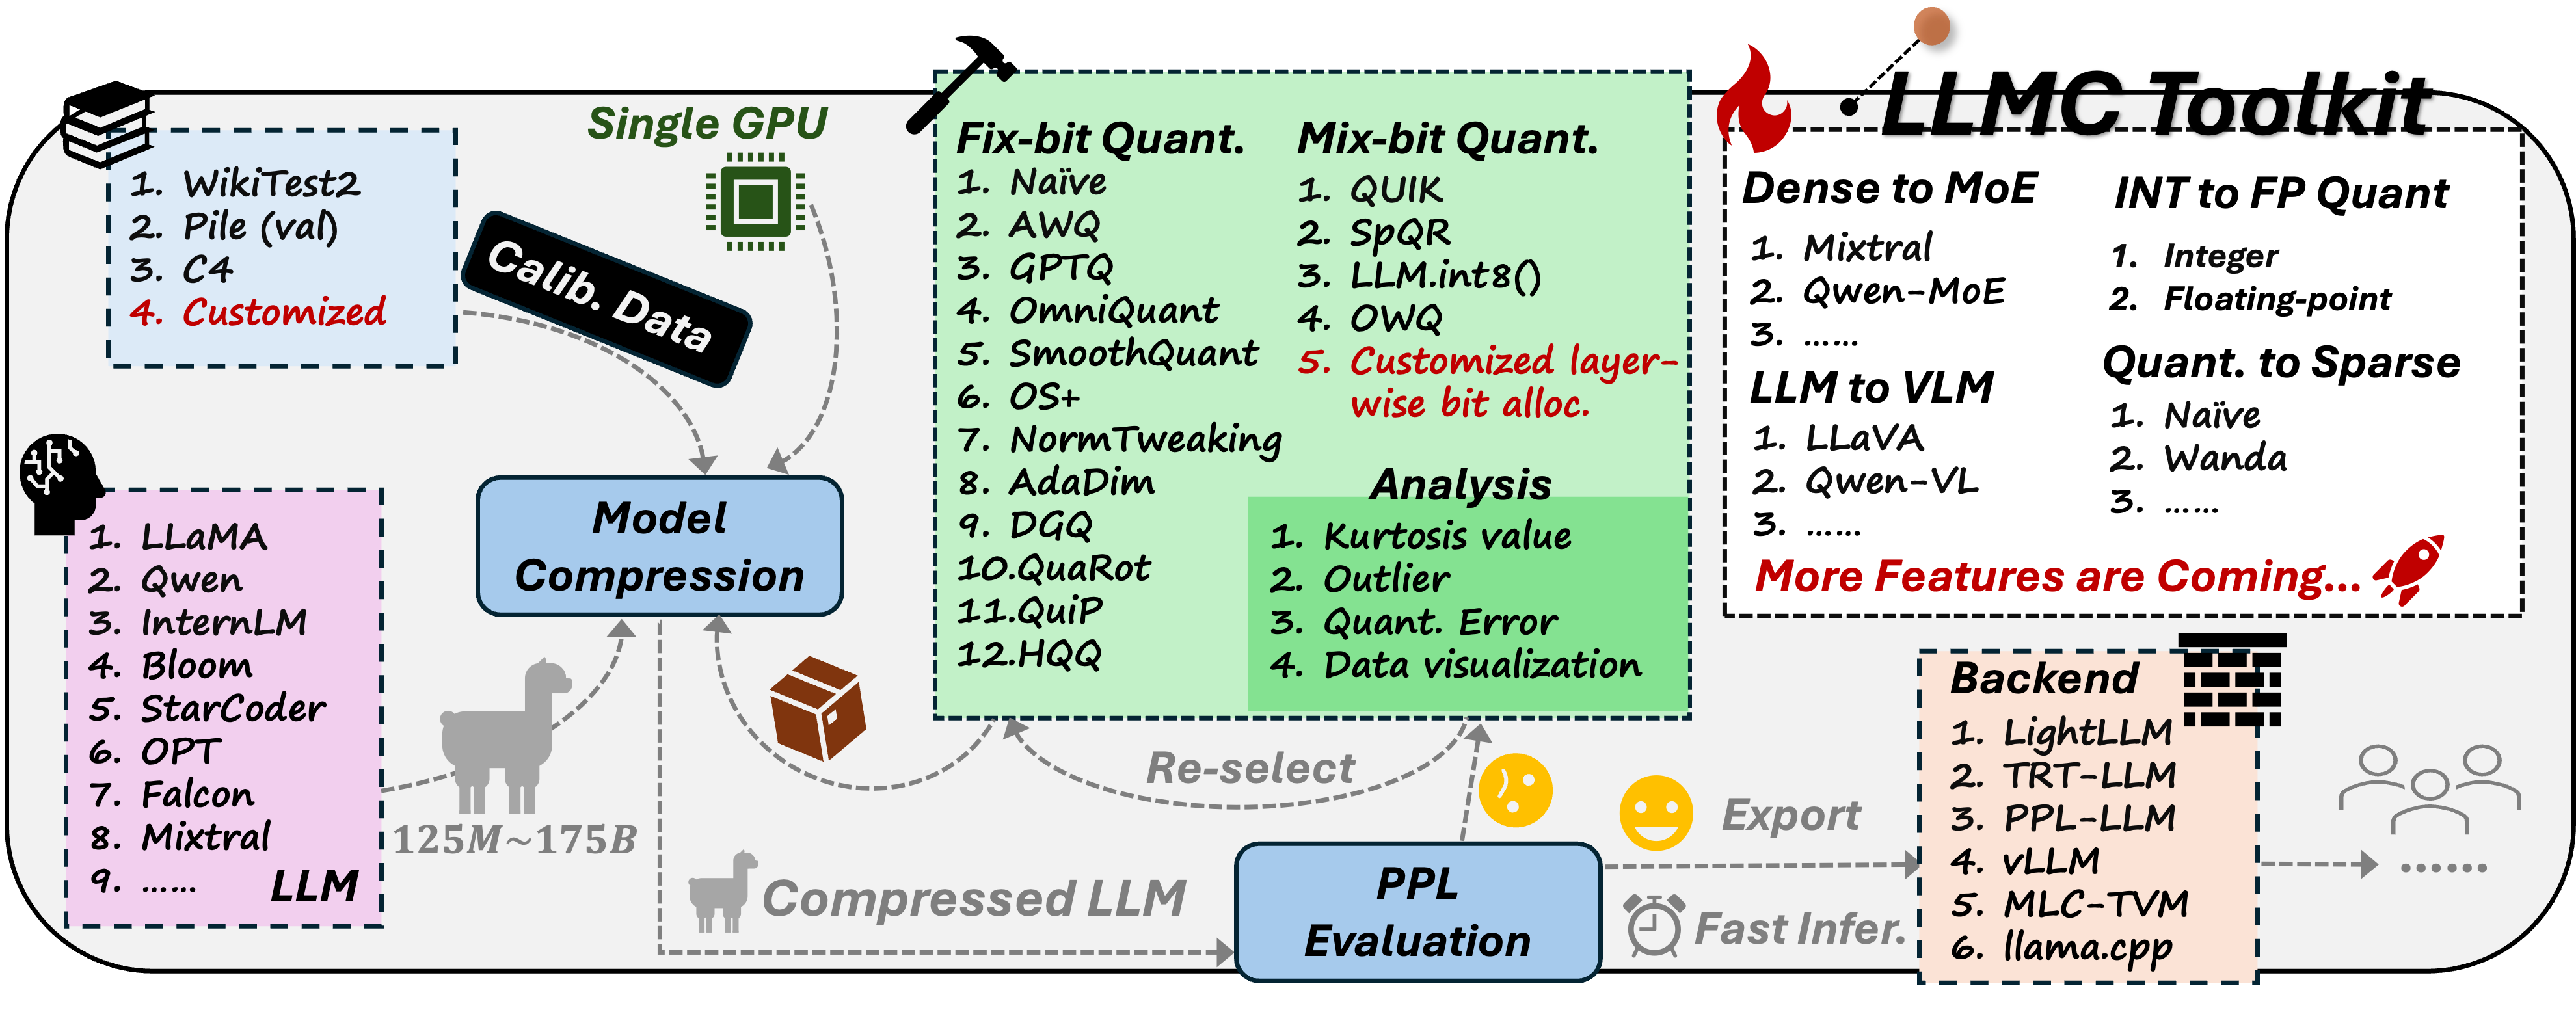
一站式大模型压缩工具箱,支持 LLM、VLM 和视频生成模型的量化与剪枝,覆盖 AWQ、SmoothQuant 等算法,并提供压缩后的评测与部署流程。
把视觉语言模型变成通用多模态嵌入模型,配套 MMEB 系列基准,用于图文视频检索和 RAG 场景的表示学习评测。
面向 AI Agent 的文档解析评测基准,覆盖 OCR、PDF 解析和表格抽取,用统一指标对比不同模型与工具在真实文档上的解析效果。
面向企业内部文档场景的 RAG 数据集与评测基准,提供标准化测试集和评估流程,用来衡量检索增强生成系统在企业知识库上的真实表现。
跨平台命令行工具,用同一套测试测 CPU、GPU、NPU 的峰值算力、内存带宽和延迟,覆盖 CUDA、Metal、OpenCL 等主流 API。
OpenRCA 是 ICLR'25 提出的基准,用来评测大语言模型和 LLM Agent 能否在软件故障中定位根因,为根因分析能力提供统一测试标准。
OSWorld 2.0 是一个评测基准,专门衡量计算机操作智能体在长周期真实任务中的表现,帮研究者检验模型能否连续完成多步桌面操作。
统一训练、微调和评测世界动作模型(WAM)的框架,面向具身智能与机器人研究,支持 LoRA 微调并内置基准测试。

把视频流转化为整体 3D 空间智能的 ICML 2026 Oral 工作,配套基准用于评测视觉语言模型的空间理解能力。
一套用于压测向量搜索引擎的基准框架,可对比不同向量数据库的检索性能,帮你在选型时拿到实测数据。
一站式 AI 治理与 LLM 评测平台,内置 EU AI Act、ISO 42001、NIST AI RMF 等 20 多个合规框架,帮团队做模型审计、风险评估和合规落地。
T2I-CompBench 是评估文生图模型组合能力的基准,覆盖属性绑定、物体关系和数量等维度,帮研究者量化模型是否真的画对了提示词。
用 Python 给 LLM 生成的回答跑评测的 SDK,内置多种评测指标,方便在 LLMOps 流程里量化模型输出质量。
对本地大模型服务做并发压力测试,自动跑多轮请求并生成性能报告,方便对比 Ollama、vLLM 等推理后端的吞吐和延迟表现。
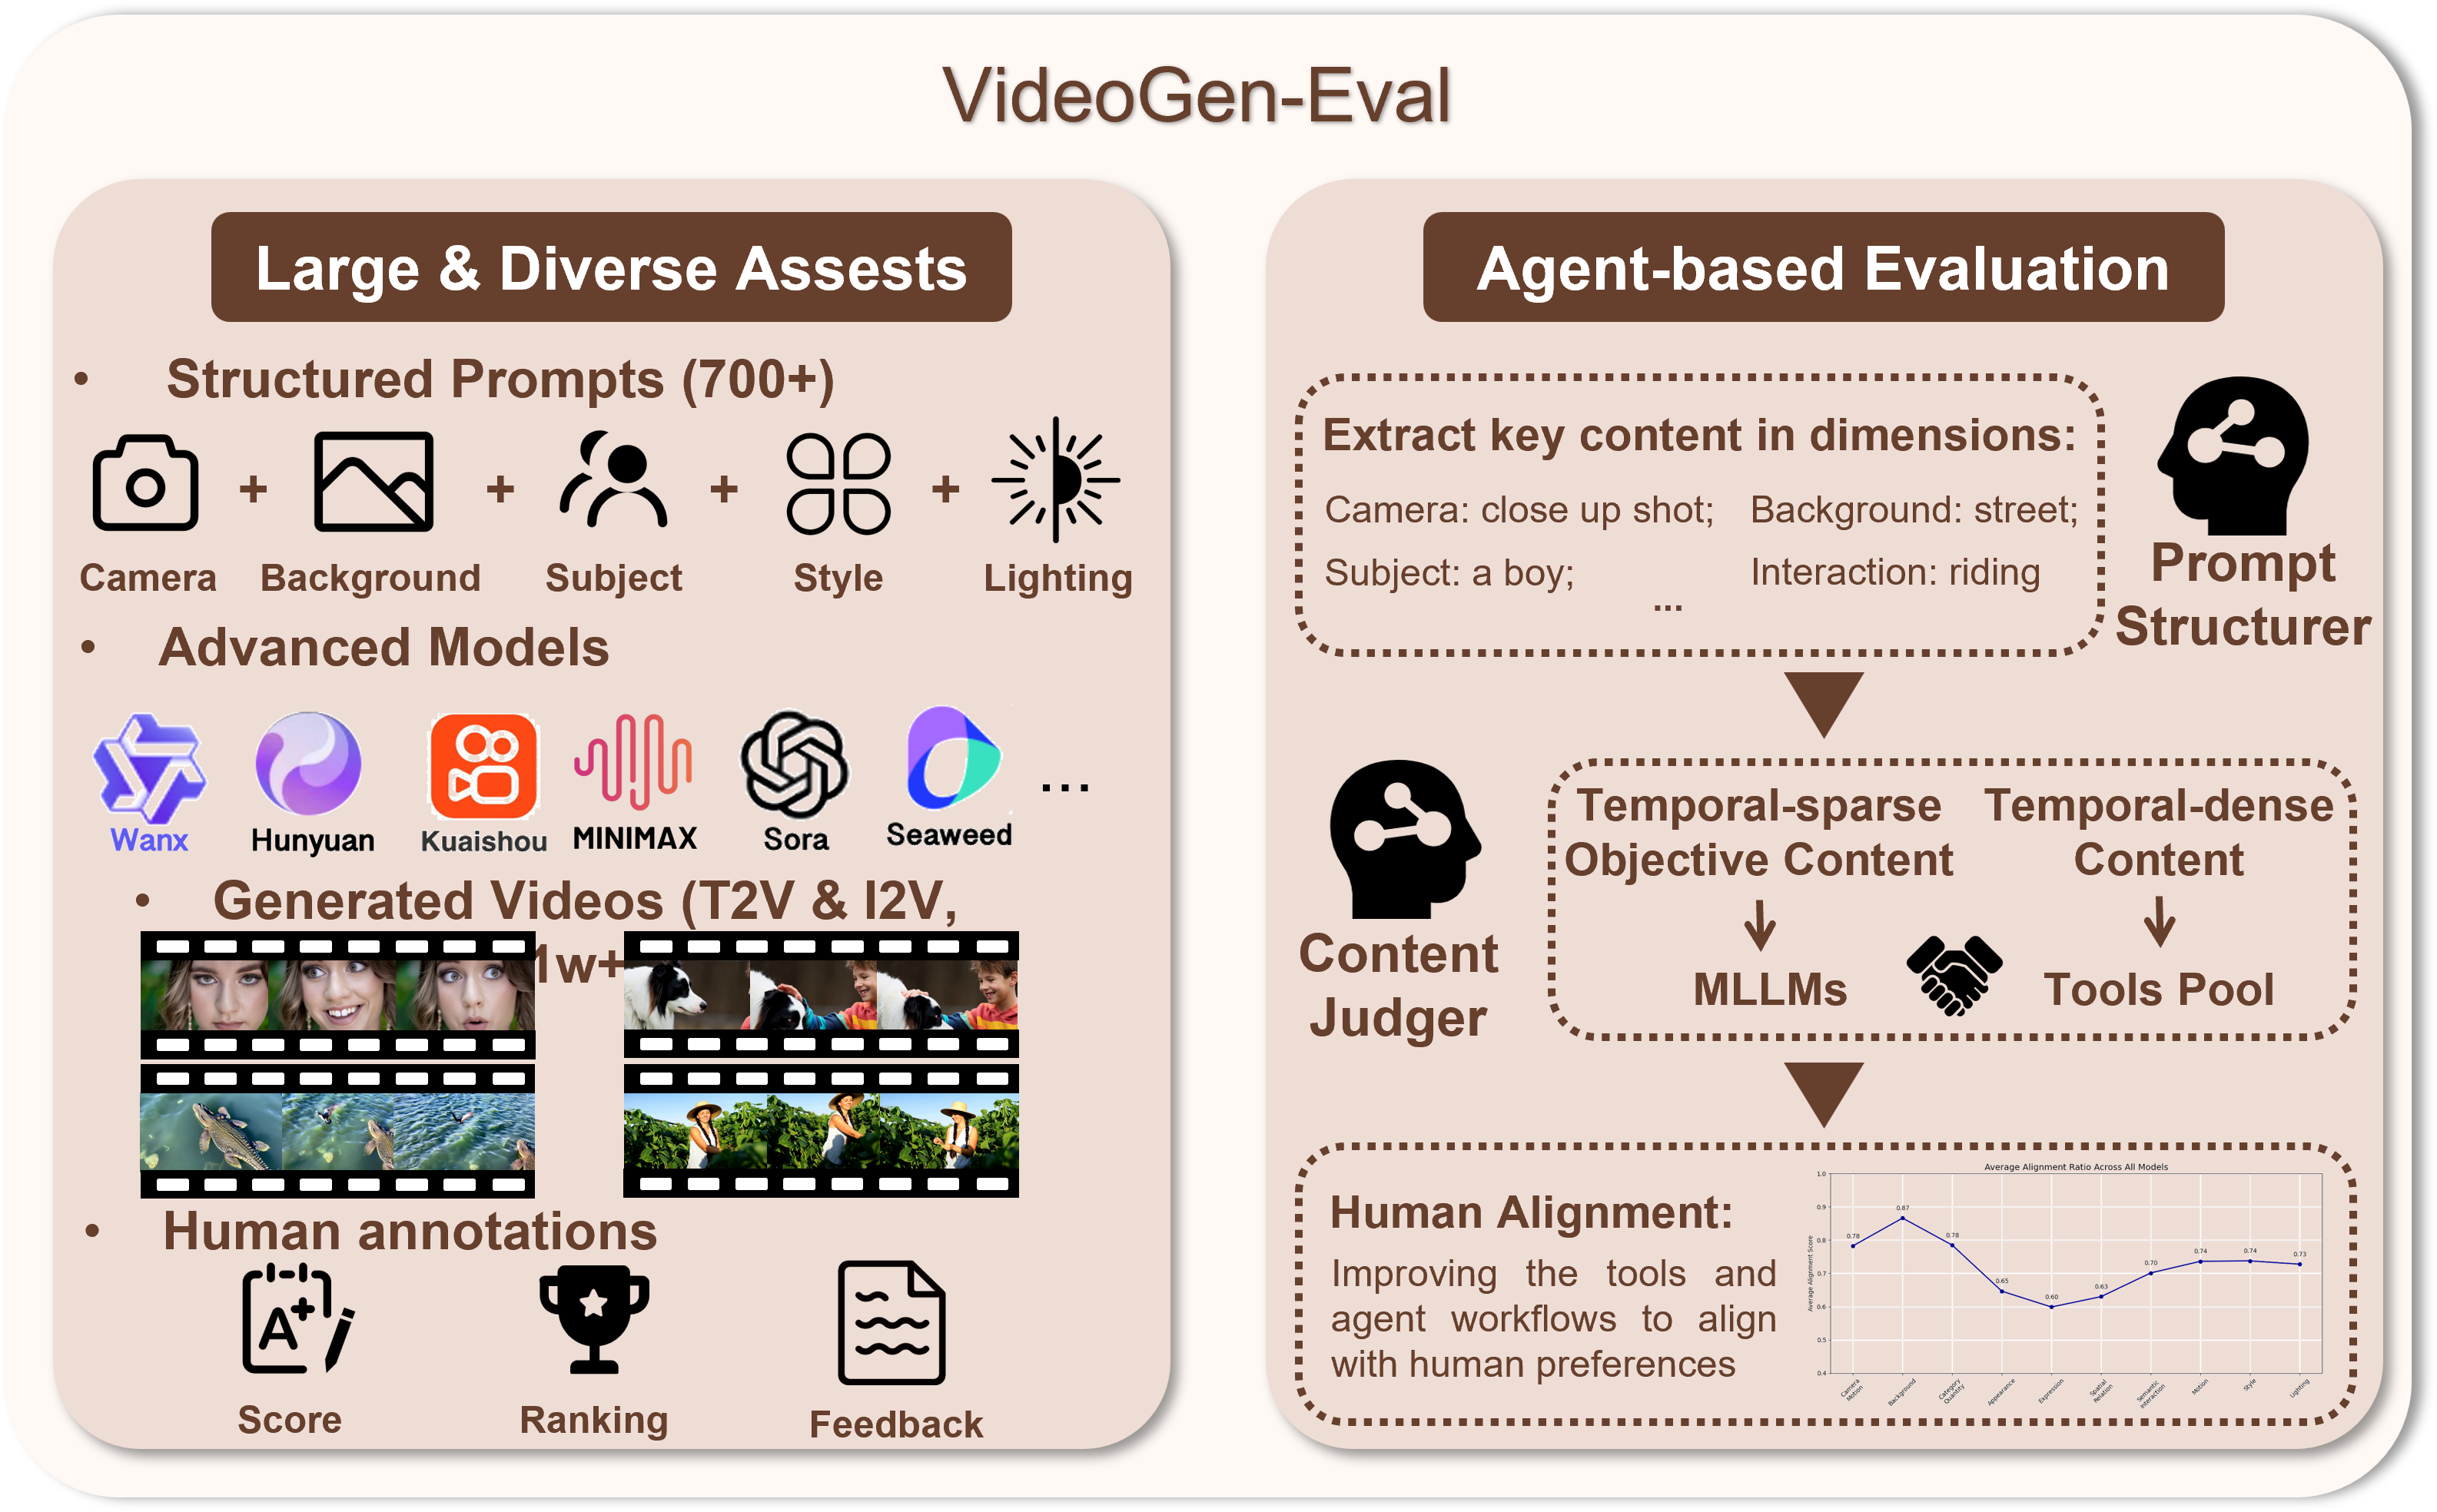
基于智能体的视频生成评测系统,用自动化方式给文生视频、图生视频等模型的生成质量打分,省去人工逐条评估的麻烦。
面向多模态游戏智能体的标准化评测基准,提供可验证的评测流程,用来衡量智能体在游戏环境中的真实表现。
面向 ONNX 工作流的无代码命令行工具,能一键完成模型转换、基准测试和本地部署,省去手写脚本的麻烦。

OpenS2V-Nexus 是面向主体到视频生成(S2V)的评测基准与百万级数据集,提供评估工具包,用来衡量模型在保持指定主体一致性上的生成效果。

用 Crystal 写的单二进制 HTTP 压测工具,面向 CI/CD 流水线,提供真实延迟统计、阈值校验和 JSON 输出,方便在流水线里卡性能回归。

ChronoMagic-Bench 是 NeurIPS 2024 提出的文本到延时视频生成评测基准,用变形评估衡量扩散模型生成延时视频的质量。