推理与服务
751 个仓库把模型跑起来:吞吐、延迟、显存、批量调度与 API 服务化。
跨平台语音转文字听写应用,支持本地 Nvidia Parakeet/Whisper 模型和自带密钥的云端模型,主打隐私优先。
面向云端和数据中心的高性能推理服务端,支持多种深度学习框架模型部署,并可在边缘设备上运行。
Amazon SageMaker 官方示例集,用 Jupyter Notebook 演示如何构建、训练和部署机器学习模型,适合上手 MLOps 全流程。
Large Language Model Text Generation Inference

开源 API 与 AI 网关,统一代理 REST、GraphQL、TCP、gRPC 和 MCP 流量,帮你在微服务和 LLM 调用前做路由、鉴权与限流。
Official inference library for Mistral models
把分散在多家云上的 GPU 资源统一调度成一台「AI 超算」,自动选最便宜的可用算力跑训练、微调和推理任务,省去手动比价与跨云管理。

基于 PyTorch 的 YOLOv3 系列实现,覆盖训练、验证、推理全流程,并支持导出 ONNX、CoreML、TensorRT 等多种格式,方便做实时目标检测和边缘部署。

端到端语音处理工具箱,覆盖语音识别、合成、翻译、增强、分离和说话人日志等任务,基于 PyTorch 提供统一训练与推理流程。
面向本地部署的高速大模型推理引擎,通过稀疏激活与量化等技术,让消费级显卡也能流畅跑起 Llama 类模型。
SeaTunnel 是高性能分布式数据集成工具,支持批处理、CDC 变更捕获和多模态数据接入,用于海量数据在异构系统间高效同步。
基于 Envoy 的云原生 AI 网关,统一代理和路由大模型 API 与微服务流量,支持 AI 原生插件扩展。
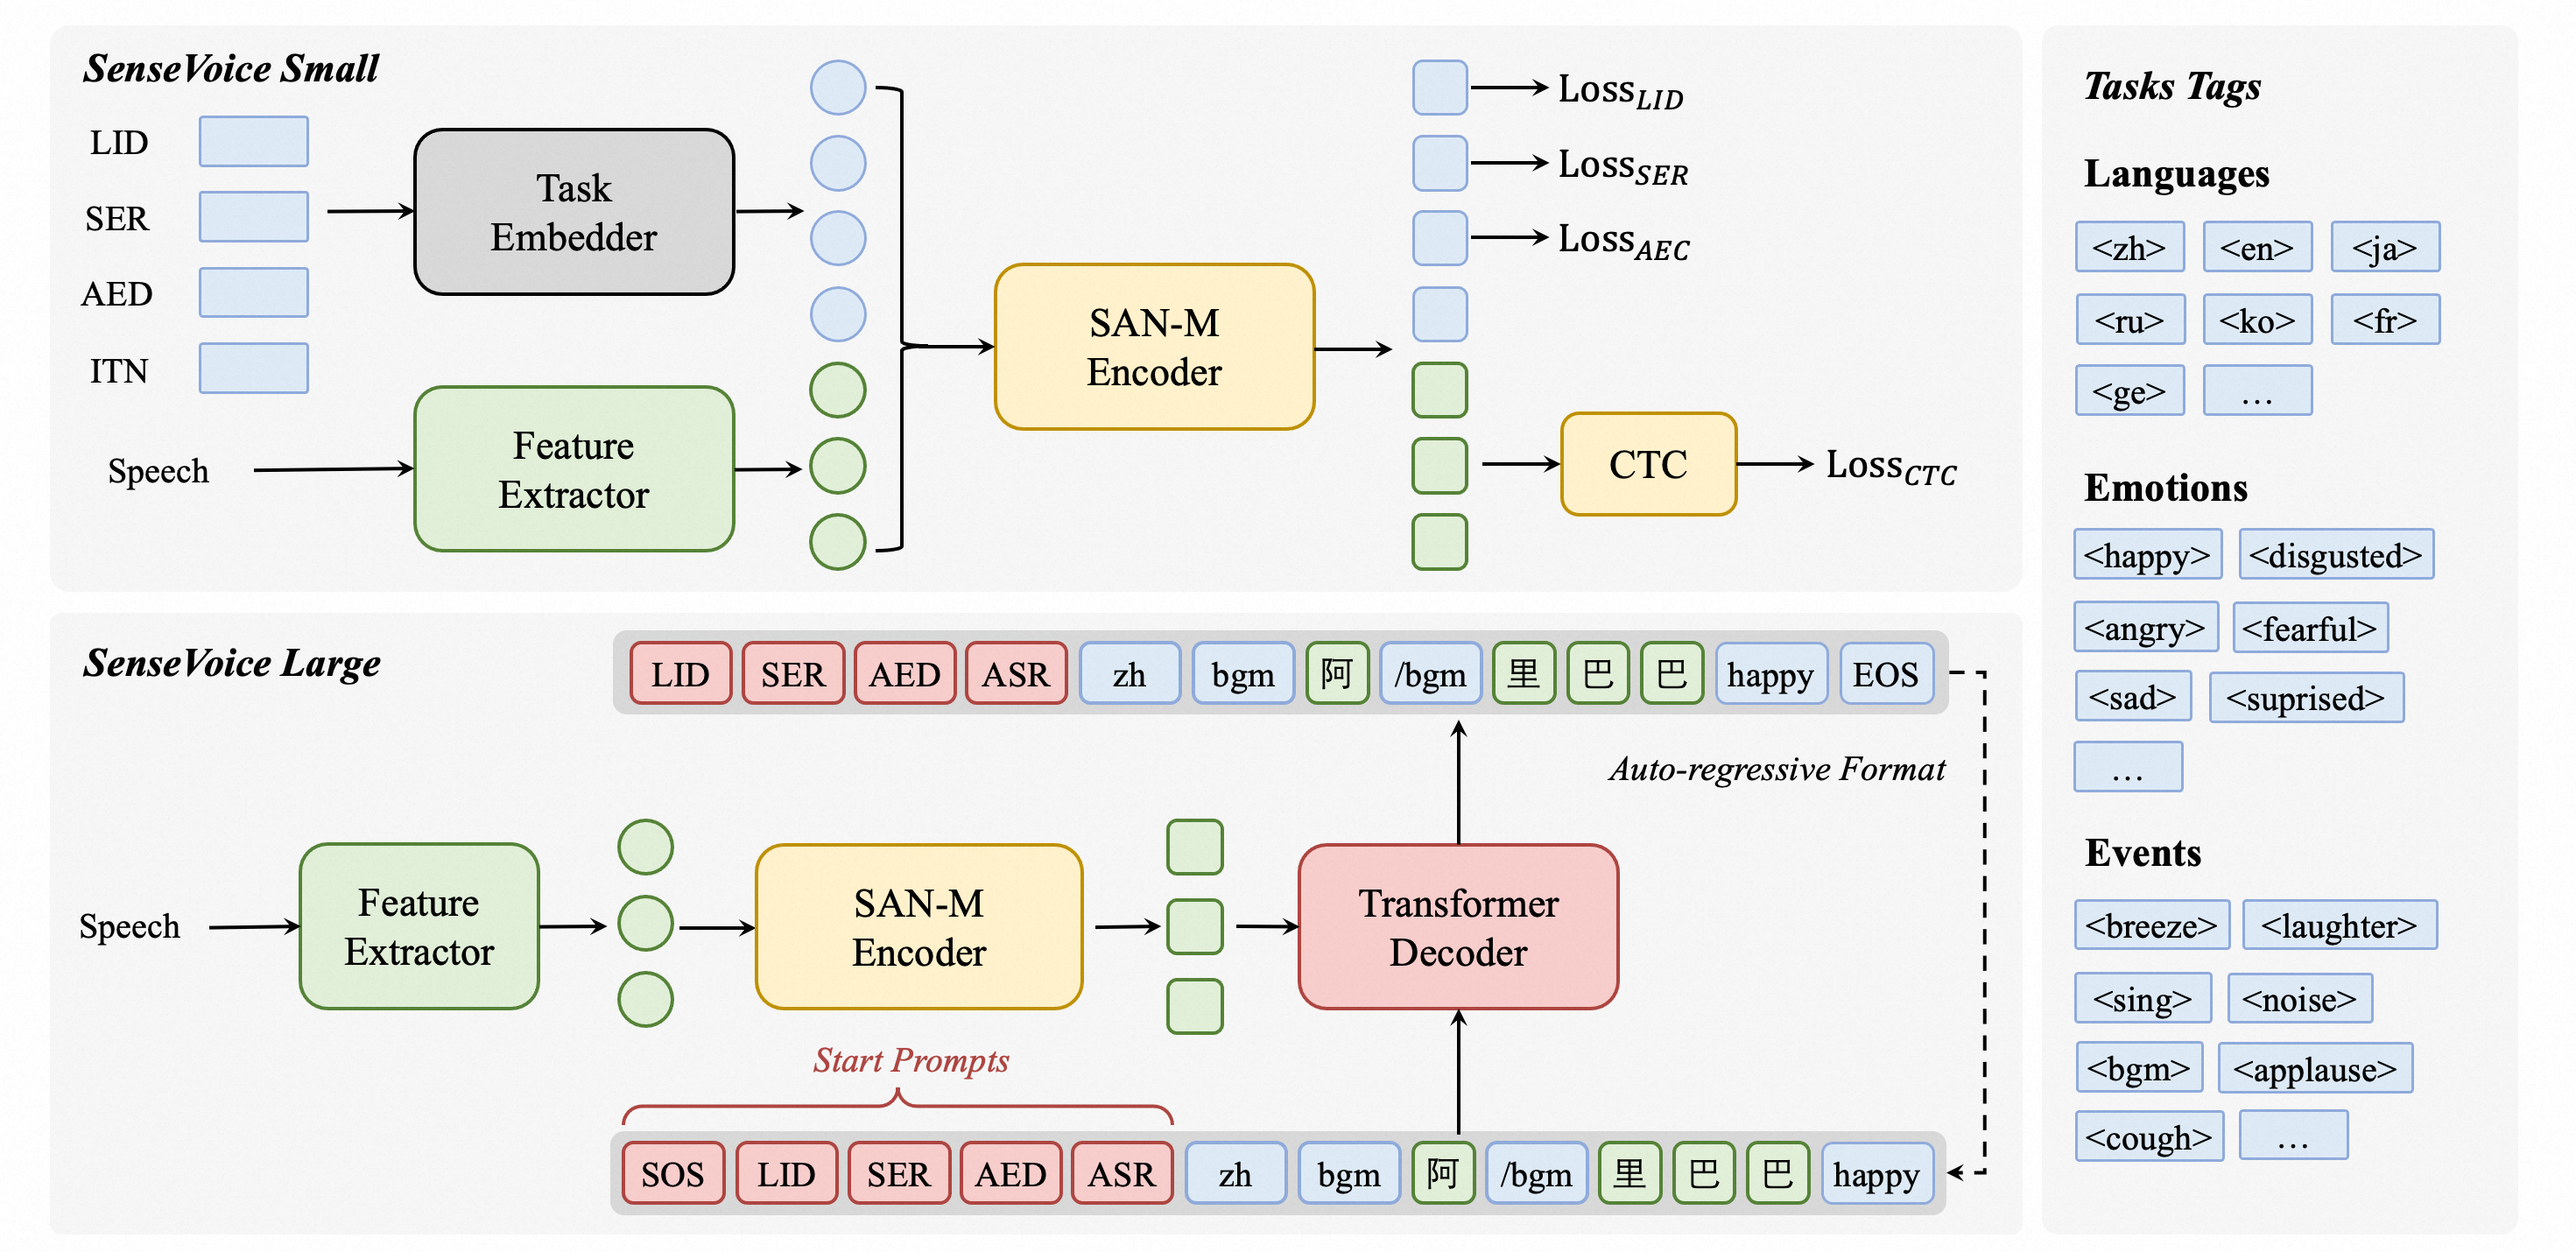
多语种语音理解模型,一次推理就能完成中英日韩粤语音识别、语种判别、情绪识别和音频事件检测,适合做语音交互与音频分析。
一行代码就能把 GPT 换成任意开源大模型,统一推理 API 支持云端、本地和笔记本部署,覆盖语言、语音和多模态模型。
用纯 RNN 架构的 RWKV 语言模型驱动的开源聊天机器人,效果对标 ChatGPT,可在本地部署运行。

高性能 AI 网关,用一套 OpenAI 兼容 API 统一接入上万模型,内置故障转移、负载均衡、语义缓存、虚拟密钥与预算管控,额外延迟低于 200µs。
一份持续更新的异常检测资源大全,汇总书籍、论文、视频和工具箱,覆盖传统方法与最新的 LLM、VLM 工作,适合快速入门和跟进前沿。

企业级多租户 LLM 网关,统一接入 200+ 模型和 35+ 供应商,带负载均衡、计费订阅和成本管理,适合团队统一管理 AI 调用。
汇总全球优质大模型学习资料,覆盖多模态生成、Agent、辅助编程、模型训练与推理、RAG 等方向,帮开发者快速找到教程、课程和实战资源。

面向 NVIDIA Jetson 嵌入式设备的深度学习推理部署指南,用 TensorRT 加速图像识别等视觉任务,配套教程和预训练模型开箱即用。
Python 语音识别库,统一封装多种在线和离线引擎与 API,几行代码就能把音频转成文字,省去逐个对接各家服务的麻烦。
Accelerate local LLM inference and finetuning (LLaMA, Mistral, ChatGLM, Qwen, DeepSeek, Mixtral, Gemma, Phi, MiniCPM, Qwen-VL, MiniCPM-V, etc.) on Intel XPU (e.g., local PC with iGPU and NPU, discrete GPU such as Arc, Flex and Max); seamlessly integrate with llama.cpp, Ollama, HuggingFace, LangChain, LlamaIndex, vLLM, DeepSpeed, Axolotl, etc.

让大模型在普通显卡上跑起来的 PyTorch 量化库,支持 8-bit 和 4-bit 权重压缩,也是 QLoRA 微调背后的核心依赖。
在骁龙设备的 NPU、GPU 和 CPU 上本地跑大模型和多模态模型,几行代码就能接入,省去自己适配硬件的麻烦。