语音推理
ASR / TTS 推理引擎与端侧语音方案。

本地运行的 ElevenLabs 开源替代品,支持声音克隆、语音设计、视频配音、听写、转写和有声书制作,覆盖 646 种语言。

开源 AI 语音工作室,支持声音克隆、语音听写和语音生成,基于 Qwen3-TTS 与 Whisper,可在 CUDA 或 MLX 上本地运行。
OpenAI Whisper 语音识别模型的 C/C++ 移植版,无需 Python 和 GPU 依赖,在普通 CPU 上就能跑语音转文字。
本地运行的 AI 会议记录工具,用 Whisper/Parakeet 在设备上完成转写和说话人分离,不需要会议机器人,会议内容不出本机。
DeepSpeech is an open source embedded (offline, on-device) speech-to-text engine which can run in real time on devices ranging from a Raspberry Pi 4 to high power GPU servers.
基于 CTranslate2 重实现的 Whisper 语音转文字推理引擎,通过量化与高效推理大幅提速并降低显存占用,适合本地部署转录。
基于 Whisper 的语音识别工具,能给出词级时间戳并支持说话人分离,适合做字幕对齐和会议转写。
基于 OpenAI Whisper 的离线音频转写与翻译工具,在本机就能把语音转成文字并翻译,不用联网也不上传数据。
开源语音识别工具包,覆盖训练、推理、流式 ASR、VAD、标点恢复和说话人分离全流程,并提供 OpenAI 兼容与 MCP 服务接口。
把视频从一种语言翻译成另一种语言,自动生成配音和字幕并嵌入视频,适合做视频本地化和跨语言内容分发。
面向语音 AI 的可扩展生成式框架,覆盖语音识别、语音合成、说话人分离与语音翻译,方便研究和开发人员训练部署语音模型。
开源的个人 AI 助手,可本地离线运行,通过语音或文字对话帮你处理日程、查询信息、执行自动化任务。
基于新一代 Kaldi 和 onnxruntime 的离线语音工具包,一套搞定语音识别、合成、说话人分离、降噪、声源分离和 VAD,可跑在嵌入式、手机和服务器上。
Kaldi 是经典的语音识别工具库,提供声学建模、解码和说话人识别等完整流程,适合搭建语音转文字与说话人验证系统。
离线语音识别 API,支持 Android、iOS、树莓派和服务器,提供 Python、Java、C#、Node 多语言绑定,适合注重隐私、不依赖云端的语音转文字场景。
面向创作者和开发者的 Gradio 语音工作台,集成多引擎 TTS、零样本声音克隆、Whisper 转写、人声分离与多语言翻译,一站式完成配音和字幕制作。
汇总深度学习、强化学习、计算机视觉和 NLP 等方向的优质公开课与讲座资源,适合系统入门或查漏补缺。

开箱即用的语音工具包,覆盖流式语音识别、语音合成、声纹识别、语音翻译和关键词唤醒,自带标点恢复与文本前端,适合快速搭建语音推理服务。

基于 PyTorch 的开源语音工具包,覆盖语音识别、说话人识别与分离、语音增强等任务,提供预训练模型和训练流程,方便快速搭建语音系统。
超低延迟的语音转文字、意图识别和语音合成工具,用来搭建语音助手和语音交互界面,响应快、适合实时对话场景。
本地跑实时语音转文字,带流式识别、说话人分离和翻译,还兼容 OpenAI/Deepgram 接口,适合自建低延迟转写服务。
跨平台语音转文字听写应用,支持本地 Nvidia Parakeet/Whisper 模型和自带密钥的云端模型,主打隐私优先。

端到端语音处理工具箱,覆盖语音识别、合成、翻译、增强、分离和说话人日志等任务,基于 PyTorch 提供统一训练与推理流程。
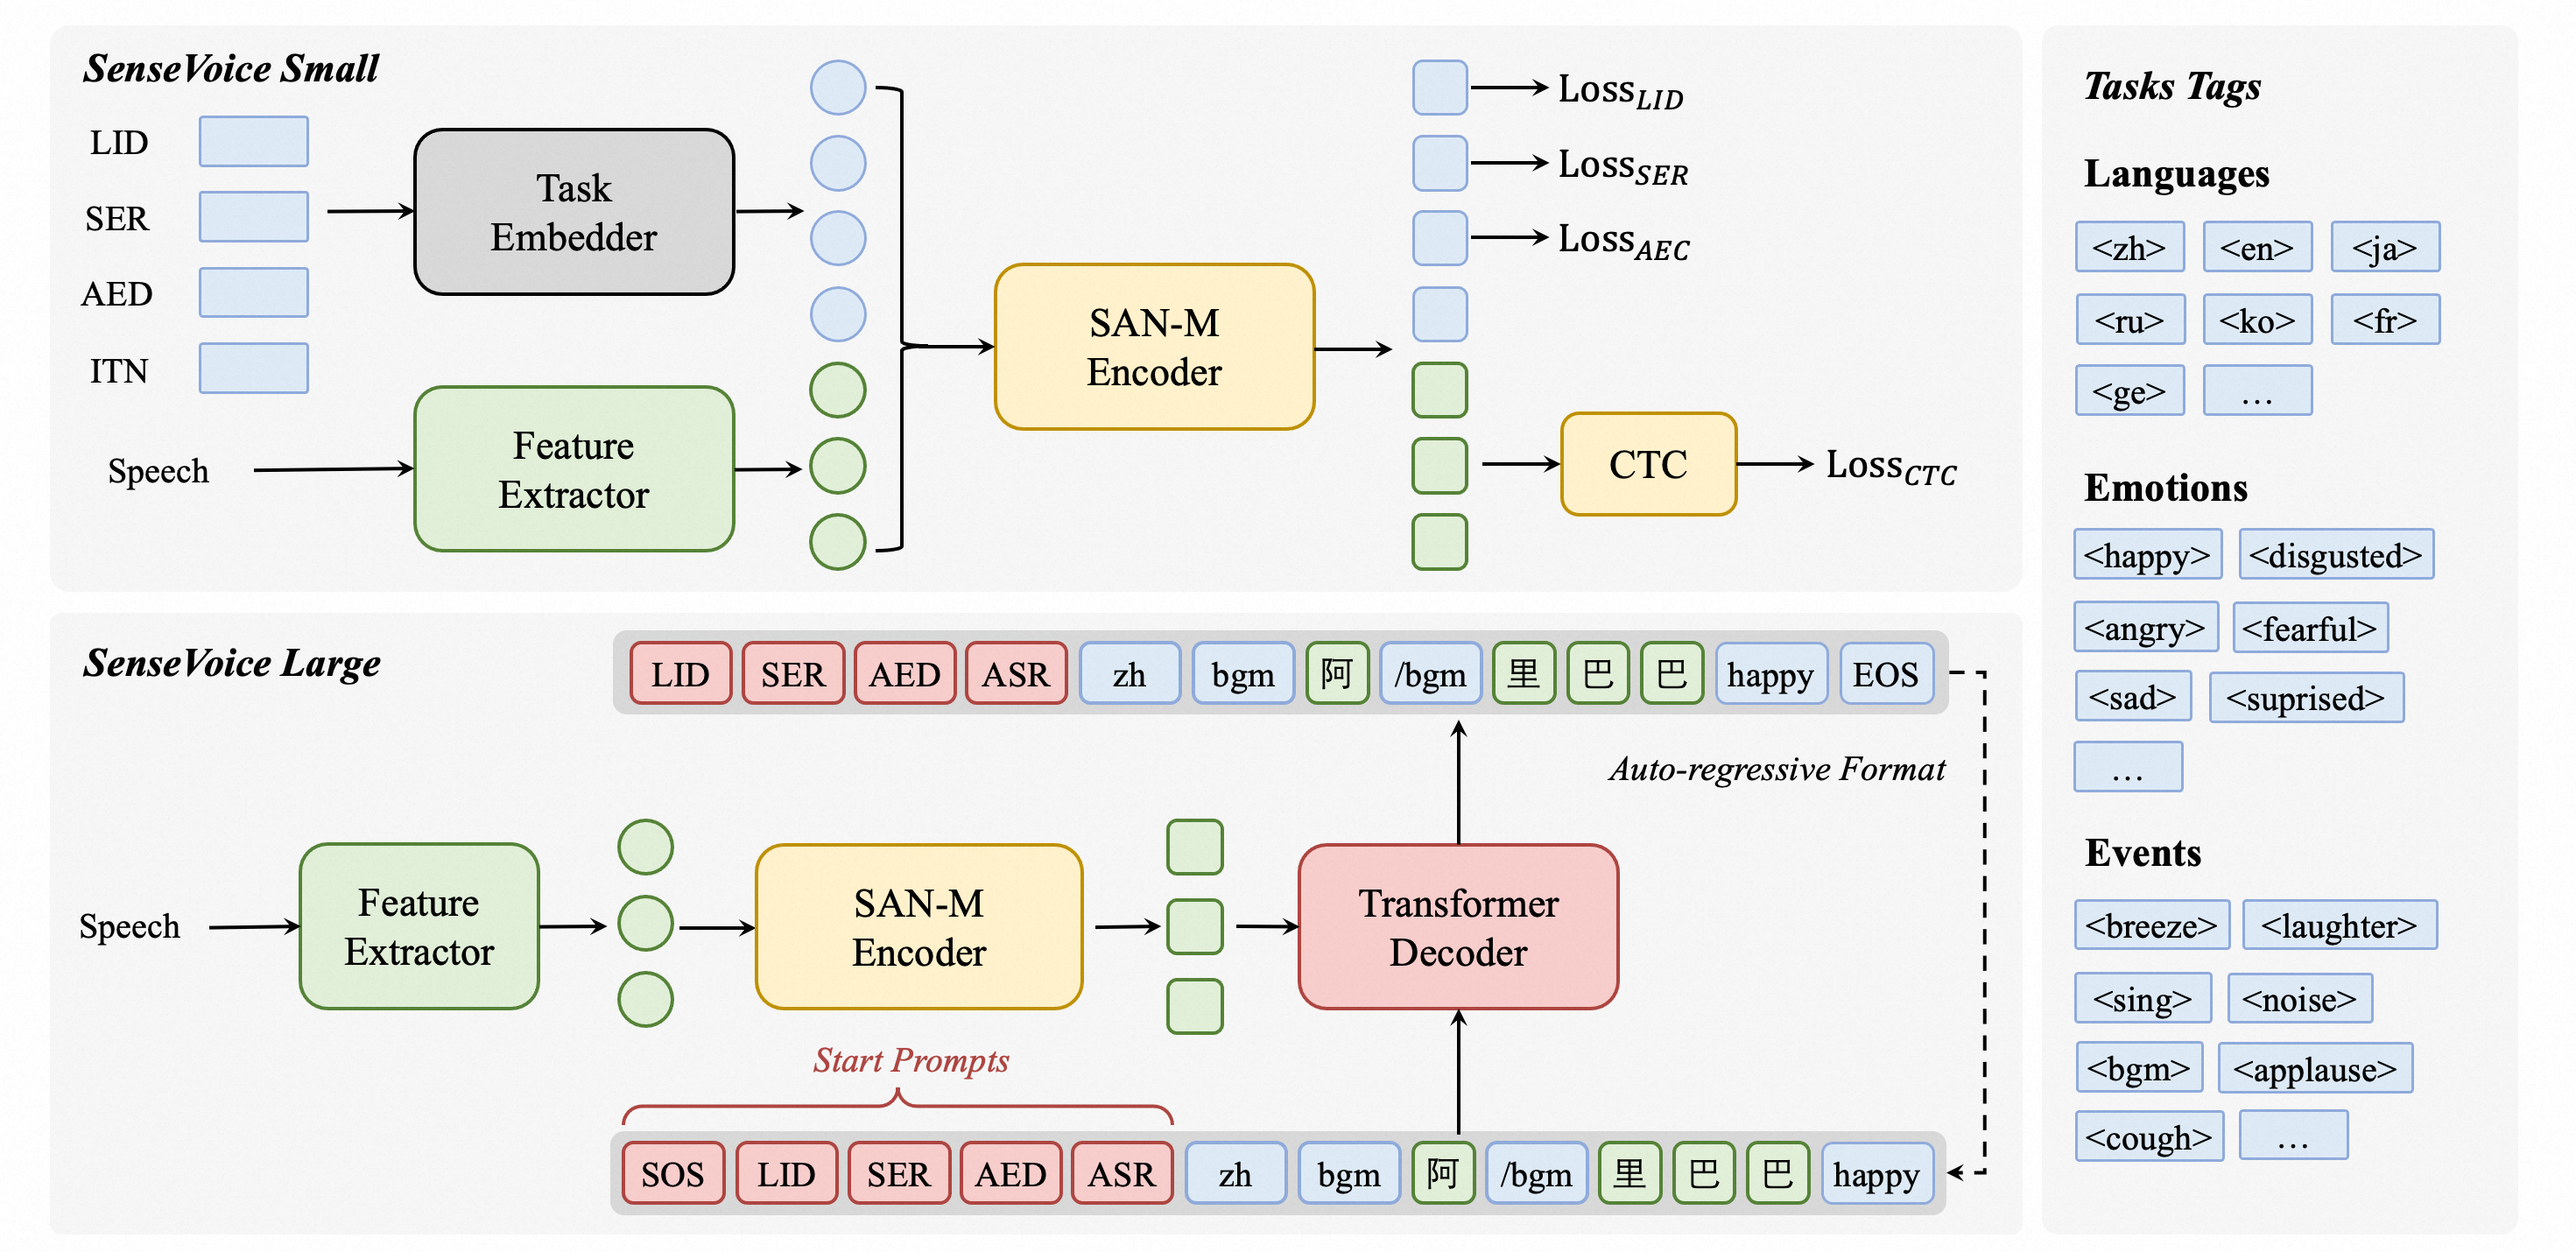
多语种语音理解模型,一次推理就能完成中英日韩粤语音识别、语种判别、情绪识别和音频事件检测,适合做语音交互与音频分析。
Python 语音识别库,统一封装多种在线和离线引擎与 API,几行代码就能把音频转成文字,省去逐个对接各家服务的麻烦。

基于深度学习的中文语音识别系统,用 CNN+CTC 把中文语音转成文字,适合搭建本地语音转写服务。
跨平台桌面端语音转写工具,基于 Whisper 在本地把音视频转成文字,不用上传云端,隐私和离线场景都能用。
给网页加语音识别的前端库,几行代码就能让站点听懂用户说话,支持语音指令和语音转文字。
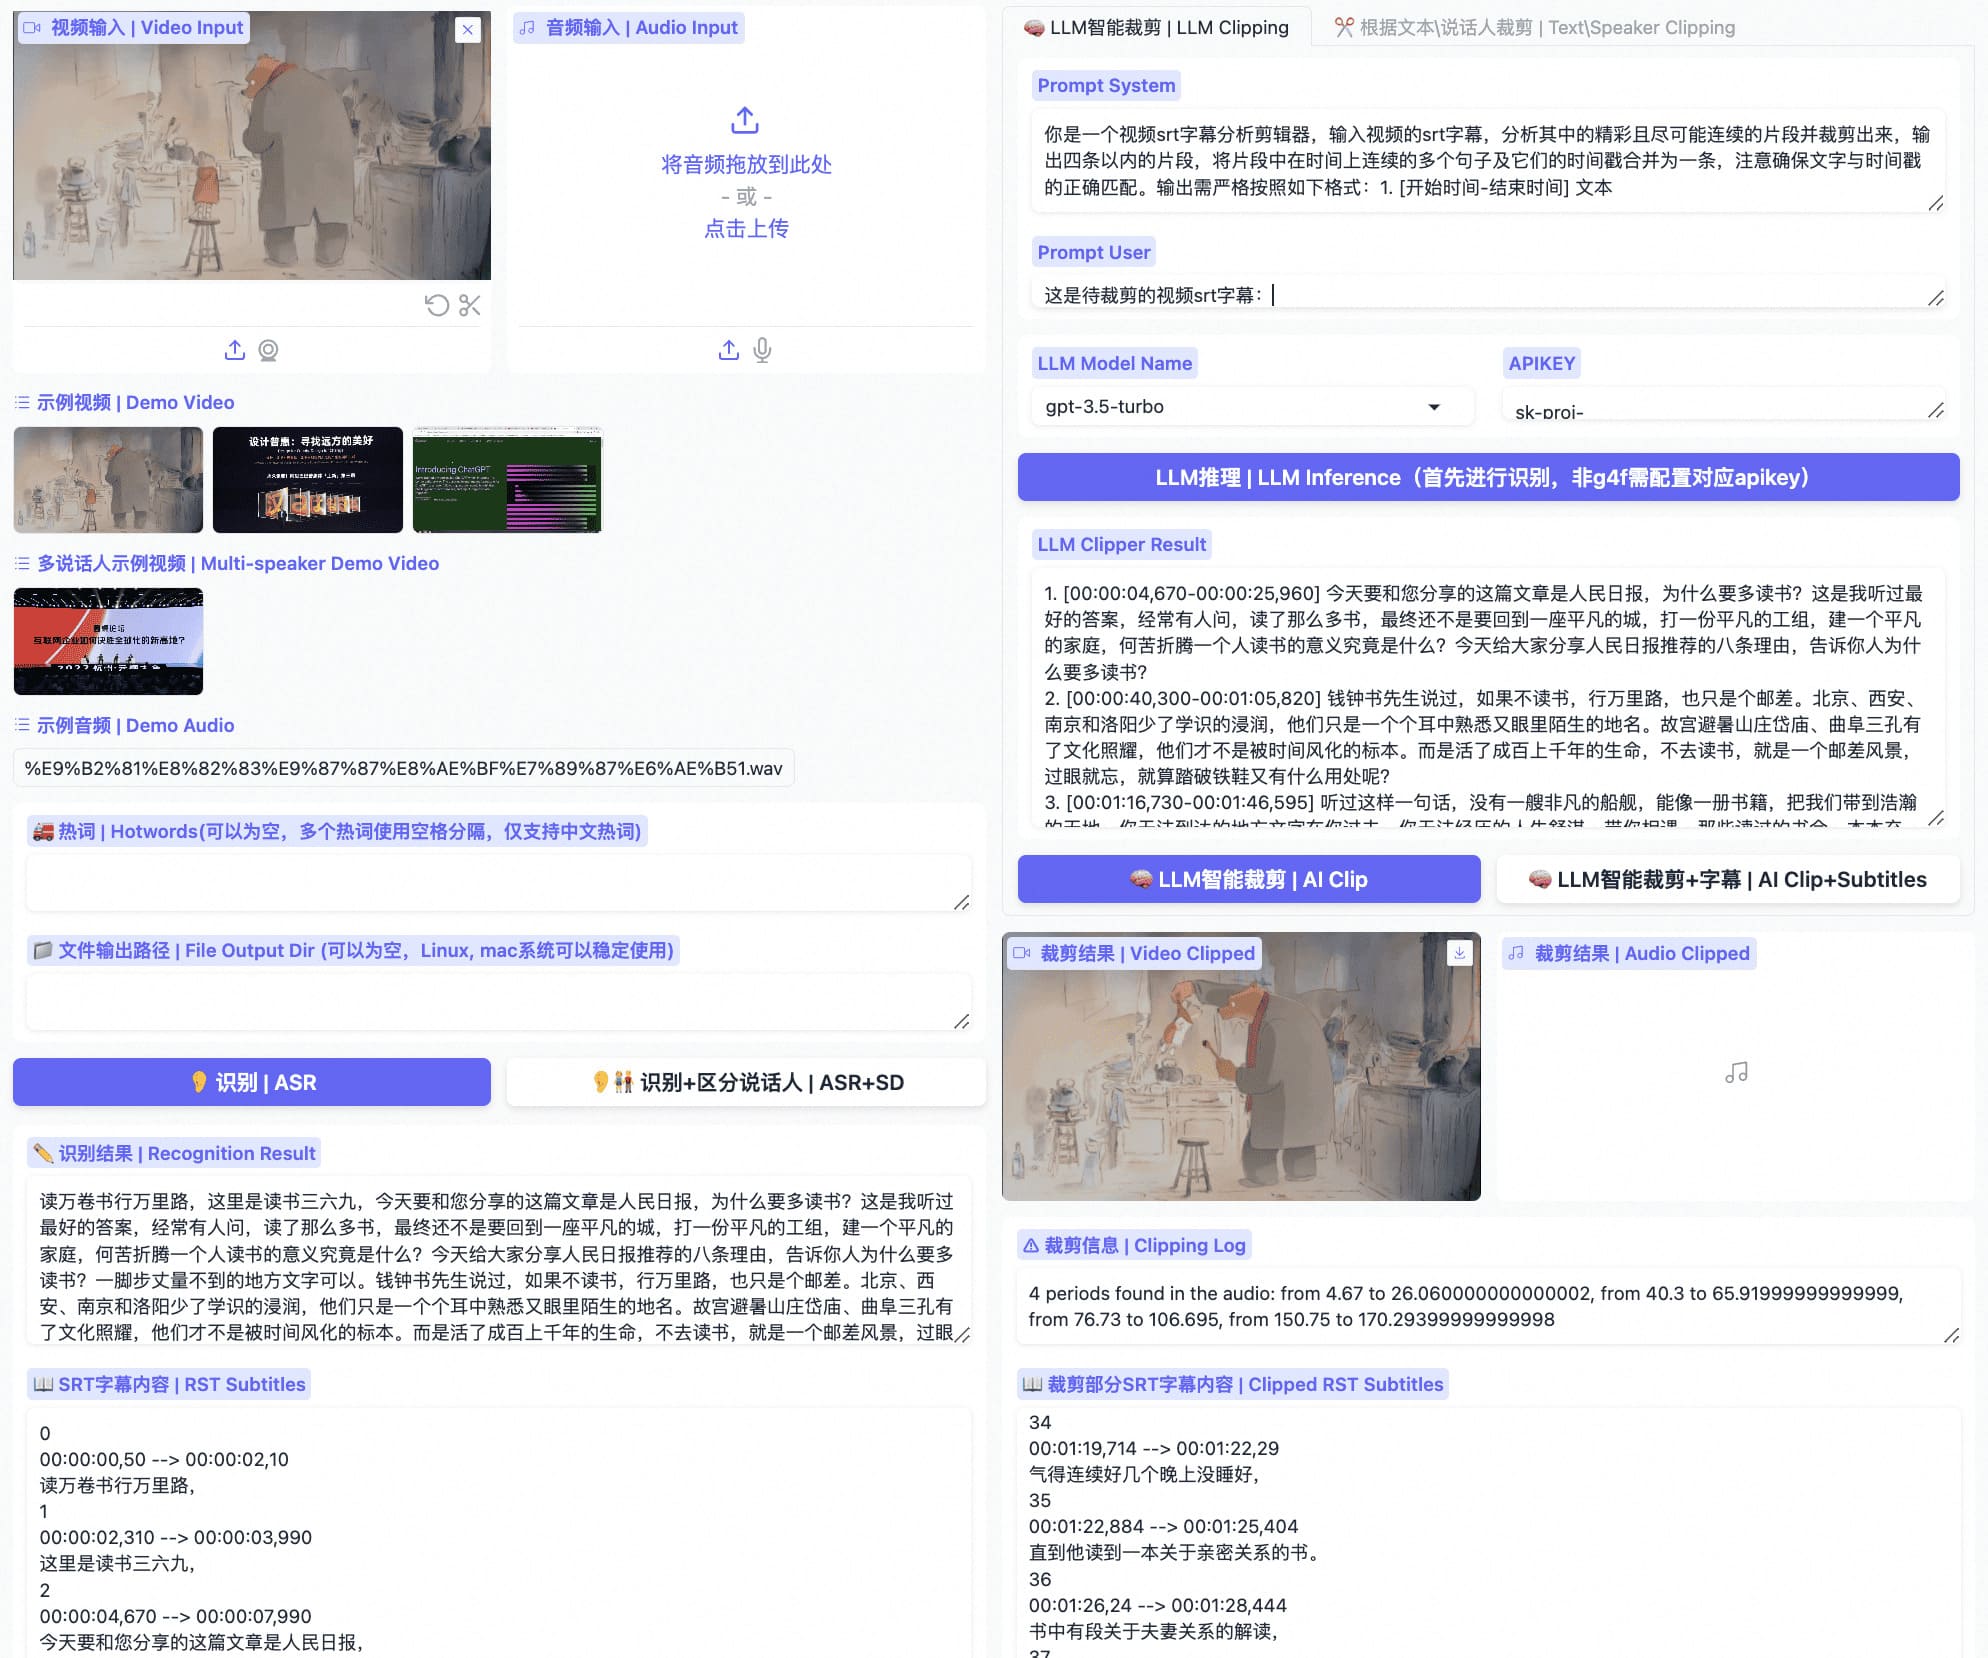
基于 FunASR 的本地视频转写与字幕生成工具,带 Gradio 界面,还能用大模型辅助自动剪辑,适合做中文视频内容创作。

Facebook AI 开源的端到端语音识别训练工具包,用 C++ 实现,可基于 wav2letter 架构训练声学模型,省去传统 ASR 繁琐的特征工程流程。
预训练语音合成模型集合,支持俄语、亚美尼亚语等多种语言,几行代码就能把文本转成语音,省去自己训练模型的麻烦。
跨 macOS、Windows、Linux 的本地语音听写工具,用 Rust 编写,把说的话实时转成文字,全程离线运行,不上传云端。
一站式桌面工具,用本地 Whisper、FunASR 等模型离线把视频转成字幕,还能翻译、AI 配音、声音克隆和烧录字幕,支持批量处理与全平台 GPU 加速。
把长视频自动剪成 9:16 竖屏短视频,用 LLM 挑高光片段、Whisper 转写、自动裁切,免费无水印,替代 Opus Clip 等付费服务。
开源 AI 视频本地化配音工具,把 YouTube/Bilibili 视频自动做语音识别、字幕翻译、声音克隆和混音渲染,一站式生成多语言配音成片。
基于 OpenAI Whisper 的语音转写工具,能自动识别不同说话人并切分对话,适合会议记录、访谈整理等多人语音场景。
面向生产环境的端到端语音识别工具包,基于 PyTorch 提供 Conformer、Transformer 等模型,可直接训练和部署 ASR 服务。
离线运行的本地音视频转字幕工具,能把语音识别成文字,输出 JSON、SRT 字幕和纯文本格式,适合不想上传云端、注重隐私的字幕制作场景。
面向语言学习者的视频播放器,支持双语字幕、Whisper 语音识别自动生成字幕、OCR 识别画面文字,并接入大模型做实时翻译。
轻量级离线语音识别引擎,用 C 写成、体积小、资源占用低,适合在嵌入式设备和移动端做实时语音转文字。
纯 C++ 音频推理引擎,基于 ggml 实现,一套代码覆盖语音合成、识别、VAD、变声和音乐生成,不依赖 Python,适合边缘部署。
基于 faster-whisper 的语音转写服务,提供兼容 OpenAI API 的接口,用 Docker 一键部署即可获得本地语音识别与翻译能力。
基于 Python 的 Telegram 机器人,接入 OpenAI 官方 API,在聊天窗口里直接提供 ChatGPT 问答、DALL·E 绘图和 Whisper 语音转写。
把 OpenAI Whisper 封装成开箱即用的 Docker 语音识别 Web 服务,上传音频即可通过 API 拿到转写文本,省去自己搭推理服务的麻烦。

免装 Python 的 Whisper 与 Faster-Whisper 独立可执行程序,解压即用,直接做语音转文字、字幕生成和说话人分离。

本地运行的开源 AI 会议助手与面试副驾,提供实时转写、会议笔记、讲座录音和本地 RAG,支持自带密钥,无需订阅。

Ruby 生态里调用 OpenAI API 的客户端库,封装 GPT-5、Realtime WebRTC、Whisper、DALL·E 等接口,让 Rails 项目直接接入对话、语音和图像能力。
自托管的本地语音助手,对标 Amazon Echo 和 Google Home,用 ESP32 硬件加语音识别在本地完成唤醒与语音转文字,数据不出户,适合注重隐私的智能家居场景。

macOS 上的本地语音听写应用,基于 Whisper 和 Parakeet 模型把语音实时转成文字,适合想要离线、隐私友好的语音输入用户。
本地运行的语音转文字工具,带网页界面,用 Whisper 模型把任意音频转成文本,还能翻译和编辑字幕,全程数据不出本机。
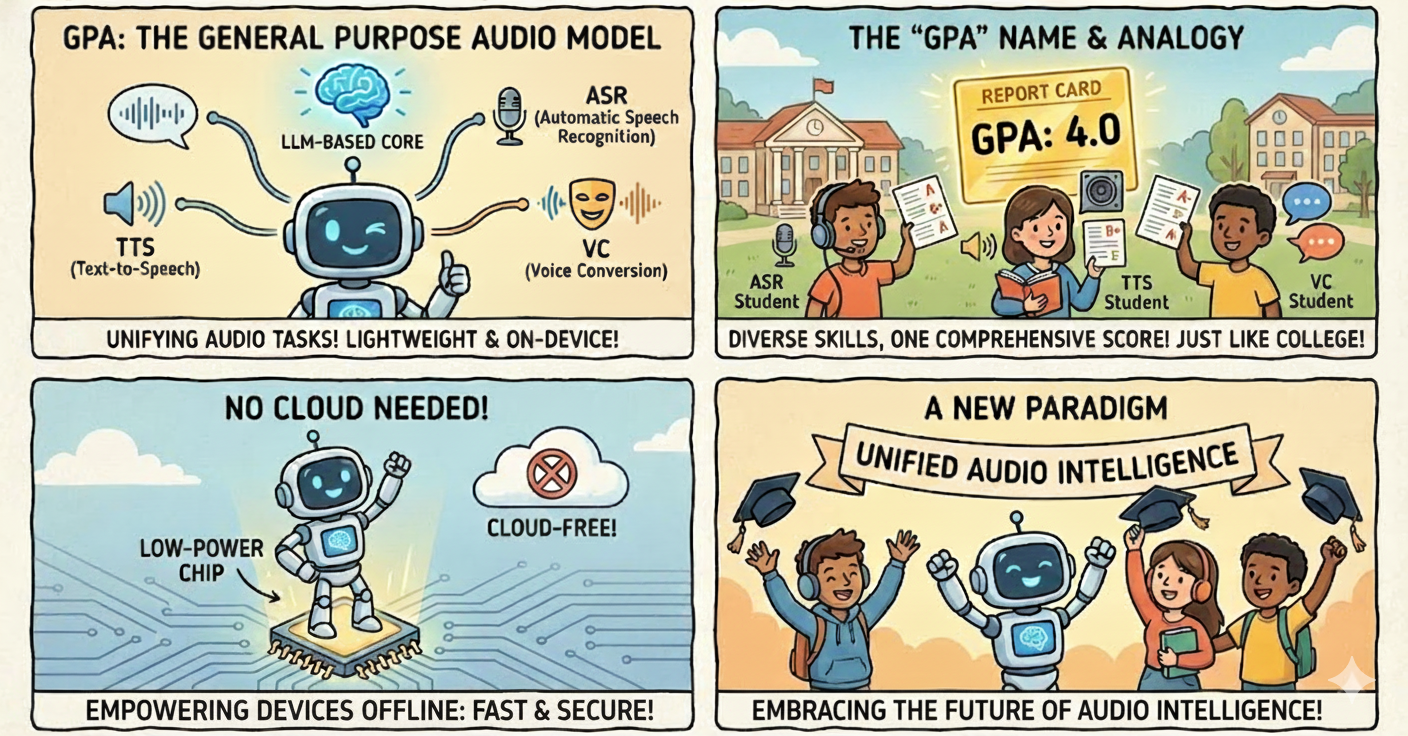
一个超小型的通用音频模型,用同一套权重同时完成语音识别、语音合成和音色转换,省去为每种任务单独部署模型。
面向 .NET 开发者的 OpenAI API 封装库,可在 C# 项目里直接调用 ChatGPT、DALL·E、Whisper 和 Azure OpenAI 服务。
基于 PySide6 的 faster-whisper 图形界面,让语音转文字不用敲命令行,支持 VAD 和 WhisperX 等能力。
给 Whisper 语音识别模型套上 Gradio 网页界面,上传音视频就能自动生成字幕,省去命令行操作。
Archived: legacy Swift Hex app. New app and source: github.com/anomalyco/hex
Lingvo 是 Google 开源的序列建模框架,用 TensorFlow 搭建语音识别、机器翻译、语言模型等 NLP 任务,支持分布式 GPU 训练。
基于 Whisper 的多语言语音识别工具,能输出词级时间戳和置信度,方便做字幕对齐和逐词定位。
微软推出的本地 AI 推理运行时,基于 ONNX Runtime 在设备端跑聊天补全和语音转文字模型,支持 GPU 加速,不用联网也能用。
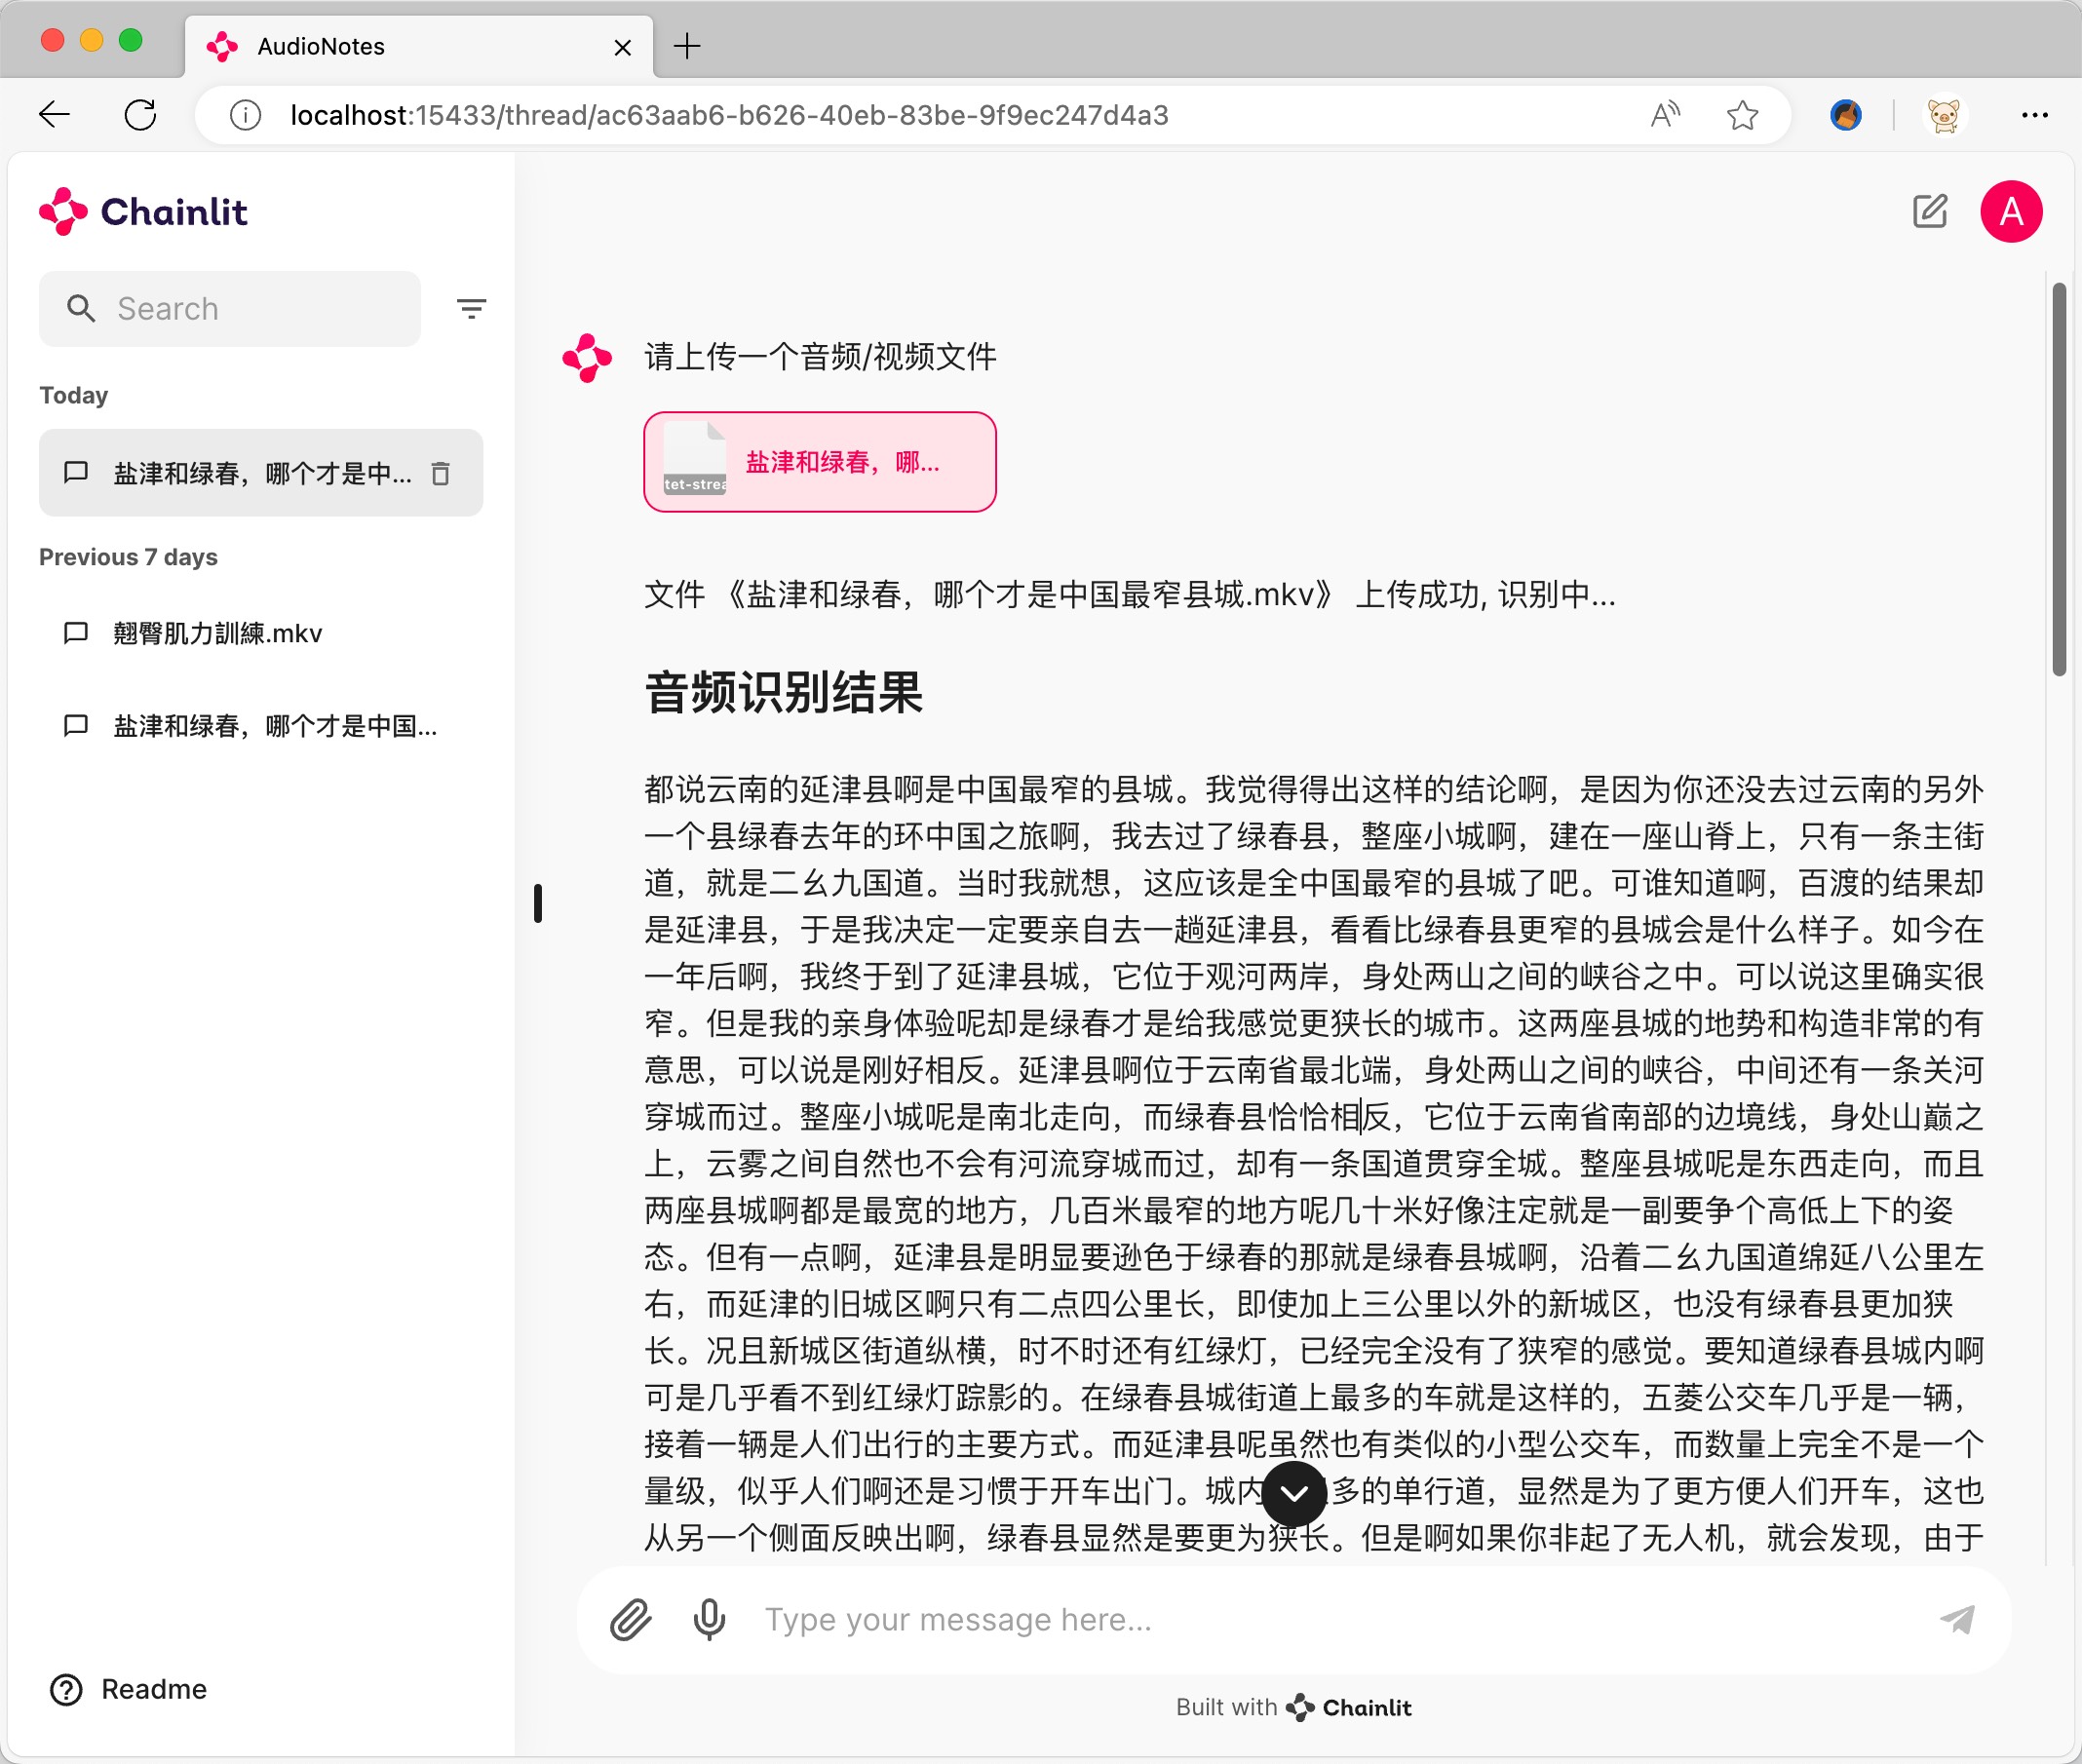
把音视频内容快速转成结构化 Markdown 笔记,先用 ASR 转写,再交给大模型整理成条理清晰的文本。

用 Qwen3-ASR、Whisper 和本地 LLM 给日语音视频自动生成字幕,靠 TEN-VAD 和降噪处理应对嘈杂背景音。