多模态生成
434 个仓库图像、视频、语音与视觉语言模型。
本地一站式 LoRA 训练工作台,从单张照片或大批图片构建角色、风格、概念数据集,自动打标并用 ai-toolkit 训练,支持多模型 checkpoint 对比。
PromptKD 是 CVPR 2024 的官方 PyTorch 实现,用无监督提示蒸馏把大视觉语言模型的能力迁移到小模型上,免去人工标注。
用掩码生成式 Transformer 做高分辨率文生图的官方实现,把非自回归架构重新拉回实用水平,兼顾生成效率与画质。
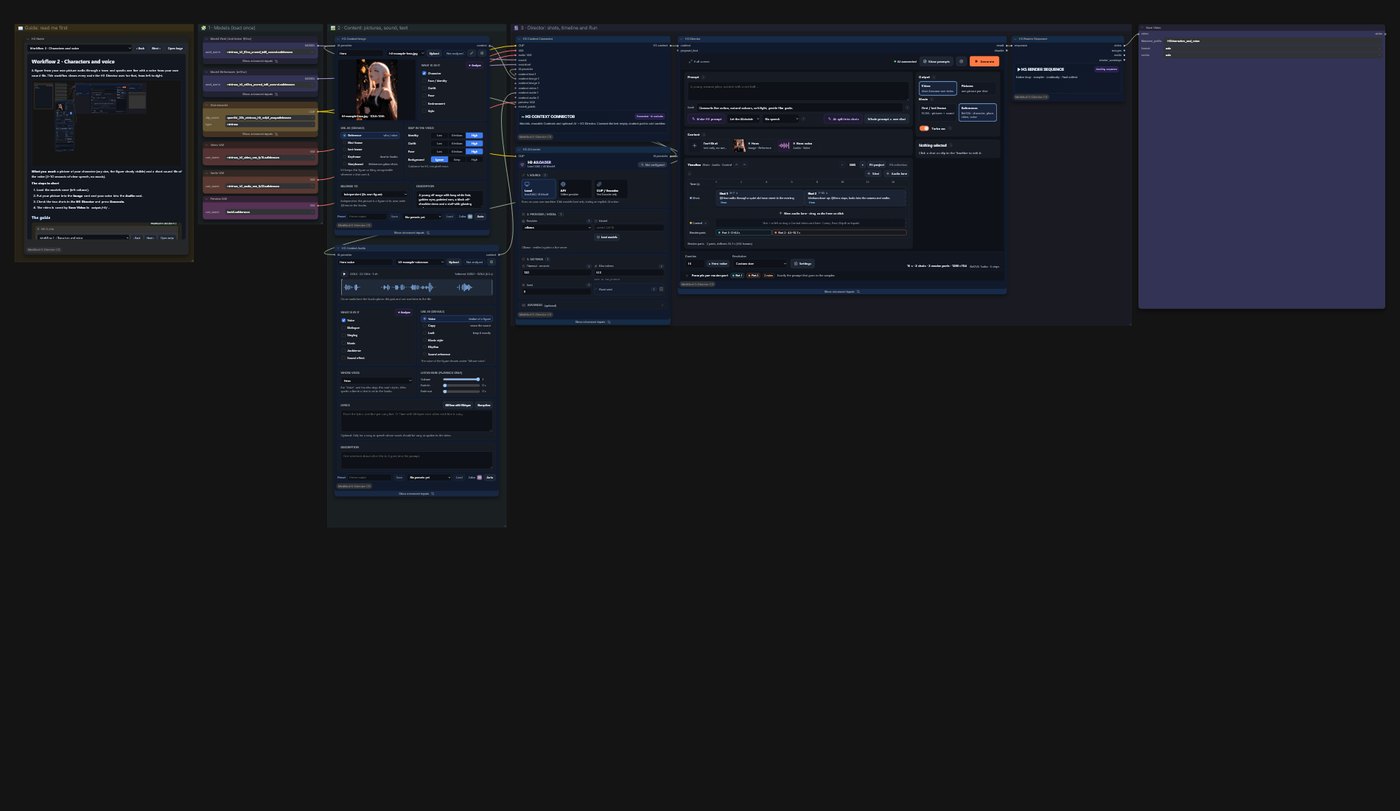
在 ComfyUI 里给 MiniMax H3 视频模型加了一条时间轴编辑器,用分镜提示词、首尾关键帧、图/视频/音频参考和联合音频来编排镜头,还能实时预览采样、重拍和镜头串联。
输入一句提示词,由 ChatGPT 自动补全成适合 MidJourney 的完整绘画提示,帮你省去反复琢磨措辞、激发更多创意灵感。
用 JSX 声明式描述视频,统一调用 Kling、Flux、ElevenLabs、Veed 等模型生成视频、图像和配音,省去逐个对接各家 API 的麻烦。
开源 AI 网红生成器,用 FLUX 等模型批量生成可定制的虚拟人物形象,适合做社交媒体内容创作。
用视觉语言模型把二维工程图纸自动转成三维 CAD 模型,省去手工建模的重复劳动。
整理 Seedance 2.5 视频生成 API 的提示词、参数与调用示例,帮开发者快速上手字节跳动的图生视频能力。
DF-GAN 是 CVPR2022 提出的文本到图像生成基线,用简洁的 GAN 结构从文字描述合成图像,效果稳定且易于复现。
用单个提示词就能让扩散模型生成前后一致的多图故事,无需额外训练或微调,解决文生图角色与场景不一致的问题。
输入一个主题就能自动生成 Vox 风格的纸片拼贴解说视频,脚本、关键帧、动画、配音、配乐和字幕全流程搞定,还能作为 Claude Code 等编程智能体的技能调用。
给照片加上对抗扰动,防止他人用 DreamBooth 等个性化文生图模型把你的脸合成到任意画面里。
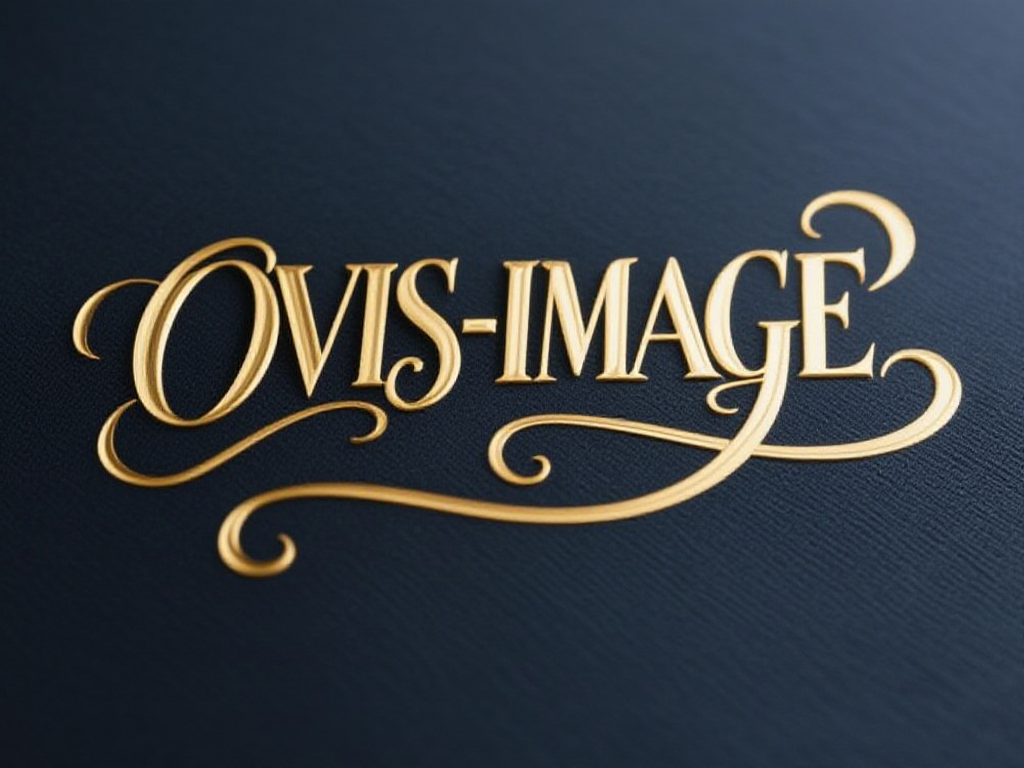
7B 参数文生图模型,专攻高质量文字渲染,在严苛算力限制下也能高效出图,适合需要画面内准确排字的场景。
用自然语言提示从任意视频中精准截取片段,省去手动拖时间轴找画面的麻烦,适合快速产出短视频素材。
把豆包逆向成 OpenAI 兼容接口,免费提供多模态对话、图像/视频/音乐生成和文件托管,方便接入 AI Agent。
开源的 AI 画布设计助手,在无限画布上通过对话生成和编辑图片、视频,可替代 Lovart、Canva AI 等商业设计工具。
基于扩散模型的多文本长视频生成与编辑方案,通过时序协同去噪把多个文本提示拼成连贯长视频,解决单次生成时长受限的问题。
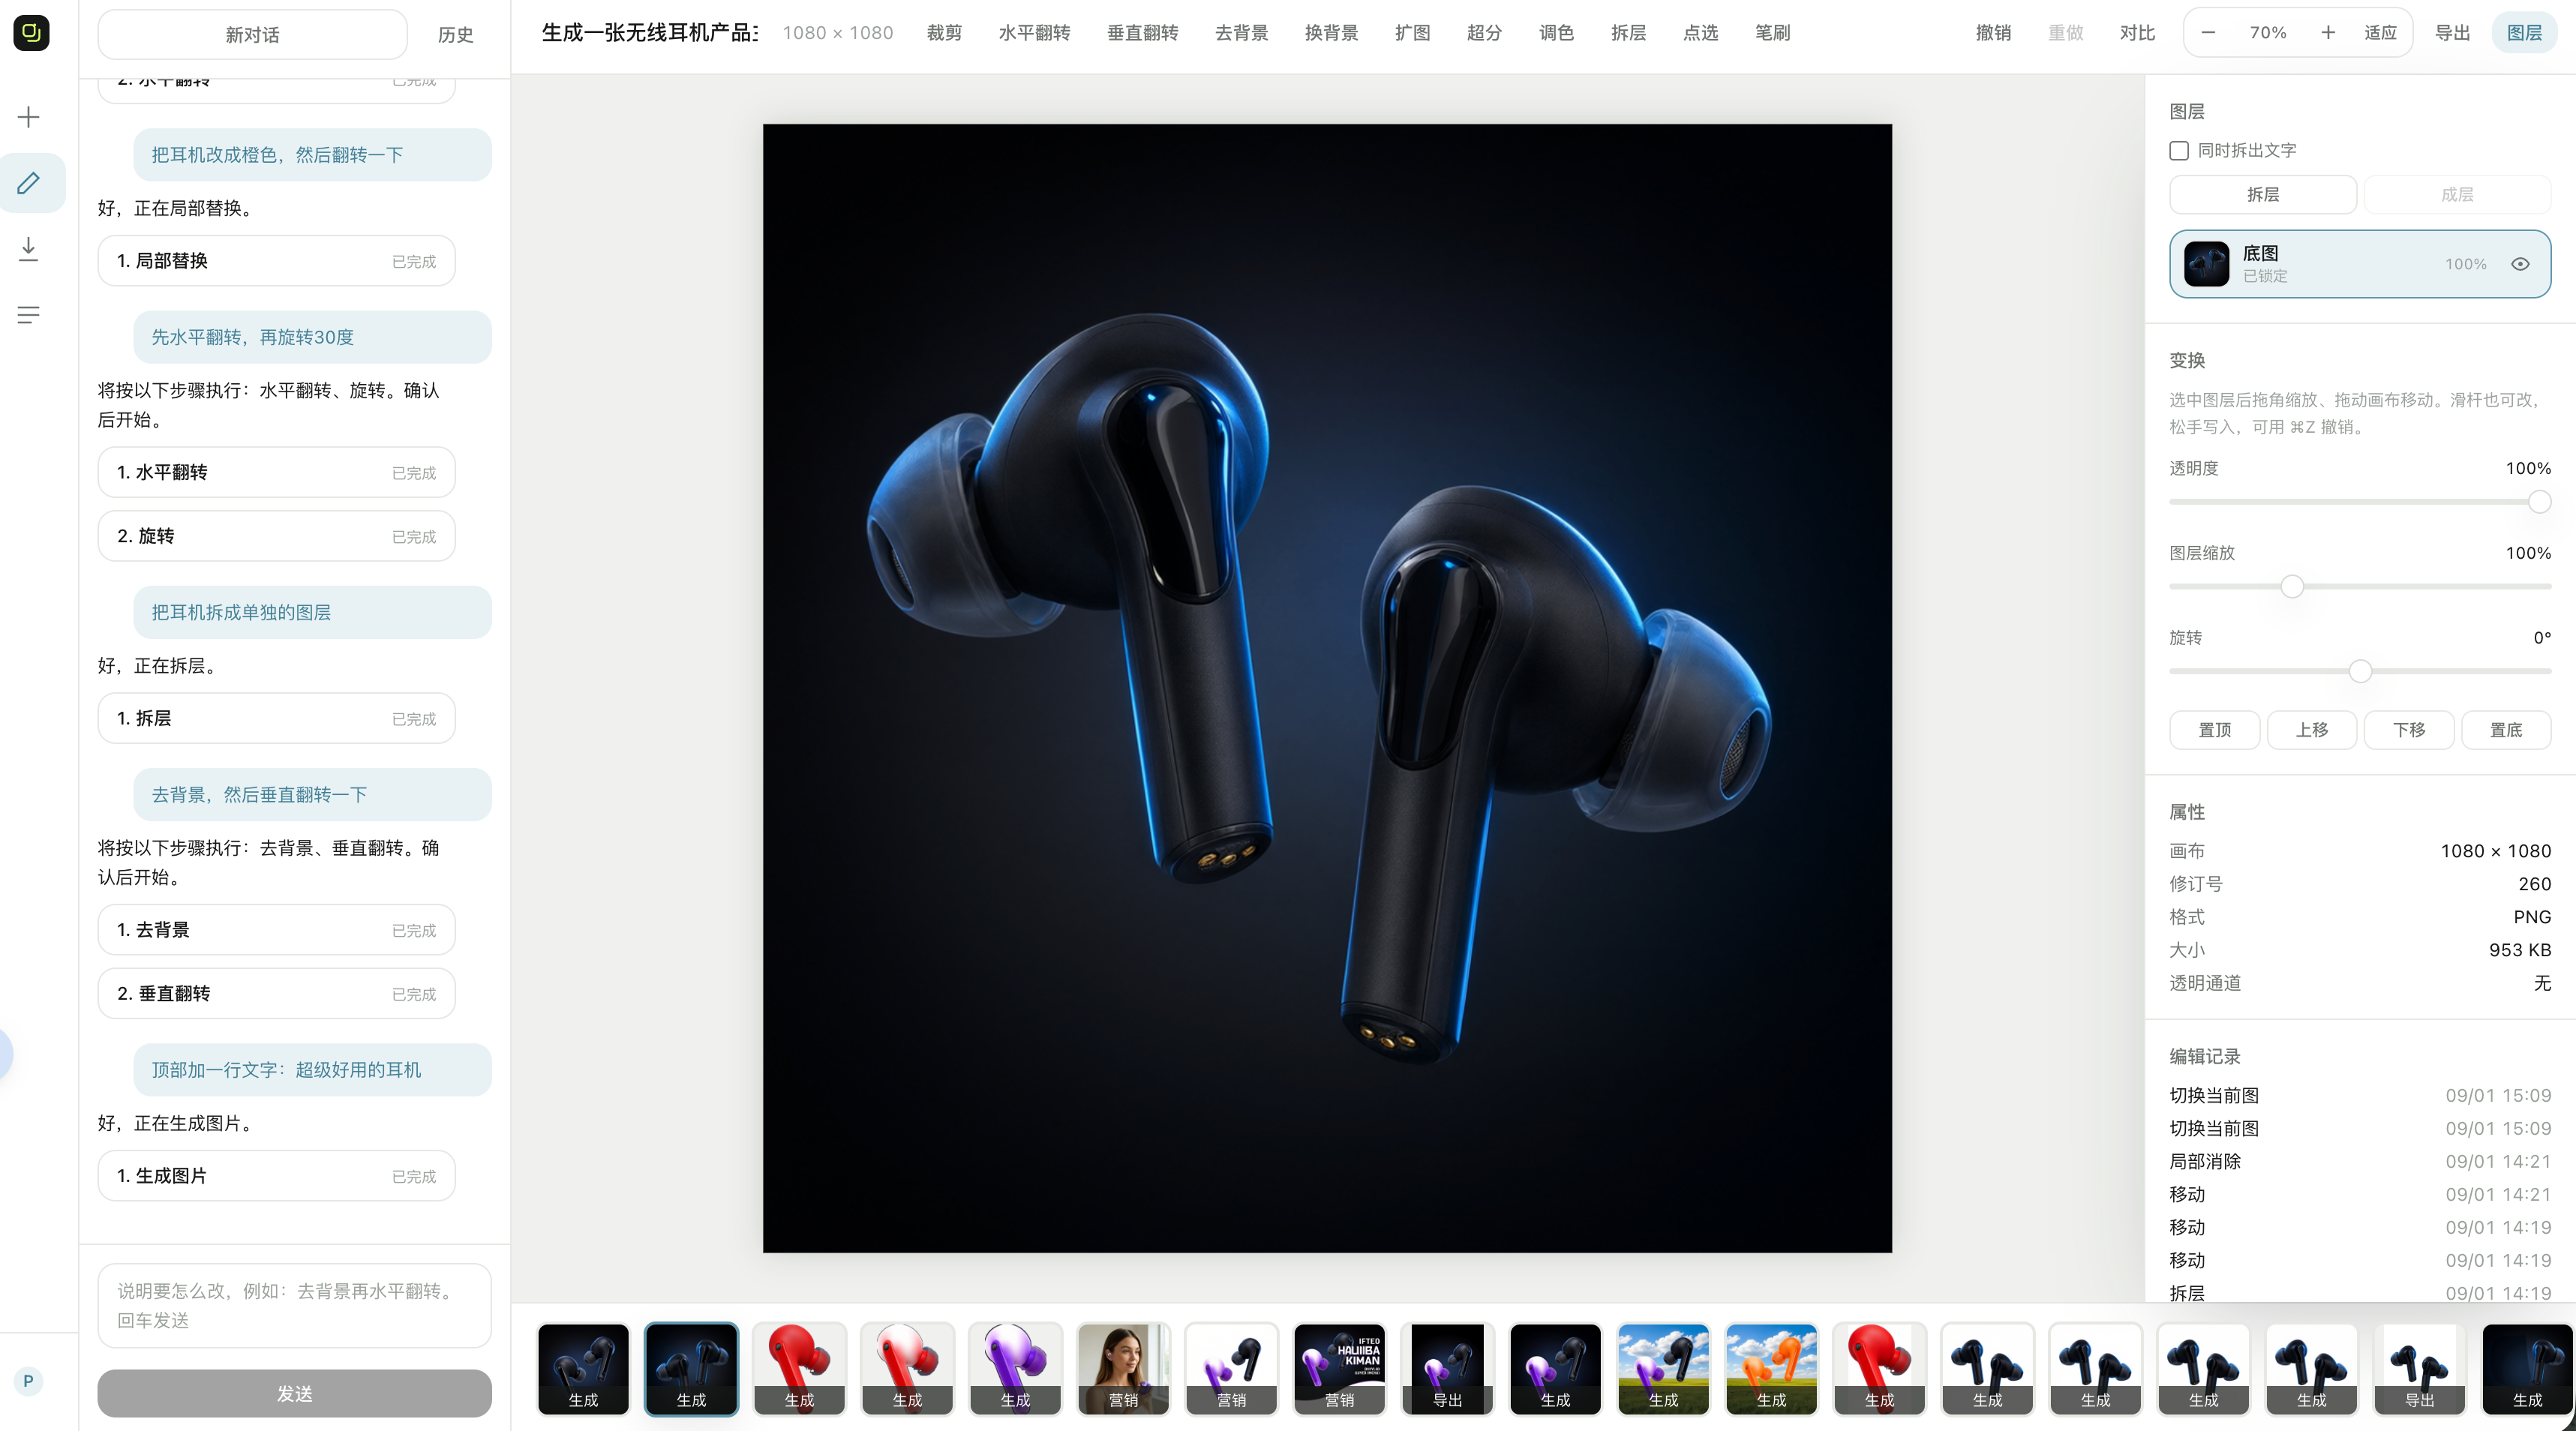
基于 React 19 + FastAPI + LangChain/LangGraph 的 AI 修图智能体,用自然语言驱动 21 种编辑工具完成抠图、图层拆分、区域编辑和文生图,配套教程带你一周掌握 AI Agent 全栈开发。

让 PC 开机直接进入大模型运行环境,基于 Rust 的 UEFI 常驻方案,底层不需要操作系统,省去启动系统开销。
基于 ComfyUI 的响应式 AI 创作工作台,在电脑或手机上流畅运行调优好的图像与视频生成工作流,适合自托管使用。
让视觉语言模型在推理时生成隐式视觉 token 做「脑内想象」,无需输出真实图像就能增强多模态空间推理能力。
把前沿 Transformer 模型接入机器人技术栈的 Python 库,支持多模态与扩散模型,帮具身智能开发者快速搭建可感知、可决策的智能体。
面向物理 AI 的命令行工具,把 VLA、VLM、WAM 等机器人多模态模型串起来,方便在 NVIDIA、Nebius 环境里做模型部署和对话机器人调试。