AI · 算法工程
共 2,598 个仓库 · 近 4 个月有推送

把 S3、GCS、Azure 上的非结构化数据整理成带类型、可版本化的数据集,方便 AI Agent 和机器学习流程直接读取和复用。
面向日文漫画的 OCR 工具,能识别漫画中的对话气泡和拟声词等文字,基于 Transformers 实现,适合做漫画翻译或文本提取。

面向 AI 编码代理的模型驱动脚手架,用语义建模、应用生成和渐进式 API 辅助,让代理写出的代码可验证、可落地。
MOSS-Image 是一个 50 亿参数的 DiT 基础模型,主打高质量文字渲染、布局生成和高效微调,适合需要精准控制文字与版式的文生图场景。
用基础模型自动给图片打标签,再拿这些标注训练自己的监督视觉模型,省掉人工标注的环节。

给 Postgres 数据库做分支和秒级瘦克隆,让 CI/CD 里的数据库测试跑得更快、成本更低。
在自己的 GPU 上跑 GLM-5.3-Flash、DeepSeek-V4.1-Flash、MiniMax-M3.1-Flash 等大模型,统一引擎加可视化面板,兼容 OpenAI 与 Anthropic 接口。

汇集 FLUX、Stable Diffusion、SDXL 等图像生成模型的训练与微调教程,涵盖 LoRA、DreamBooth、ComfyUI 和云端 Notebook 实操指南。
截图后直接识别图中文字并复制到剪贴板,省去手动输入,支持多平台,适合从图片、PDF 或界面中快速提取文本。
一个跨平台本地大模型聊天客户端,通过统一界面连接 llama.cpp 本地模型以及 Anthropic、OpenAI、DeepSeek、Ollama 等远程服务。
用命令行驱动浏览器的自学习 Agent,基于 Playwright 自动操作网页,并在使用中积累经验、越用越顺手,适合做网页自动化与数据采集。
模块化、不绑定技术栈的 AI 编码代理工具包,让代理自动发现、复现并修复代码与硬件安全漏洞。
面向已训练神经网络模型的量化与压缩库,提供剪枝、量化等高级技术,帮助在部署前压缩模型体积、降低推理开销。

把 Claude、Codex 等多家 LLM 的 API 统一成一个入口的聚合网关,方便个人集中管理和切换不同模型服务。
面向 PyTorch、TensorFlow 和 ONNX Runtime 的模型压缩工具,支持 INT8/FP8/INT4 等低比特量化和稀疏化,帮大模型在低精度下保持精度并降低显存与推理成本。
一个 MCP 服务器,让 AI 代理和 LLM 能稳定抓取公开网页,内置反爬与浏览器自动化,解决网页数据采集和提取的难题。
面向小型本地大模型的编码智能体测试框架,基于终端基准评估代码生成与工具调用能力,方便对比不同小模型的实际表现。
基于 PyTorch 的点云深度学习训练框架,集成 PointNet、KPConv、MinkowskiEngine 等主流模型,方便在 S3DIS、ScanNet 上做分割等任务。
在保留原始版面、公式和结构的前提下翻译 PDF,适合科研论文和技术文档,避免译文打乱排版。
给 Zotero 加 AI 助手的插件,能直接和 PDF 对话、全库检索文献,还带文献雷达和自动综述,支持 30 多种大模型或本地模型。

用 Go 写的高性能无状态声明式 API 网关,把后端微服务统一收口,负责路由、聚合和协议转换,适合云原生场景做统一入口。
在 Mac 上跑 Qwen 3.8 等大模型的原生推理引擎,靠 MTP 投机解码把速度拉到 125 tok/s,16GB 内存也能跑 27B 模型,并提供 OpenAI/Anthropic 兼容的本地服务。
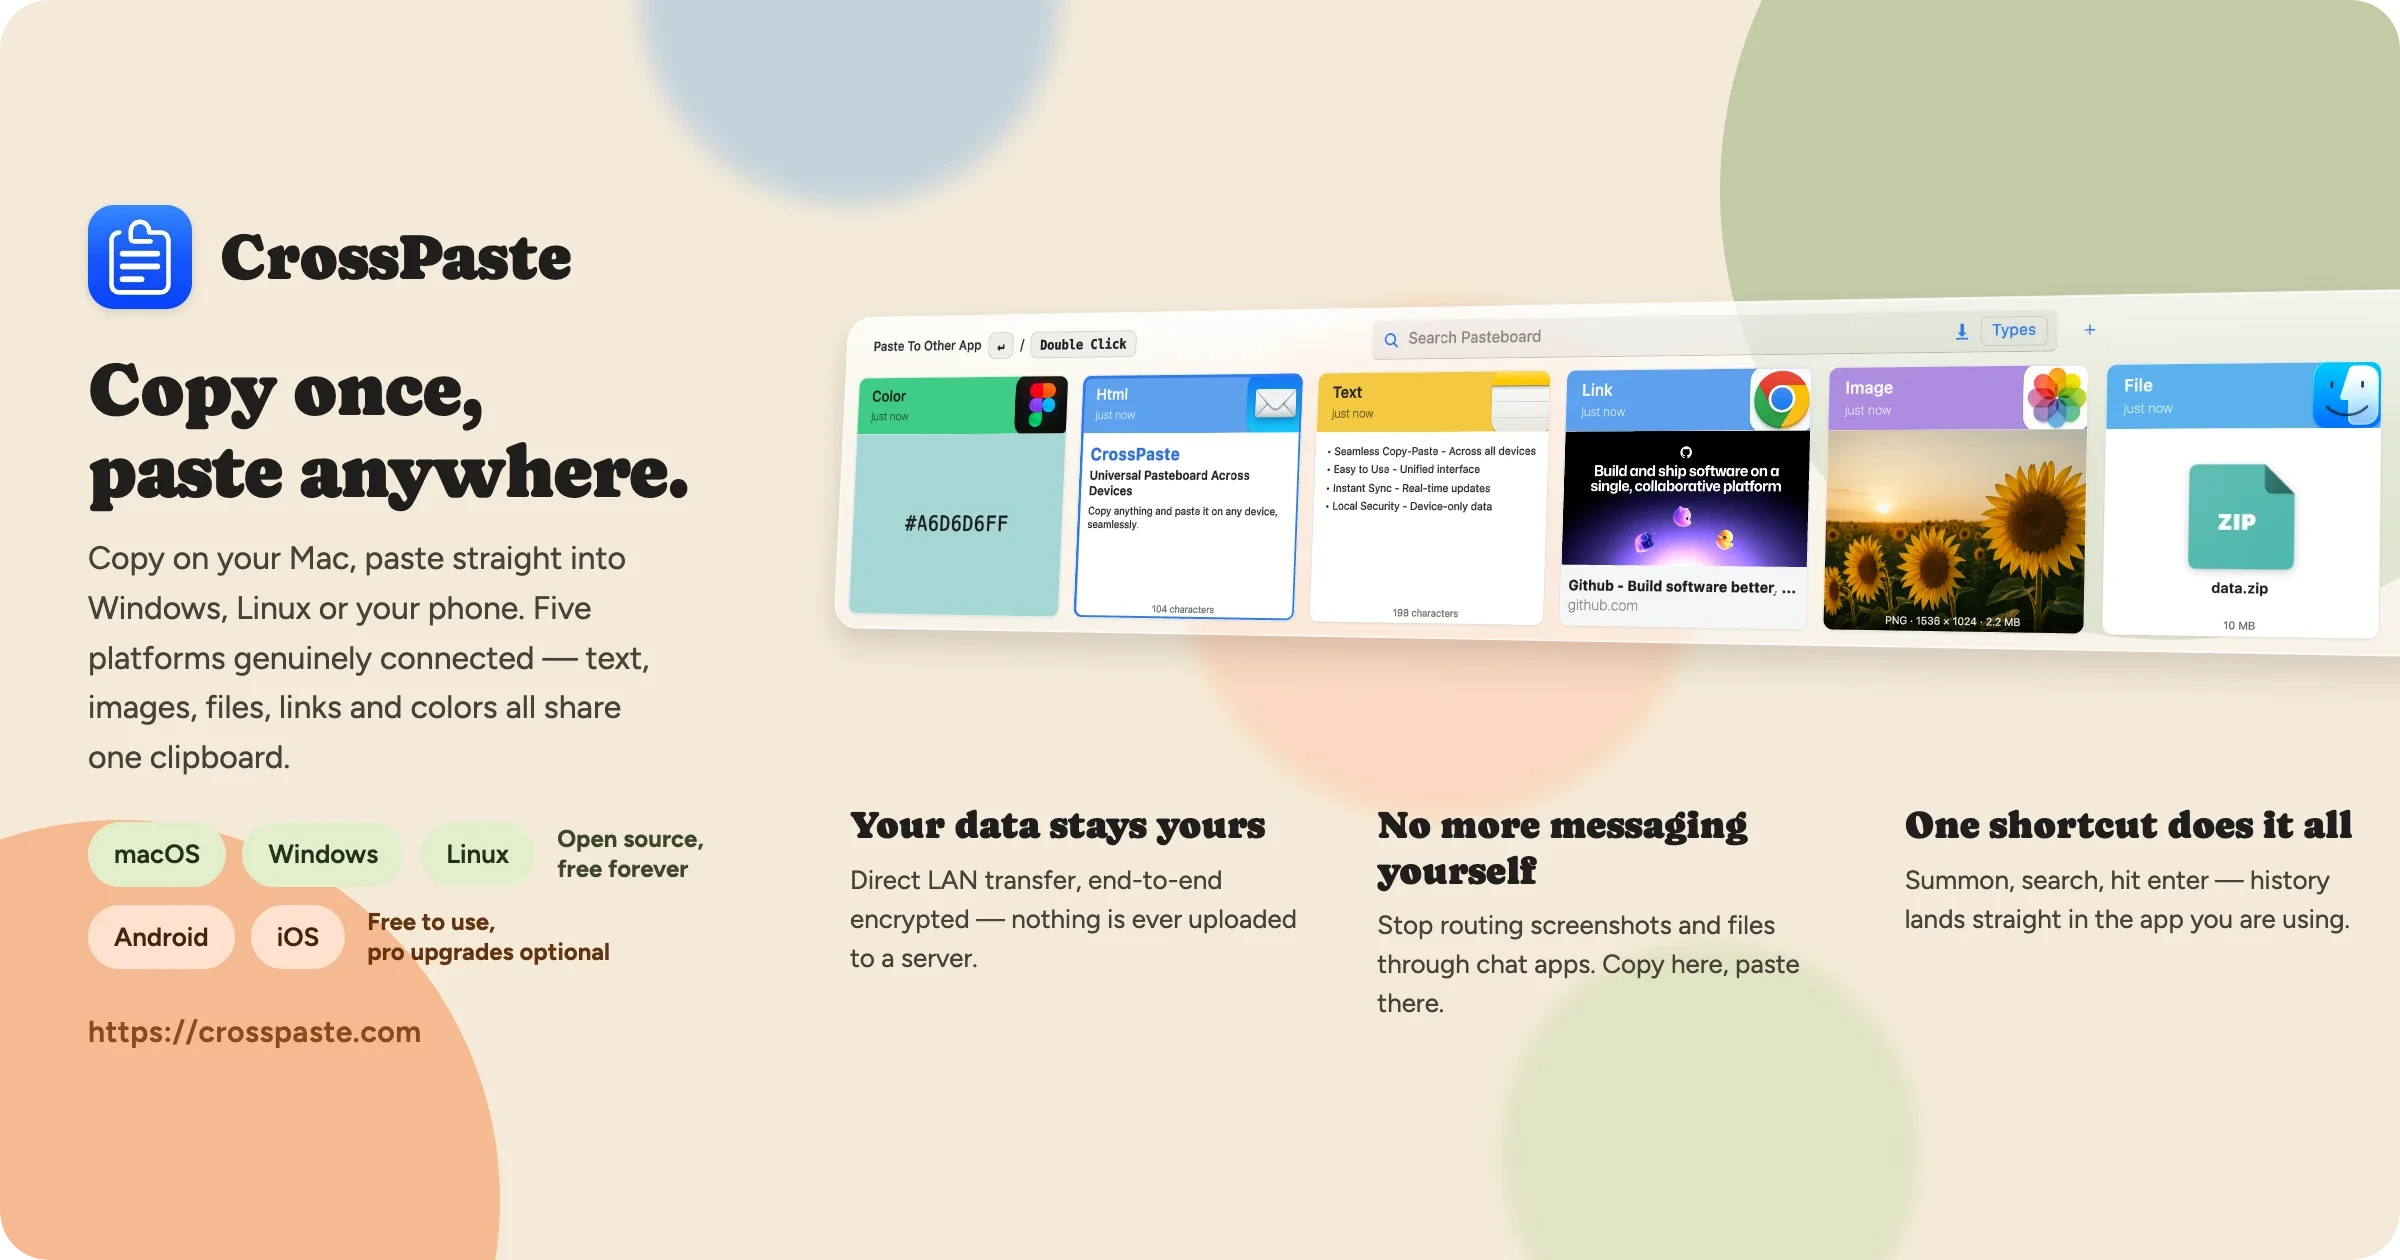
跨设备剪贴板同步工具,支持 macOS、Windows 和 Linux,数据只在局域网内端到端加密传输、不经过云端,还内置 OCR、CLI 和 MCP 服务。
一站式微调多模态模型的工具,支持 PaliGemma 2、Florence-2、Qwen2.5-VL 等,覆盖图像描述、目标检测和视觉问答任务,省去手写训练脚本的麻烦。