AI · 算法工程
共 3,223 个仓库 · 一年内有推送
面向大模型推理与 GPU 训练的高性能存储引擎,用 Rust 编写,通过 RDMA 等技术提升模型加载和服务吞吐。
为 AI Agent 提供可扩展、可互操作的通用记忆层,统一存储与检索状态,简化自主系统的上下文管理。

面向性能敏感场景的超低延迟异步 C++17 日志与指标库,用异步写入避免日志拖慢主线程。
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。

面向 AI Agent 的 JS 逆向 MCP Server,通过有头 Chrome 调试、断点与网络/WebSocket 分析,配合 Patchright 反检测,帮 Agent 完成前端逆向。
一套用来测试和实验提示词的开源工具,支持 OpenAI、LLaMA 等大模型以及 Chroma、Weaviate 等向量数据库,方便对比不同提示词的效果。
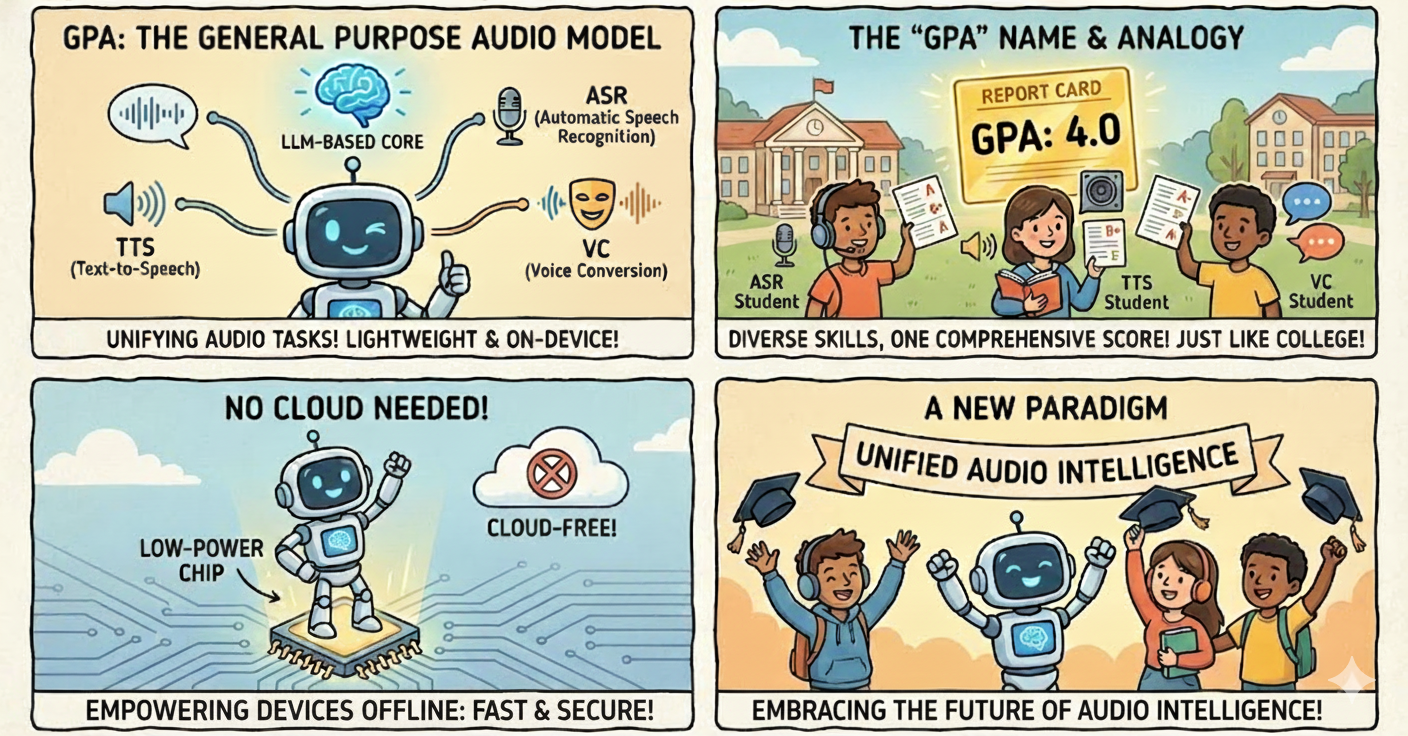
一个超小型的通用音频模型,用同一套权重同时完成语音识别、语音合成和音色转换,省去为每种任务单独部署模型。

Pinecone 官方示例仓库,用 Jupyter Notebook 演示向量数据库的建库、检索和 RAG 语义搜索流程,适合快速上手实践。
不用搬数据就能做企业知识检索和 RAG,跨 100+ 应用联合搜索并直接生成答案,几分钟即可部署。
可视化编程环境,用来对 LLM 提示词做压力测试和效果对比,方便快速验证不同提示方案的表现。
在 PHP 里调用 Tesseract OCR 的封装库,让你不用折腾命令行就能把图片里的文字识别出来,适合做发票、截图等文档的文字提取。

用蓝图驱动多智能体自动跑完从选题、实验到论文写作和同行评审的 AI 科研流程,适合想自动化科研工作流的团队。

给 AI 编码 Agent 做可观测与成本优化的基础设施,通过减少 token 消耗和算力占用,让同样的 Agent 花更少的钱干更多的活。
PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。
面向 .NET 开发者的 OpenAI API 封装库,可在 C# 项目里直接调用 ChatGPT、DALL·E、Whisper 和 Azure OpenAI 服务。
把 PyTorch、TorchScript 和 FX 模型编译成 TensorRT 引擎,在 NVIDIA GPU 上做推理加速,省去手写 TensorRT 网络的麻烦。
用大模型对 Tesseract 的 OCR 结果做纠错、智能分块和 Markdown 排版,把扫描 PDF 转成干净可读的文本,支持本地或 API 模型。
给 JADX 反编译工具加装 MCP 服务端插件,让大模型能直接读取和分析反编译出的 Java 代码,辅助逆向工程与安全审计。
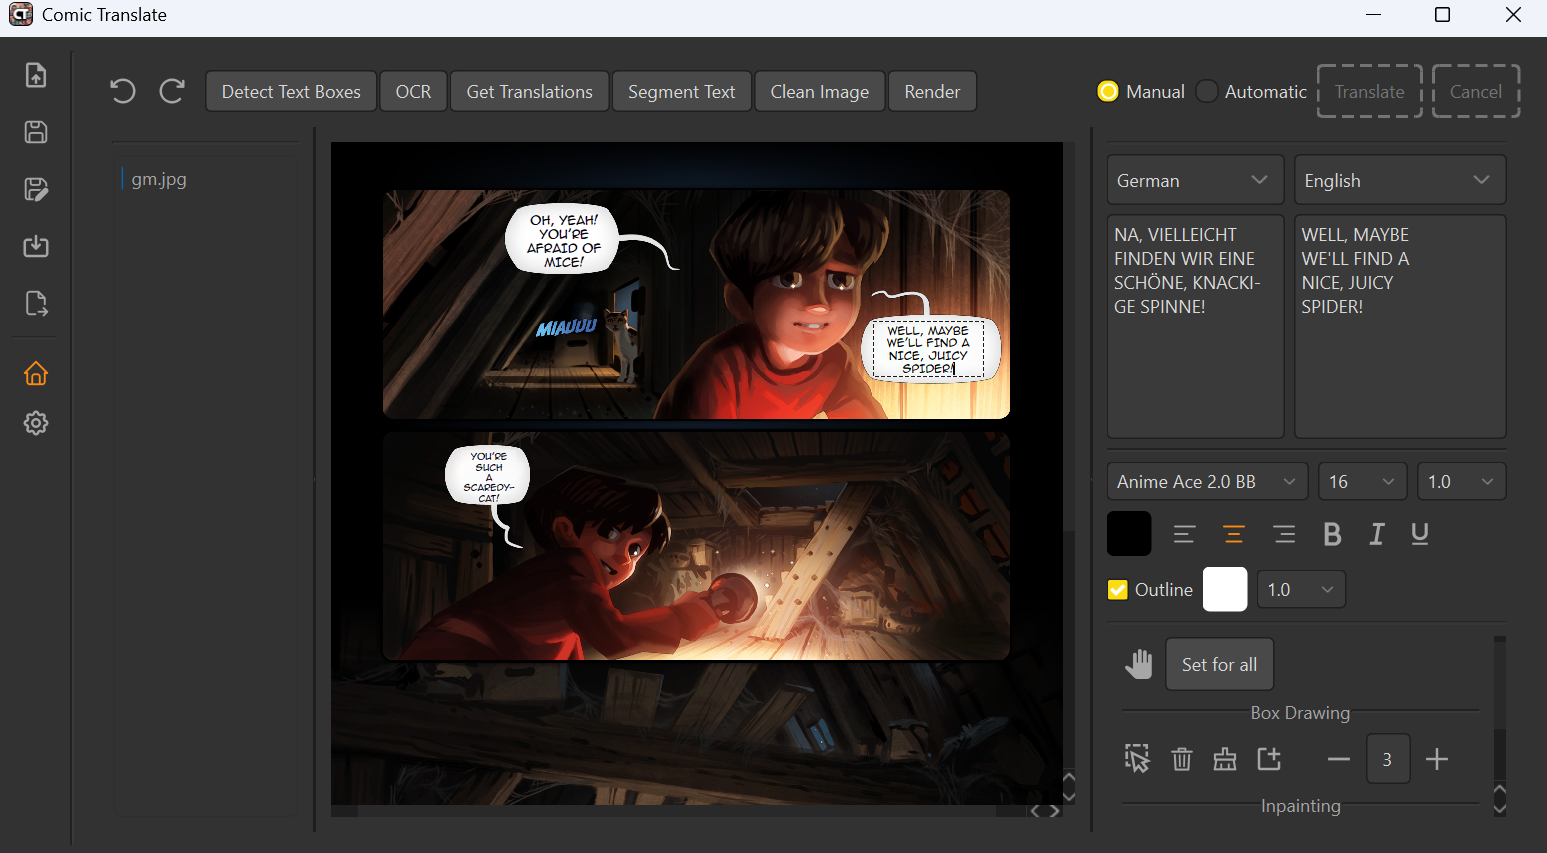
自动翻译漫画、日漫、韩漫等图片与 PDF/EPUB/CBR/CBZ 文件,集成 OCR、图像修复和机器翻译,支持多语言多格式。
基于 PySide6 的 faster-whisper 图形界面,让语音转文字不用敲命令行,支持 VAD 和 WhisperX 等能力。

面向大语言模型的高性能推理框架,主打高效、灵活和易用,支持 DeepSeek 等模型在 GPU 上做推理服务部署。
轻量级图像与视频生成推理框架,支持 Wan、Hunyuan、LTX 等主流视频模型及自回归扩散模型,降低多模态生成模型的部署与推理门槛。

跨平台视频结构化分析框架,基于 C++ 和 GStreamer 串联 CV 模型与多模态大模型,把视频流拆解成人脸、车牌、行为等结构化信息。
面向文本嵌入、重排、CLIP、CLAP 和 ColPali 模型的高吞吐低延迟推理服务引擎,适合把向量化和重排模型部署成线上 API。