模型工具链
共 110 个仓库 · Python

面向 vLLM 生产推理的 LLM 压缩工具,支持量化等压缩算法,把大模型压小以便高效部署。
给 LLM Agent 用的长期记忆系统,通过压缩和知识图谱把文本与多模态历史高效存下来,让 Agent 跨会话记住关键信息。
AWQ 是一种激活感知的权重量化方法,能在几乎不损失精度的情况下把大模型压到 4bit,并配合高效推理内核显著降低显存占用、提升推理速度。
为 Transformers、Diffusers 等模型提供硬件加速与量化、ONNX 导出等优化工具,让推理和训练在各类硬件上跑得更快。

面向任意结构剪枝的通用框架,支持 LLM、视觉基础模型和 Transformer 等,用依赖图自动处理层间耦合,省去手工设计剪枝策略。
基于 ONNX Runtime 和 DirectX 12 的图像/视频 AI 超分工具,带图形界面,支持 N 卡、A 卡和 Intel 显卡,可降噪、去压缩伪影,适合修复动漫和漫画素材。
让 vLLM 推理引擎跑在华为昇腾 NPU 上的社区维护硬件插件,帮你在国产算力上部署大模型服务。
PyTorch 官方的量化与稀疏化工具库,支持训练和推理阶段的低精度计算,覆盖 float8、MX 等数据类型,可加速 Transformer 和 Llama 等大模型。
把 PyTorch、TorchScript 和 FX 模型编译成 TensorRT 引擎,在 NVIDIA GPU 上做推理加速,省去手写 TensorRT 网络的麻烦。

把 Nunchaku 的 4-bit 量化扩散模型推理接进 ComfyUI,让 FLUX 等模型在低显存下也能快速出图。
面向已训练神经网络模型的量化与压缩库,提供剪枝、量化等高级技术,帮助在部署前压缩模型体积、降低推理开销。
面向 PyTorch、TensorFlow 和 ONNX Runtime 的模型压缩工具,支持 INT8/FP8/INT4 等低比特量化和稀疏化,帮大模型在低精度下保持精度并降低显存与推理成本。
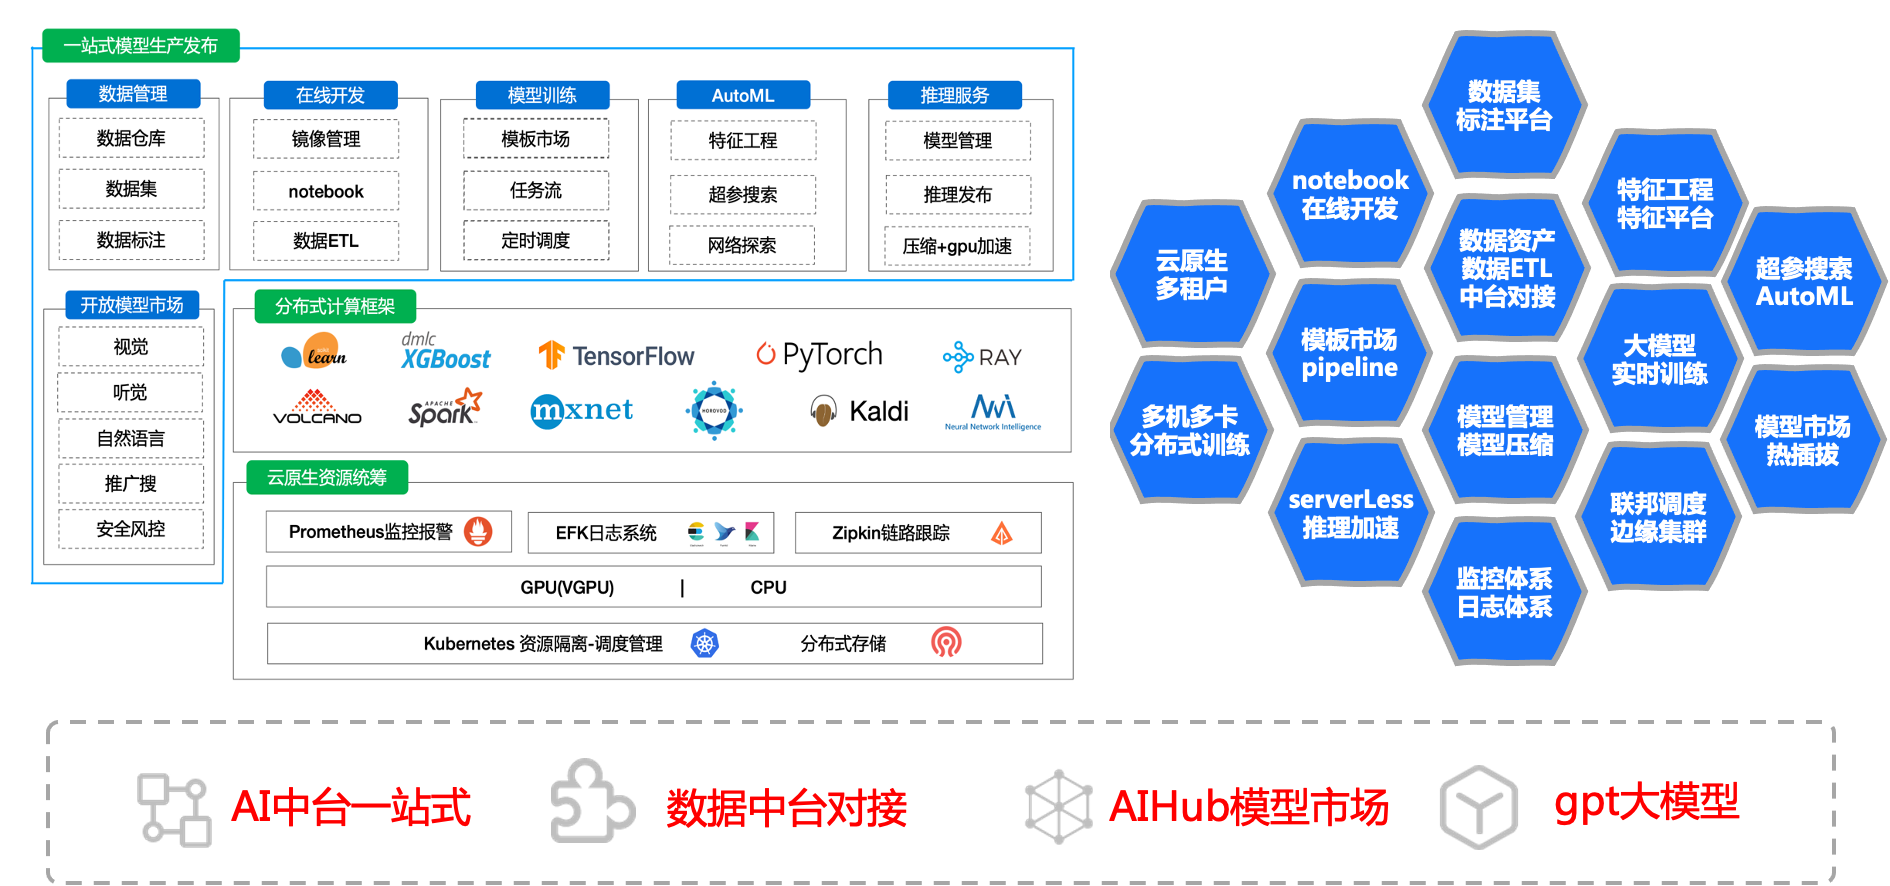
开源云原生一站式机器学习与大模型平台,覆盖拖拉拽 pipeline 编排、多机多卡训练、推理服务和 MaaS,支持昇腾等国产异构算力调度。
GPTQ 是 ICLR 2023 论文的官方实现,能在训练后把 GPT 类大模型量化到 3/4 比特,几乎不掉精度,大幅降低显存占用和推理成本。

在 ComfyUI 里搭建 LLM Agent 的框架,接入 MCP、GraphRAG、语音合成与 OCR 节点,兼容 OpenAI 接口的各类模型和本地 GGUF 模型。
AutoAWQ implements the AWQ algorithm for 4-bit quantization with a 2x speedup during inference. Documentation:
把 Keras、PyTorch、ONNX 训练好的神经网络模型自动转成 FPGA 可综合的 HLS 代码,方便在硬件上做低延迟推理。
用 AnimeGANv3 把照片或视频一键转成日漫风格,支持 Colab、ONNX、CoreML、TFLite 等多种部署格式,方便直接产出动画作品。
整理大模型高效化研究的资源清单,汇总量化、剪枝、知识蒸馏等压缩与加速方向的论文和工具,方便快速找到降低推理成本的方法。
A Python package for extending the official PyTorch that can easily obtain performance on Intel platform
让 vLLM 在 Apple Silicon 的 Mac 上跑起来,通过 Metal 和 MLX 后端把大模型推理搬到本地苹果芯片,省去 GPU 服务器。
把 YOLOv8 的检测、分割、姿态模型导出为 ONNX 并用 TensorRT 加速推理,支持 Jetson 和 DeepStream 部署。
腾讯开源的模型压缩工具包,支持量化、投机解码和扩散模型加速,帮你在部署大模型时降低显存占用、提升推理效率。
面向 Tenstorrent 加速卡的 TT-NN 算子库和 TT-Metalium 底层内核编程模型,让大模型和图像生成模型能在非 GPU 硬件上高效推理。