多模态生成
共 27 个仓库 · Jupyter Notebook
输入一段文本就能生成带笑声、叹息等非语言声音和背景音乐的语音,效果自然,适合做创意配音和音频内容原型。
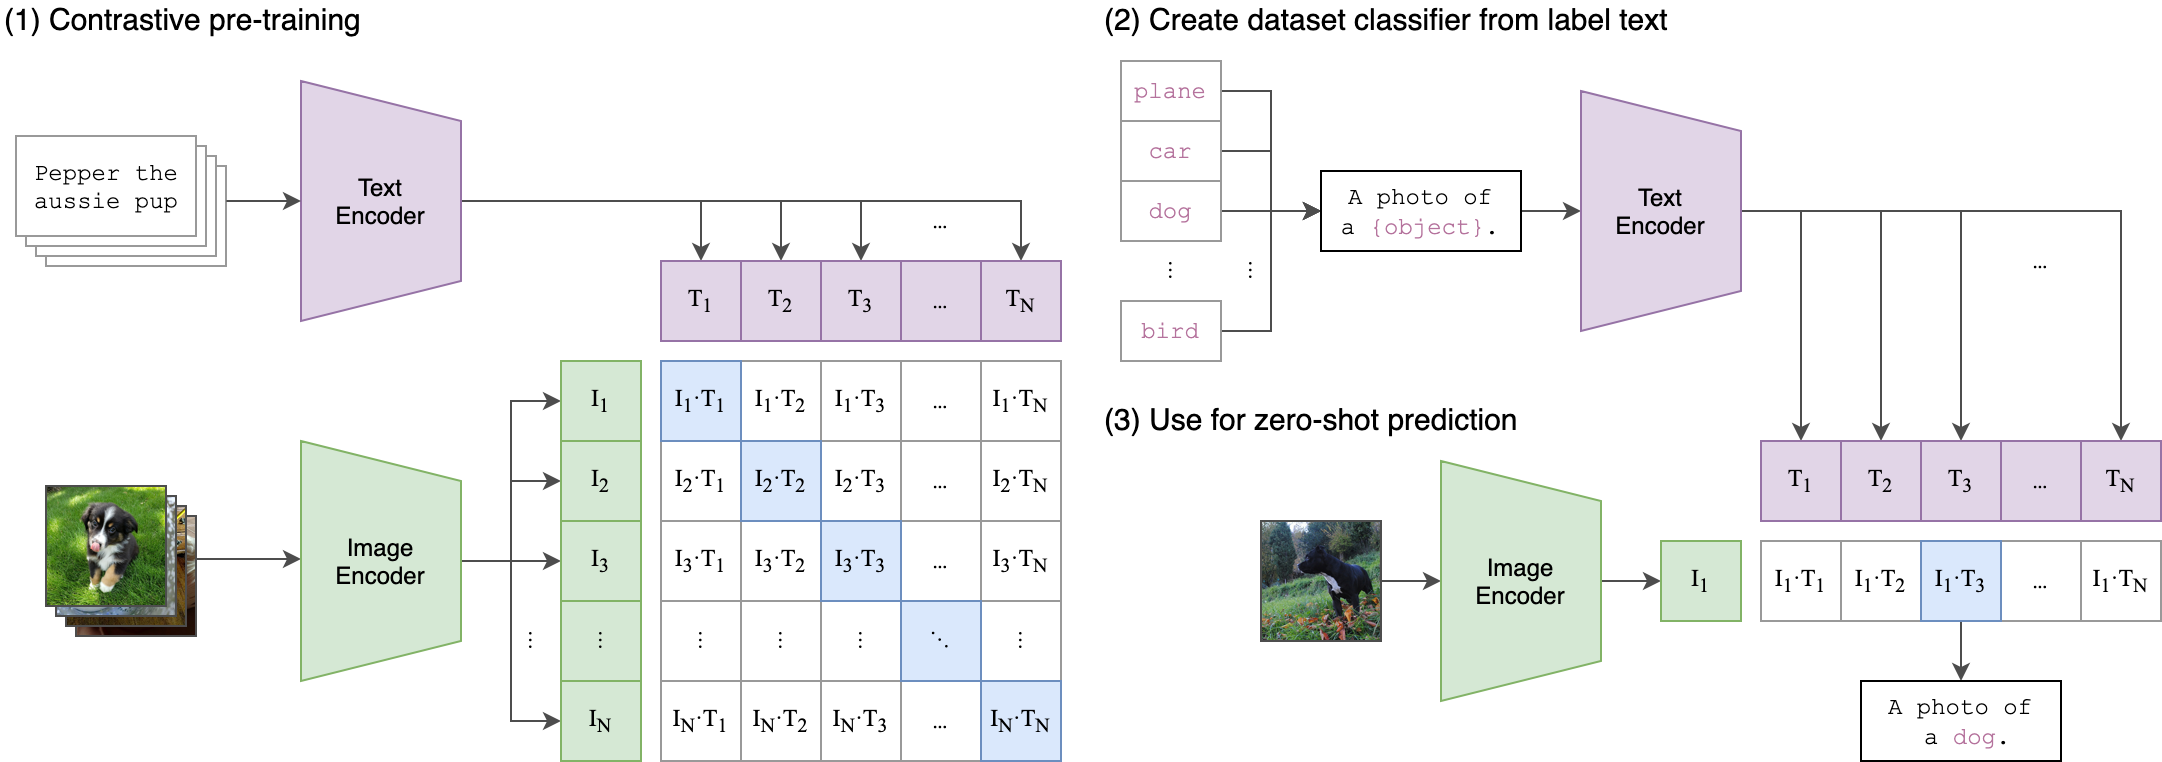
用对比学习把图像和文本映射到同一嵌入空间,实现零样本图像分类和图文匹配,是跨模态检索与多模态模型的经典底座。

阿里云通义团队开源的多模态大模型系列,能同时理解图像和文本,用于视觉问答、图文推理等视觉语言任务。
在 Google Colab 上一键跑起 Stable Diffusion WebUI 的笔记本合集,省去本地显卡和环境配置,直接在线出图、图生图、训练 LoRA 和 DreamBooth。

基于 PyTorch 的说话人日志神经网络组件库,提供语音活动检测、说话人变化检测、重叠语音检测和说话人嵌入等预训练模块,方便搭建说话人分离与识别流程。
基于下一尺度预测的自回归视觉生成模型,用GPT式架构做图像生成并击败扩散模型,代码简洁易用,附带缩放定律研究。
预训练语音合成模型集合,支持俄语、亚美尼亚语等多种语言,几行代码就能把文本转成语音,省去自己训练模型的麻烦。

中文版 CLIP 预训练模型,支持中文图文跨模态检索和表征生成,可直接用于图文匹配、零样本分类等任务。
把 OpenAI Whisper 语音识别模型反过来用做文本转语音的开源 TTS 系统,基于 PyTorch 实现,可直接在真实语音数据上训练出多说话人合成效果。

从零基础到 CV、NLP、LLM 项目实战再到 ONNX/TensorRT 工程化部署的 PyTorch 中文教程,配套 Jupyter Notebook 边学边练。

汇集 FLUX、Stable Diffusion、SDXL 等图像生成模型的训练与微调教程,涵盖 LoRA、DreamBooth、ComfyUI 和云端 Notebook 实操指南。
开箱即用的扩散模型推理加速库,兼容 Diffusers 和 ComfyUI,通过编译优化和 LoRA 支持显著提升图像生成速度。
字节跳动开源的视觉语言基础模型,主打通用多模态理解与推理,在 60 个公开基准中有 38 项达到 SOTA,配套 Notebook 教程方便上手。
用计算图变换(如自动微分)加速飞行器设计优化,提供气动、推进、结构、轨迹设计等可组合分析工具,适合多学科设计优化场景。
基于条件流匹配的快速非自回归语音合成架构,用更少采样步数生成高质量语音,适合搭建低延迟 TTS 系统。
从零构建的免费开源、无审查图像描述视觉语言模型,专为扩散模型训练生成高质量图片说明。
面向机器人导航的开源平台,用多模态大模型和视觉语言动作模型构建通用导航基础模型,解决跨场景视觉导航与空间智能问题。
微软出品的 5 周 RAG 学习路线,用 Jupyter Notebook 带你从索引、混合检索到量化压缩,系统掌握检索增强生成。

Alpha-CLIP 是 CVPR 2024 提出的 CLIP 改进模型,通过引入 alpha 通道掩码让视觉语言模型能聚焦图像中指定区域,解决传统 CLIP 无法控制关注位置的问题。
用 Hugging Face diffusers 把扩散模型从图像搬到音频,能直接训练和生成音乐片段,省去自己搭扩散流程的麻烦。

一套 Colab 笔记本,手把手演示蛋白质与 RNA 结构预测、设计、对接等深度学习工具的用法,适合边跑边学。
一堆可直接在 Google Colab 上跑的生成式 AI 笔记本,覆盖 ComfyUI 工作流、Flux Kontext、混元、LTX 视频等图生图与图生视频玩法,省去自己配环境。
输入一段文字就能自动生成视频脚本、AI 配音和会说话的人脸,快速产出无真人出镜的短视频,适合做 Shorts 类内容。
MACE 是 CVPR 2024 提出的扩散模型大规模概念擦除方法,能从 Stable Diffusion 等文生图模型中批量移除指定概念,适合做内容安全与版权合规。