多模态生成

共 434 个仓库

打开分类页
gpt-image-2.5-for-e-commerce
Evolink-AI

面向电商场景的 GPT Image 2.5 提示词手册,覆盖商品主图、模特试穿、产品展示、互动场景和社交电商素材的生成与修图。

电商图像生成+4图像生成
236422026-09-09 16:34 UTC
CapRL
InternLM·Python

用强化学习(GRPO)训练视觉语言模型生成更细粒度、更密集的图像描述,解决普通 caption 模型描述过于笼统的问题。

图像描述+4视觉语言模型
23682026-06-23 02:40 UTC
generative-media-skills
calesthio·Python

一套面向 AI 编程助手的生成式媒体技能包,让 Claude、Cursor 等助手能直接产出高质量图片、视频、音频和语音内容。

生成式媒体+4图像生成
235482026-07-14 13:44 UTC
OpenReels
tsensei·TypeScript

一条命令把任意选题自动做成可直接发布的短视频,涵盖调研、脚本、配音、画面、配乐、字幕与合成,适合批量生产 YouTube、Reels、TikTok 内容。

短视频生成+4视频生成
235502026-04-10 11:17 UTC
AttackVLM
yunqing-me·Python

面向视觉语言模型的对齐与安全研究代码库,提供对抗攻击方法,用于评估多模态基础模型的鲁棒性和可信度。

对抗攻击+4视觉语言模型
233182026-11-01 13:57 UTC
GenAI4AD
taco-group

系统梳理生成式 AI 在自动驾驶全栈中的应用,覆盖感知、决策到仿真与 sim2real,帮研究者快速看清技术版图与关键挑战。
自动驾驶+4自动驾驶
232152025-09-20 04:41 UTC
DiffusionART
vanzll·Python

用强化学习对扩散模型做后训练,支持文生图、文生视频和图生视频,主打高效、稳定、可扩展。

扩散模型+4图像生成
229+332026-11-10 11:04 UTC
ComfyUI-fal-API
gokayfem·Python

把 fal.ai 上 1400 多个图像、视频、音频和 LLM 模型接进 ComfyUI 的自定义节点,自带缓存和费用控制,方便在本地工作流里直接调用云端生成能力。

ComfyUI节点+4图像生成
227+1632026-11-10 12:45 UTC
PS3
NVlabs·Python

把视觉预训练扩展到 4K 分辨率,让视觉语言模型在高清图像上也能高效训练和推理。

视觉预训练+3视觉语言模型
22614v0.1.22026-01-04 00:49 UTC
zenith-image-generator
WuMingDao·TypeScript

多供应商 AI 图像生成器,支持 Gitee AI、HuggingFace、ModelScope 等后端,提供 OpenAI 兼容 API 与 token 轮换,可一键部署到 Cloudflare Pages。

图像生成+4图像生成
2251202026-11-01 07:10 UTC
iris-3b
speridlabs·Python

Iris-3B 是一个 3B 参数的扩散 Transformer,直接在像素空间生成图像、无需 VAE;同一预训练先验微调后还能做单目深度估计和 4 倍图像修复。
像素空间生成+4图像生成
224+1192026-10-15 07:33 UTC
MooshieUI
Mooshieblob1·TypeScript

面向新手的 ComfyUI 前端界面,简化 Stable Diffusion 和 Flux 等图像生成工作流操作,降低上手门槛。

图像生成+4图像生成
223+221v2.3.412026-11-10 20:29 UTC
Awesome-VLM-Streaming-Video
ydyhello

收集视觉语言模型在流式视频场景下的论文与开源代码,帮研究者快速定位在线视频理解方向的资料。
视觉语言模型+4视觉语言模型
219+182026-10-30 03:17 UTC
AsyncDiff
czg1225·Python

把扩散模型的去噪步骤拆到多张卡上异步并行执行,无需重新训练就能显著加速 Stable Diffusion 等文生图、文生视频模型的推理。

扩散模型+4图像生成
216132025-09-27 03:22 UTC
ComfyUI-MiniMax-H3-Image-Studio
astropuzzo·Python

为 ComfyUI 提供 MiniMax H3 文生图、参考图编辑和 Qwen 细节精修的节点与实测工作流,开箱即用。
文生图+4图像生成
21511v24.1.02026-09-30 10:01 UTC
GRACE
ForeverBlue816·Jupyter Notebook

面向视觉语言模型的 INT4 量化部署方案,通过量化感知蒸馏把大模型压缩到 4bit,在保持多模态能力的同时大幅降低显存占用。

视觉语言模型+4视觉语言模型
2138v0.1.02026-10-26 10:57 UTC
RSI-Qwen
wadeKeith·Python

在官方 DocVQA 基准上让智能体自动迭代 Qwen3-VL 的训练代码,省去手工调参和实验设计,支持 NVIDIA 多卡与 Apple Silicon。
视觉语言模型+4视觉语言模型
212341.0.02026-10-31 07:42 UTC
pictex
francozanardi·Python

用 CSS Flexbox 布局语法在 Python 里生成图片,支持渐变、阴影和文字排版,适合批量出图或程序化设计。
图像生成+4图像生成
2117v2.3.02026-04-03 22:45 UTC
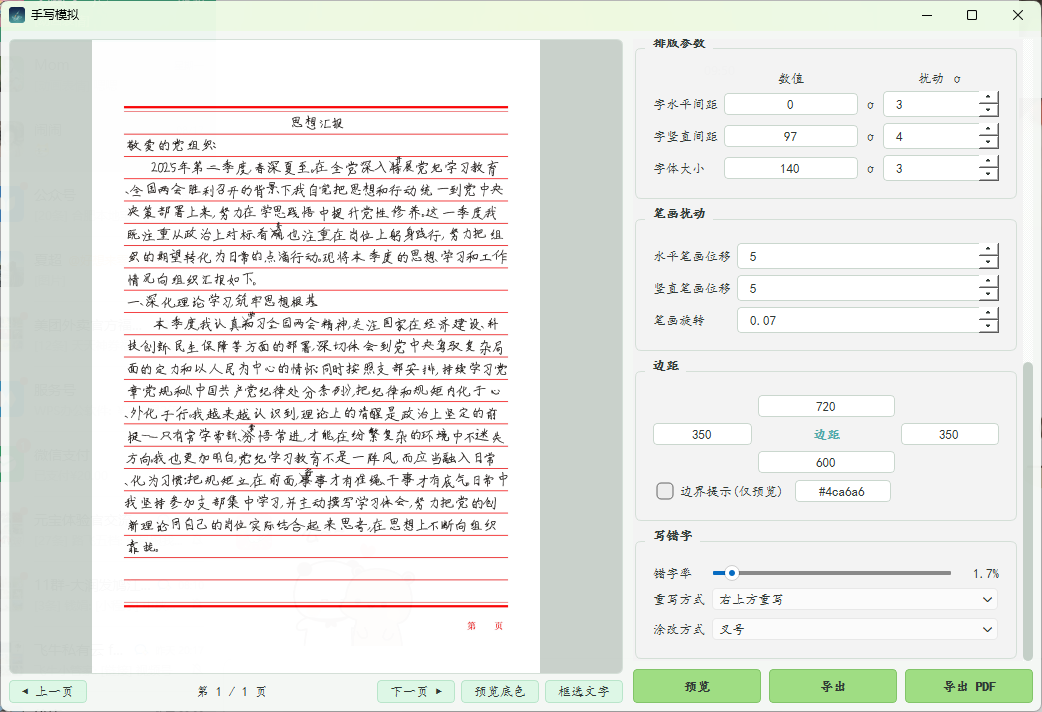
Handwriting-simulator
bamboostrip·Python

把普通文本渲染成逼真的手写体图片,支持手写字体、信纸背景和字距行距笔画随机扰动,提供 GUI 和 CLI 两种用法。

手写体生成+4图像生成
211+428v0.5.12026-10-29 03:06 UTC
awesome-ai-video-models
Anil-matcha

汇总各家 AI 视频生成模型的横向对比清单,覆盖模型能力、可用 API、价格和生成速度,方便选型时快速查表。

视频生成+4视频生成
211482026-09-29 08:06 UTC
awesome-minimax-h3-prompts
BeatAPI·JavaScript

收集整理 MiniMax H3 视频生成提示词,覆盖电影感、广告、动漫、UGC、产品视频等场景,附带可播放示例和创作者署名,方便直接参考套用。
视频生成+4视频生成
209142026-10-07 14:41 UTC
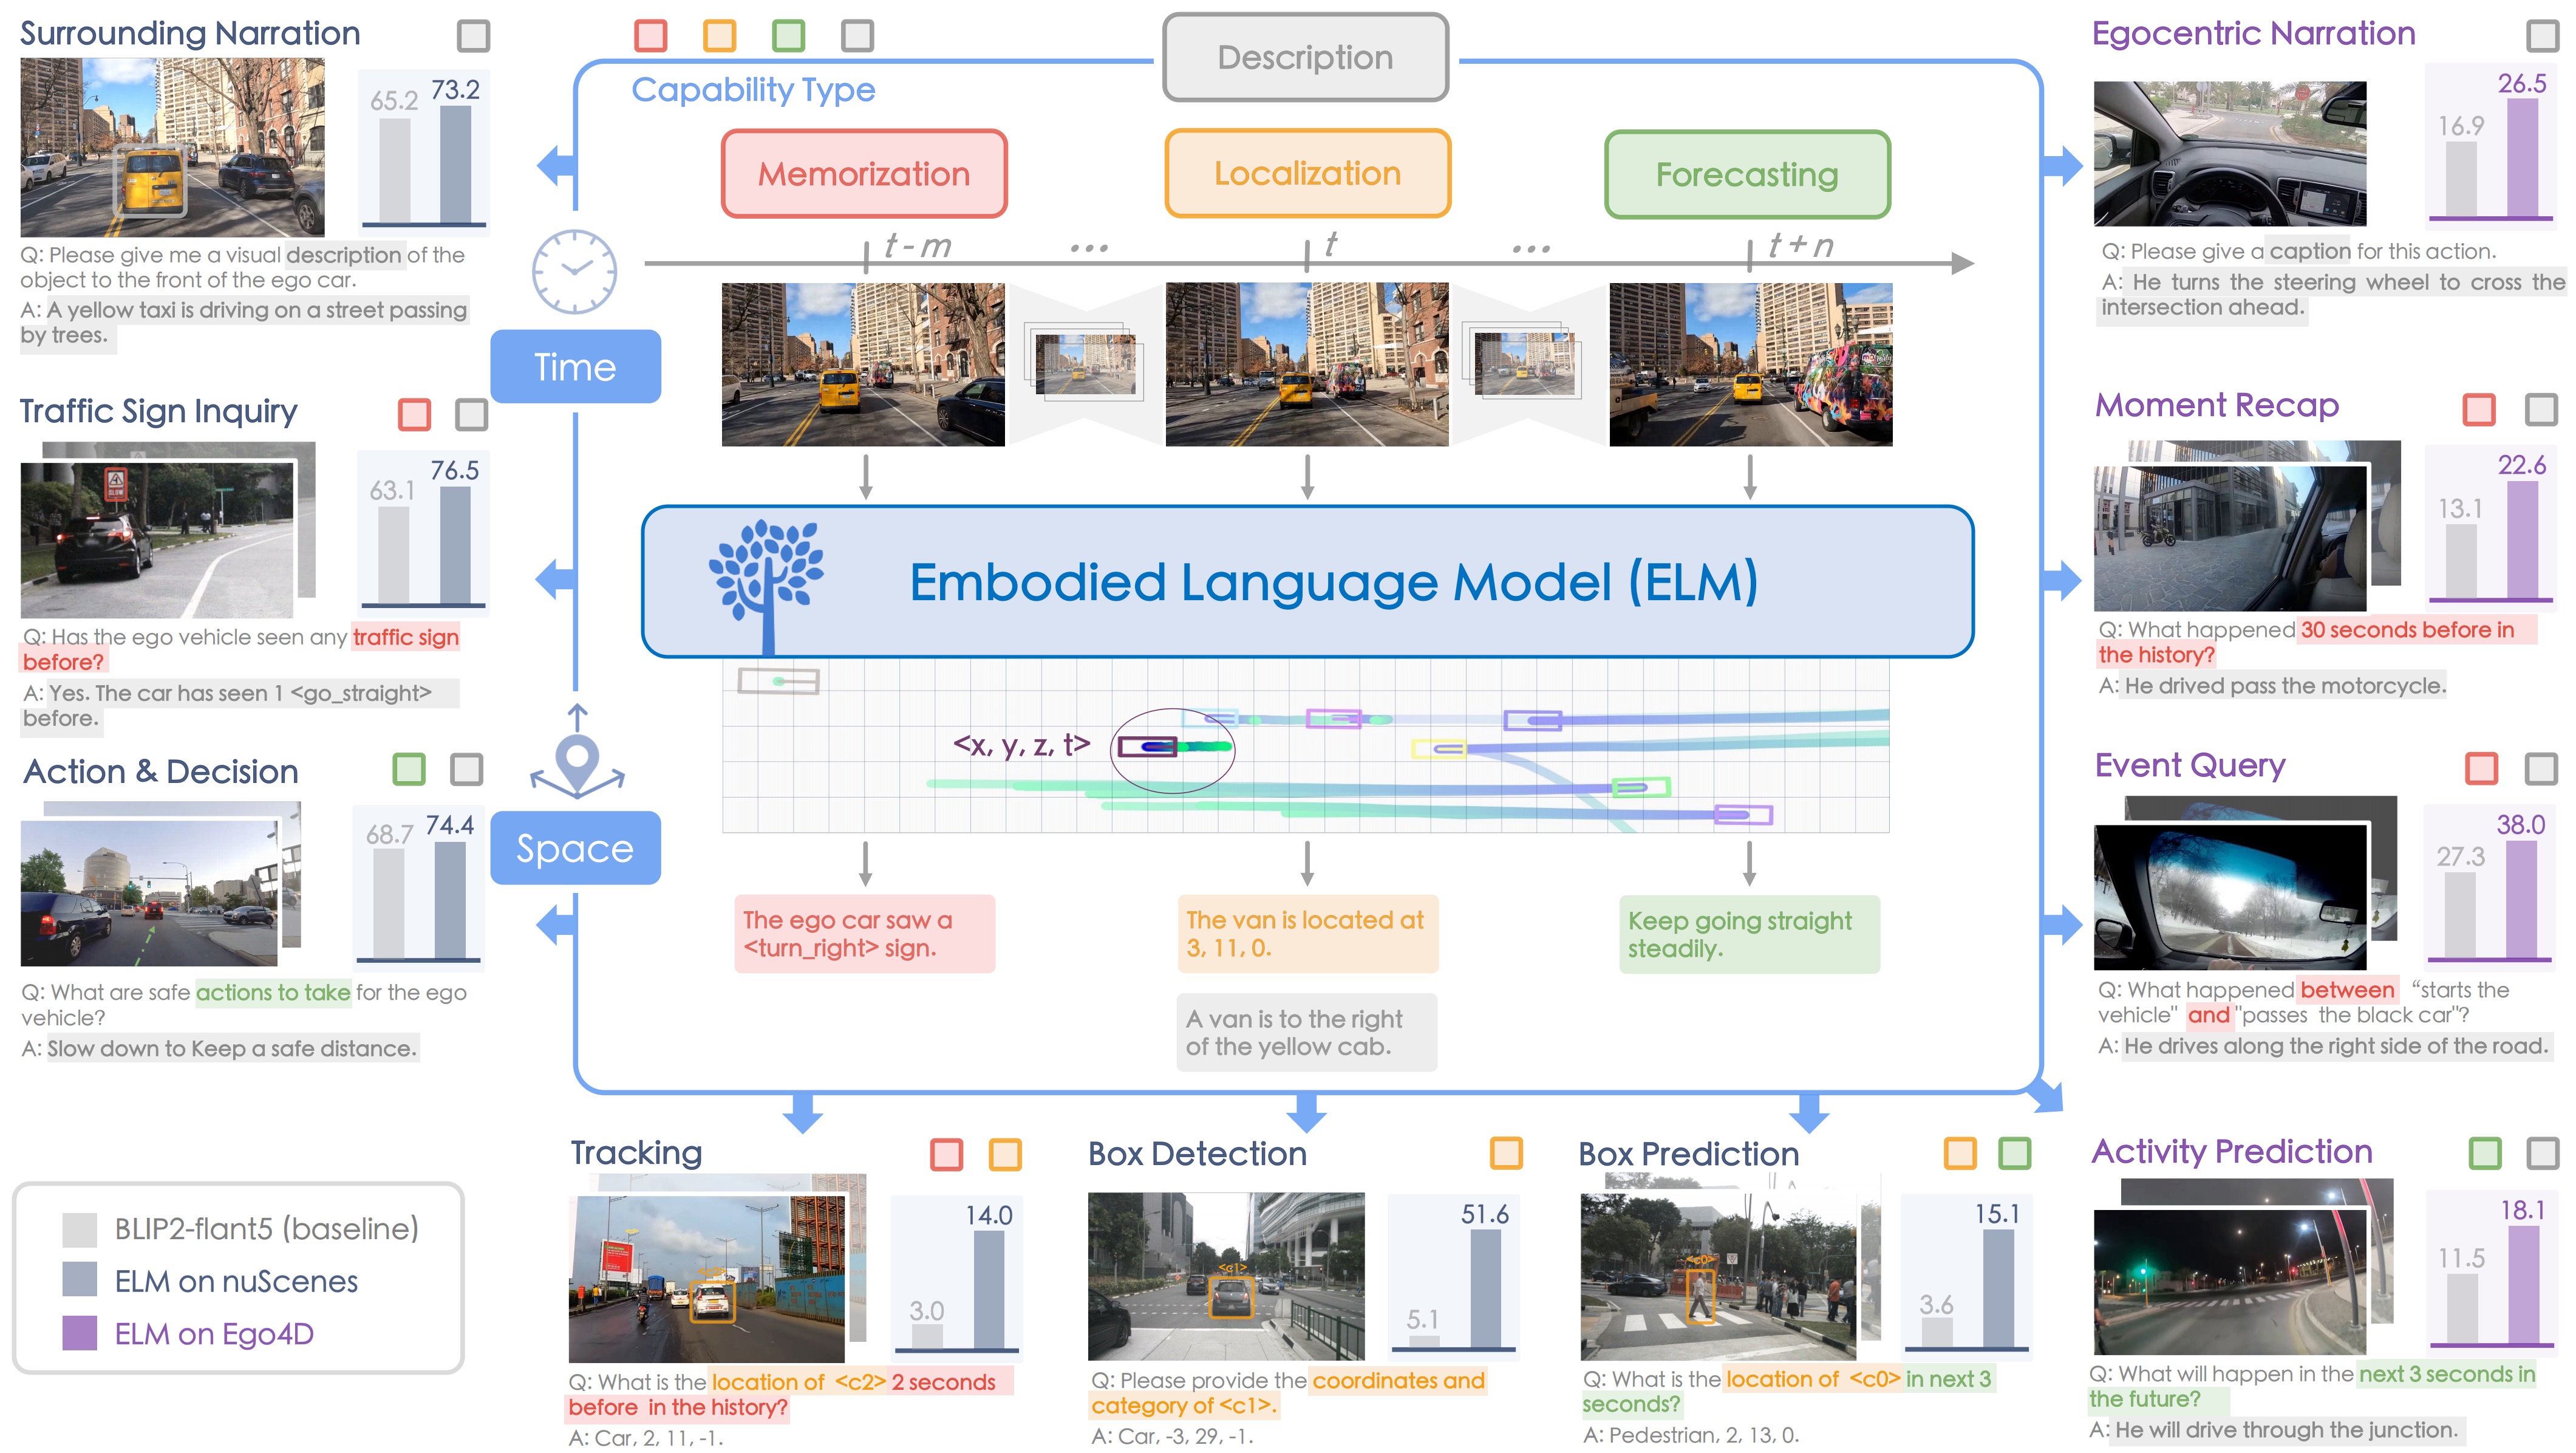
ELM
OpenDriveLab·Python

面向自动驾驶场景的视觉语言基础模型,通过多模态理解把驾驶画面转成可推理的语义描述,为端到端驾驶提供感知与决策支持。

自动驾驶+4自动驾驶
208142025-07-02 05:28 UTC
qwen-image-2.1-skill
iamyoki·Python

把 Qwen-Image-2.1 的文生图和多图编辑提示词按阿里官方规范自动改写优化,让 AI Agent 出图更准。

提示词优化+4图像生成
207112026-09-22 05:33 UTC
autoshorts
divyaprakash0426·Python

从长视频游戏录像里自动剪出适合竖屏短视频的精彩片段,靠 AI 场景分析挑高光、GPU 加速渲染,还能加 AI 配音。

短视频生成+4语音
207202026-11-05 08:47 UTC