检索与 RAG
共 22 个仓库 · 近 4 个月有推送 · C++
老牌开源 OCR 引擎,用 LSTM 识别图片中的文字,支持上百种语言,适合做文档扫描和文本提取。
面向稠密向量的高效相似度检索与聚类库,支持十亿级向量近邻搜索,是构建向量数据库和 RAG 检索层的底层引擎。
兼容 Redis 和 Memcached 协议的内存数据库,用多线程架构提升吞吐量,可直接替换现有缓存层。
用 C++ 写的开源内存搜索引擎,支持模糊容错、分面和地理检索,可作为 Algolia、Pinecone 或 ElasticSearch 的轻量替代,快速搭建搜索体验。
轻量级进程内向量数据库,主打极速检索,适合在本地为 RAG、语义搜索和 LLM 记忆等场景提供向量与全文检索能力。
面向视觉小说和 Galgame 的翻译工具,通过文本钩子、OCR 和剪贴板等多种方式提取游戏文本,再接入翻译引擎,让玩家能顺畅阅读原文。

开源分布式数据库,兼容 MySQL,支持 HTAP 混合负载与全文检索,用一套引擎承载 OLTP、分析和 AI 场景下的高要求业务。
MySQL 的社区分支,由原 MySQL 核心团队维护,提供功能完整、稳定且许可证宽松的开源关系型数据库,支持全文检索、GIS 和向量近邻搜索。
Windows/macOS 上替代 Snipaste 和系统截图工具的本地截图录屏方案,OCR 与标注全程离线
提供 Snow Shot 截图工具和 Snow Image Viewer 看图软件的源码,集截图、录屏、OCR 和图片浏览于一体,适合需要本地桌面图像处理工具的用户。
纯头文件的 C++/Python 近似最近邻检索库,实现 HNSW 算法,无需额外依赖即可嵌入项目,用于向量相似度搜索。
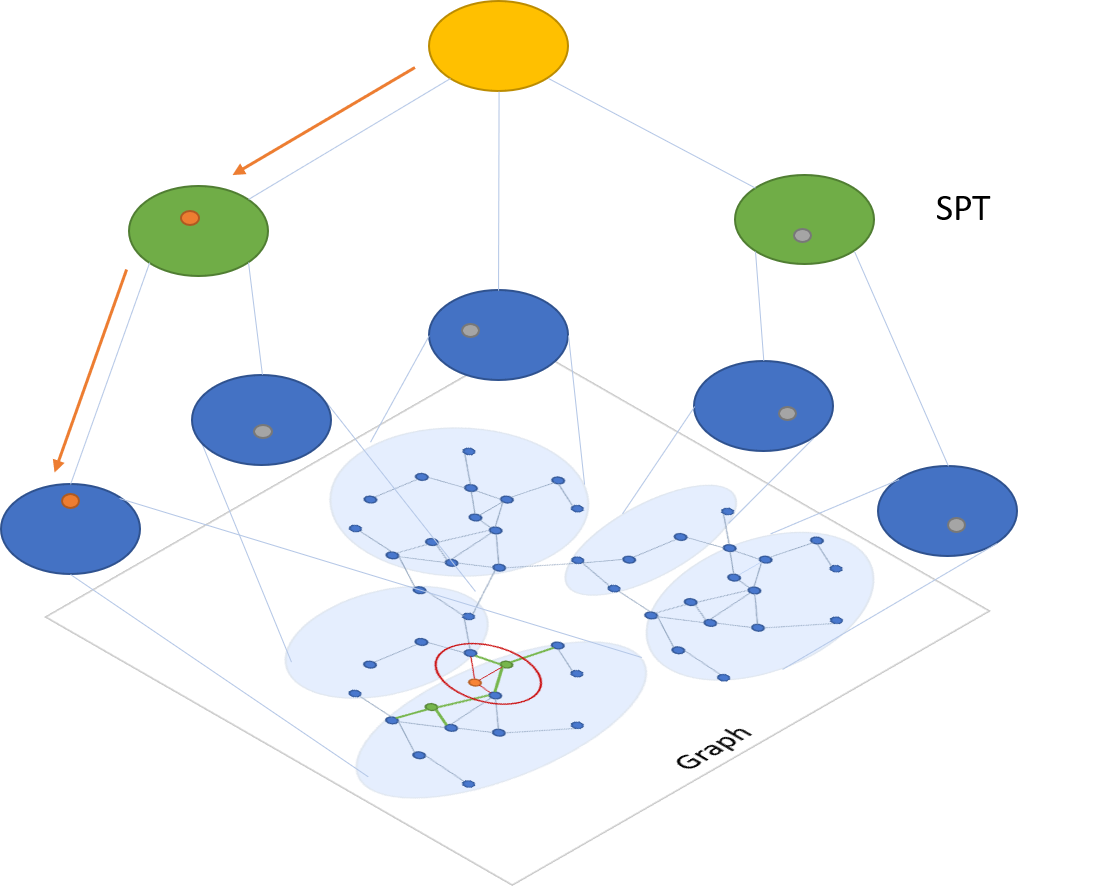
微软开源的分布式近似最近邻搜索库,提供高质量向量索引构建、搜索和在线服务工具,专为大规模向量检索场景设计。
高性能开源内存图数据库,兼容 Cypher,用 C++ 编写,适合 GraphRAG、AI 记忆、智能体和实时图分析场景。

轻量级向量与任意对象相似度搜索聚类引擎,支持十多种编程语言,可做近似最近邻检索、模糊搜索和推荐系统。
给编码智能体用的零依赖 C++23 命令行工具和 MCP 服务器,像 ripgrep 一样快速检索代码上下文,还能评估改动影响范围、该跑哪些测试和质量变化。
基于 Tesseract 的图形界面 OCR 工具,支持扫描仪输入和 PDF 文档处理,方便把图片和扫描件转成可编辑文本。
用 C++ 实现的支持 Cypher 查询语言的图数据库,适合构建代码知识库和知识图谱,为检索与 RAG 场景提供图数据存储和查询能力。
基于邻域图和树结构的高维向量近邻检索库,用 C++ 实现,适合给向量数据库和 RAG 系统做低延迟的近似最近邻搜索。
基于 TensorRT FP16 加速的 PP-OCRv6 推理服务,在 OmnidocBench 上跑出 200+ img/s,提供 HTTP 和 gRPC 接口,适合高吞吐文档解析与 RAG 场景。

可嵌入内存文档数据库,自带高层查询构建器,支持向量、全文和混合检索,适合在应用内直接做 RAG 与相似度搜索。

一个多模态数据库,用单一 ACID 方案替代 MongoDB、Neo4J 和 Elastic,支持文档、图、键值存储,并提供 NetworkX、Pandas 接口和多语言绑定。

一款开源的 Windows 截图工具,支持滚动长截图、标注、OCR 文字识别、翻译、钉图编辑、GIF 录制和剪贴板历史,适合日常截图与图文处理。