视觉与 3D
共 256 个仓库 · Python
面向随手拍摄的长视频,无需相机位姿即可稳健重建 3D 高斯泼溅场景,解决长序列位姿漂移和重建不稳的问题。

基于结构感知的稀疏视角 X 射线三维重建工具箱,用 Transformer 和 NeRF 从少量 X 光片重建 CT 体积并合成新视角,降低辐射采样需求。
用神经网络学习多视角一致的隐式场景表示,从一组图像中估计相机参数,实现无需传统匹配流程的稀疏重建与相机定位。

基于 PyTorch/MXNet 的 Python 文字检测工具包,能从图片中定位中英文场景文字、数学公式和版面结构,适合 OCR 前处理与文档解析。
YOLO-Master 是腾讯开源的实时目标检测模型,用专家混合(MoE)搭配专用 Transformer 提升检测精度与速度,支持检测、分割和分类任务。
把组织切片图像做空间拓扑重建和切片间对齐,为空间组学分析提供三维组织坐标,解决连续切片难以配准的问题。
用高斯层级表示做三维重建和新视角合成,能从多视角图像重建可实时渲染的场景,适合需要高质量渲染的 3D 视觉任务。
给 CUT3R 这类循环式三维重建模型换了个简单的状态更新规则,让它在长序列输入下不容易崩,提升长度泛化能力。
面向 LiDAR 里程计的鲁棒 ICP 算法,专门解决走廊、隧道等几何退化场景下位姿估计失准的问题,是 IEEE RA-L 2025 的 SOTA 方案。
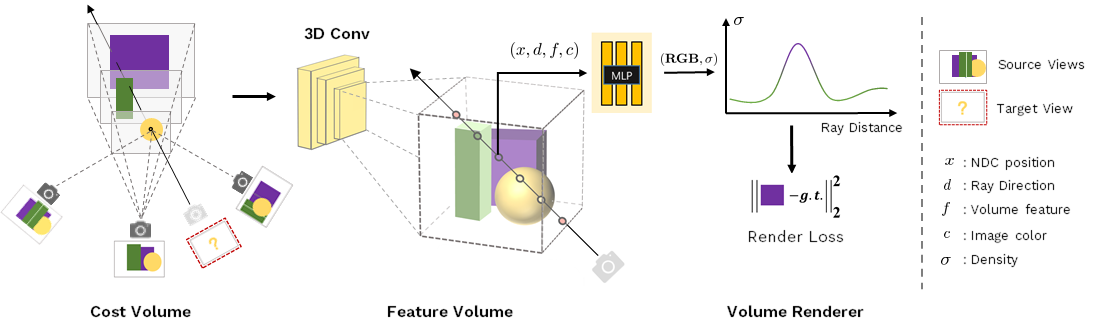
ICCV 2021 提出的神经渲染方法,能从多视角图像高效重建几何与神经辐射场,用于新视角合成。
Python 实现的多目标跟踪算法集合,集成 IoU Tracker 等多种跟踪器,配合 OpenCV 和 SSD-MobileNet 等检测模型,快速搭建视频目标跟踪流程。
用 RANSAC 从点云中拟合平面、球、圆柱、长方体、圆和直线等 3D 基元,适合 LiDAR 与三维重建场景做形状检测和分割。
用生成模型提升多视角 3D 物体重建精度,从多张图片还原准确的三维形状与位姿,适合做图像到 3D 的研究与落地。

用稀疏控制点驱动 3D 高斯泼溅,从视频重建可编辑的动态场景,支持对运动轨迹做编辑和操控。
把手机拍摄的视频重建为可被 AI 查询的 3D 场景,内置 MCP 工具让 Claude、Cursor 等直接调用,并提供可自托管的 broker 与 VGGT-SLAM 库。
面向 AI 秋招的中英双语面试速查表,覆盖机器学习、大模型、扩散模型与智能体,可生成单文件 HTML 随时翻阅,另附学术主页生成器。
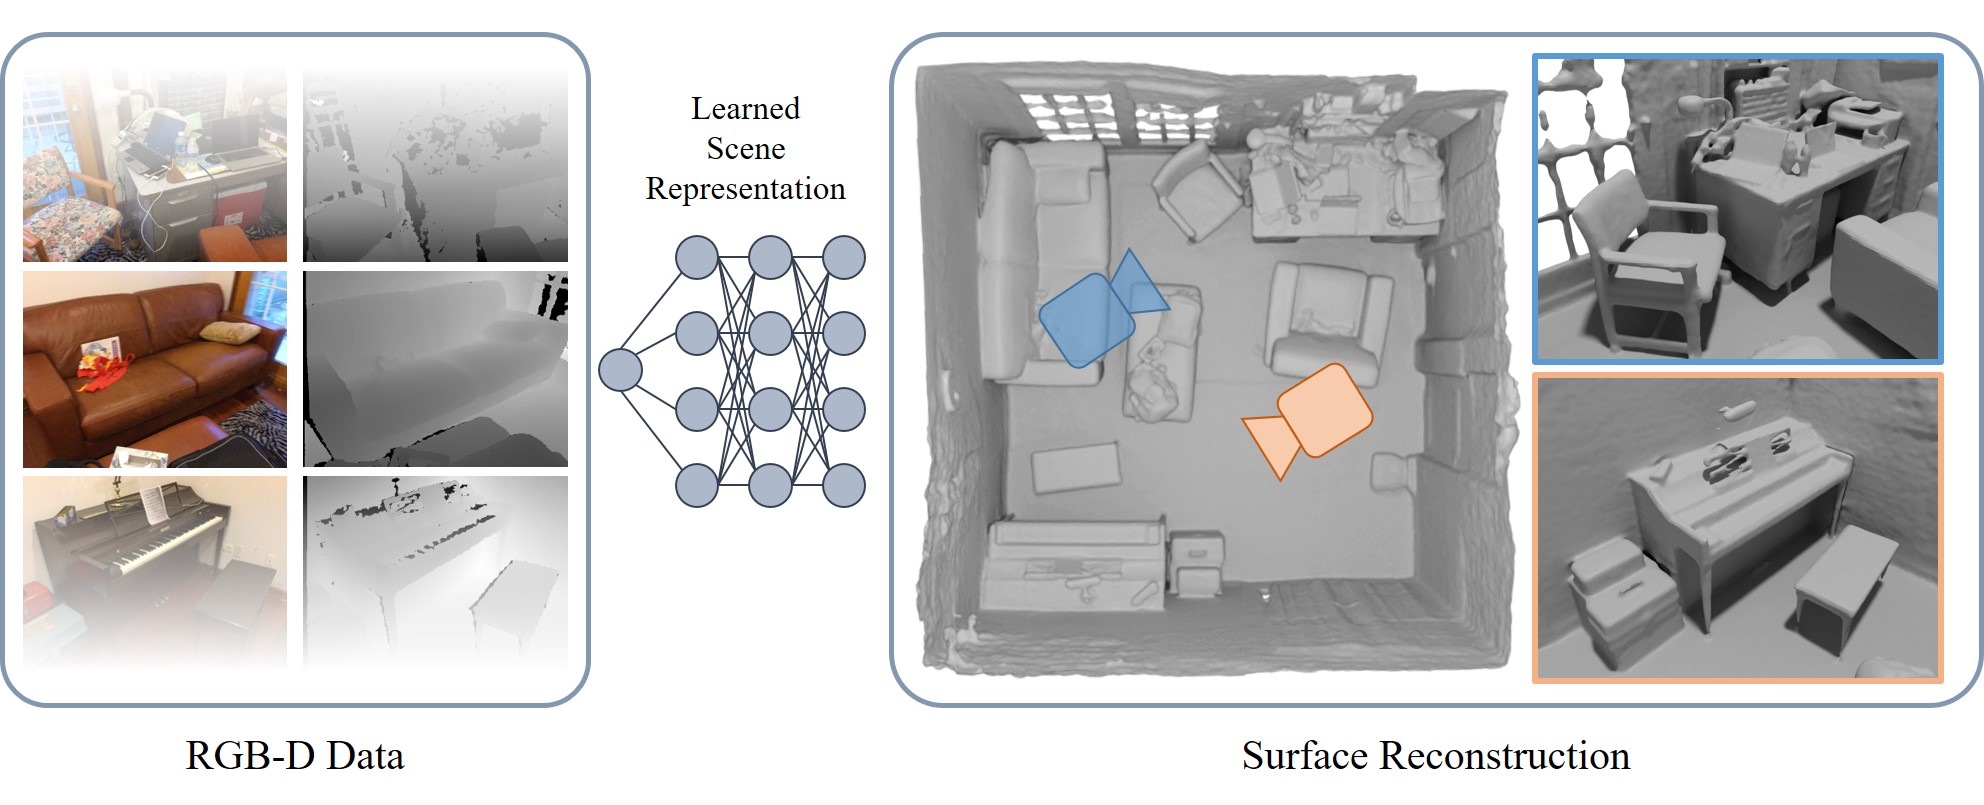
用神经网络从 RGB-D 序列重建高质量三维表面,是 CVPR 2022 论文的官方实现,适合做室内场景的稠密重建。
用点式隐式神经表示做 LiDAR SLAM,在保持全局地图一致性的同时完成定位与建图,适合机器人和 3D 建图场景。
带空间标注的大规模视频数据集,为视频生成、3D/4D 重建和空间推理模型提供训练与评测数据。
命令行工具,用于在 3DGS、KSplat、SPZ、Splat 等十余种 3D 高斯泼溅模型格式间互转,并支持 GPU 加速的统计离群点与密度滤波。
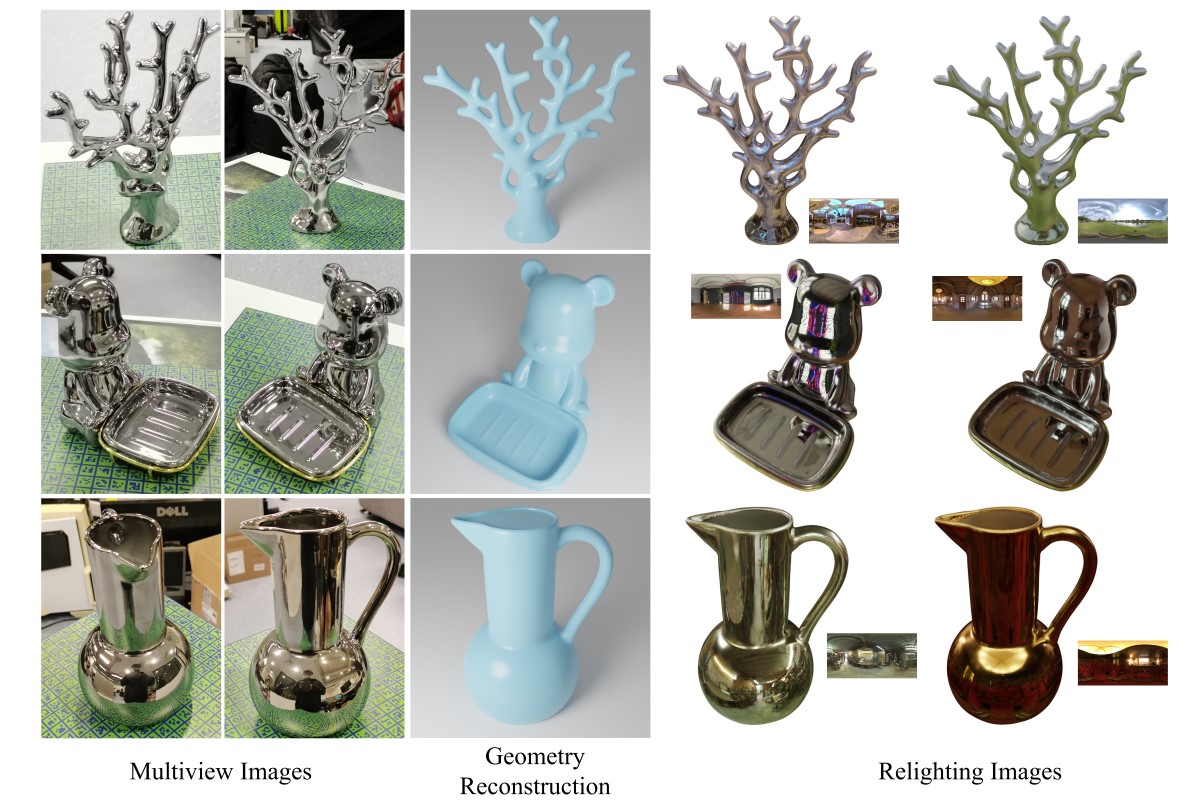
从多视角图像重建高反射物体的神经几何与BRDF,解决反光表面难以准确建模和渲染的问题。
面向计算机视觉的高性能图像增强库,支持分类、分割、检测等任务,可同步变换边界框和掩码,适合深度学习训练数据扩增。
用轨迹场把任意视频表示为 4D 结构,从普通视频中重建出带时间维度的三维场景,适合做动态场景的 4D 重建研究。
原生多模态大模型,把文本和图像统一到 3D 生成与理解任务中,支持文生 3D、图生 3D、3D 描述和编辑。