视觉与 3D
共 256 个仓库 · Python
QGIS 插件,用 Segment Anything Model 在地理栅格影像上快速分割和勾绘地貌,省去手工描边的麻烦。
把 SAM、MobileSAM、EfficientSAM、SAM 2/2.1 和 SAM 3 导出成 ONNX 模型,方便在任意平台跑可移植的图像分割,不用绑死原始框架。
基于零样本分割模型实现任意图像抠图,无需针对特定类别训练即可提取前景透明通道,适合快速落地通用抠图需求。
轻量级卡尔曼滤波 Python 库,用于视觉定位、里程计和 SLAM 中的状态估计与传感器数据融合。
单张图片一次前向即可重建画面中多人的 SMPL-X 三维人体网格与姿态,提供 PyTorch 推理代码和预训练模型,适合做多人姿态估计与人体重建的落地验证。
端到端 SLAM 系统,把相机标定、单目先验和 3D 高斯泼溅稠密渲染串成一条流水线,让单目视觉同时完成跟踪与高质量三维重建。
一个 4B 参数的视觉定位基础模型,把检测、指代、指向、OCR、GUI 和版面定位统一到一个模型里,在 34 个基准上达到 SOTA,并提升机器人泛化和数据效率。
无需训练即可从视频中恢复人体网格模型,结合 SAM-3、Diffusion-VAS 和 SAM-3D-Body 实现 4D 人体重建,适合快速做视频人体建模。

HUGS 用高斯泼溅从单目视频重建可动画的人体三维模型,能同时还原人体和场景,方便做数字人渲染。
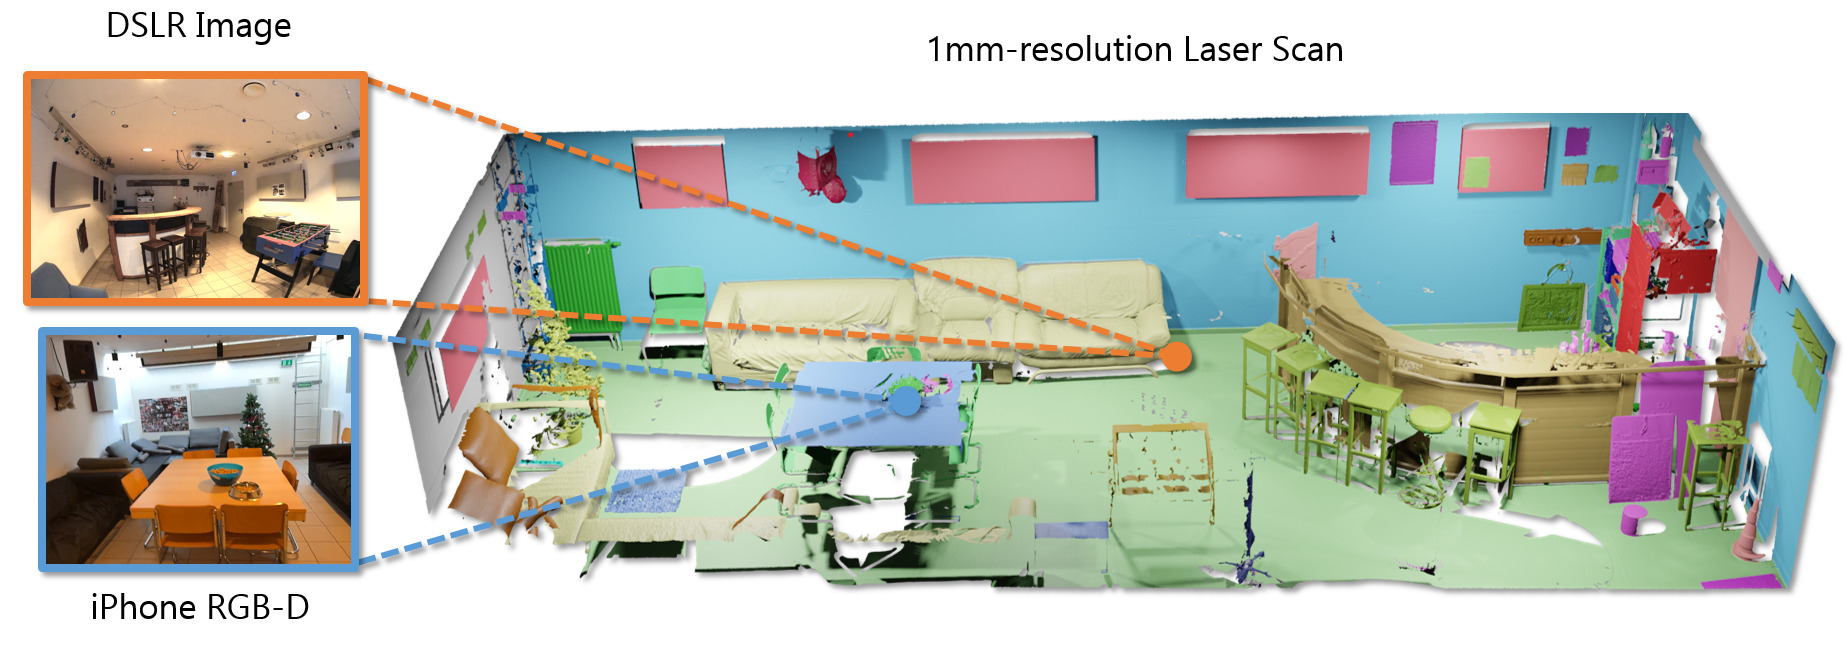
ScanNet++ 是一个高保真 3D 室内场景数据集,提供配套工具,支撑三维重建、语义与实例分割、新视角合成等研究。

压缩 3D 高斯泼溅模型,减少存储占用并加速新视角合成渲染,适合在资源受限设备上部署 3DGS 场景。
把 SAM 的分割能力扩展到任意分割任务的多模态大模型,支持文本指令驱动的通用图像分割。
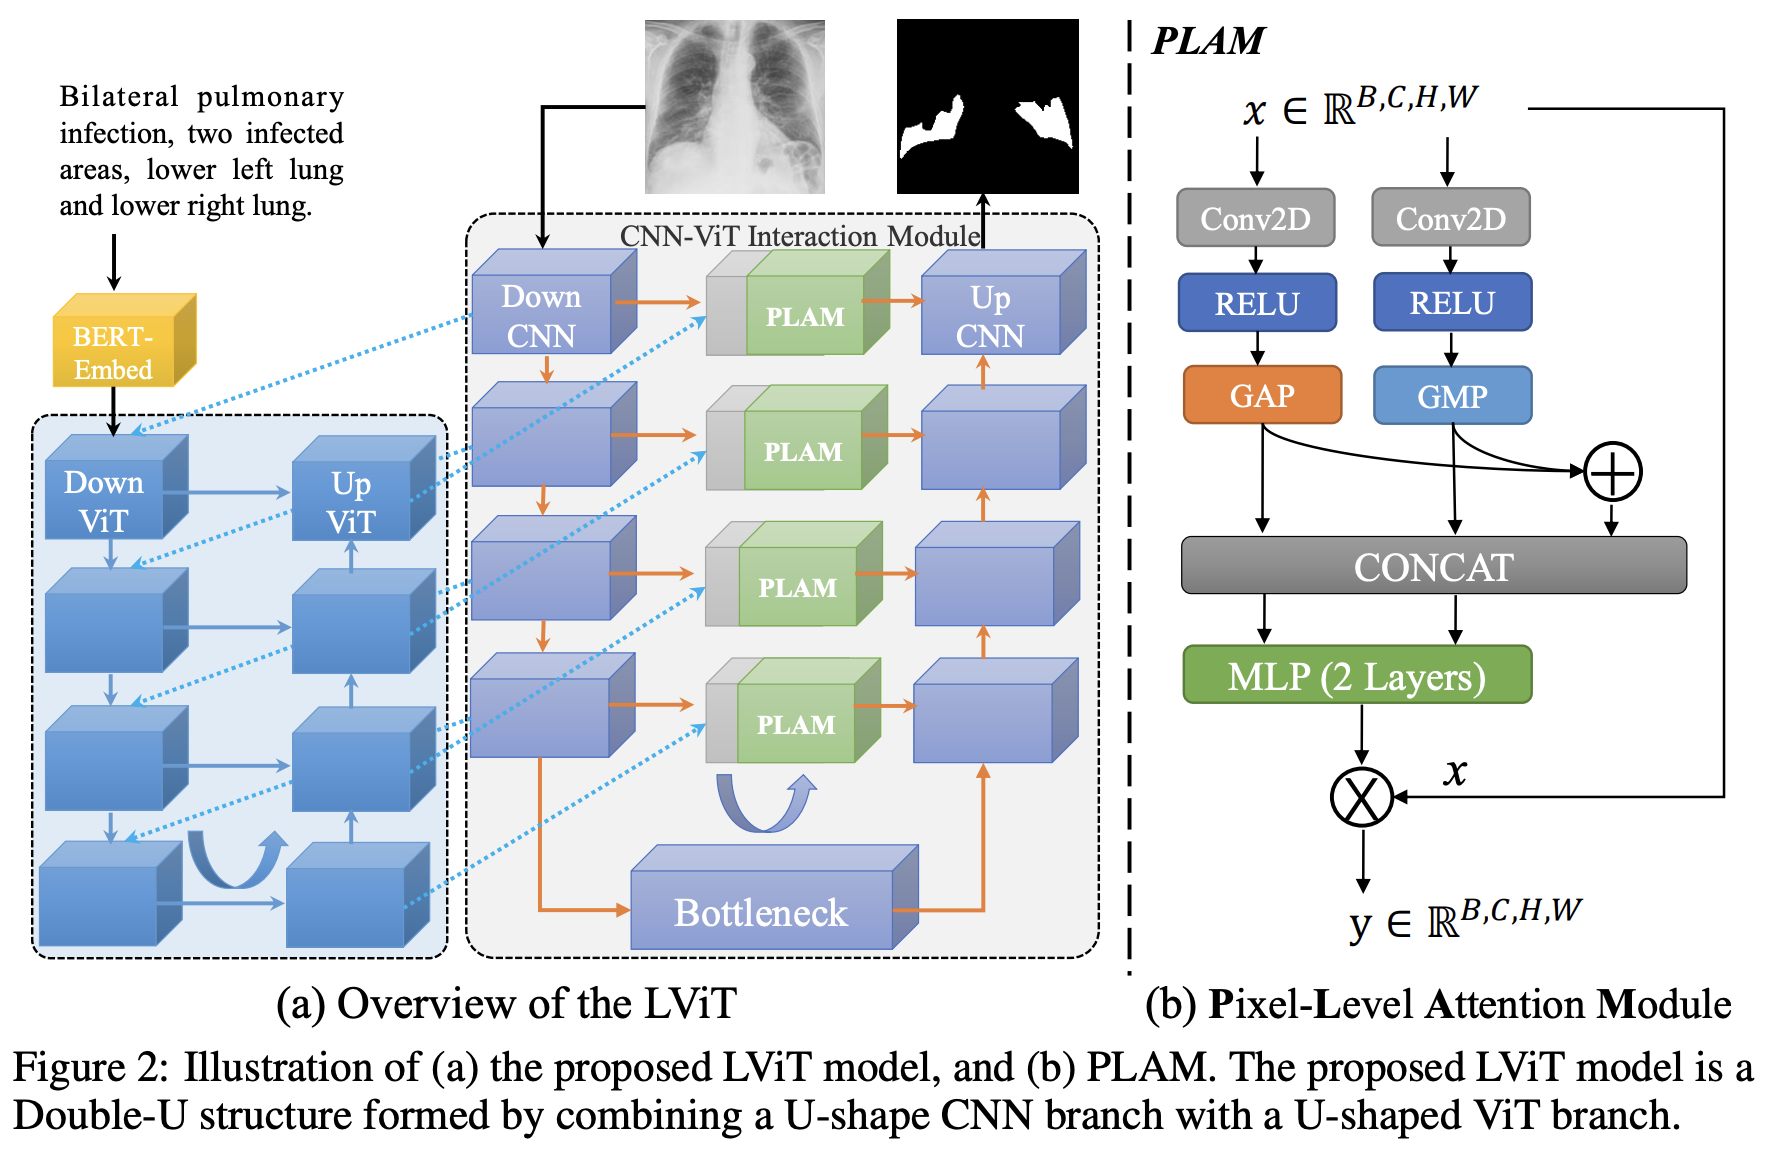
LViT 把文本描述引入视觉 Transformer,做医学图像分割,用语言信息弥补标注数据不足,提升分割精度。
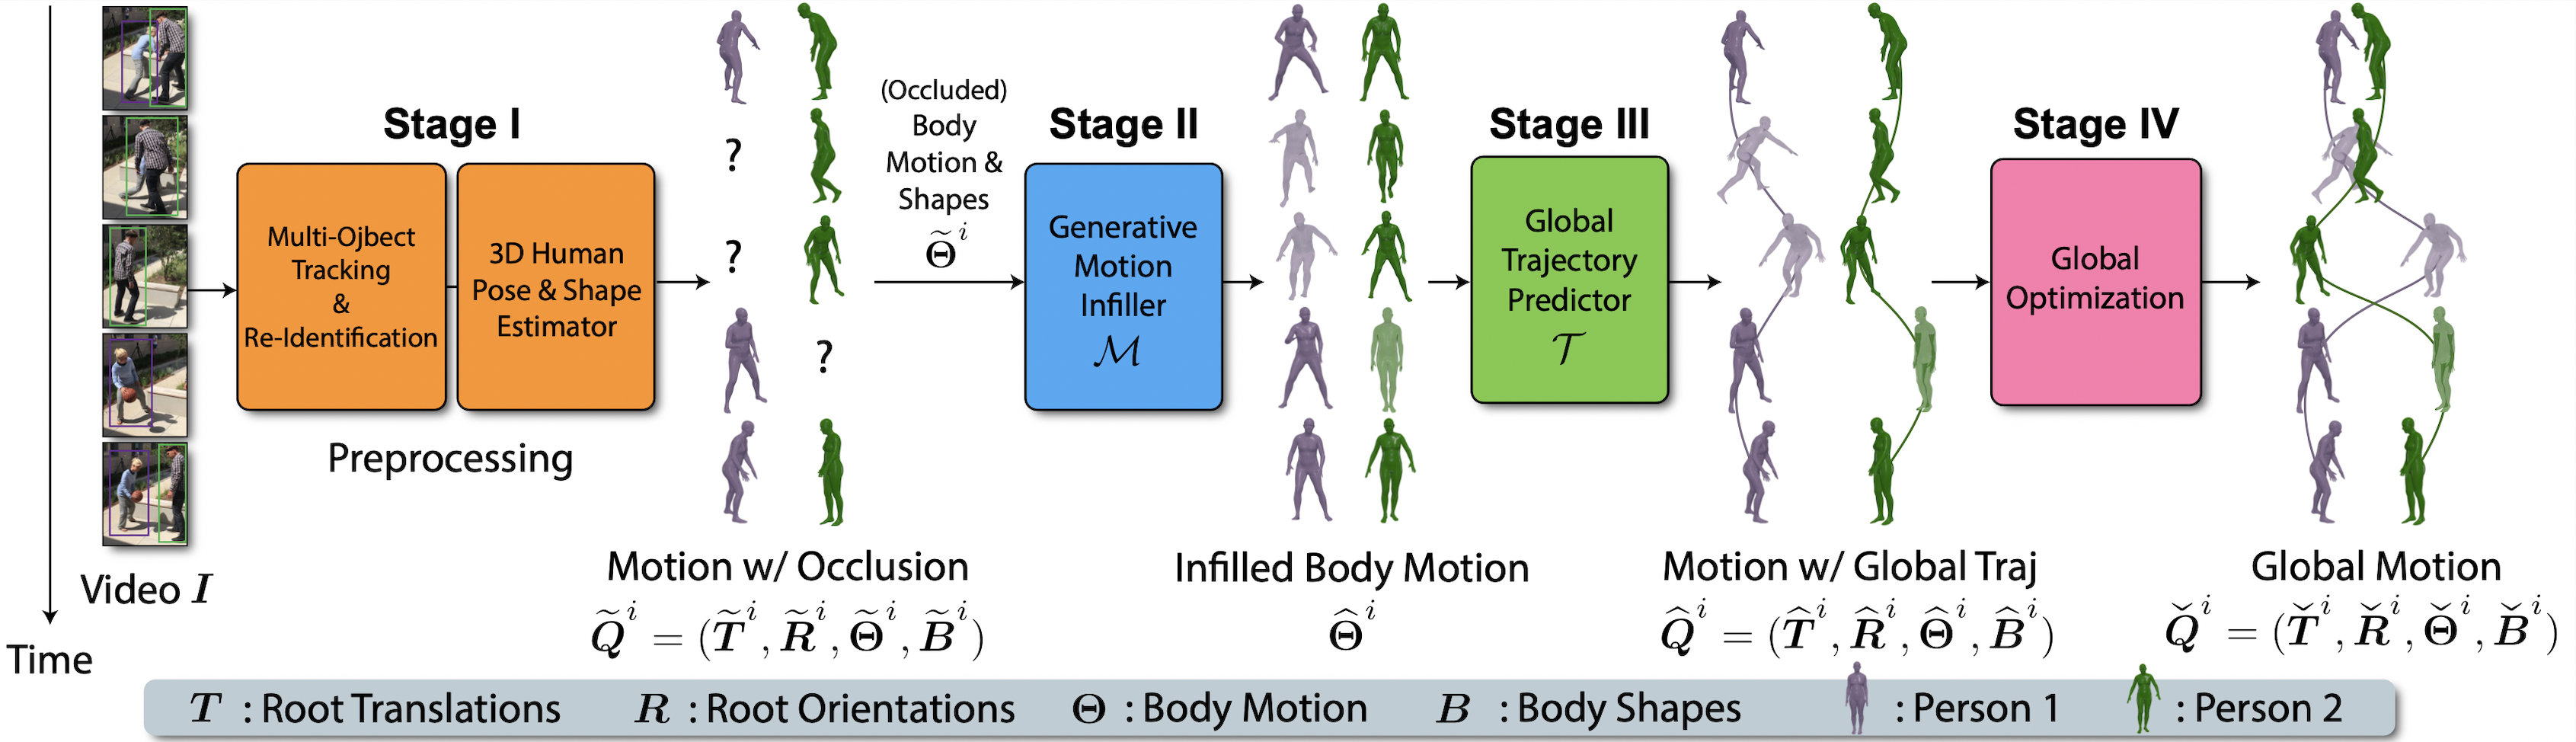
从动态相机拍摄的视频中恢复人体网格,能处理遮挡和全局轨迹,适合做人体动作捕捉与三维重建研究。
从多视角图像生成三维网格模型,通过形变网络逐步细化网格顶点,解决单视图重建细节不足的问题。

用 SfM 引导的单目深度估计做多视角三维重建,把稀疏重建的相机位姿和单目深度先验结合起来,提升复杂场景下的重建精度。

基于 3D 高斯泼溅的高动态范围新视角合成方法,用高斯表示重建 HDR 场景,比 NeRF 类方案快约 1000 倍。
用单张图片自监督重建三维场景,基于神经辐射场实现新视角合成与深度估计,无需三维标注数据。

OmniVGGT 是 CVPR 2026 提出的多模态视觉几何 Transformer,把图像、深度、点云等不同模态统一进一个空间基础模型,用来做 3D 重建和几何理解。
用生成模型合成带标注的肝脏肿瘤 CT 图像,无需人工标注即可训练分割模型,缓解医学影像标注成本高的问题。
基于 YOLOv8、PyTorch 和 OpenCV 实现目标检测与多目标跟踪,可直接跑通视频流中的实时追踪,省去自己拼装检测器和跟踪器的麻烦。
追踪 arXiv 上 3D 高斯泼溅(Gaussian Splatting)最新研究进展的精选列表,每日自动更新,帮研究者快速跟进三维重建与渲染的前沿论文。
vMAP 是 CVPR 2023 提出的神经场 SLAM 系统,用向量化对象建图实现实时 RGB-D 稠密重建,无需逐场景训练即可完成三维重建。
统一 NeRF 与 3DGS 方法的可复现评测框架,提供标准化基准和工具,方便公平比较不同新视角合成方案的性能。